一个 AI 或媒体工具最难解释的反馈,往往不是"任务失败",而是"上周同一个文件、同一个按钮,为什么今天结果不一样"。这类问题通常不是模型突然失灵,而是系统只保存了一个原始文件名和几项页面参数:文件可能被覆盖,默认值可能升级,用户也无法说明当时究竟选择了哪套配置。
本文继续使用脱敏的媒体处理任务 PT-20261007-002。用户上传 source.mp4,选择预设 WEB_1080P,系统创建一份可重复执行的任务快照。案例中的文件名、摘要值、参数和版本号均为教学示意;不公开真实素材、模型提示词、内部路径或服务配置。
环境边界:Java 17、Spring Boot 风格服务层、Python 3.11 Worker、MySQL 8.x。本文讨论文件身份、参数校验和配置快照,不讨论具体模型算法,也不公开生产环境的存储地址或运行命令。
目录
- 为什么文件名和页面参数不足以复现任务
- 固定案例:一次提交应留下哪些事实
- 上传校验:先确认文件能不能成为输入资产
- 配置版本:保存快照,不回头读取页面默认值
- 数据模型:文件资产、配置快照与任务引用
- 服务层实现:校验、归一化和生成可复现指纹
- 预期输出与自动测试
- [SQL 验证:如何发现覆盖、漂移和脏数据](#SQL 验证:如何发现覆盖、漂移和脏数据)
- 异常边界与上线验收
- 小结和延伸阅读
一、为什么文件名和页面参数不足以复现任务
上传接口收到 source.mp4 后,最简单的做法是把它存成 uploads/source.mp4,然后把页面上选择的分辨率写进任务表。这个做法会立刻遇到三种歧义:第二位用户同名上传会覆盖第一份;页面默认码率升级后,旧任务重跑得到不同结果;用户手工填入的"1080""1080p""1080P"被当作三个不同配置。
可复现不是要求每次都得到字节完全一致的媒体文件。编码器、依赖版本或硬件差异可能影响二进制结果。它要求的是:系统能明确回答任务当时引用哪一份输入、经过哪套归一化配置、使用哪个配置版本,并能在环境允许时按这些事实重新运行。没有这份证据,所谓"重跑"只是重新点一次按钮。
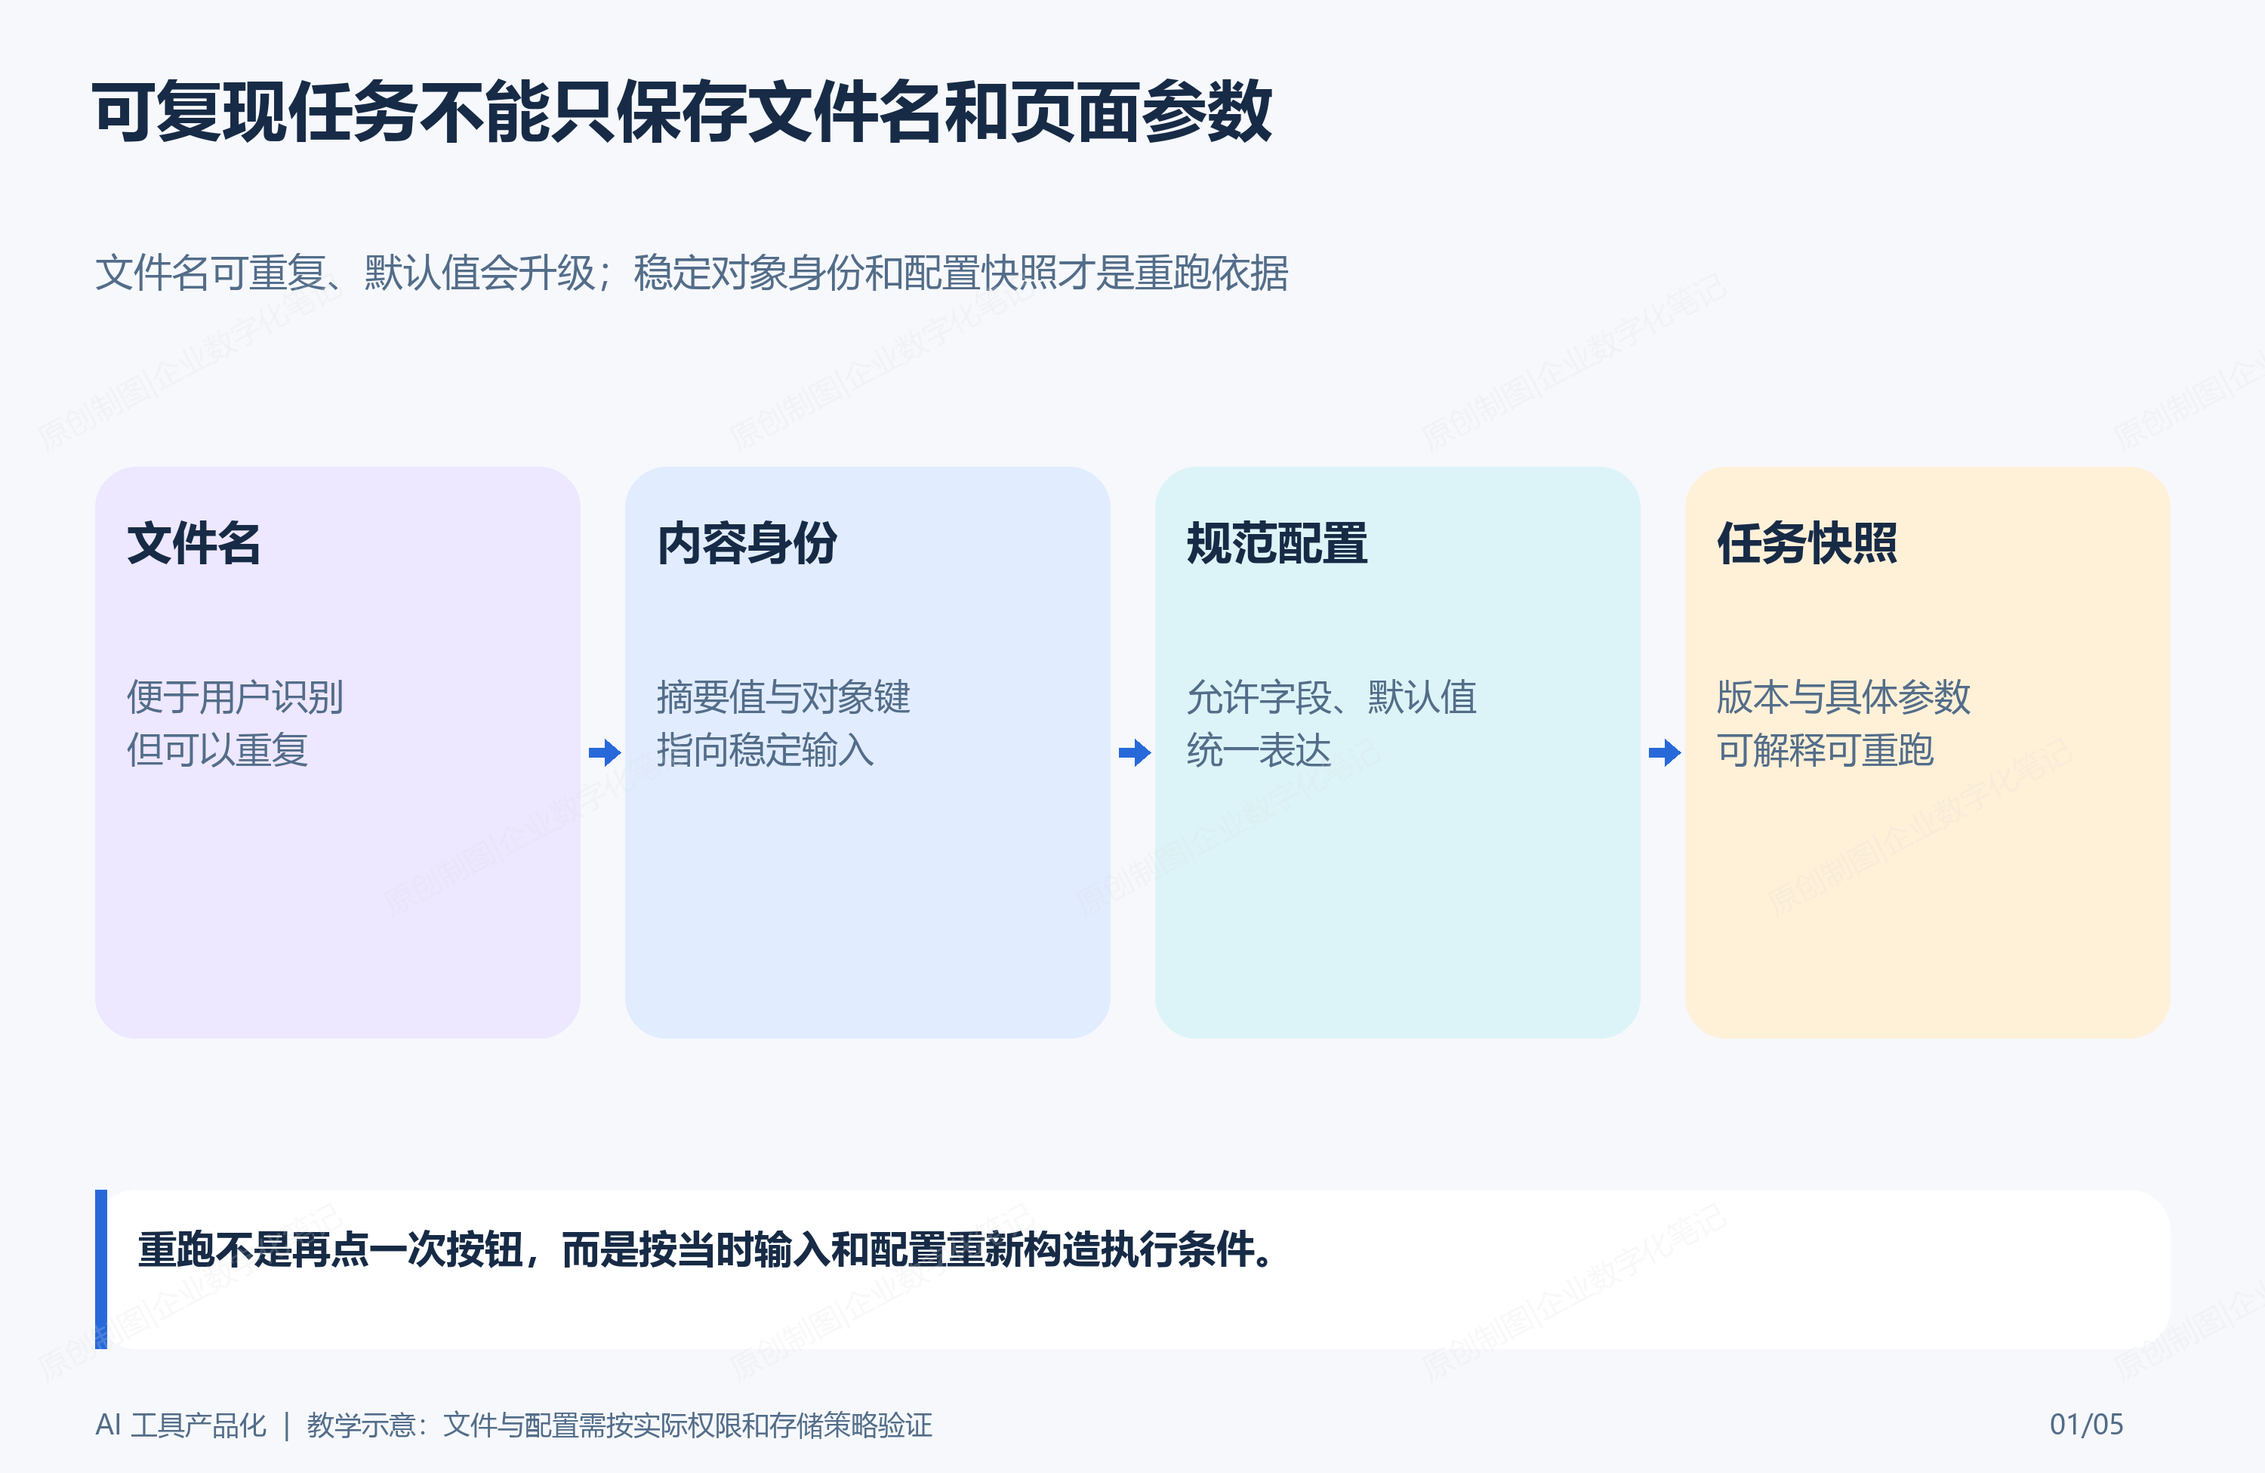
图1:文件名便于展示,却不能证明文件身份;页面参数便于输入,却不能代替版本化快照。
二、固定案例:一次提交应留下哪些事实
任务 PT-20261007-002 的输入和配置如下:
| 事实 | 教学示例 | 作用 |
|---|---|---|
| 上传显示名 | source.mp4 |
让用户识别自己提交的文件 |
| 对象键 | source/sha256/7f3a.../original.mp4 |
指向不可被同名上传覆盖的对象 |
| 内容摘要 | 7f3a... |
识别同一份二进制内容,支持去重与复查 |
| 媒体摘要 | 1920x1080、25fps、90.04s |
判断是否满足工具输入条件 |
| 配置版本 | media-preset-v3 |
固定可用预设和参数语义 |
| 配置快照 | WEB_1080P、1080、音频保留 |
重跑时不依赖当前页面默认值 |
| 复现指纹 | 输入摘要 + 规范配置 + 版本 | 区分"同一任务意图"和"新的一次请求" |
其中对象键可以是对象存储键、受控文件目录中的相对键,或其他稳定引用;重点是它不能仅由用户文件名组成。内容摘要也不是为了让前端承担安全校验,而是给后端建立"文件内容是否相同"的可核对标识。
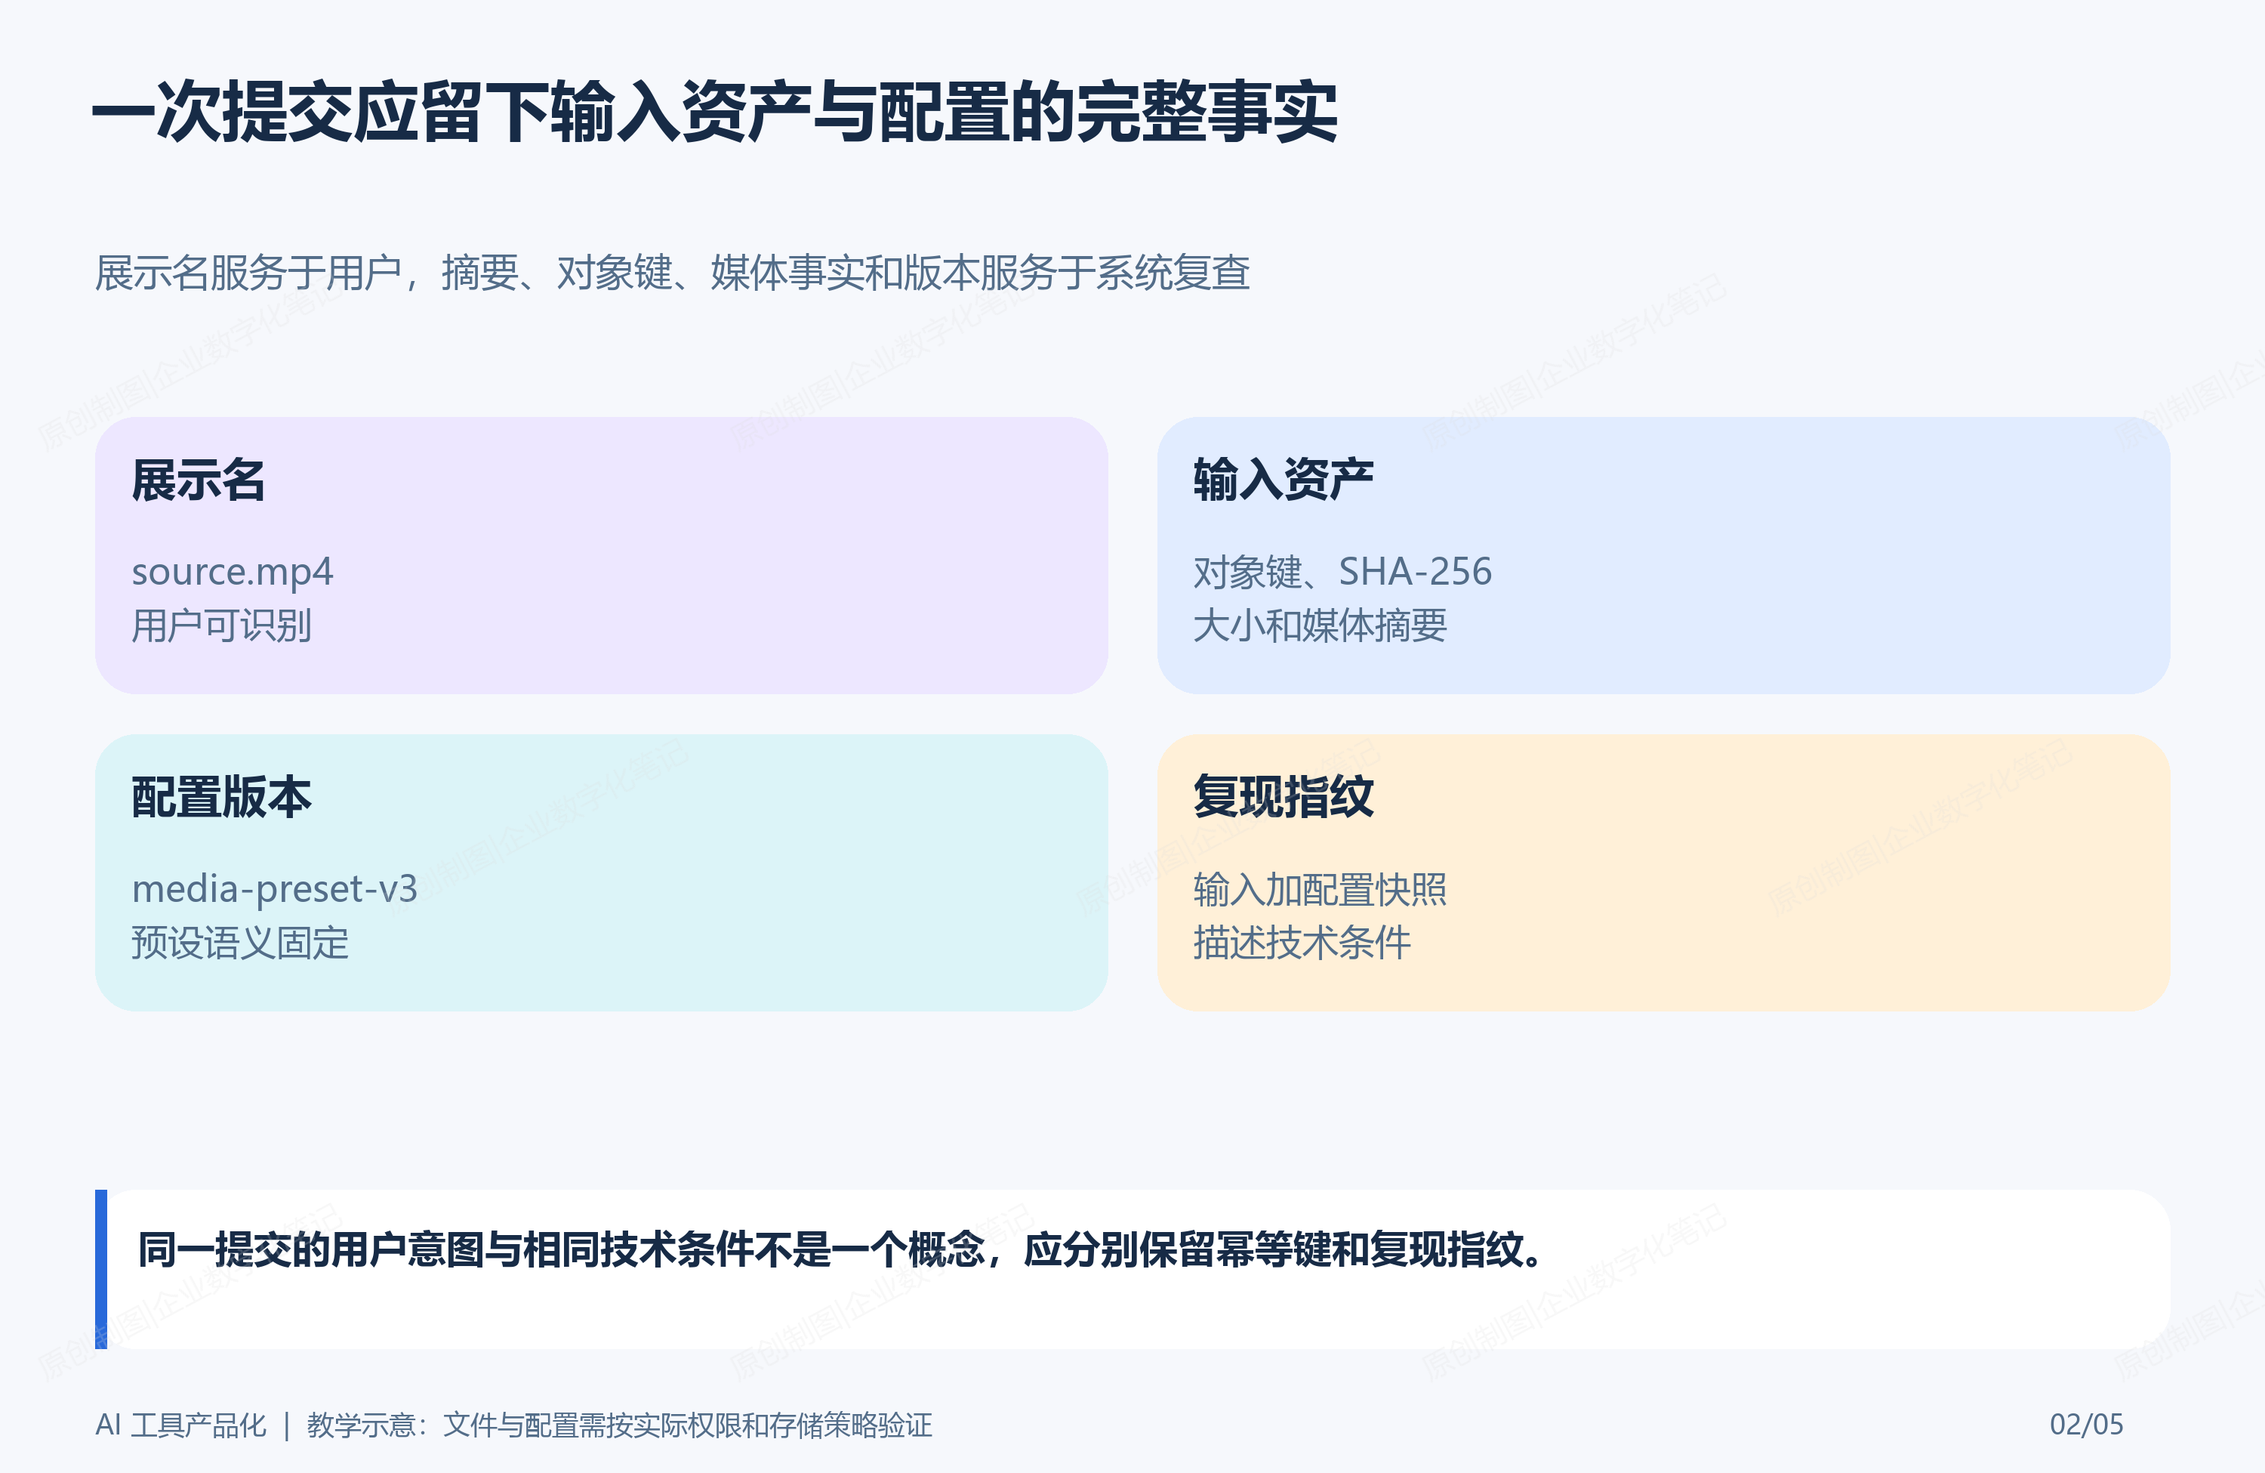
图2:用户看见的是文件名;系统重跑依赖的是对象键、摘要和固定版本的配置。
三、上传校验:先确认文件能不能成为输入资产
上传成功只说明字节已经到达服务端,不说明它适合进入任务队列。校验应分为三个层次:
| 层次 | 要检查什么 | 失败后的处理 |
|---|---|---|
| 接收层 | 文件大小上限、空文件、上传中断、允许扩展名 | 直接拒绝,提示重新上传 |
| 内容层 | MIME 仅作辅助;读取文件头或媒体探测,确认存在视频流 | 标记 INPUT_INVALID,不创建可执行任务 |
| 业务层 | 分辨率、时长、帧率、音频要求是否落入当前预设支持范围 | 告知该预设不支持,不把问题拖给 Worker |
扩展名不能单独作为可信依据;反过来,探测到视频流也不表示任何视频都值得处理。比如 WEB_1080P 可以允许大于等于 720p 的输入,却拒绝零时长和旋转元数据无法读取的文件。校验结果应作为输入资产的一部分保存,Worker 不需要再次靠猜测判断"这是什么文件"。
json
{
  "fileId": "F-20261007-001",
  "displayName": "source.mp4",
  "sha256": "7f3a...",
  "sizeBytes": 251004832,
  "probe": {"video": true, "width": 1920, "height": 1080, "durationSeconds": 90.04},
  "validationStatus": "ACCEPTED"
}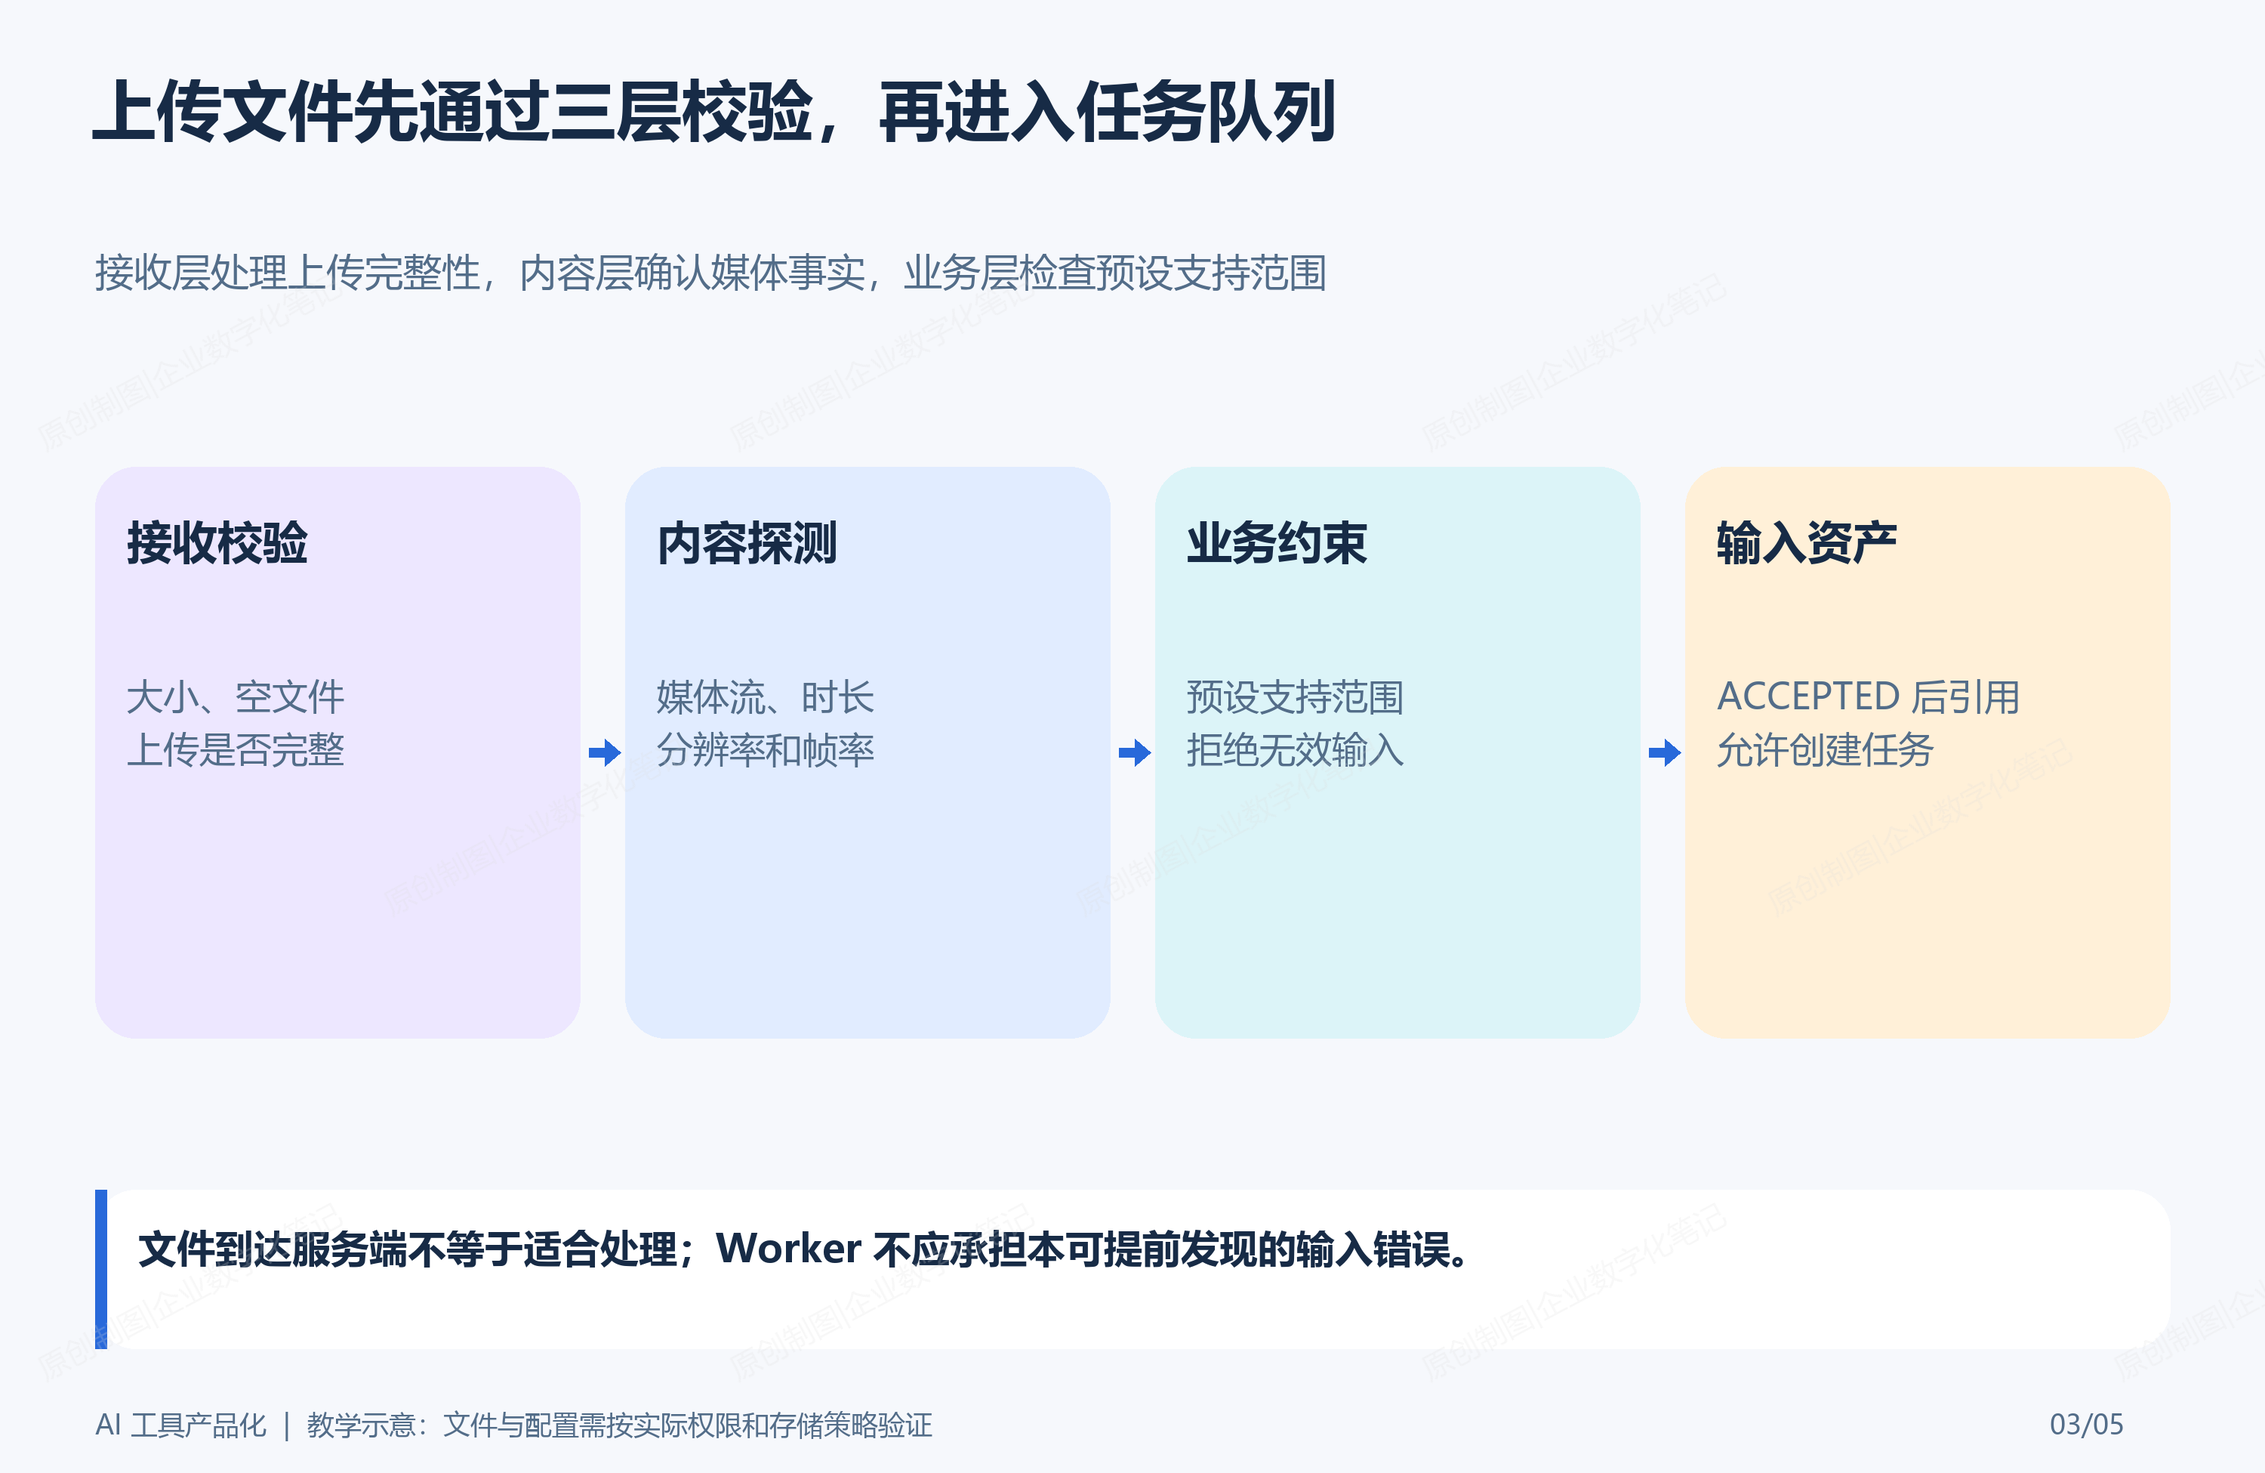
图3:输入校验在入队之前完成,让格式、时长和媒体流问题尽早暴露。
四、配置版本:保存快照,不回头读取页面默认值
预设并不只是下拉框文案。它定义哪些参数允许用户选择、缺省值是什么、参数如何组合以及哪些输入条件可接受。例如 WEB_1080P 在 media-preset-v3 中可能表示"最长边限制为 1080、保留音频、生成网页兼容结果"。当 v4 修改了默认质量策略,旧任务重跑仍应引用 v3 的已保存快照,而不是静默套用新默认值。
可以把配置分为两份:配置定义由发布人员管理,包含版本和允许字段;任务快照由提交时生成,只包含已归一化、已验证的具体值。页面只提交业务意图,服务端负责填充默认值、拒绝未知字段、排序键并生成规范 JSON。
json
{
  "configVersion": "media-preset-v3",
  "presetCode": "WEB_1080P",
  "normalized": {
    "maxHeight": 1080,
    "keepAudio": true,
    "outputContainer": "mp4"
  }
}
这里的 JSON 不是"把整个页面请求原样塞进数据库"。例如 UI 文案、临时开关、未被允许的自由文本都不应进入 Worker 配置。真正有意义的是一份字段稳定、语义明确、可比较的快照。
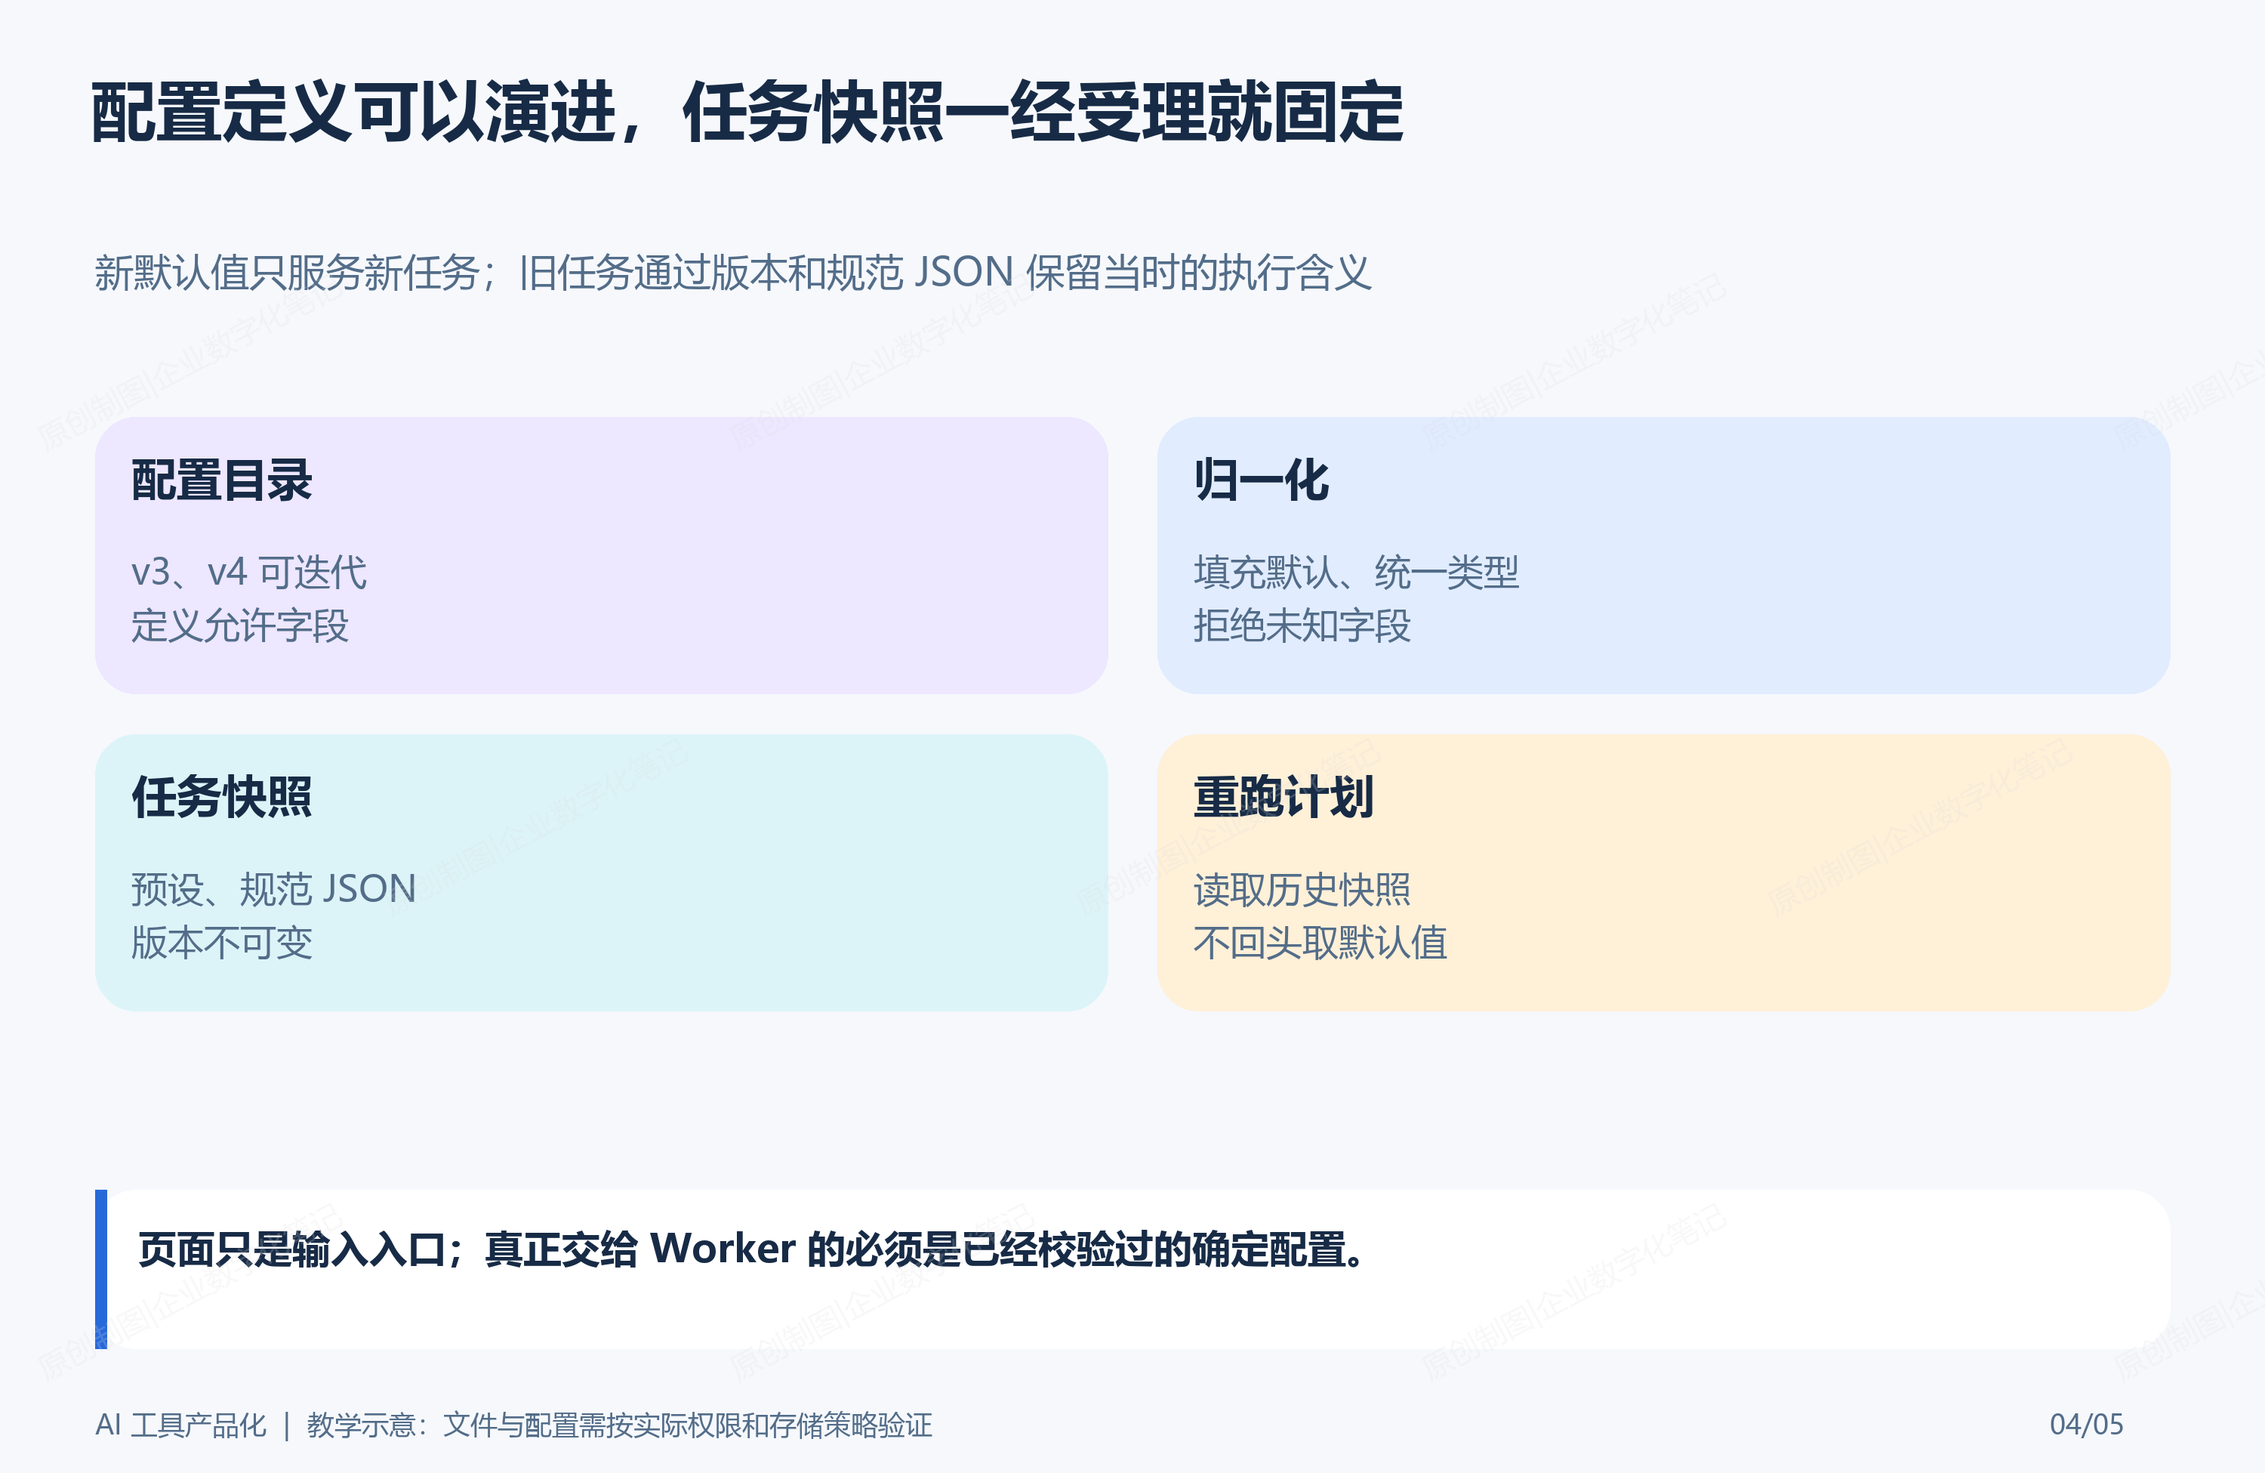
图4:页面默认值可以更新;任务配置一经受理就固定,以便解释和复跑。
五、数据模型:文件资产、配置快照与任务引用
将上传文件、配置快照和任务分开保存,可以避免"任务删了输入丢失"或"配置改了历史被改写"。下面的结构刻意省略存储供应商细节,只保留追溯所需事实:
sql
CREATE TABLE input_asset (
    id BIGINT PRIMARY KEY AUTO_INCREMENT,
    asset_no VARCHAR(40) NOT NULL,
    display_name VARCHAR(255) NOT NULL,
    object_key VARCHAR(255) NOT NULL,
    sha256 CHAR(64) NOT NULL,
    byte_size BIGINT NOT NULL,
    media_summary_json JSON NOT NULL,
    validation_status VARCHAR(24) NOT NULL,
    created_at DATETIME NOT NULL,
    UNIQUE KEY uk_asset_no (asset_no),
    UNIQUE KEY uk_asset_sha256 (sha256),
    CONSTRAINT ck_asset_status CHECK (validation_status IN ('ACCEPTED', 'REJECTED'))
);

CREATE TABLE tool_config_snapshot (
    id BIGINT PRIMARY KEY AUTO_INCREMENT,
    config_version VARCHAR(40) NOT NULL,
    preset_code VARCHAR(40) NOT NULL,
    normalized_json JSON NOT NULL,
    config_fingerprint CHAR(64) NOT NULL,
    created_at DATETIME NOT NULL,
    UNIQUE KEY uk_config_fingerprint (config_fingerprint)
);

ALTER TABLE tool_job
    ADD COLUMN input_asset_id BIGINT NOT NULL,
    ADD COLUMN config_snapshot_id BIGINT NOT NULL,
    ADD CONSTRAINT fk_job_asset FOREIGN KEY (input_asset_id) REFERENCES input_asset(id),
    ADD CONSTRAINT fk_job_config FOREIGN KEY (config_snapshot_id) REFERENCES tool_config_snapshot(id);
input_asset 不等于某位用户的任务:同一份内容可以被多次合法引用,但每次运行仍有独立任务号。tool_config_snapshot 也不等于全局配置表:它是一次提交所用参数的不可变记录。是否允许对相同摘要和相同快照复用结果,属于业务缓存策略,不能为了"省算力"而默认把所有用户任务合并。
六、服务层实现:校验、归一化和生成可复现指纹
服务层收到的请求只能包含允许的字段。下面示例先验证输入资产,再用配置定义归一化参数,最后基于内容摘要、配置版本和规范 JSON 生成复现指纹。它不把原始 JSON 的字段顺序、无关空格或前端临时字段当成配置差异。
java
public record SubmitCommand(Long assetId, String presetCode, Map<String, Object> options) {}

@Service
public class ReproducibleJobService {

    @Transactional
    public String submit(SubmitCommand command) {
        InputAsset asset = assetRepository.requireAccepted(command.assetId());
        PresetDefinition definition = presetCatalog.require(command.presetCode());
        Map<String, Object> normalized = definition.normalizeAndValidate(command.options(), asset.mediaSummary());
        String canonicalJson = canonicalJsonWriter.write(normalized);
        String fingerprint = sha256(asset.getSha256() + "|" + definition.version() + "|" + canonicalJson);

        ConfigSnapshot snapshot = snapshotRepository.findOrCreate(
                definition.version(), definition.code(), canonicalJson, fingerprint);
        ToolJob job = ToolJob.queued(JobNo.next(), asset.getId(), snapshot.getId());
        jobRepository.insert(job);
        return job.getJobNo();
    }
}
这里的 normalizeAndValidate 是关键:它将 "1080P" 这类展示值转换为固定数值,将未传字段补为预设默认值,并拒绝 extraCommand 之类不属于配置定义的字段。复现指纹用于定位"相同输入和配置"的任务,不应代替用户提交幂等键;前者描述技术条件,后者描述一次用户意图。
七、预期输出与自动测试
提交成功后,任务查询应同时返回输入资产和配置快照的关键信息:
json
{
  "jobNo": "PT-20261007-002",
  "input": {"assetNo": "F-20261007-001", "displayName": "source.mp4", "sha256": "7f3a..."},
  "configuration": {"version": "media-preset-v3", "preset": "WEB_1080P", "maxHeight": 1080},
  "status": "QUEUED"
}
自动测试应覆盖"输入不能进队列"和"语义相同参数产生同一配置快照"两件事:
java
@Test
void rejectedAssetCannotCreateJob() {
    InputAsset asset = assetRepository.save(rejectedAsset());

    assertThatThrownBy(() -> service.submit(new SubmitCommand(asset.getId(), "WEB_1080P", Map.of())))
            .hasMessage("INPUT_NOT_ACCEPTED");
}

@Test
void equivalentOptionsShareTheSameConfigFingerprint() {
    String first = service.submit(commandWith(Map.of("height", "1080P")));
    String second = service.submit(commandWith(Map.of("height", 1080)));

    assertThat(jobRepository.findByNo(first).getConfigSnapshotId())
            .isEqualTo(jobRepository.findByNo(second).getConfigSnapshotId());
}
还应补一条版本回归测试:配置目录更新到 media-preset-v4 后,历史 v3 任务的查询和重跑计划仍读取其已保存 JSON,不从当前目录重新取默认值。
八、SQL 验证:如何发现覆盖、漂移和脏数据
以下查询可以在上线后检查最常见的数据质量问题:执行任务引用了被拒绝输入、配置快照缺失、同一摘要却指向不一致的对象键。
sql
-- 预期结果:0 行。可执行任务必须只引用已接受的输入资产。
SELECT j.job_no, a.validation_status
FROM tool_job j
JOIN input_asset a ON a.id = j.input_asset_id
WHERE j.status IN ('QUEUED', 'RUNNING', 'READY')
  AND a.validation_status <> 'ACCEPTED';

-- 预期结果:0 行。每个任务都必须关联一份不可变配置快照。
SELECT j.job_no
FROM tool_job j
LEFT JOIN tool_config_snapshot c ON c.id = j.config_snapshot_id
WHERE c.id IS NULL;

-- 预期结果:0 组。相同内容摘要不应被登记成多个稳定对象键。
SELECT sha256, COUNT(DISTINCT object_key) AS object_keys
FROM input_asset
GROUP BY sha256
HAVING COUNT(DISTINCT object_key) > 1;
第三条的前提是系统采用"按内容摘要归档"的存储策略;如果产品有意按租户或权限隔离对象键,应把隔离维度加入分组,而不是机械追求全局唯一。SQL 验证必须服从真实权限模型,不能因为去重优化而打破隔离边界。
九、异常边界与上线验收
| 场景 | 系统应做什么 | 不应做什么 |
|---|---|---|
| 同名文件再次上传 | 保存独立显示记录,使用摘要和对象键判断内容关系 | 直接覆盖旧对象 |
| 探测失败或无视频流 | 标记输入被拒绝,返回可理解的失败原因 | 创建 QUEUED 任务让 Worker 再试 |
| 用户提交未知参数 | 在服务层拒绝并记录字段名 | 拼接到 Worker 命令或悄悄忽略 |
| 当前预设升级 | 只影响新的提交;历史任务继续引用原快照 | 将旧任务的配置静默改为新默认值 |
| 同内容再次处理 | 根据业务策略决定复用、复跑或提示 | 因为摘要相同而越权暴露别人的产物 |
上线验收可准备三份脱敏文件:两个同名但内容不同的文件、两次内容相同但展示名不同的上传。再使用语义相同的两种参数表达提交任务,并在配置升级后查询第一批任务。预期是:不同内容得到不同资产;相同内容可被系统识别;语义相同参数归一化为同一快照;历史任务的版本和参数保持不变。
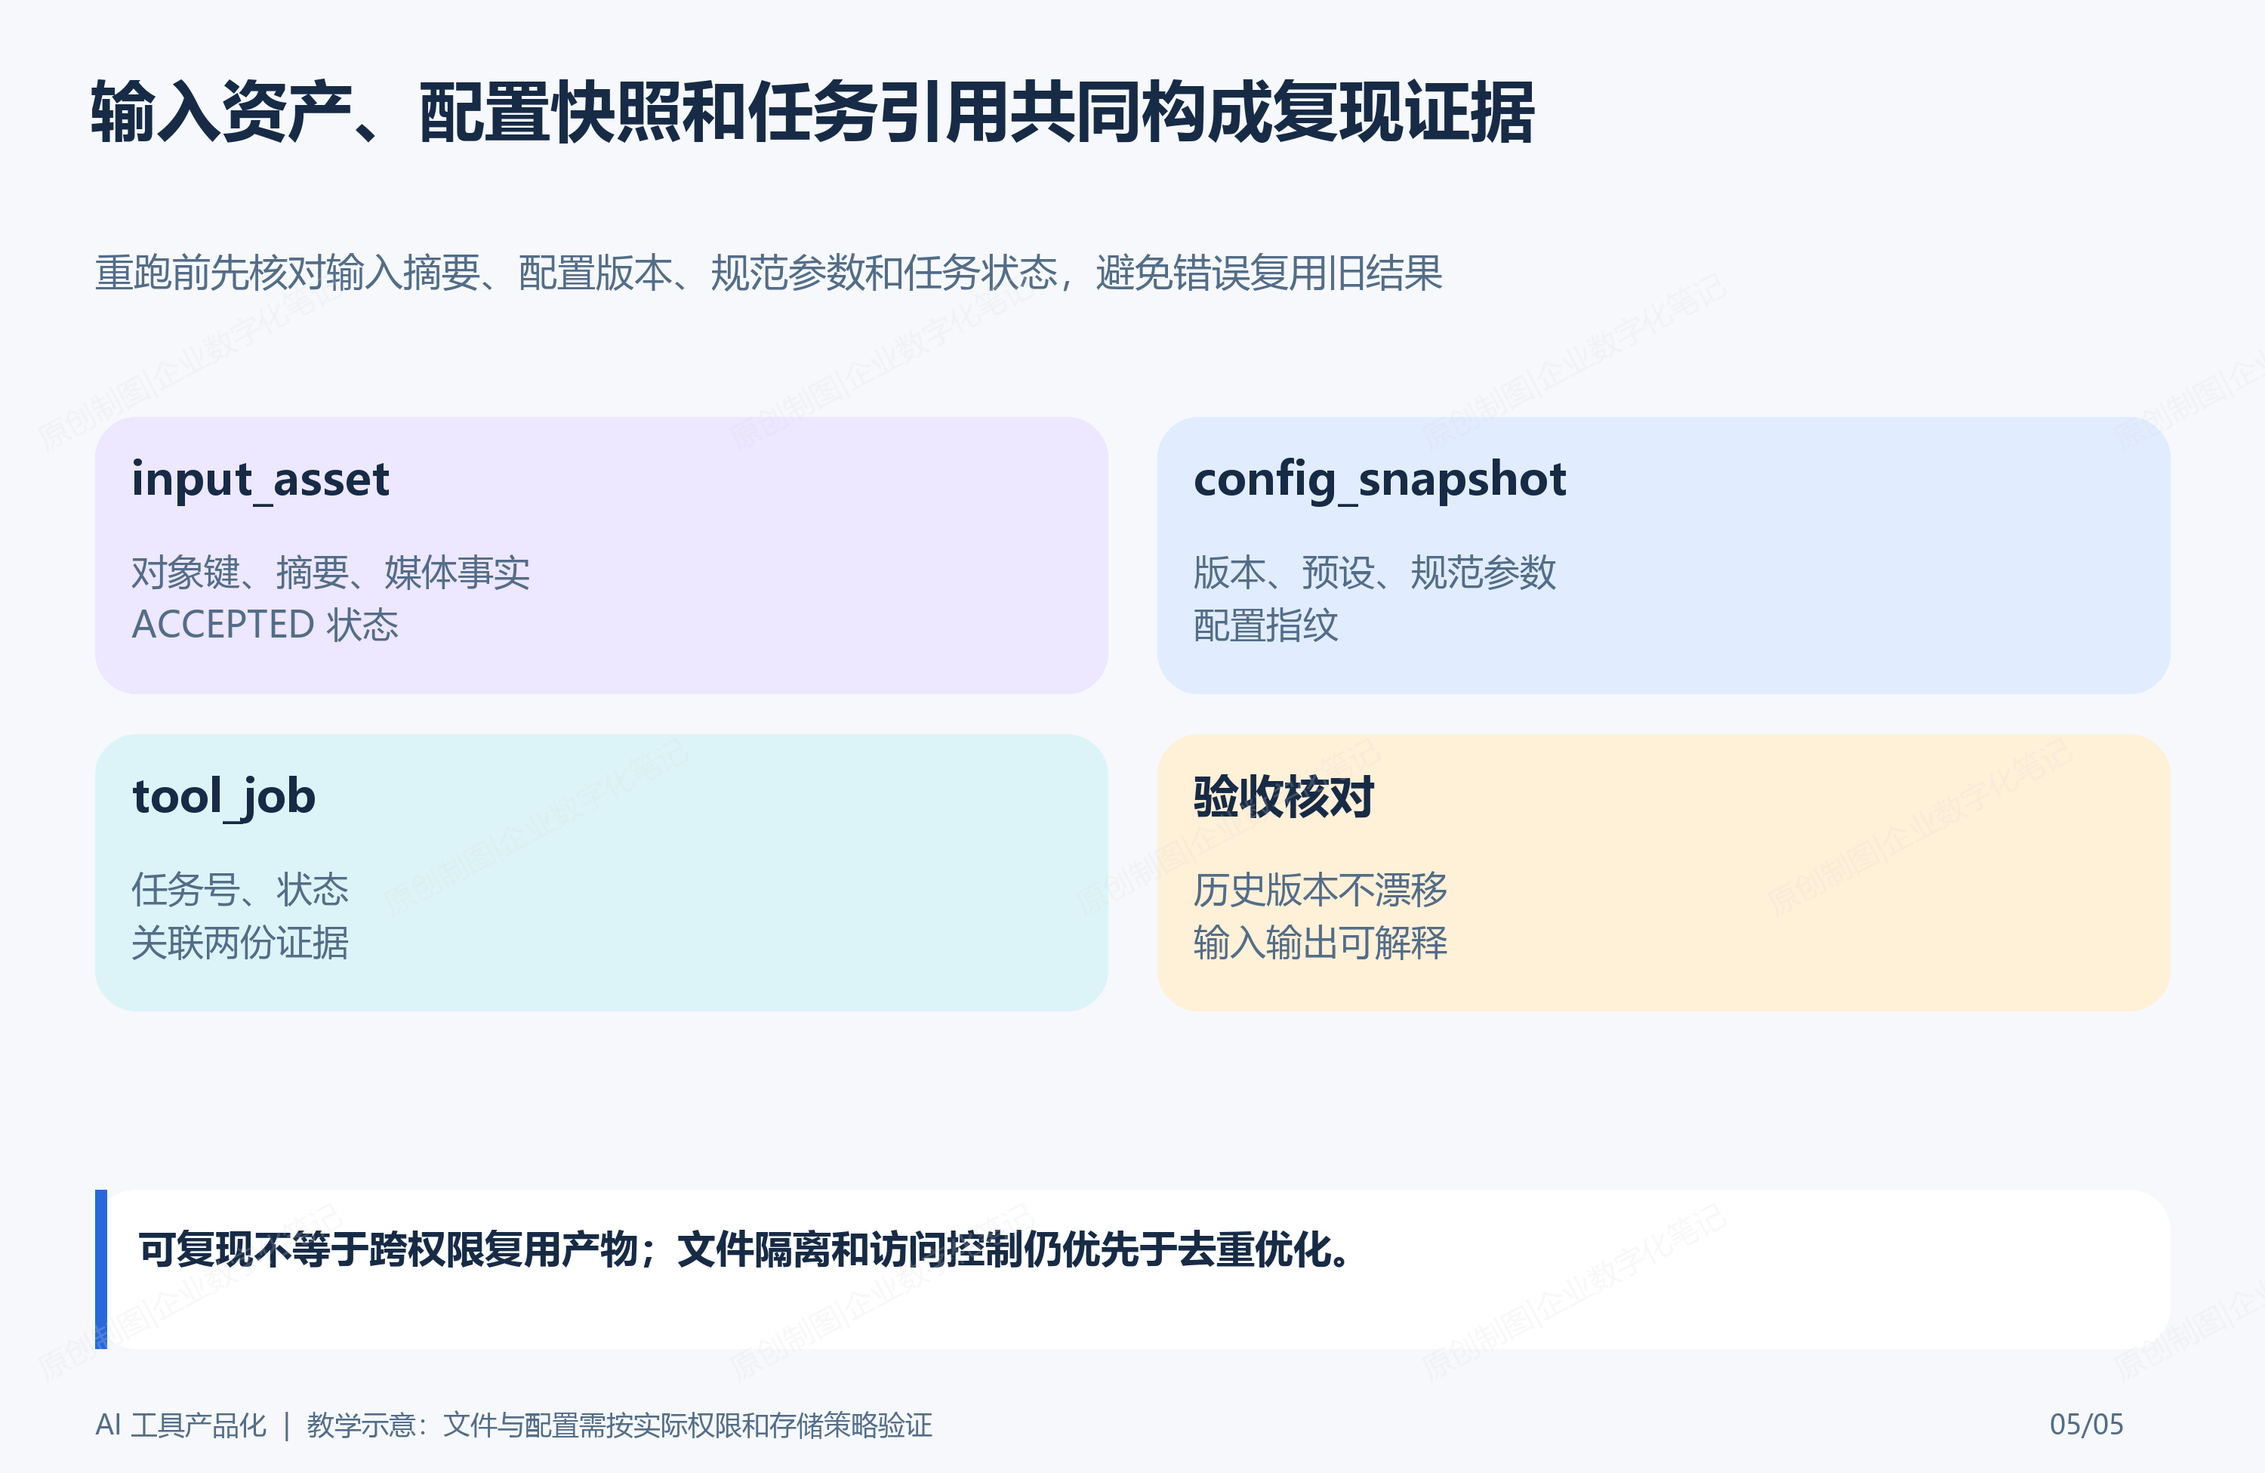
图5:能解释"当时用了什么"的任务,才具备可信的重跑和验收基础。
十、小结和延伸阅读
文件管理不是给上传接口加一个目录,参数管理也不是把请求 JSON 存下来。产品化的核心是将可变的文件名、页面默认值和用户输入,转换为稳定的输入资产、规范配置和版本化快照。这样任务失败时能定位原因,任务重跑时有明确依据,配置升级也不会改写历史。
下一篇将讨论长时间任务的队列、进度、取消和状态反馈:当输入与配置已经可追溯后,如何让用户看懂任务到底在等待、执行、失败还是可以下载。
参考资料: