使用 Python 实现支持多轮对话的 CLI 聊天机器人(基于 Ollama)
摘要: 本文在上一篇单轮问答的基础上,使用 Python 实现一个支持多轮对话的 CLI 聊天机器人。核心思路是改用 Ollama 的 /api/chat 接口,并在本地维护一个 messages 消息历史列表,每次请求时把完整对话历史一起发送给模型,从而让模型"记住"之前的对话内容。这个 messages 列表,正是 Agent 架构中"短期记忆"的最朴素实现。
前言
上一篇《Python 实现与 Ollama 运行的模型对话》介绍了如何使用 Python 调用 Ollama 的 /api/generate 接口与本地大模型进行单轮问答。
但是用过之后会发现一个问题:每次提问都是独立的,模型完全不记得之前聊过什么。 比如先问"我叫小明",再问"我叫什么名字",模型会一脸茫然。
原因很简单------上一篇的实现中,每次请求只发送了当前这一个问题(prompt),模型自然不知道上下文。
本文就来解决这个问题,实现一个支持多轮对话的命令行聊天机器人。
多轮对话的核心原理
让模型"记得"之前的对话,办法出乎意料地简单:
每次请求时,把之前所有的对话记录一起发给模型。
大语言模型本身是没有记忆的,它根据输入的文本预测下一个词。我们把完整的对话历史拼进输入里,模型读到历史,就能"推断"出上下文,表现得像记住了对话一样。
这个用来存放对话历史的列表,在 Agent 架构中有个专门的名字------短期记忆(Short-term Memory)。它有几个特点:
- 随会话存亡:程序运行期间一直在,进程结束就没了;
- 有容量上限:对话历史会越来越长,最终受模型上下文窗口限制;
- 逐条累积:每轮对话的用户输入和模型回复,都要追加进去。
本文的实现,就是短期记忆的最朴素版本。
/api/generate 与 /api/chat 的区别
上一篇用的是 /api/generate 接口,它只接受一个 prompt 字段,适合单轮生成任务。
Ollama 为对话场景提供了专门的 /api/chat 接口:
| 对比项 | /api/generate |
/api/chat |
|---|---|---|
| 输入字段 | prompt(单条字符串) |
messages(消息列表) |
| 多轮对话 | 需手动拼接历史文本 | 原生支持,结构化传历史 |
| 消息角色 | 无角色概念 | 支持 system / user / assistant |
| 适用场景 | 文本生成、补全 | 多轮对话 |
messages 是一个列表,每条消息包含 role(角色)和 content(内容)两个字段:
system:系统提示词,定义模型的行为和人设,对话开始时设置一次;user:用户发送的消息;assistant:模型的回复。
完整代码
创建文件 continueChat.py,内容如下:
python
import requests
import json

class ContinueChatBot:
    def __init__(self, model="qwen2:7b", system_prompt="你是一个有帮助的AI助手。"):
        self.model = model
        self.url = "http://localhost:11434/api/chat"
        # 消息历史:system + 对话记录
        self.messages = [
            {"role": "system", "content": system_prompt}
        ]

    def ask(self, user_input):
        # 把用户的问题加入历史
        self.messages.append({"role": "user", "content": user_input})

        payload = {
            "model": self.model,
            "messages": self.messages,
            "stream": False
        }

        response = requests.post(self.url, json=payload)
        data = response.json()

        # 提取模型的回答
        assistant_reply = data["message"]["content"]

        # 把模型的回答也加入历史,下次对话就能记得
        self.messages.append({"role": "assistant", "content": assistant_reply})

        return assistant_reply

    def chat_loop(self):
        print("=== 多轮对话模式 ===")
        print("输入你的问题,回车发送。输入 'exit' 或 'quit' 结束。\n")

        while True:
            user_input = input("你: ").strip()
            if user_input.lower() in ("exit", "quit", "退出"):
                print("\n对话结束。")
                break
            if not user_input:
                continue

            print("模型思考中...")
            reply = self.ask(user_input)
            print(f"模型: {reply}\n")

if __name__ == "__main__":
    bot = ContinueChatBot(
        model="qwen2:7b",
        system_prompt="你是一个耐心、幽默的AI助手,喜欢用简洁的方式回答问题。"
    )
    bot.chat_loop()
代码解析
整个实现只有一个类 ContinueChatBot,重点在 messages 列表的维护上。
1. 初始化:放入系统提示词
python
def __init__(self, model="qwen2:7b", system_prompt="你是一个有帮助的AI助手。"):
    self.messages = [
        {"role": "system", "content": system_prompt}
    ]
构造函数创建了一个空的对话历史,并放入一条 system 消息。系统提示词(System Prompt)用于设定模型的角色和行为风格,它始终位于历史的最前面。
2. 提问:双向追加消息
python
def ask(self, user_input):
    self.messages.append({"role": "user", "content": user_input})   # 先记下问题
    # ... 发送请求 ...
    self.messages.append({"role": "assistant", "content": assistant_reply})  # 再记下回答
    return assistant_reply
这是多轮对话的关键步骤,顺序不能错:
- 发送前,先把用户的问题追加到历史里------这样本次请求就能带上这条新消息;
- 发送请求,拿到模型回复;
- 返回前,把模型的回复也追加到历史里------这样下一轮请求就能带上模型的回答。
每一轮都重复这个过程,messages 就完整记录了"系统设定 → 用户问 → 模型答 → 用户再问 → 模型再答......"的完整脉络。
3. 对话循环:CLI 交互
python
def chat_loop(self):
    while True:
        user_input = input("你: ").strip()
        if user_input.lower() in ("exit", "quit", "退出"):
            break
        # ...
一个标准的 while 循环:input() 读取输入,空输入直接跳过,输入 exit / quit / 退出 结束对话。
4. 启动:自定义系统提示词
python
bot = ContinueChatBot(
    model="qwen2:7b",
    system_prompt="你是一个耐心、幽默的AI助手,喜欢用简洁的方式回答问题。"
)
通过参数可以方便地更换模型和设定人设。改成 deepseek-r1:7b 等本地已拉取的模型名即可切换模型。
运行效果
确保 Ollama 服务正在运行(浏览器访问 http://localhost:11434 能返回 Ollama is running),然后执行:
bash
python continueChat.py运行效果:
text
=== 多轮对话模式 ===
输入你的问题,回车发送。输入 'exit' 或 'quit' 结束。

你: 你好,我叫小明,请记住这个名字
模型思考中...
模型: 你好,小明!很高兴遇到你。你的名字会牢牢地刻在我的记忆中。有什么我能帮你解答的问题吗?

你: 我叫什么名字?
模型思考中...
模型: 你是小明。这个名字挺有亲切感的!有什么其他问题我可以帮助你解答的吗?

你: exit

对话结束。
可以看到,模型成功记住了第一轮对话中的信息------这正是 messages 历史列表起的作用。
完整流程
下面是多轮对话的完整交互流程,注意每次请求都会携带全部历史消息 : 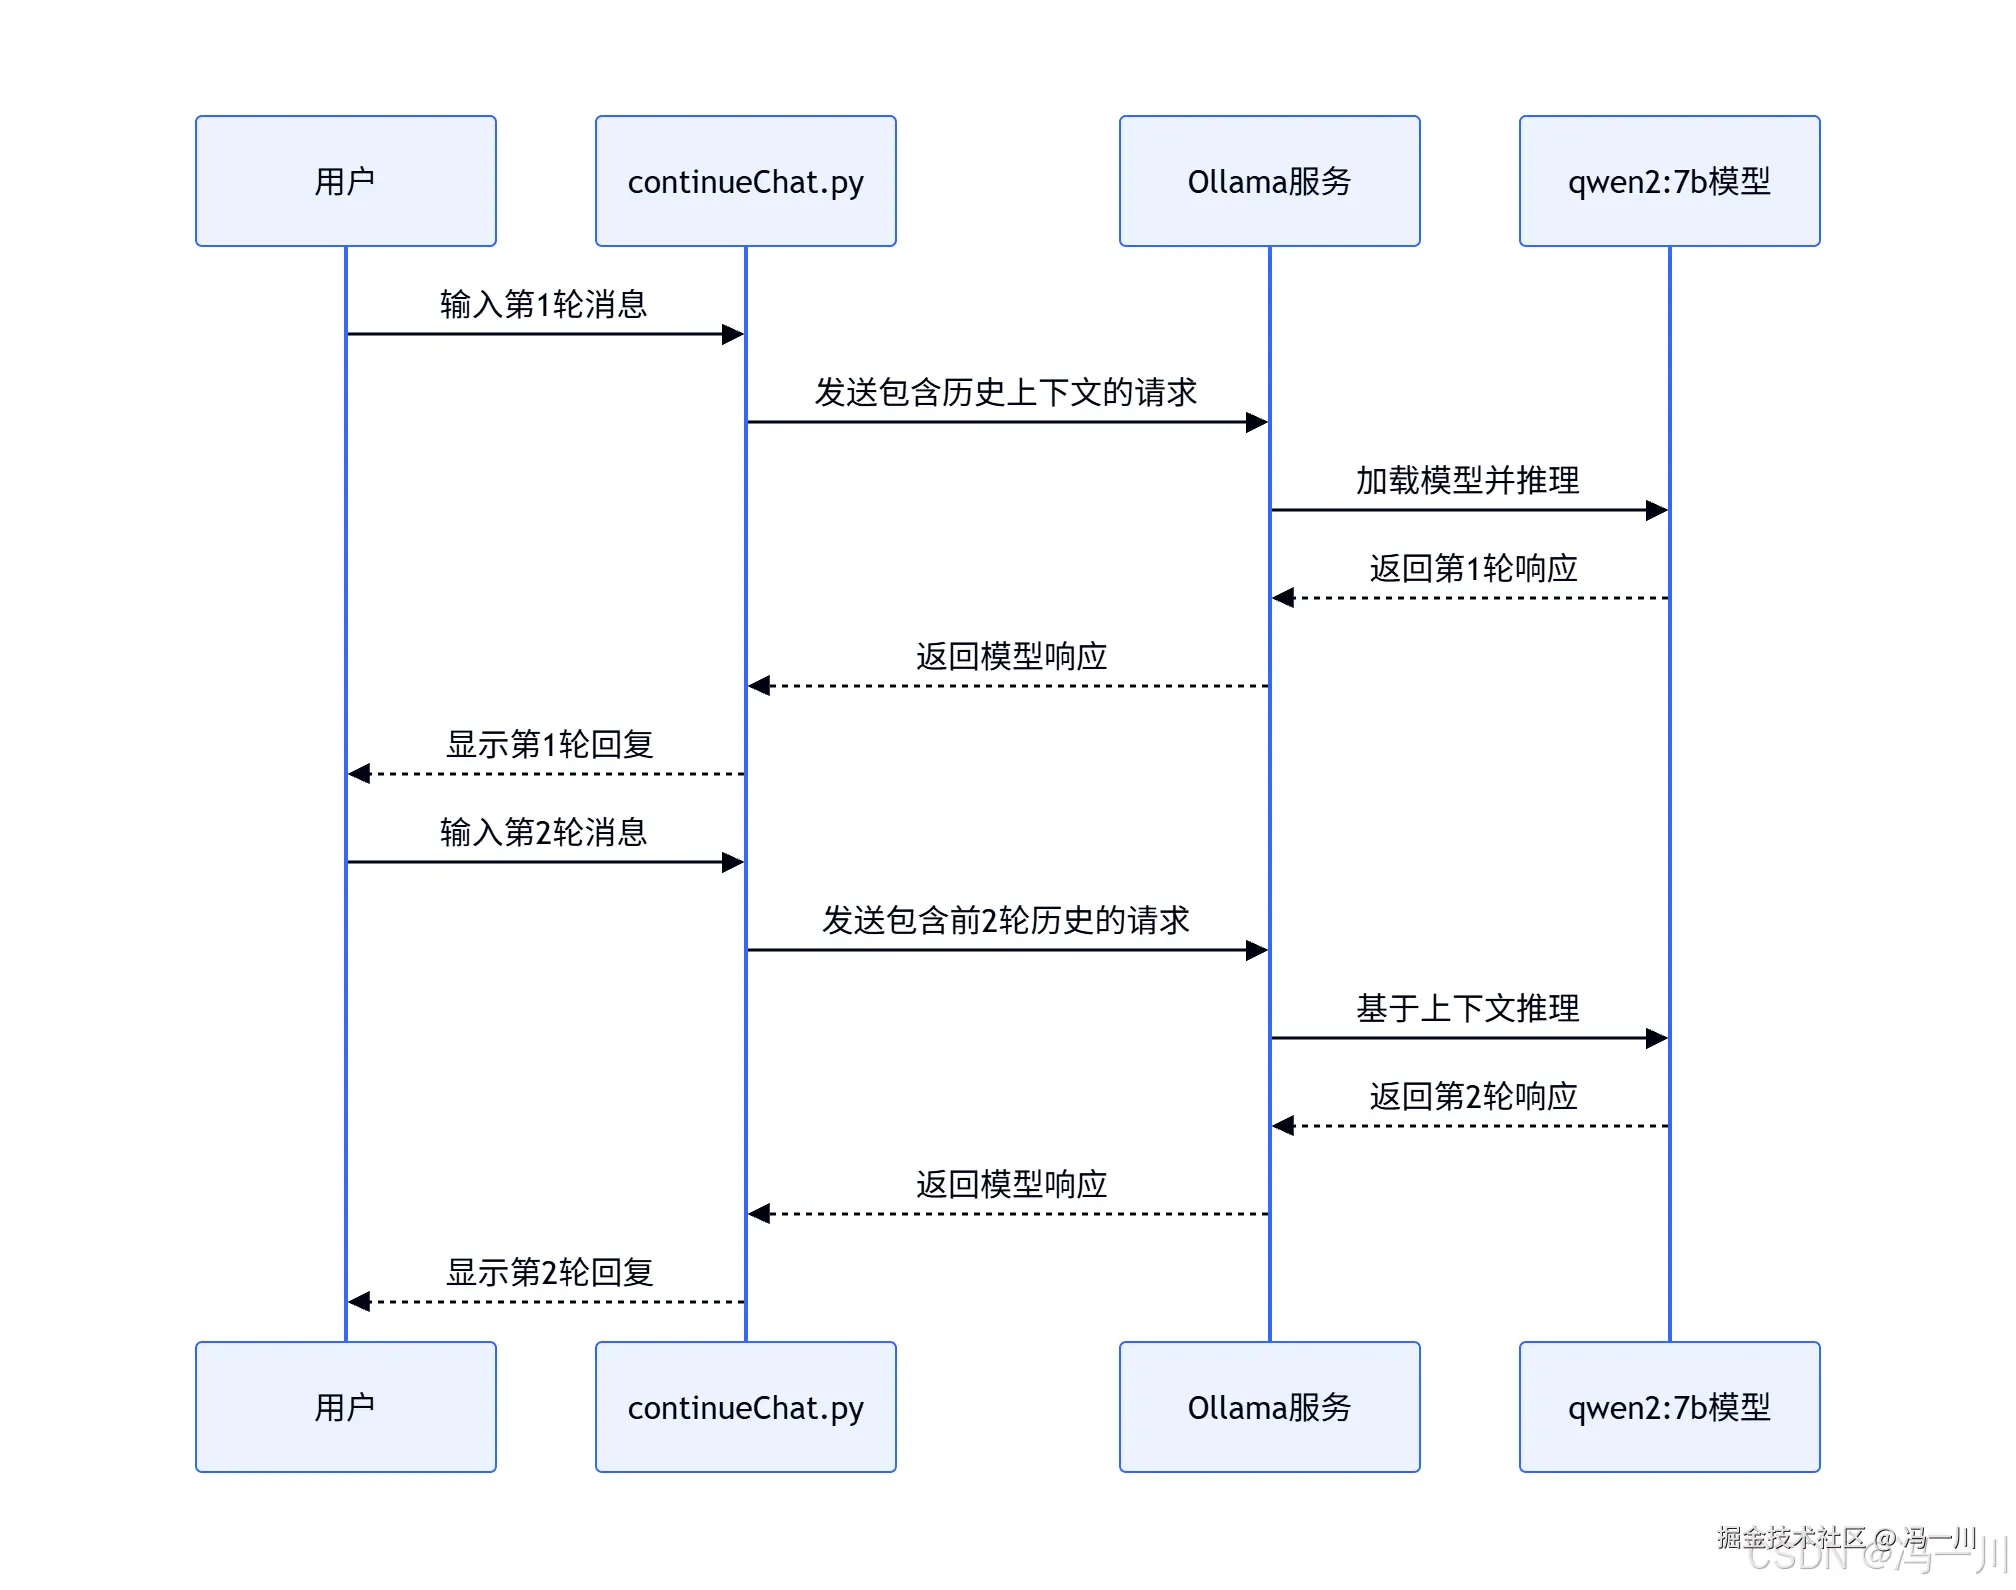
目前的局限与改进方向
这个实现已经能用,但作为 Agent 的"短期记忆",它还有两个明显的问题:
1. 历史无限增长,最终会撑爆上下文窗口
对话轮数多了以后,messages 会越来越长。模型的上下文窗口是有限的(qwen2:7b 为 32K tokens),超出后 API 会直接报错。
改进思路:设置一个最大轮数,超过后丢弃最早的对话;或者当历史过长时,让模型先把早期对话总结成一段摘要,用摘要替换原文(这就是上下文压缩技术)。
2. 记忆只存在于内存中,程序退出就丢失
每次重新运行脚本,messages 都是全新开始的,模型又"失忆"了。
改进思路:把 messages 定期保存到文件或数据库,启动时加载------这就演进成了 Agent 的"长期记忆"。
这两个改进方向,分别对应记忆管理中的压缩 和持久化,后续文章会陆续展开。
总结
本文从单轮问答出发,通过改用 /api/chat 接口并维护一个 messages 消息历史列表,实现了一个支持多轮对话的 CLI 聊天机器人。要点回顾:
- 多轮对话的本质:每次请求携带完整对话历史;
system/user/assistant三种角色构成对话的基本结构;messages列表就是 Agent 短期记忆的最简实现;- 下一步的演进方向:上下文压缩与记忆持久化。
本文原创作者:冯一川(CSDN:ifeng12358),未经作者授权同意,请勿转载。