ThreadLocal 每次 get 都要算哈希、定位槽位并可能线性探测,冲突越多越慢;FastThreadLocal 用全局自增下标 + 连续数组,把存取压成一步直达的 O(1)。但快路径只认 FastThreadLocalThread,普通线程会退化成更慢的 slowGet。
为什么说它在绕弯路?JDK 为了给你的变量找个存放位置,要先算哈希、再定位,冲突了还得顺着数组往后逐个试。一次两次无所谓,可在高并发框架里,每个请求都要反复 set/get 几十次,这点绕路成本就被放大成了实打实的耗时。
于是有人选择重新实现了一遍:位置提前分配好,取的时候直接拿,连"算位置"这一步都省了。这个框架就是 Netty,重做后得到的东西叫 FastThreadLocal。但这引出一个更根本的问题------既然已经有了 ThreadLocal,为什么还需要一个带 Fast 的版本?这篇文章只回答这一个问题:我们到底为什么需要它,以及同样重要的------什么时候其实并不需要。
观点:FastThreadLocal 不是来"替代" ThreadLocal 的。ThreadLocal 是 JDK 标准库,通用、稳健,绝大多数业务代码用它就够了;FastThreadLocal 的出现,是因为在"少量线程、极高吞吐、线程私有状态被疯狂读写"的场景里(典型如 Netty 的 EventLoop),ThreadLocal 每次存取都要"算哈希 + 定位 + 可能探测"的那点隐性开销,被放大到值得专门消除 。它不是更好,只是更专:用"放弃通用性(只认自家线程)"换来了"极致的 O(1)"。带着这个视角看下文,你就不会再去纠结"要不要把项目里所有 ThreadLocal 都换成它"------这正是"为什么需要它"这个问题的正确打开方式。
前提:ThreadLocal 解决的是"同一个变量在不同线程里有各自独立副本"的问题,这件事 JDK 和 Netty 都做,能力完全一样。区别只在存取这条路径的效率------也就是你每次 get/set 时底层发生了什么。下面所有对比都只在这个层面展开,不扯"谁功能更强"。
一、ThreadLocal 到底慢在哪
每个 Thread 对象里都藏着一个 threadLocals 字段,类型是一个叫 ThreadLocalMap 的哈希表。注意,它不是 HashMap,而是一个专门为 ThreadLocal 定制的开放寻址哈希表:把数组当桶,冲突了就顺着数组往后找下一个空位(线性探测)。
每次调用 get,至少都要经历下面这几步:
java
// JDK ThreadLocalMap 的核心:算哈希 -> 定位槽位 -> 可能线性探测
private Entry getEntry(ThreadLocal<?> key) {
    // 用斐波那契散列算出的 hash 码,对表长取模定位初始槽位
    int i = key.threadLocalHashCode & (table.length - 1);
    Entry e = table[i];
    if (e != null && e.get() == key) {
        return e; // 一次命中,最好情况
    }
    // 否则往后逐个槽位探测,直到找到或遇到空槽
    return getEntryAfterMiss(key, i, e);
}问题在于:这个哈希表会发生冲突。你在一个线程里用的 ThreadLocal 越多,槽位就越挤,某次 get 就越可能要经过好几次探测才找到。理想情况是 O(1),最坏会退化到接近 O(n)。而且哈希计算、取模、探测这几步每次都跑,没法省。
还有一个老生常谈的问题:Entry 的 key(那个 ThreadLocal 对象)是弱引用,value 是强引用。如果你用完不调用 remove,key 被 GC 收掉后 value 还挂着,就成了泄漏。JDK 只能在后续的 get/set 里顺手清理无效槽位,前提是你还得再去访问它------不访问,它就一直挂着。
**一句话总结 JDK 的代价:**每次存取都要"算哈希 + 定位 + 可能探测",并且泄漏得靠你自己记着 remove 来防。这两点恰恰是 Netty 下手的地方,也是这篇文章要回答"为什么还需要更快"的靶子。
二、FastThreadLocal 是怎么优化的
Netty 的思路特别朴素:既然哈希表和线性探测是慢的根源,那就别用哈希表了,直接用数组。每个 FastThreadLocal 在创建时,去一个全局计数器领一个下标;每个线程持有一个数组,get 就直接按下标取,set 就直接按下标存。
java
// 1) 每个 FastThreadLocal 领一个全局自增的下标
public FastThreadLocal() {
    index = InternalThreadLocalMap.nextVariableIndex();
}
// 全局自增,AtomicInteger 保证并发安全
private static final AtomicInteger nextIndex = new AtomicInteger();
static final int nextVariableIndex() {
    return nextIndex.getAndIncrement();
}
// 2) 线程持有的不再是哈希表,而是一个普通 Object 数组
//    InternalThreadLocalMap 里:Object[] indexedVariables
// 3) get:直接按下标取,没有哈希、没有探测
public Object indexedVariable(int index) {
    Object[] lookup = indexedVariables;
    return index < lookup.length ? lookup[index] : UNSET;
}
看到区别了吗?JDK 的 get 是"先算出一个位置再去找",Netty 的 get 是"位置早就分配好了,直接拿"。这一步把复杂度从"可能要探测"压成了严格的 O(1)。而且数组是连续内存,对 CPU 缓存更友好,顺手还捞到了一点缓存命中的便宜------这恰恰是冲着上一节那个"靶子"去的:把"每次现算位置"彻底去掉。
set 同样直白------按下标写进去,下标超过数组长度就通过 Arrays.copyOf 扩容,没有"先算槽位再探测"那一套。
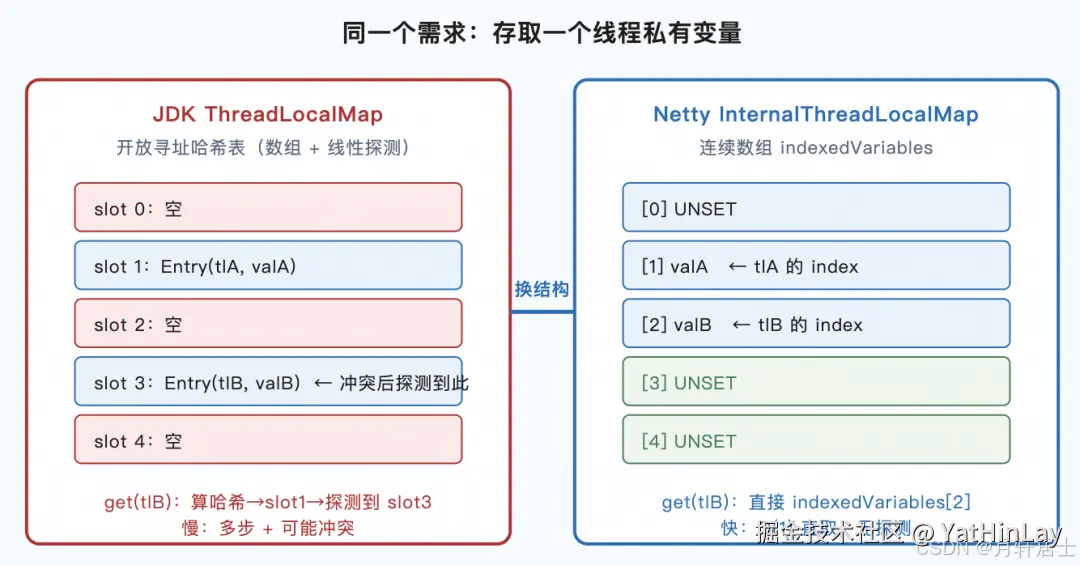
上图中,左侧是 JDK 的 ThreadLocalMap(开放寻址哈希表 + 线性探测):get(tlB) 要先算哈希,再从初始槽位逐步探测到 slot 3,步骤多、还可能因为冲突改变查找路径;右侧是 Netty 的 InternalThreadLocalMap(连续数组):get(tlB) 直接读取 indexedVariables2,O(1) 直达、没有探测。
为了更直观地看清两条路的差异,下面用一张表格把 JDK ThreadLocal 与 FastThreadLocal 在关键维度上做个对比:
| 对比维度 | JDK ThreadLocal | FastThreadLocal(Netty) |
|---|---|---|
| 数据结构 | ThreadLocalMap,开放寻址哈希表 | InternalThreadLocalMap,普通 Object 数组 |
| get 路径 | 算哈希 + 取模定位 + 可能线性探测 | 直接按下标读取 indexedVariablesindex,无探测 |
| set 路径 | 算哈希 + 定位槽位 + 冲突时探测 | 按下标写入,越界时 Arrays.copyOf 扩容 |
| 内存布局 | 哈希表,槽位可能稀疏、冲突时分散 | 连续数组,对 CPU 缓存更友好 |
| 线程要求 | 任意线程均可使用 | 快路径只认 FastThreadLocalThread,普通线程走 slowGet 退化 |
| 清理机制 | 依赖使用者手动调用 remove,否则可能泄漏 | FastThreadLocalRunnable 任务结束自动 removeAll 兜底 |
| 适用场景 | 通用业务代码,绝大多数场景 | Netty 生态、少量线程高频 get/set 线程私有状态 |
一句话概括:JDK ThreadLocal 胜在通用、不挑线程,代价是每次存取都要现算位置、还可能探测;FastThreadLocal 胜在固定下标一步直达、缓存友好,代价是快路径只认自家线程,用错线程反而更慢。这张表也正好呼应了后文要展开的结论------它不是替代品,而是特定场景下的专属优化。
三、同样一次 get,两条路的差别
上面的图展示的是"静态结构",下面这张图展示的则是"一次 get 的动态路径"。两者的目标相同------拿到当前线程里那个变量的值:
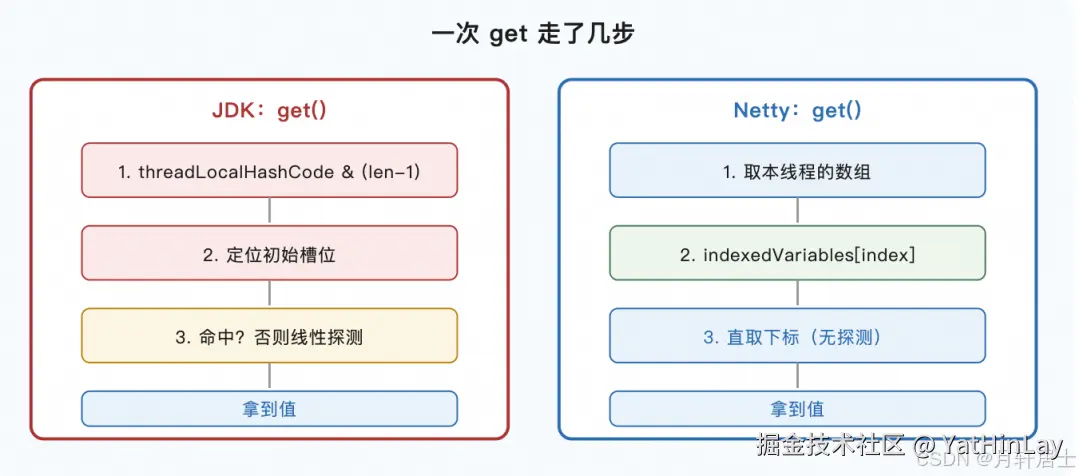
JDK 的 get:先用 threadLocalHashCode 定位初始槽位,命中则返回,否则继续线性探测再拿到值;Netty 的 get:先取当前线程的数组,再直接读取 indexedVariablesindex,无探测、一步拿到值。
**关键直觉:**JDK 是"每次来都现算位置",Netty 是"位置在出生时就已算好存着"。这就像 JDK 每次进图书馆都要按书名算个哈希再找书架,而 Netty 直接给你一个固定书架号。书越多,前者的找书成本越容易往上飘;后者永远一步到位。
四、它是 ThreadLocal 的"替代"吗
FastThreadLocal 不是 ThreadLocal 的"升级替代",它只是带条件的专属优化。如果你以为"把项目里所有 ThreadLocal 换成 FastThreadLocal 就能全体提速",那就要踩坑了。Netty 的快路径只发生在跑在 FastThreadLocalThread 上的时候 。它会判断当前线程是不是自家的:是,就直接拿那个数组;不是,就退化回去用 JDK 自己的 ThreadLocal 兜住。所以"为什么需要它"的第二个答案也清楚了:用错线程,不仅不快,反而更慢。
java
static InternalThreadLocalMap get() {
    Thread t = Thread.currentThread();
    if (t instanceof FastThreadLocalThread) {
        // 快路径:直接从自家线程拿数组
        return ((FastThreadLocalThread) t).threadLocalMap();
    }
    // 慢路径:当前线程不是 Netty 的,退化成 JDK ThreadLocal
    return slowGet();
}

// slowGet 其实就是拿一个 static 的 JDK ThreadLocal 兜着
private static InternalThreadLocalMap slowGet() {
    ThreadLocal<InternalThreadLocalMap> slow = UnpaddedInternalThreadLocalMap.slowThreadLocalMap;
    InternalThreadLocalMap ret = slow.get();
    if (ret == null) {
        ret = new InternalThreadLocalMap();
        slow.set(ret);
    }
    return ret;
}
这意味着:你在 Netty 的 EventLoop 线程(NioEventLoop 就是 FastThreadLocalThread)里用 FastThreadLocal,是真正在享受红利;但如果你在业务代码里 new 一个普通 Thread,或者丢进一个普通线程池里用,它就会走 slowGet,不仅不快,反而多一层对象包装的开销。Netty 自己把 EventLoop 线程都设成了 FastThreadLocalThread,所以内部用起来很顺;而你自己用的时候,得先确认好线程身份。
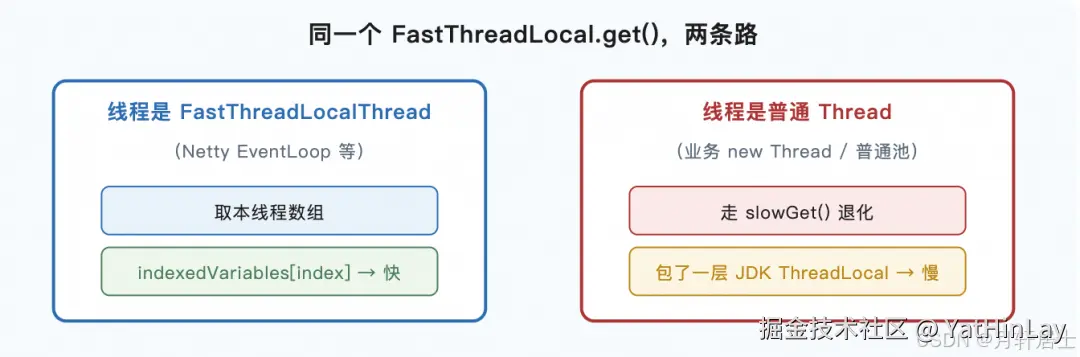
当线程是 FastThreadLocalThread(如 Netty EventLoop)时,直接取本线程数组的 indexedVariablesindex,走快路径;当线程是普通 Thread(业务里 new Thread 或普通线程池)时,走 slowGet() 退化路径,多包一层 JDK ThreadLocal,反而更慢。
五、除了快,它弥补了 JDK 的一处痛点
前面说过,JDK 的 ThreadLocal 有弱引用导致的泄漏隐患,得靠你自己记得调用 remove。Netty 并没有根治这个问题(它的数组里 value 同样是强引用),但它在机制上帮你兜底了一层:当你把一个 Runnable 交给 FastThreadLocalThread 执行时,它会被包装成 FastThreadLocalRunnable,任务跑完后在 finally 里自动调用 removeAll(),把所有 FastThreadLocal 复位成 UNSET。
java
// 包了一层,任务结束自动清理
final class FastThreadLocalRunnable implements Runnable {
    private final Runnable runnable;
    public void run() {
        try {
            runnable.run();
        } finally {
            FastThreadLocal.removeAll();
            // 把本线程所有 FastThreadLocal 复位
        }
    }
}
**诚实地说:**这解决的是"忘 remove 导致泄漏"的痛点,不是"能跨线程传值"------ThreadLocal 天生不跨线程,FastThreadLocal 也一样。别指望用它在线程间搬数据,那是 InheritableThreadLocal / TransmittableThreadLocal 的事。
六、实战:在 Netty 中正确使用 FastThreadLocal
在 Netty 中使用 FastThreadLocal 的典型姿势,是在 ChannelHandler 里定义一个静态的 FastThreadLocal,然后在请求读写回调中完成 set、get 和清理。下面以 ChannelInboundHandlerAdapter 为例,演示一个请求 TraceId 的存取过程:
java
import io.netty.channel.ChannelHandlerContext;
import io.netty.channel.ChannelInboundHandlerAdapter;
import io.netty.util.concurrent.FastThreadLocal;

public class TraceIdHandler extends ChannelInboundHandlerAdapter {

    // 定义线程私有状态:每个 EventLoop 线程只会看到属于自己的 traceId
    // 注意:这里用的是 Netty 的 FastThreadLocal,不是 JDK 的 ThreadLocal
    private static final FastThreadLocal<String> TRACE_ID = new FastThreadLocal<String>() {
        @Override
        protected String initialValue() {
            return "UNKNOWN";
        }
    };

    @Override
    public void channelRead(ChannelHandlerContext ctx, Object msg) throws Exception {
        // 1. set:在读取请求的入口处写入当前请求的 traceId。
        // 此时当前回调一定运行在 Netty 的 EventLoop 线程上,而这类线程会被 Netty
        // 创建为 FastThreadLocalThread,因此下面的 get/set 都会命中快路径:
        // 直接读取本线程 InternalThreadLocalMap 中的 indexedVariables,按下标访问,
        // 不需要像 JDK ThreadLocal 那样做哈希计算、取模和线性探测。
        TRACE_ID.set("trace-" + ctx.channel().id().asShortText());

        try {
            // 2. get:业务处理过程中随时读取,仍然发生在同一个 EventLoop 线程内,
            // 不会存在跨线程串值的问题。
            String traceId = TRACE_ID.get();
            System.out.println("handle message with traceId: " + traceId);

            // 继续向下一个 Handler 传递消息,当前线程私有状态保持一致。
            ctx.fireChannelRead(msg);
        } finally {
            // 3. removeAll:任务结束前统一清理当前线程上的所有 FastThreadLocal。
            // 这里不能只依赖 Netty 的兜底清理,显式调用可以避免线程复用后残留上一轮数据。
            FastThreadLocal.removeAll();

            // 如果当前 Handler 只使用 TRACE_ID 这一个变量,也可以单独清理:
            // TRACE_ID.remove();
        }
    }
}
这里的 set、get、removeAll 都发生在同一个 EventLoop 回调中。之所以能一直走快路径,是因为 Netty 为 EventLoop 创建的线程正是 FastThreadLocalThread:FastThreadLocal 每次访问前会先通过 Thread.currentThread() 判断线程类型,命中 FastThreadLocalThread 时直接拿线程内已经分配好的固定下标数组,跳过了 JDK ThreadLocal 的哈希计算、取模和探测步骤。也就是说,只有在 EventLoop 线程内使用 FastThreadLocal,才是它真正发挥价值的场景。
七、使用场景
这类 benchmark 高度依赖 JDK 版本、线程数、ThreadLocal 的数量和访问频率,网上能找到的对比数字彼此差得很远,照抄就是瞎编。能确定的是定性结论:它消除了哈希计算、取模和冲突探测这几步常数开销,并且数组连续内存对缓存更友好,所以"理论上更快"是稳的,收益在高频 get/set + 大量 ThreadLocal 共存的场景里最明显。
**别为"快"而快:**如果你的代码里就一个 ThreadLocal、一天也 set 不了几次,换成 FastThreadLocal 带来的收益基本测不出来,反而引入了"必须跑在 FastThreadLocalThread 上"的约束和对 Netty 的依赖。它值得用的信号很明确------你在写 Netty 相关代码,或在自己的高性能线程模型里高频存取线程私有状态。说到底,它从来不是要取代 ThreadLocal,只是给那个特定场景多一个更狠的选项。
该用 FastThreadLocal:
-
✓ Netty 生态内(ChannelHandler、Codec、EventLoop 任务)
-
✓ 同一个线程里高频 get/set 的线程私有状态
-
✓ 一个线程持有很多个 ThreadLocal,哈希冲突已能感知
-
✓ 你自己实现了 FastThreadLocalThread 的线程模型
不该用 FastThreadLocal:
-
✗ 普通业务代码、普通线程池里图个"快"
-
✗ 只为偶尔存一个用户上下文
-
✗ 想在线程之间传递数据(它不是干这个的)
-
✗ 项目根本没引入 Netty,仅为这一个类加依赖
八、为什么还需要 FastThreadLocal
已经有了 ThreadLocal,为什么还需要 FastThreadLocal?一句话:**不是因为 ThreadLocal 不好,而是因为在"少量线程、极高吞吐、线程私有状态被疯狂读写"的场景里,它每次存取都要"算哈希 + 定位 + 可能探测"的那点成本,被放大到了值得专门消除。**FastThreadLocal 做的唯一一件事,就是把存取路径从"哈希表 + 线性探测"换成"数组 + 固定下标",做到出生时分配、之后永远一步直达。它比 JDK 更省心的地方,是任务结束时自动 removeAll 兜底防泄漏;它比 JDK 更娇气的地方,是快路径只认 FastThreadLocalThread,认错线程就会退化。所以它从不打算取代谁。
所以结论很朴素:FastThreadLocal 是为 Netty 那种"少量线程、极高吞吐、线程私有状态频繁读写"的场景量身定制的优化------它不替代 ThreadLocal,只是补上了高频场景里那块短板。你在那个场景里,它就是真的 fast;你不在那个场景里,它顶多算一个更啰嗦、还挑线程的 ThreadLocal。