9 月 22 日,AgentBridge 在云栖大会 AI 实时数据智能论坛上正式发布。作为一站式 Agent 实时数据上下文服务,AgentBridge 连接企业分散的数据源,围绕业务任务组织实时事件、业务事实、历史信息和规则,为 Agent 提供可信、可追溯、持续更新的上下文,帮助企业将 Agent 应用于实际业务。
从一笔退单说起:Agent 落地的数据难题
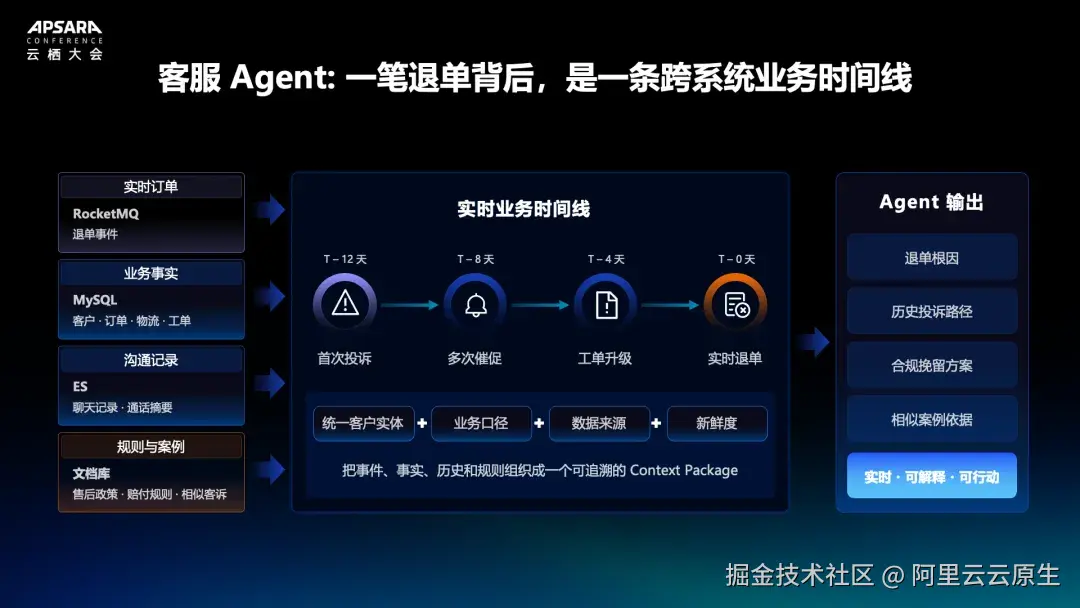
一笔退单刚刚发生,客服 Agent 需要回答:客户为什么退单?此前有没有投诉?按照当前的售后政策,还能采取什么挽留措施?
回答这些问题,需要查看消息队列里的退单事件,关联数据库中的订单、物流和历史工单,再从客服对话中还原沟通过程,找到适用的赔付规则和相似案例。任何一部分缺失,都可能影响最终判断。只看到订单状态,就容易忽略客户多次催促的经历;引用了旧版政策,给出的建议也可能不再适用。
AgentBridge:一站式 Agent 实时数据上下文服务
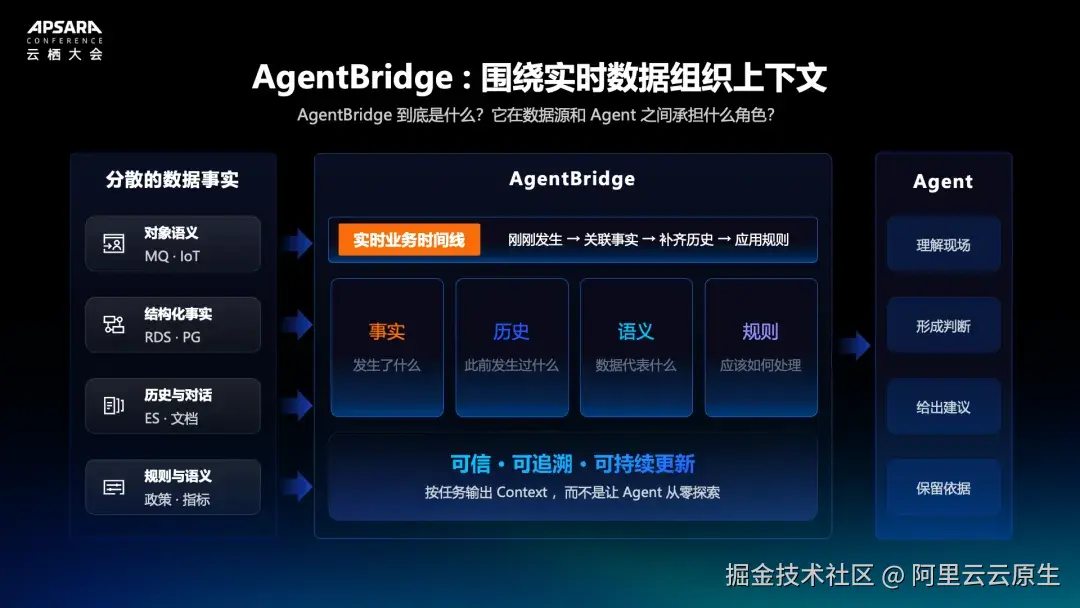
面向这类企业 Agent 场景,AgentBridge 全新发布。作为一站式 Agent 实时数据上下文服务,AgentBridge 连接企业分散的数据源,围绕业务任务组织实时事件、业务事实、历史信息和规则,为 Agent 提供可信、可追溯、持续更新的上下文,帮助企业将 Agent 应用于实际业务。
从原型到生产:落地的现实挑战
这样的需求同样出现在制造、物流和零售行业。产线温度异常,需要结合传感器数据、维保记录和安全规范判断处置方式;包裹异常滞留,需要联查追踪记录与分拣设备状态;商品库存触及安全线,则需要同时考虑销售变化、在途补货和供应商交期。业务持续变化,Agent 的判断依据也需要跟着更新。
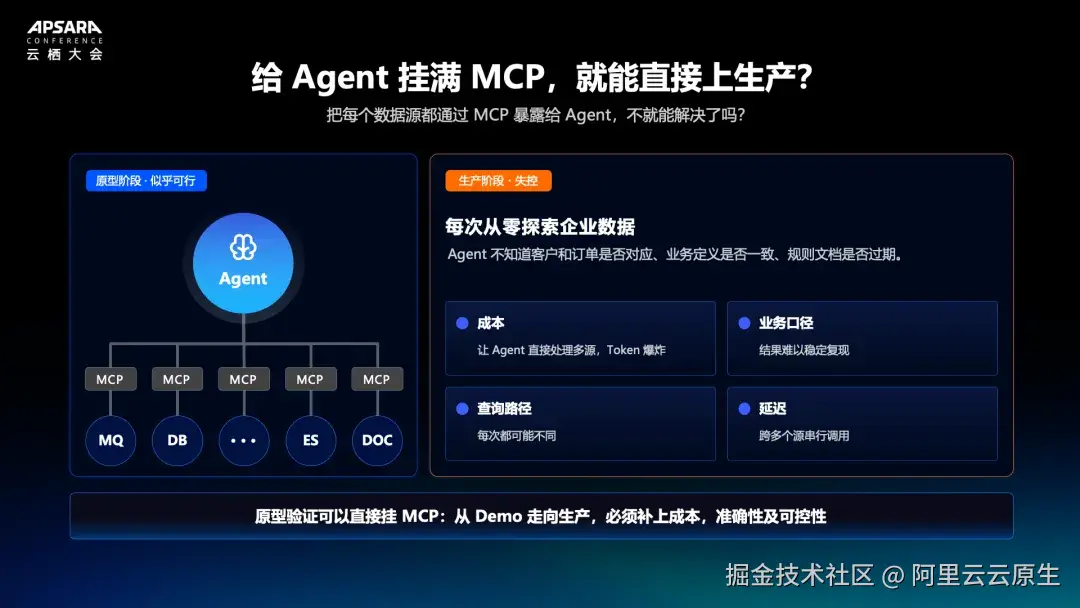
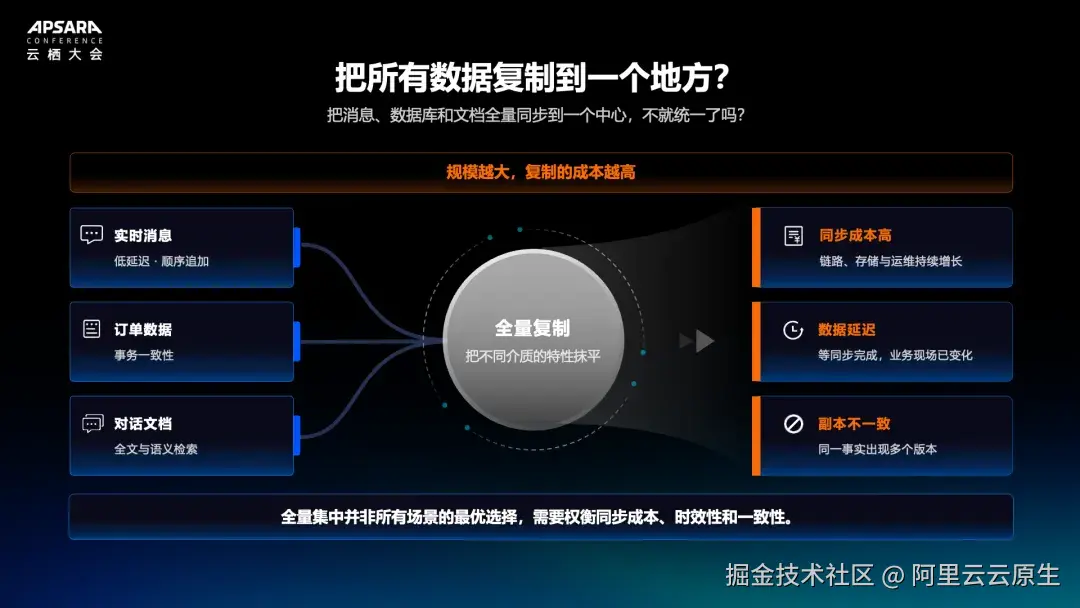
企业在原型阶段,可以通过多个 MCP 连接数据源,也可以将数据集中到一处,快速跑通业务流程。进入生产环境后,还需要解决跨系统对象如何关联、业务口径如何统一,以及查询延迟和调用成本如何控制。随着数据量增长,全量复制也会带来持续的同步、存储与运维开销。
AgentBridge 如何构建生产级上下文
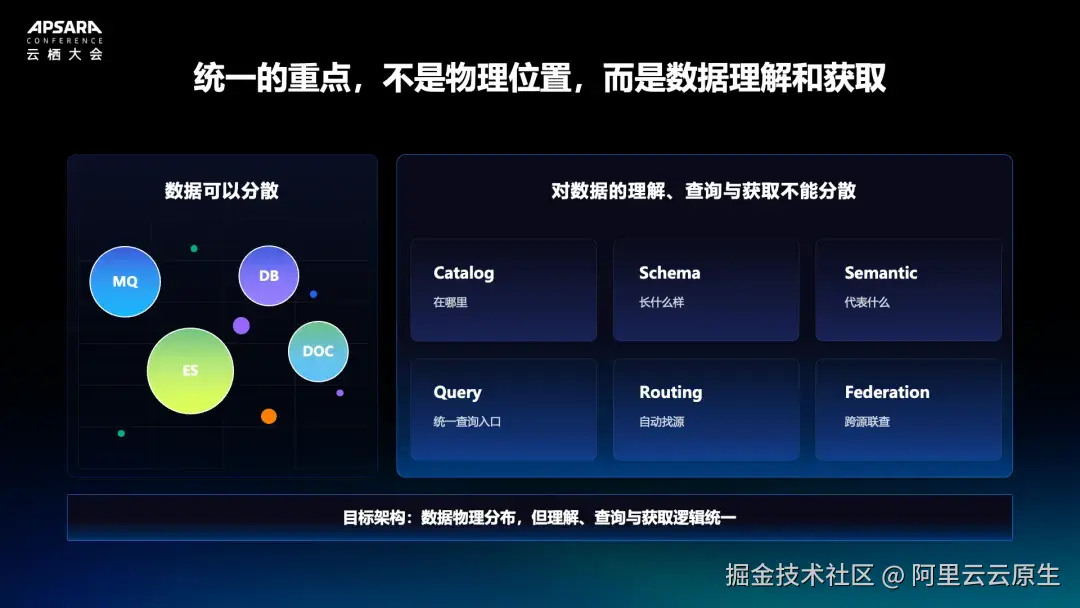
元数据统一:数据留在原处,理解保持一致
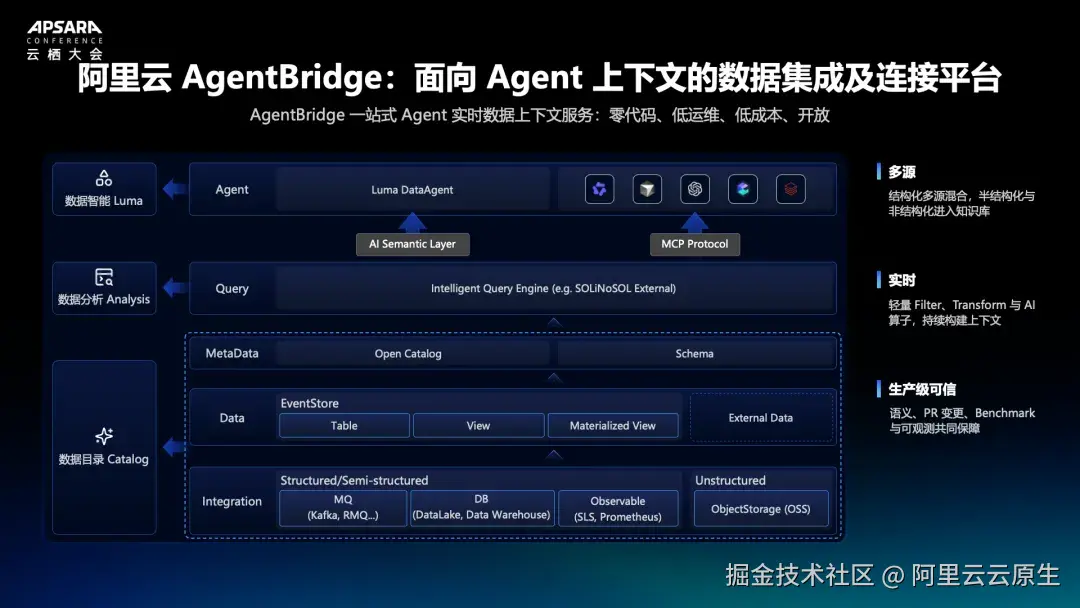
AgentBridge 采用元数据统一的方式:数据可以保留在适合自身特性的系统中,通过统一的数据目录、结构定义和业务语义,描述数据在哪里、如何组织、代表什么,再由查询入口完成数据源路由与跨源关联。企业能够沿用已有数据架构,为不同 Agent 提供一致的数据理解和使用方式。
实时接入:让刚发生的事件可被查询
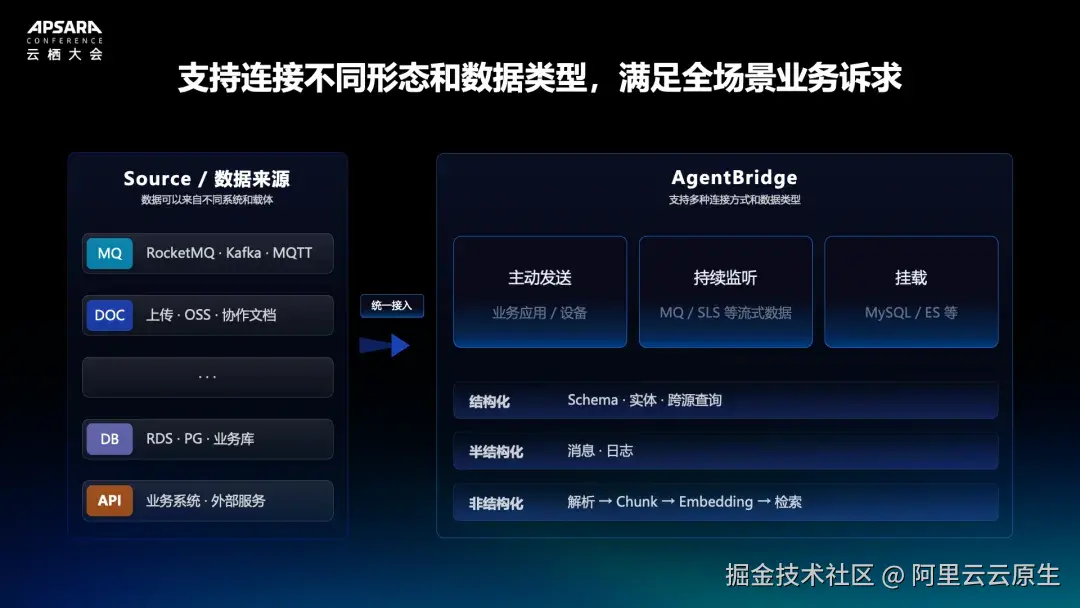
在接入层,AgentBridge 支持主动发送、持续监听和原位挂载三种连接方式,覆盖消息、数据库、日志、对象存储和协作文档等来源。结构化数据进入查询与关联路径,消息和日志保留其事件特征,非结构化文档则经过解析、分块和索引,形成可检索的知识。企业已确认的业务术语、指标定义和使用约定,也可以沉淀为可复用的语义资产。
对于 Kafka、RocketMQ 中持续产生的消息,AgentBridge 可将其持续写入并组织为可查询的 Event Table。Agent 可以通过实时 SQL 筛选事件、按时间窗口统计变化,并进一步关联数据库中的客户与订单信息,或对象存储中的历史日志。这样,刚刚发生的退单事件就能进入分析过程,与客户的业务记录共同构成判断依据。
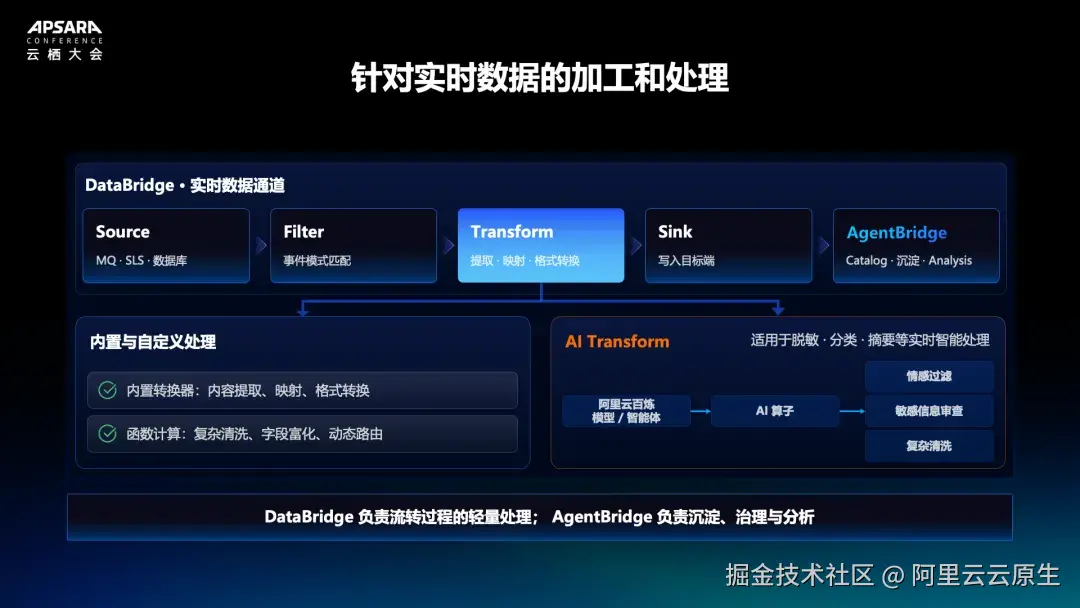
实时数据的接入还可以与 EventStreaming 配合。EventStreaming 在流转过程中完成事件过滤、字段映射和格式转换,也可结合函数计算或 AI Transform 进行自定义清洗、分类与摘要等处理。AgentBridge 接收处理结果,负责后续的数据沉淀、治理和查询分析。两者协同,让原始变化经过必要处理后进入 Agent 的上下文。
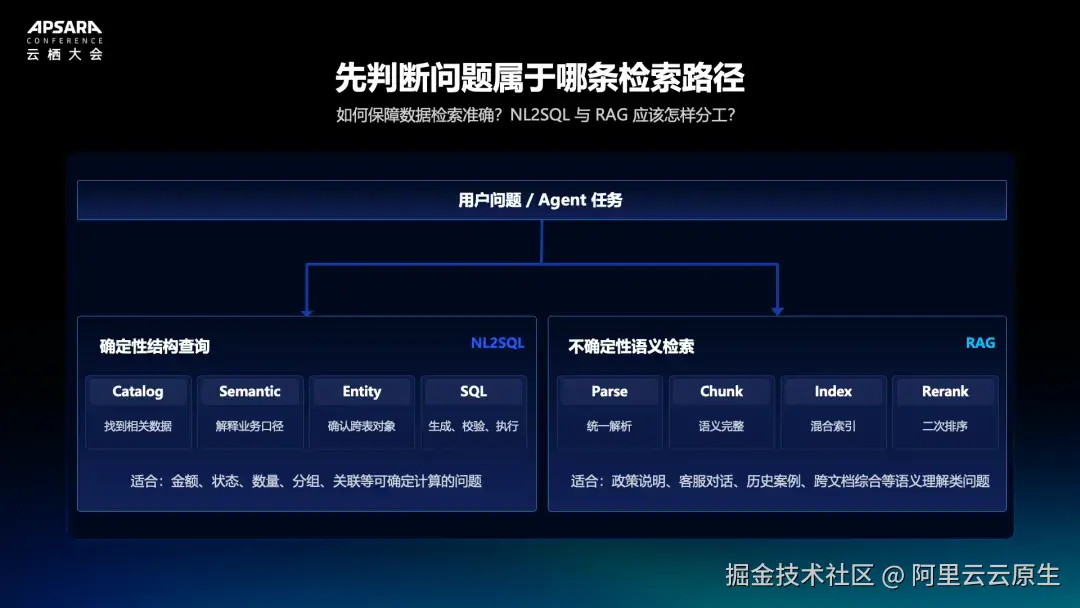
精准查询:SQL 与检索各司其职
数据及时到达之后,还需要采用适合问题的查询方式。订单金额、支付状态、工单数量等问题,需要依据结构化数据精确计算,适合通过自然语言生成 SQL 并执行。售后政策、客服对话和历史案例,则适合通过检索增强生成(RAG)找到相关内容。在退单场景中,两条路径共同提供事实与规则,支撑 Agent 形成完整的建议。
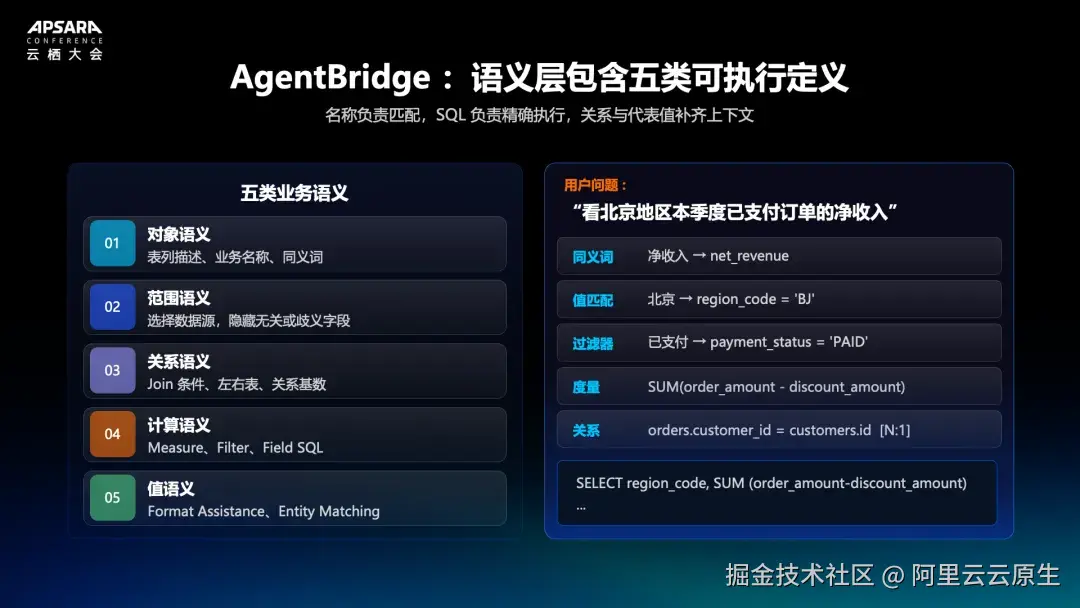
为了让 SQL 符合企业业务口径,AgentBridge 将语义层引入查询过程,管理表和字段的业务含义、可用数据范围、表间关联、计算公式,以及业务表达与实际存储值之间的映射。例如,"北京地区本季度已支付订单的净收入"这个问题,需要识别地区编码、支付状态和时间范围,还需要使用企业确认的净收入公式与关联关系。这些定义为 SQL 生成提供明确依据。
知识管理:可检索、可溯源、可核查
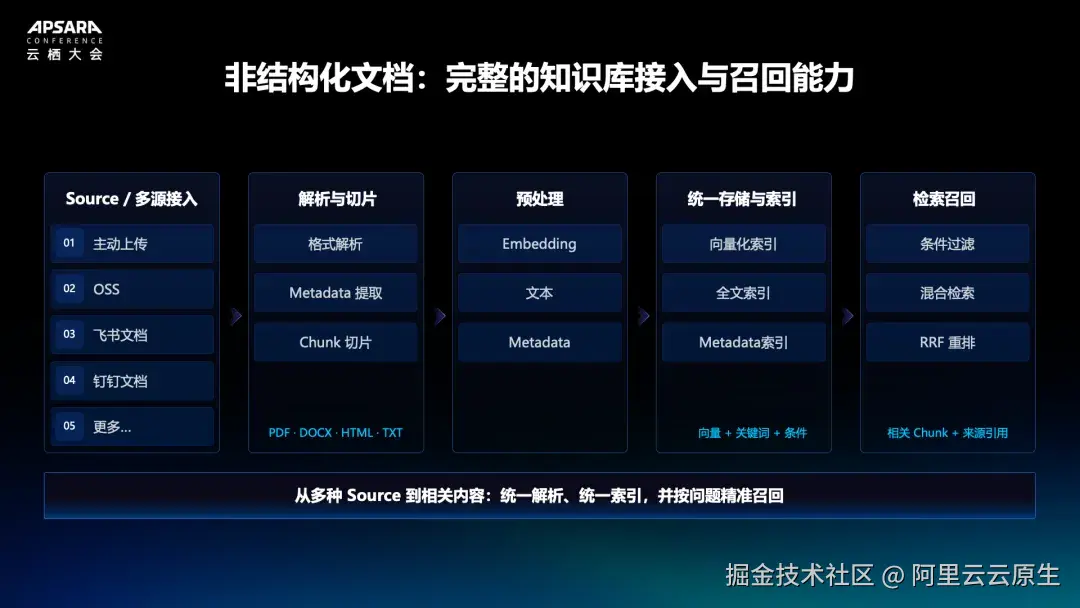
对于非结构化内容,AgentBridge 支持从文件上传、OSS、飞书文档和钉钉文档等来源接入,统一解析 PDF、DOCX、HTML、TXT 等格式,并建立向量、全文和元数据索引。查询时,系统结合关键词与语义检索,通过来源、版本及适用条件缩小范围,再对结果进行融合排序,向 Agent 返回相关内容片段和来源引用。
文档的身份与版本管理贯穿这一过程。稳定的唯一标识、幂等处理和版本追踪帮助减少重复内容与新旧版本混淆,分块过程尽量保留语义完整性。知识库文件作为事实来源,更新后索引保持最终一致,检索结果保留来源与版本信息,让使用者能够核查答案依据。
可观测与回归:让每次回答都能追溯
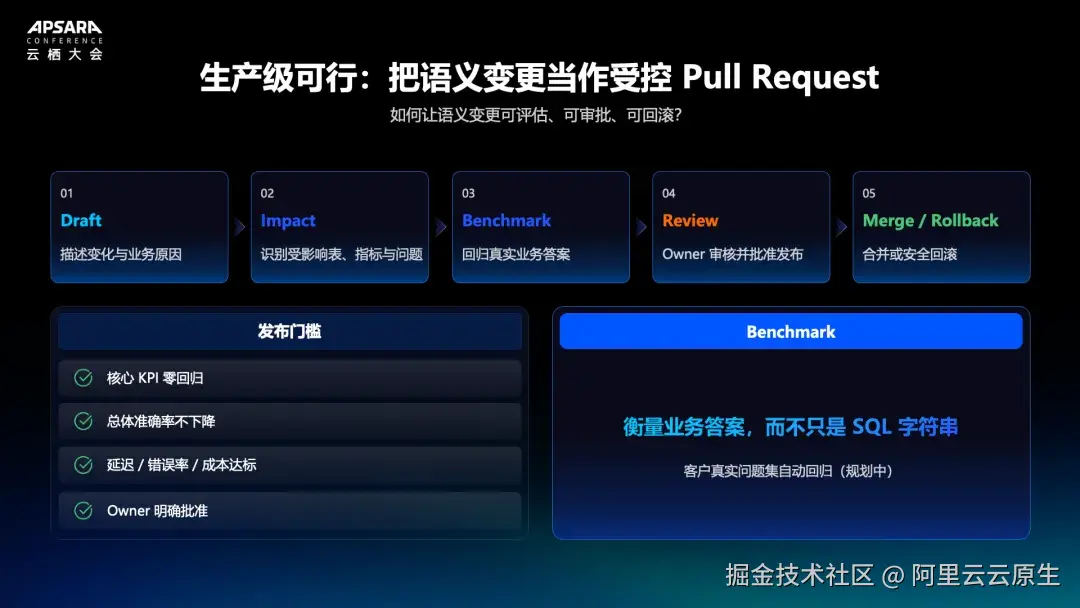
生产环境还需要回答另一个问题:当 Agent 的某次回答出现偏差,应该从哪里排查?AgentBridge 通过事件、查询与 Trace 等关联标识,连接数据流转和 Agent 执行链路,支持追踪事件到达、查询执行、内容召回,以及工具和模型调用过程。开发者可以据此查看使用了哪些数据、执行了什么 SQL、召回了哪些内容,进一步定位延迟、错误或重试发生的环节。
结合链路延迟、成功率、召回质量和 Token 消耗等运行指标,企业能够持续观察 Agent 的运行质量与成本。对于指标口径和表间关系的调整,业务答案是否受到影响,同样需要验证。AgentBridge 后续规划包括基于客户真实问题集的自动回归,用于进一步评估语义变更对已有业务问答的影响。
开放架构:沿用已有数据资产
AgentBridge 在加工、存储、查询和语义层保留开放能力。企业可以组合现有流处理组件,选择内置存储或基于 Iceberg、Parquet 等开放格式的自有存储,并通过跨源查询访问已有数据库。统一的数据目录、结构、语义和血缘也可以通过 API、CLI、MCP 等接口开放,供 Luma 或企业自己的 Agent 复用。
总结
从原型到生产,Agent 落地的差距往往不在模型,而在于能否持续获得可信、实时、可追溯的上下文。AgentBridge 让企业沿用已有的数据架构,把分散在消息、数据库、日志与文档中的信息,围绕业务任务组织为 Agent 可以直接使用的上下文,并让每一次回答都能被观测和核查。
我们期待与正在建设客服、运营、制造、物流及零售 Agent 的企业一起,带着具体的业务问题和数据源,把 Agent 真正用到业务当中。
钉钉搜索群号(184650006355)进入 AgentBridge 用户交流群!
本场论坛直播回看: