摘要
模型反演(Model Inversion,MI)攻击旨在为每个目标类别恢复具有语义意义的重建结果。此类攻击已得到广泛研究,并被证明在白盒场景中能够成功。相比之下,黑盒模型反演攻击的效果和效率都较低:效果指能否重建出可辨认为其真实类别的样本;效率则指完成攻击所需的时间或查询次数。对于卷积神经网络(CNN)等复杂目标,能否实施有效且高效的黑盒模型反演攻击,目前仍不明确。
本文研究黑盒场景下模型反演攻击的可行性、效果与效率,并提出 Deep-BMI(Deep Black-box Model Inversion,深度黑盒模型反演)框架。该框架支持多种黑盒优化器,用于攻击图像识别任务中的深度 CNN。Deep-BMI 中效率最高的优化器采用自适应爬山算法;效果最好的优化器采用进化算法,能够一次性攻击所有类别,并为每个类别返回多样化图像。
为了评估这一威胁的严重程度,我们采用文献中的三种评估方法:(a)对人类参与者开展用户研究;(b)展示实际重建结果及其真实样本;(c)使用相关定量指标。令人意外的是,结果表明,针对复杂模型的黑盒模型反演攻击,其表现有时可与迄今报告的白盒攻击相当。
关键词:模型反演;推断攻击;安全;隐私
1 引言
尽管机器学习(ML)模型十分普及,但研究已证明它们容易受到多种安全与隐私攻击,例如模型提取55、成员推断54和对抗样本生成16。本文聚焦于模型反演(MI)攻击。在此场景中,攻击者试图生成与目标模型训练时所用原始输入相似的样本19。这类信息泄露可能使用户去匿名化20,并暴露个人或敏感信息5。
所提出的模型反演攻击在效果和效率上差异显著,具体取决于多种因素,例如攻击者掌握的目标模型信息,以及模型的复杂度。举例来说,已有多种白盒模型反演攻击在不同目标上成功实施6, 19, 21, 55, 58, 62。此外,一些攻击针对低复杂度模型(目标模型复杂度的分类见第2节),仅尝试推断少量敏感特征,而这些特征取自规模可处理的小型取值域20, 27, 58。表1对现有先进模型反演攻击进行了定性定位。每篇论文依据其实用性和目标复杂度放入相应类别。如表所示,针对图像数据集训练的中等复杂度目标模型,完全不了解目标模型内部信息的黑盒模型反演攻击仅有少数成功案例4, 19, 60。然而,在训练类别推断攻击设定下,这些工作在效果与效率方面均有明显限制:前者指重建的样本能否被辨认为其真实类别;后者指计算开销和对目标模型的查询次数。
具体而言,Fredrikson等人19和Aïvodji等人4未能在黑盒场景下成功进行模型反演,因为推断出的图像在语义上没有意义,甚至无法形成可辨识的人脸60;同时,攻击效率极低,例如Fredrikson等人19需要50至80天才能完成攻击。相比之下,Yang等人60能够重建出可辨识的人脸,但需要向目标模型发出244,306次查询,攻击约需12小时¹。
本文研究黑盒场景下模型反演攻击的效果和效率,并将其定位为可行性研究,原因有二。第一,与本领域其他有明确基准的攻击不同(例如成员推断攻击的基准为50%54),模型反演具有概率性,目前尚无科学共识来界定攻击何时算有效或无效。因此,为判断模型反演攻击的表现,我们在与相关工作相同的目标模型上开展实验4, 19, 60,以便直接比较。第二,迄今在训练类别推断设定中提出的黑盒模型反演攻击被认为很难实施,有时甚至不可能。因而,本文旨在探索对中等复杂度目标实施黑盒模型反演攻击的可行程度,同时尽量减少开销。在此背景下,我们提出 Deep-BMI:一个模块化模型反演框架,支持多种黑盒连续优化算法,以最大化目标模型的置信度分数。
那么,如何解决黑盒场景下的模型反演问题?一种方法是从随机像素开始,持续扰动图像,直到目标类别的置信度分数达到最大。这种方法简单且具备生成能力,但已知会产生欺骗性图像42:这类图像虽然能以高置信度触发目标类别,却与真实样本在视觉上毫无关联。原因在于,判别式机器学习模型会将高维空间中的大片区域分配给某个类别,而这些区域包含远离自然样本的点(图像)。即便不考虑欺骗性图像问题,要生成一张图像也需要大量迭代和目标模型查询,更不用说重建完整数据集,也就是目标模型的训练集。
Yang等人60最早提出了另一种方法:根据攻击者的背景知识收集一个较通用的数据集,并用它来训练生成式反演模型。具体来说,可以使用与目标模型训练集在描述特征上相似的公开数据集。所谓描述相似的数据集,可能具有相同的基本描述性特征,并且(假设)与目标模型训练集具有相似分布,但不包含相同的训练样本。例如,攻击者可使用AT&T50、CelebA35和FERET44等人脸数据集,攻击Google Vision3、Amazon Rekognition1和Clarifai2等常见人脸识别机器学习模型。攻击者可以探测目标模型,获取任务背景、图像分辨率、彩色或灰度等基本描述信息,据此找到并下载描述相似的数据集。该方法基于这样一种假设:两个数据集中的图像共享某些特征,因此公开数据集中的部分图像可能使目标模型的某个类别置信度达到较高水平。
然而,在训练类别推断攻击设定下,Yang等人的模型反演方法未能充分利用描述相似数据集的潜力。具体而言,它有以下局限:(a)反演模型会重建出所有能够以一定置信度触发各目标类别的辅助样本的"平均图像";(b)对目标模型的查询次数与描述相似数据集的规模直接相关;(c)它缺少搜索反演模型潜在空间的优化机制,无法为各目标类别生成更具代表性的重建结果。第2节将进一步讨论这些局限,以及Deep-BMI如何应对它们。
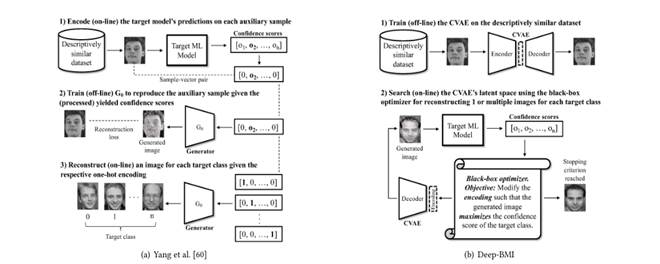
图1 黑盒模型反演框架的概念对比
左图:Yang等人60;右图:Deep-BMI。前两步中,Yang等人为训练反演模型,需要对描述相似数据集中的每个辅助样本各向目标模型查询一次,共k次(k为数据集大小)。相比之下,Deep-BMI在离线阶段直接用描述相似数据集训练卷积变分自编码器(CVAE,即反演模型),无需查询目标模型。此外,Yang等人的模型会学习重建那些以一定置信度触发同一目标类别的不同辅助样本,因此模型权重会被调整为生成代表该目标类别的平均样本。Deep-BMI则在离线阶段对每个辅助样本进行编码和解码(重建),并最小化相应的重建损失,以此训练反演模型。执行实际反演时,Yang等人将每个目标类别对应的独热编码输入反演模型,并将重建图像作为输出,每个目标类别需要一次查询。Deep-BMI则采用黑盒优化技术,对输入到解码器部分的20维编码进行结构化扰动,使生成图像的目标类别置信度最大化。最后,Yang等人的方法每个目标类别只能返回一个解或重建结果;Deep-BMI则可根据所用的黑盒优化器返回多个多样化结果。
引言(续)
本文的关键洞见是:先使用描述相似数据集离线训练反演模型,而无需让目标模型参与或对其发出查询,然后再借助多种黑盒优化器搜索该模型的潜在空间,就能够兼顾上述两种方法的优点。具体来说,我们的方法(见图1(b))分为两个阶段。第一阶段,我们在描述相似的公开数据集上训练生成模型;本文使用深度卷积变分自编码器(CVAE),以学习输入的结构,并假设可由此学习两个数据集共享的特征。第二阶段,CVAE可对其潜在空间进行采样,执行尊重公开数据集(并假设也尊重目标模型训练集)已学习特征的结构化扰动,而不是像素扰动,从而缓解生成欺骗性图像的问题。采样的计算开销很低,并持续进行,直到目标类别的置信度分数达到最大。第3节将说明选择CVAE而非其他生成模型的理由。
为了评估这一威胁的严重程度,我们将Deep-BMI用于一个经过训练的目标CNN,该模型有两种任务:数字分类(场景1)和人脸识别(场景2)。借此,我们可以观察随着问题复杂度提高,模型反演框架的表现如何变化。场景1针对数字分类,主要用于展示Deep-BMI如何应用于难度适中、但实际隐私影响较低的目标。场景2针对人脸识别,其目标复杂度更高,隐私影响也更为显著。我们关注CNN,是因为文献表明,与其他机器学习模型相比,它们对模型反演攻击具有最先进的鲁棒性4, 19, 60。对于Deep-BMI在其他目标模型上的效果,我们留待未来研究。
为评估Deep-BMI的表现,我们采用三种方法(见第4节):(a)展示实际重建结果及其真实样本;(b)使用相关定量指标;(c)开展用户研究。三种评估方法均表明Deep-BMI表现良好。例如,在用户研究中,Deep-BMI平均能够以95.45%的成功率推断出可辨识的数字,受访者中有83.58%在作答时表示"非常有把握"或"有把握"。对于人脸,平均成功率为60.05%,有52.91%的受访者表示"非常有把握"或"有把握"。此外,与Yang等人的模型反演框架60相比,Deep-BMI在重建可辨识图像时少向目标模型查询234,306次。就我们所知,除Yang等人的工作外,图像识别领域还没有其他黑盒模型反演框架成功应用于判别式机器学习模型。
最后,Deep-BMI重建出的图像会触发目标类别,并获得与真实图像输入时相近、许多情况下完全相同的置信度分数。这一点很重要,因为它可能引发进一步的安全影响,例如绕过依赖置信度分数的人脸识别身份验证系统1--3。
本文的贡献概括如下。
(1)我们开展可行性研究,考察黑盒模型反演攻击面对中等复杂度目标时的效果和效率。为此,我们提出黑盒模型反演框架Deep-BMI,并将其应用于两个泛化能力良好的图像识别目标模型²。Deep-BMI采用模块化设计,潜在攻击者可为攻击特定目标模型接入自己的黑盒优化器。
(2)尽管我们并非首个使用描述相似数据集实施模型反演攻击的工作60,但我们是首个在训练类别推断设定下,以更高效率(相较Yang等人减少234,306次查询)重建出可辨识图像的工作,平均成功率为77.75%。例如,针对特定目标类别,即特定数字和人脸,Deep-BMI分别只需1.59秒和21.24秒,便可重建出100%可辨识的数字和90.47%可辨识的人脸。此外,我们表明,在复杂度相近的目标上,黑盒模型反演攻击能达到与Fredrikson等人的白盒模型反演攻击19相当的表现。
(3)Deep-BMI支持多种黑盒优化器(也可视作不同类型的攻击者),并在攻击时间与效果之间进行权衡。效果最好的优化器基于质心Voronoi镶嵌(CVT)多维表型精英档案(MAP-Elites)算法56,在场景1和场景2中的成功率分别达到100%和77.77%。效率方面,没有单一指标能够决定哪种优化器最佳。例如,若要尽量减少查询次数,应使用CVT-MAP-Elites;它的样本效率最高³,在场景1和场景2中,每个重建结果或解分别需要20次和3次查询。若要缩短攻击耗时,则应使用自适应爬山算法,因为它针对特定目标类别的攻击在场景1和场景2中分别需要1.59秒和21.24秒。
(4)我们通过实验表明,在深度图像识别模型上实施模型反演攻击时,能够为每个目标类别返回多个多样化结果的优化器(例如CVT-MAP-Elites)效果最好。这是因为多样化结果能从不同角度泄露每个目标类别的定性信息。
(5)为推动这一主题的进一步研究并提高可复现性,我们公开了实验代码⁴。
2 模型反演
模型反演问题
模型反演攻击旨在重建目标模型训练集中某个输入样本的部分或全部内容。设目标机器学习模型Mₜ是一个函数f,它接收由n维特征x₁,...,xₙ组成的向量,并输出预测结果y=f(x₁,...,xₙ)19。Fredrikson等人20提出的首个模型反演攻击通过黑盒方式访问f,在已知其他非敏感特征x₂,...,xₙ、目标模型输出y,以及有关Mₜ或特征向量中单个特征边缘先验的其他辅助信息时,推断敏感特征x₁。随后,该算法选取能使特定目标类别置信度分数最大的x₁取值。然而,Fredrikson等人19在后续论文中指出,先前提出的攻击存在明显局限,其中之一是无法用于未知特征取自难以穷举的大集合或大取值域的情况。
与Yang等人60类似,本文探索如何在图像识别模型上开展黑盒模型反演攻击:攻击者只利用与目标模型训练集在描述特征上相似的数据集,推断图像的所有特征(像素值)。
模型反演有两种形式:
• 数据重建:攻击者根据输入样本的置信度分数向量,尝试重建该样本。例如,在人脸识别机器学习模型中,攻击者的目标是根据某人的置信度分数向量重建其人脸图像60。同样的攻击设定适用于其他基于机器学习的生物识别身份验证系统:攻击者根据系统对个人样本给出的置信度分数向量,恢复其生物特征数据30。
• 训练类别推断:攻击者根据一个经过训练的机器学习模型,为每个目标类别恢复具有语义意义的重建结果。沿用人脸识别的例子,攻击者的目标是恢复训练数据集中某个任意人物(类别)的可辨识人脸图像60。在其他基于机器学习的生物识别身份验证系统中,攻击者同样旨在推断训练数据集中某个任意个体(类别)的生物特征数据30。
本文只关注训练类别推断攻击设定。在这一设定下,Yang等人60重建的样本可辨识度较低(见图8)。这是因为要求攻击者掌握待推断目标样本对应的置信度分数向量,假设条件较强。
威胁模型
本文关注黑盒攻击场景:攻击者无法以任何方式访问目标模型的内部信息,例如其架构、参数或训练数据;攻击者只能查询目标模型,并接收模型返回的各类别置信度分数。与Fredrikson等人19提出的白盒模型反演攻击相比,这种攻击场景的难度和实用性都更高。白盒攻击假设攻击者能够访问模型内部信息,并通过梯度下降最小化代价函数(预测误差),重建可辨认为真实类别的图像。相比之下,Deep-BMI仅利用获胜类别的置信度分数,就能重建出可辨识的数字和人脸。对于只能访问获胜类别离散标签、无法获知相应置信度分数的完全黑盒模型反演攻击,我们留待未来研究(见第5节)。
黑盒攻击者的重要目标之一,是尽量减少实施模型反演攻击时对目标模型的查询次数。查询需求过高的黑盒攻击:(a)效率低,因此不实用;(b)可能引起目标系统怀疑,并被系统识别为恶意行为。此外,若黑盒攻击者可以无限查询,就能够估算目标模型的梯度,或以黑盒方式"窃取"整个目标模型,从而逼近白盒攻击者的表现。因此,与白盒攻击相比,对目标模型的查询次数是限制黑盒攻击者实施模型反演攻击能力的重要因素。
目标模型的复杂度
目前没有广泛认可的目标模型复杂度分类。为便于介绍实验并准确定位Deep-BMI相对于现有先进方法的位置,本文提出如下分类。我们依据目标模型的架构和参数数量,将其分成三类:(a)低复杂度:浅层模型,例如支持向量机15,或参数量不超过50万的人工神经网络(ANN);(b)中等复杂度:参数量为50万至5亿的CNN;(c)高复杂度:参数量超过5亿的CNN。
Yang等人的黑盒模型反演框架(见图1(a))按以下方式工作。第一步,在线对目标模型进行查询,将其在每个辅助样本上预测概率最大的类别及其置信度编码成n维向量(n为输出类别数),其余类别位置填零。第二步,将编码后的预测作为特征,离线训练反演模型Gθ。换言之,Gθ接受样本对应的编码预测向量作为输入,并学习重建各辅助样本。第三步,训练完成后,为每个目标类别创建一个独热编码,并输入Gθ;模型输出即为相应类别的推断图像。简言之,Gθ在观察所有图像---向量对之后,会被要求生成一张最有可能以最高置信度(即1)触发目标类别的图像。
这一模型反演策略存在以下局限。首先,反演模型会重建出所有能以一定置信度触发各目标类别的辅助样本的"平均图像"。这是因为每个目标类别很可能会被多个辅助样本触发,因此Gθ会学习生成一张能够为所有这些不同辅助样本最小化重建损失的图像。其次,它对每个辅助样本都需要查询目标模型一次,因此查询总数等于描述相似数据集的规模。第三,它缺乏搜索反演模型潜在空间的优化机制,无法为各目标类别生成更具代表性、更加接近真实样本的重建结果。按照Yang等人方法的当前形式,其攻击效果受限于辅助样本与目标模型数据集样本之间的相似程度。换言之,描述相似数据集与目标模型数据集的分布越相似,模型反演效果越好。
Deep-BMI按以下方式克服Yang等人方法的局限。首先,在Deep-BMI中,反演模型不会学习重建那些以一定置信度触发同一目标类别的不同辅助样本。相反,我们采用自编码器的经典训练范式:离线训练CVAE,对每个辅助样本先编码、再解码(重建),并最小化相应的重建损失。其次,Deep-BMI将向目标模型发出的查询次数与描述相似数据集的大小解耦;
注:¹ 原文指出,Yang等人使用的工作站配有2颗英特尔至强CPU(共16核/32线程)、256 GB内存和2块NVIDIA Tesla P100 GPU。² 此处"泛化能力好"指模型能以较高成功率分类此前未见过的输入样本。³ 样本效率与生成单个样本所需的查询数成反比;效率越高,所需查询越少。⁴ https://bitbucket.org/srecgrp/deep-bmi-public/
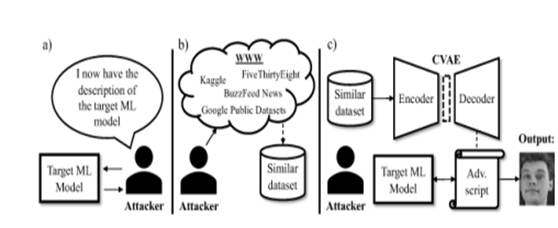
图2 Deep-BMI攻击流程
图示说明:攻击者(a)探测目标模型,了解其功能的基本描述;(b)在网上搜索并下载与目标模型训练集在描述特征上相似的公开数据集;(c)使用下载的数据集训练CVAE,并根据自己的优先目标(攻击时间或攻击效果)选择攻击脚本和黑盒优化器,执行模型反演。整个攻击过程中,攻击脚本与目标模型进行双向通信。
在Deep-BMI中,对目标模型的查询次数由所采用的黑盒优化器明确控制。第三,Deep-BMI在设计上是模块化的模型反演框架,支持多种黑盒优化方法,例如爬山法和协方差矩阵自适应进化策略(CMA-ES),用于搜索CVAE的潜在空间,并为每个目标类别推断更具代表性的重建结果。有关黑盒连续优化的更多细节见附录A。图1对Deep-BMI与Yang等人的方法进行了概念比较。
3 Deep-BMI
概述
从整体上看,我们的模型反演框架由一个深度CVAE构成(见附录B图15),它充当攻击者模型,并在一个与目标模型训练集描述相似但样本不同的数据集上训练。如Deep-BMI攻击流程(图2)所示,攻击者先探测目标模型以获得基本描述信息(阶段a),再据此寻找并下载描述相似的数据集(阶段b),并用其训练模型(阶段c)。与Yang等人相同,我们通过目视检查来选择相似数据集。如何深入分析并找到这样的数据集,与本文的研究方向正交,因此不在本文讨论范围之内。相关细节可参阅Yang等人论文60第4.1节。
据我们所知,除Deep-BMI和Yang等人的方法外,尚无其他基于描述相似数据集的黑盒模型反演框架。
Yang等人是首批在黑盒场景下利用描述相似数据集实施模型反演攻击的研究者⁵。作者指出,目标数据集与描述相似数据集之间的分布相似度会显著影响整体攻击表现。这是因为黑盒模型反演框架只能利用目标模型的置信度分数,并通过最大化各目标类别的置信度执行反演,因此更容易重建出欺骗性图像。图3给出实验示例。因此,对于黑盒模型反演框架而言,选择用于训练攻击者模型的相似数据集至关重要,因为它会限制搜索范围,使其集中在图像空间中相应区域内可识别的部分。
与Yang等人的方法类似,我们假设目标模型的输入和输出形状对所有用户均已知,因此攻击者也知道这些信息。至于描述相似数据集必须具备哪些具体描述属性,这是一个有趣的研究方向,但超出本文讨论范围(见第5节)。
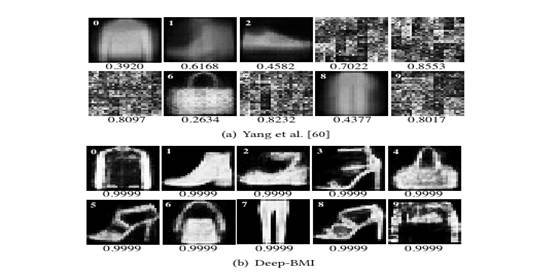
图3 使用分布不同的背景数据集时的数字重建
图示说明:图中为数字0至9的重建结果及目标模型置信度分数,对比Yang等人和Deep-BMI。两种方法均使用与目标数据集(MNIST34)分布不同的背景数据集(Fashion-MNIST59)。如图所示,尽管两种模型反演框架在一定程度上提高了各目标类别的置信度分数,生成的欺骗性图像在视觉上仍与真实类别无关。本文不试图解决背景数据集分布不同时产生欺骗性图像的问题。
使用生成模型
我们的模型反演攻击基于以下事实:给定随机噪声向量,如果该向量的维度与CVAE架构中间层潜在空间编码的维度一致,并且按照指定均值和方差的高斯分布生成,CVAE就能够生成与目标模型训练集样本相似的输入。因此,我们将图像域中的模型反演表述为搜索问题,并通过多种采样算法(黑盒优化器)搜索CVAE的潜在空间来优化问题。优化器从朴素方法到更智能的方法不等,搜索过程持续进行,直至目标类别的置信度分数达到最大。采用朴素采样算法,也有助于我们理解图像识别模型上的模型反演攻击究竟能做到什么程度。
选择CVAE而非其他生成模型的理由
Deep-BMI需要生成图像,最简单的选择是使用自编码器(AE)47。然而,AE的潜在空间不保证连续,因此不容易在不同解之间进行插值。随后可考虑变分自编码器(VAE)和生成对抗网络(GAN)。我们选择VAE,具体而言是CVAE,而不选GAN,是因为普通GAN比普通VAE更难训练;我们希望使用简单模型来检验模型反演框架的可行性。虽然还有更先进的生成模型,但基于相同理由,我们仍采用CVAE:希望选择一种简单、成熟且有现成源代码的方法。
问题形式化
给定一个预训练图像分类模型F:X→Y,它将灰度图像映射到Y个类别,攻击者希望以任意方式构造输入图像X_adv,使其真实标签为Y_tar∈Y,并让F(X_adv)=Y_tar,同时尽可能提高该预测的置信度。直观而言,能以最高置信度触发Y_tar的X_adv,在视觉上应与目标模型训练集中属于该类别的样本均值相似。事实上,攻击者还要求针对某个特定领域的相似性函数Similar,满足Similar(X_adv, X_mean)≥ε;其中X_mean为真实标签是Y_tar的训练样本均值,界限ε∈R⁺表示能够保留视觉语义的改动程度。我们通过以下方法模拟相似性函数:对重建图像开展用户研究4, 19;展示实际重建结果及其真实样本60;使用相关定量指标62。
实验场景
我们在两个复杂度不同的场景中部署模型反演框架。场景1中,目标模型在MNIST34上训练,攻击者模型在EMNIST-letters11上训练;场景2中,目标模型在AT&T人脸数据库50上训练,攻击者模型在CelebA35上训练。两个场景下,目标数据集与攻击者数据集的类别均不重叠。数据集的详细介绍见第4.1和4.2节。
我们有意选择这两个设定,以分析目标模型复杂度是否影响黑盒模型反演框架(如Deep-BMI)的表现,以及影响程度。选择这些数据集也便于与现有文献中的方法直接比较,因为其他工作采用了完全相同的数据集4, 19, 60。出于伦理考虑,我们没有攻击商业图像识别模型1--3,而是自行训练并测试图像识别目标模型,从而在不涉及伦理风险的情况下评估Deep-BMI。
我们重点攻击泛化能力良好的模型,因为文献表明,与过拟合模型相比,此类模型对类似攻击的鲁棒性显著更高49, 54。场景1的目标模型训练准确率为99.34%,测试准确率为99.13%;场景2的训练准确率为99.48%,测试准确率为99.44%。因此,在两个场景中,目标模型都已在相应数据集上正确训练,并实现了较高的性能和泛化能力。攻击者模型也达到类似水平。两个场景中目标模型与攻击者模型每个训练周期的训练和测试损失曲线见附录A图14。
攻击者与黑盒优化器
表2总结了本文的攻击者(黑盒优化器),并与文献中的攻击者进行比较。我们只将本方法与针对复杂度相近的机器学习模型和数据集开展的模型反演攻击比较,即参数量为50万至5亿的深度CNN。这样做是因为,相比于IWPC数据集上的回归模型等常见或低复杂度目标20,针对中等复杂度、在图像数据集上训练的模型实施反演攻击,难度本来就更高。本节稍后将依据样本效率和返回解的数量,对所用黑盒优化器进行分类。
我们总共使用六种黑盒优化器,大体分为两类:单次调用时只能攻击一个目标类别的单类别优化器,以及可同时攻击所有目标类别的全类别优化器。第一种优化器是随机采样,主要从高斯分布中抽取随机向量。其余优化器,即简单爬山、自适应爬山、CMA-ES、MAP-Elites和CVT-MAP-Elites,均属于随机、无导数优化或质量多样性(QD)算法。
所有攻击者的共同目标是搜索使目标模型置信度分数最大的重建结果。因此,只利用目标模型置信度分数的优化器正好适用。需要强调的是,Deep-BMI在设计上是模块化的模型反演框架,潜在攻击者可以接入自己的黑盒优化器,测试对任意目标模型实施模型反演攻击的可行性。
下文介绍的所有攻击者都接收经过训练的目标模型Mₜ和攻击者模型Mₐ作为输入。在机器学习即服务(MLaaS)场景中,Mₜ和Mₐ参数可以是通过API访问目标模型和攻击者模型的密钥。
单类别黑盒优化器
随机采样:首先,此优化器创建用户指定数量rand_vecs_no个来自正态分布的随机向量;然后,通过Mₐ的解码器部分将这些向量重建为图像;接着,把图像输入目标模型并取得各图像的预测结果;最后,找到并展示能以最高置信度触发指定目标类别的图像。该优化器的计算复杂度为O(n),其中n为需要解码的随机向量总数。本文报告的所有优化器计算复杂度均与目标模型查询次数有关。
爬山法(HC):该优化器使用爬山算法,通过调整当前解中随机选取的一个元素,最大化评估函数(即目标类别置信度分数),并判断调整是否提高了评估得分。所有能够提高得分的改动都会被接受。搜索过程在达到预先设定的最大迭代次数后停止。该优化器的计算复杂度为O(n),其中n为迭代总数。更多细节见附录C。
自适应爬山法(Adaptive HC):该优化器在执行爬山搜索时,对当前解的各个元素进行自适应改动,并同时逐步调整学习加速度。若两个连续向量的得分差小于预先设定的ε,或达到最大迭代次数max_iterations,算法即停止。计算复杂度为O(nd),其中n为迭代次数,d为潜在空间维度。更多细节见附录C。
CMA-ES:此优化器使用CMA-ES算法25搜索CVAE的潜在空间。计算复杂度为O(nm),其中n为迭代总数,m为每次迭代进行的函数评估次数。详见附录C。
全类别黑盒优化器
MAP-Elites:此优化器使用MAP-Elites搜索潜在空间,同时保持类别空间中的多样性,以实施全类别攻击。计算复杂度为O(n),其中n为迭代总数。当达到预先设定的最大迭代次数max_iterations时,算法结束。具体的变异和交叉方法见附录C。
CVT-MAP-Elites:该优化器使用CVT-MAP-Elites,同时维持类别空间和潜在空间中的多样性,以返回分布较广的多个解。MAP-Elites无法有效利用20个维度,因此做不到这一点。该优化器的算法与MAP-Elites相同,仅有以下差异:(a)使用大小为100×c×20的映射,其中100为聚类数、每个聚类包含c个解(每个类别一个),因此场景1有1,000个解,场景2有4,000个解;(b)根据正态分布生成每个聚类的质心。计算复杂度为O(n),其中n为迭代总数。
优化器分类
表3列出各黑盒优化器的样本效率和返回解的数量。随机采样只靠运气,因此没有智能优化机制,样本效率低。HC采用各向同性高斯扰动,但不会调整扰动方差来加速优化,样本效率中等。相比之下,自适应HC和CMA-ES能够按维度调整扰动,样本效率高。MAP-Elites的样本效率可视为中等,因为它需要的查询数与HC攻击所有类别所需的数量相近,但能返回大致相当数量的解(见表5)。CVT-MAP-Elites的样本效率可视为高,因为它可以同时攻击多个类别并返回多个多样化解:只需20,000次查询,返回的解就比自适应HC多;后者必须多次攻击所有类别才能返回多个解(见表5)。请注意,自适应HC没有机制保证返回结果的多样性。
|----------------|-----------------|------------|
| 优化器 | 样本效率(低/中/高) | 返回解的数量 |
| 随机采样 | 低 | 1 |
| HC | 中 | 1 |
| 自适应HC | 高 | 1 |
| CMA-ES | 高 | 1 |
| MAP-Elites | 中 | c |
| CVT-MAP-Elites | 高 | k×c |
注:c为目标类别数;k(≥1)为每个类别的解数。
4 Deep-BMI评估
评估模型反演框架
目前没有单一的模型反演框架性能评估方法,这主要是因为模型反演攻击具有概率性,缺少明确基准。例如,有些论文对人类参与者开展用户研究4, 19,另一些则采用不同指标,如峰值信噪比(PSNR)62。此外,还有论文展示实际重建结果及其真实样本,据此判断攻击效果60。
本文采用全部三种评估方法。首先,图8在训练类别推断攻击设定下,将Deep-BMI的重建结果与Yang等人报告的结果进行比较,并为每个重建结果提供目标模型对真实类别给出的置信度分数。其次,我们针对两个场景分别开展用户研究:给参与者展示由模型反演框架重建的图像,并请他们辨认图中的数字(0--9),或从给定选项中选择最相似的人脸。参与者也可以回答"不知道"图中是什么数字,或表示给出的备选项中"没有目标人脸"。两项研究均收集同一批22位参与者的回答,其中59.1%为男性、40.9%为女性;77.3%年龄为18至25岁,其余22.7%为26至35岁。参与者没有特定的教育背景要求或其他资格标准。
研究已通过伦理审查。申请审查时,我们向所在国家相应伦理部门提交了相关文件,说明(a)完整实验设置;(b)将收集的参与者数据;(c)参与者可能获得的益处及可能面临的风险。所有数据均以匿名方式收集。
第三,我们使用表4和表6中的指标⁶,分别衡量Deep-BMI在两个场景中的表现:(a)PSNR,即图像最大平方像素波动值与目标图像和重建图像之间均方误差的比值;(b)攻击准确率,即评估分类器预测重建输入类别的成功率⁷;(c)特征距离,即重建图像与目标类别质心之间的L2特征距离;(d)Fréchet Inception距离(FID),即根据真实图像和生成图像计算的特征向量之间的距离。PSNR和攻击准确率越高越好;特征距离和FID越低越好。注:⁶ 指标(a)至(c)由Zhang等人62提出。我们未报告KNN距离,因为Zhang等人指出,该指标与特征距离给出的结果非常相似。
将Deep-BMI与其他基线方法比较时,我们确保各方假设条件一致。例如,与同为黑盒且依赖背景数据集的Yang等人方法比较时,我们确保两个模型反演框架具有相同的(a)攻击者能力、(b)目标数据集和(c)描述相似数据集。此外,我们在所有模型反演框架的攻击者模型训练和超参数调优上投入相当的工作;在可能的情况下,我们采用作者建议的最优取值。
为估算Deep-BMI的效率,我们统计向目标模型发出的查询次数,并测量攻击所需时间,与文献4, 19, 60一致。查询预算,即对目标模型的查询总数,是根据实验结果选定的;增加查询预算会改善重建结果,因此也会提高每种优化器的性能。我们没有报告训练攻击者模型所需时间,因为与Yang等人的方法不同,Deep-BMI能够离线训练该模型,无需与目标模型进行任何通信或交互。因此,训练时间完全取决于攻击者的计算能力,例如能否使用多块GPU并行运行,并不影响攻击过程。
如第2节所述,黑盒模型反演框架的一个缺点是对目标模型的查询量可能很大。潜在攻击者可以使用僵尸网络分布式发出这些查询,以缓解该限制;但这会提高攻击整体复杂度,并降低其实用性。Deep-BMI的目标是通过所选黑盒优化器控制查询次数,从而尽量减少查询。此外,潜在攻击者可以根据需要设置查询预算上限,或在重建图像对相应目标类别的置信度超过(预先设定的)阈值后,停止查询和攻击。在本文实验中,我们调整各优化器的最大迭代次数,进而影响目标模型的总查询数,直到重建出的数字和人脸均能以较高置信度被分类为真实类别。因此,对每种优化器而言,所有目标类别的查询预算相同。
实验设置
我们按照以下参数设置构建并训练攻击者模型(CVAE,见附录B图15):(a)优化器:采用默认设置的Adam31;(b)批次大小:128;(c)损失函数:二元交叉熵加KL散度32。攻击者CVAE的编码器由三个卷积层组成。第一层提取线条和边缘等低级特征;第二层提取多条线和形状;最后一层在场景1中提取数字,在场景2中提取人脸。一般而言,随着网络深度增加,所提取特征的抽象层次也会提高。目标CNN(见附录B图13)的参数设置为:(a)优化器:采用默认设置的Adadelta61;(b)批次大小:64;(c)损失函数:负对数似然。实验使用PyTorch 1.4.043,运行于一台4核Xeon处理器、64 GB内存且没有GPU的机器上,底层操作系统为64位Ubuntu 18.04.5 LTS。
4.1 反演数字识别模型
首先,我们将Deep-BMI部署在一个难度适中、但实际隐私影响较低的目标上,以展示其工作机制。具体而言,我们使用Deep-BMI反演一个手写数字识别模型。此场景中,目标模型使用MNIST训练,攻击者模型使用EMNIST-letters训练。
• MNIST包含70,000张手写数字图像,共10个类别(数字0至9),其中训练集有60,000个样本,测试集有10,000个样本。灰度数字图像已进行尺寸归一化和居中处理,并统一为28×28像素。
• EMNIST-letters包含145,600个字符,共26个均衡类别,训练集有124,800个样本,测试集有20,800个样本。该数据集包含从NIST特别数据库19收集的手写字母,已转换为28×28灰度图像,图像格式与MNIST一致。
效果:展示实际重建结果
如图4所示,Deep-BMI重建出的图像能够被辨认为其真实数字类别。
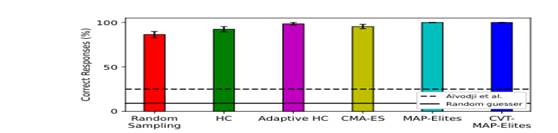
图4 Deep-BMI重建的数字。
用户研究
我们设计了一份共18道题的问卷(从每种优化器的重建结果中随机选择3张)。参与者需要辨认每张重建图像中的数字,也可以选择"不知道";同时,他们还需报告每道题作答时的信心程度,采用五点李克特量表9。因此,我们能够定性分析框架的表现,不仅考察重建图像是否可辨识,也考察图像的保真度。
我们展示以下图表:(a)各黑盒优化器的正确回答比例(图5);(b)参与者辨认重建图像时的信心水平分布(图6)。
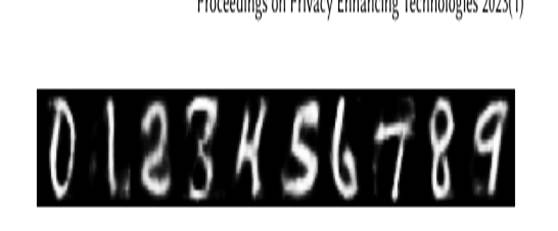
图5 场景1中各黑盒优化器的正确回答比例及均值标准误。
图5给出了各黑盒优化器的平均表现。总体而言,所有优化器表现相近且良好。自适应HC是效果最好的单类别优化器,成功率为98.48%,比排名第二和最差的单类别优化器(CMA-ES和随机采样)分别高3.03%和12.12%。两个全类别优化器MAP-Elites和CVT-MAP-Elites表现相同,成功率均为100%。总体而言,单类别和全类别黑盒优化器重建出可辨识数字的成功率分别为93.18%和100%。最后,"不知道"的回答比例为1.26%,说明绝大多数重建数字都可辨识。
注:⁵ 除Deep-BMI和Yang等人的方法外,其他黑盒模型反演框架都不基于描述相似数据集。
4.1 反演数字识别模型(续)
总体而言,在该场景下,MAP-Elites和CVT-MAP-Elites是效果最好的黑盒优化器,其攻击成功率比表现最好的单类别优化器自适应HC高1.51%。不过,所有优化器的攻击成功率都远高于Aïvodji等人报告的结果4。
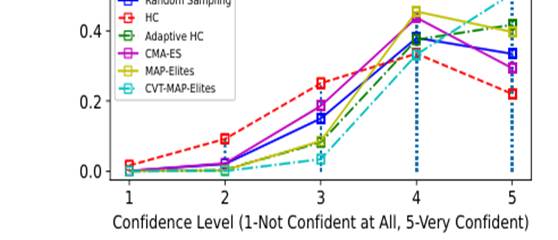
图6 场景1中各黑盒优化器的信心分布。
图6展示场景1中各优化器的信心分布。所有优化器的分布峰值均出现在"非常有把握"和"有把握"两档。具体而言,在辨认单类别和全类别优化器生成的数字重建结果时,分别有78.03%和94.69%的受访者感到"非常有把握"或"有把握"。分别只有6.06%和3.03%的受访者对单类别和全类别优化器重建的图像感到"没有把握"或"完全没有把握"。
定量指标
为完整起见,表4采用相关定量指标衡量Deep-BMI的效果,尽管(a)场景1主要用于概念验证、展示Deep-BMI的工作机制;(b)我们没有与文献中的其他方法直接比较。
|--------|--------------------------|
| 指标 | Deep-BMI平均值(95%置信区间) |
| PSNR | 11.61(11.58,11.64) |
| 特征距离 | 298.68(297.76,299.60) |
| 攻击准确率 | 98% |
| FID | 124.74(123.91,125.57) |
效率
表5汇总了单类别和全类别黑盒优化器的效率结果。所有优化器均能高效地重建可辨识数字:单类别攻击中,CMA-ES只需1.29秒;全类别攻击中,MAP-Elites只需270.89秒(4.5分钟)。我们也报告各优化器向目标模型发出的查询总数。单类别攻击最多仅需388次查询(自适应HC);全类别攻击需要20,000次查询(MAP-Elites和CVT-MAP-Elites)。平均而言,单类别和全类别黑盒优化器分别需要16.41秒和295.66秒,以及25,448次和20,000次查询。
|--------|----------------|---------------|----------|
| 类别 | 优化器 | 时间(秒) | 查询次数 |
| 单类别 | 随机采样 | 58 | 100,000 |
| 单类别 | HC | 4.76 | 1,000 |
| 单类别 | 自适应HC | 1.59 | 388 |
| 单类别 | CMA-ES | 1.29 | 404 |
| 全类别 | MAP-Elites | 270.89(4.5分钟) | 20,000 |
| 全类别 | CVT-MAP-Elites | 320.43(5.3分钟) | 20,000 |
小结
在该场景中,Deep-BMI支持效果良好且效率高的黑盒优化器。MAP-Elites和CVT-MAP-Elites效果最佳,平均成功率达到100%。按计算时间衡量,效率最高的是CMA-ES;它只需1.29秒(及404次查询)就能攻击一个特定目标类别。综合本节结果可以看出,手写数字识别机器学习模型在实践中能够被反演。
4.2 反演人脸识别模型
人脸识别机器学习模型将包含人脸的输入图像映射到与图中人物对应的特定标识符19。这类模型越来越多地用于用户身份验证14和主体监控51。支持人脸识别的网络API也日益增多19。
本节将Deep-BMI部署在人脸识别机器学习模型上,以破坏其安全性,并侵害那些人脸图像已被纳入目标模型训练数据集的个体隐私。此场景中,目标模型在AT&T数据集上训练,攻击者模型在CelebA上训练。
• AT&T包含40名个体(类别)的灰度图像,每人10张,共400张,拍摄时的光照、表情和细节各异。Fredrikson等人19及其他论文10, 37, 40, 45, 53都曾使用AT&T。我们按照Fredrikson等人19的做法,将每个人的图像划分为训练集和验证集,分别包含7张和3张图像;然后在训练集上训练目标模型,并用验证集评估准确率。
• CelebA包含202,599张人脸图像,来自10,177名不同个体(类别),涵盖较大的姿态变化和复杂背景。CelebA广泛用于人脸属性识别、人脸检测和关键点定位等计算机视觉任务35。为匹配AT&T的数据格式,我们将CelebA图像转换为灰度图。
图7展示了针对某个个体的重建图像,其中(a,i)使用Fredrikson等人的白盒模型反演攻击19,(b,ii)使用Deep-BMI。如图所示,Fredrikson等人能够重建可辨识的人脸,但他们可以白盒访问目标模型;Deep-BMI则在黑盒场景下运行。在我们的实验中,可以对背景数据集中以不低于0.6的置信度触发目标类别的样本求平均(图7(b,i)),但得到的结果较差,类似于Yang等人报告的结果60(见图8)。只有使用Deep-BMI(图7(b,ii)),我们才能逼近Fredrikson等人的表现。
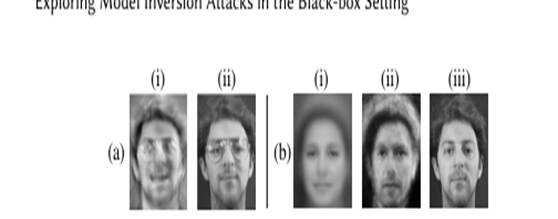
图7 特定个体的人脸重建:Fredrikson等人的白盒攻击结果(a,i)和Deep-BMI的黑盒攻击结果(b,ii)。图7(b,i)为描述相似数据集中那些以不低于0.6的置信度触发目标类别的样本均值。(a,ii)和(b,iii)为目标个体的真实图像。
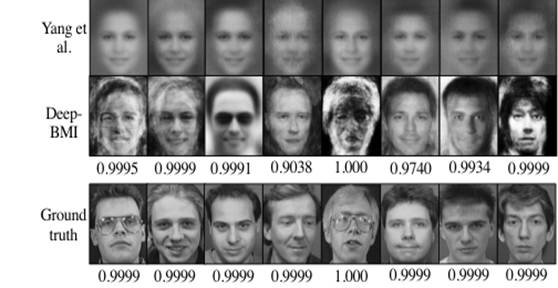
图8 Yang等人的模型反演框架60和Deep-BMI恢复的受害者人脸、对应真实图像及目标模型的置信度分数。
效果:展示实际重建结果
图8对比了我们的重建结果和Yang等人60在训练类别推断攻击设定下报告的结果。Deep-BMI重建出具有可辨识特征的图像;Yang等人的方法则只保留一般人脸属性,例如眼睛、嘴巴和鼻子,却难以辨认为真实个体。举例来说,Yang等人的某些重建结果看上去非常相似,尽管它们对应不同目标个体。正如预期,Yang等人的结果与对背景数据集中以超过置信度阈值触发各目标类别的样本求平均所得图像(图7(b,i))有些相似。
值得注意的是,真实图像输入目标模型时得到的置信度分数,与Deep-BMI重建图像输入时的分数相近,许多情况下甚至完全相同。这使Deep-BMI的重建结果有可能替代原始图像,并带来进一步的安全影响。例如,攻击者可以绕过利用目标模型置信度分数的人脸识别身份验证系统1--3⁸。相反,真实图像和Yang等人重建图像所对应的目标模型置信度分数差异显著。注:⁸ 是否能让具体的人脸识别身份验证系统将生成图像认证为特定个体,不在本文讨论范围内。
用户研究
我们设计了一份共22道题的问卷(从每种优化器的重建结果中随机选取3张),其结构与前一场景(第4.1节)不同。具体而言,我们采用Fredrikson等人19报告的相同问卷结构:让参与者从AT&T数据集的5个备选图像中选出与重建图像相符的一张,或回答显示的图像与所有备选项均不对应。80%的实验中,5张图像里有1张包含重建图像所对应的个体,其余图像随机选取。作为对照,10%的实验使用AT&T数据集中的原始图像,而非Deep-BMI生成的图像,以评估参与者匹配训练集人脸的基准能力⁹。最后10%的实验使用一张重建图像,但它不对应给出的任何一个选项。题目布局与Fredrikson等人19相同。此外,受访者还需用五点李克特量表9报告每道题作答时的信心程度。这样,我们便能评估Deep-BMI重建的人脸是否可辨识,以及其保真度。
我们展示以下图表:(a)各黑盒优化器的正确回答比例(图9);(b)参与者辨认重建图像时的信心水平分布(图10);(c)整体正确率、识别率和排除率的百分比(图11)。"整体正确率"指受访者在目标个体出现时选中其图像,否则回答"未出现";"识别率"指目标个体出现在测试图像中时,受访者选出正确图像的比例;"排除率"指目标个体没有出现在测试图像中时,受访者正确回答"未出现"的比例。
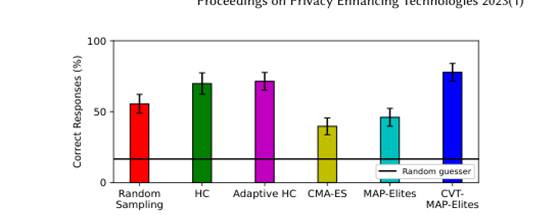
图9 场景2中各黑盒优化器的正确回答比例及均值标准误。
图9显示各黑盒优化器的平均表现。自适应HC是效果最佳的单类别优化器,成功率为71.42%,比HC高1.58%。CVT-MAP-Elites是效果最佳的全类别优化器,成功率为77.77%,比MAP-Elites高31.74%。总体而言,单类别和全类别黑盒优化器重建可辨识人脸的成功率分别为59.12%和61.90%。在该场景中,CVT-MAP-Elites是效果最好的黑盒优化器,攻击成功率比自适应HC高6.34%。注:⁹ 所有参与者均正确辨认出作为对照的全部真实(未反演)图像。
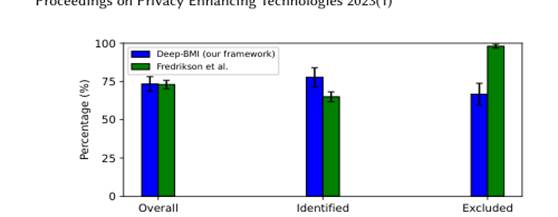
图10 场景2中各黑盒优化器的信心分布。
图10展示场景2中各优化器的信心分布。除CVT-MAP-Elites外,所有优化器的分布峰值均为"既不自信也不缺乏自信";CVT-MAP-Elites的峰值则为"有把握"。具体而言,在辨认单类别和全类别优化器生成的人脸重建结果时,分别有50.39%和57.93%的受访者感到"非常有把握"或"有把握"。分别只有24.60%和10.31%的受访者对单类别和全类别优化器重建的人脸感到"没有把握"或"完全没有把握"。与前一场景相比,受访者信心下降是预期之中的,因为该场景更复杂。不过,绝大多数受访者仍能将框架重建的人脸与目标人脸正确匹配(见图11)。
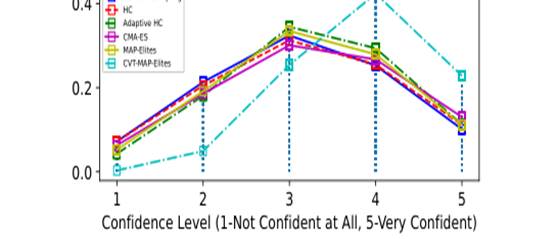
图11 场景2中Deep-BMI与Fredrikson等人的整体正确率、识别率和排除率。
图11展示整体正确率、识别率和排除率,均为Fredrikson等人使用的指标19。Deep-BMI整体准确率达到73.33%,识别率最高为77.77%,排除率为66.66%。这些结果与Fredrikson等人针对复杂度相似目标模型的白盒模型反演攻击结果相当。因此,Deep-BMI表明,尽量减少攻击者假设条件的黑盒模型反演攻击,即使面对人脸识别等更复杂的目标,也可能具有实用性。
定量指标
表6使用相关定量指标,将Deep-BMI与Yang等人提出的黑盒模型反演框架进行比较。结果表明,Deep-BMI重建的图像:(a)按特征距离和FID衡量,与真实图像的距离更小;(b)与Yang等人的方法相比,多暴露了8%的私人信息(见攻击准确率)。Deep-BMI唯一表现较差的指标是PSNR,Yang等人的结果比Deep-BMI高4.51。
|--------|-----------------------|-----------------------|
| 指标 | Yang等人60 | Deep-BMI |
| PSNR | 18.01(17.92,18.09) | 13.50(13.38,13.62) |
| 特征距离 | 419.36(412.15,426.57) | 403.66(398.01,409.31) |
| 攻击准确率 | 53% | 61% |
| FID | 263.75(259.08,268.43) | 223.16(218.54,227.77) |
效率
表7汇总了单类别和全类别黑盒优化器的效率。即使面对更复杂的目标,Deep-BMI仍然高效:单类别攻击中,自适应HC只需21.24秒就能重建可辨识的人脸;全类别攻击中,MAP-Elites需要158.23分钟。我们也报告各优化器的目标模型查询总数。单类别攻击仅需230次查询(自适应HC);全类别攻击需要10,000次查询(MAP-Elites和CVT-MAP-Elites)。与Yang等人的黑盒模型反演框架相比,对于复杂度相近的目标,Deep-BMI使用自适应HC和CVT-MAP-Elites时,查询次数分别减少244,076次和234,306次。单类别和全类别黑盒优化器平均分别需要3.8分钟和5.5小时,以及5,464次和10,000次查询。
|--------|----------------|-------------------|----------|
| 类别 | 优化器 | 时间 | 查询次数 |
| 单类别 | 随机采样 | 339.82秒(5.6分钟) | 20,000 |
| 单类别 | HC | 374.38秒(6.2分钟) | 1,000 |
| 单类别 | 自适应HC | 21.24秒 | 230 |
| 单类别 | CMA-ES | 181.42秒(3分钟) | 625 |
| 全类别 | MAP-Elites | 9,494.01秒(2.6小时) | 10,000 |
| 全类别 | CVT-MAP-Elites | 30,175.05秒(8.3小时) | 10,000 |
小结
在该场景中,Deep-BMI能够重建出具有可辨识人脸特征的图像(见图8)。用户研究显示,Deep-BMI的平均成功率为60.05%;效果最好的黑盒优化器仍是CVT-MAP-Elites,平均成功率为77.77%。请注意,与其他优化器相比,CVT-MAP-Elites重建的人脸使受访者作答时更有把握。具体而言,65.07%的受访者在辨认CVT-MAP-Elites重建图像时感到"非常有把握"或"有把握",比排名第二的CMA-ES高4.76%。
按计算时间衡量,效率最高的黑盒优化器是自适应HC;它只需21.24秒(和230次查询)攻击特定目标类别,同时取得较高的重建成功率(71.42%)。综合本节结果可以看出,Deep-BMI能够对人脸识别机器学习模型实施实用的黑盒模型反演攻击。
5 讨论
黑盒优化器比较
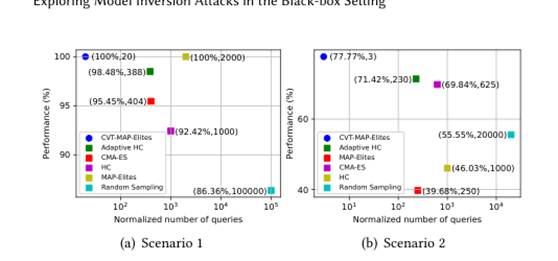
图12 各黑盒优化器的平均表现与归一化查询数。圆圈表示非支配解。
图12展示场景1和场景2中,各黑盒优化器的平均效果与归一化查询数之间的关系(总查询数除以返回的重建结果或解的数量,见表3)¹⁰。如图12(a)所示,在场景1中,CVT-MAP-Elites是效果和样本效率最高的黑盒优化器,攻击成功率为100%,每个解需要20次查询。CVT-MAP-Elites的成功率比效果和样本效率排名第二的优化器(自适应HC)高1.51%,所需查询少368次。请注意,自适应HC和CMA-ES在效果和样本效率方面表现相近,但它们每返回一个解,需要向目标模型发出的查询数分别是CVT-MAP-Elites的19倍和20倍。
如图12(b)所示,在场景2中,CVT-MAP-Elites仍是效果和样本效率最高的黑盒优化器,攻击成功率为77.77%,每个解需要3次查询。具体而言,其成功率比效果和样本效率排名第二的优化器(自适应HC)高6.34%,查询数少227次。请注意,自适应HC和CMA-ES的表现也相近(均超过69%),且对目标模型的查询次数较少(不超过625次)。综合图12可见,在两个场景中,CVT-MAP-Elites都是效果和样本效率最高的黑盒优化器。该结果符合预期,因为CVT-MAP-Elites可用于高维特征空间,并为每个聚类返回多个(多样化)解。因此,受访者可以从多张重建图像中判断图中数字或人脸(每个类别向他们展示5张图像)。
然而,图12也显示其他黑盒优化器同样可取得相近的效果和样本效率。例如,场景1和场景2中,自适应HC的攻击成功率分别为98.48%和71.42%;所需目标模型查询分别为388次和230次。CMA-ES的情况也相似。按计算时间衡量,自适应HC是效率最高的优化器,攻击场景1和场景2中的特定目标类别分别需要1.59秒和21.24秒。我们没有展示各优化器平均效果与时间的对比,因为它们的实现可能通过使用GPU等方式得到优化。
总体而言,如果要推荐优化器,攻击单个类别且希望快速获得结果时,可以使用自适应HC;同时攻击所有类别且希望每个类别得到多个解时,可以使用CVT-MAP-Elites。换言之,CVT-MAP-Elites只有在返回多个解时才具有较高样本效率。注:¹⁰ 图12主要用于比较所用黑盒优化器的表现。为特定个体返回可辨识重建结果可能比攻击其他个体需要更多查询,但所有优化器都存在这一情况,因此比较优化器时,考察平均表现即可。
将Deep-BMI用于基于人脸嵌入的目标模型
尽管本文所用目标模型也曾用于类似研究4, 26, 60, 62,但这并不意味着我们的研究会立即适用于实际人脸识别系统。例如,最先进的人脸识别模型(如FaceNet52)要么允许对预训练模型进行微调,并依据模型输出的logit确定输入身份;要么使用人脸嵌入,通过比较输入嵌入与原型嵌入之间的距离进行识别。本文主要展示前一种情形的实验。不过,Deep-BMI也可以用于后一种情形,唯一的区别是:优化器需进行调整,搜索能让重建图像嵌入与目标图像嵌入距离最小的解。虽然展示此类人脸嵌入模型的实验确实很有意思,但本文不作探讨。
局限与未来工作
本文展示了在训练类别推断设定下成功实施黑盒模型反演攻击的可能性,但Deep-BMI和Yang等人的方法仍依赖一些尚未充分探索的特定条件和假设。下文将阐述这些假设和局限,因为它们直接影响Deep-BMI和Yang等人框架的实用性,并提出未来研究方向。这些问题涵盖三个方面:(a)能否获得与目标数据集在描述特征上相似的背景数据集;(b)所用生成式(反演)模型;(c)能否访问目标模型Top-1置信度分数。
获取描述相似的数据集
首先,在某些场景(例如生物医学领域)中,可能很难获取描述相似的背景数据集。因此,攻击者可能只能获得非常少量、完全无法代表整体分布的训练样本。分析背景数据集大小如何影响Deep-BMI等黑盒模型反演框架的表现,是一个有意义的研究方向。
其次,描述相似数据集必须具备哪些属性尚不明确。若能详细分析该数据集的具体特征,以及这些特征如何与Deep-BMI的机制或Yang等人提出的攻击相互作用,将有助于揭示如何最好地判断目标数据集和背景数据集之间的相似程度,并据此制定寻找此类数据集的指南。
第三,文献尚未穷尽探讨目标数据集与背景数据集之间的相似程度如何影响模型反演效果。例如,两个数据集之间达到令人满意结果所需的相似度最低为多少?即使取得与目标数据集属于同一领域、但与目标数据集相似度较低的数据集,是否仍可能重建可辨识的图像?若能回答这些问题,将有助于判断依赖背景数据集的模型反演框架在现实世界中的实用性。
所用生成式(反演)模型
Deep-BMI的反演效果不仅取决于描述相似数据集,也取决于所用生成式(反演)模型的能力。调整生成模型确实会在一定程度上影响整体模型反演效果。但我们方法的关键在于模型反演攻击的一般流程以及不同组成部分如何配合,而非某个特定生成模型本身。因此,Deep-BMI可以用其他生成模型替换CVAE。不同CVAE参数以及其他潜在生成模型如何影响整体模型反演效果,留待未来研究。
生成模型的选择取决于目标领域。例如,在计算机视觉领域,可使用VAE、GAN、基于流的模型、自回归模型或基于能量的模型8。若要判断某个生成模型能否达到最低要求的效果,应开展以下工作。首先,使用相关定量和定性指标,评估模型在背景数据集样本上的效果。例如,可使用Fréchet Inception距离,或展示一批合成图像,目视检查其质量及其与真实图像的差异。展示合成图像有助于判断生成模型是否只产生模糊图像,因为这些图像可能是对某个子集求平均得到的。通常,所选模型应能生成在变化程度和质量方面与背景数据集样本相当的图像。其次,通过多种黑盒优化器搜索模型的潜在空间,检验它能否针对每个目标类别生成具有较高置信度的图像。如果做不到,则应更换生成模型,或扩充背景数据集,因为只能以低置信度触发某个目标类别的生成图像,无法代表相应类别。
潜在空间的大小和形状可能导致模型反演攻击效果不佳。具体而言,黑盒优化器能够搜索的潜在空间比例,以及接近自然图像的解有多稀疏,都会影响攻击效果。深入分析潜在空间的大小和形状如何具体影响模型反演效果并非易事,我们计划在未来研究中探讨。
训练生成模型是困难且耗时的过程,在计算机视觉领域尤其如此。训练所需的计算开销与所选模型和背景数据集的复杂度直接相关。本文实验所需计算资源处于个人可承担的范围内,但对于在规模更大、复杂度更高的数据集上训练更大架构的模型,可能需要更强的计算资源。
访问目标模型的Top-1置信度分数
Deep-BMI和Yang等人的方法都使用Top-1置信度分数(连续值),而不是获胜类别的离散标签。因此,一种可降低此类黑盒模型反演框架风险的对策,是限制目标模型只返回预测获胜类别的标签,而不报告任何概率¹¹。由此,开发只利用目标模型预测获胜类别标签、无需置信度分数的完全黑盒模型反演框架,是另一个有意义的未来研究方向。注:¹¹ 请注意,该对策会显著降低目标模型所提供信息的效用54。
6 相关工作
Fredrikson等人20提出了首个针对敏感基因组数据的黑盒模型反演攻击。但该攻击只适用于低复杂度模型,以及敏感目标特征数量有限、且其取值来自小型域的数据集19。在后续研究中,Fredrikson等人19进一步展示了这一威胁可能造成的严重后果:他们对人脸识别模型实施模型反演攻击,恢复出目标模型数据集中个体可辨识的人脸特征。然而,这些攻击大多为白盒攻击;唯一的黑盒攻击效果低下(会生成语义上没有意义的重建结果60),效率也低(需耗时50至80天才能完成)。
Yang等人60提出了使用描述相似数据集的黑盒模型反演攻击,并在数据重建攻击设定下重建出可辨识图像。然而,在训练类别推断设定下,他们的攻击重建图像可辨识度较低(图8)。本文只关注后一设定,并表明只需Yang等人所需查询次数的一小部分,就可能重建出具有可辨识特征的数字和人脸。例如,Deep-BMI的CVT-MAP-Elites只需10,000次查询就能重建可辨识的人脸,而Yang等人需要244,306次查询。因此,Deep-BMI比Yang等人的方法少查询234,306次。Yang等人没有进行用户研究来评估模型反演框架的效果,因此我们不提供Deep-BMI与Fredrikson等人19在整体正确率、识别率和排除率方面的详细比较。相反,他们展示了特定个体的重建图像及其真实样本(图8)。
Aïvodji等人4提出了黑盒模型反演框架GAMIN,目标是中等复杂度模型和数据集。GAMIN推断可辨识数字的平均成功率为25%。相比之下,Deep-BMI的平均成功率为95.45%,高出70.45个百分点。此外,GAMIN无法对人脸识别模型实施模型反演,因为其重建结果无法构成可辨识人脸(见4中的图9至图11):作者只能重建出模糊的人脸轮廓,不包含目标个体的任何可辨识特征。这是我们不对Deep-BMI与GAMIN进行详细比较的主要原因。最后,GAMIN带来显著计算开销,主要来自:(a)在线训练用于模仿目标模型行为的替代模型;(b)针对每个目标类别训练不同的攻击者模型;(c)使用计算密集型图像后处理技术来提高重建质量。Deep-BMI不需要这些操作。
Zhang等人62提出生成式模型反演攻击,能够以较高成功率反演深度人工神经网络。不过,他们的攻击属于白盒攻击,而且在某些情况下依赖一组来自目标模型训练集的模糊或部分遮挡图像;这些图像正是攻击者试图推断的敏感图像。
Hitaj等人29和He等人26表明,协同学习系统容易受到白盒和黑盒模型反演攻击。然而,针对不同数据分布实施黑盒模型反演攻击时,恢复输入的质量较差26。
Hidano等人28通过向目标模型训练数据集中注入恶意样本,改变其决策近似结果,以实施白盒模型反演攻击。不过,作者仅在两个低复杂度机器学习模型和与Fredrikson等人20类似的数据集上评估其攻击。
Salem等人48提出了四种模型反演攻击,它们利用黑盒目标模型更新前后的输出差异,推断更新数据集中的多样化信息。
7 结论
本文针对中等复杂度目标,研究了黑盒模型反演攻击的效果和效率,并提出Deep-BMI这一模块化模型反演框架。该框架支持多种黑盒优化器,能够在实践中反演图像识别模型。这一发现使广泛部署的机器学习模型的安全与隐私面临重大隐患。
致谢
我们感谢匿名评审提出的建设性意见,也感谢指导编辑帮助我们改进论文最终版本。本研究得到欧盟"地平线2020"研究与创新计划及其资助协议(编号830929,CyberSec4Europe;编号739578,RISE;编号101007673,RESPECT)的支持,并获得塞浦路斯共和国研究、创新与数字政策副部的支持。
参考文献
1 2021. Amazon Rekognition. https://aws.amazon.com/rekognition/
2 2021. Clarifai. https://docs.clarifai.com
3 2021. Google Cloud Vision. https://cloud.google.com/vision
4 Ulrich Aïvodji, Sébastien Gambs, and Timon Ther. 2019. GAMIN: An Adversarial Approach to Black-Box Model Inversion. arXiv preprint arXiv:1909.11835 (2019).
5 Idan Amit, John Matherly, William Hewlett, Zhi Xu, Yinnon Meshi, and Yigal Weinberger. 2018. Machine learning in cyber-security-problems, challenges and data sets. arXiv preprint arXiv:1812.07858 (2018).
6 Giuseppe Ateniese, Luigi V. Mancini, Angelo Spognardi, Antonio Villani, Domenico Vitali, and Giovanni Felici. 2015. Hacking Smart Machines with Smarter Ones: How to Extract Meaningful Data from Machine Learning Classi- fiers. Int. J. Secur. Netw. 10, 3 (2015), 137--150.
7 Hans-Georg Beyer and Hans-Paul Schwefel. 2002. Evolution strategies--A com- prehensive introduction. Nat. Comput. 1, 1 (2002), 3--52.
8 Sam Bond-Taylor, Adam Leach, Yang Long, and Chris G. Willcocks. 2021. Deep Generative Modelling: A Comparative Review of VAEs, GANs, Normalizing Flows, Energy-Based and Autoregressive Models. TPAMI (2021), 1--1.
9 John Brooke et al. 1996. SUS-A quick and dirty usability scale. Usab. Eval. in Ind. 189, 194 (1996), 4--7.
10 Sumit Chopra, Raia Hadsell, and Yann LeCun. 2005. Learning a similarity metric discriminatively, with application to face verification. In CVPR, Vol. 1. 539--546.
11 Gregory Cohen, Saeed Afshar, Jonathan Tapson, and André van Schaik. 2017. EMNIST: an extension of MNIST to handwritten letters. arXiv preprint arXiv:1702.05373 (2017).
12 Antoine Cully, Jeff Clune, Danesh Tarapore, and Jean-Baptiste Mouret. 2015. Robots that can adapt like animals. Nature 521, 7553 (2015), 503--507.
13 Antoine Cully and Yiannis Demiris. 2017. Quality and diversity optimization: A unifying modular framework. TEVC 22, 2 (2017), 245--259.
14 MA Dabbah, WL Woo, and SS Dlay. 2007. Secure authentication for face recogni- tion. In CIISP. 121--126.
15 Antreas Dionysiou, Michalis Agathocleous, Chris Christodoulou, and Vasilis Promponas. 2018. Convolutional Neural Networks in Combination with Support Vector Machines for Complex Sequential Data Classification. InICANN. 444--455.
16 Antreas Dionysiou and Elias Athanasopoulos. 2021. Unicode Evil: Evading NLP Systems Using Visual Similarities of Text Characters. In AISEC. 1--12.
17 Carl Doersch. 2016. Tutorial on variational autoencoders. arXiv preprint arXiv:1606.05908 (2016).
18 Andries P Engelbrecht. 2007. Computational intelligence: an introduction .
19 Matt Fredrikson, Somesh Jha, and Thomas Ristenpart. 2015. Model inversion attacks that exploit confidence information and basic countermeasures. In CCS. 1322--1333.
20 Matthew Fredrikson, Eric Lantz, Somesh Jha, Simon Lin, David Page, and Thomas Ristenpart. 2014. Privacy in Pharmacogenetics: An End-to-End Case Study of Personalized Warfarin Dosing. In USENIX Security. 17--32.
21 Karan Ganju, Qi Wang, Wei Yang, Carl A Gunter, and Nikita Borisov. 2018. Property inference attacks on fully connected neural networks using permutation invariant representations. In CCS. 619--633.
22 Nikolaus Hansen, Youhei Akimoto, and Petr Baudis. 2019. CMA-ES/pycma on Github. Zenodo, DOI:10.5281/zenodo.2559634.
23 Nikolaus Hansen, Anne Auger, Raymond Ros, Steffen Finck, and Petr Pošík. 2010. Comparing results of 31 algorithms from the black-box optimization benchmarking BBOB-2009. In SIGEVO. 1689--1696.
24 Nikolaus Hansen, Sibylle D Müller, and Petros Koumoutsakos. 2003. Reducing the time complexity of the derandomized evolution strategy with covariance matrix adaptation (CMA-ES). Evol. Comput. 11, 1 (2003), 1--18.
25 Nikolaus Hansen and Andreas Ostermeier. 2001. Completely derandomized self-adaptation in evolution strategies. Evol. Comput. 9, 2 (2001), 159--195.
26 Zecheng He, Tianwei Zhang, and Ruby B. Lee. 2019. Model Inversion Attacks against Collaborative Inference. In ACSAC. 148--162.
27 Seira Hidano, Takao Murakami, Shuichi Katsumata, Shinsaku Kiyomoto, and Goichiro Hanaoka. 2017. Model inversion attacks for prediction systems: Without knowledge of non-sensitive attributes. In PST. 115--11509.
28 Seira Hidano, Takao Murakami, Shuichi Katsumata, Shinsaku Kiyomoto, and Goichiro Hanaoka. 2018. Model inversion attacks for online prediction systems: Without knowledge of non-sensitive attributes. TOIS 101, 11 (2018), 2665--2676.
29 Briland Hitaj, Giuseppe Ateniese, and Fernando Perez-Cruz. 2017. Deep models under the GAN: information leakage from collaborative deep learning. In CCS. 603--618.
30 Mahdi Khosravy, Kazuaki Nakamura, Naoko Nitta, and Noboru Babaguchi. 2020. Deep face recognizer privacy attack: Model inversion initialization by a deep generative adversarial data space discriminator. In APSIPA ASC. 1400--1405.
31 Diederik P Kingma and Jimmy Ba. 2014. Adam: A method for stochastic opti- mization. arXiv preprint arXiv:1412.6980 (2014).
32 Diederik P Kingma and Max Welling. 2013. Auto-encoding variational bayes. arXiv preprint arXiv:1312.6114 (2013).
33 Diederik P Kingma, Max Welling, et al . 2019. An introduction to variational autoencoders. Found. Trends Mach. Learn. 12, 4 (2019), 307--392.
34 Yann LeCun, Léon Bottou, Yoshua Bengio, and Patrick Haffner. 1998. Gradient- based learning applied to document recognition. Proc. of the IEEE 86, 11 (1998), 2278--2324.
35 Ziwei Liu, Ping Luo, Xiaogang Wang, and Xiaoou Tang. 2015. Deep Learning Face Attributes in the Wild. In ICCV. 3730--3738.
36 James MacQueen. 1967. Some methods for classification and analysis of multi- variate observations. In Proc. 5th Berkeley Symp. on Math. Statist. and Prob. , Vol. 1. 281--297.
37 Tanaya Mandal, Angshul Majumdar, and QM Jonathan Wu. 2007. Face recognition by curvelet based feature extraction. In ICIAR. 806--817.
38 Brian Mc Ginley, John Maher, Colm O'Riordan, and Fearghal Morgan. 2011. Maintaining healthy population diversity using adaptive crossover, mutation, and selection. TEVC 15, 5 (2011), 692--714.
39 Shagufta Mehnaz, Ninghui Li, and Elisa Bertino. 2020. Black-box model in- version attribute inference attacks on classification models. arXiv preprint arXiv:2012.03404 (2020).
40 Andrea Melle and Jean-Luc Dugelay. 2014. Scrambling faces for privacy protection using background self-similarities. In ICIP. 6046--6050.
41 Jean-Baptiste Mouret and Jeff Clune. 2015. Illuminating search spaces by mapping elites. arXiv preprint arXiv:1504.04909 (2015).
42 Anh Nguyen, Jason Yosinski, and Jeff Clune. 2015. Deep neural networks are easily fooled: High confidence predictions for unrecognizable images. In CVPR. 427--436.
43 Adam Paszke, Sam Gross, Francisco Massa, Adam Lerer, James Bradbury, Gregory Chanan, Trevor Killeen, Zeming Lin, Natalia Gimelshein, Luca Antiga, Alban Des- maison, Andreas Kopf, Edward Yang, Zachary DeVito, Martin Raison, Alykhan Tejani, Sasank Chilamkurthy, Benoit Steiner, Lu Fang, Junjie Bai, and Soumith Chintala. 2019. PyTorch: An Imperative Style, High-Performance Deep Learning Library. In NeurIPS. 8024--8035.
44 P Jonathon Phillips, Harry Wechsler, Jeffery Huang, and Patrick J Rauss. 1998. The FERET database and evaluation procedure for face-recognition algorithms. Image Vis. Comput. 16, 5 (1998), 295--306.
45 Roberto Pieraccini, Esther Levin, and Wieland Eckert. 1997. AMICA: The AT&T mixed initiative conversational architecture. In EUROSPEECH. 1875--1878.
46 Justin K Pugh, Lisa B Soros, and Kenneth O Stanley. 2016. Quality diversity: A new frontier for evolutionary computation. Front. in Robotics and AI 3 (2016), 40.
47 David E Rumelhart, Geoffrey E Hinton, and Ronald J Williams. 1985. Learning internal representations by error propagation . Technical Report. California Univ. San Diego La Jolla Inst. for Cognitive Science.
48 Ahmed Salem, Apratim Bhattacharya, Michael Backes, Mario Fritz, and Yang Zhang. 2020. Updates-Leak: Data Set Inference and Reconstruction Attacks in Online Learning. In USENIX Security. 1291--1308.
49 Ahmed Salem, Yang Zhang, Mathias Humbert, Pascal Berrang, Mario Fritz, and Michael Backes. 2019. ML-Leaks: Model and Data Independent Membership Inference Attacks and Defenses on Machine Learning Models. In NDSS.
50 Ferdinando S Samaria and Andy C Harter. 1994. Parameterisation of a stochastic model for human face identification. In W ACV. 138--142.
51 Charles Savage. 2013. Facial scanning is making gains in surveillance. The New York Times (2013).
52 Florian Schroff, Dmitry Kalenichenko, and James Philbin. 2015. Facenet: A unified embedding for face recognition and clustering. In CVPR. 815--823.
53 J Shermina. 2011. Face recognition system using multilinear principal component analysis and locality preserving projection. In GCC. 283--286.
54 Reza Shokri, Marco Stronati, Congzheng Song, and Vitaly Shmatikov. 2017. Mem- bership inference attacks against machine learning models. In SP. 3--18.
55 Florian Tramèr, Fan Zhang, Ari Juels, Michael K Reiter, and Thomas Ristenpart. 2016. Stealing machine learning models via prediction apis. In USENIX Security. 601--618.
56 Vassilis Vassiliades, Konstantinos Chatzilygeroudis, and Jean-Baptiste Mouret. 2017. Using centroidal voronoi tessellations to scale up the multidimensional archive of phenotypic elites algorithm. TEVC 22, 4 (2017), 623--630.
57 Vassiiis Vassiliades and Jean-Baptiste Mouret. 2018. Discovering the elite hyper- volume by leveraging interspecies correlation. In SIGEVO. 149--156. 203 Proceedings on Privacy Enhancing Technologies 2023(1) Dionysiou et al.
58 Xi Wu, Matthew Fredrikson, Somesh Jha, and Jeffrey F Naughton. 2016. A methodology for formalizing model-inversion attacks. In CSF. 355--370.
59 Han Xiao, Kashif Rasul, and Roland Vollgraf. 2017. Fashion-MNIST: a novel image dataset for benchmarking machine learning algorithms. arXiv preprint arXiv:1708.07747 (2017).
60 Ziqi Yang, Jiyi Zhang, Ee-Chien Chang, and Zhenkai Liang. 2019. Neural network inversion in adversarial setting via background knowledge alignment. In CCS. 225--240.
61 Matthew D Zeiler. 2012. Adadelta: an adaptive learning rate method. arXiv preprint arXiv:1212.5701 (2012).
62 Yuheng Zhang, Ruoxi Jia, Hengzhi Pei, Wenxiao Wang, Bo Li, and Dawn Song. 2020. The secret revealer: Generative model-inversion attacks against deep neural networks. In CVPR. 253--261.
附录A 黑盒优化方法
爬山法
对实数黑盒模型进行优化(如本文的任务)需要使用随机、无导数的连续优化器。爬山法(也称贪心局部搜索)是此类黑盒优化器之一。最简单形式的算法从任意解出发,通过增量改动寻找更优解,即对解的所有特征或随机选择的一个特征添加从高斯分布中抽取的噪声。如果随机改动使解更优,则保留新解。该过程持续进行,直到满足某个停止条件,例如达到最大迭代次数。某些变体可以按特征调整噪声分布或学习率,直至观察不到进一步显著改进。因此,自适应爬山算法可能收敛更快,甚至提供更好的解。
爬山法简单,因此适用于处理广泛的简单问题。但在具有多个最优点、脊线和平坦区域的非凸函数问题中,其贪心特性可能成为缺点。因此,进化算法作为全局优化器发展起来,具备更好的机制,可以跳出局部最优。
进化算法(EA)
对于无法使用基于梯度的方法求解的非凸优化问题,进化算法已成为一种常见选择18。进化算法遵循生物进化原理,采用选择、变异和替换等机制。简单进化算法按以下步骤运行:随机初始化并评估一组解;使用适应度(目标)函数计算每个解的适应度(表现);在每代中,对选中的父代个体进行变异(重组和/或突变),产生新的个体(候选解或后代),并替换适应度较低的个体。此过程持续进行,直至满足停止条件。
进化算法采用基于种群的方法,探索能力更强,并有更多机会找到全局最优解,因此本质上具有较好的鲁棒性。此外,它们很容易并行化,因此在现代硬件上效率更高24。本文采用两个进化算法家族中的算法:进化策略7和质量多样性算法12, 13, 41, 46, 56, 57。进化策略通过给候选解增加特定"策略参数"(例如每个特征对应的突变强度),并随时间调整这些参数,以加速进化优化。CMA-ES25是最先进的算法之一,实验表明,它在多种问题上具有较好的收敛特性23。它利用多元高斯搜索分布采样新的候选解,并将均值调整到适应度较高解的方向,同时调整协方差矩阵,提高以往成功搜索步长再次出现的可能性。
与此不同,质量多样性(QD)算法不追求快速收敛到单个全局最优解,而是在一次运行中返回数量众多且多样化的高质量解。从本质上说,它们尝试呈现特征空间不同区域的适应度潜力。用户可能希望在该特征空间中保持多样性,例如进化得到的机器人形态的体重和身高,而适应度函数可以是机器人向前移动的距离。MAP-Elites算法12, 41是最简单的QD算法之一:它将特征空间离散为网格,并尝试将一个后代放入相应网格单元;若该单元为空,或后代适应度高于当前占用该单元的解,则放入该后代。
CVT-MAP-Elites56解决了MAP-Elites无法利用高维特征空间这一主要缺点。它将特征空间划分为若干均匀区域,每个区域以其质心点表示。通常的做法是对特征空间均匀采样,再使用k-means聚类算法36找到k个聚类。此后,算法与以往相同,只是将后代所属"网格单元"定义为距其最近的质心所在区域。
附录B 所用模型
VAE的数学形式
VAE是生成模型,旨在近似输入样本(如图像)x∈R^dx、x∼P(x)的未知概率分布P(x)。VAE采用类似传统自编码器47的编码器---解码器结构,将样本压缩(编码)到更低维空间z∈R^dz(dz远小于dx),并尽可能准确地重建(解码)样本,同时以规则方式组织潜在空间,使其中的样本服从正态分布。
具体而言,VAE使用概率编码器计算qφ(z|x)=N(μ(x), σ(x)),近似后验分布p(z|x);使用概率解码器计算条件似然分布pθ(x|z)。均值μ(x)∈R^dz和标准差σ(x)∈R^dz分别通过函数fμ和fσ计算,二者通常共享某个组件(一个神经网络),即μ(x)=fμ(fe(x)),σ(x)=fσ(fe(x))。
潜在编码z从近似后验分布z∼N(μ(x),σ(x))中采样,然后输入解码器函数fd(通常是神经网络)以重建输入,即x̂=fd(z),x̂∈R^dx。为了使反向传播可行,即能够通过上述采样操作计算梯度,VAE使用重参数化技巧:z=μ(x)+ε⊙σ(x),其中⊙表示逐元素乘积,ε∼N(0,I),ε∈R^dz是一个外部输入,用于向潜在空间注入噪声。
给定数据点x,VAE的损失函数如下:
Lθ,φ(x) = −Ez∼qφ(z\|x)log pθ(x\|z) + D_KL(qφ(z|x) || p(z))
= ||x − x̂||² + D_KL(N(μ(x), σ(x)) || N(0, I)) (1)
第一项是重建损失,即x的期望负对数似然;第二项是编码器分布qφ(z|x)与p(z)=N(0,I)之间的Kullback--Leibler散度。该项可视作正则化器,促使编码器输出服从正态分布。更多细节见17, 32, 33。
本文关注图像数据,因此使用CVAE,即编码器fe采用卷积结构,解码器fd采用反卷积结构(见图15)。为避免训练CVAE时过拟合,我们在卷积层中使用dropout,并采用提前停止。请注意,搜索CVAE潜在空间的过程在推理阶段进行,因此过拟合这一概念并不适用。
关注泛化能力良好的目标
证明用于评估模型反演框架的机器学习模型具有良好的泛化能力至关重要,原因有二:(a)已有研究表明,与泛化能力良好的模型相比,过拟合机器学习模型更容易受到类似隐私攻击49, 54;(b)面对泛化能力良好的目标是常见情形,因为许多成熟的机器学习即服务(MLaaS)平台和机器学习专家会在隐私敏感模型部署前提高模型性能和泛化能力。因此,有必要展示场景1和场景2中目标模型和攻击者模型的训练/测试损失与训练周期关系曲线(见图14)。如图所示,所有机器学习模型的训练损失和测试损失都持续下降,并最终趋于稳定。这些图与第3节报告的训练/测试准确率共同证明,我们的模型已在相应数据集上正确训练,达到较高的性能和泛化能力。
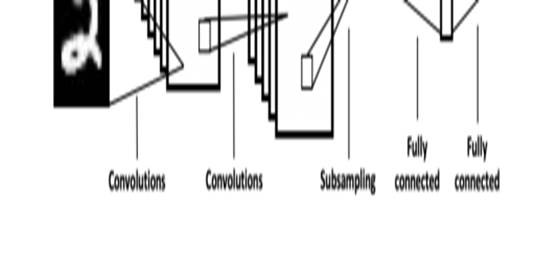
图13 目标CNN由5层组成:2个卷积层(C1、C2)、1个下采样层(S3)和2个全连接层(FC4、O5)。C1和C2采用3×3卷积、步幅为1,并以ReLU为激活函数。S3层使用2×2滤波器、步幅为2的最大池化。FC4和O5层分别使用ReLU和Log-Softmax作为激活函数。请注意,对于AT&T数据集(场景2),我们使用结构相似但更深的CNN。
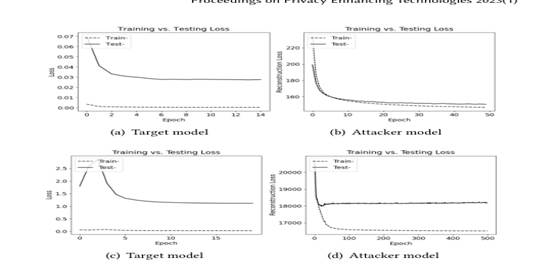
图14 场景1(a-b)和场景2(c-d)中目标模型与攻击者模型的训练/测试损失随训练周期变化的曲线。
附录C Deep-BMI的黑盒优化器
HC
首先,HC生成一个大小为1×20的随机向量,作为待优化向量current_point。接着,优化器将该随机向量输入CVAE解码器部分,评估其表现。然后算法复制初始向量,得到new_point,从待优化向量的20个特征中随机选择一个,为new_point对应特征添加从高斯分布抽取的随机噪声,再评估new_point。如果new_point的得分高于current_point,算法就保存current_point及其得分,并进入下一次迭代。最后,算法展示对给定target_class能产生最高置信度分数的图像。
自适应HC
这是前一种优化器的自适应版本。该优化器对当前解进行自适应改动,以实现某种受控加速。总体运行方式与HC相同,但自适应HC还指定以下参数:(a)step_size:每个特征要改动的幅度,其大小与待优化向量相同;(b)加速度因子:控制学习速度,即待优化向量各元素的变化;(c)candidate表:包含可用选项,这些选项与对应step_size相乘后用于更新向量特征。总之,算法会测试所有候选改动,并据此调整学习速度。达到最大迭代次数max_iterations,或两个连续向量版本的表现差异小于用户提供的epsilon值时,算法即结束。
CMA-ES
该优化器的核心实现取自文献22。目标函数返回给定样本针对目标类别的置信度分数。首先,优化器创建一个大小为1×20的随机向量top_similar_encoding。然后,脚本使用待优化向量top_similar_encoding及初始标准差0.5,初始化CMA-ES实例。之后,优化器在提供目标函数(用于确定各解的置信度分数)的同时开始优化过程。最后,CMA-ES将优化后的向量输入CVAE解码器,重建并展示能够以最高置信度触发目标类别的图像。
MAP-Elites
优化算法尝试在搜索空间中找到表现最高的解;而照亮算法旨在为特征空间的每个位置返回表现最高的解41。因此,它们能够展现特征空间各区域的适应度潜力。"照亮"一词正是由此而来。MAP-Elites属于照亮算法:它为每个目标类别返回多个解,并最大化这些解的多样性。首先,优化器创建一个大小为10×20的映射,用于存放每个目标类别对应的解;并创建一个大小为1×10的表现表来保存各自的表现。之后,每次迭代中,算法使用(a)文献38所述交叉函数,以及(b)场景1采用多项式突变、场景2采用高斯突变,生成两个新向量child_1和child_2。突变和交叉策略由random_variation()函数实现,该函数接收向量映射作为参数。随后,算法评估这两个子代;如果其表现优于当前向量,就将其放入映射。达到最大迭代次数max_iterations时,算法停止。最后,优化器将映射中的每个向量输入CVAE解码器,并重建、展示能够以最高置信度触发各目标类别的图像。
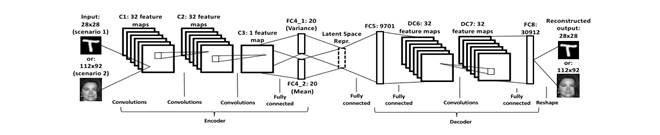
图15 攻击者CVAE由8层组成:3个卷积层(C1、C2、C3)、2个反卷积层(DC6、DC7)以及4个全连接层(FC4_1、FC4_2、FC5、FC8)。C1、C2和C3采用2×2卷积、步幅为1,并以ReLU为激活函数。DC6和DC7采用2×2反卷积、步幅为2,并以ReLU为激活函数。FC4_1、FC4_2、FC5和FC8分别使用ReLU和Sigmoid激活函数。请注意,我们也在卷积层中应用dropout以提高模型的泛化能力。
译文表格
表1 现有模型反演攻击的定性定位
表中每篇论文根据其攻击实用性和目标复杂度归类;本文探讨对中等复杂度图像识别模型实施完全不了解目标内部结构的攻击。
|---------|------------------------------------|---------------|------------------------------|
| 目标模型复杂度 | 白盒攻击 | 黑盒:部分了解目标内部 | 黑盒:完全不了解目标内部 |
| 中等 | 19、26、29、60、62 | 26、48 | Deep-BMI、4、19、60 |
| 低 | 27、48、58 | 20、58 | 39 |
表2 图像识别领域模型反演攻击者概览
符号"•"和"◦"分别表示相应论文完全或部分满足该列所述条件;"---"表示否。攻击范围列为"全部/部分目标模型训练数据"。
|--------------------|--------|---------|-----------|------|--------|-------|------|------|
| 攻击者 | 使用替代模型 | 不依赖目标结构 | 不依赖目标训练数据 | 需后处理 | 需训练数据集 | 全类别攻击 | 每类多解 | 攻击范围 |
| Fredrikson等人19 | --- | ◦ | ◦ | • | --- | --- | --- | 全部 |
| Aïvodji等人4 | • | ◦ | ◦ | • | • | --- | --- | 全部 |
| He等人26 | • | ◦ | --- | --- | • | --- | --- | 全部 |
| Hitaj等人29 | --- | --- | ◦ | --- | • | --- | --- | 全部 |
| Zhang等人62 | --- | --- | ◦ | --- | • | --- | --- | 全部 |
| Salem等人48 | • | --- | --- | --- | • | --- | --- | 部分 |
| Yang等人60 | --- | --- | ◦ | --- | • | --- | --- | 全部 |
| 随机采样 | --- | ◦ | ◦ | --- | • | --- | --- | 全部 |
| HC | --- | ◦ | ◦ | --- | • | --- | --- | 全部 |
| 自适应HC | --- | • | • | --- | • | --- | --- | 全部 |
| CMA-ES | --- | • | • | --- | • | --- | --- | 全部 |
| MAP-Elites | --- | • | • | --- | • | • | --- | 全部 |
| CVT-MAP-Elites | --- | • | • | --- | • | • | • | 全部 |
注:表2按照原文的列项和标记重建;空白或短横线按否处理。