LLM 训练系列(总览):从数据工程到推理部署
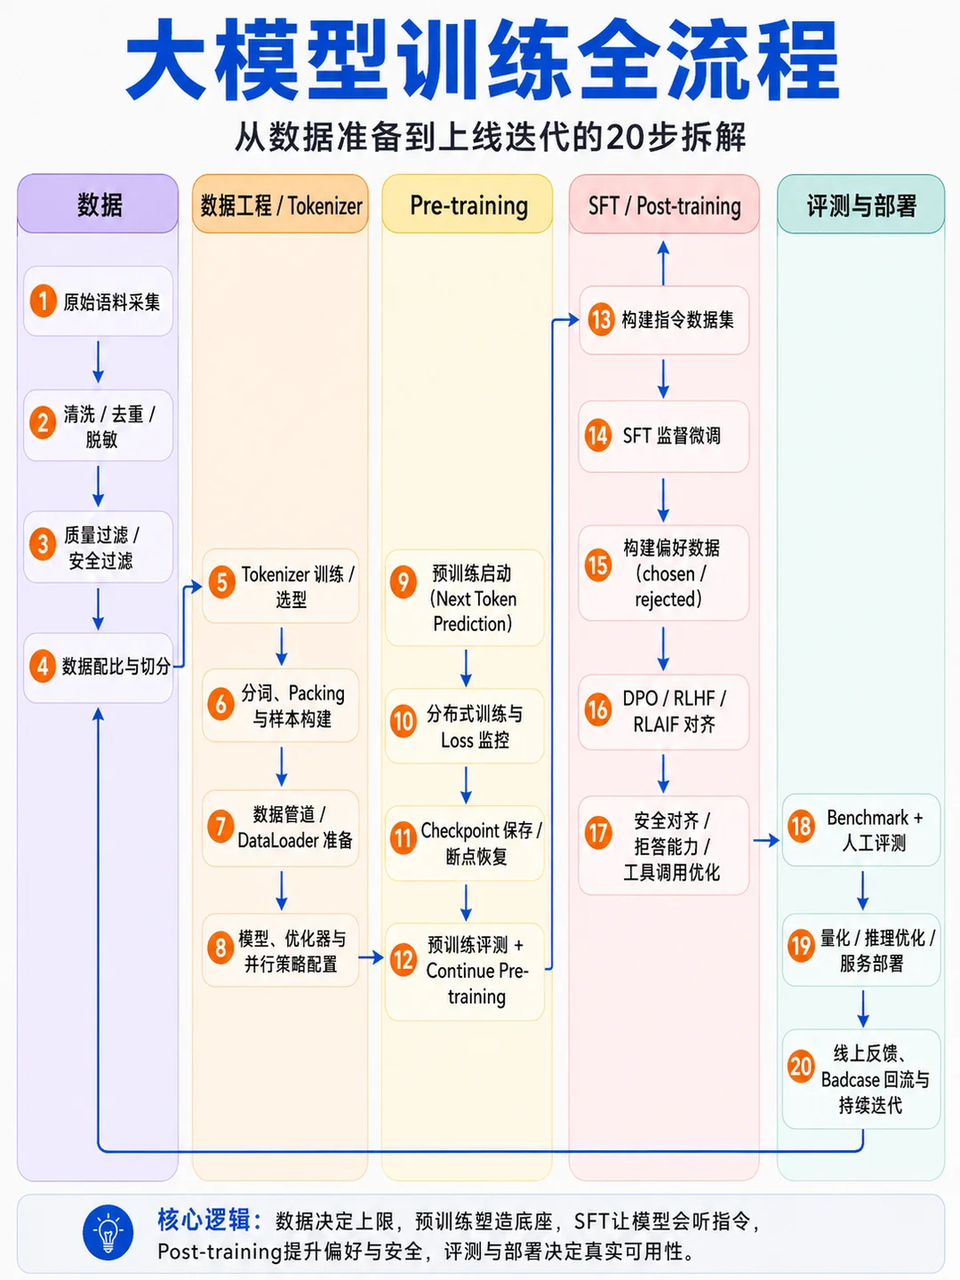
大语言模型的完整生命周期不只有"微调"。从数据准备到最终提供 API 服务,通常会经历数据工程、预训练、后训练、评测和部署等环节。
本文主要以 Decoder-only 自回归大语言模型为例,先建立全局认识,再通过三篇专题分别介绍预训练、后训练和参数更新策略。
系列导读
本系列暂时包含一篇总览和三篇专题文章,文章发布后可以在此补充 CSDN 链接。
| 系列位置 | 文章主题 | 主要内容 |
|---|---|---|
| 总览(本文) | LLM 训练系列(总览):从数据工程到推理部署 | 数据工程、预训练、后训练、评测和部署 |
| 第一篇 | LLM 训练系列(一):预训练------通用预训练与持续预训练 | CLM、Next Token Prediction、Base Model |
| 第二篇 | LLM 训练系列(二):后训练------SFT 与偏好对齐 | SFT、PPO、DPO、GRPO |
| 第三篇 | LLM 训练系列(三):参数更新策略------Full FT、LoRA 与 QLoRA | Full FT、LoRA、QLoRA 与 PEFT |
一、LLM 训练先看全貌
1.1 先区分四个核心维度
理解 LLM 训练体系时,需要区分四个维度:
| 维度 | 回答的问题 | 典型概念 |
|---|---|---|
| 生命周期阶段(Stage) | 当前处于哪个训练环节 | 预训练、持续预训练、后训练 |
| 训练任务或目标(Objective) | 模型正在优化什么 | CLM、监督交叉熵、偏好或奖励目标 |
| 训练或优化方法(Method) | 如何把目标转化为训练过程 | SFT、DPO、PPO、GRPO |
| 参数更新策略(Update Strategy) | 模型中的哪些参数会更新 | Full FT、LoRA、QLoRA |
可以先记住三句话:
- 预训练和后训练描述模型所处的生命周期阶段。
- SFT、DPO、PPO、GRPO描述不同的训练范式或优化方法。
- Full FT、LoRA、QLoRA描述参数如何更新,可以与多个训练阶段组合。
1.2 LLM 从训练到部署的完整流程
text
0. 数据工程(Data Engineering)
   ├─ 数据收集、过滤、清洗、去重和质量筛选
   ├─ 训练集、验证集和测试集划分
   ├─ 评测集污染检查与敏感信息处理
   ├─ Tokenizer 构建或加载
   └─ 分词、截断、Packing 和训练样本构建

1. 预训练(Pre‑training)
 ├─ 通用预训练(General Pre‑training)
 │  ├─ 数据准备
 │  │  ├─ 高质量通用文本语料
 │  │  ├─ 文本转 Token ID 序列
 │  │  └─ 按 max_seq_len 切块
 │  │
 │  ├─ 预训练任务
 │  │  └─ CLM 因果语言建模
 │  │    ↓
 │  │    自监督 Next Token Prediction
 │  │    ↓
 │  │    Cross Entropy Loss
 │  │
 │  ├─ 训练流程
 │  │  ├─ Transformer 前向传播(Causal Mask 屏蔽未来 Token)
 │  │  ├─ 反向传播参数更新
 │  │  ├─ 梯度裁剪 Gradient Clipping
 │  │  ├─ AdamW 优化器更新参数
 │  │  └─ 训练 Loss / 验证集 PPL 监控
 │  │
 │  └─ 输出:Base Model(通用基座模型)
 │
 └─ 持续预训练(Continued Pre‑training,可选)
    ├─ 输入:通用 Base Model
    ├─ 训练数据:领域专属语料(代码、金融、医学、法律、多语言等)
    └─ 输出:Domain Adapted Model(领域增强基座模型)

2. 后训练(Post‑training)
 ├─ 第一阶段:SFT 指令微调(Supervised Fine‑Tuning)
 │   输入:人工标注、机器合成、Self‑Instruct、蒸馏、推理轨迹数据
 │   目标:学习指令交互行为分布,拟合人类对话范式,不直接优化人类偏好
 │      ↓
 │   Instruction Model(指令交互模型)
 │
 └─ 第二阶段:Preference Alignment 偏好对齐
    (通用对话模型一般基于 SFT 模型;推理模型可从 Base Model 或 SFT Model 开始进行可验证奖励 RL)
    目标:提升模型有用性、真实性、安全性、输出风格贴合人类偏好
    ├─ 基于强化学习的对齐方法(RL‑based)
    │  ├─ PPO
    │  ├─ GRPO
    │  └─ 其他
    │
    └─ 非强化学习的偏好优化方法(Non‑RL Preference Optimization)
       ├─ DPO
       ├─ IPO
       ├─ KTO
       ├─ ORPO
       └─ 其他


3. 评测(Evaluation)
   ├─ 通用能力与专业能力评测
   ├─ 人工偏好评测
   ├─ 安全、风险和鲁棒性评测
   └─ 回归测试与上线门禁

4. 部署(Deployment)
   ├─ 模型量化和推理优化
   ├─ 推理框架与服务化
   ├─ API、限流、监控和灰度发布
   └─ 收集反馈并进入下一轮数据与训练迭代
二、LLM 生命周期的主要阶段
2.1 数据工程:模型训练之前先准备数据
数据工程决定模型能学到什么,也会直接影响模型质量、安全性和评测可信度。
常见步骤包括:
- 从网页、书籍、代码、论文、业务文档等来源收集数据。
- 删除乱码、广告、模板文本和明显低质量内容。
- 进行精确去重和近似去重,降低数据重复带来的偏差。
- 处理个人敏感信息、版权风险和不安全内容。
- 检查训练数据是否包含评测集答案,避免评测污染。
- 使用 Tokenizer 把文本转换为 Token ID。
- 按上下文长度截断、拼接并构建训练样本。
text
原始文本
   ↓
清洗、过滤、去重
   ↓
Tokenizer:文本 → Token ID
   ↓
截断、Packing、样本构建
   ↓
训练数据集
2.2 预训练:让模型获得基础能力
预训练通常包括通用预训练,以及可选的持续预训练:前者用于构建模型的基础能力,后者用于让已有 Base Model 继续适应特定领域或新的数据分布。
text
1. 预训练(Pre‑training)
 ├─ 通用预训练(General Pre‑training)
 └─ 持续预训练(Continued Pre‑training,可选)
对于主流 Decoder-only LLM,通用预训练通常采用 CLM(Causal Language Modeling,因果语言建模)任务。
预训练语料不需要人工逐条标注。训练标签可以通过文本序列右移自动生成,因此 Next Token Prediction 属于自监督学习。训练时还会使用 Causal Mask 屏蔽未来 Token,防止模型提前看到需要预测的答案。
模型看到前面的 Token,并预测下一个 Token:
text
输入:今天 天气 很
目标:好
训练时会计算每个位置上的预测概率与真实 Token 之间的交叉熵损失,再通过反向传播更新模型参数。
text
海量通用文本
   ↓
Next Token Prediction
   ↓
Cross Entropy Loss
   ↓
反向传播与参数更新
   ↓
Base Model
训练过程中通常会监控训练 Loss、验证集 Loss 和 PPL,并结合 Token Budget、训练步数和下游能力评测决定何时停止。
通用预训练最终得到 Base Model。它通常具备语言生成、知识建模以及一定的推理、代码或多语言能力,但不一定能够稳定地遵循指令或进行多轮对话。
如果在 Base Model 上继续使用医学、法律、金融、代码或多语言原始语料训练,通常称为持续预训练。
text
Base Model
   +
领域原始语料
   ↓
Continued Pre-training
   ↓
Domain-adapted Base Model
持续预训练是否必需
持续预训练是可选阶段。对于大多数直接使用现成大模型构建的应用,通常不需要进行持续预训练。
- 如果基座模型与目标领域存在明显的数据分布差异或基础能力差距,并且拥有大量高质量领域原始语料,可以进一步评估持续预训练。
- 如果只是需要补充最新或私有知识,通常优先考虑 RAG;如果主要问题是指令遵循或输出格式,通常优先考虑 SFT。
2.3 后训练:让模型学会交互和对齐
典型的后训练通常从 SFT 开始,再根据目标选择基于强化学习的对齐方法或直接偏好优化方法,但这不是所有模型都必须遵循的固定顺序。
Base Model 具备语言建模能力,但不一定能够稳定地理解指令、遵循对话格式或调用工具,因此通常还需要后训练。
text
2. 后训练(Post‑training)
 ├─ 第一阶段:SFT 指令微调(Supervised Fine‑Tuning)
 └─ 第二阶段:Preference Alignment 偏好对齐
SFT:从示范答案中学习
SFT 使用指令与回答、多轮对话、工具调用和推理轨迹等监督数据,让模型学习期望的交互行为。
text
Prompt + 标准回答
   ↓
监督微调
   ↓
Instruction Model
SFT 常使用自回归 Token-level Cross Entropy Loss。工程上经常只对 Assistant 回答部分计算损失,但这是一种常见掩码策略,并不是 SFT 唯一可能的实现。
偏好或奖励对齐:在多个可能输出中进一步优化
SFT 主要从示范中学习"应该怎样回答",偏好或奖励对齐则进一步提供"哪些回答更好"的训练信号。
常见方法包括:
- PPO:经典 RLHF 中常见,需要策略模型、参考模型、奖励信号和价值估计。
- DPO:直接使用
chosen/rejected偏好对进行优化,不显式训练 Reward Model。 - GRPO:为同一个 Prompt 采样多个回答,根据组内奖励估计相对优势,不训练独立 Critic。
2.4 评测和部署:训练完成不等于可以上线
模型训练完成后,还需要验证它是否真正满足目标。
评测通常包括:
- 验证集 Loss 和 PPL。
- 通用知识、推理、代码和领域能力基准。
- 人工偏好与业务任务评测。
- 幻觉、安全、偏见和对抗测试。
- 与上一版本比较的回归测试。
评测通过后,才进入量化、推理优化和服务化阶段:
text
训练完成的模型
   ↓
量化、蒸馏或算子优化
   ↓
vLLM / TensorRT-LLM / llama.cpp 等推理框架
   ↓
API 服务
   ↓
监控、反馈和下一轮训练
三、参数更新策略与常见误区
3.1 参数更新策略:哪些权重真正发生变化
训练任务与参数更新策略属于不同维度。
以 SFT 为例,可以选择:
text
SFT + Full Fine-tuning
SFT + LoRA
SFT + QLoRA
DPO 和 GRPO 等训练也可以根据工程实现选择全量更新或 PEFT。
| 策略 | 基座权重 | 可训练参数 | 主要特点 |
|---|---|---|---|
| Full FT | 更新 | 全部或几乎全部模型参数 | 效果上限高,训练成本大 |
| LoRA | 通常冻结 | 低秩适配器 | 参数少、训练成本低、适合多任务切换 |
| QLoRA | 低比特量化并冻结 | 高精度 LoRA 适配器 | 进一步降低基座权重的显存占用 |
3.2 容易混淆的三个问题
问题一:SFT 和 LoRA 是一回事吗?
不是。SFT 描述训练过程,LoRA 描述参数如何更新。
问题二:DPO 和 GRPO 都是偏好数据训练吗?
不完全是。DPO 通常使用离线偏好对;GRPO 属于强化学习方法,需要对采样结果提供奖励信号。
问题三:PEFT 是否只用于 SFT?
不是。LoRA、QLoRA 是参数高效更新方案,也可以用于持续预训练和偏好对齐,但是否合适取决于数据规模、目标和实现。
四、总结
LLM 从数据到上线的大致链路可以概括为:
text
数据工程
   ↓
通用预训练
   ↓
持续预训练(可选)
   ↓
SFT
   ↓
偏好或奖励对齐(可选但常见)
   ↓
评测
   ↓
部署与反馈迭代
理解整个体系的关键,是不要把"训练阶段、训练方法和参数更新策略"混为一谈。
参考资料
- LoRA: Low-Rank Adaptation of Large Language Models
- QLoRA: Efficient Finetuning of Quantized LLMs
- Direct Preference Optimization
- DeepSeekMath:GRPO
个人声明: 本文为个人学习笔记,如有错误,欢迎指正。