内容摘要
This guide walks through a single-strategy sync that pulls CRM return-order product lines into MySQL on a 10-minute cadence, using Qeasy's WebAPI-to-SQL mapping. It emphasizes header-first phasing, business-key idempotency, float precision handling, and the dual-track incremental-plus-full scheduling pattern.
核心要点
- 先同步退货单表头,再带表头 ID 拉行项目,避免孤儿行。
- 目标表必须用业务唯一键(`returned_goods_inv_id + product_code__c`)加唯一索引,保证幂等。
- 浮点价格字段在中间层不要四舍五入,MySQL 端用 `DECIMAL` 接住。
- 源端与目标端调度错开(`*/10` 与 `3-59/10`),防止同窗抢资源。
- 自定义字段(如赠品标识)在初次配置时按 schema 全量勾选,避免后续统计缺失。
这个策略解决什么问题
在某零售企业的供应链系统里,退货流程涉及两套系统:CRM(本文以纷享销客为代表)负责前端开单与审批,MySQL 数据仓库负责后续的财务核算与库存冲销。退货单一旦在 CRM 里生效,明细行就要立刻同步到 MySQL,否则下游对账就会少一笔。但实际跑下来,常见痛点是:退货单表头同步了,产品行项目漏了;或者行同步了,赠品、规格、退货单价对不上,导致 3 个月后两边数字根本对不齐。
我们要做的就是一条策略:把纷享销客里的退货单产品(ReturnedGoodsInvoiceProductObj),按调度节奏,完整、准确地落到 MySQL 的退货单产品明细表里。
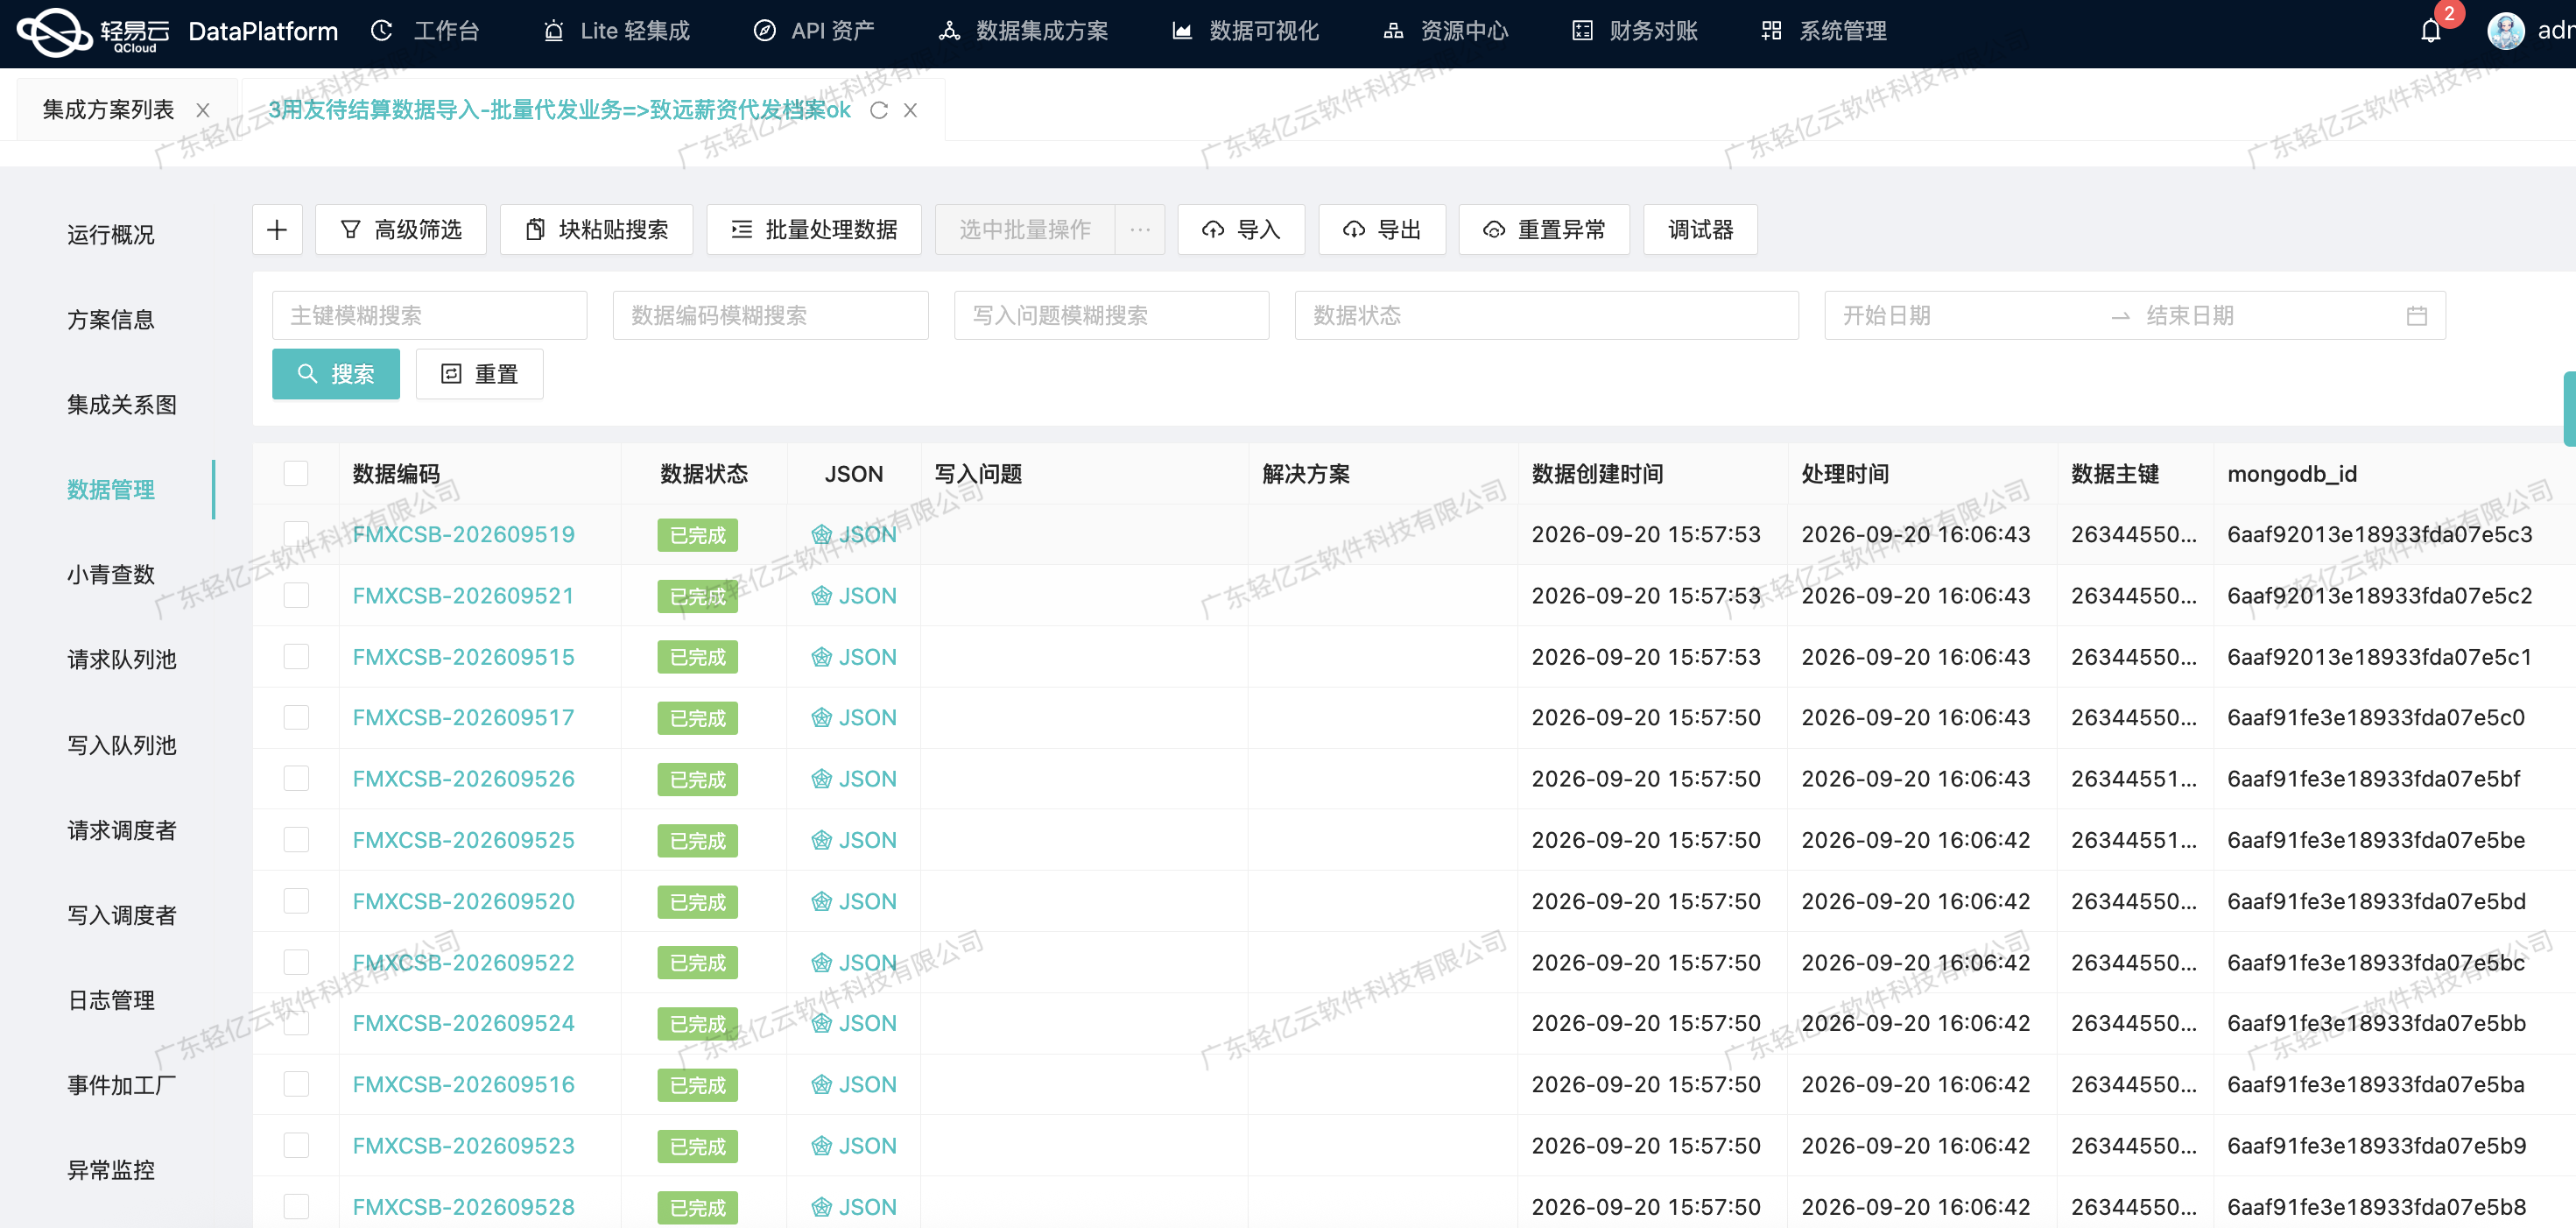
数据流向与字段映射
整体流向是:纷享销客(源)→ 轻易云数据集成平台(中间层)→ MySQL(目标)。
源端通过 WebAPI(/cgi/crm/v2/data/query)以 POST 方式查询退货单产品对象,目标端通过 SQL(batchexecute)执行批量写入。下面是核心字段对照:
| 业务含义 | 源端字段(纷享销客) | 目标字段(MySQL) | 类型 | 备注 |
|---|---|---|---|---|
| 退货单编号 | returned_goods_inv_id__r | returned_goods_inv_id | string | 关联退货单表头 |
| 产品编码 | product_code__c | product_code__c | string | 主键之一 |
| 产品名称 | product_id__r | product_id | string | 关联产品档案 |
| 退货单价 | returned_product_price | returned_product_price | float | 注意精度 |
| 规格 | specs | specs | string | 来源端可直接透传 |
| 是否赠品备注 | field_BMa8W__c | field_BMa8W__c | string | 自定义字段 |
映射规则有两类典型做法:编码映射集中管理 (产品编码、客户编码单独维护映射表,变更只改一处),表头表体分阶段(先同步退货单表头并落库,再带表头 ID 去拉行项目)。本策略采用后者,避免出现"孤儿行"。
在轻易云上如何配置
在轻易云数据集成平台(Qeasy)中,这条策略属于典型的"源 WebAPI + 目标 SQL"组合。配置要点如下:
- 源端连接器 :选择纷享销客适配器,填入
dataObjectApiName = ReturnedGoodsInvoiceProductObj,并配置currentOpenUserId作为操作用户,保证接口权限一致。 - 目标端连接器 :选择 MySQL 适配器,执行模式为
batchexecute,主键字段id开启idCheck=true,避免重复写入。 - 字段映射 :在轻易云的映射画布里,把源端字段拖到目标字段,变量占位用
{``{字段名}},例如{``{returned_product_price}}。浮点字段建议在映射中保留原始精度,不要在中间层四舍五入。 - 去重与幂等 :以
returned_goods_inv_id + product_code__c作为业务唯一键,目标表加唯一索引,重复时走更新而非插入。
实施步骤
我们在客户现场通常按三步走:
- 全量触发(初始化):策略上线当晚手工跑一次全量,把已存在的退货单产品一次性补到 MySQL。这一步只跑一次,用于校准基线。
- 增量起点:在源端查询条件里加上"最后修改时间 > 上次同步成功时间",把全量跑完的时间戳作为增量起点。
- 调度频率 :源端 crontab 设为
*/10 * * * *(每 10 分钟拉一次),目标端设为3-59/10 * * * *(错开 3 分钟),防止两端在同一时间窗抢资源。这一组双轨调度是轻易云客户里很常见的应对模式------增量与全量双轨,日常走增量,异常时一键回退到全量。
上线后建议先用影子环境跑 24 小时,核对两边行数和金额,无误再切生产。
踩坑复盘
下面是这条策略最容易翻车的几个点:
- 退货单表头没先行落库 。如果直接拉行项目,
returned_goods_inv_id__r在 MySQL 里会找不到外键关联。稳妥做法是先跑表头策略,再跑行项目。 - 浮点价格被中间层截断 。
returned_product_price在源端是 float,经过 JSON 序列化后可能出现精度丢失,建议在映射里显式声明为高精度数值,或在 MySQL 端用DECIMAL类型接住。 - 赠品/自定义字段被默认忽略 。
field_BMa8W__c这类自定义字段容易在初次配置时被漏掉,导致后续做"是否赠品"统计时数据缺失。配置时一定要对照源端 schema 全量勾选。 - 操作用户权限不一致 。
currentOpenUserId配错或失效,接口会返回空数据,但不报错,排查极费时间。建议每次同步后做"返回行数 + 抽样校验"双重确认。 - 重复写入导致主键冲突 。目标表如果只用自增
id做主键,增量同步时容易冲突。务必把业务唯一键也加上唯一索引。
适用场景与不适用场景
适用:CRM 作为退货业务入口、MySQL 作为核算/报表底座、数据量在单表千万级以内、对实时性要求在分钟级的零售与分销企业。
不适用:退货流程完全在 ERP 内闭环(无需 CRM),或需要秒级实时反写库存的场景,后者建议走消息队列 + CDC 方案。