最近谷歌发布的 EmbeddingGemma 2 ,终于是把端侧的文本向量模型扩成了一套端侧多模态检索 backbone,支持 740M 参数、 100+ 语言,文本、代码、图片、视频和音频进入同一个 embedding space,甚至视觉和音频 encoder 都可以按需组合,另外上下文也从 2K 拉到 8K,代码检索能力明显提升了不少。
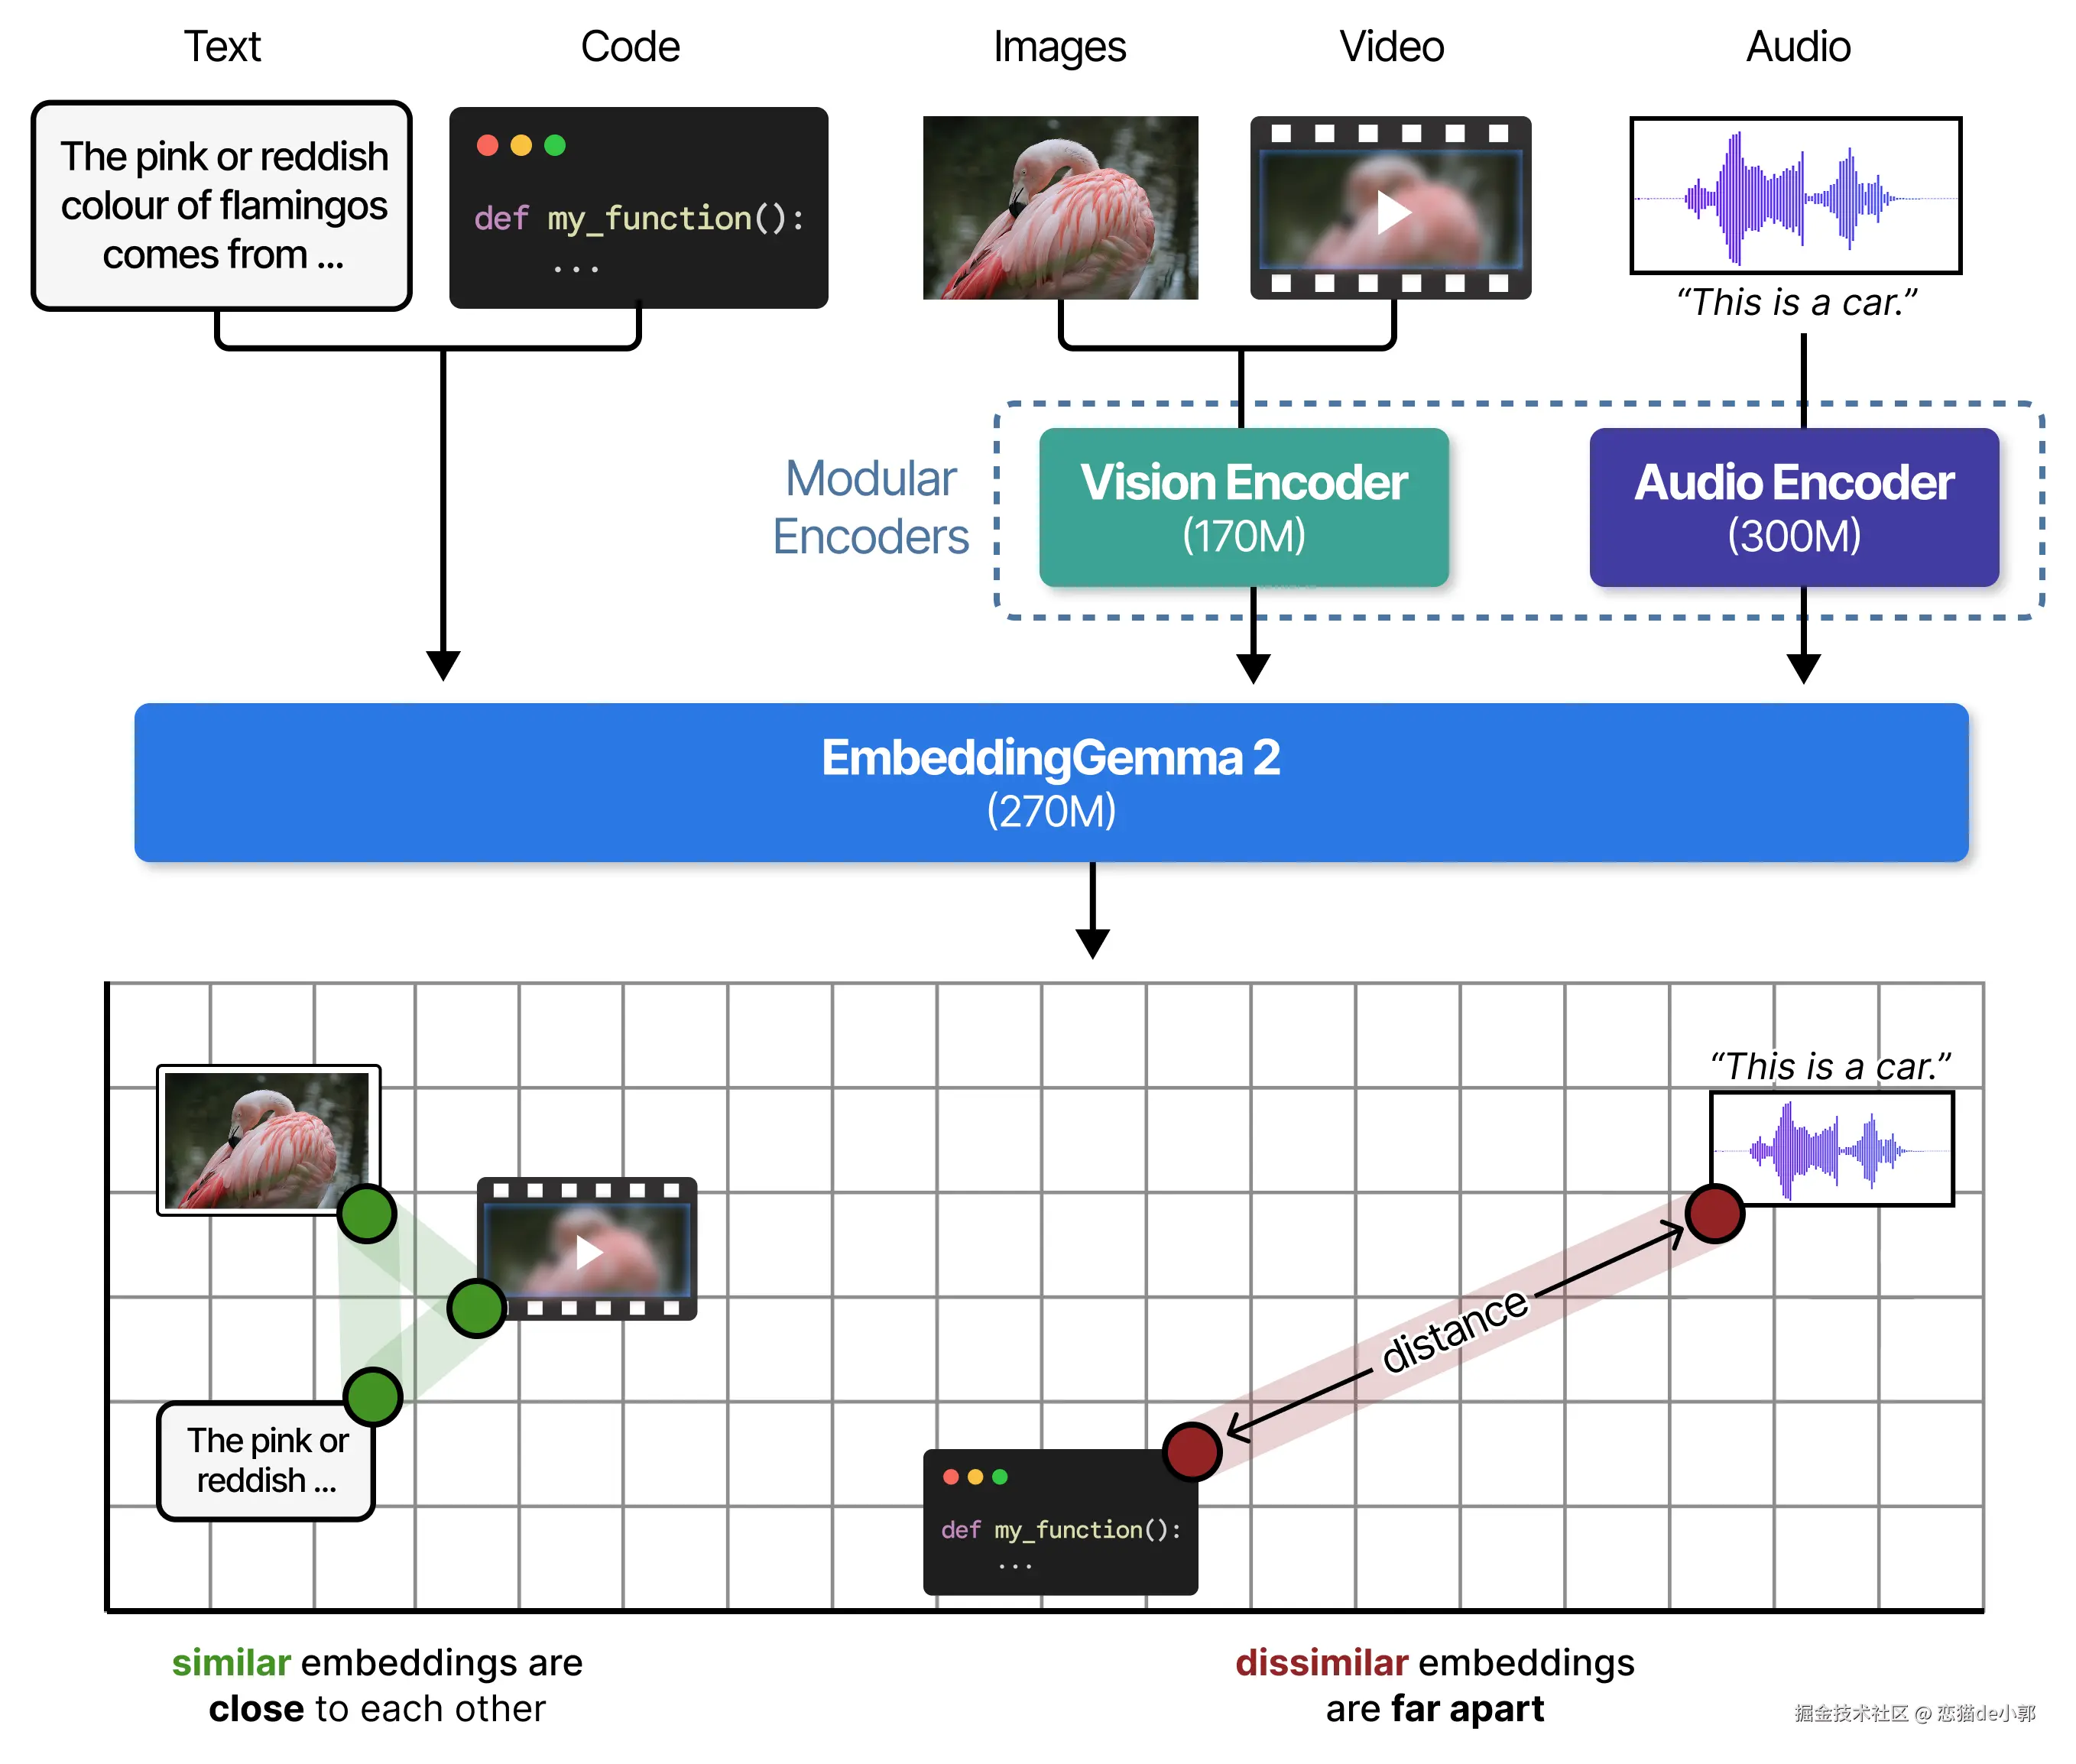
这里 EmbeddingGemma 2 做的核心事情,就是把 text、code、image、video、audio 还有它们的组合都映射到统一的 768 维 embedding space,这样子查询可以只是普通文字,但候选项会时来自文本、图片、视频和音频,特别是反过来也可以拿一段 voice memo 去找相关视频片段。
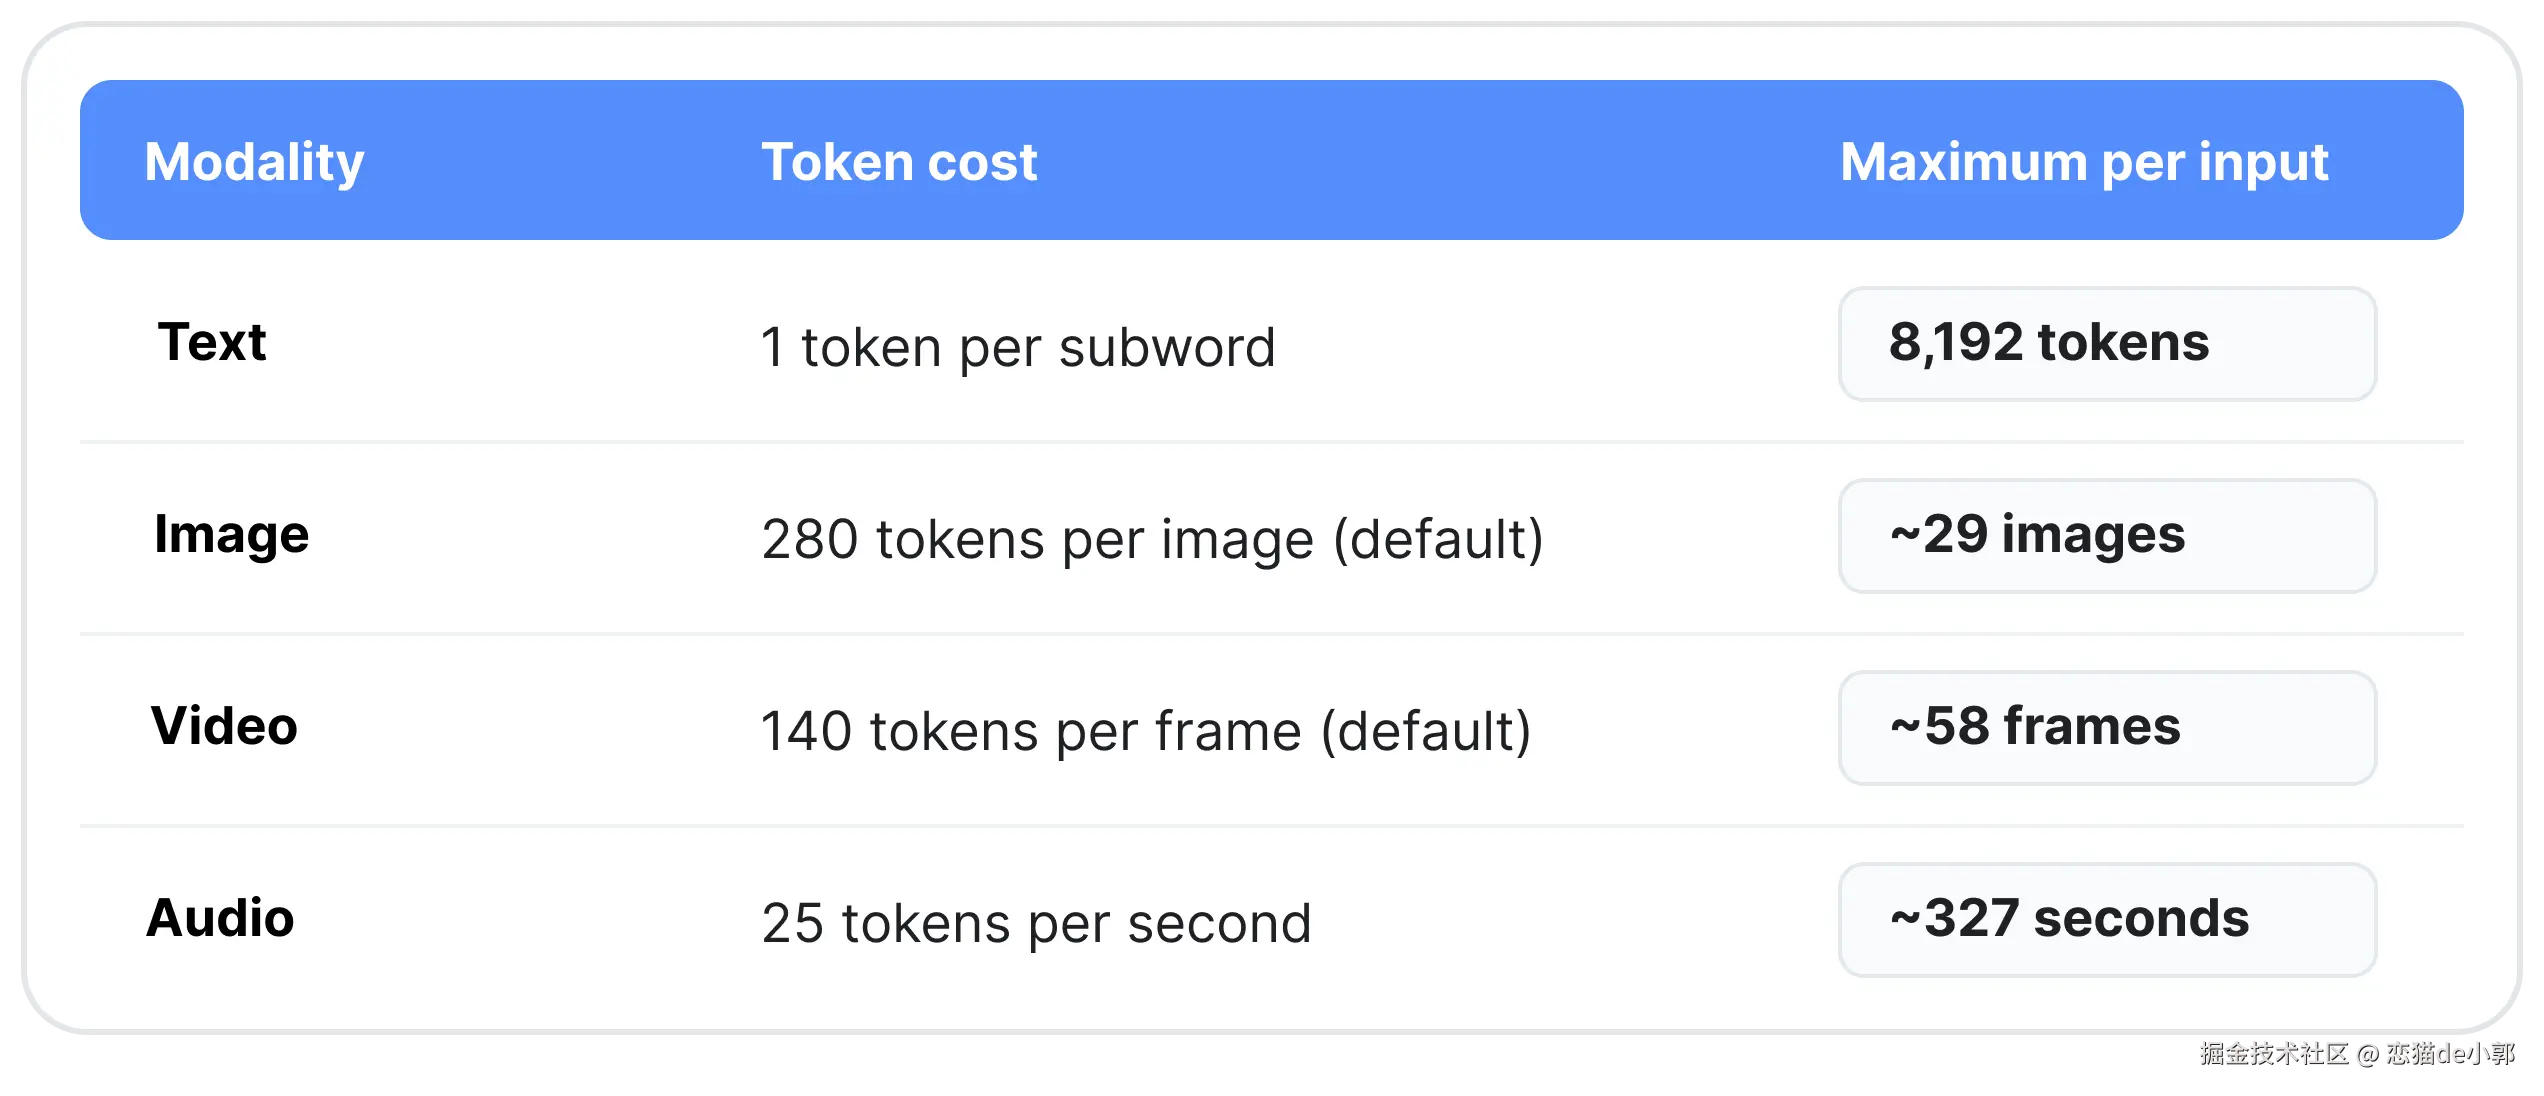
8K context 也主要服务这个方向,官方给出的上限示例是最多 5.5 分钟音频、29 张图片、58 个视频帧或者这些内容的混合输入,这是真的挺强的,最主要是这个也是开源的 Apache 2.0。
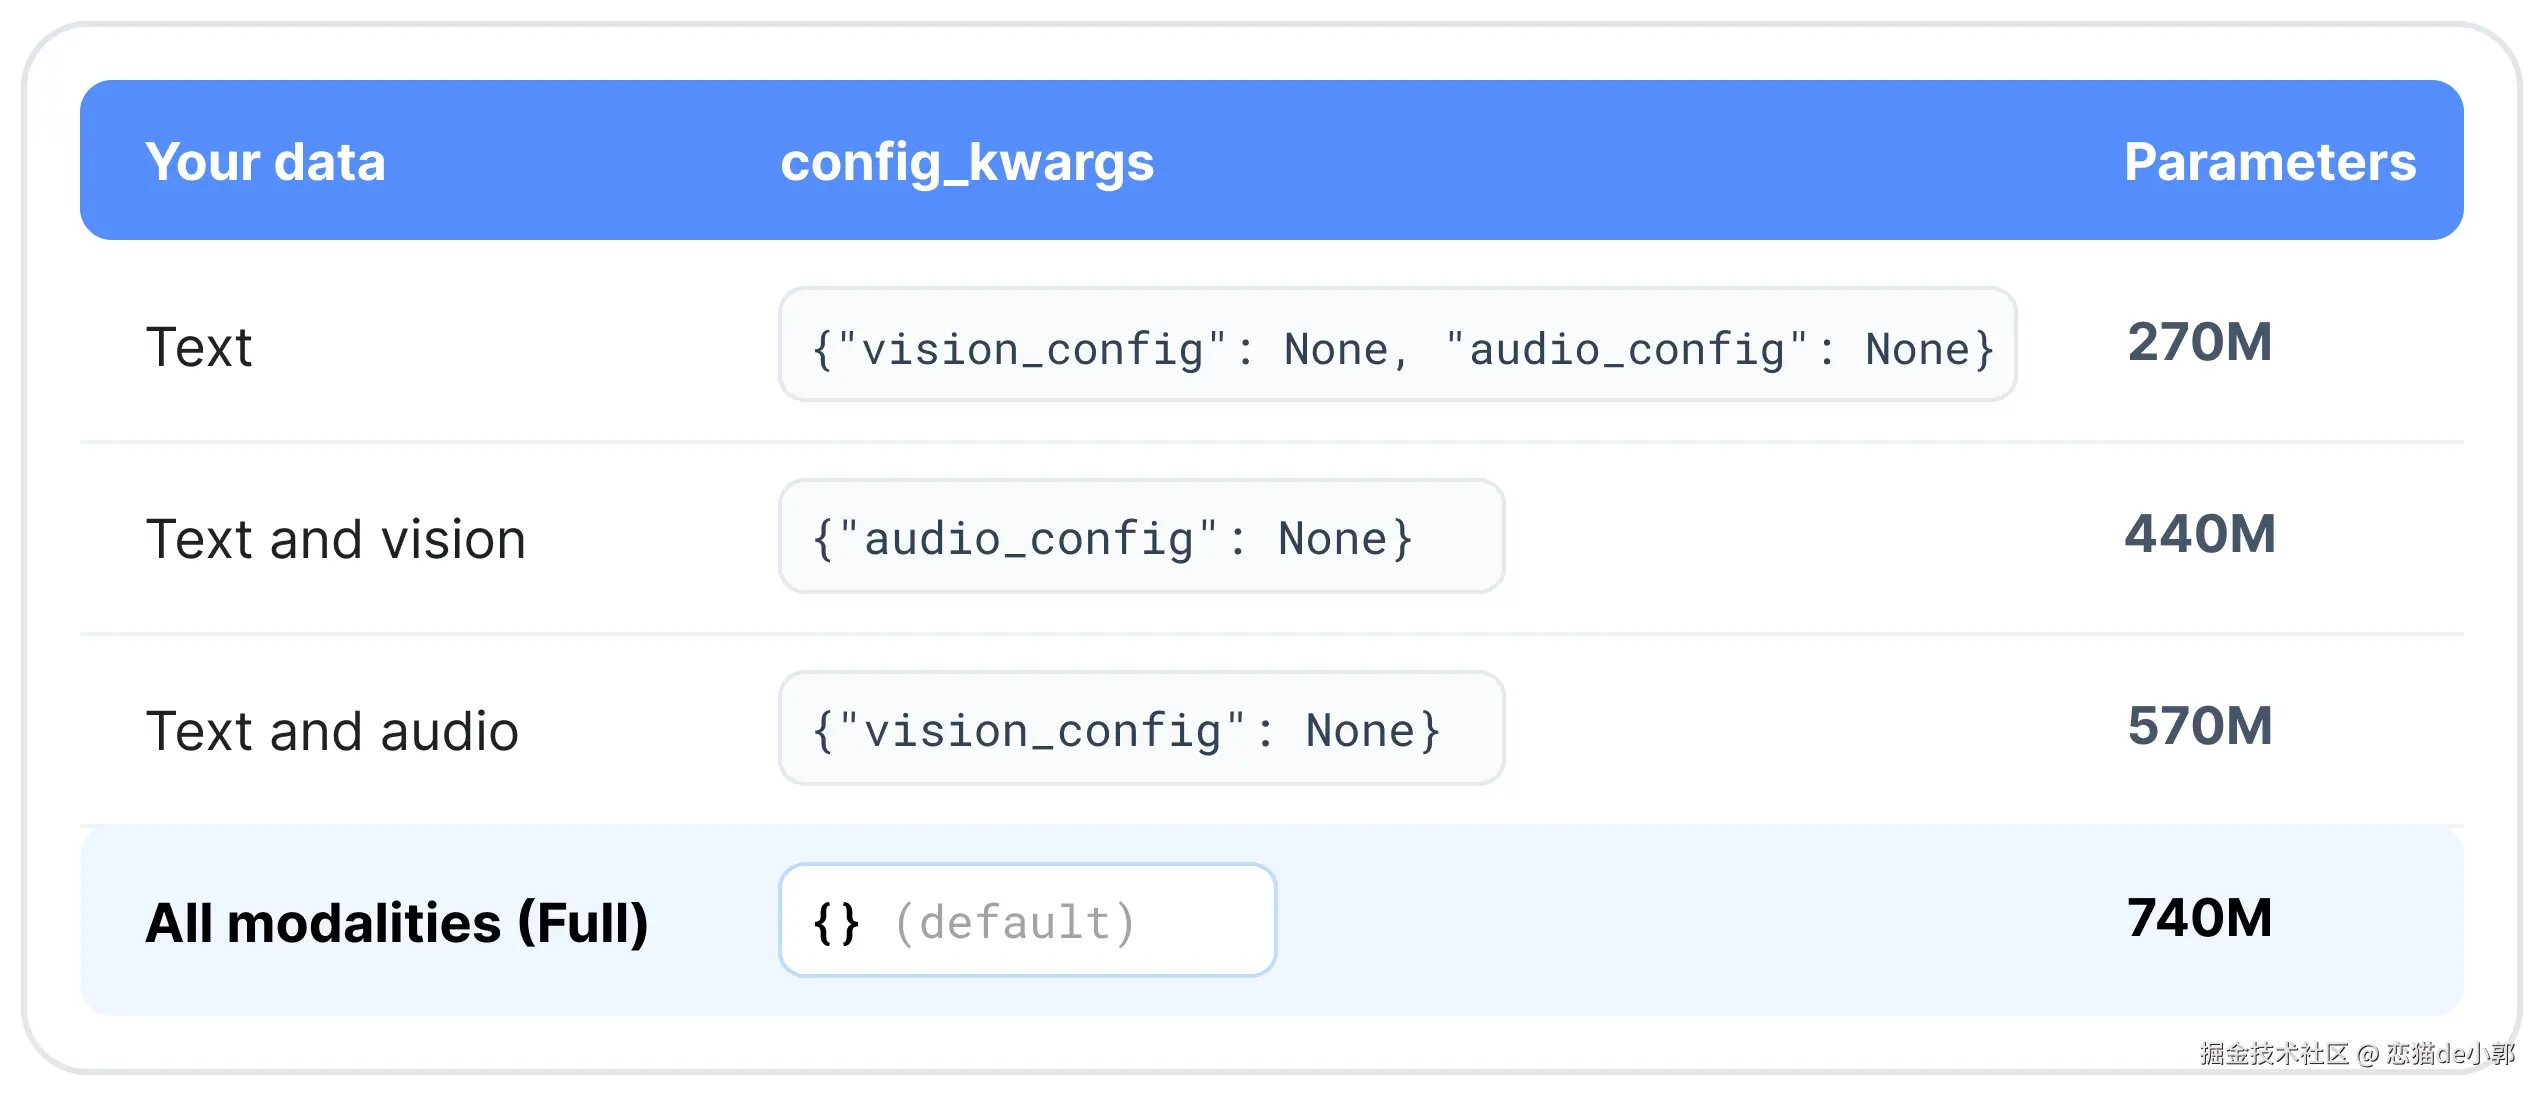
目前 EmbeddingGemma 2 的总参数量是 740M,不过 Google 实际上把模型拆成了文本主体、Vision Encoder 和 Audio Encoder,不同任务可以只加载自己需要的部分:
- text-only 只需要 270M 参数
- 加上视觉后 440M
- text + audio 570M
- 完整 text + image + audio 才到 740M
Google 在 Pixel 11 Pro 上给出的量化测试里,text-only weights 的 active RAM 可以低到约 191MB,完整多模态大概 567MB,至少端侧的确实能跑起来。
而且 EmbeddingGemma 2 基于 Gemma 4,和 Gemma 4 共用 text tokenizer 和 audio encoder,这样一个本地多模态 RAG 可以先用 EmbeddingGemma 2 做 retrieval,再把结果交给 Gemma 4 推理,两边不需要完全重复准备一套音频和文本前处理组件,也就是对端侧来说,这种组件共享的思路可以进一步减少占用。
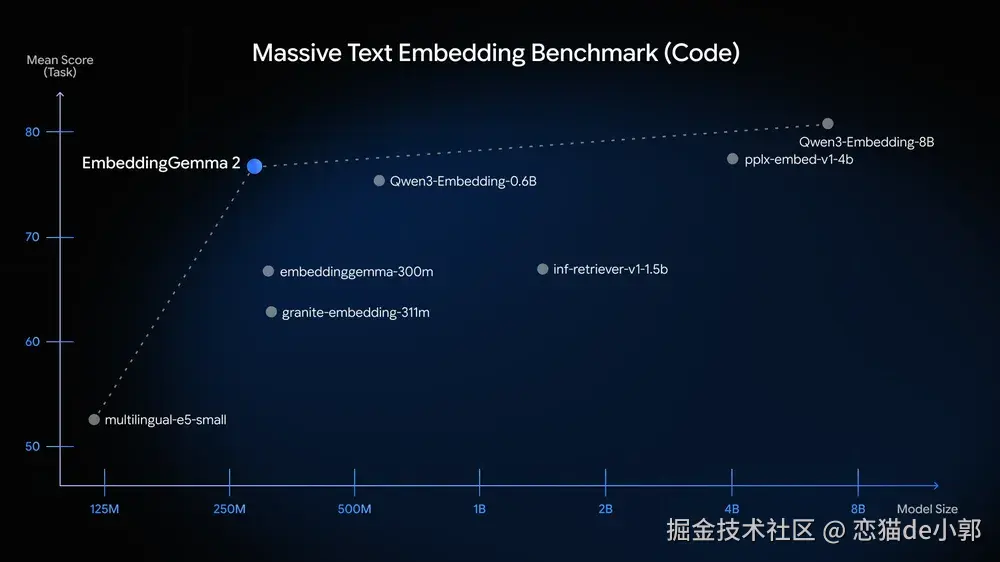
整体测试基准对比效果如下所示,核心还是大小优势和统一多模态能力,在这个 size 下还有不错的表现:
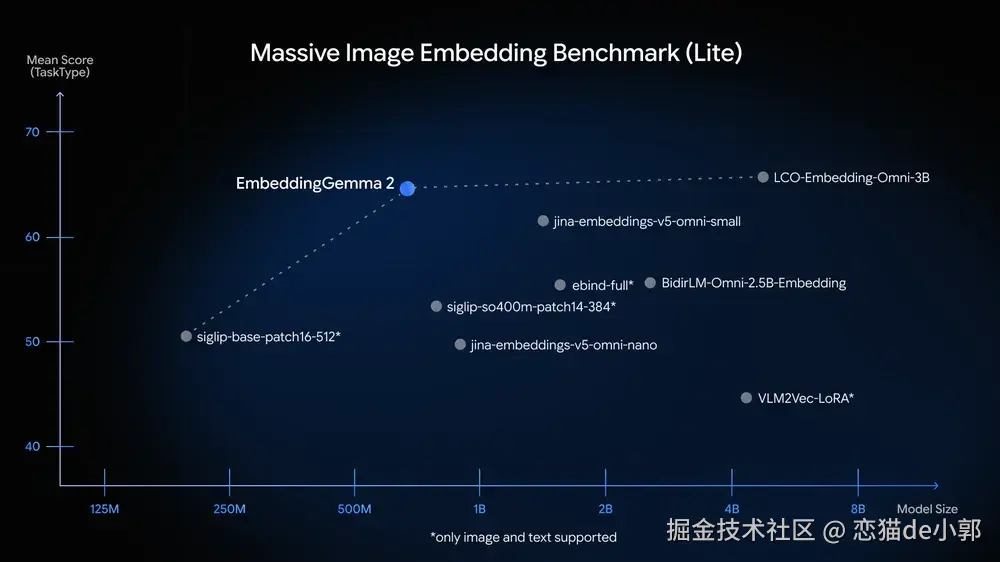
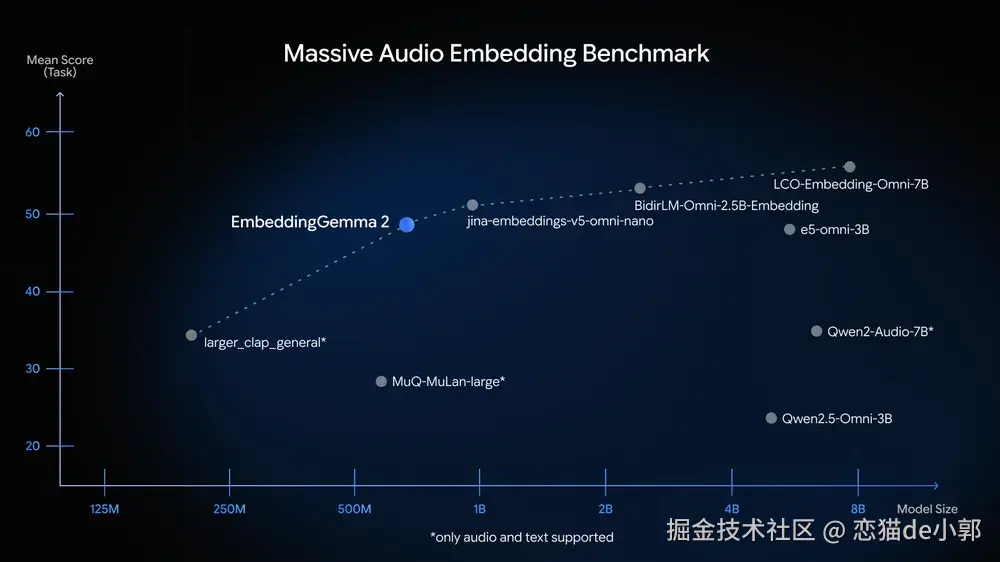
而且谷歌这次还是强调 Matryoshka Representation Learning,可以把 768 维向量截成 512、256 或 128 维,最多把向量库存储缩小到六分之一,但这项能力一代就已经存在,但是在第二代作用明显更大:
一个端侧媒体库可能会给大量图片、视频帧、录音片段建立向量索引,最终长期占存储的很可能是几十万甚至几百万条 embedding。
从模型卡的结果看,256d 很可能是比较实际的平衡点,768 降到 256,Code 从 78.68 降到 76.18,MIEB 从 64.64 降到 63.13,向量存储能减少三分之一,这种变化在手机和端侧性价比会高很多:
| Output Dimension | Compression Ratio | MTEB (multilingual, v2) Mean(Task) | MTEB (eng, v2) Mean(Task) | MTEB (code, v1) Mean(Task) | MIEB (lite) Mean(TaskType) | MMEB (v2) Overall | MSEB (Retrieval) Mean(Task) | MAEB Mean(Task) |
|---|---|---|---|---|---|---|---|---|
| 768d (Full) | 1:1 | 61.36 | 68.46 | 78.68 | 64.64 | 59.01 | 69.54 | 49.39 |
| 512d | 1:1.5 | 61.17 | 68.41 | 77.24 | 64.32 | 58.38 | 69.18 | 49.21 |
| 256d | 1:3 | 60.41 | 67.78 | 76.18 | 63.13 | 56.24 | 66.76 | 48.91 |
| 128d | 1:6 | 57.89 | 65.68 | 71.41 | 59.06 | 45.65 | 56.71 | 46.92 |
128d benchmark 的下降太明显了,比如 MMEB overall 从 59.01 掉到 45.65,audio retrieval 也从 69.54 掉到 56.71。
如果是需要本地多媒体检索,个人知识库之类的场景,EmbeddingGemma 2 就挺合适的,而且可以根据场景灵活组合还有选择,目前来说作为端侧是一个不错的选择。
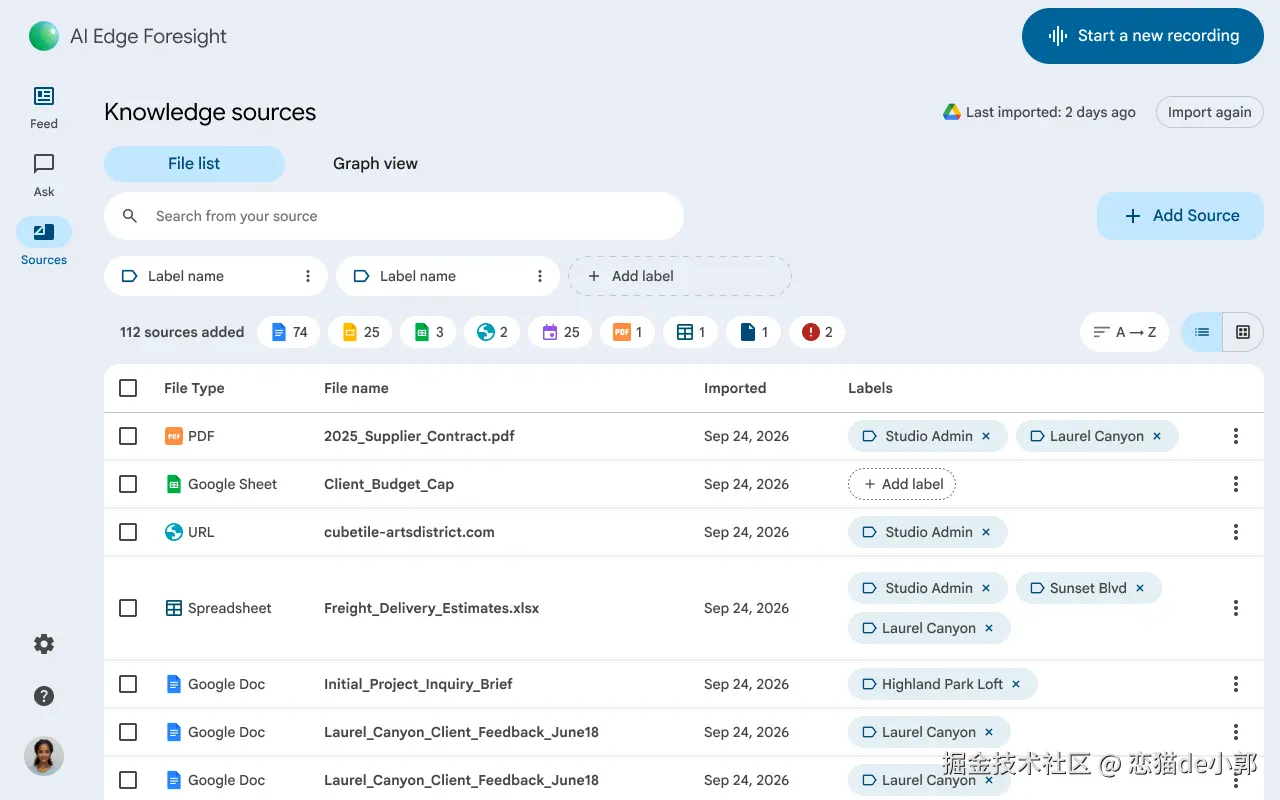
然后基于 EmbeddingGemma 2 和 Gemma4 ,谷歌推出了用 Flutter 开发的全新 Google AI Edge Foresight ,谷歌最新的 Labs 应用 ( developers.google.com/edge/foresi... ),一款适用于 Mac 的会议笔记助手和个人知识助理,通过 EmbeddingGemma2 和 Gemma4 模型套件的本地处理功能,个人知识库里的音频、文字记录和敏感文件可以做到完全本地处理,还可以在需要的时候通过多模态检索和分类: