vLLM高吞吐推理引擎:本地高并发推理服务
Ollama 把"一个人用本地模型"做到了极致,但它的默认假设是单用户:请求一次一个,排队执行。等到多个人共用一台机器,或者要把模型接进内部应用当服务用,瓶颈就露出来了。这一篇讲 vLLM------本地推理从"单机自用"走向"团队服务"的那一层,重点说清它凭什么比裸 transformers 快一个量级(PagedAttention 与 continuous batching 两个机制),以及它和 Ollama 各自站在什么位置。
一、为什么需要它
先定位:vLLM 是一个高吞吐的大模型推理引擎 ,仓库在 github.com/vllm-project/vllm。如果你只用 transformers 的 pipeline 或裸 generate() 一个一个地处理请求,那是"一次喂一个"的模式;而 vLLM 面向的是同时来一堆请求、请求长短不一、还随时有新请求插进来的服务场景。同样的模型、同样的卡,vLLM 的吞吐(单位时间处理的 token 总量)通常比裸 transformers 高一个量级------这不是凭感觉,靠的就是第五节要讲清的两个机制,也是本篇的核心。
为什么这是真实的高频需求?三个典型场景:一是团队共享 ------你不想让五个人各装一份 Ollama 各占一块显存,而是起一个服务让全组调用;二是接应用 ------公司内部的 RAG、客服机器人、代码审查工具都要调同一个本地模型,并发上来了,"串行排队"的引擎就成了瓶颈;三是研究/压测 ------做推理性能对比(AI-29 会专门讲调优与基准测试),vLLM 是业界事实上的基准线之一。搜索词"vLLM 安装""高并发推理""PagedAttention 原理"也都在问同一件事:本地这台机器,怎么把它当成一个靠谱的模型 API 服务器用。
我的使用习惯:Ollama 管"个人日常用",vLLM 管"当服务用"。两者不冲突------同一个模型,Ollama 拉一份 GGUF、vLLM 加载 HuggingFace 仓库,应用侧看到的都是 OpenAI 兼容接口,切换只改一个 base_url。这个"接口形状统一"的设计是本系列反复强调的:你的应用代码不应该和某个具体引擎绑死。
二、环境要求
| 项目 | 要求 | 说明 |
|---|---|---|
| GPU | N 卡(NVIDIA)+ 对应驱动 | nvidia-smi 能出表;显存按 §5.6 口径估算(见《AI-05》) |
| Python | 3.9-3.12 区间 | 以官方文档为准;保守选 3.10/3.11(见《AI-03》) |
| CUDA 环境 | N 卡 + CUDA 运行时 | PyTorch wheel 自带 CUDA 运行时,多数情况不用另装 Toolkit(见《AI-01》) |
| 磁盘 | 模型放非 C 盘(如 D:\models) |
7B fp16 约 14-15 GB;量化权重更小 |
| 系统 | Windows / Linux / WSL2 | WSL2 需 Windows 侧驱动支持 GPU 直通(见《AI-04》) |
| 网络 | 能访问 PyPI 与 HuggingFace(或镜像) | 国内用清华/阿里 pip 镜像 + hf-mirror |
显存估算与《AI-05 显存计算与模型选择》完全一致,先记住三个数:7B 级 fp16 权重约 14-15 GB、Q8 约 7-8 GB、Q4 约 4-5 GB (量化后),再加 10-20% 框架开销与 KV Cache。经验下限(单卡、含 KV):8 GB 跑 7B int4 舒适、12 GB 跑 13B/14B int4、24 GB 跑 32B int4 舒适、48 GB 才轮到 70B int4。vLLM 是服务引擎,KV Cache 随并发增长比单人使用更凶,估算时给 KV 留的余量要比 AI-05 的单人场景更保守。
三、安装与部署
3.1 建独立环境(强烈建议,别装在全局 Python 里)
vLLM 自带一整套 PyTorch 依赖,装进独立 venv 可以把它和 Ollama 工具链、其他项目彻底隔开:
bash
python -m venv D:\vllm-venv
D:\vllm-venv\Scripts\activate        :: Windows
source D:/vllm-venv/bin/activate     # Linux/WSL2
3.2 安装 vLLM
pip install vllm国内网络慢时走清华/阿里 pip 镜像:
arduino
pip install vllm -i https://pypi.tuna.tsinghua.edu.cn/simple要求 Python 3.9-3.12、N 卡 + CUDA(以官方文档当前版本为准)。预期:下载并装完 vllm 及其 PyTorch 依赖(体积较大,耐心等待;中途断网重跑即可)。装完顺手确认 Python 版本在支持区间内:python --version。
3.3 准备模型
vLLM 加载 HuggingFace 格式的模型(本地路径或 HF 仓库名都行)。模型获取完全复用《AI-06 模型下载全攻略》:
arduino
set HF_ENDPOINT=https://hf-mirror.com
huggingface-cli download Qwen/Qwen2.5-7B-Instruct --local-dir D:\models\qwen2.5-7b
国内用户这一步基本必配镜像(hf-mirror 或 ModelScope),直连 huggingface.co 大概率卡住。
3.4 起服务:vllm serve
python
vllm serve D:\models\qwen2.5-7b --port 8000 --max-model-len 8192Linux/WSL2 把路径换成 ~/models/qwen2.5-7b 即可。启动过程会先加载权重进显存,再打印监听信息,服务监听 8000 端口。常用参数(按需裁剪,完整列表以 vllm serve --help 与官方文档为准):
| 参数 | 示例 | 作用 |
|---|---|---|
--port |
8000 |
服务监听端口 |
--max-model-len |
8192 |
单请求最大上下文长度,KV Cache 显存的直接开关,够用就好别拉满 |
--gpu-memory-utilization |
0.9 |
允许 vLLM 占用的显存比例;显存被其他程序占着就调低(见第六节) |
--tensor-parallel-size |
1 |
张量并行卡数,单卡就是 1;双卡切 70B 可设 2 |
--quantization |
awq |
加载 AWQ 等量化权重时用,详见《AI-14 模型量化完全指南》 |
3.5 OpenAI 兼容接口:curl 验证
vLLM 提供与 OpenAI 一致形状的 /v1/chat/completions 接口:
sql
curl http://localhost:8000/v1/chat/completions -H "Content-Type: application/json" -d "{\"model\":\"D:\models\qwen2.5-7b\",\"messages\":[{\"role\":\"user\",\"content\":\"你好\"}]}"预期:返回 JSON,choices[0].message.content 是正常回答。这个端点和 Ollama 的 OpenAI 兼容端点(localhost:11434/v1,见《AI-08 Ollama进阶与API开发》)、llama-server 的 8080 端口(见《AI-12 llama.cpp与GGUF格式》)形状完全一致------OpenAI SDK、Cherry Studio、OpenWebUI 把 base_url 指过来就能用,应用代码一行不改。
四、验证
- 服务起来了:跑 3.5 的 curl 能拿到 JSON 回答,而不是连接拒绝;
- 回答质量正常:问一句中文常识题,回答通顺、不重复、不乱码;乱码先怀疑模型文件没下全或量化位宽过低(见第六节);
- 显存对账 :另开终端跑
nvidia-smi,看 vLLM 进程的显存占用 ≈ 权重大小 + KV 预算,且不超过--gpu-memory-utilization设的上限; - 并发不排队(可选):同时发两三个 curl 请求,vLLM 会用连续批处理把它们插进同一批一起算,响应不会"一个跑完才轮下一个"------这正是它和串行引擎的体验差异。
五、进阶技巧
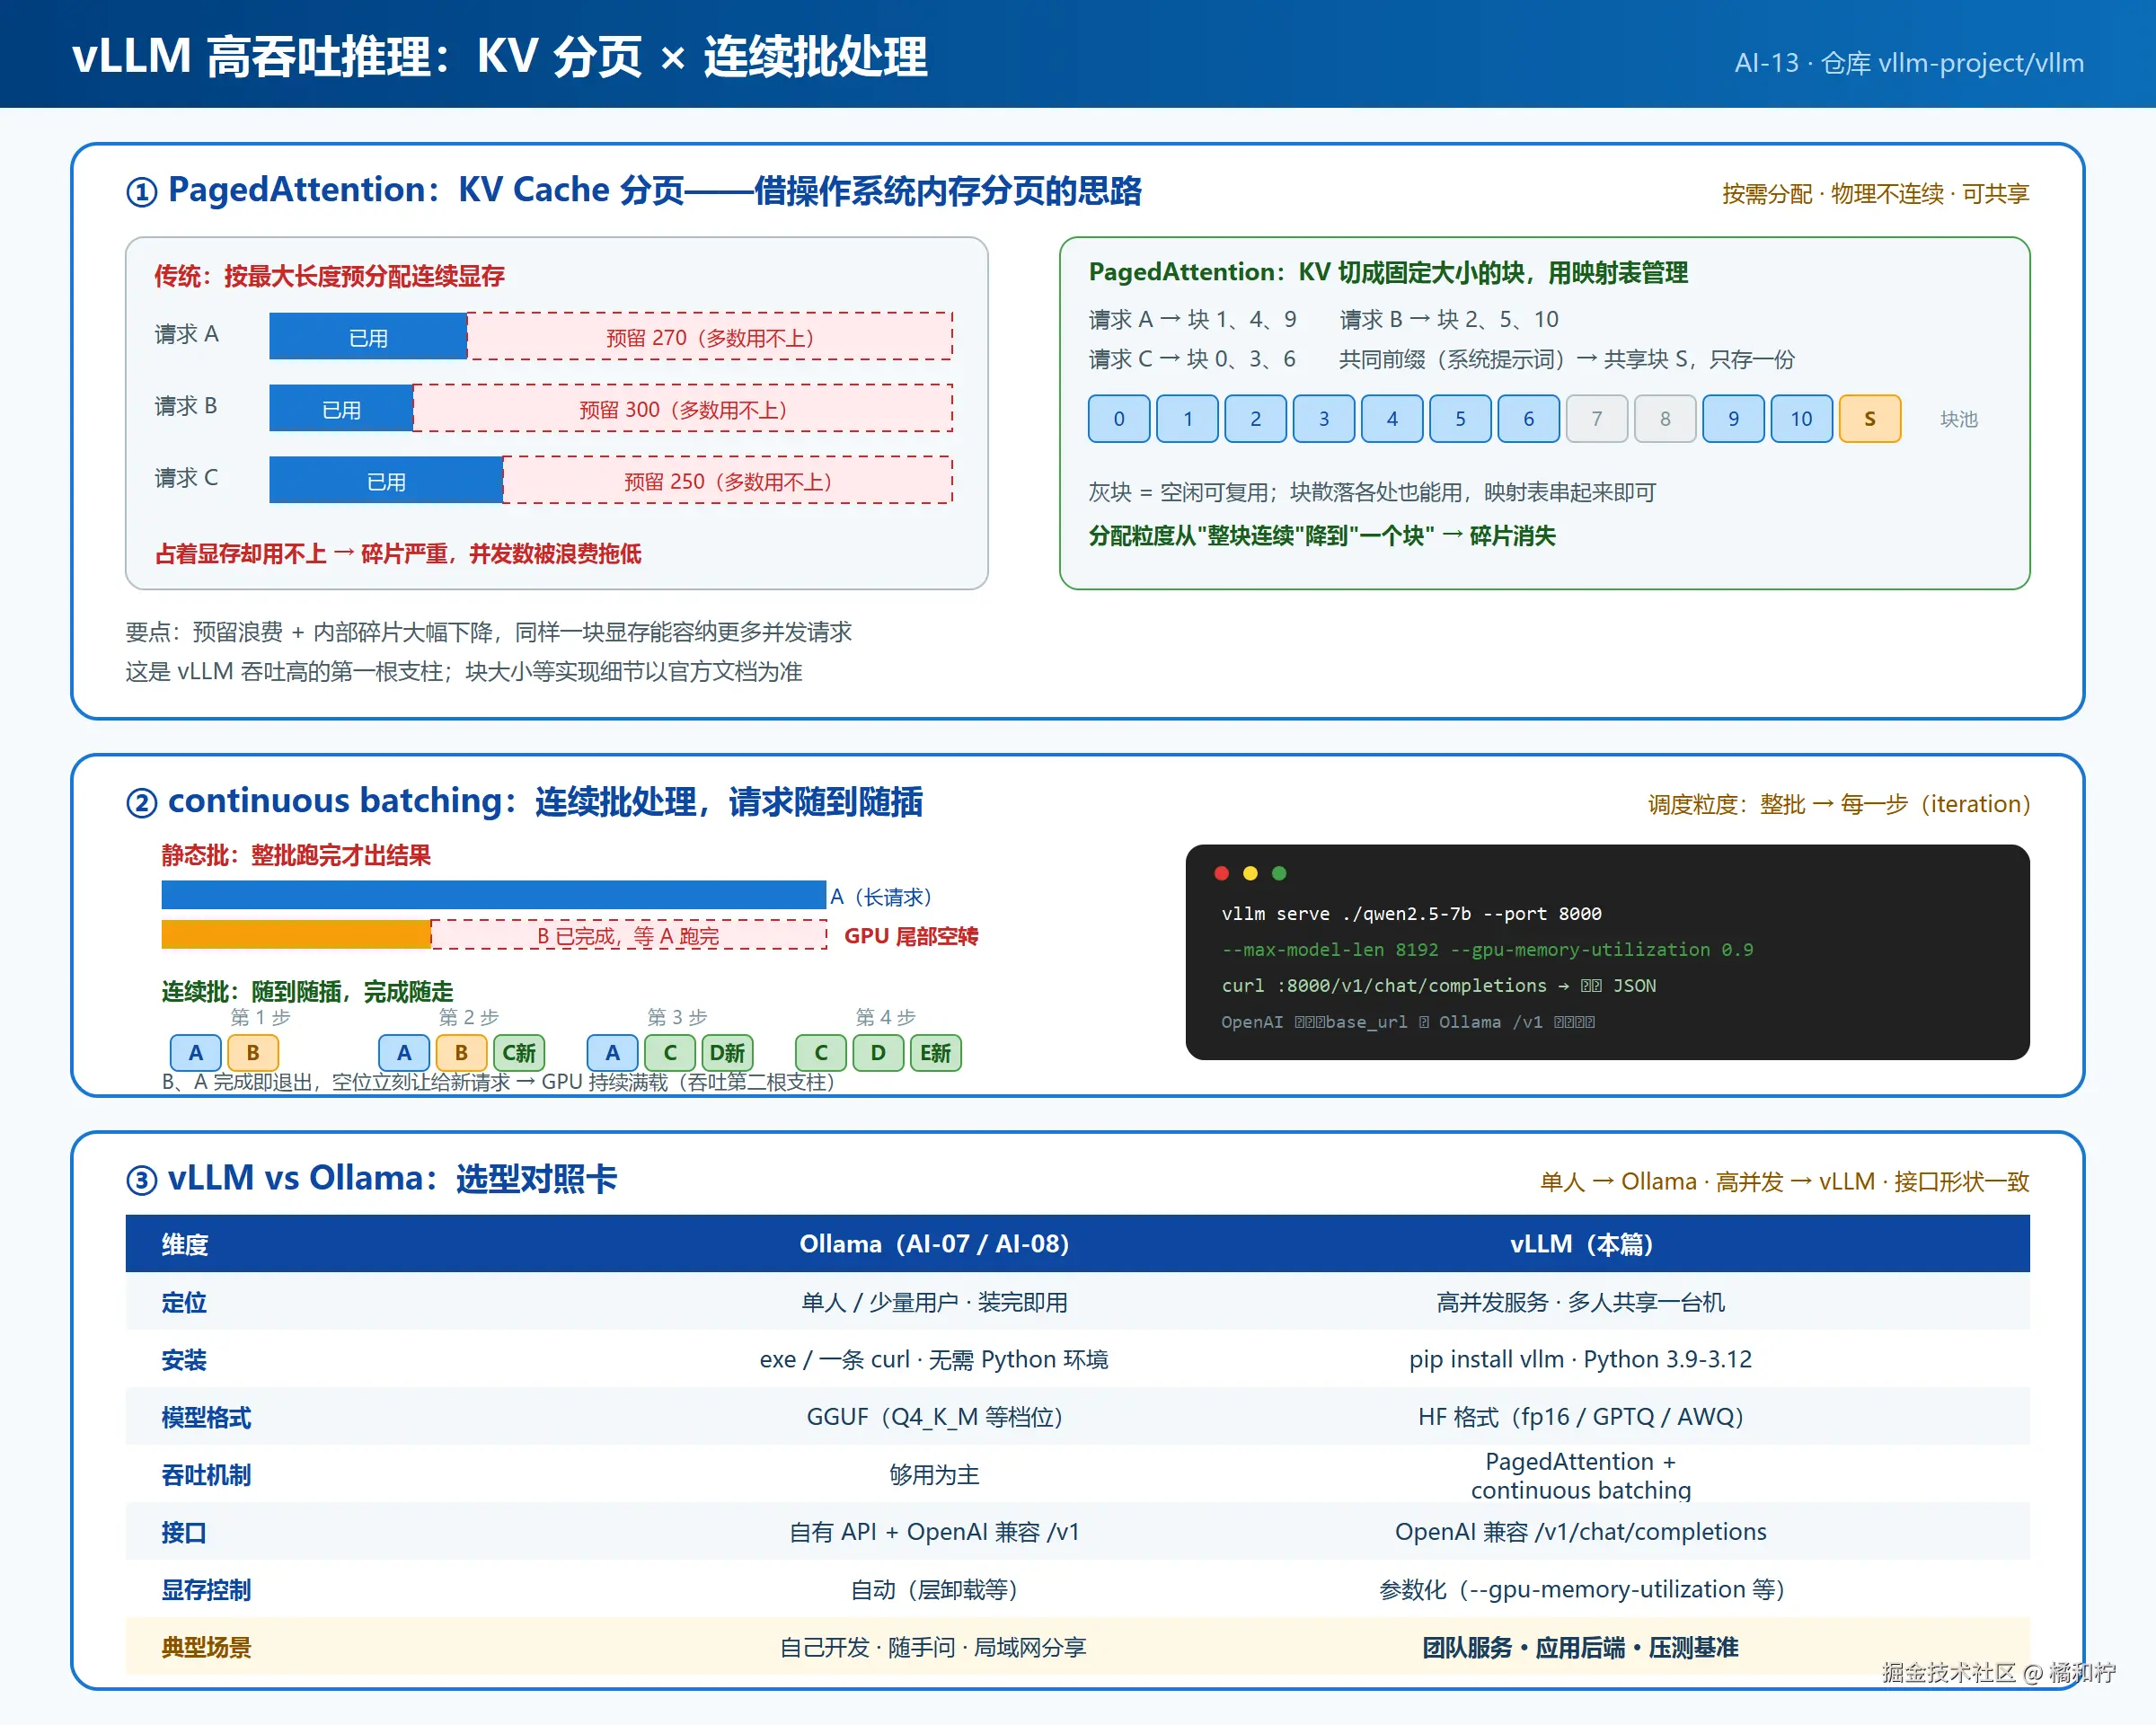
5.1 PagedAttention:KV Cache 分页,像操作系统给内存分页
先说背景:大模型生成时,每个请求的 KV Cache(已生成 token 的注意力缓存)是随生成长度逐步变长 的。传统做法是给每个请求预分配一块连续显存,按它可能达到的最大长度预留------请求实际只生成了 100 个 token,你却按 2000 预留了空间,中间大量显存被"占着但用不上",碎片严重。
PagedAttention 直接借了操作系统给物理内存分页的思路:把 KV Cache 切成固定大小的"块"(block),像虚拟内存的页一样管理------
- 按需分配:请求生成到哪,块才分配到哪,不再按最大长度预留;
- 物理块可以不连续:一个请求的 KV 块可以散落在显存各处,用一张映射表串起来------逻辑连续、物理零碎完全没问题,这就是"分页"消灭碎片的本质;
- 块可共享:多个请求引用同一段前缀(比如同一份系统提示词)时,那段 KV 块只需存一份,多请求共享引用。
结果:KV 显存的浪费(预留浪费 + 内部碎片)大幅下降,同样一块显存能容纳的并发请求更多------这是 vLLM 吞吐高的第一根支柱。块大小等实现细节以官方文档说明为准。 打个比方:传统分配像"按最大行李额买票",每人占满一个舱位却往往只放一件行李;分页之后是"按实际行李占格",空出来的格子立刻给后面的人用------舱位利用率自然上去。
5.2 continuous batching:连续批处理,请求随到随插
传统批处理(static batching)是"凑够一批、整批跑完、下一批再来":批里最短的请求早早生成完了,也得等最长的跑完整个批才出结果------短请求被长请求"拖着",GPU 在批次尾部空转。
continuous batching 把调度粒度从"一批"细化到"每生成一步(每个 iteration)":
- 随到随插:新请求一进来,下一个 iteration 就插进正在跑的批次,不用等下一批;
- 随完成随走:哪个请求生成结束(碰到结束符或到长度上限),它立刻退出批次、释放 KV,位置让给新请求;
- 每个 iteration 都在"能塞进显存的请求"之间动态调整组合,GPU 持续保持高利用率。
5.3 显存预算(引用 §5.6 口径,与《AI-05》同公式)
两个机制讲完,落到工程上就是一个问题:我这块卡到底能同时扛多少请求?答案是按下面三项把账算平,再决定 --max-model-len 和并发数留多大。
把《AI-05》的估算公式套到 vLLM 上,三项相加:所需显存 ≈ 权重显存 ×1.1~1.2 + KV Cache(随并发 × 上下文增长)+ 0.5-1 GB 系统底噪。
- 权重项:7B fp16 约 14-15 GB;换成 AWQ/GPTQ 4bit 权重约 4-5 GB(量化对比详见《AI-14 模型量化完全指南》);
- KV 项:7B 模型 4K 上下文单并发 KV 约 0.5-1.5 GB(量级参考,随架构而异)------vLLM 是多并发服务,KV 要按"并发数 × 单请求 KV"去估,这是它比 Ollama 单人场景更吃显存的根源;
--gpu-memory-utilization是这三项的"总闸门":设 0.9 表示允许 vLLM 占 90% 显存,权重 + KV 都从池子里出。
实操顺序:先按上式算模型 + 目标并发大概要多少,对照显卡总显存------够,就留在默认或 0.9;不够,优先降 --max-model-len(KV 的关键调节项),其次换更低量化。8 GB 卡建议 7B 4bit + 4K 上下文起步;24 GB 卡可以试 32B 4bit 或 7B 长上下文多并发。
5.4 vLLM vs Ollama:到底选哪个
| 维度 | Ollama(AI-07/AI-08) | vLLM(本篇) |
|---|---|---|
| 定位 | 单人/少量用户,装完即用 | 高并发服务,多人共享一台机 |
| 安装 | exe/一条 curl,无 Python 环境 | pip install vllm,需 Python 3.9-3.12 |
| 模型格式 | GGUF(Q4_K_M 等量化档) | HuggingFace 格式(fp16 / GPTQ / AWQ) |
| 吞吐机制 | 够用为主 | PagedAttention + continuous batching |
| 接口 | 自有 API + OpenAI 兼容 /v1 |
OpenAI 兼容 /v1/chat/completions |
| 显存控制 | 自动(层卸载等) | 参数化(--gpu-memory-utilization 等) |
| 典型场景 | 自己开发、日常提问、局域网分享 | 团队服务、应用后端、压测基准 |
选型结论:单用户开发、要省心 → Ollama;多用户/高并发/生产化 → vLLM 。两者接口形状一致,很多团队的真实架构就是"开发期 Ollama、服务期 vLLM",切换只改 base_url。之后调 --max-model-len、并发数、显存利用率的理论依据,都是 5.1/5.2 两个机制(AI-29 展开)。
六、故障排查(按层定位)
| # | 症状(报错原文) | 层 | 原因 | 解决 |
|---|---|---|---|---|
| 1 | vLLM:ValueError: Free GPU memory ... less than desired GPU memory utilization |
显存 | --gpu-memory-utilization 设太高,或显存被其他进程占着 |
降到 --gpu-memory-utilization 0.85;先 nvidia-smi 清掉占卡进程再启动 |
| 2 | CUDA error: out of memory / torch.cuda.OutOfMemoryError: CUDA out of memory. Tried to allocate ... |
显存 | 模型/上下文/并发超出显存 | 降 --max-model-len、换更低量化(见《AI-14》)、nvidia-smi 查占用 |
| 3 | CUDA error: no kernel image is available for execution on the device |
框架/CUDA | 所装 CUDA 版本与显卡架构不匹配(如太新的 CUDA 编译 + 老卡) | 换与显卡架构匹配的 PyTorch wheel(pytorch.org 选择器),见《AI-02》 |
| 4 | HuggingFace 下载卡住 / ConnectionError / 超时 |
网络 | 国内访问 huggingface.co 受限 | set HF_ENDPOINT=https://hf-mirror.com(Win)/ export HF_ENDPOINT=https://hf-mirror.com(Linux);或改 ModelScope(见《AI-06》) |
| 5 | pip install vllm 失败/提示 Python 版本不符 |
环境 | Python 不在 3.9-3.12 区间,或环境被污染 | 换 3.10/3.11 重建 venv 再装;先 python --version 确认(区间以官方文档最新说明为准) |
| 6 | 模型加载成功但输出乱码/重复 | 量化 | 量化位宽过低(Q2/Q3 级)或权重与 tokenizer 不匹配 | 升量化位宽(Q4 起);确认权重与 tokenizer 来自同一 repo |
| 7 | port 8000 already in use 或连接拒绝 |
端口/服务 | 8000 被占,或服务还没加载完 | 换端口(--port 8001);Windows `netstat -ano |
| 8 | CUDA driver version is insufficient for CUDA runtime version |
驱动 | 驱动低于框架所需 CUDA | 升级 NVIDIA 驱动(只升 Toolkit 没用),见《AI-01》 |
七、本篇自检清单
- 能说出 vLLM 定位:高吞吐推理引擎,面向多请求服务场景,吞吐比裸 transformers 高一个量级
- 能讲清 PagedAttention:KV Cache 像操作系统内存一样分页,按需分配、物理不连续、前缀可共享,减少碎片
- 能讲清 continuous batching:调度粒度到每个 iteration,请求随到随插、完成随走
- 会用
python -m venv+pip install vllm(国内加清华镜像)装好 vLLM - 跑过
vllm serve <模型> --port 8000 --max-model-len 8192,并用 curl 调通/v1/chat/completions - 会按《AI-05》口径给 vLLM 做显存预算(权重 ×1.1~1.2 + 并发×单请求 KV,闸门是
--gpu-memory-utilization) - 能背出选型结论:单人 Ollama、并发 vLLM
- 遇到
Free GPU memory ... less than desired GPU memory utilization知道降--gpu-memory-utilization或先清显存