有一段时间不在广州,没有办法及时给大家上新(为了生活没有办法)。刚好最近在升级之前开源的 ops-wiki 系统。这次给各位分享一下我究竟升级了什么,也当作是一次记录吧。
升级时间线
为了满足自己日常使用需要,8月份的时候我稍微做了一些调整。直到最近,我想将这个个人知识库结合之前开源的 brain-mix 系统打造一款本地的个人助手,所以又做了一些升级(将两个项目结合起来,顺便自己理顺一下之前的知识点)。
| 日期 | 提交 | 主要内容 |
|---|---|---|
| 8 月 4 日 | 38bcce4 |
工程结构重构;编辑器改为自研分屏方案;后台自动保存 |
| 8 月 11 日 | 286fae9、85d93f9 |
细节修复;支持 Mermaid 图与 KaTeX 公式 |
| 8 月 12 日 | eaf098a、35c52cf、4356ed0、342ae9a |
页面清理;树节点右键菜单;文章密码锁定 |
| 8 月 13 日 | 873bab8 |
编辑区"回到顶部"按钮 |
| 10 月 8 日 | e0f43b0 |
本地语义检索、国际化、异步索引队列 |
如上表所示,整个升级过程共分为三个阶段,每个阶段的定位不太一样。
第一阶段(8 月 4 日)解决的是"代码好不好维护";
第二阶段(8 月 11 - 13 日)解决的是"写文档顺不顺手、文章能不能单独锁起来";
第三阶段(10 月 8 日)解决的是"内容多了以后能不能按意思搜到、不同语言的同事能不能用"。
第一阶段:工程结构重构
6 月的版本里,后端代码是平铺的------app.py、models.py、views.py、crypto.py 全部堆在一起,前端资源也直接放在仓库根目录的 static/、templates/ 下,数据库文件 wiki.sqlite 甚至被一起提交进了版本库。
虽然功能能跑,但继续加东西会很别扭:想找某个路由的加解密逻辑,得在几个大文件之间来回翻。
于是
后端拆成一个包 src/ops_wiki/,按职责分四个子包:
core/:应用组装与配置models/:数据模型routes/:HTTP 蓝图,按入口分成auth/views/adminservices/:加解密、检索、邮件、权限校验等可复用能力
前端资源统一挪到 web/,与后端代码物理分开。本着"个人数据不离出境"的原则,运行期产生的东西------数据库、导入的图片、日志------全部迁出项目,落到一个配置项 _ASSET_ROOT 指向的本机目录里,并写进 .gitignore。仓库从此只装代码,不装数据。
同时补了一个 wsgi.py 作为 WSGI 入口,负责日志配置和应用创建。为了方便后续运维,写了一个 run.sh 一键脚本,把 start / stop / restart / status 四个动作包起来,日志和 PID 文件的位置都从这里统一管理。脚本支持两种运行模式:开发用 Flask 内置服务器,生产用 gunicorn。
顺带完成的编辑器重写
同一批提交里,编辑器从第三方组件(Toast UI)换成了自研的分屏编辑器。左侧是 Markdown 原文,右侧用 marked 渲染 HTML 实时预览,中间的分隔条可以拖动,拖到边缘会自动切成全屏原文或全屏预览。两侧滚动做了双向同步------在原文区滚动,预览区按相同比例跟随,反过来也一样。
此外,为了适应 ms office 的使用习惯还补了后台自动保存功能。停止输入满一分钟后自动静默存盘,编辑过程中每次敲键盘都会重置这个计时,所以正在改的时候不会触发保存。保存成功时工具栏右侧会亮一个绿色对勾和文字提示,手动保存显示"保存成功",自动保存显示"自动保存成功",五秒后淡出。
至此,这个工具才过得了我自己的这一关(毕竟操作起来还算可以了)。
第二阶段:编辑器能力与文章锁定
Mermaid 图与 KaTeX 公式
作为一名技术人员,写技术文档经常要画流程图、时序图,也要写数学公式。这些 ops-wiki 又没有了,既然不够用了就把两个渲染能力本地化接进来吧。
Mermaid 的用法是在 Markdown 里写一个 ```````mermaid```` 围栏代码块,预览时这段代码会被替换成矢量图,宽度跟着容器走,不会撑出横向滚动条。
实现上是在 marked 解析完成之后做一次后处理:找到渲染出来的 pre > code.language-mermaid 节点,交给 mermaid 渲染成 SVG 再替换回去,中间加了 180 毫秒的防抖,避免连续输入时反复重画大图。
然而,公式走的是另一条路。
KaTeX 通过 marked 的扩展机制在解析阶段就接管 $...$(行内)和 $ $...$$ (块级)。这个扩展排在代码块和行内代码的处理之后,所以正文里的 $ 不会和代码里的 $ 打架,公式内部的下划线、星号也不会被当成 Markdown 的强调语法。
公式写错时 throwOnError 设为 false,回退成纯文本显示,不会让整段预览报错(这个是后面加的特性,未处理的时候报错就整屏用不了了特别恼火)。
mermaid、katex 的脚本、样式和字体文件都放进了 web/static/vendor/,整套系统离线也能用,不依赖外部 CDN。
文章密码锁定
这是这一阶段最完整的一个功能。目标很直接:某篇文章可以加"锁",加了之后连文章所有者自己每次打开都要输入密码(坦白说这个我用语雀的时候就有用过,其实还挺实用的就自己加了)。
数据层给 node 表加了两个字段:is_locked(布尔)和 lock_password_hash(密码的哈希,用 werkzeug 的 pbkdf2 存,不存明文)。
接口层做了几件事。GET /api/nodes/:id 遇到锁定文章一律返回空内容,前端据此弹出密码遮罩;解锁用单独的 POST /api/nodes/:id/unlock,密码正确才返回明文,而且只对当次响应有效,下次请求仍然锁定。
启用或修改密码通过 PUT /api/nodes/:id,只对 article 类型开放,is_locked: false 才是真正关闭保护(会把哈希一并清掉)。左侧目录树里被锁的文章会显示锁图标,所有者自己则另有钥匙图标。
有一个细节值得说明:锁定的文章不参与语义检索索引。也就是说,加锁之后这篇文章的分块和向量会被跳过(新增时跳过,已索引的会在重建时清理),避免锁定内容以向量或片段的形式从检索结果里漏出去。
解锁流程如下:
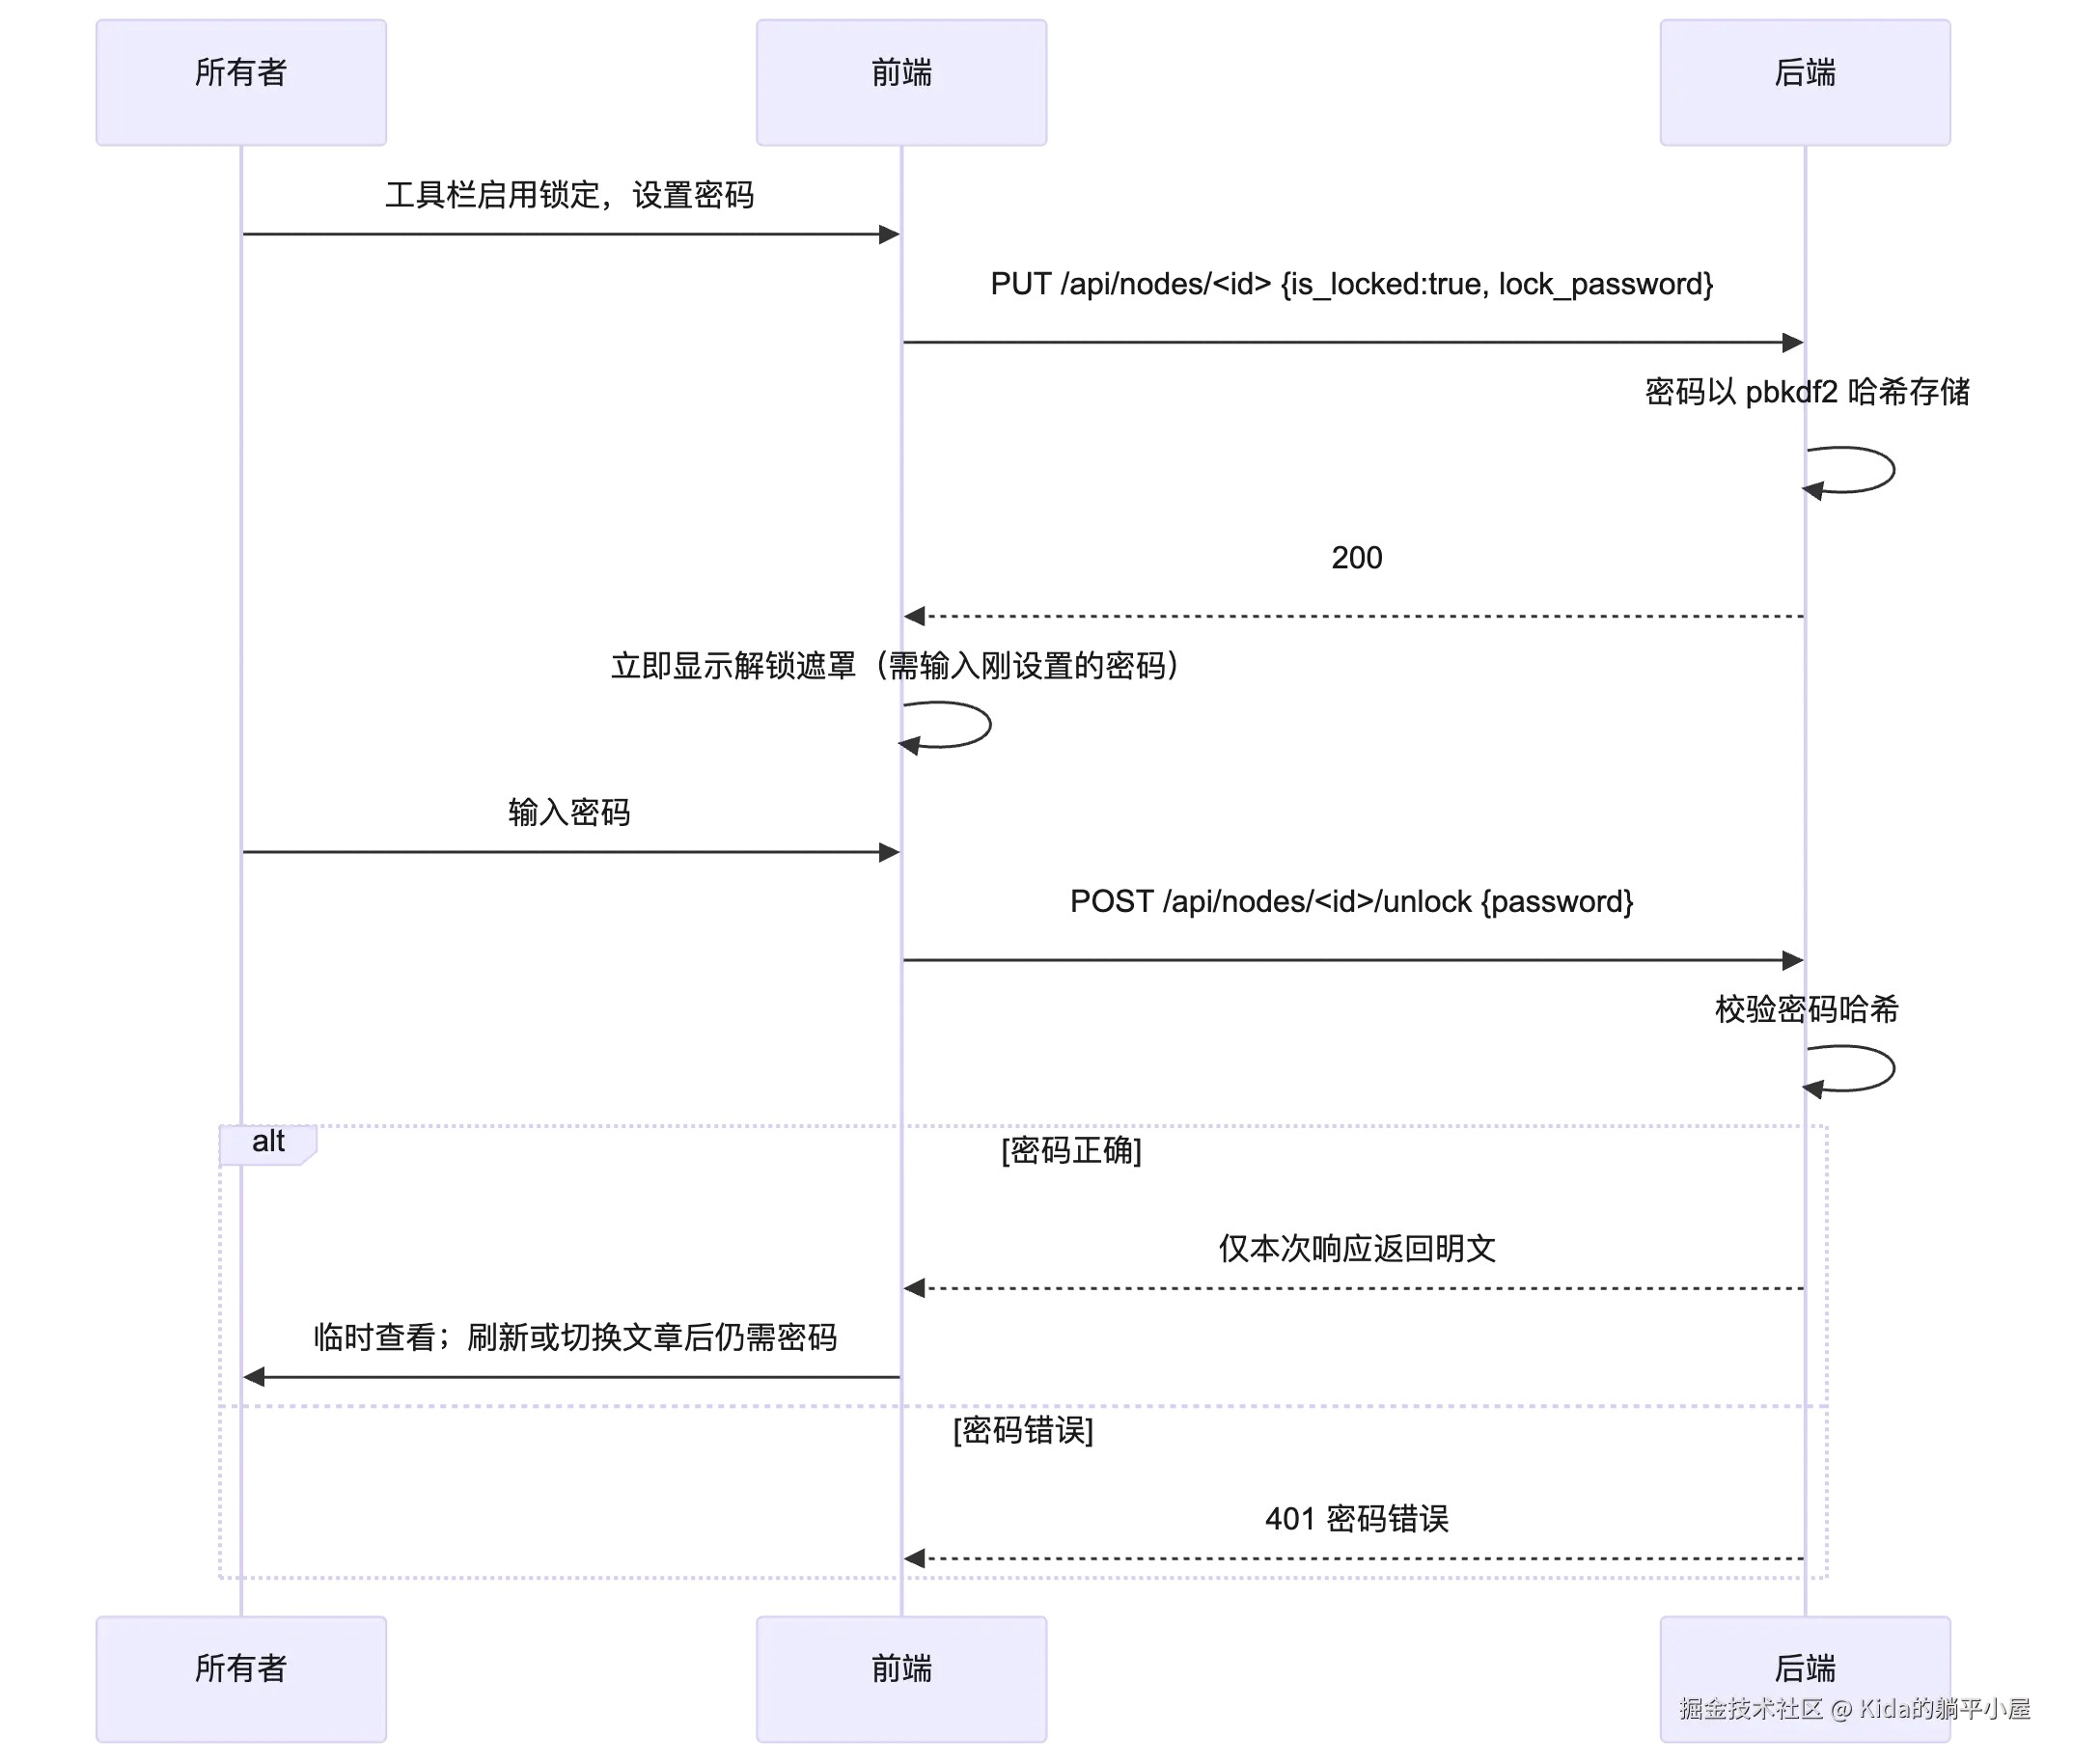
"临时解锁"和"真正解除锁定"是两件事。输入密码只是这次能看,刷新或切走再回来还是要输。想以后打开都不需要密码,得先输密码进去,再从工具栏的锁定管理里点"解除锁定"。锁定遮罩状态下不展示锁定管理入口,防止还没解锁就冒出"解除锁定"这种不合逻辑的选项。
其他内容
目录树增加了右键菜单,节点上右键弹出重命名、删除、导入、批量授权等操作,空白处右键则提供新建根目录;拖拽移动节点时,右键刚点过的节点会被抑制掉紧接着的展开动作,避免右键顺手把节点展开了。
还有一个"回到顶部"的小按钮(外面博客网站经常有,也挺实用的就加上了),会在编辑区滚动超过一定距离后出现,点了平滑滚回顶部。所有者状态下滚动 Markdown 窗格即可,滚动同步会带预览一起回顶;只读访客的预览区是唯一可滚动区域,就直接滚它。
第三阶段:语义检索与国际化
引入了两个新能力:按意思检索的语义搜索和中英双语支持。
语义检索
为什么要在本地做
考虑到团队文档一多,靠标题关键词搜就不够用了。人的记忆力有限,记得内容但想不起标题,是很常见的情况。语义检索解决的是这个问题,用一句话描述你要找的东西,系统按意思匹配,而不是按字面匹配。
由于之前关系型数据库用的就是 SQLite,因此向量数据库直接用 sqlite-vec 扩展即可,和业务数据放在同一个 wiki.sqlite 里,不额外起服务;至于向量模型用本地的 Qwen3-Embedding-0.6B,只在 CPU 上跑,不占用 GPU。这样的代价是首次建索引慢一点,好处是零新增依赖、零外部服务、部署简单。(在 brain-mix 项目中我使用的是 bge-large-zh-v1.5 作为向量模型,这次选 Qwen3-Embedding-0.6B 是想尝试一下新突破,这也是为后面的个人人工智能助手做准备。至于选 0.6B 是因为它放在 CPU 运行刚刚好,无论你机器有没有显卡算力都能用上,并且 0.6B 用 1024 维已经足够了,就没必要硬上更高参数了)
内容怎么切成块
长文章不能整篇压成一个向量,那样召回的粒度太粗。系统把文章按"标题 + 正文"切块:
- 每个块开头都带上文章标题,让标题作为上下文一起参与编码
- 以空行分隔的段落为最小单位,贪心累积到约 450 个 token
- 相邻块保留 15% 的重叠,避免正好卡在边界上的信息丢失
- 超过 512 token 的长段落按 token 硬切
- 图片和链接的 Markdown 语法会被清理掉,只留文字
向量怎么算
编码用的是 Qwen3-Embedding 的官方推荐方式,取序列最后一个 token 的隐状态做池化,再做 L2 归一化,得到 1024 维向量。
这里有两个刻意的处理:分词器用左填充,这样序列的最后一个位置一定是最后一个有效 token;查询时加官方给的检索 instruction("Given a web search query, retrieve relevant passages..."),文档不加。这是 Qwen3-Embedding 训练时约定的用法,query 和 document 走不同前缀,效果更稳。
模型是懒加载的进程内单例,只在 CPU 上跑,实测 4 个推理线程吞吐最好(线程再多会互相抢 CPU)。启动时会在后台线程里预热,让模型常驻内存,免得第一次检索时才卡顿着加载。
换了内容怎么自动更新
这是整个功能里工程量最大的一块,也是最容易出问题的地方。用户保存文章后,向量必须跟着更新,但编码是 CPU 上的重活,不能让它堵住保存请求。
我的做法是"后台线程 + 去重队列 + 完成事件"。保存接口把节点丢进队列就立即返回,一个常驻的后台线程逐个处理,整篇重新分块、编码、覆盖旧向量。同一篇文章在排队期间重复保存只会保留一次。处理完会写一条事件,前端每 4 秒轮询一次,拿到结果就弹 toast 提示"《文章标题》向量转换完成"。
为什么不用 WebSocket?因为整套前端就是 Flask 加 fetch,没有长连接,用轮询可以零新增依赖地解决问题。
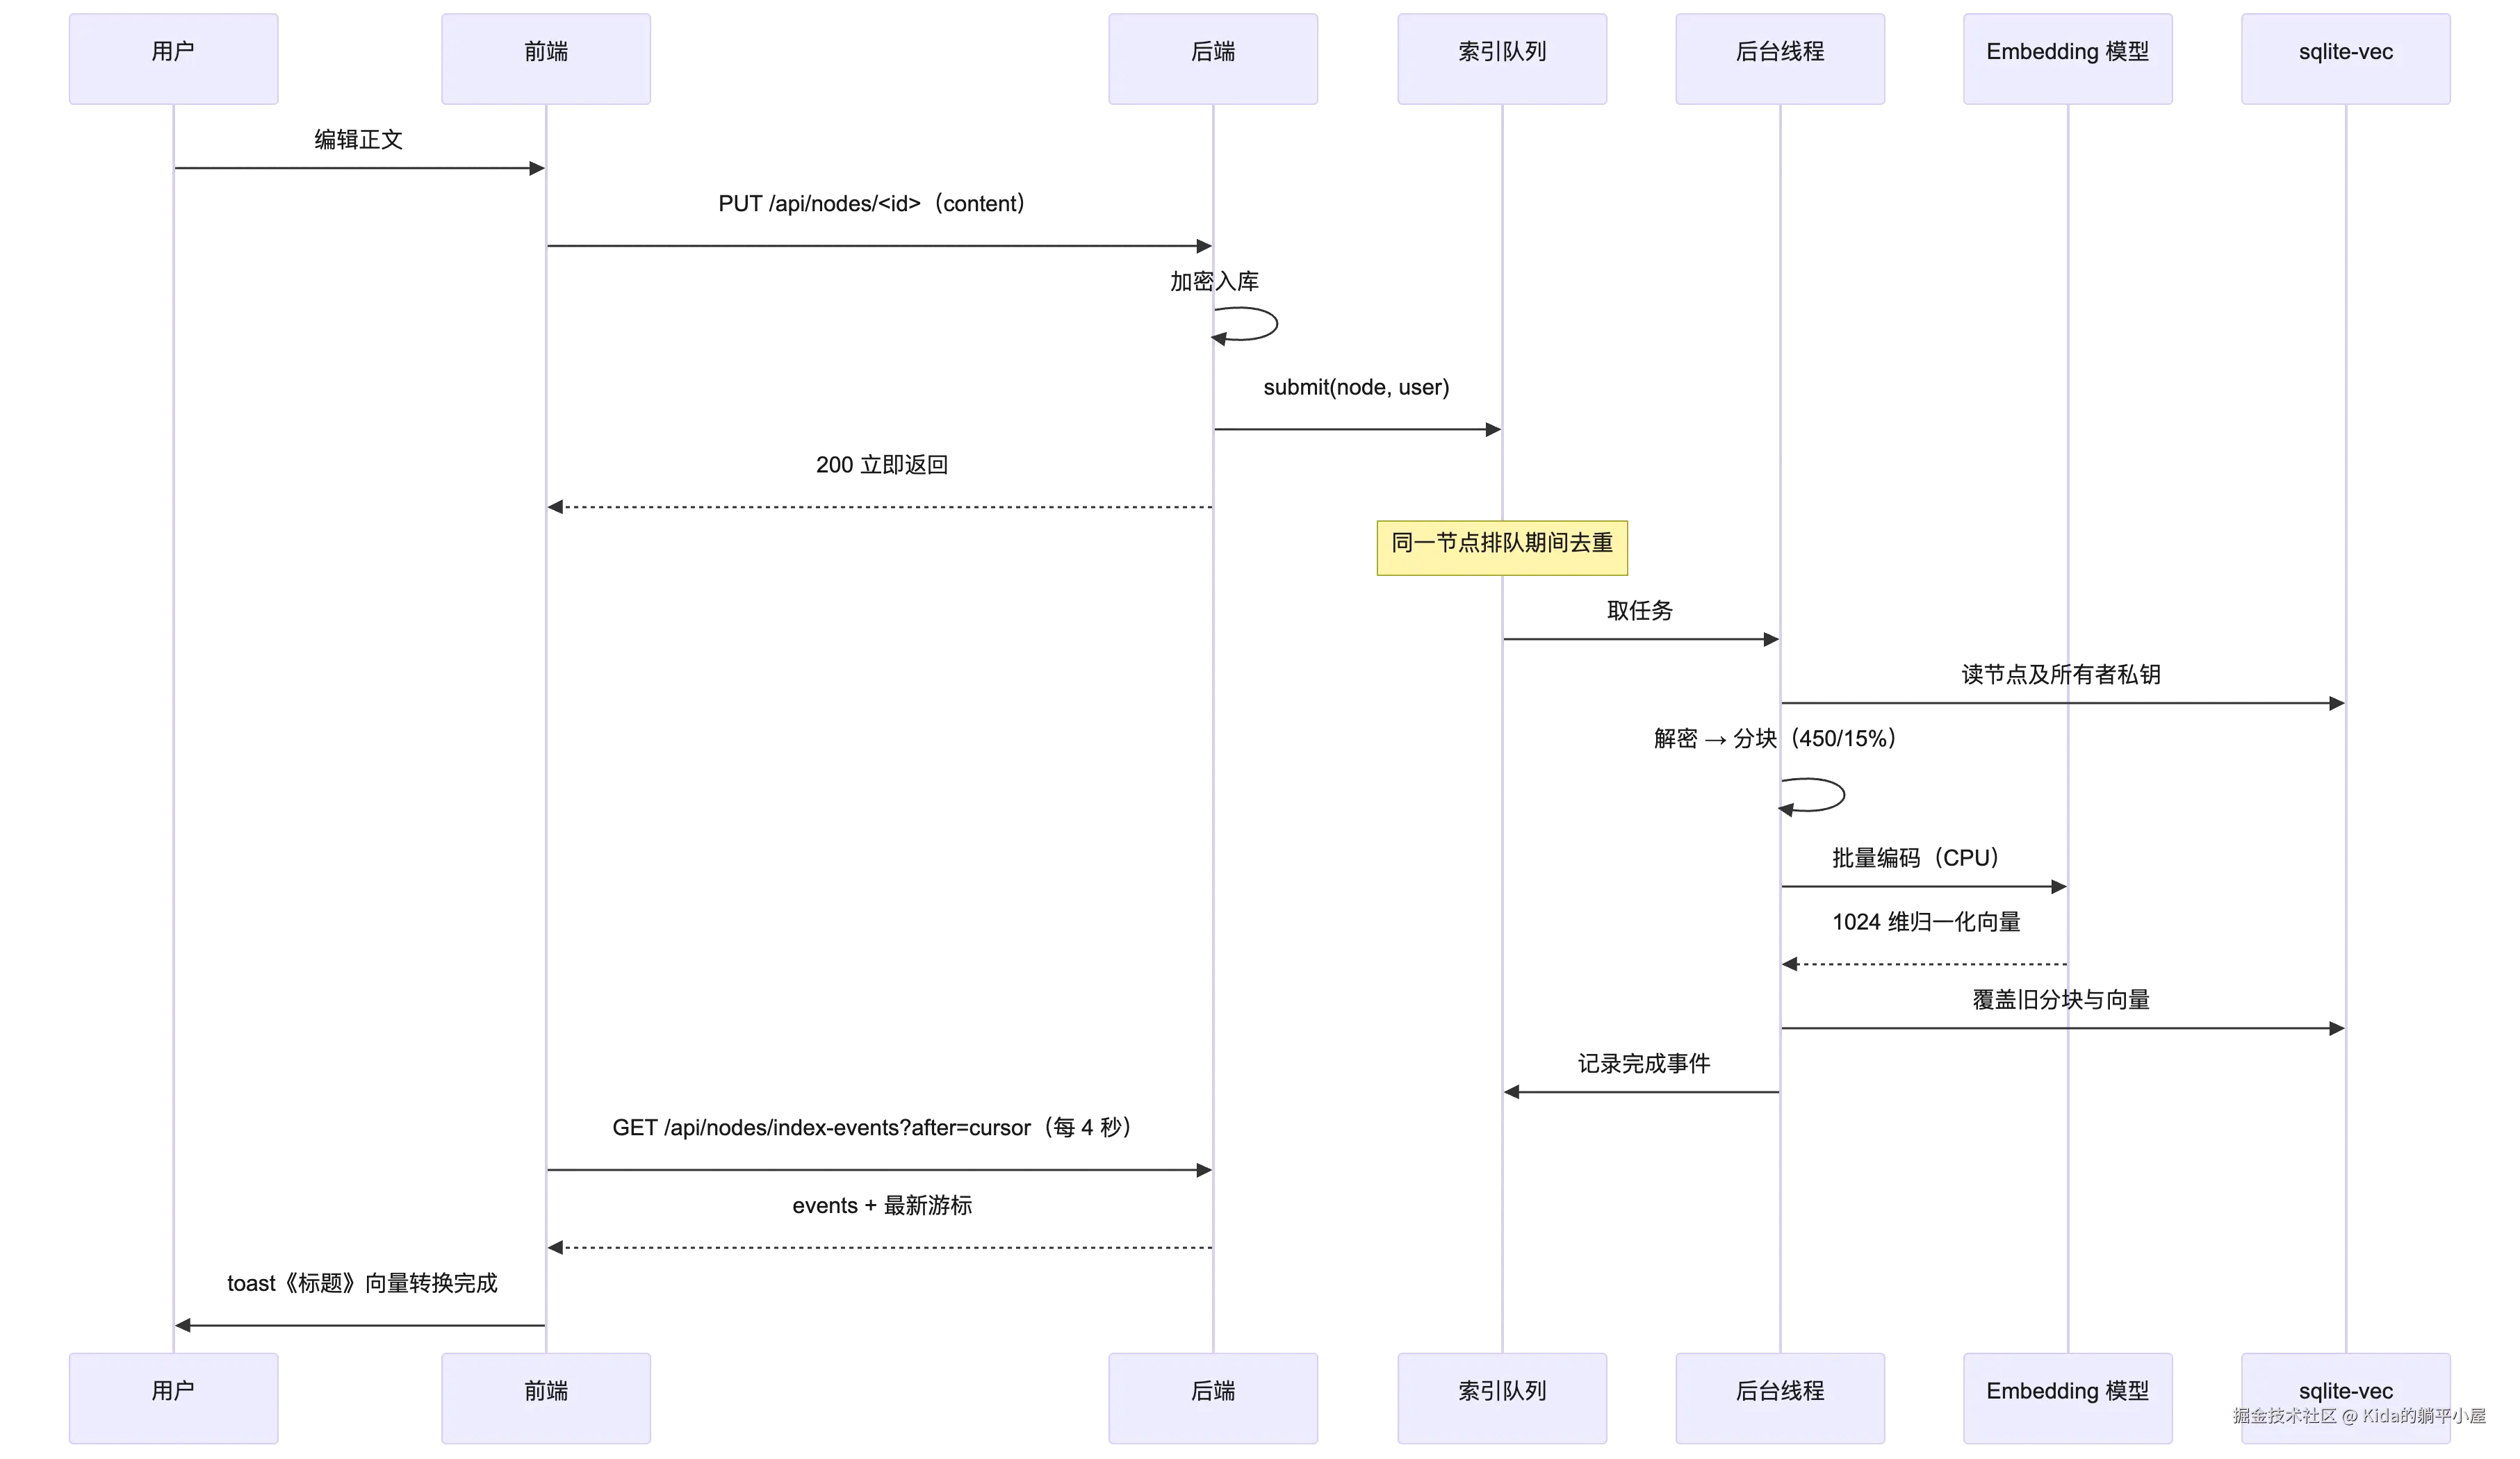
事件按用户隔离,页面只能看到自己触发的转换结果;游标机制保证第一次轮询只取当前位置,不会把历史事件当成新事件重复弹提示。
除了运行时的自动重建,还有一个命令行脚本 scripts/build_vectors.py 用于首次建库和手工重建,支持增量、全量重建(--rebuild)、只处理单篇(--node-id)和清理残留(--prune)。它和运行时用的是同一套索引逻辑,保证两条路径行为一致。
检索时怎么过滤
搜索接口接受自然语言查询,返回文章标题、命中的片段和相似度。检索本身用 sqlite-vec 做 KNN,但有两层过滤必须做对:
一是权限。只返回当前用户是所有者、或已被授权的文章,查询里带上了权限判断。
二是锁定。is_locked = 1 的文章直接排除,和前面锁定的设计保持一致。
另外,命中池子放得比要返回的数量大不少(至少 200 条候选),因为长文章分块多,池子太小会被单篇文档占满,去重后反而只剩一两个节点。每个节点最终只保留最相关的那一块。相似度按归一化向量的性质换算成 1 - d²/2,换算后夹在 0 到 1 之间,前端显示成百分比。
整个检索链路是这样:
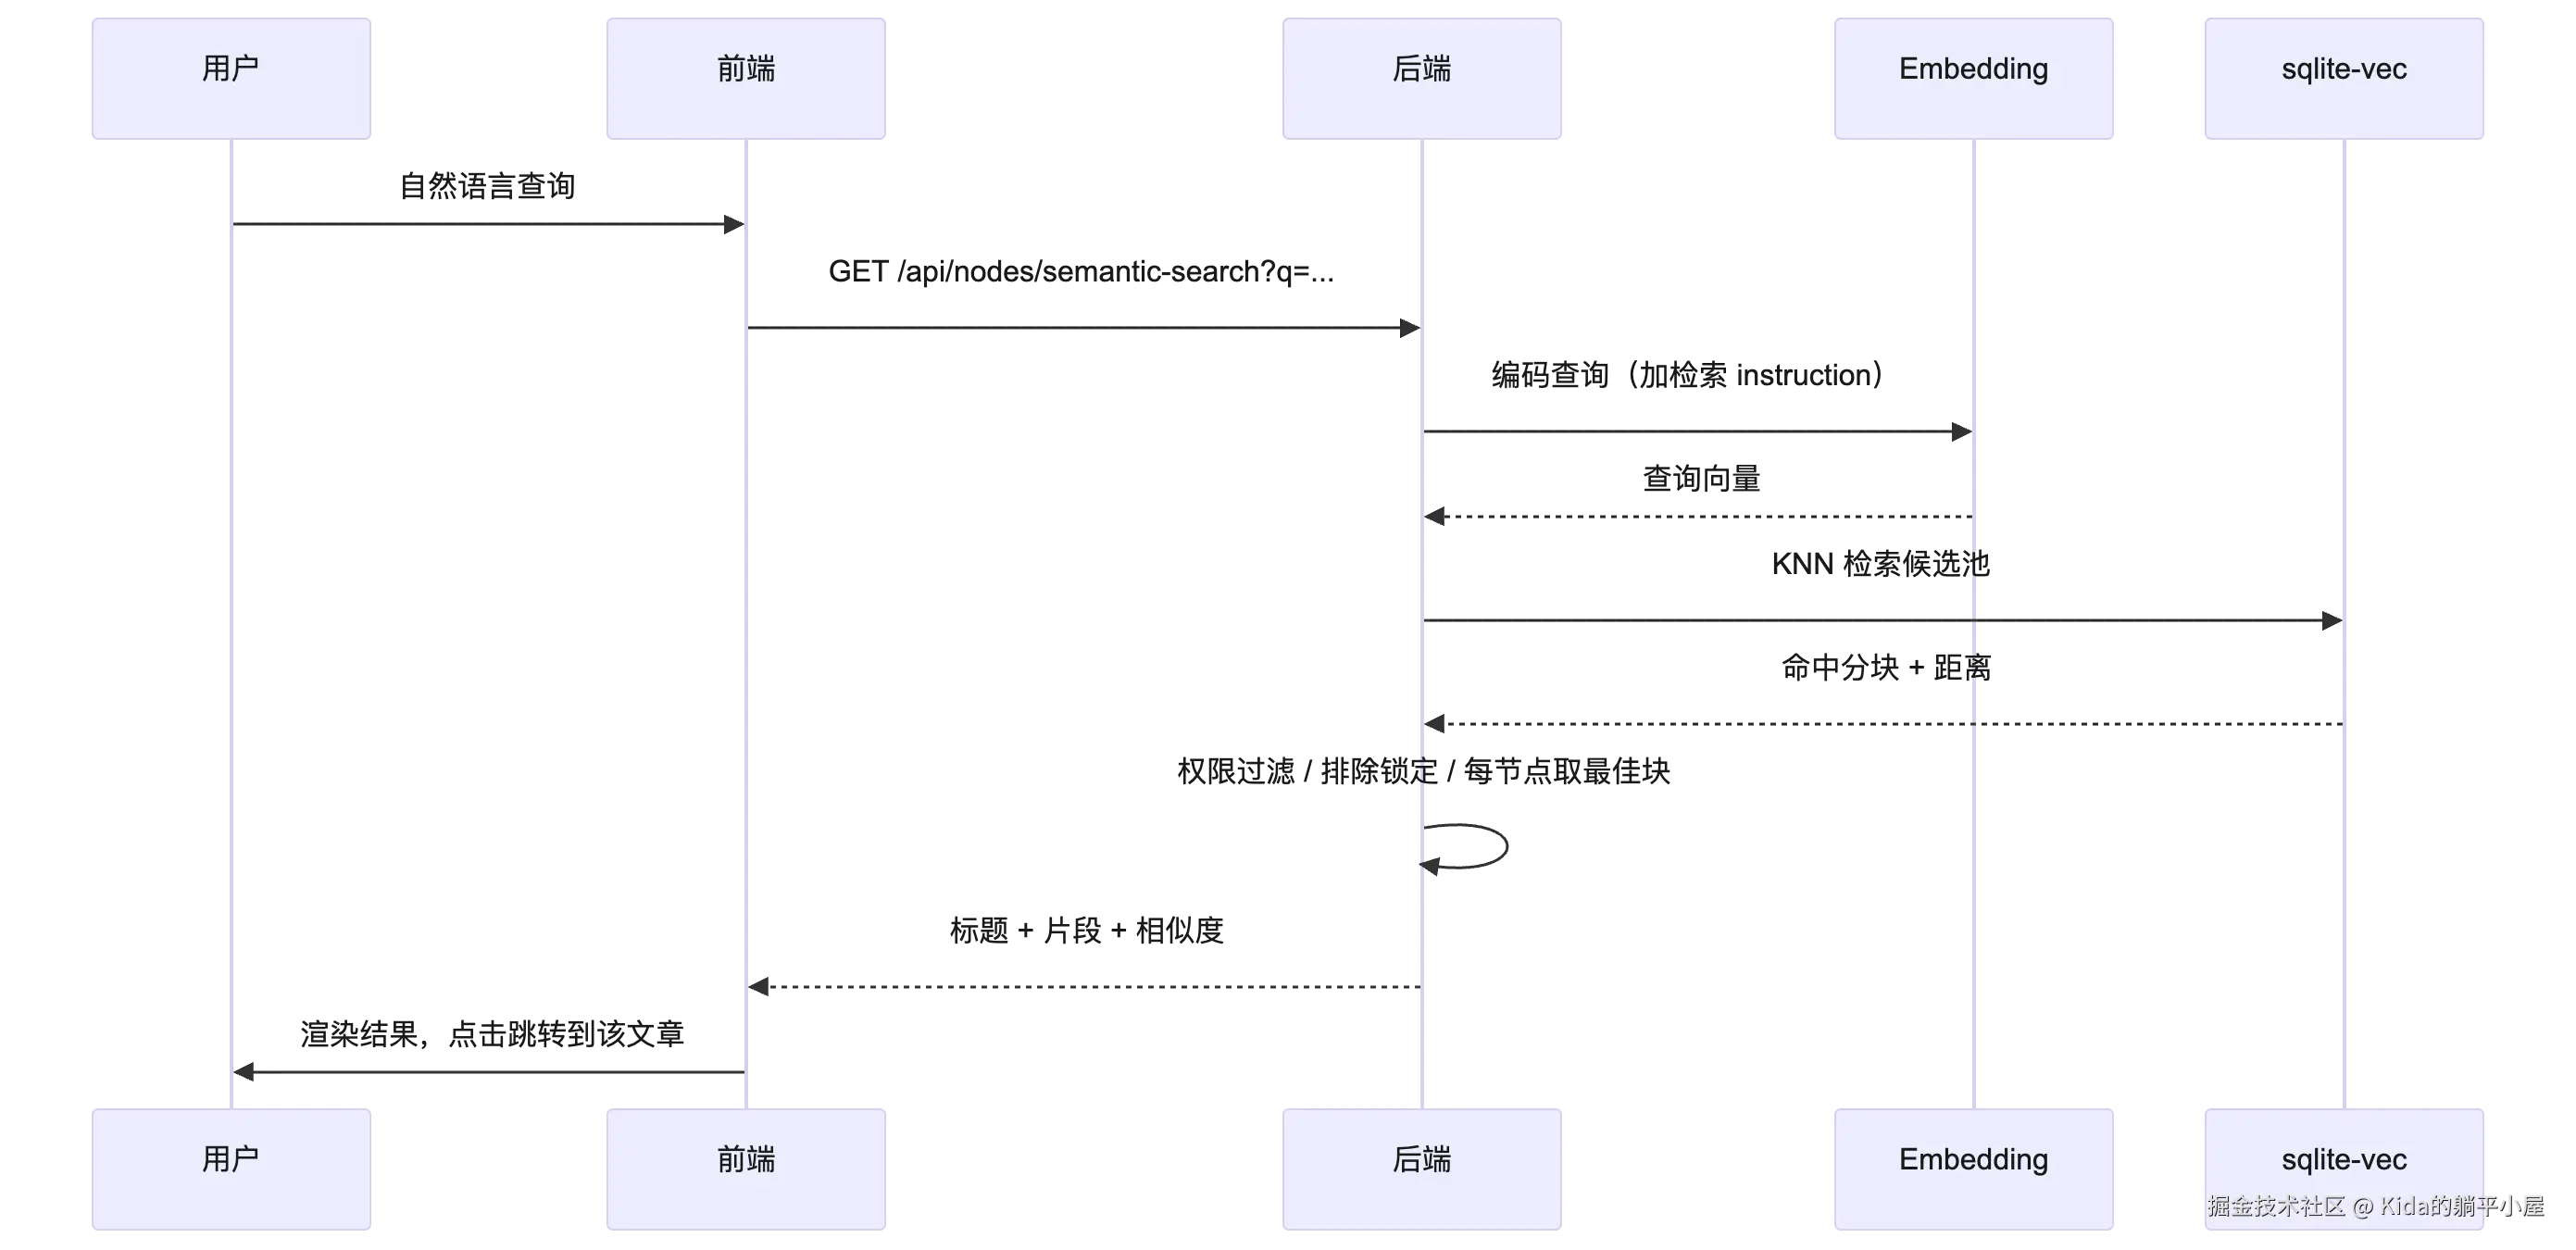
侧边栏加了"标题|语义"两个模式标签。切到语义模式输入自然语言即可,点击结果会跳回文章树并打开对应文章。
国际化
原来系统只有中文。为了让 GitHub 用户也能够看懂,这次加了完整的中英双语,默认英文。
前端做法是标准的 data-i18n 方案:index.html 里的静态文案标上 data-i18n 键,JS 里拼的字符串走 I18n.t(),两份语言的字典放在 i18n.js。语言开关做成"中|EN"的分段滑块,登录页和顶栏各一个,两处同步,选择存在浏览器本地(localStorage 加 cookie)。因为登录前就要能切换,所以不做账号级同步。
后端做法比较有意思。如果让每个路由 handler 都去查字典,改动量太大,也容易漏。这里的处理是:handler 照常写中文,以中文原文做 msgid 建一张到英文的映射表,再挂一个自定义的 JSON Provider,在序列化响应时统一把 error / message 字段翻成英文。带参数的提示(比如"不支持的文件格式: .zip")用正则规则匹配。这样业务代码基本不用动,只需要在新增提示时往字典里补一条。邮件通知因为不走 JSON,单独用 t() 按当前语言取模板。
为了让这套机制不出错,配了一个检查脚本 scripts/check_i18n.py,它会检查四件事:前端 JS 里不该残留中文字面量(注释和开发者日志除外)、HTML 用到的 data-i18n 键都要在字典里、中英两套字典的键要完全一致、后端所有 jsonify 的提示文案都能被翻译。新增或改动文案后跑一遍,能挡住大部分漏译。
其他更新
这一批还更新了依赖清单(补上 sqlite-vec、transformers、torch 等),README 重写并加了英文版,config.py 集中了 embedding 相关参数(模型路径、设备、精度、线程数、批大小、分块参数等),都可以用环境变量覆盖。启动时应用会自动建向量表,并做幂等迁移。
部署与运维
有几个约束是上线前必须清楚的,否则容易踩坑。
语义检索必须单进程运行。 embedding 模型常驻内存约 2.7GB,每个 worker 都会各自加载一份;而且异步索引的完成事件存在进程内存里,多 worker 时"保存"和"轮询提示"可能落在不同进程,前端就收不到 toast。所以 run.sh 里把 gunicorn 的 worker 数固定成 1,不要调大。
模型和向量数据都在本地。 embedding 模型目录默认在作者机器上的路径,部署到别的机器要用 OPS_WIKI_EMBED_MODEL 改掉;向量和业务数据同库,不需要额外服务。
首次部署要建索引。 已有文章需要在装好依赖后跑一次 scripts/build_vectors.py,之后日常编辑由异步任务自动维护。我本地的 intel i5 CPU 推理实测约 0.55 块/秒,以约 800 块的数据量估算,全量首建在 20 到 30 分钟。
旧库兼容是自动的。 启动时会检查并补齐 node.is_locked、node.lock_password_hash 两列,并幂等创建向量相关的四张表,不需要手工迁移。
还没完善
有几件还没做好的事:
-
语义检索的命中片段以明文存在
node_chunk表里,用于展示。如果对这点敏感,可以改成只存向量、检索时再解密取片段,但会慢一些,目前没做。 -
文章锁定的密码校验没有失败次数限制,也没有针对解锁接口的限流。考虑到系统定位是内网/本地使用,暂时可以接受。
-
数据库仍是 SQLite,并发写多的时候可能遇到锁冲突(连接超时设为 5 秒)。几十人的小团队够用,规模再大建议换 PostgreSQL。
-
系统本身没有面向公网做安全加固,README 里也明确写了不要暴露到公网。
说在最后
现在万物都说自己有 AI,但个人还是觉得要看情况。就像 "AI+Office" 的确能够帮你大大提升效率,但与此同时你的个人信息、数据也会被大量流出(私有部署除外)。虽然厂商一再强调不使用个人数据进行训练,也会严格按照国家法律法规对数据的采集使用进行约束。但天底下没有免费的午餐,商业行为必须是通过利益驱动的,我不想以小人之心去揣度任何事情,但往往免费的东西才是最贵的,我觉得往后"数据"就算其一,尤其是结构化后干净纯洁的高质量数据。
因此,守住自己的数据也是算是我做这个项目的目的之一。
真的很佩服 LibreOffice 能在万物 AI 的大时代说出"不接入 AI"的豪言壮语。我也向它学习,这个项目我会尽量不引入外部服务,保持轻量。后面也会时不时进行更新,像移动端的能力现在还没有,后面弄一下也不难。