关系型数据库的伸缩:读写分离与集群扩展
简介:商品这类读多写少的场景,用主库写、从库读的读写分离,再水平扩展读库来解决性能瓶颈
-
底层数据不只是 DBA 的事
- 底层数据不只是数据库里的数据,还包括很多业务层面的数据,和开发团队息息相关
-
为什么需要读写分离
- 以商品中心为例:发布商品、修改价格是写操作(insert / update),场景很少
- 营销玩法、搜索等大量场景都是读商品
- 读多写少的业务,瓶颈在读操作,解法就是读写分离
-
读写分离架构
-
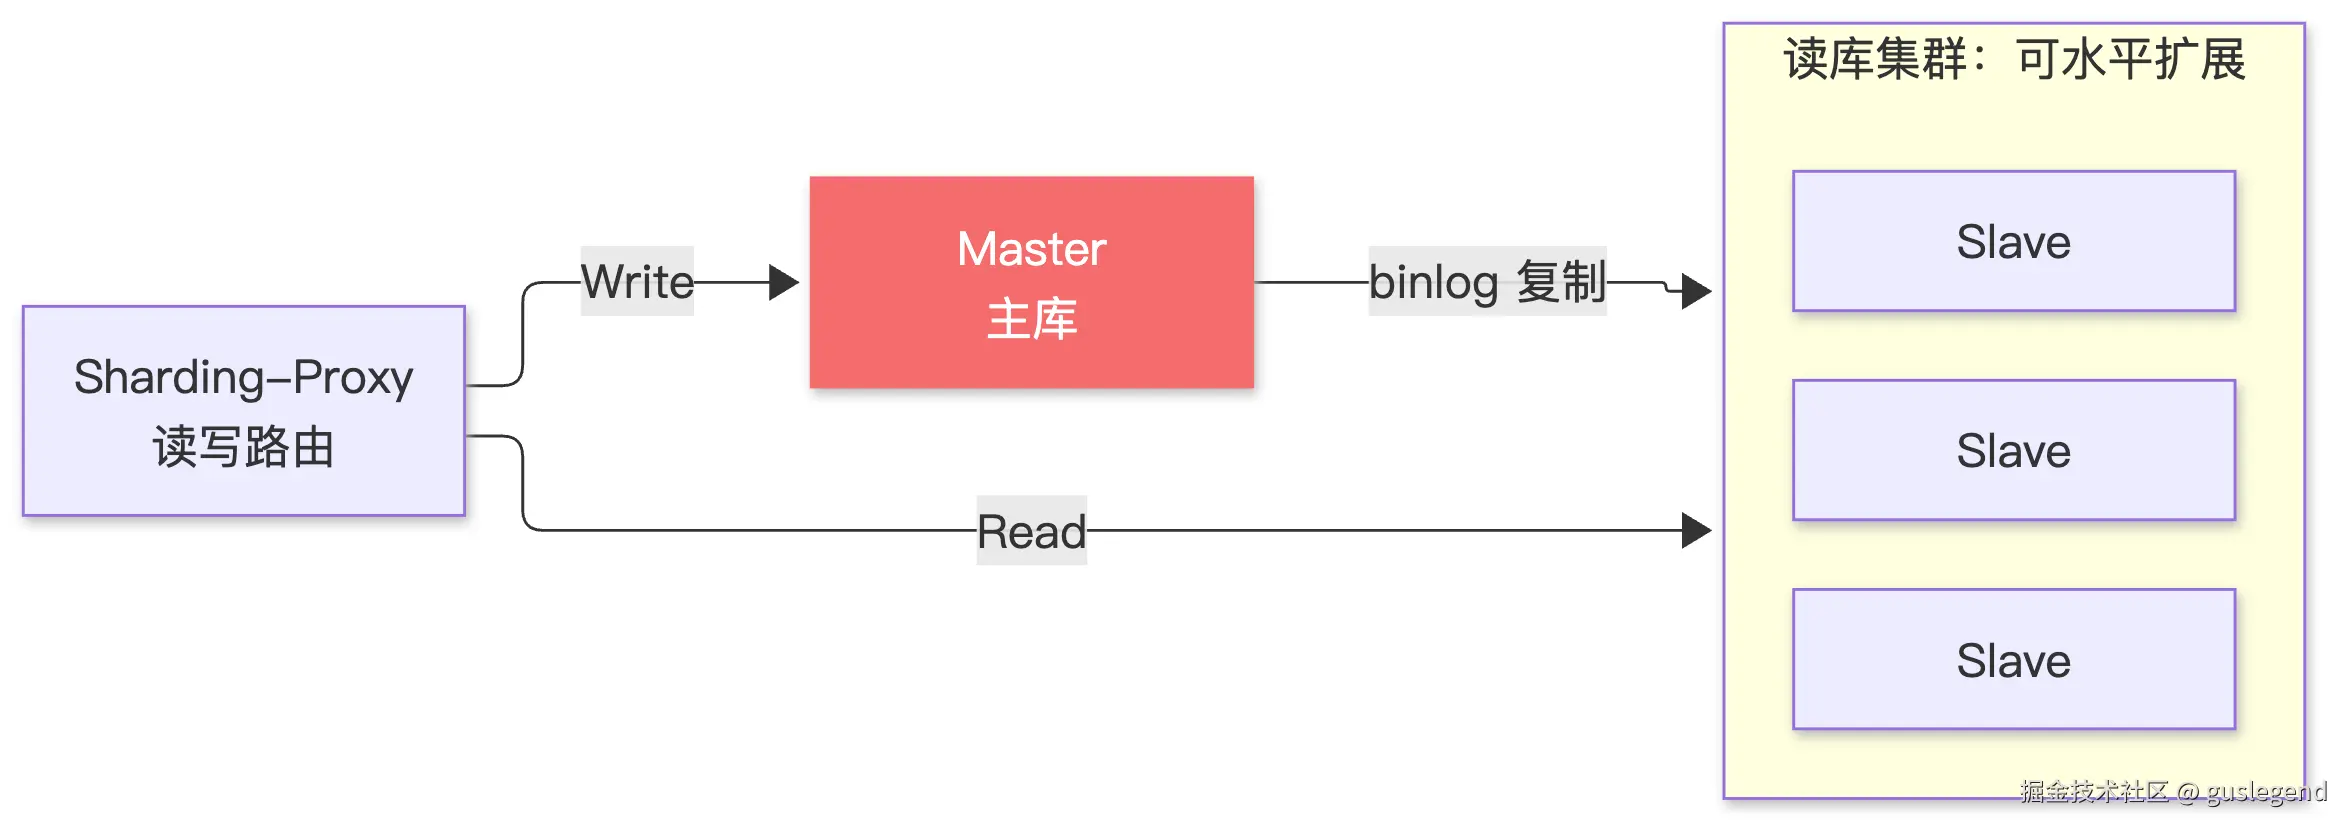
图中红色节点是唯一的写入点
- 以 MySQL 为例:一个主库 Master 负责写,多个读库 Slave 负责读
- 主从之间通过 binlog 做复制(Replication)
- 读请求增多时,水平扩展读库节点即可解决性能瓶颈
- 额外好处:读库集群被打崩也不影响 Master,写请求照常处理
-
性能高的深层原因:消除锁竞争
| 锁 | 别名 | 加锁后 |
|---|---|---|
| 排他锁 | 写锁,写入时加 | 锁释放前,其他事务不能修改或读取这条数据 |
| 共享锁 | 读锁,读取时加 | 其他事务只能再加读锁,不能加排他锁,数据只能被共享读取、不能被修改 |
-
读写都落在 Master 时,两种锁互相竞争、相互拖累;读写分离后两者"老死不相往来",自然消除了竞争
-
如何落地
- 在代码里判断 select 导向 Slave、update / insert 导向 Master:可行,但不优雅,还增加开发量
- 更优雅的做法:用 Sharding-Proxy、Sharding-JDBC 这类中间件,自动把读请求导向 Slave、写请求导向 Master
-
另一种解读:缓存和搜索引擎也是读写分离
-
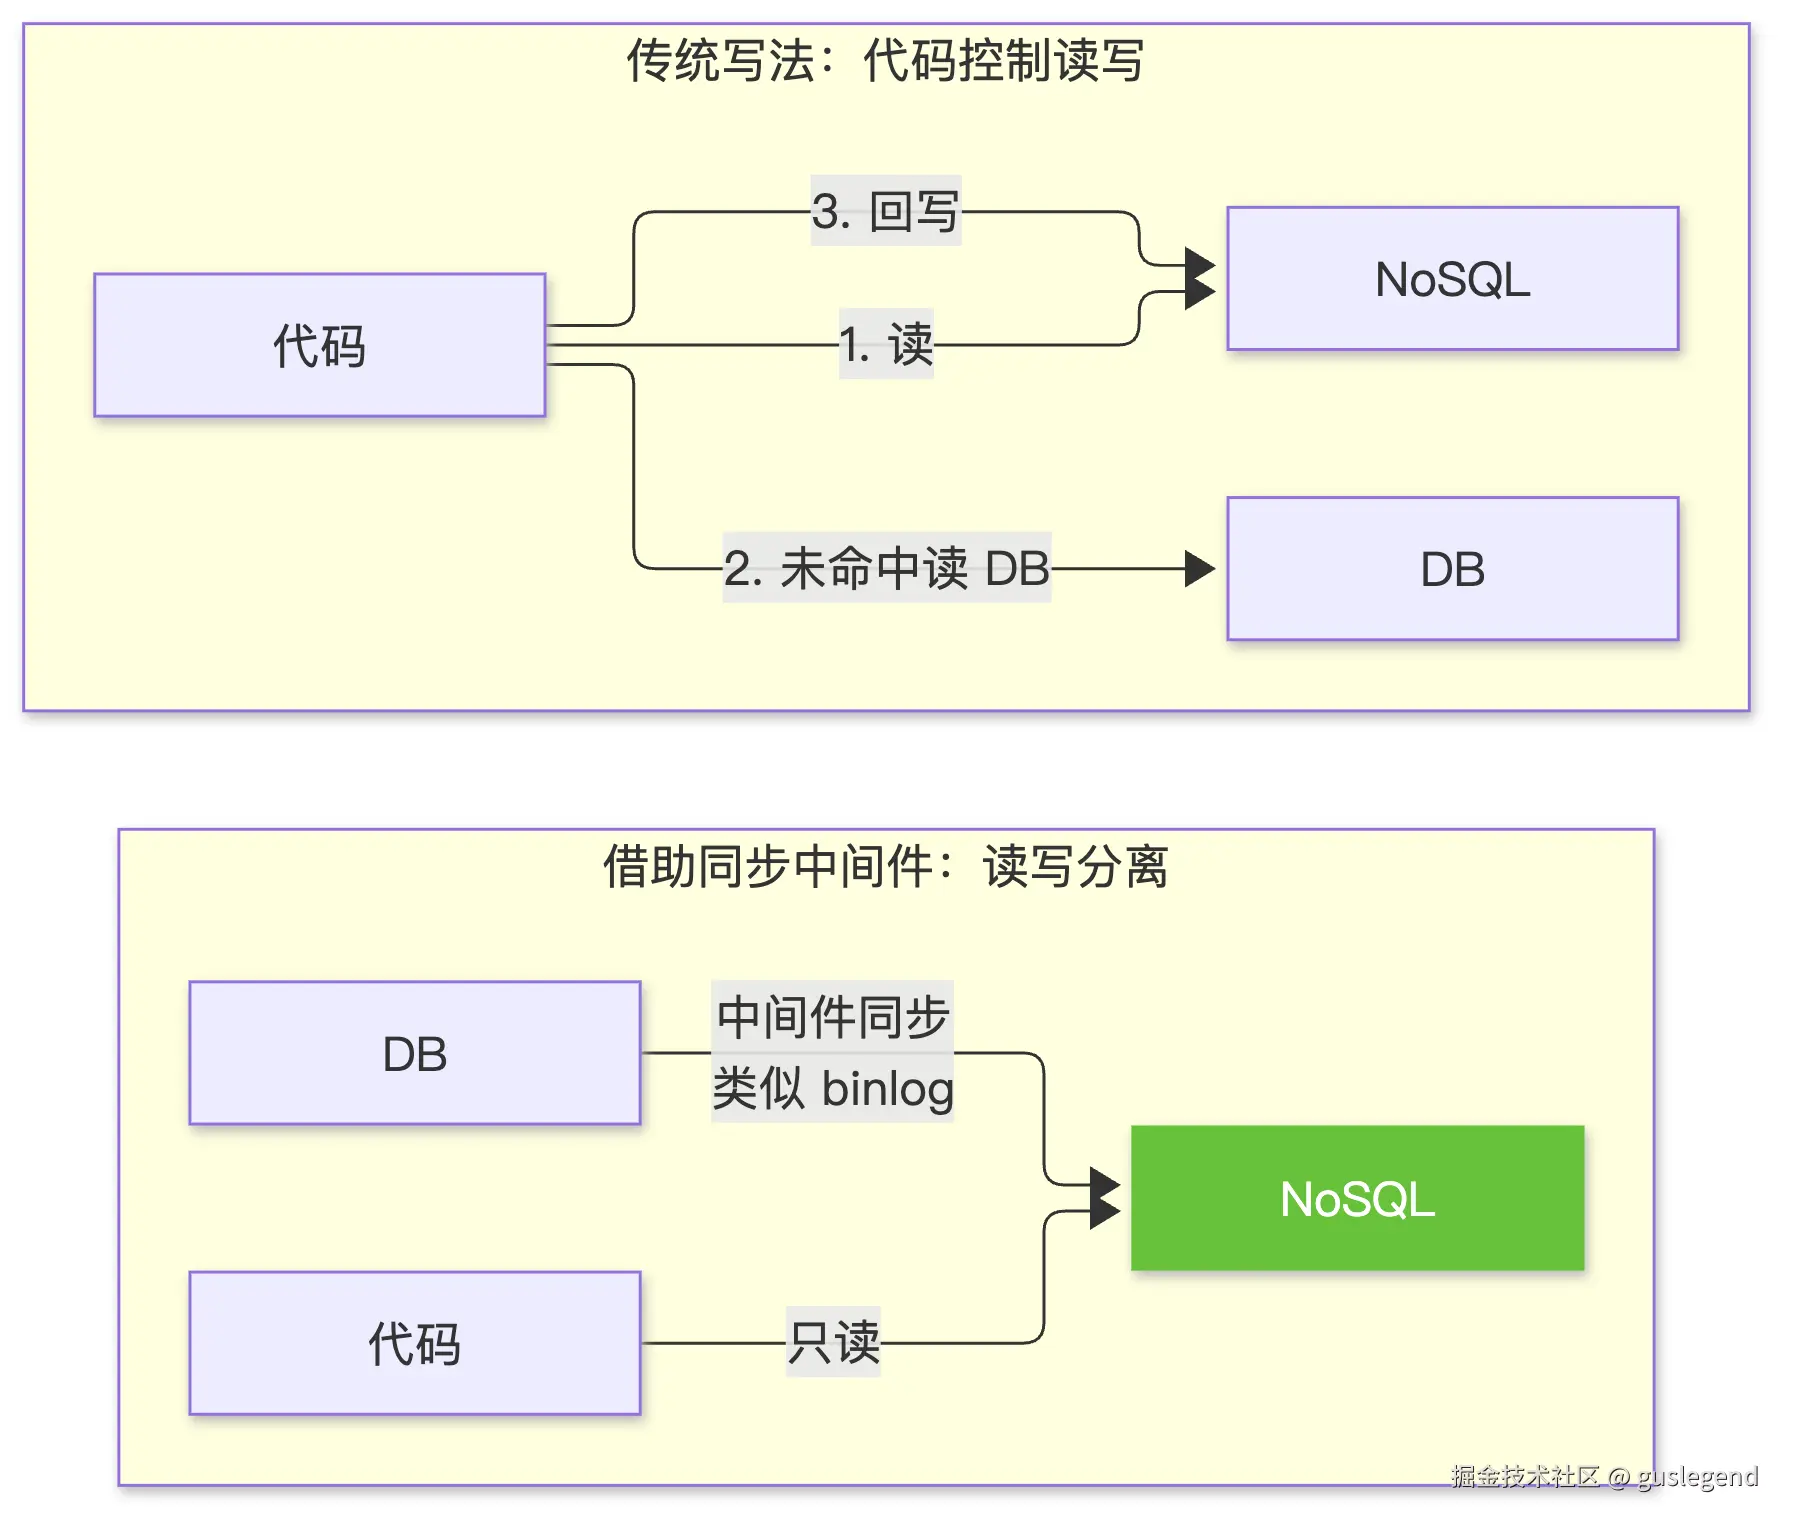
图中绿色节点是代码唯一需要读取的地方
- NoSQL 指 ES、OpenSearch、Redis、Solr 这类缓存或搜索引擎
- 传统写法:先读 NoSQL,读不到再查 DB,再写回 NoSQL;从哪读、往哪写、怎么同步都由代码控制,不算读写分离
- 借助数据同步中间件:代码只管读 NoSQL,DB 到 NoSQL 的同步交给中间件,原理和主从 binlog 同步异曲同工
-
读写分离的死角
- 每个 Slave 都存全量数据:商品从 50 万涨到 500 万,Master 和每个 Slave 都是 500 万
- 单表记录超过一定数值,查询和写入性能会显著下降,多买硬盘解决不了,需要分库分表
分库分表
简介:分库分表其实是分库和分表两件事,各有垂直和水平两个维度,用来解决单表数据量过大的问题
-
垂直分表
- 按字段把一张表拆成多张表,每张表存一部分字段
- 经常查询的
name、price放在商品主表Product - 不常查询又占 IO 的 clob / blob 大字段单独拆出:描述
desc→PROD_TEXT,主图img→PROD_IMG - 相对冷门的字段也可以拆出去
- 大部分业务只查主表就够了,实现简单,没有技术难度
-
水平分表
- 多张表字段完全一样,如
Product_0、Product_1、Product_2,不同的数据落到不同的表 - 数据落在哪张表由路由规则决定
- 多张表字段完全一样,如
| 路由规则 | 典型场景 | 优点 | 缺点 |
|---|---|---|---|
ID 取模:商品 ID % 表数量 |
商品表 | 单表数据量显著降低,整体查询效率提升 | 不好水平扩展:加表后模变了,同一个 ID 会路由到别的表,每次扩容都要迁移数据 |
| 时间分片:按月、按季度等 | 订单表 | 随时间新增表即可,没有迁移问题 | 数据分布可能不均匀,如双十一当月的订单比过去 6 个月还多 |
-
分库
- 垂直分库:和垂直分表类似,按业务维度把不同业务的数据放到不同数据库
- 水平分库:多个库(
DB_0、DB_1),每个库下面再做水平分表,形成树状结构
-
水平分库分表的路由计算
-
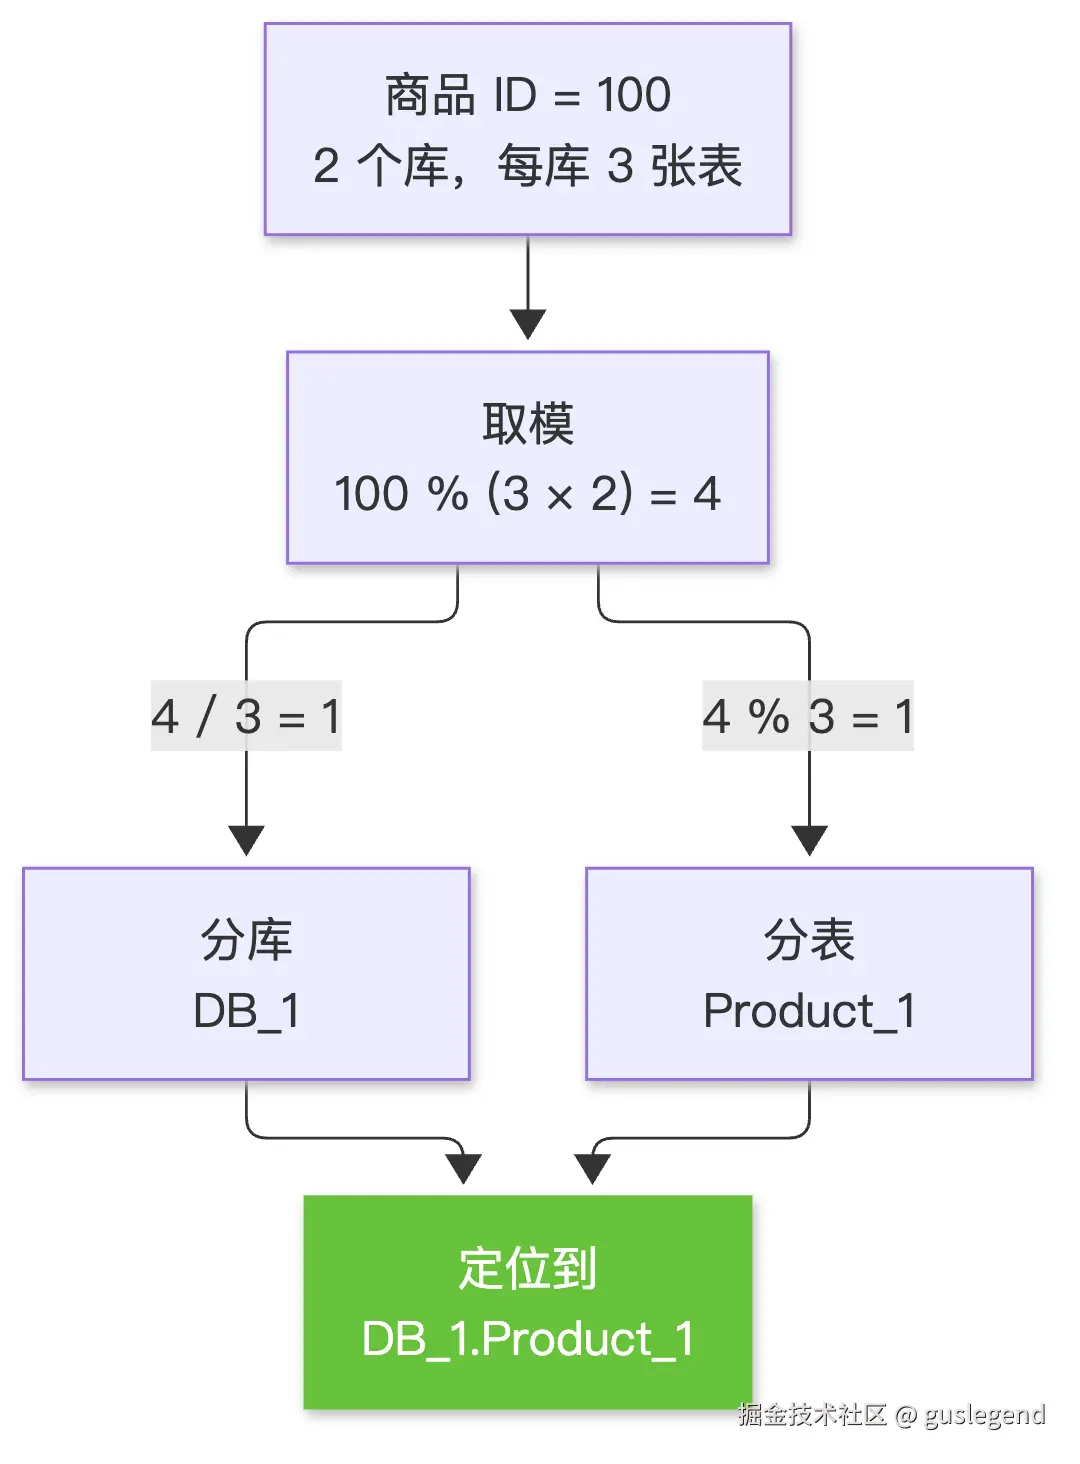
图中绿色节点是最终定位的表
- 第一步取模:模 = 每库表数 3 × 库数 2 = 总表数 6,
100 % 6 = 4 - 第二步分库:
4 / 3 = 1(除法),定位到第二个库DB_1 - 第三步分表:
4 % 3 = 1(取余),定位到第二张表Product_1 - 实际开发中由分库分表中间件计算,不用手写
- 第一步取模:模 = 每库表数 3 × 库数 2 = 总表数 6,
-
哪些数据需要分库分表
- 注册用户、用户信息、订单、商品等大数据量业务,在互联网场景下一定要做
- 没做的原因:业务量还没到那个量级,或者公司有钱用了昂贵的商业数据库
- 海量数据面前,再好的关系型数据库也得分库分表,否则单表体量会拖垮查询性能
-
数据异构
- 订单按订单 ID 分库分表后,查询"某个用户的所有订单"要扫描所有分库分表,性能不可接受
- 同一份订单数据再按用户 ID 做一套分库分表,一条数据落在多个库中,满足多维度查询
- 难点在数据同步,甚至要跨存储介质同步,如从 MySQL / Oracle 同步到 ES、Redis
分库分表的数据迁移与扩容
简介:扩容不难,难在零宕机,常用备库转主库和增量存量同步两种方案,都要求成倍扩容
- 方案一:备库转主库
-
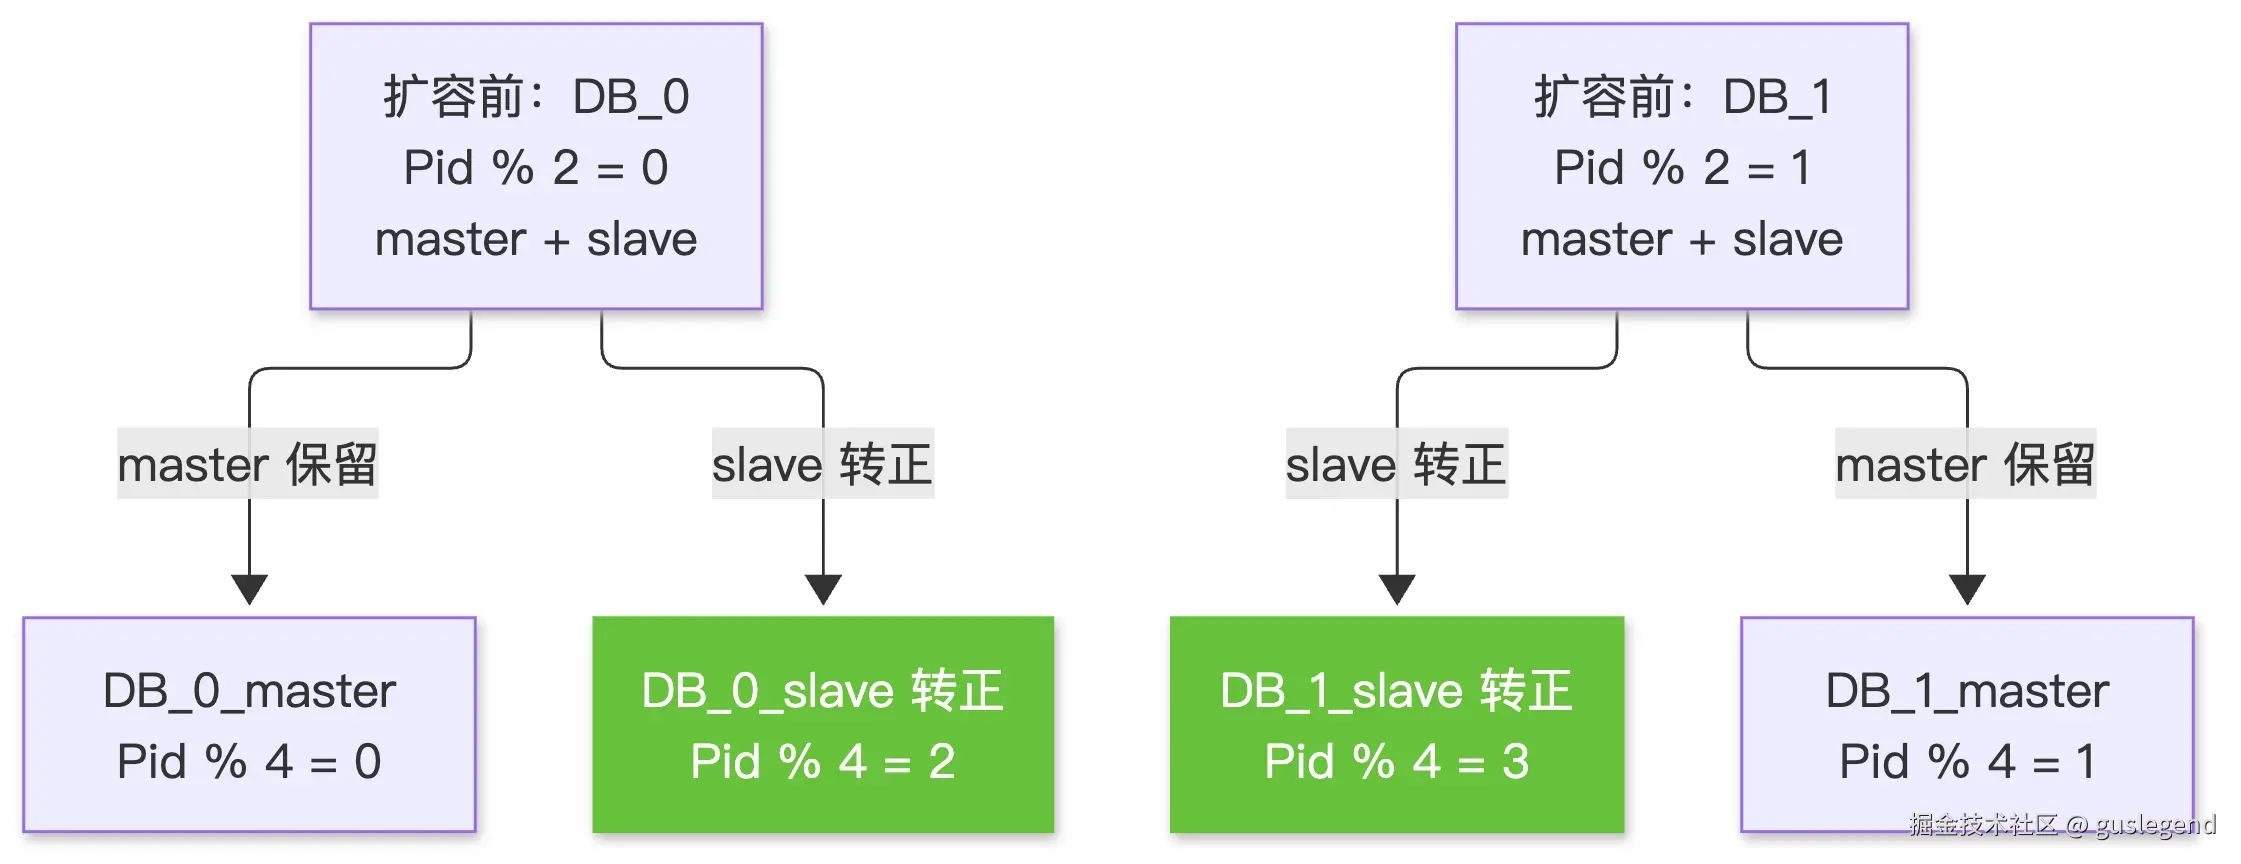
图中绿色节点是转正的备库
- 线上主库一般都有一个配置相同的 Slave 备库,备库数据和主库一致
- 路由的模从 2 改成 4,原来路由到主库的请求分一半给备库
Pid % 4 = 2的数据按老规则% 2 = 0,本来就在DB_0_master,所以DB_0_slave里也有Pid % 4 = 3的数据按老规则% 2 = 1,本来就在DB_1_master,所以DB_1_slave里也有
- 解除原来的主从备份,让备库彻底转正
- 再给 4 个主库各配一个新的备库
-
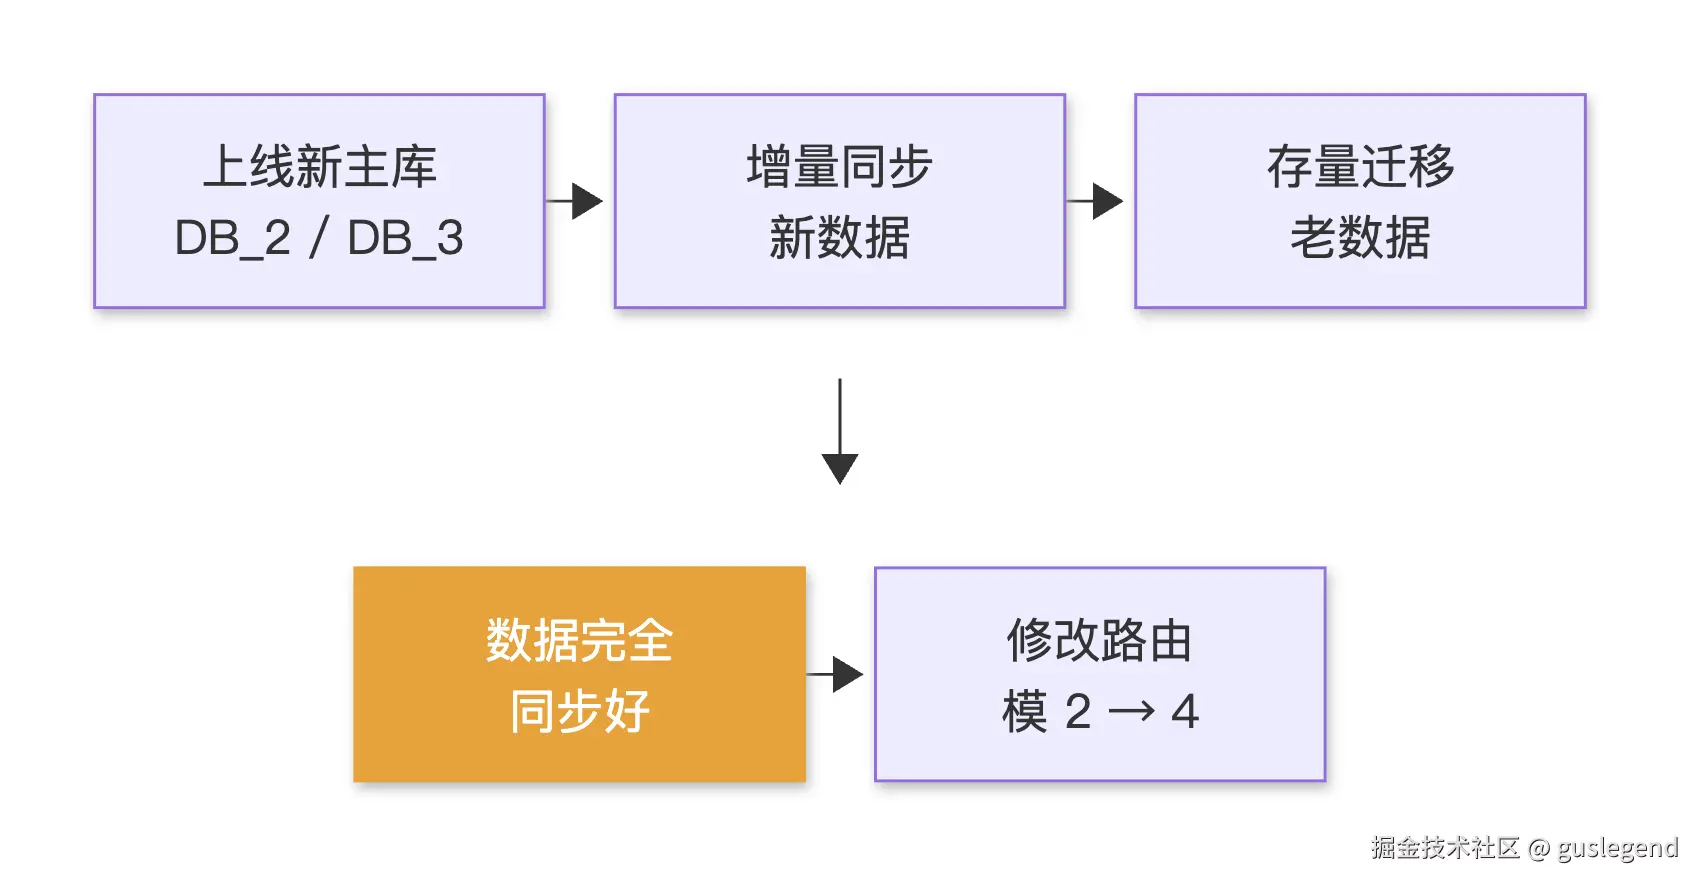
方案二:增量存量同步
-
图中橙色节点是修改路由前必须满足的条件
- 新上线的
DB_2_master、DB_3_master不是备库转正,里面没有数据 - 增量同步:从某个时间点或某个 ID 开始,把新生成的数据同步到新库,可借助数据同步中间件
- 存量迁移:把老数据迁移到新库,一般由 DBA 操作,也可以用迁移工具或自己写脚本
- 迁移期间路由不变,新库还不承接请求
- 改路由时,新库承接它增量数据来源机器的一部分请求:
DB_0拆出Pid % 4 = 2给DB_2,DB_1拆出Pid % 4 = 3给DB_3
- 新上线的
-
注意点
- 必须成倍扩容:2 进 4、4 进 8、8 进 16、16 进 32,路由规则才能平滑过渡
- 增量存量同步方案只有数据完全同步好之后,才能修改路由表
什么是热点数据
简介:热点数据是极短时间内被高并发频繁访问的数据,分为可预知热点和不可预知的突发热点
-
定义
- 热点数据:在极短时间内被频繁高并发访问的数据,被称为"团灭发动机"
- 互联网巨头踩坑最多的地方,经常因为热点数据把系统打崩
-
两类热点
| 类型 | 例子 | 特点 |
|---|---|---|
| 可预知热点 | 秒杀:百亿补贴的特价商品加倒计时 | 秒杀要提前报名,可以提前预防;业界有成熟方案,算不上技术难题 |
| 不可预知热点 | 突发新闻:明星宣布结婚、名人八卦 | 无法提前准备,突然成为热点后会对系统造成单点击穿 |
-
秒杀为什么倒计时结束才"炸"
- 倒计时期间,大部分请求被前端拦截,并不会到达后端
- 倒计时结束后,真实请求在短时间内集中涌入,频繁访问同一个热点商品
-
注意点
- 分布式缓存不是银弹:真正的热点面前缓存也扛不住
- 对不可预知热点,关键是第一时间感知变化,再按热点数据隔离处理
为什么需要对热点数据进行隔离
简介:中心化缓存或分片缓存都可能被单个热点打崩并击穿到数据库,必须把热点从普通数据中隔离出来
- 缓存为什么靠不住
- 中心化缓存存全部分库的数据:每个分库 100 万条时可行;每库 1000 万条、全平台商品以亿计时,普通数据量就能压垮这种架构
- 高并发场景下缓存也要分区:按查询维度把数据放到不同的缓存分区
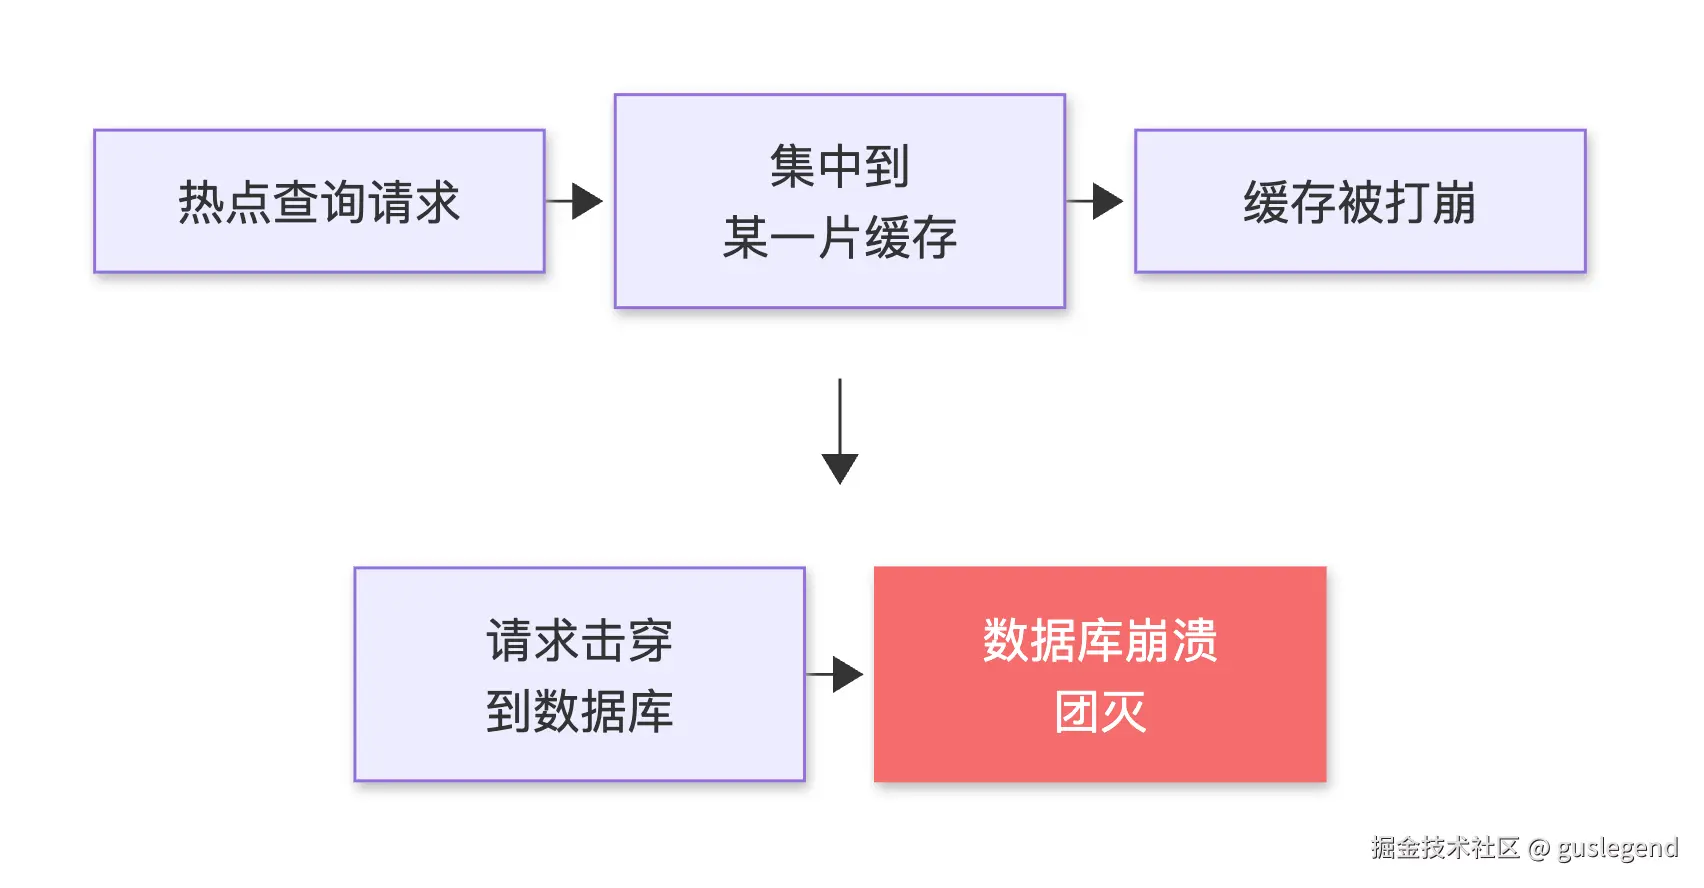
- 热点商品会被路由到其中某一片缓存,这一片承受巨大访问压力,形成单点故障
- 缓存吞吐量比数据库高,但单机 QPS 到十万以上,性能也会明显下降,Tair 这类缓存也不例外
-
图中红色节点是不做隔离的最终后果
- 把数据库和缓存看成两个存储点,这种架构就是单点故障,缓存一失效,数据库立马被打崩,要死一起死
-
数据隔离
- 把热点数据从普通商品缓存中单独抽出,形成独立的存储区域,热点失效时其他商品和业务仍能正常运作
- 超高并发场景的架构和技术选型,热点数据通常都要隔离:接口层面隔离、底层数据层面隔离
-
热点放在哪:从特征推导方案
- 架构推理要从场景现象推导解决方案
- 特征一:数量少,秒杀商品只占全部商品很少一部分,所以能存放的地方限制少
- 特征二:访问频次高,QPS 非常高
- 三种存储方案:多级缓存、热点库、热点散列
热点数据的三种存储方案
简介:多级缓存把热点放进本地,热点库用低成本隔离只读热点,热点散列让集群每个节点都能承接热点请求
- 多级缓存
- 不是在 Redis 外再套一层 Redis,而是在 Web 容器里腾出一块区域做本地缓存
- 首次从分布式缓存获取热点,保存到本地;之后直接从本地读取,大幅降低分布式缓存的压力
| 阶段 | 架构 | 问题与改进 |
|---|---|---|
| 1 | 分布式缓存 | 海量请求打到缓存的热点上,读压力过高导致服务不可用 |
| 2 | 分布式缓存 + 堆内缓存(JVM) | 大对象热点占用 JVM 空间,容易频繁 GC,影响服务响应时间 |
| 3 | 分布式缓存 + 堆外缓存 | 改用 JVM 之外的内存区域,Java 可以操作堆外内存 |
-
QPS 从低到高的演进路线:分布式缓存 → 加堆内缓存 → 加堆外缓存
-
热点库
- 本着数据隔离原则,用最低的成本把热点数据从分布式缓存中平移出来,单独做一个热点库
- 热点数据量小、只读,容易水平扩展,用多个热点库节点分担分布式缓存集群的读压力
- 实施成本低,应用广泛
-
热点散列(Tair 的方案)
- 每台 Tair 服务器(可以看作一台 Redis 服务器)都分为正常区域和 Hot Zone
- 所有 Hot Zone 存的热点数据都一样,相互之间没有权重关系
- 读热点的请求会随机落到任意一个 Hot Zone,热点请求就被散列到整个集群
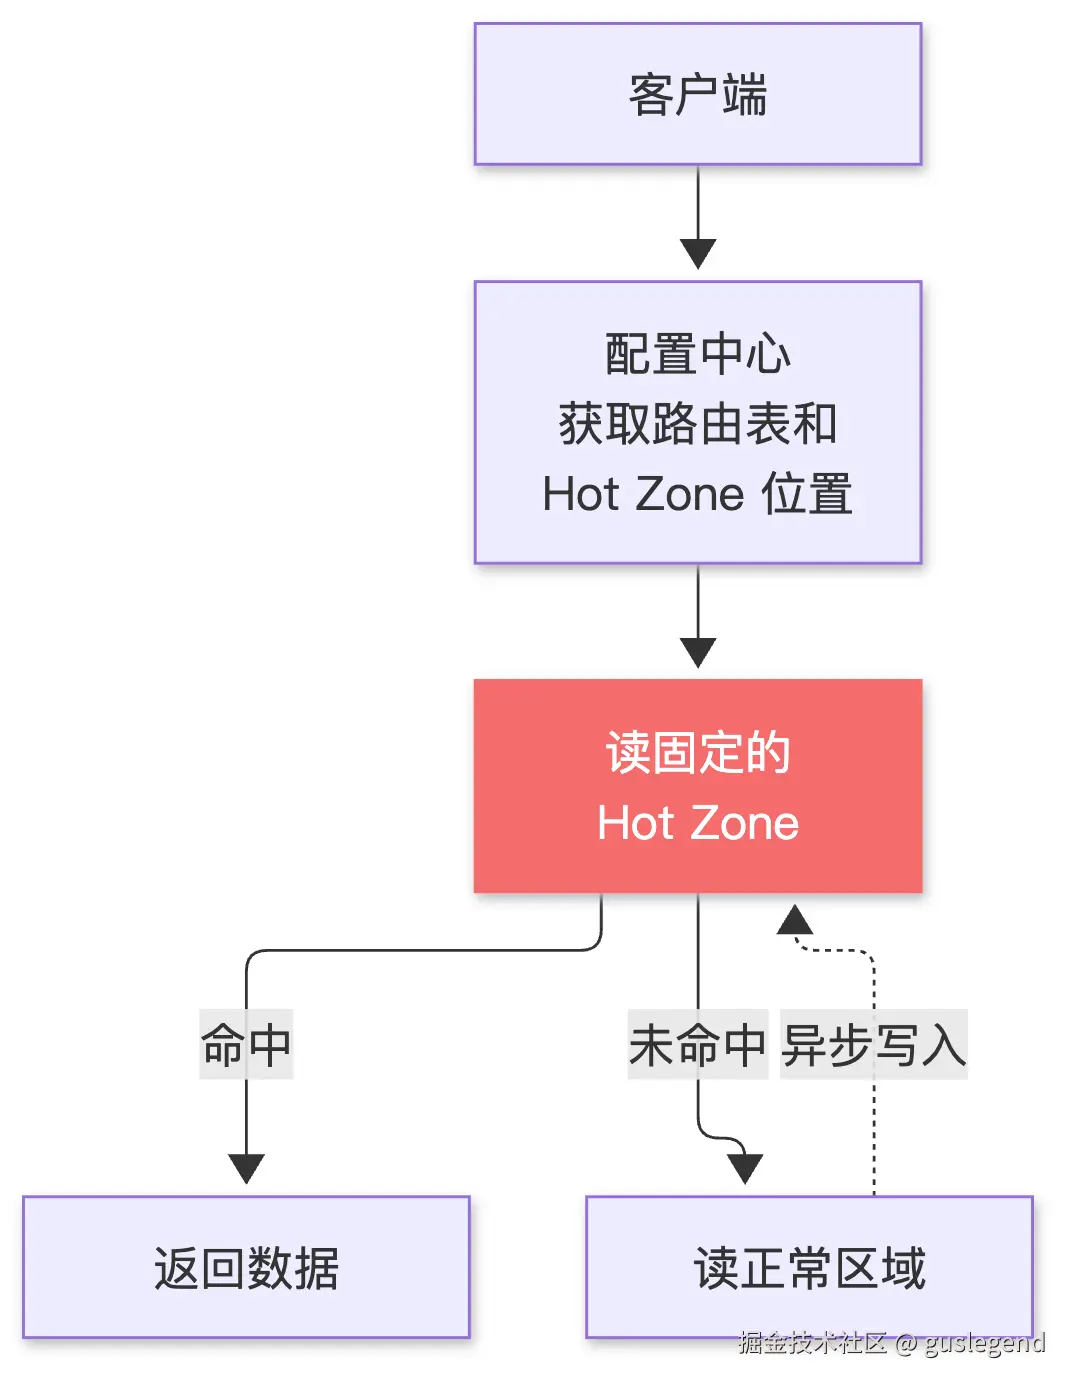
- 图中红色节点是承接热点请求的 Hot Zone
- 客户端发请求前,先从配置中心获取整个集群的数据路由表和 Hot Zone 的位置
- 客户端认定一个 Hot Zone 后固定读取,只有机器数量变化、散列配置变化时才可能更换
- 服务端反馈某个 key 是热点后,热点生效期间客户端访问这个 key 先读 Hot Zone
- Hot Zone 没有数据就去正常区域读取,再异步写入 Hot Zone,类似二级缓存
- 热 key 的同步由 Tair 实现;不用 Tair 时,要自己识别热点
如何监听热点数据
简介:根治热点分三步:识别热点、隔离热点、性能优化,其中最难的是识别不可预知的动态热点
- 三步走
| 步骤 | 手段 | 说明 |
|---|---|---|
| 识别热点 | 日志抓取、聚合分析、热点发布 | 最难的一步 |
| 隔离热点 | 缓存预热 | 把预知的热点数据提前加载到缓存 |
| 隔离热点 | 访问单元隔离 | 大促、秒杀会场用独立网址,请求导向单独设计的隔离单元,压力不传导到正常节点 |
| 隔离热点 | 数据隔离 | 单独建热点库,承接海量读请求 |
| 隔离热点 | 接口隔离 | 在接口层面对热点请求做访问控制和特殊业务逻辑 |
| 性能优化 | 缓存 | 缓解高频热点访问的压力 |
| 性能优化 | 降级熔断 | 接口异常或超时走降级逻辑;失败比例超过阈值就打开熔断开关,一段时间内请求都走降级,即 Fast Fail(快速失败) |
| 性能优化 | 限流 | 按接口 QPS 做分布式限流,在源头掐灭访问压力 |
- 识别热点:漏斗模型
- 场景:某商品买了很高的竞价排名,从默默无闻突然变成爆款,大量用户下单
- 下单时订单中心要调用商品中心查商品、营销平台算优惠、库存中心减库存和锁库存
- 电商流量是漏斗模型:入口最宽,越往下越窄,到订单时流量已经很窄
- 流量入口是搜索页和商品详情页,后面是 RPC 接口和 Gateway 网关
- 谁调用 RPC 接口查询某个商品的频率越高,它就越可能成为热点
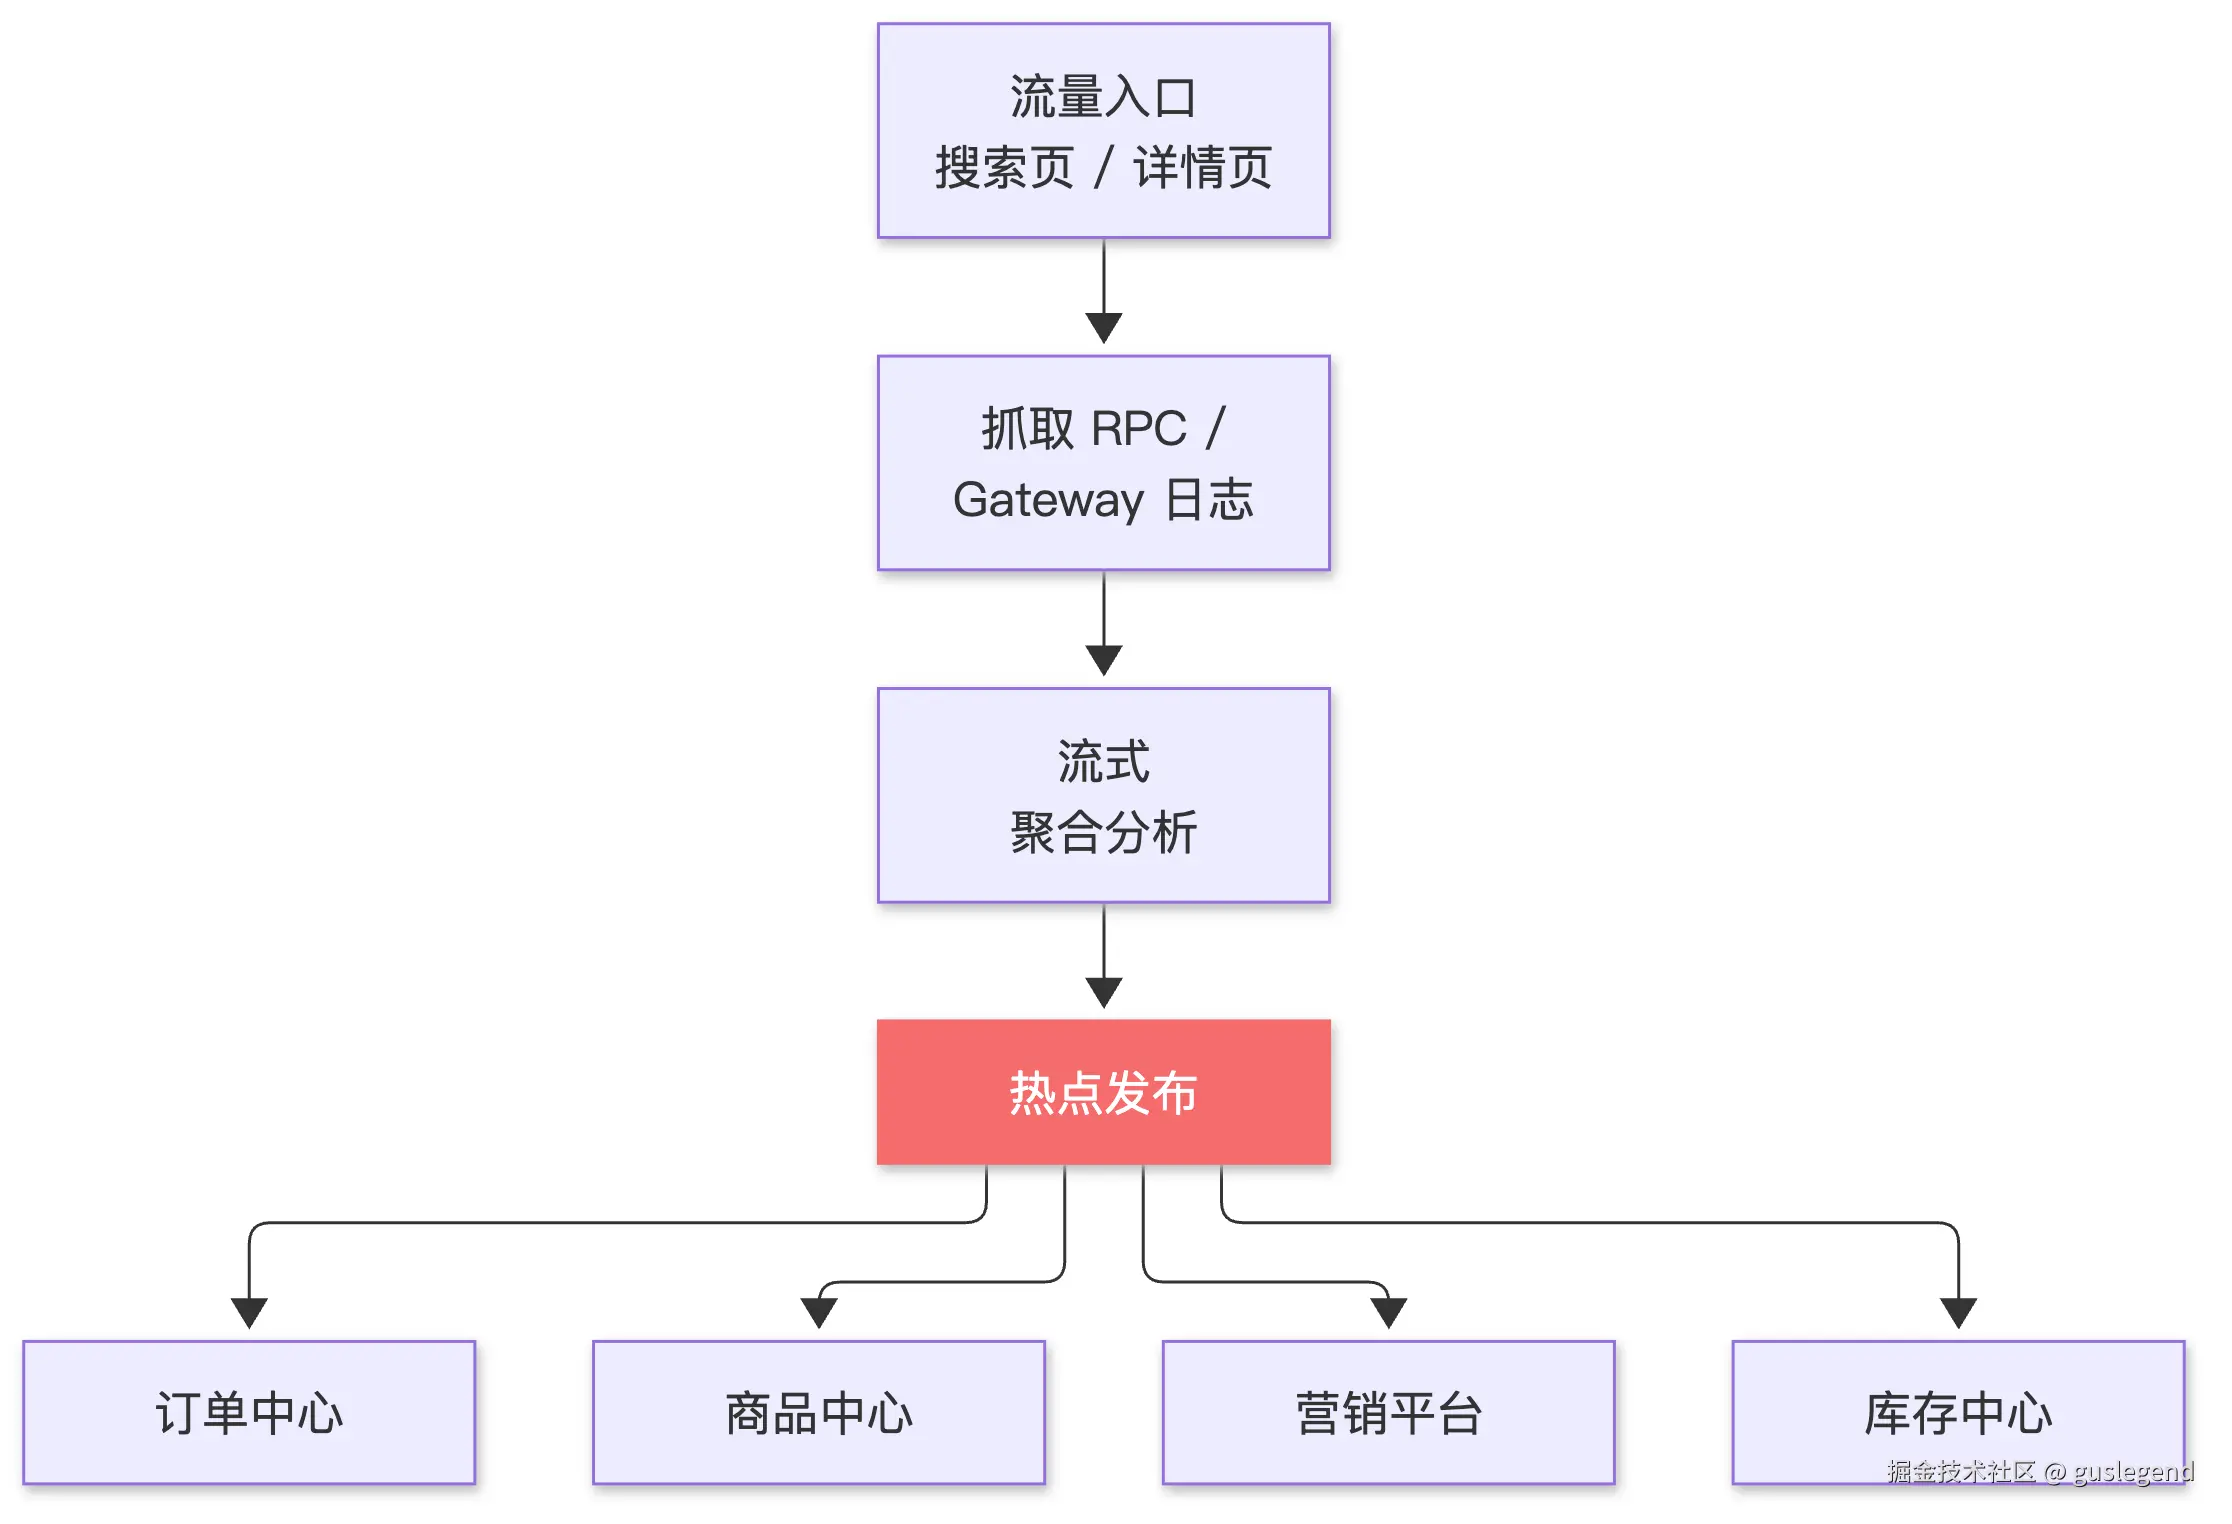
-
图中红色节点是热点通知的发布点,右侧是订阅方
- 抓取网关层的日志或 RPC 接口打印的日志
- 用 Stream 流式计算做聚合,分析出访问频次高的商品
- 针对这些商品发布热点通知,订单中心、商品中心、营销平台、库存中心订阅后,对热点商品走不同的业务逻辑
- 热度退去后反向发布,删除热点
-
简易热点处理方案
- 通过 MQ 接收推送的热点 ID,如商品 ID
- 从 Redis 集群取出该热点数据,缓存到本机的本地缓存(local cache),Redis 中要预先设置好这个热点 key
- API 对推送过的热点 ID 不再查 Redis,直接从本地缓存获取
- 成本低,生产环境中用得不少
- 坑:热点 ID 列表存在 JVM 内存里,应用重启后丢失,接口无法判断该走本地缓存还是 Redis
面试题:答题思路
| 问题 | 答题思路 |
|---|---|
| 设计一个支撑 xxx 并发量的应用,数据层面要考虑什么 | 底层数据:读写分离 + 集群扩展、主从备库做容灾、数据异构 + 分库分表;一致性要求不高的数据放缓存,降低底层数据库压力;再升华到热点方案 |
| 热点数据怎么防范 | 预知热点:热点库、本地缓存 + 多级缓存;动态热点:通过接口参数聚合、日志埋点统计侦听热点,再用 MQ 通知送达各节点,节点收到后按预知热点的方案构建本地缓存,或者先建好热点库再通知 |
| 分库分表后业务量再翻倍,如何扩容 | 备库转主库,再给新主库添加备库;或者增量存量同步;都要成倍扩容 |
面试/考试记忆点
- 读多写少的场景用读写分离:Master 写、Slave 读,通过 binlog 复制,读库可水平扩展
- 读写分离消除了排他锁和共享锁的竞争,可用 Sharding-Proxy、Sharding-JDBC 实现读写路由
- 缓存和搜索引擎配合数据同步中间件,本质上也是一种读写分离
- 读写分离解决不了单表数据量过大,要靠分库分表
- 垂直分表按字段拆,水平分表按路由规则拆数据;ID 取模不好扩容,时间分片数据可能不均
- 水平分库分表:先对总表数取模,再用除法定位库、取余定位表
- 数据异构让同一份数据按多个维度分库分表,难点在数据同步
- 零宕机扩容:备库转主库、增量存量同步,都必须成倍扩容
- 热点数据是极短时间内被高并发访问的数据,分布式缓存不是银弹,热点必须隔离
- 热点方案是区分高并发和超高并发应用的分水岭
- 热点三种存储方案:多级缓存、热点库、热点散列;热点处理三步走:识别、隔离、性能优化
- 识别动态热点:入口处 RPC / 网关日志抓取 → 流式聚合分析 → 发布热点通知