选定区域
需要使用https://ui.perfetto.dev/打开trace信息的json文件。
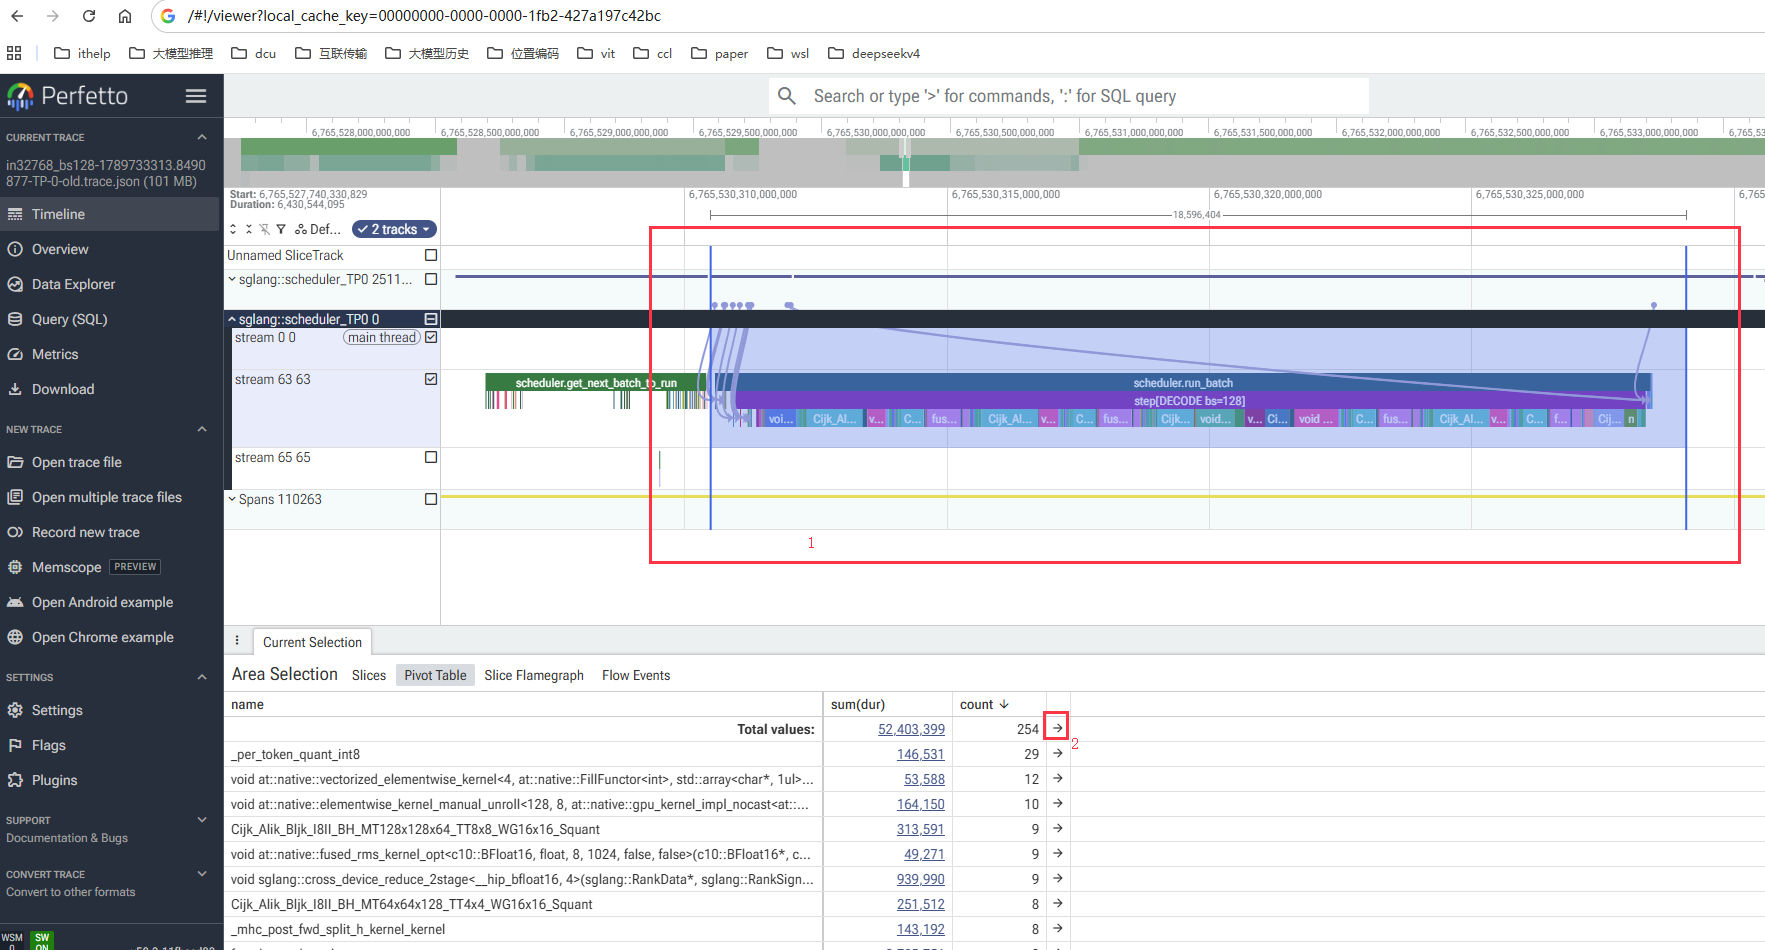
获取选定区域的ts信息
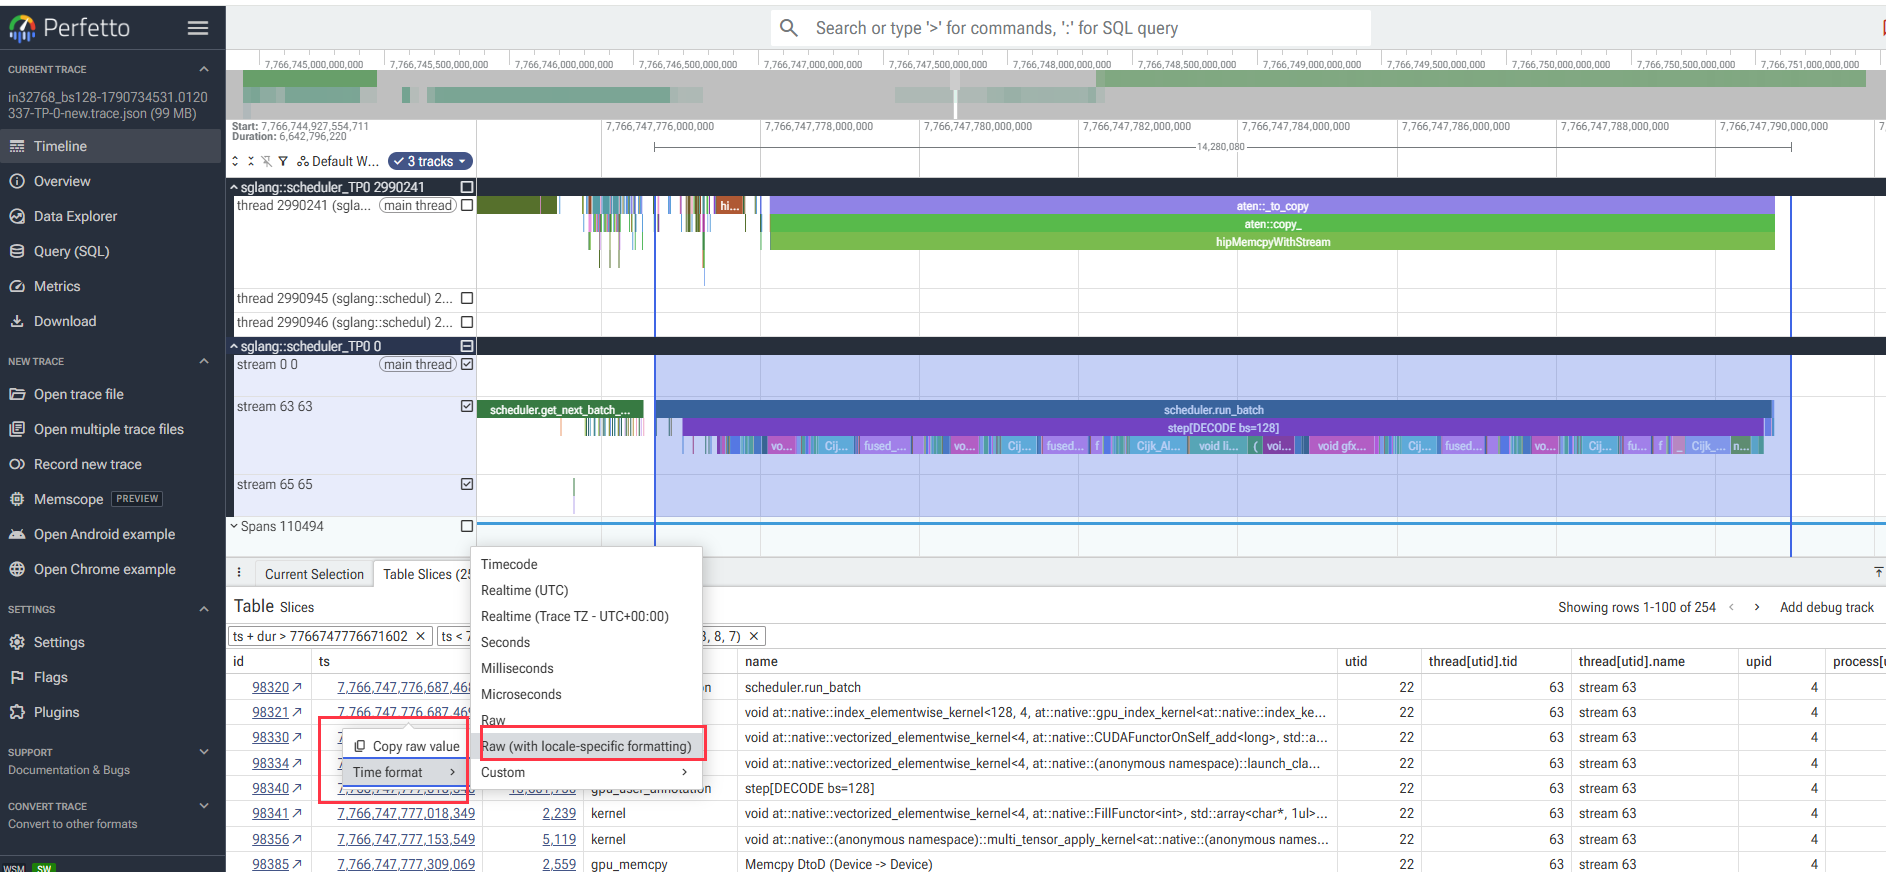
使用代码获取kernel信息
trace_pro.py
python
import json

def truncate_trace(input_file, output_csv, start_ts, end_ts, delimiter: str = ","):

    with open(input_file, 'r') as f:
        data = json.load(f)

    events = data['traceEvents']
    # 筛选时间范围内的完整事件
    filtered = []
    for e in events:
        if e.get('ph') != 'X':
            continue
        args = e.get('args', {})
        if 'stream' not in args:          # 关键:只留含 stream 字段的事件
            continue
        ts = e.get('ts', None)
        if ts is None :#or not (start_ts <= ts <= end_ts):
            continue
        filtered.append(e)

    # 按时间戳排序
    filtered.sort(key=lambda x: x['ts'])

    # 写入 CSV
    with open(output_csv, 'w', newline='', encoding='utf-8-sig') as f:
        table_name = f"name {delimiter} dur {delimiter} start {delimiter} end {delimiter} "
        f"cat {delimiter} pid {delimiter} tid {delimiter}"
        #f.write(table_name + "\n")
        for e in filtered:
            name = e.get('name', '')
            start = e.get('ts', 0)
            dur = e.get('dur', 0)
            end = start + dur
            cat = e.get('cat', '')
            pid = e.get('pid', '')
            tid = e.get('tid', '')
            row = f"{name} {delimiter} {dur} {delimiter} {start} {delimiter} {end} {delimiter} "
            f"{cat} {delimiter} {pid} {delimiter} {tid} {delimiter}"
            f.write(row + "\n")

    print(f"write rows {len(filtered)}")


def process_new():
    start_ts = 7,766,747,776,000,000
    end_ts =   7,766,747,790,000,000

    input_file = 'in32768_bs128-1790734531.0120337-TP-0-new.trace.json'
    output_csv = 'kernels_new.csv'
    truncate_trace(input_file, output_csv, start_ts, end_ts, delimiter=";")

def process_old():
    start_ts = 6,765,530,310,500,000
    end_ts =   6,765,530,330,000,000

    input_file = 'in32768_bs128-1789733313.8490877-TP-0-old.trace.json'
    output_csv = 'kernels_old.csv'
    truncate_trace(input_file, output_csv, start_ts, end_ts, delimiter=";")

if __name__ == "__main__":
    process_old()
    process_new()
使用excel打开处理后的csv文件
代码中使用分号(delimiter=";")作为分割符。
打开excel,数据,从文本/csv。