本章我将和大家谈谈关于应用层协议 ---- HTTP
之前我们谈论过了关于传输层 --- TCP;网络层 --- IP
而HTTP对于我们程序员来说是更为重要的,因为他是我们今后常常会打交道的~~~
HTTP也称为:超文本传输协议
HTTP在传输层主要依赖的是TCP协议(但是从HTTP3.0开始后,就切换到UDP协议)
1.HTTP应用场景
2.抓包工具 --- Fiddle
3 .HTTP请求和响应
4.URL
5.query string
6.URLencode
7.HTTP中的方法
8.GET和POST的区别
9.HOST
10.Content-Length
11.Content-Type
12.User-Agent
13.Referer
14.Cookie
15.状态码
HTTP的应用场景
1.)Web开发:网页前端和服务器后端之间的通信
2.)移动端app开发:和服务器后端之间的通信
3.)分布式系统的服务器之间的调用
抓包工具 --- Fiddle
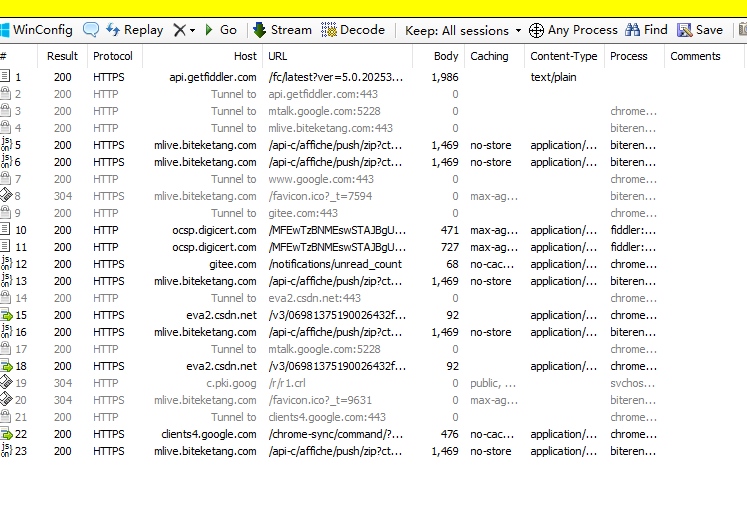
通过Fiddle抓包工具,读取网卡的内容,从而让我们可以看到当前请求和响应的数据~~~
Fiddle下载连接:https://www.telerik.com/fiddler/fiddler-classic
当我们打开Fiddle的时候,即使我们不操作任何的页面,电脑上也可能运行很多程序,这些程序都会访问他们的服务器,这些都会被Fiddle抓包抓到
当我们通过浏览器访问一个网站的时候,就可以从Fiddle看到抓包,比如我们访问bilibili网站
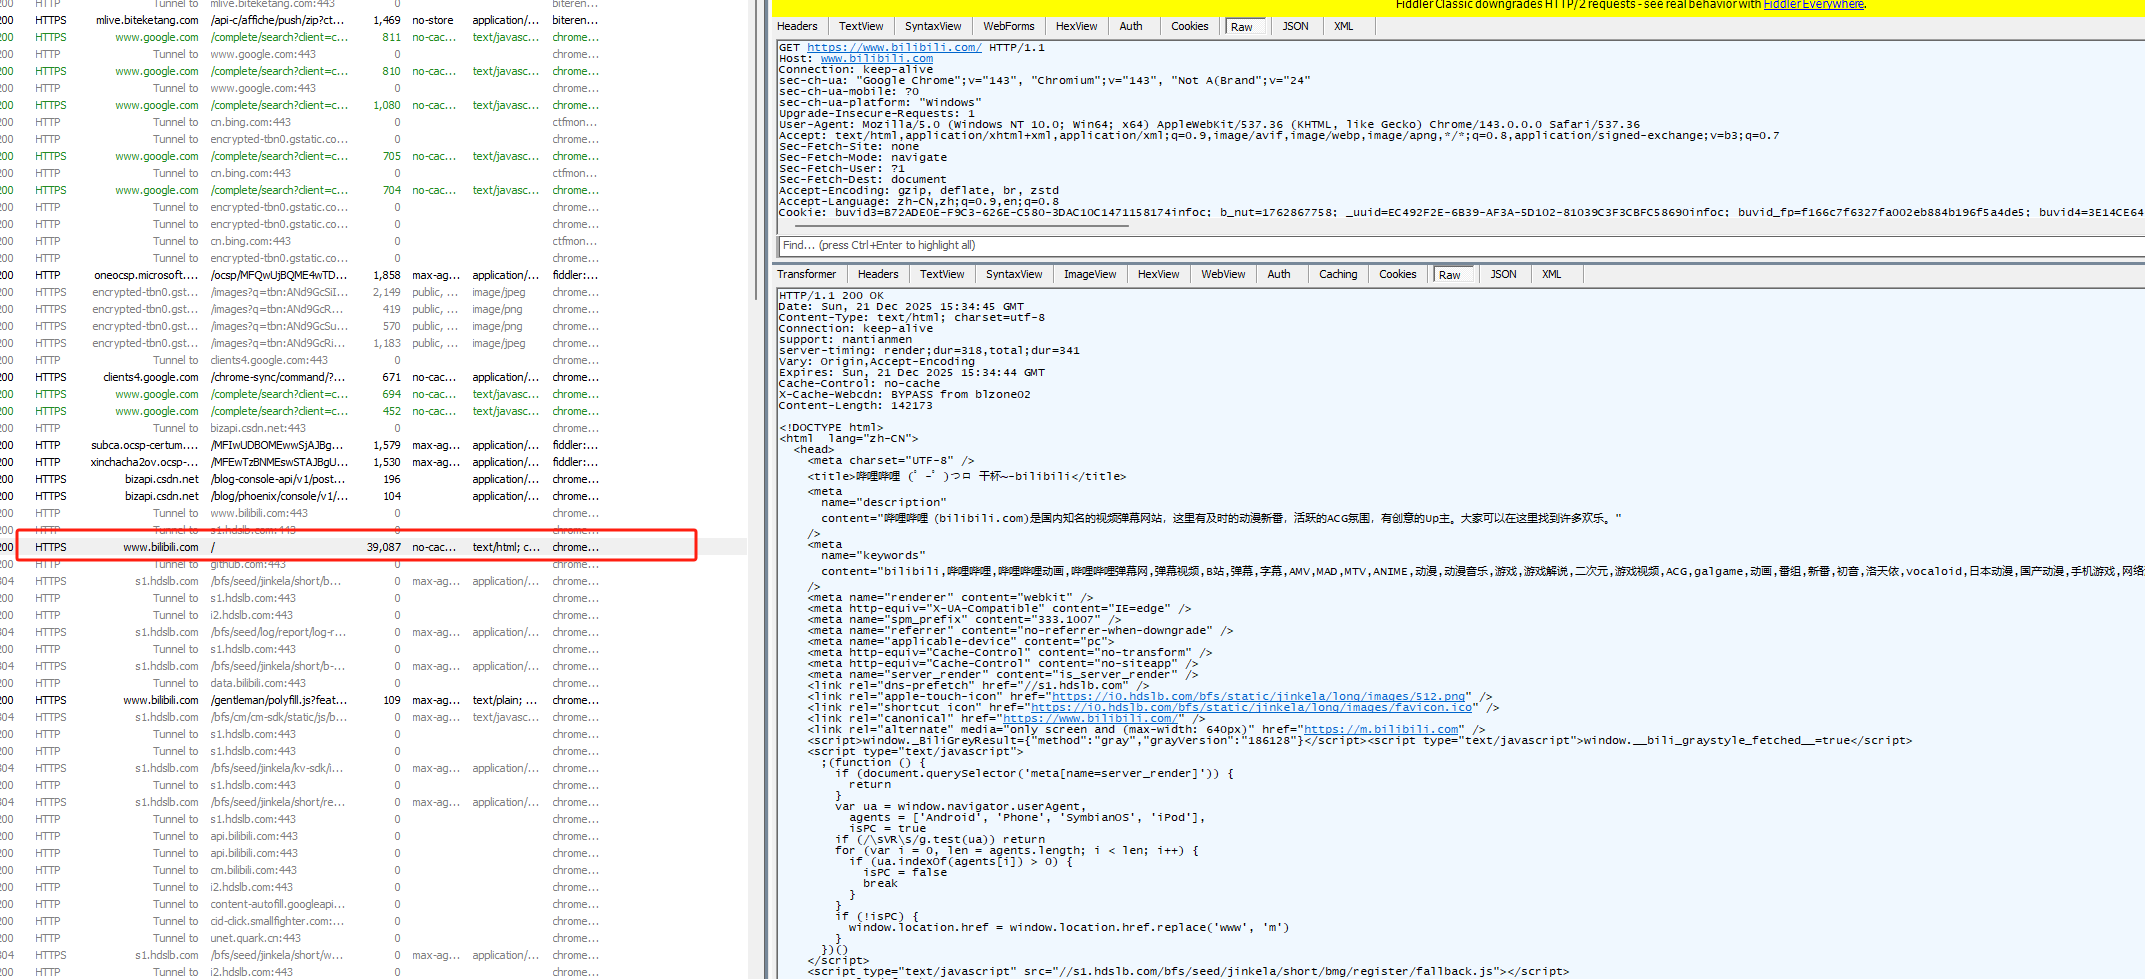
HTTP请求和响应
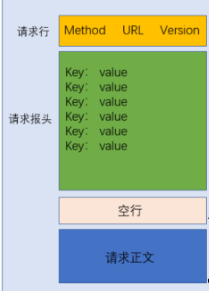
请求:由首行;请求报头;空行;正文组成(正文可能会被省略)
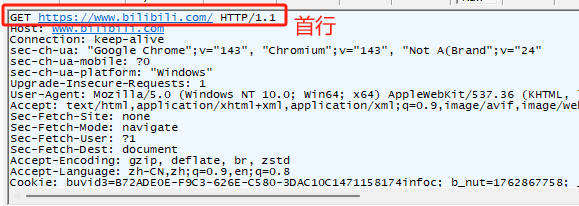
通过抓包工具查看首行:
请求报头,有若干行,每一行都是一个键值对,键值对都是有特殊的含义,是HTTP协议规定好了的,键和值之间通过:空格 来进行分割
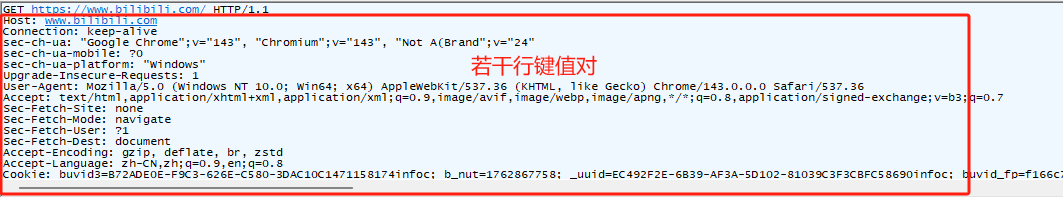
遇到空行,说明请求报头部分结束
正文部分可能会被省略
响应:由首行;响应报头;空行;正文组成
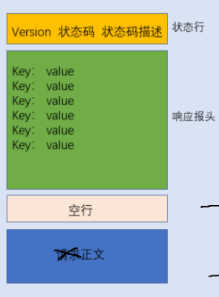
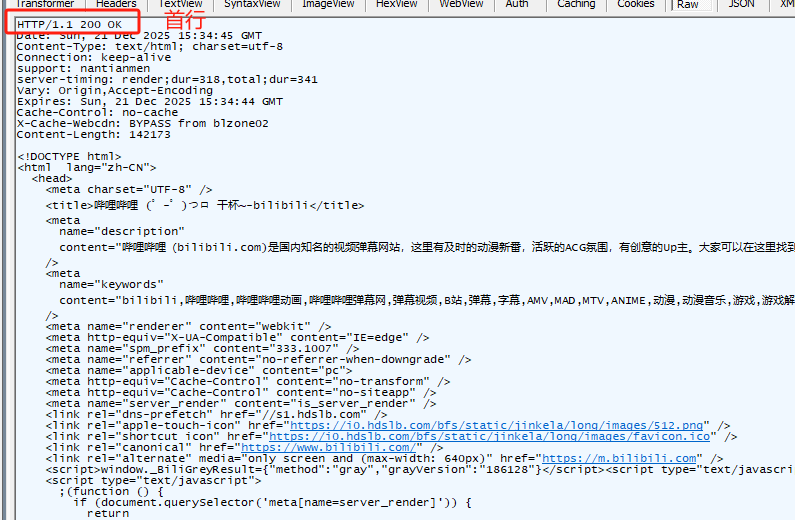
通过抓包工具可以看到响应的首行:
响应报头有若干行,每一行都是一个键值对,键和值之间通过:空格 进行分割,每个键值对也有特殊的含义
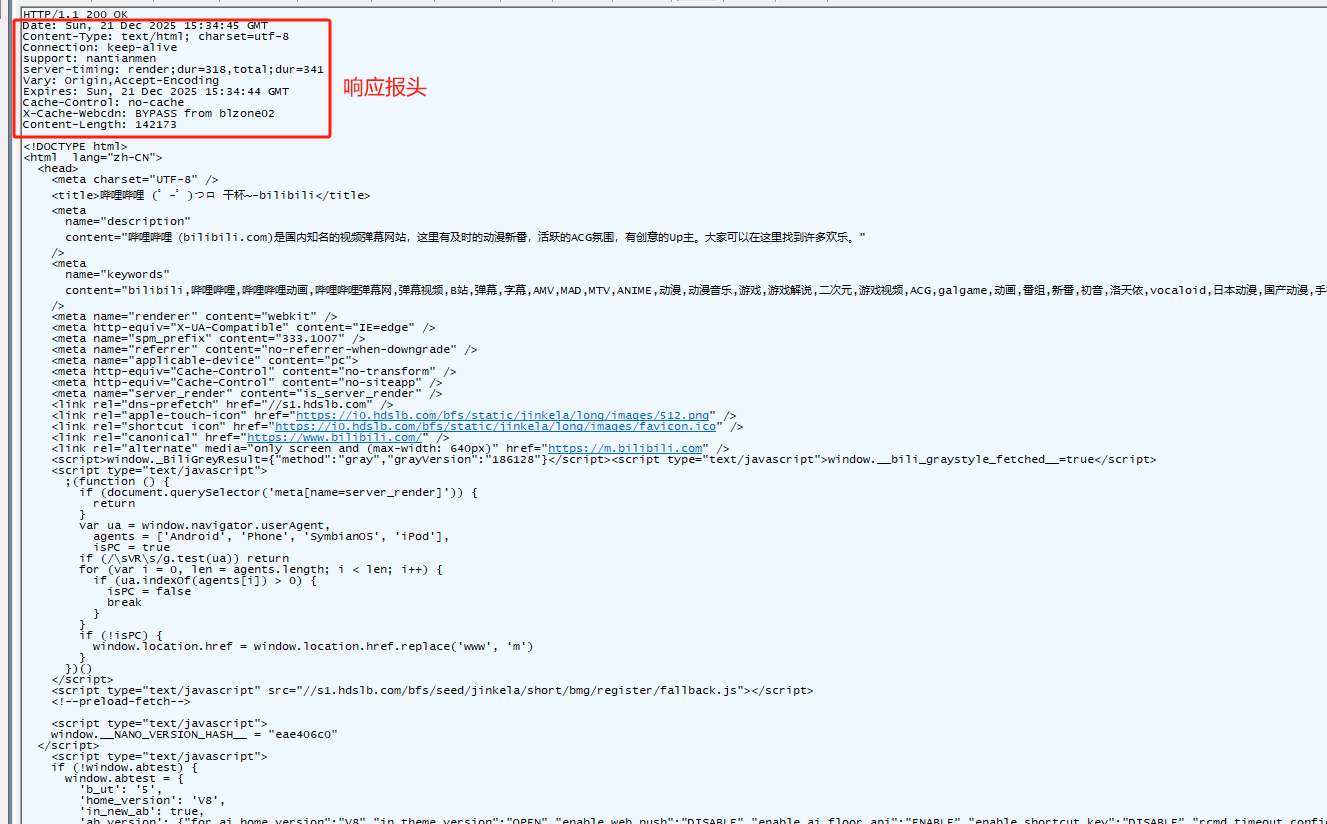
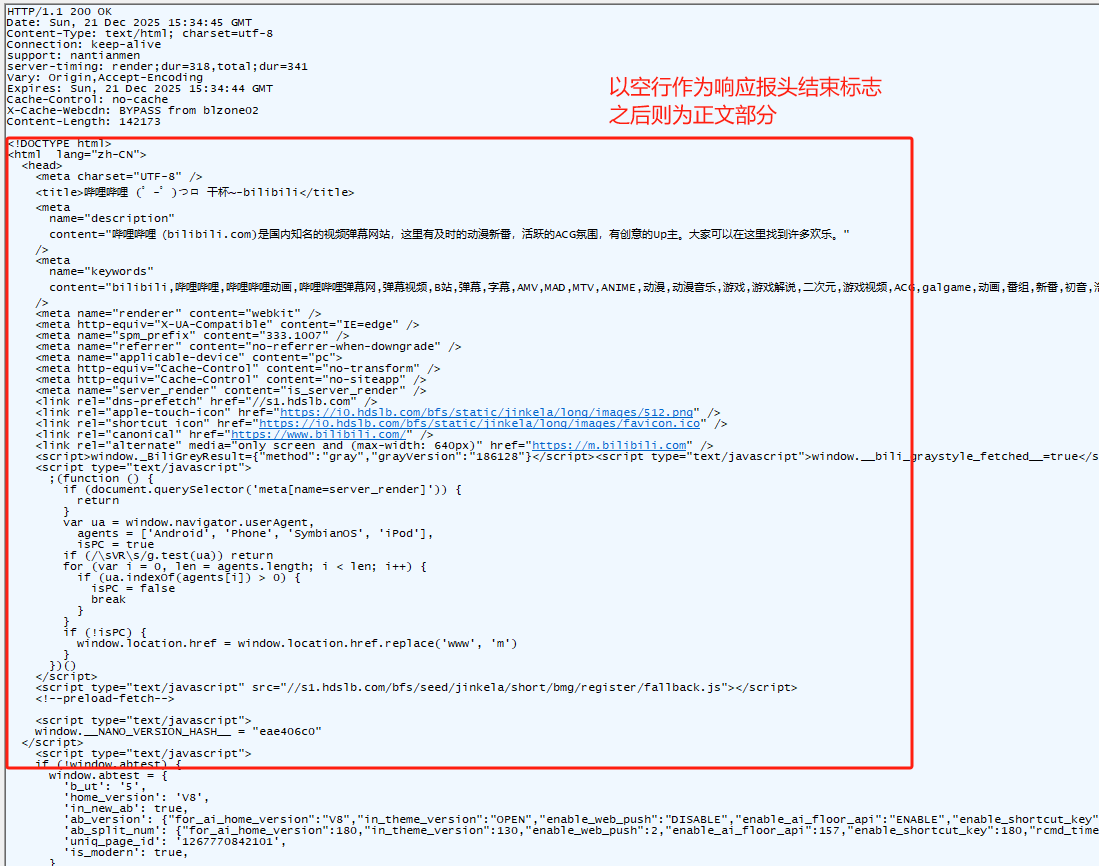
空行,作为响应报头的结束标志
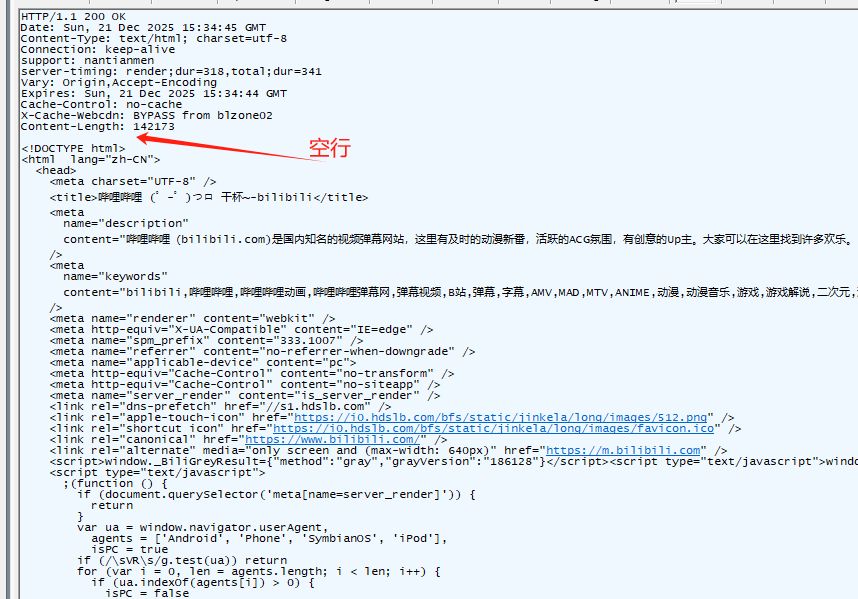
正文部分也可以通过抓包工具查看
URL
URL也被称为:唯一资源定位符(标识一个网络上的资源位置)说白了就是网址
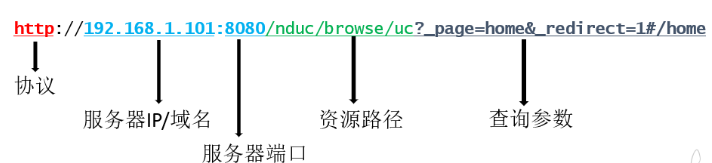
服务器IP/域名:这里是IP地址,其实更常见的是域名,如果填写成IP地址也是可以的
资源路径:通过IP确定主机,通过端口号确定程序,但是一个服务器程序可能会有很多资源
如HTML,CSS,JS,图片,音频...为了让服务器管理方便,就可能按照一定的
目录结构来组织。
查询字符串 query string
query string也是键值对结构的数据。使用 & 分割键值对,= 分割键和值
注意:报头中的键值对,都是HTTP协议规定好的;而query string中的键值对,是程序员自定义的
URLencode
其中查询字符串包含程序员自己定义的键值对的数据
对于query string 来说,有时候需要进行encode转码,因为URL中包含很多特殊符号,都是有特殊含义的,只要是标点符号或者中文字符,都是需要进行转义的,因为一个中文,包含很多个字节,就害怕其中的某一个字节和ASCII中的某个特殊符号一样,就完蛋了~~~~
那么如何进行转义呢?
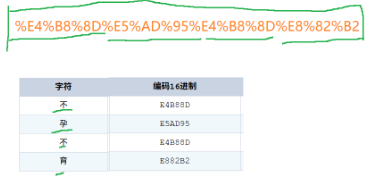
把要转义的内容,将每个字节都拿出来,是用十六进制表示,每个字节前面加上%
比如+,在ASCII中是2B,那么转义后就是%2B
不孕不育这四个中文,每一个中文有三个字节,然后将每个字节前面加上%,就可以将不孕不育这四个中文转义为一串字符串了
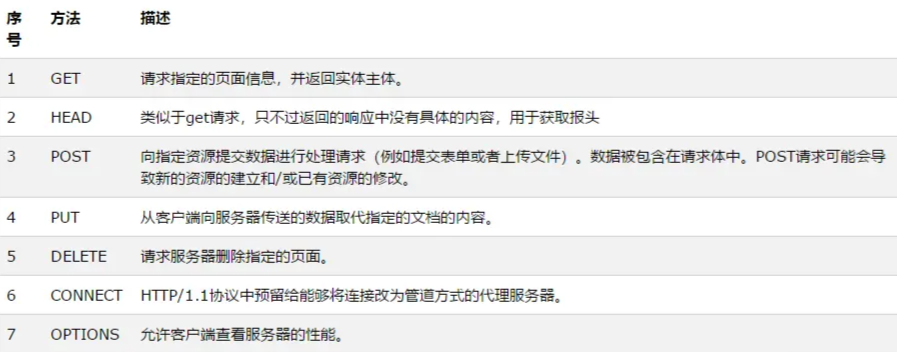
HTTP中的方法
方法是请求中的一个部分,是一个动词,表示这个请求将要做什么样的动作
GET(获取):我将要从服务器上获取某个资源
POST(投递):我将要把xxx数据往服务器上发送
PUT(放过去):也是将xxx数据往服务器上发送
DELETE(删除):我将要删除服务器上的xxx数据
GET方法
对于GET请求来说,通常情况下,是没有body的(也可以有body,但是很少)~~~~
body就是放程序员自定义的数据
GET是从服务器中获取一个数据,到底拿哪个数据?(通过URL路径知道)有啥要求?(通过URL中的query string知道)
POST方法
POST请求一般都是有正文的,当然也可以完全没有~~~
俩个场景非常容易出现POST:
1.登录场景
2.传输文件场景
POST请求:

正文:
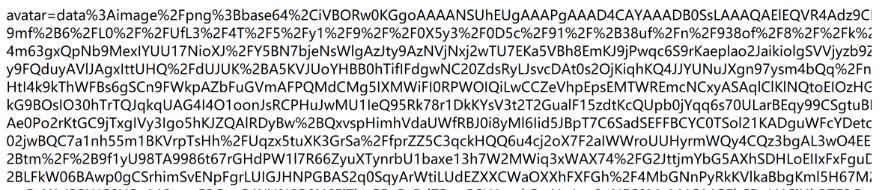
GET和POST的区别
(其实GET和POST没有本质上的区别,可以使用GET的,也可以使用POST)
区别一:
GET通常用来表示 "数据获取" 语义;POST通常用来表示 "提交数据" 语义
区别二:
GET通常把给服务器传递的数据放到query string中;POST通常放在body中
但是关于一些说法,是有歧义的~~~
(1)GET请求一般是实现 "幂等";POST请求没有 "幂等" 要求
幂等在计算机中的含义:如果某个请求,重复产生之后,结果是明确的,就可以认为是
幂等(吃进去的是青草,挤出来的是羊奶~~~(明确));反之,如果这个
请求,重复产生之后,结果不明确,就认为不是幂等。
HTTP RFC标准文档中,意思是:建议把GET实现成幂等。但是很多程序员并未遵守~~
比如我们浏览哔哩哔哩网站,但我们刷新时,内容是不同的!!所以不是幂等
(2)GET请求不安全,POST请求更安全(错误结论)
我们以登录为例:
GET实现登录,用户名和密码出现在URL的query string中,就会显示在浏览器地址栏里
POST实现登录,用户名和密码在body中,不会显示在浏览器地地址栏里
但是!!!如果用户名和密码不进行加密,即使黑客进行抓包,照样可以抓到~~~
(3)GET请求单次传输的数据量比较小,POST请求单次传输的数据量更大(不准确)
这个结论其实是上古时期的,上古时期,IE浏览器对URL的长度有限制(1KB,2KB,10KB...)
但是现在的URL长度可以很长!!
(4)针对GET请求只能传输文本数据,POST可以传输文本和二进制数据(不准确)
针对二进制数据,可以通过urlencode/base64 转为文本,通过GET的URL进行传输
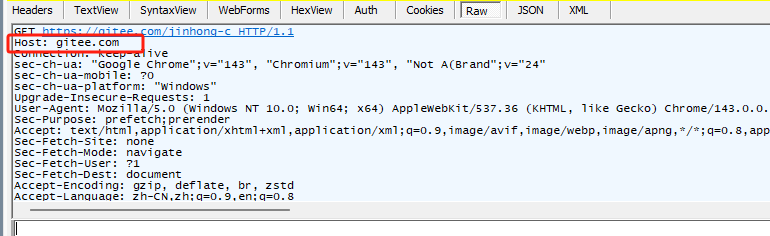
HOST ---- 表示服务器主机的地址和端口
当我们在浏览器打开gitee,通过Fiddle抓包得到的数据:
Content-Length ---- 表示body中的数据长度(单位字节)
比如Content-Length:1008611,标识了body长度为1008611字节~~~
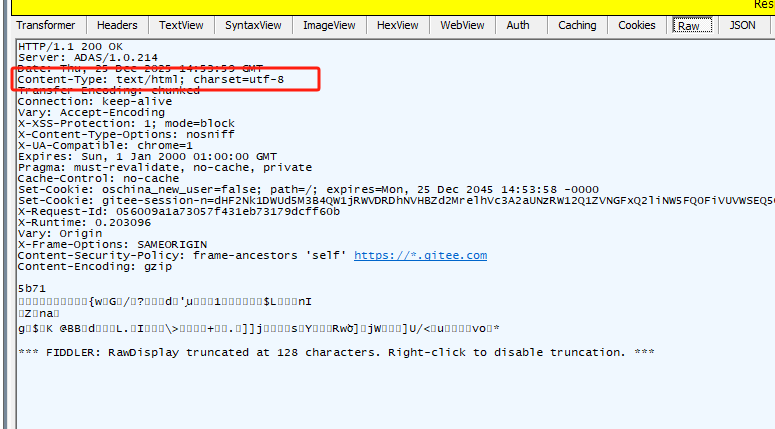
Content-Type ---- 表示请求的body中的数据格式
Conten-Type 描述了body的数据格式,告诉服务器/浏览器如何理解这里面的数据~~
对于浏览器来说,如果是html,就按照html的规则进行解析,渲染成网页的骨架
如果是css,就按照css的规则进行解析,渲染成网页的样式
如果是javascript,就执行JavaScript中的逻辑
如果是json,浏览器一般不主动处理,由浏览器中的js代码来进行负责处理
如果是图片,浏览器直接按照图片的格式显示
当我们在浏览器打开gitee,通过Fiddle抓包得到的数据:
Content-Type常见的取值:
1)text/html
2)text/css
3)application/javascript
4)application/json
5)image/jpg
6)image/png
7)text/plain
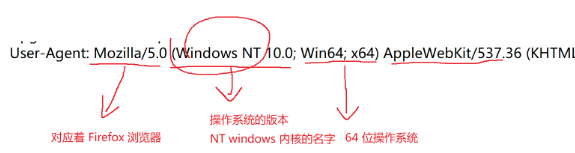
User-Agent(简称UA)
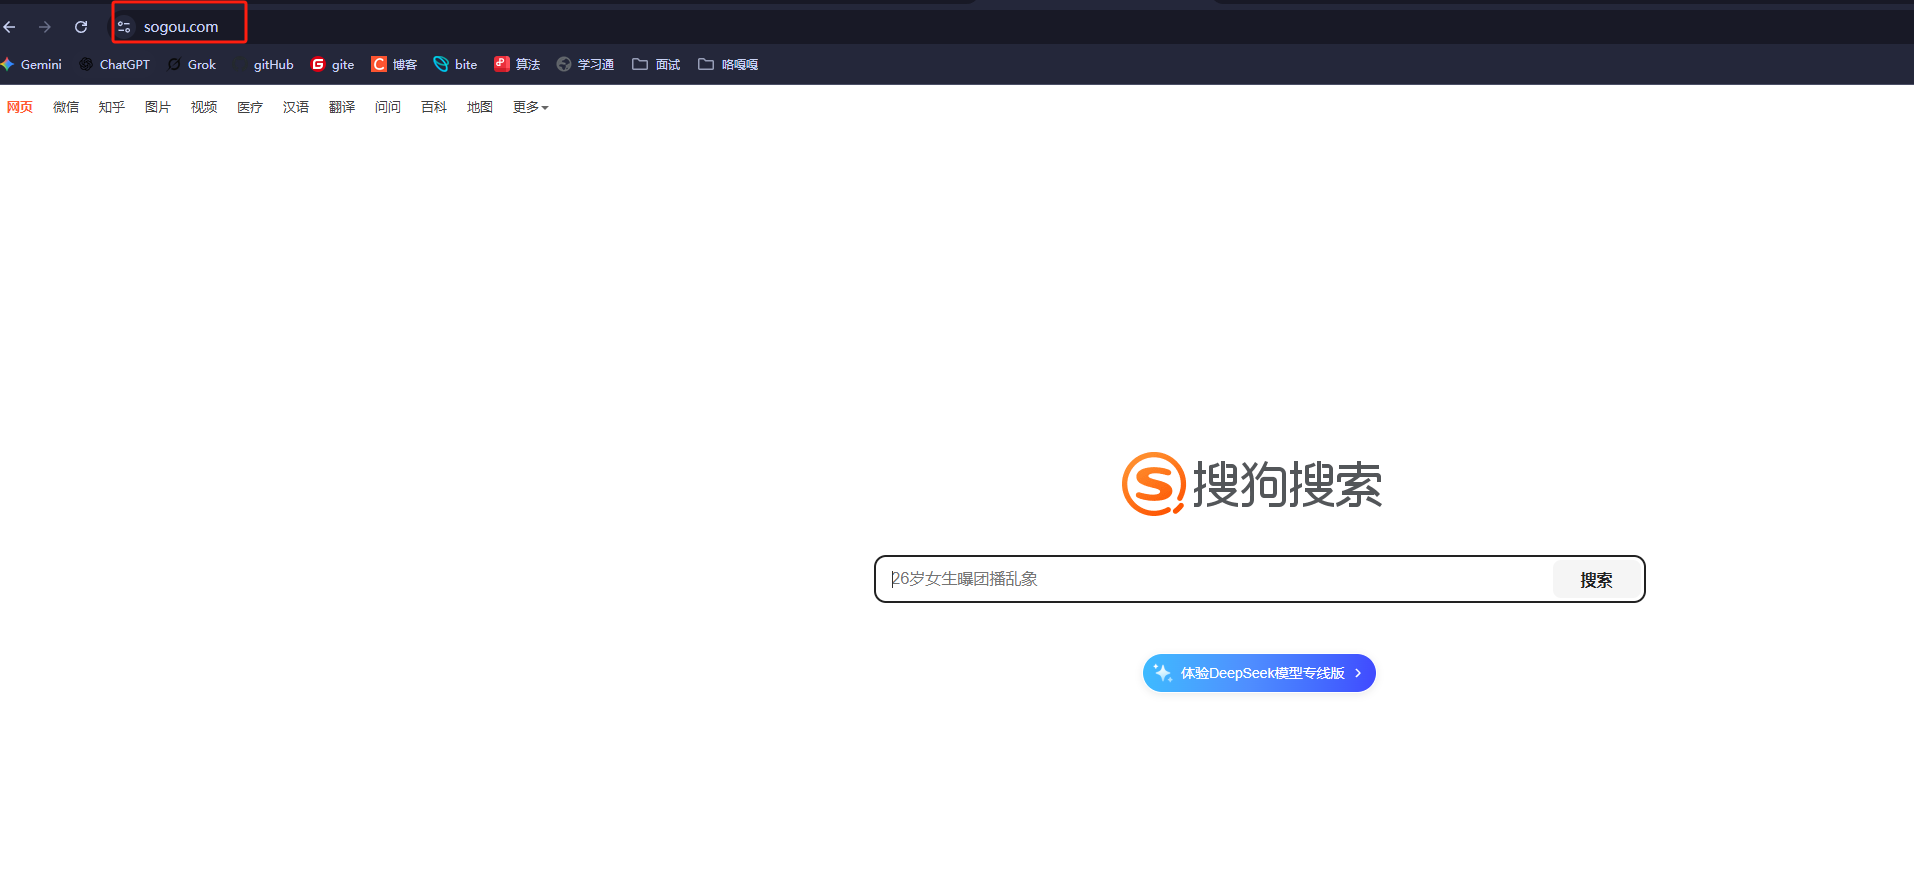
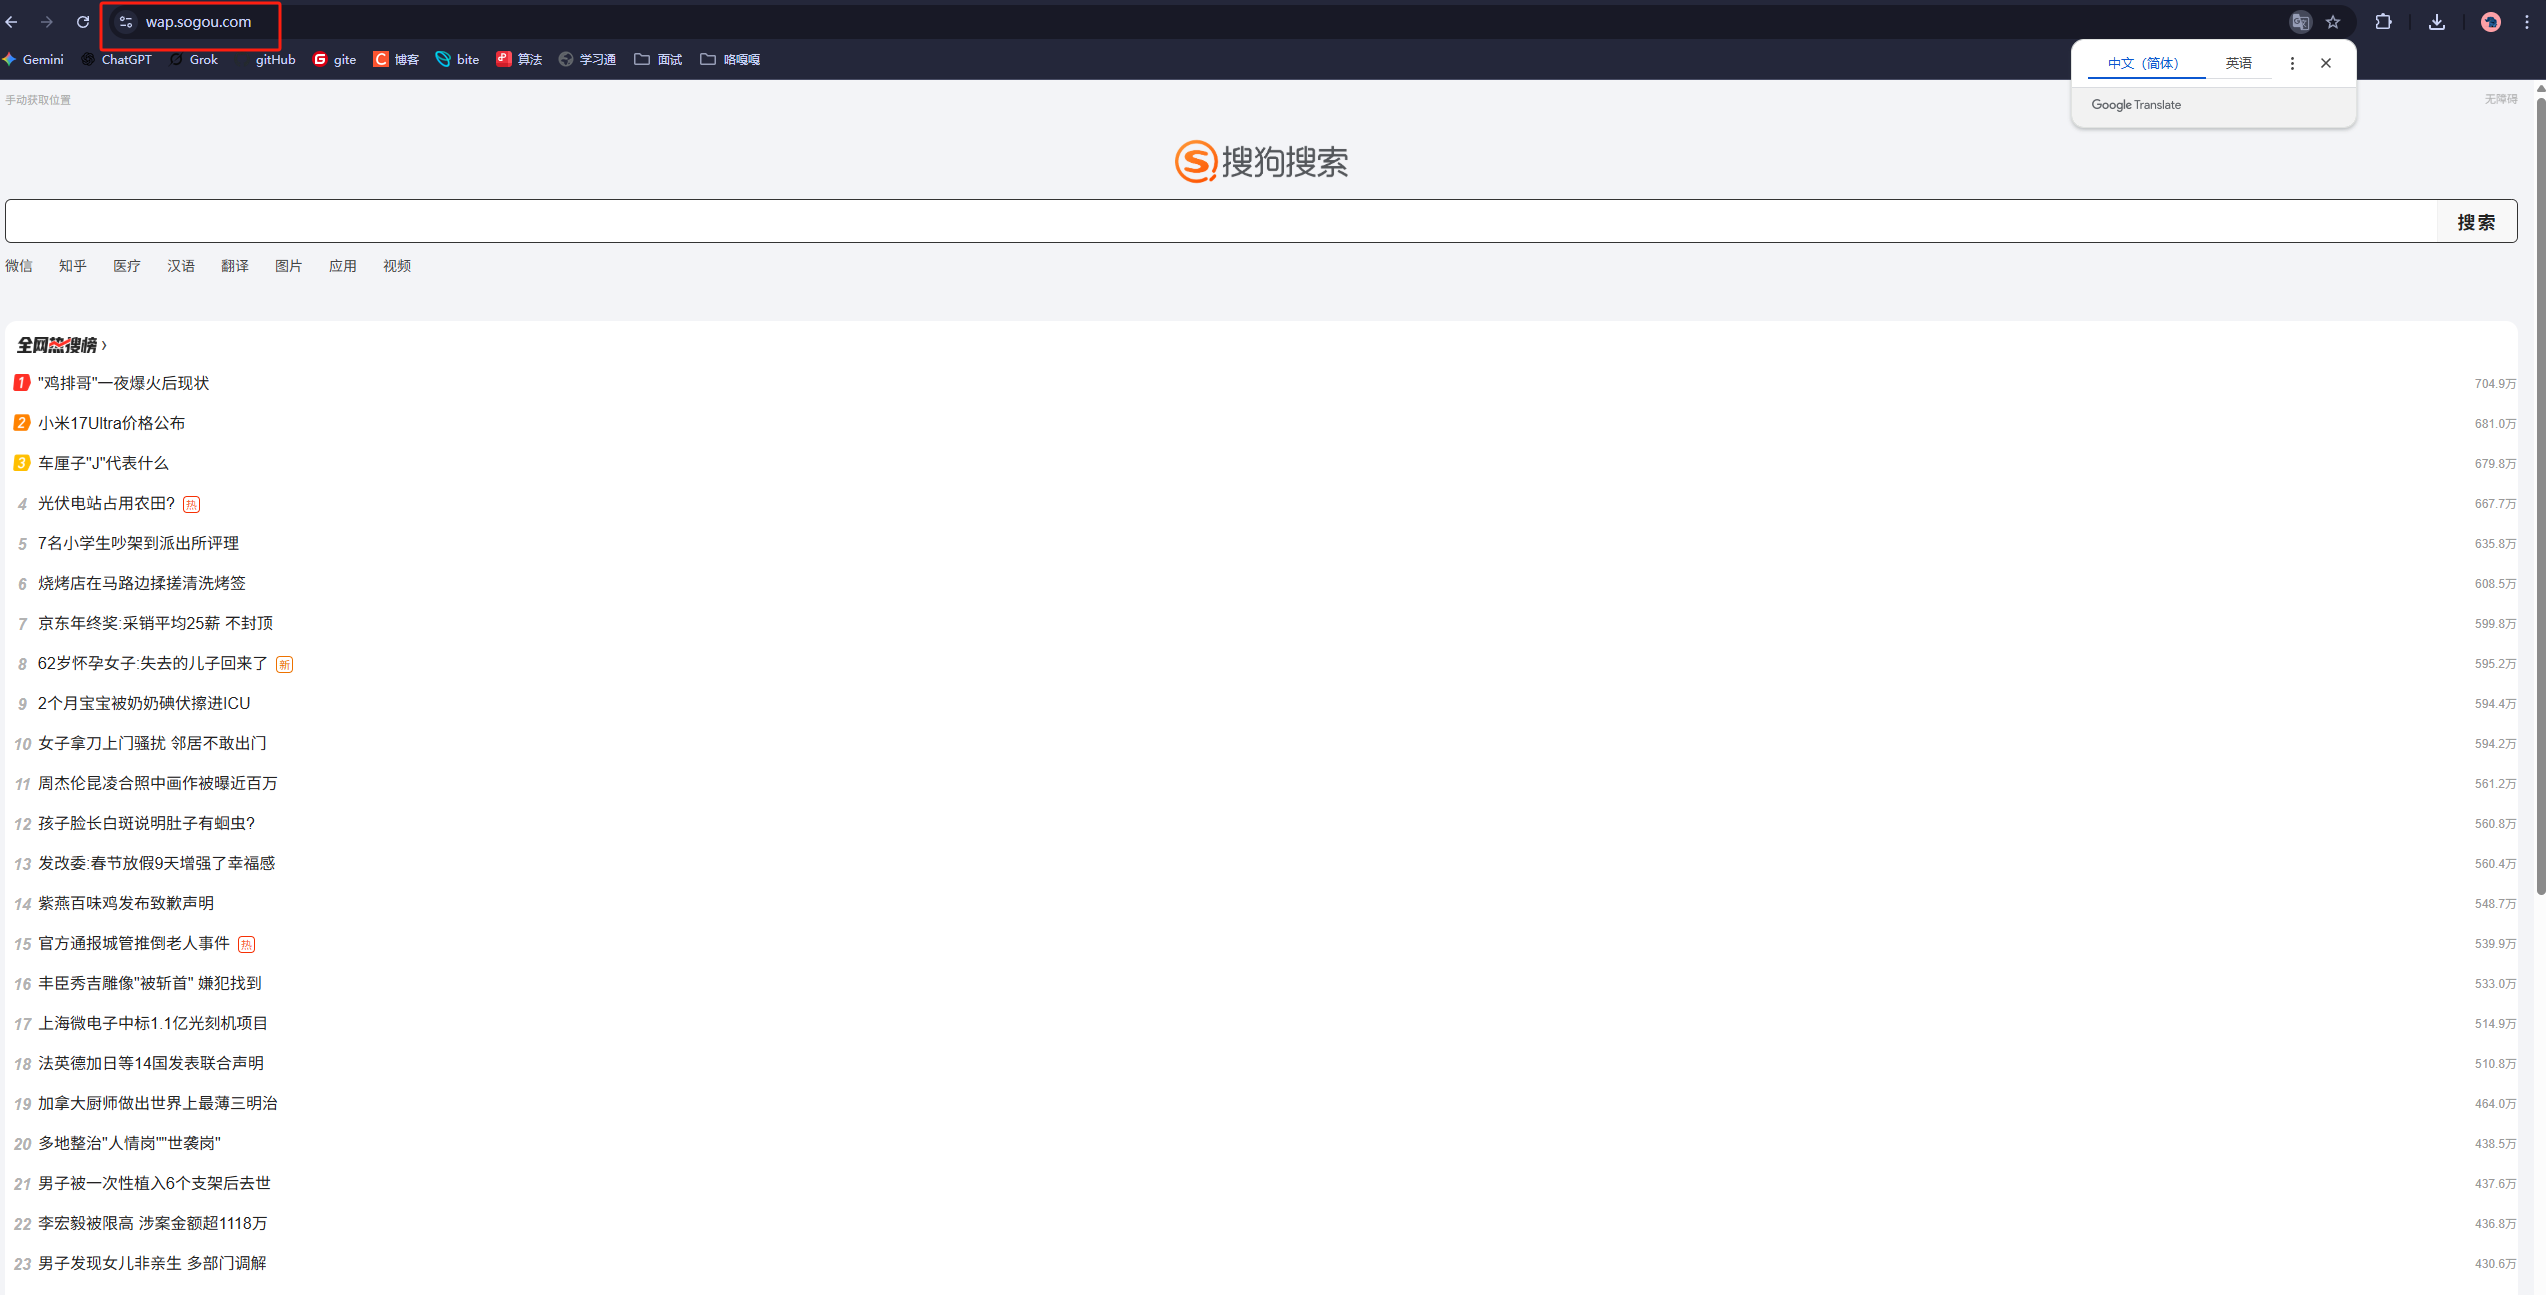
通过修改UA的方式,我们就可以在手机上查看到PC端的网页,在PC端也可以看到手机端的网页
PC端的搜狗网页:
修改UA,使我们在PC端可以查看到手机端的搜狗网页:
Referer --- 表示这个界面是从哪个界面跳转过来的
当我们打开搜狗网页,搜索哔哩哔哩的时候,我们跳转到对应的页面,我们通过抓包,可以看到哔哩哔哩这个页面是从哪里跳转过来的~~
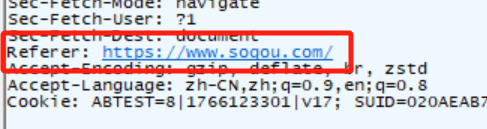
为什么需要记录这个页面是从哪里跳转过来的呢???
其实很多搜索引擎都有广告产商,当我们点击广告的时候,就会跳转到对应的广告页面,这时候就需要记录,这个广告是从哪里跳转过来的???百度?搜狗?....,这样才能区分好,最后广告产生的利益也才不会乱!!!!哪个搜索引擎跳转多少次广告,才不会乱了。
Cookie ---- 浏览器提供本地存储数据的机制
cookie是一系列的键值对,每个键值对之间使用;进行分割,键和值之间使用=进行分割
关于键值对的内容,是程序员自己定义的~~~~
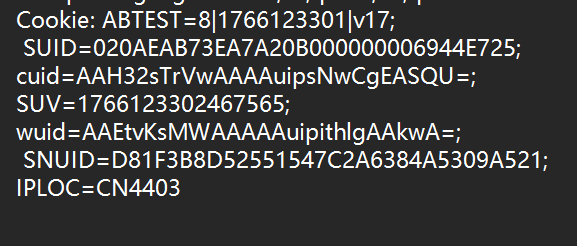
cookie的用途,是浏览器本地储存数据的一种机制。
我们一般谈到的本地存储是存储在硬盘里面的,但是浏览器无法访问硬盘!!因为一些网页可能包含一些有风险的代码,恶意的代码会攻击到我们的电脑,是非常危险的~~~
但是浏览器还是给我们开了一条通道,允许提供一些机制,使得浏览器可以访问硬盘,但是有了一定的限制。
浏览器提供的本地存储数据的机制:Cookie
Cookie有啥用:浏览器给网页提供本存储数据的方案
Cookie从哪里来:服务器返回的
Cookie怎么存储:按照键值对方式来存储,根据域名维度进行划分,每个域名下都有自己的cookie
Cookie到哪里去:本地存储之后,访问同一个域名的网站,就会把Cookie的内容通过请求报头发送给服务器!!!
Cookie的一个重要的用途:用来保存用户登录的账户和密码的数据~~~~
状态码
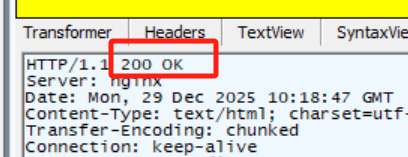
1.)2xx --- 表示成功状态码
2.)3xx --- 表示重定向状态码
它们都告诉浏览器或搜索引擎:"你要访问的这个页面不在原来的地方了,去新的地址找吧~~~
301 --- 永久重定向
资源已经被永久移动到了新的 URL。原有的 URL 已经失效,将来也不应该再访问了
浏览器缓存: 浏览器会记住这个重定向。下次用户再输入旧网址时,浏览器可能根本不会去问服务器,而是直接跳转到新网址
适用场景:
-
网站更换域名(如从
example.com换到new-example.com)。 -
网页 URL 结构调整(如从
/blog/p=123变成/blog/my-article)。 -
将
http流量永久强制跳转到https
302 --- 临时重定向
源暂时被移动到了新的 URL。原来的 URL 还是有效的,未来可能还会用回来~~~
浏览器缓存: 浏览器通常不会缓存这个重定向(除非专门设置了缓存头)。每次用户访问旧网址,浏览器都会先去问服务器:"我现在去哪?"服务器说:"今天先去新地址 B 吧。
适用场景:
-
网站维护期间,临时把用户引导到一个"维护中"的页面。
-
根据用户的地理位置或设备,临时跳转到特定版本的页面(如 PC 端跳到移动端)。
-
A/B 测试(一部分用户看页面 A,一部分看页面 B)。
-
登录页跳转(未登录用户访问主页,临时跳到登录页,登录后跳回)。
3.)4xx --- 表示客户端错误状态码
404(Not Fount) --- 访问的该资源在服务器上不存在
403(Forbidden)--- 拒绝访问(访问的页面无权限访问,比如别人的私有仓库啥的)
405(Method Not Allowed)--- 服务器不支持这个方法
4.)5xx --- 表示服务器错误状态码
500(Internal Server Error)--- 服务器挂了
504(Gateway Timeout) ---- 服务器繁忙(服务器网关出现问题)