目录
[7.1.Agent 为什么不稳定](#7.1.Agent 为什么不稳定)
[7.8.Agent 兜底](#7.8.Agent 兜底)
[8.1.Agent 为什么需要记忆](#8.1.Agent 为什么需要记忆)
[8.2.Agent 记忆至少分四类](#8.2.Agent 记忆至少分四类)
[8.4.Session State](#8.4.Session State)
5.第五步:Tool如何设计
Agent 到底是什么,核心是:Agent 不是更会聊天,而是能围绕目标持续行动。
ReAct、Reflection、Plan,核心是:Agent 要能边做边判断,做完还要检查。
Agent vs Workflow,核心是:流程能写死,就别硬上 Agent
这篇就专门讲:Agent 的工具到底应该怎么设计。
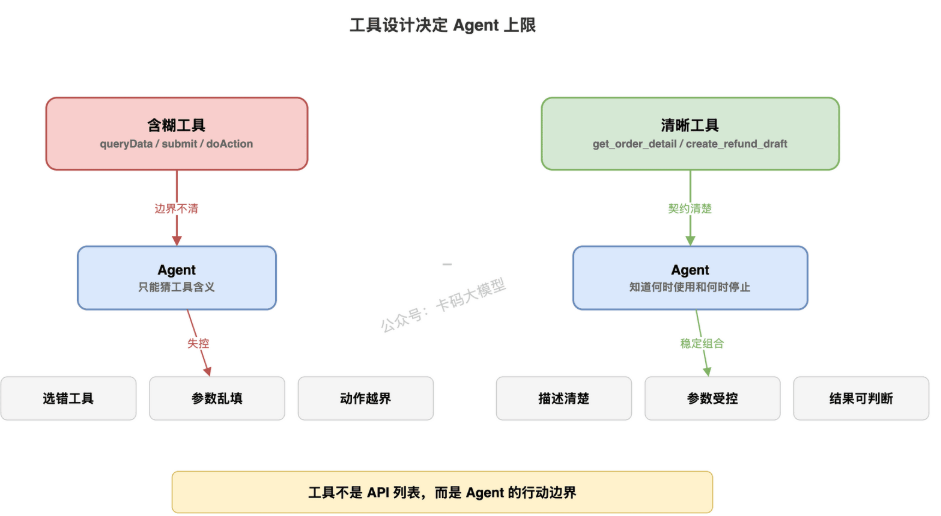
很多开发 Agent 项目时容易踩坑💡:直接把后端现有的 API 全部注册给大模型当作工具,这正是 Agent 系统容易失控的根源⚠️。
后端 API 面向程序员👨💻,开发者清楚业务含义、调用时机、参数与异常逻辑;
但 Agent 工具是供大模型做决策使用🤖,模型仅能读取工具名称、描述、参数结构和对话上下文。 如果直接暴露命名模糊的内部接口(如queryData、submit这类通用名称),模型只能猜测接口实际作用,分不清调用后果,容易胡乱调用。
queryData
getInfo
submit
updateStatus
doAction📌工具设计核心原则:工具≠简单对外暴露 API,而是将可控业务动作封装成模型可理解、可选择、可回滚恢复的能力。
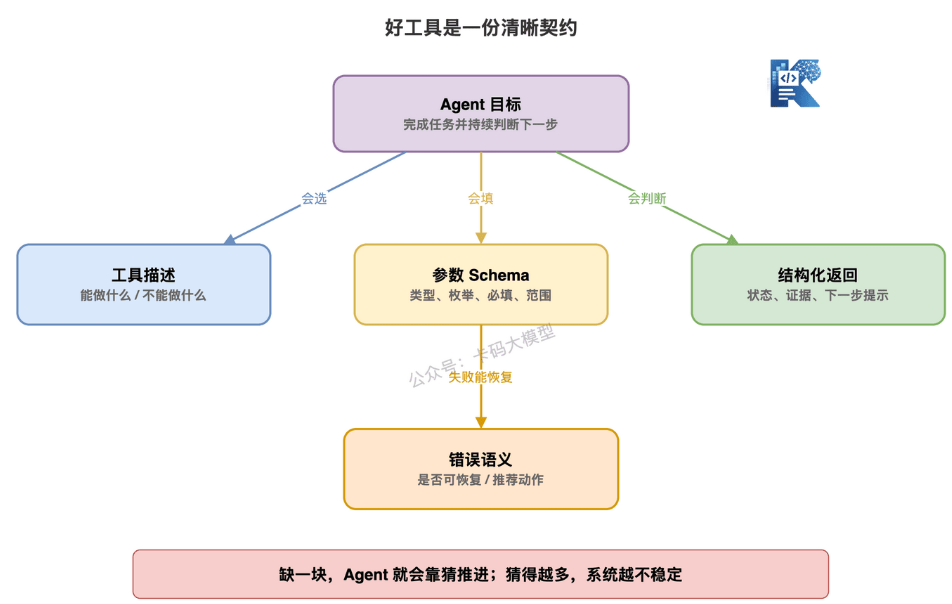
✅设计工具需要明确回答 4 个问题:
- 这个工具能做什么?
- 什么时候应该调用它?
- 什么时候不应该调用它?
- 调用返回结果后,Agent 能否依据结果继续推理决策?
如果没有清晰定义这四点,Agent 就会出现不可控的 "自由发挥",放到生产环境里,直接表现为稳定性差❌。
5.1.Tool描述设计
很多人写工具描述时很敷衍📝,举个典型例子:
{ "name": "get_order", "description": "查询订单信息" }这个描述对 Agent 来说太单薄⚠️。模型只知道可以查订单,但无法判断:
- 查询范围:是基础信息,还是支付 / 物流 / 退款状态?
- 参数限制:只有手机号能不能调用?
- 返回异常:订单不存在会返回什么?
- 业务边界:适合排查哪类问题?能不能用来退款?
人类看 "查询订单信息" 能理解,但 Agent 要依靠描述判断是否调用工具,这样简短描述远远不够🤖。
✅优化示例:
{
  "name": "get_order_detail",
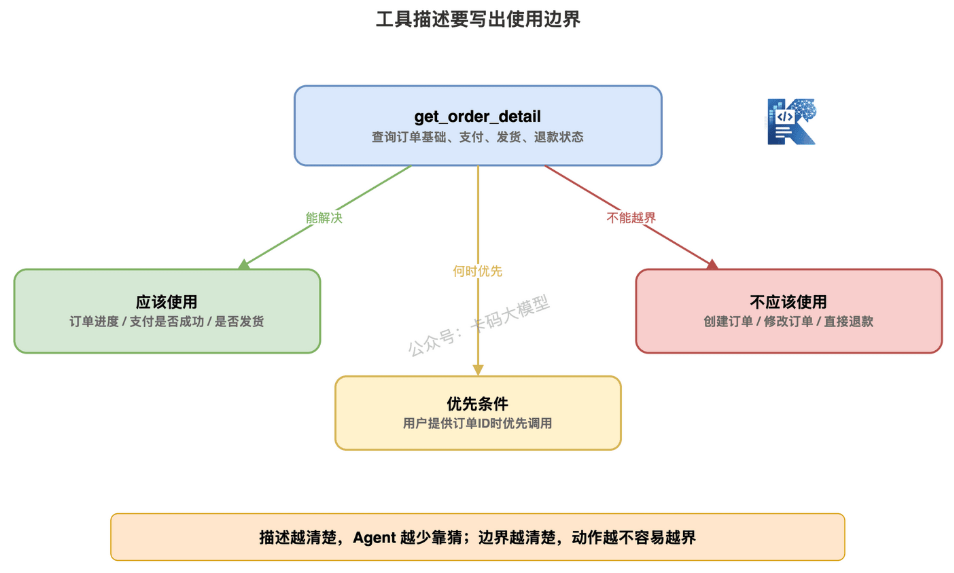
  "description": "根据订单ID查询订单的基础状态、支付状态、发货状态和退款状态。适用于用户询问订单进度、支付是否成功、是否已发货、是否已退款等问题。不用于创建订单、修改订单或发起退款。"
}
📌优质工具描述,必须包含三类关键信息:
- ✅能解决什么问题:写具体能力,拒绝 "处理用户请求" 这类空泛话术;
- ❌不能做什么:明确边界,防止 Agent 混淆功能相近的工具(查询工具不可改数据、草稿工具不能直接发消息等);
- ⏱️优先使用场景:写明触发条件,例如用户提供订单 ID 时优先调用;检索知识库无结果时不要重复调用。
💡核心观点:工具描述不是代码注释,而是Agent 专属的使用说明书,直接决定模型会不会选错工具。
5.2.参数设计
工具描述决定模型会不会选对工具 📖;参数设计决定模型能不能把工具用对⚙️。
很多 Agent 工具的参数设计过于粗暴,示例:
{
  "name": "search_logs",
  "parameters": {
    "query": "string"
  }
}
这种单字符串参数看着灵活,实则风险很高⚠️。相当于把全部解析工作丢给模型:要自行判断服务名、时间范围、日志级别、关键词、traceId 过滤等。模型很容易输出模糊时间(昨天晚上)、写错服务名、查询范围过大导致超时,或是范围过小查不到数据。
✅优化后的结构化参数示例:
{
  "name": "search_service_logs",
  "description": "查询指定服务在固定时间范围内的日志,用于排查接口错误、超时和异常调用链。",
  "parameters": {
    "type": "object",
    "properties": {
      "service_name": {
        "type": "string",
        "description": "服务名称,例如 payment-service"
      },
      "start_time": {
        "type": "string",
        "description": "查询开始时间,格式为 YYYY-MM-DD HH:mm:ss"
      },
      "end_time": {
        "type": "string",
        "description": "查询结束时间,格式为 YYYY-MM-DD HH:mm:ss"
      },
      "level": {
        "type": "string",
        "enum": ["ERROR", "WARN", "INFO"],
        "description": "日志级别,排查故障时优先使用 ERROR 或 WARN"
      },
      "keyword": {
        "type": "string",
        "description": "可选关键词,例如接口路径、错误码或 traceId"
      }
    },
    "required": ["service_name", "start_time", "end_time", "level"]
  }
}
借助参数 Schema 强制结构化填写,约束模型的自由度,避免模型随意拼接大段文本。
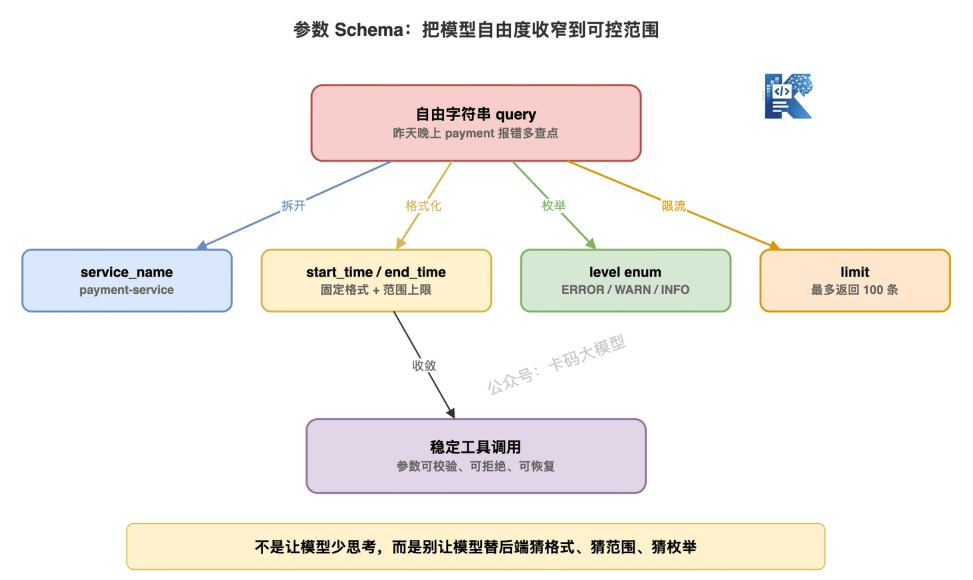
📌参数设计 4 条实用原则:
- 🧾能枚举就枚举:日志级别、订单状态这类固定选项,优先使用 enum,不要开放自由字符串输入,避免模型输出五花八门的文本,减少后端兼容成本与不稳定问题。
- ⏱️时间、数量、范围要明确:禁止 "最近、昨晚" 这类模糊表述,强制标准时间格式;设置上限(日志最多返回 100 条、检索最多 5 个文档块、查询跨度不超过 7 天),防止 Agent 调用压垮系统。
- 🧩不要让单个参数承载多重含义 :不要把用户名、时间、查询意图全部塞进同一个
user_input字段,否则会叠加两层不确定性。拆分成独立字段(user_name、date、query_type),参数越拆分清晰,Agent 越稳定。 - ❗缺少必填参数时,禁止模型编造:信息不全不要强行调用工具,应该主动向用户追问缺失信息。很多 Agent 事故都源于关键参数缺失时,模型编造内容调用工具,产生幻觉。
5.3.返回值设计
很多开发者只关注工具入参📥,却忽略工具返回值📤,这也是 Agent 容易出问题的一大坑⚠️。
举个反面例子,订单工具直接返回一段自然语言:
{
  "result": "订单已经支付成功,目前正在仓库处理中,预计明天发货。"
}
人类阅读很顺畅,但 Agent 无法直接做分支判断🤖:不知道要不要继续查物流、是否展示退款入口,只能再次解析文本,引入额外不确定性。
✅推荐结构化返回示例:
{
  "success": true,
  "order_id": "202605190001",
  "order_status": "PROCESSING",
  "payment_status": "PAID",
  "shipping_status": "NOT_SHIPPED",
  "refund_status": "NONE",
  "estimated_shipping_time": "2026-05-20",
  "evidence": [
    "支付流水号 PAY_8891 已确认",
    "仓库系统状态为待出库"
  ]
}
结构化字段可以让 Agent 稳定识别状态:支付已完成、尚未发货、无退款记录,直接取用预计发货时间;用户后续问退款时,再按需调用退款相关工具。
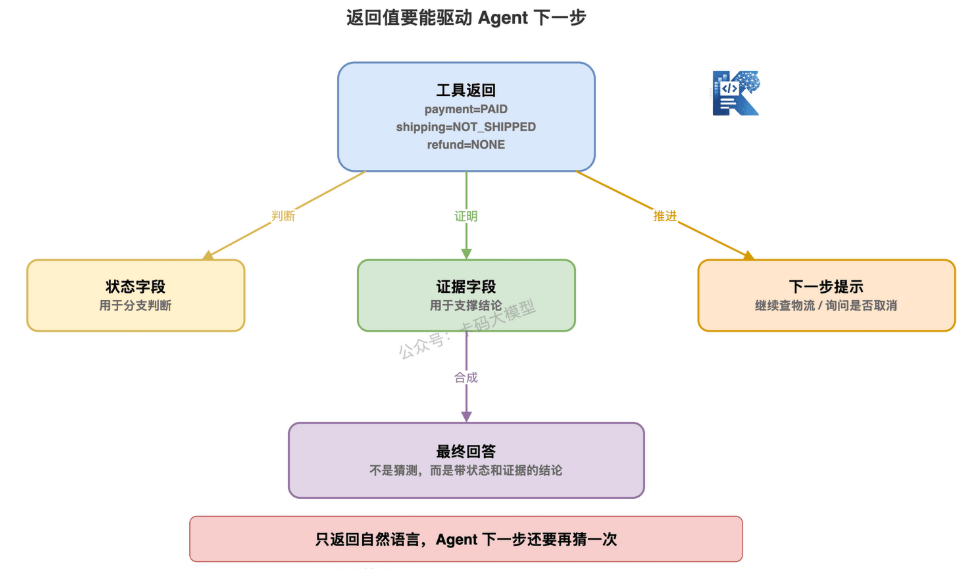
📌工具返回值设计,建议包含三类信息:
- 📊状态字段 :
success、error_code、业务状态枚举(订单状态 / 风险等级等),支撑 Agent 做分支逻辑判断; - 📝证据字段:数据来源、命中文档、日志片段 ID 等。Agent 输出答案时可以溯源,结论不是凭空猜测;
- 💡下一步提示(可选) :
suggested_next_actions,给出可选后续动作。不会强制替 Agent 决策,但给模型可靠的行动参考,在复杂业务场景下,大幅降低模型胡乱猜测的概率。
5.4.问题1:工具粒度
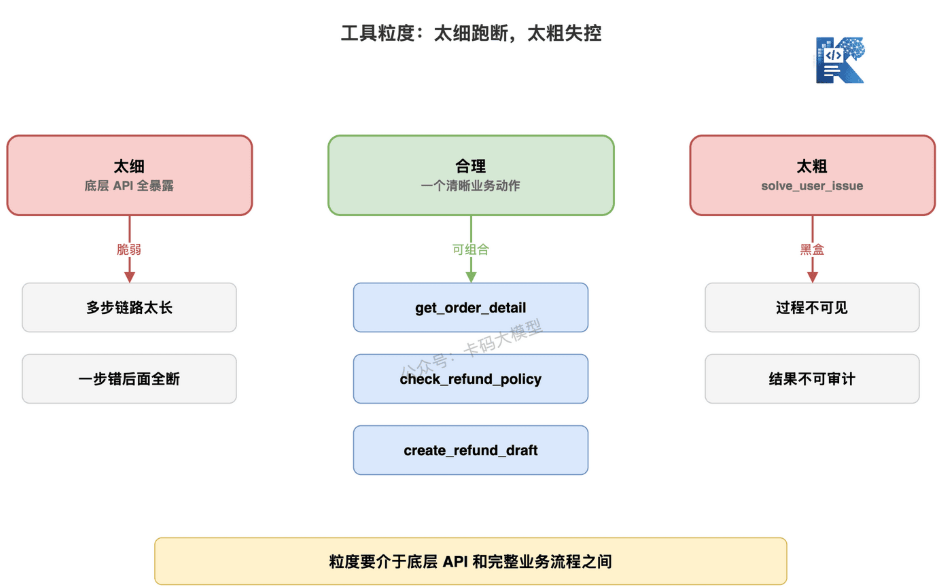
工具粒度⚖️,是 Agent 设计中最容易纠结的问题:工具到底该设计得更细,还是更粗?答案是不能走向任何一个极端。
- 🧩工具过细 :迫使 Agent 执行大量低级调用 示例工具:
get_user_id_by_phone、get_order_ids_by_user_id、get_order_base_info、get_payment_info、get_shipping_info、get_refund_info用户一句简单提问 "我买的东西怎么还没发货?",Agent 可能就要连续调用五六次工具。只要中间任意一步参数错误、返回空数据、状态丢失,整个流程就中断。 工具太细会让 Agent 沦为脆弱的流程编排器,大量机械步骤并不是大模型擅长的事❌。 - 📦工具过粗 :内部逻辑变成黑盒,Agent 看不到执行过程 示例工具:
handle_order_problem、solve_user_issue、process_after_sales调用这类大包工具之后,Agent 无法感知内部执行细节。返回 "处理成功",也不知道成功原因;一旦报错,无法区分是订单不存在、支付失败、库存不足还是物流异常。 表面调用简单,但系统不可解释、难以调试❌。 - ✅合理粒度:围绕单一业务动作封装 原则:一个工具完成一个清晰的业务动作,并且返回可判断的结构化结果。 合适工具举例:
get_order_detail:查询订单完整状态check_refund_policy:判断订单是否满足退款规则create_refund_draft:创建退款申请草稿confirm_refund_submit:用户确认后提交退款search_service_logs:查询指定服务日志query_api_latency:查询接口延迟指标get_deploy_records:查询对应时段发布记录
这类工具既不是底层数据库接口,也不是包揽全部问题的超级工具,方便 Agent 稳定组合调用。
💡面试金句:工具粒度要介于底层 API 和完整业务流程之间。太细会增加多步调用失败率,太粗会降低可控性和可解释性。
5.5.问题2:副作用的工具
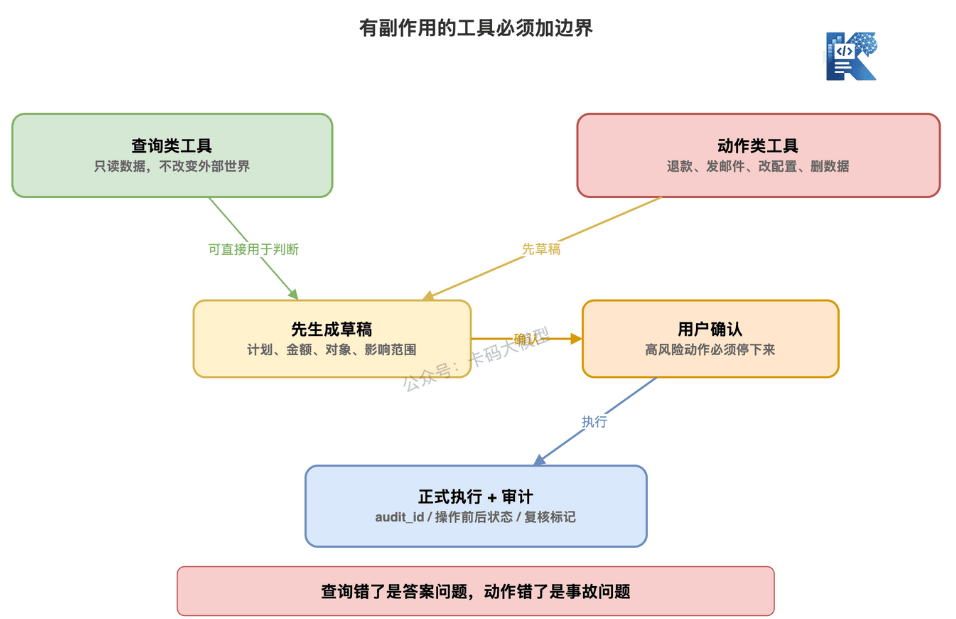
Agent 工具大体可划分为两大类📚:查询类工具 和 动作类工具,二者千万不要混在一起设计,风险等级完全不同⚠️
- 🔍查询类工具:只读数据,不会修改外部状态。例如查询订单、日志、监控指标、知识库。调用出错最多只是返回信息不准确。
- ⚙️动作类工具:会改变外部系统状态,存在业务风险。例如发邮件、提交退款、修改配置、重启服务、删除文件、创建工单。一旦调用失误,会直接引发线上事故。
带有副作用的动作类工具,至少需要三层安全保护:
-
📖✍️读写工具严格分离 不要设计像
handle_refund(处理退款)这种模糊工具,无法区分是查询退款规则还是直接执行退款。 推荐拆分成独立工具:get_order_detail、check_refund_policy、create_refund_draft、submit_refund_after_user_confirm。 查询、生成草稿、正式提交相互隔离,边界清晰,降低事故概率。 -
✅高风险操作必须二次确认 涉及资金、权限、数据、生产环境变更的操作,不能交由 Agent 自行决定执行。 退款、扣费、删数据、修改权限、发送正式邮件、重启线上服务、修改生产配置等场景,Agent 先输出草稿 / 执行计划,等待用户确认之后,再调用真正执行的工具。 这不是牺牲智能体验,而是工程安全,成熟 Agent 要懂得适时暂停,交由人工确认。
-
📜动作工具返回结果携带审计信息 动作类工具返回值建议包含:操作人、操作对象、操作时间、操作前后状态、审计 ID、是否需要人工复核。 示例:
{
"success": true,
"action": "CREATE_REFUND_DRAFT",
"draft_id": "RF_DRAFT_10086",
"order_id": "202605190001",
"amount": 199.00,
"requires_user_confirm": true,
"audit_id": "AUDIT_7788"
}
有了审计字段,Agent 就不会谎称已经完成退款,而是准确告知用户:已创建退款草稿,需要确认后才正式提交。清晰的工具边界带来系统稳定性。
5.6.问题3:报错恢复
很多工具失败时的返回设计很简陋⚠️,只简单返回:
{
  "success": false,
  "message": "系统异常"
}
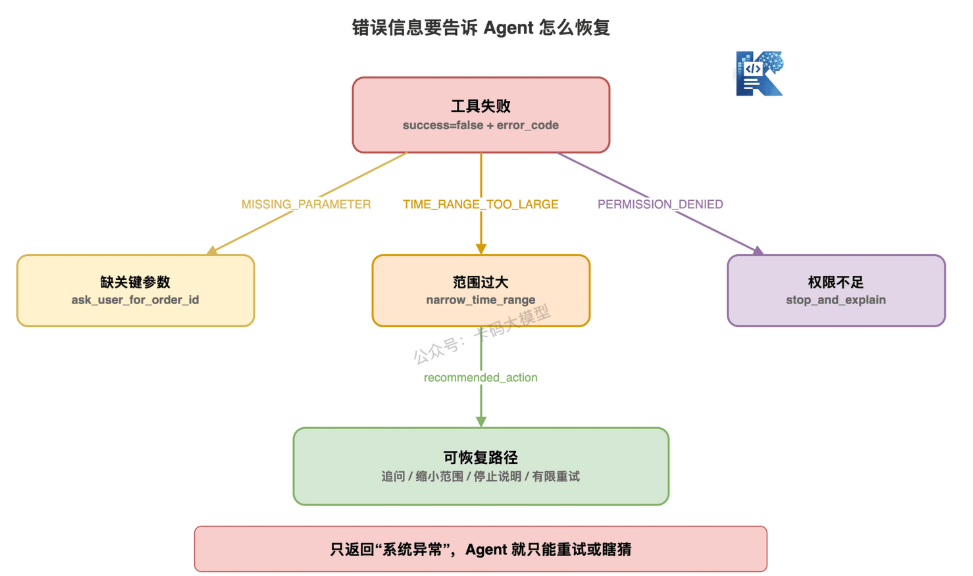
这样的报错对 Agent 几乎没有价值🤖。Agent 无法判断:是该重试、修改参数、更换工具,还是告知用户稍后再尝试。
✅优质的错误返回,要能够支撑 Agent 做故障恢复决策,示例:
{
  "success": false,
  "error_code": "MISSING_REQUIRED_PARAMETER",
  "message": "缺少订单ID",
  "recoverable": true,
  "recommended_action": "ask_user_for_order_id"
}

{
  "success": false,
  "error_code": "TIME_RANGE_TOO_LARGE",
  "message": "日志查询时间范围不能超过24小时",
  "recoverable": true,
  "recommended_action": "narrow_time_range"
}
📌设计思路:
- 携带
error_code错误码,区分错误类型; recoverable标记是否可恢复;recommended_action给出建议动作。
Agent 就可以根据错误类型分支处理: 🔹缺少必填参数 → 向用户追问信息 🔹查询时间范围超限 → 自动缩小时间区间 🔹权限不足 → 告知用户无法执行 🔹工具超时 → 有限次数重试 🔹业务规则禁止操作 → 直接终止尝试
💡核心观点:错误信息不只是给人阅读,同样要给 Agent 解析。 不少模型幻觉根源并不是模型本身,而是工具返回的错误信息质量太差,导致 Agent 无法正确处理失败,最后编造答案。
5.7.问题4:工具编排
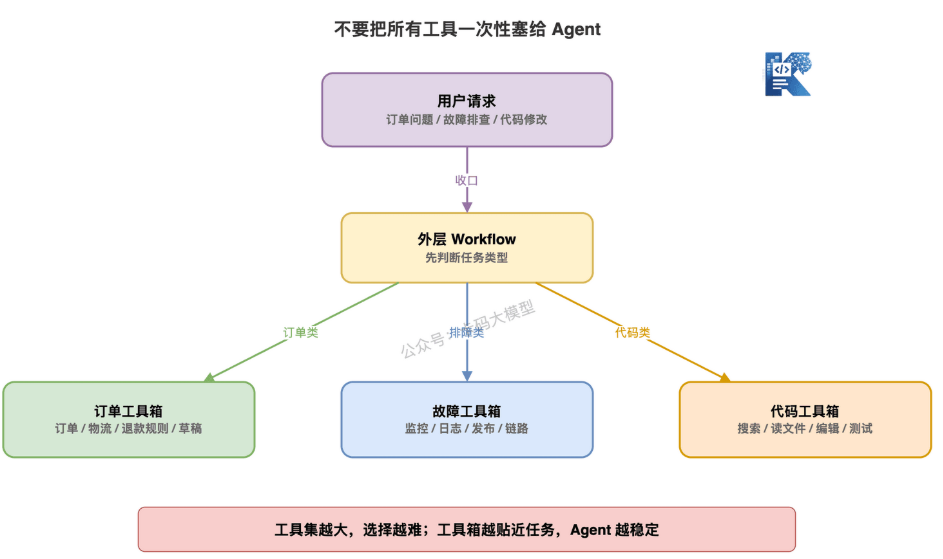
很多人存在一个误区💡:工具越多,Agent 能力越强。事实并非如此⚠️。 工具数量越多,模型可选范围越大,选错工具的概率也随之上升。一次性把订单、物流、退款、日志、监控、数据库等几十种工具全部注入 Agent,每一步推理都要在大量工具中筛选,不是增强能力,反而是带来严重干扰🤖。
✅更优方案:根据任务动态收敛工具集,只提供当前场景需要的工具:
- 🧑💼客服 Agent 处理订单问题:仅开放订单查询、物流查询、退款规则查询、退款草稿创建、用户追问工具
- 🛠️故障排查场景:仅开放监控查询、日志查询、发布记录查询、链路追踪查询、报告生成工具
- 💻代码开发场景:仅开放文件读取、代码搜索、测试执行、补丁编辑、结果汇总工具
📌核心思路:工具集不在于大,而在于和当前任务匹配。 可以搭配 Workflow 架构实现:外层工作流先判断任务类型,再为 Agent 分配对应的工具箱。外层流程负责整体收口,内部 Agent 负责局部灵活探索,整体稳定性会大幅提升。
5.8.面试官可能会问
面试高频 Agent 工具设计问答合集📝,避开只说 "使用 Function Calling 对接 API" 这种浅层回答,下面这套话术可以直接拿去面试,体现工程落地经验,不只是懂 ReAct 理论🤖
❌普通回答(不推荐):我们用 Function Calling 对接了几个业务 API。
✅面试官:你们 Agent 的工具是怎么设计的?
我们没有直接把后端 API 暴露给模型,而是按业务动作封装成工具 。每个工具会写清楚使用场景、不适用场景、参数 Schema、返回结构和错误码 。查询类工具和有副作用的执行类工具分开,高风险操作只允许先生成草稿,用户确认后再提交。
✅面试官:工具粒度怎么控制?
工具粒度一般介于底层 API 和完整业务流程之间。太细会导致 Agent 多步调用链过长,任何一步出错都会中断;太粗会让工具内部变成黑盒,Agent 看不到状态和证据。我们通常围绕一个清晰业务动作封装工具,比如查询订单完整状态、检查退款规则、创建退款草稿,而不是暴露一堆数据库接口。
✅面试官:如果工具调用失败怎么办?
工具失败不能只返回系统异常,而要返回结构化错误码、是否可恢复、推荐下一步动作。比如缺少参数就让 Agent 追问用户,时间范围过大就缩小范围,权限不足就停止并告知原因。这样 Agent 才能从错误中恢复,而不是继续瞎猜产生幻觉。
✅面试官:问到安全边界怎么答?
查询类工具和写操作工具必须分开。写操作尤其是退款、发邮件、改配置、删数据这类有副作用的动作,要先生成草稿或执行计划,再经过用户确认 。工具返回里要携带审计信息,方便追踪和回放。
💡亮点:这套回答证明你具备真实 Agent 工程落地经验,而不是只了解 ReAct、Function Calling 这类名词概念。
6.第六步:MCP协议
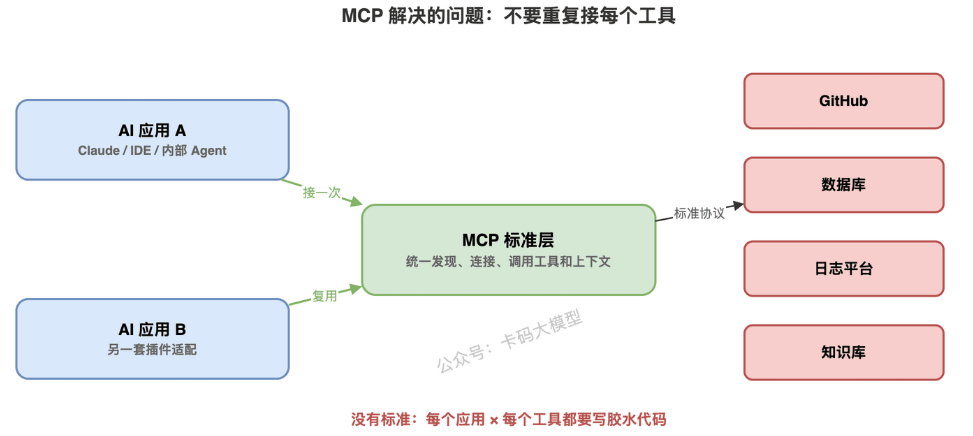
MCP,Model Context Protocol。(模型上下文协议)
MCP 是一套标准协议,用来让 AI 应用以统一方式连接外部工具、数据和提示模板。
6.1.三层架构
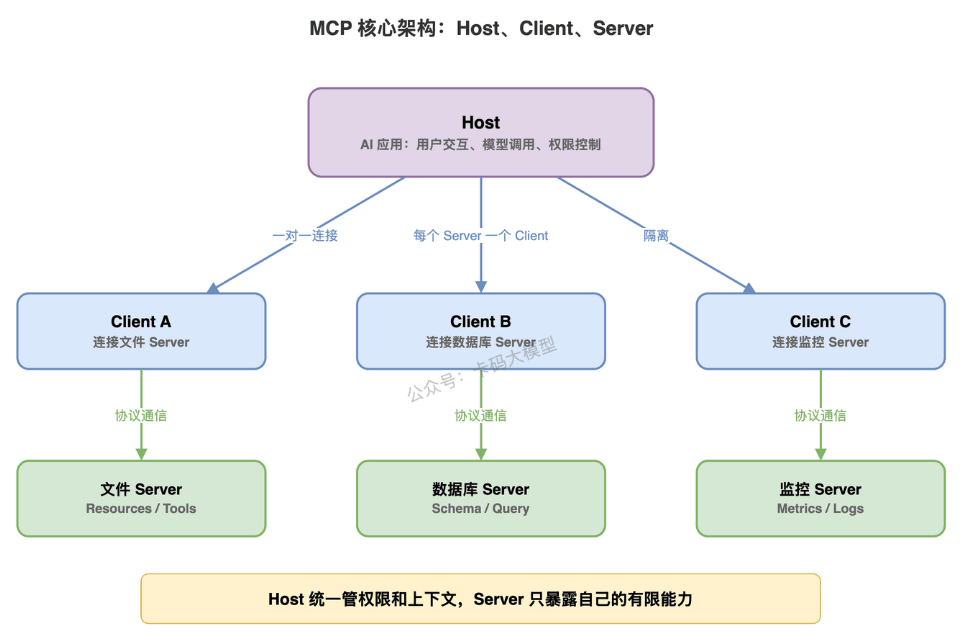
MCP 官方架构包含三大核心角色:Host、Client、Server🤖,概念一定要区分清楚,不然讲解 MCP 很容易混淆。
🧠Host:AI 应用本体 Host 就是用户直接使用的 AI 应用本身。 例子:Claude Desktop、Claude Code、VS Code AI 插件、Cursor 代码助手、自研 Agent 平台。 职责:处理用户交互、调用大模型、权限判断、聚合上下文。 一句话理解:Host 是承载大模型大脑的应用外壳。用户并不是直接和 MCP Server 对话,而是在 Host 内发起提问。
🔗Client:Host 内部对接 Server 的组件 MCP Client 并不是独立软件产品,是 Host 内部的连接模块。 一个 Host 可以对接多个 MCP Server,每接入一个 Server,就会新建一个对应的 Client。 Client 职责:
- 和 MCP Server 建立通信连接
- 协商协议版本与能力
- 请求获取工具清单、发起工具调用
- 接收返回结果与通知
- 维护这条连接的安全边界 简单比喻:一个 Client 就是通往一台 MCP Server 的专属通信通道。
📦Server:对外提供能力(工具、资源、提示模板) MCP Server 是能力的实际提供者。 示例:文件系统 Server、GitHub Server、数据库 Server、Sentry 监控 Server、企业内部订单 / 日志 / 知识库 Server。 Server 不直接和用户对话,只遵循 MCP 协议向外输出能力。
提供三类核心能力:
✅ Tools(工具)
✅ Resources(资源)
✅ Prompts(提示模板)
6.2.两层协议
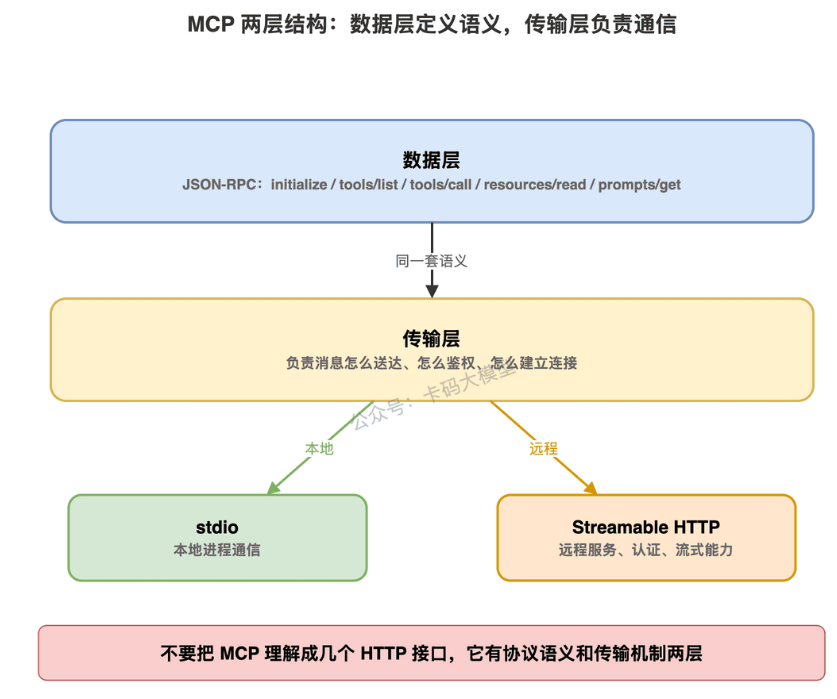
很多人对 MCP 的理解只停留在 "用来对接工具" 这个表层💡,实际上 MCP 包含数据层、传输层两层核心定义📚
全称:JavaScript Object Notation Remote Procedure Call 2.0 中文:基于 JSON 的远程过程调用协议(2.0 版本)
一句话:无状态、轻量、与传输无关的 RPC 协议,用 JSON 序列化消息,MCP 上层消息语义就基于它JSON-RPC。
✅ 核心特点(论文 / 答辩用)
- 传输无关 :不绑定底层通道。既可跑在
stdio管道,也可 HTTP、SSE、TCP;MCP 就是利用这个特性,上层统一 JSON-RPC,下层切换 stdio / Streamable HTTP。- 无状态 :每次调用独立,服务端默认不保存会话状态(MCP 自己在 HTTP 层增加
Mcp-Session-Id会话,不属于 JSON-RPC 原生)。- 只有 3 类消息:请求 Request、应答 Response、通知 Notification。
- 极简 JSON 结构,规定固定字段。
📄数据层:定义消息与业务语义 基于 JSON-RPC 规范,约定整套交互的消息结构与语义规则:
- 初始化流程、能力协商
- 获取工具列表
tools/list、执行工具调用tools/call - 读取资源
resources/read、获取提示模板prompts/get - 通知推送、错误返回格式
⚠️重点:MCP 不是简单的 HTTP 接口集合,它拥有独立的协议方法、请求与响应结构。
📡传输层:定义消息如何传递 负责把 JSON-RPC 消息完成收发,主流两种实现方式:
stdio:本地进程间标准输入输出通信。 例:Claude Desktop 拉起本地文件系统 MCP Server,使用 stdio 通信。✅优势:本地调用性能高,无需网络。适合本地工具场景。Streamable HTTP:远程 HTTP 通信,支持流式输出与鉴权。 例:对接远程 Sentry MCP Server、企业内部 MCP 网关。✅适合远程服务、多用户、需要身份认证的场景。
| 传输 | 通信载体 | 会话 | 鉴权 | 适用场景 |
|---|---|---|---|---|
| stdio | OS 进程管道 stdin/stdout | 单会话一对一 | 无 | 本地本机工具(文件系统、本地知识库),Claude Desktop 本地插件 |
| Streamable HTTP | HTTP + 可选 SSE 长流 | Mcp-Session-Id 多会话 | Bearer/OAuth/API Key | 远程 MCP 网关、Sentry、企业内部服务、多用户 Agent |
6.3.三种能力
MCP Server 暴露三类能力:Tools、Resources、Prompts
MCP Server 不只是暴露工具而已,它对外提供三类核心能力:Tools、Resources、Prompts,三者概念要区分清楚🤖
- ⚙️Tools:模型可主动执行的动作 和 Function Calling 最接近,代表模型可以主动触发的函数。 示例:查询订单、检索日志、创建工单、查询数据库、修改文件。 Tool 包含名称、描述、参数 Schema,由模型根据问题和上下文判断是否调用。 一句话:Tools 解决 Agent「能做什么动作」。
- 📖Resources:用于补充上下文的数据源 偏向被动提供信息,不一定由模型主动发起调用;常由 Host 按需读取后注入上下文。 示例:文件内容、数据库表结构、API 文档、项目 README、用户偏好、日历信息。 一句话:Resources 解决 Agent「能看到什么信息」。
- 📝Prompts:可复用的提示模板 预先封装好的交互流程模板,可以指导模型如何组合调用工具与资源。 示例:日志故障排查模板、会议总结模板、PR 描述生成模板、旅行规划模板。 一句话:Prompts 解决 Agent「按什么套路做事」。
| 对比维度 | stdio(本地子进程) | Streamable HTTP(远程服务 / 网关) |
|---|---|---|
| 常见场景 | 本机文件、本地知识库、本地数据库 | 企业中台、Sentry、云数据库、多租户远程服务 |
| Resources(读什么) | 读取本地文件、本地配置文档(高频) | 拉取远程文档库、远程 API 文档、远程知识库内容 |
| Tools(做什么) | 修改本地文件、查询本地 SQLite 数据库(高频) | 调用远程接口、查询远程日志、创建工单(高频) |
| Prompts(怎么干) | 本地存放的故障排查模板、本地任务模板 | 服务端托管的全局提示模板,所有接入 Agent 共用 |
| 典型例子 | Claude Desktop 挂载本地 filesystem MCP Server:读文件(Resources)+ 新建 / 修改文件(Tools)+ 本地 prompt 模板 | 企业 MCP 网关:远程知识库读取(Resources)+ 业务 API 调用(Tools)+ 全局任务模板(Prompts) |
💡记忆口诀: ✅ Tools = 能做什么 ✅ Resources = 能看什么 ✅ Prompts = 怎么做更稳
很多人片面认为 MCP 仅仅是工具调用协议,其实这个理解比较局限。
MCP 本质目标是标准化 AI 应用与外部上下文之间的连接方式,工具只是其中最受关注的一部分。
用一个场景完整演示 MCP 单次工具调用的完整流程🔁
用户在 AI 应用提问:帮我查一下支付服务昨天晚上为什么变慢
前提:Host 已经连接监控 MCP Server、日志 MCP Server。
- 🤝初始化连接 Host 为每一个 MCP Server 新建独立 Client;Client 与 Server 完成协议初始化,协商协议版本、能力集(例如 Server 声明支持 tools、resources)。
- 🔍工具发现 Client 向 Server 发送
tools/list请求,Server 返回可用工具清单,如query_api_latency、search_service_logs、get_deploy_records。Host 整理工具描述,供给大模型使用。- 🧠模型决策,选择调用工具 模型解析用户问题,选择优先调用
query_api_latency,生成对应的工具名称与入参。- 📤Client 发起 MCP 工具调用 Host 通过对应 Client 发送
tools/call请求;MCP Server 执行真实业务查询,返回结构化结果。- 🔄模型基于返回结果继续推理(ReAct 循环) 举例:查到 22:10 延迟飙升 → 模型继续调用发布记录工具;发现 22:05 有版本发布 → 再调用日志工具排查异常。
💡关键要点: MCP 只负责工具接入与调用通信协议。 Agent 的任务规划、逻辑判断、反思迭代,依旧由 Host 内部的大模型和应用逻辑承担。
6.4.面试官可能会问
✅面试官:MCP 是什么?
MCP,全称 Model Context Protocol,是一套让 AI 应用标准化连接外部工具、数据源和提示模板的协议。采用 Host-Client-Server 架构,Server 对外暴露 Tools、Resources、Prompts;Host 通过 Client 连接多个 Server,将这些能力提供给大模型使用。
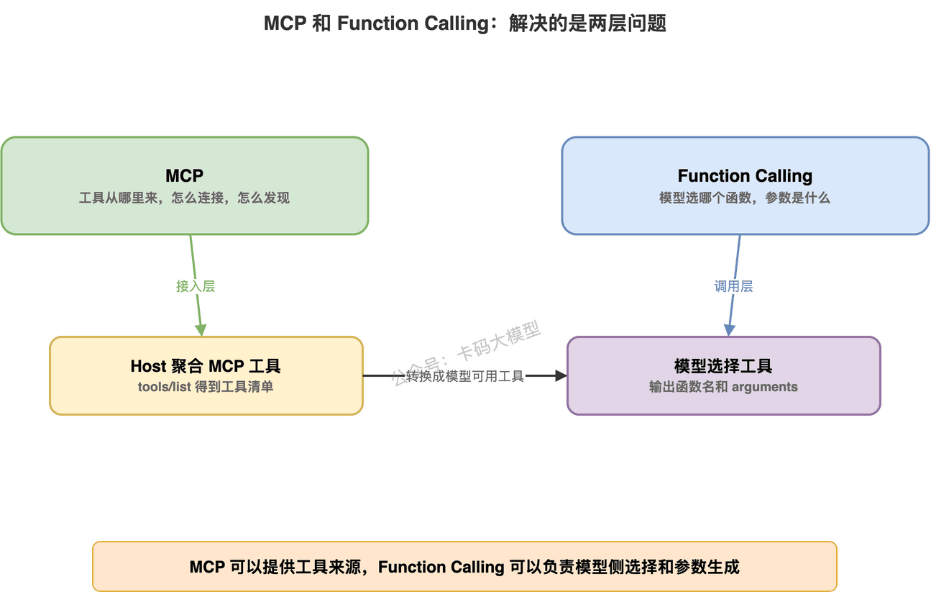
✅面试官:MCP 和 Function Calling 有什么区别?
Function Calling 偏向模型侧,解决模型怎么选择函数、生成调用参数;
MCP 偏向应用接入层,解决工具、资源、提示模板如何被 AI 应用发现、连接与调用。在真实项目中,Host 可以借助 MCP 拿到工具列表,再转换成模型支持的 Function Calling 格式供模型调用。
✅面试官:MCP 的核心角色有哪些?
三大核心角色:Host、Client、Server。Host 就是 AI 应用本体,负责用户交互、模型调用、权限控制、上下文聚合;Client 是 Host 内部对接单个 Server 的连接组件;Server 用来暴露工具、资源和提示模板。一个 Host 可以创建多个 Client,每个 Client 一般对应一个 MCP Server。
✅面试官:Tools、Resources、Prompts 怎么区分?
Tools 是模型可以主动执行的动作,例如查询数据库、发送消息;Resources 是只读的上下文数据源,例如文件内容、数据库表结构、API 文档;Prompts 是可复用提示模板,用来指导模型按固定流程使用工具和资源。简单概括:Tools 是能做什么 ,Resources 是能看什么 ,Prompts 是怎么做。
✅面试官:MCP 有什么安全风险?
MCP 只是标准化了工具接入,本身并不自带安全能力。Host 侧需要管控 Server 接入权限、上下文传输范围,高风险操作增加确认机制;Server 遵循最小权限原则,不要开放全部数据访问。具备副作用的工具(删除文件、修改数据库、发送消息等),必须增加用户确认、权限校验与审计日志。
7.第七步:Agent设计思路
💡核心主旨:Agent 区别于传统程序,拥有自主动态决策能力,这既是它的优势,也是不稳定的根源。传统程序路径预先写死;Agent 每一步都由模型实时判断,推理不确定性会沿着调用链放大。Demo 效果亮眼,但落地生产必须搭建多层工程护栏,做到故障可拦截、可止损、可复盘。不要单纯指望模型自身来保证稳定!
7.1.Agent 为什么不稳定
✅ 普通应用:分支逻辑硬编码,输入确定,输出可预期。
🤖 Agent:动态自主决策,模型实时选工具、填参数、规划下一步。
⚠️ 重点:模型推理自带不确定性,多步链路会不断放大风险。必须依靠外部工程机制兜底。
7.2.死循环
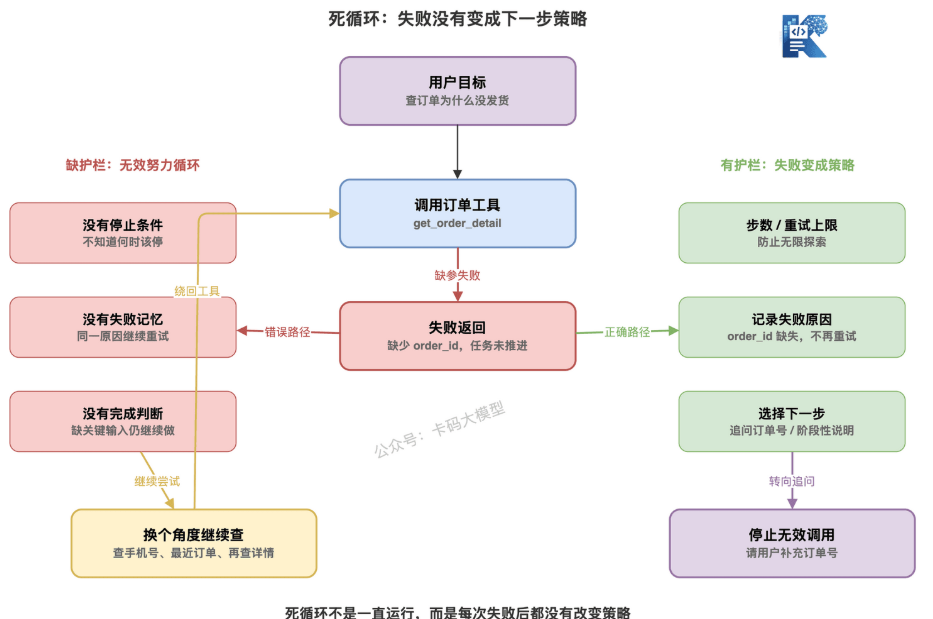
1. 死循环:反复执行,任务毫无推进🔁
并不是代码层面那种 while(true) 死循环,更多是业务逻辑层面的空转。
📎案例:订单退款流程 Agent 反复调用查询订单接口,但一直缺失订单编号这个关键入参。它不会停下来向用户询问订单号,只会一遍又一遍发起空查询,无限循环,任务永远无法向前推进。
诱因 没有定义停止条件、不会记录已经失败过的调用记录、缺少任务完成度判断逻辑。
兜底方案
- 设置全局最大工具调用步数上限,达到阈值强制终止;
- 记录失败工具 + 对应参数,禁止无意义重复重试;
- 多维度终止判断:触发后要么输出阶段性结果,要么向用户索要缺失信息,或是流转人工确认。
7.3.误调用
误调用 🛠️|工具选错,一步错步步错
Agent 调用工具 / 传参出错,是项目高频问题。
✅例子:查退款直接提交退款;查接口耗时却去读业务库,乱解读数据。
🔍4 个诱因:
- 工具命名描述太相似,模型分不清
- 读写操作耦合在同一个工具,风险极高
- 参数校验规则宽松,非法参数可传入
- 工具返回无标准化状态,模型只能猜测下一步
💡兜底方案:查询工具 & 动作工具强制拆分 高风险操作只生成草稿,必须人工确认后执行; 在模型之外增加系统层参数校验,模型负责决策,系统负责守门。
比如:
check_refund_policycreate_refund_draftsubmit_refund_after_confirm
不要写一个模糊的 handle_refund。
7.4.多步任务中断
Agent 做简单任务还好。一旦进入多步任务,问题就多了。
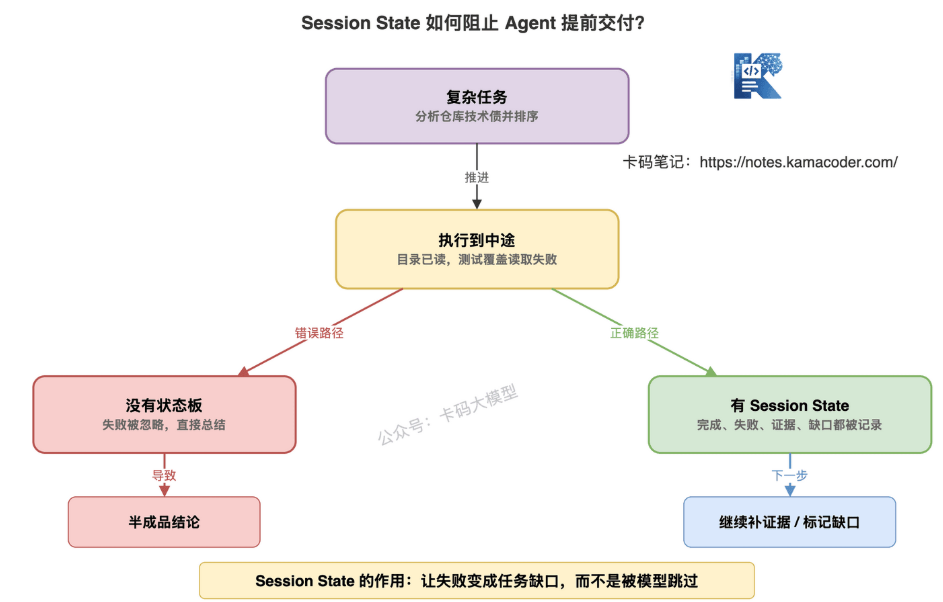
比如让 Agent:"帮我分析这个仓库的技术债,并按优先级给修复建议。" 它可能要做这些步骤:看目录结构、找核心模块、搜复杂函数、看测试覆盖、找重复代码、总结优先级。 中间任何一步失败,Agent 都可能断。 比如搜索工具超时,它可能直接说 "仓库没有明显技术债"。 比如某个目录无权限,它可能忽略这个目录,继续总结。 比如读取文件失败,它可能脑补文件内容。 这就是多步中断。
为什么多步任务容易中断🔍
根因是 Agent 缺少任务状态。 它只知道刚才工具返回了什么。但不知道整个任务目前做到哪一步、哪些子任务完成了、哪些子任务失败了、哪些证据已经拿到、哪些结论还不能下。
所以它很容易出现两种问题。一种是提前交付,只完成了 30%,就开始总结。另一种是丢失上下文,前面查到的证据,后面忘了。
怎么兜底📌
多步任务要用任务状态管理。不要只让模型在脑子里记。 可以维护一个简单的任务状态:
当前目标是什么
已完成哪些步骤
每一步证据是什么
哪些步骤失败了
失败是否可恢复
还缺什么信息
当前是否可以交付
这听起来像 Workflow。但不是把 Agent 变成固定流程。而是给 Agent 一个外部任务板。它可以动态决策,但每一步都要写入状态。如果失败,要标记失败原因。如果证据不足,要标记缺口。最后交付前,要检查状态是否满足目标。 这就是把 Agent 从 "边走边忘" 拉回 "边走边记录" 。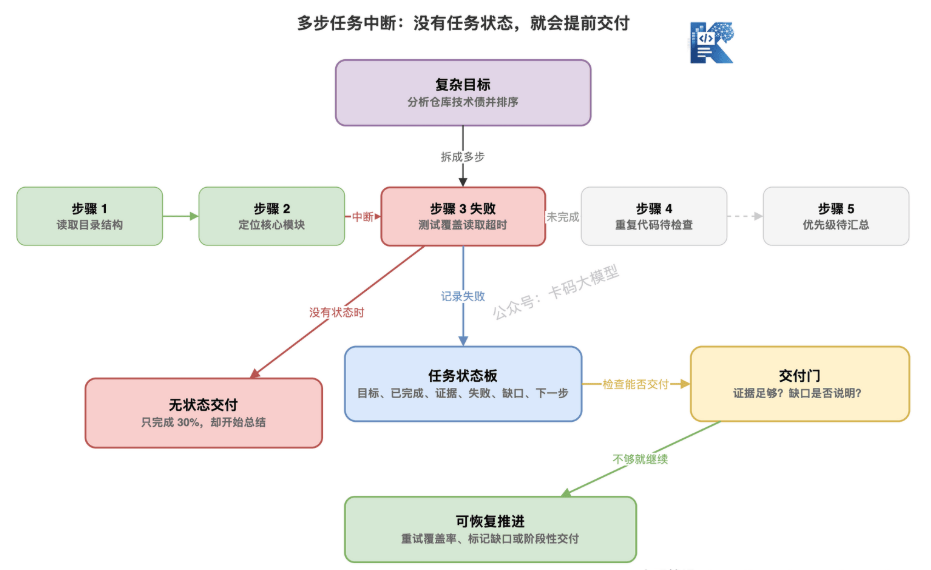
7.5.上下文污染
错信息混进去,后面全被带偏 ☁️
上下文污染,是 Agent 里非常隐蔽的问题。它不像工具调用失败那么明显,但杀伤力很大。
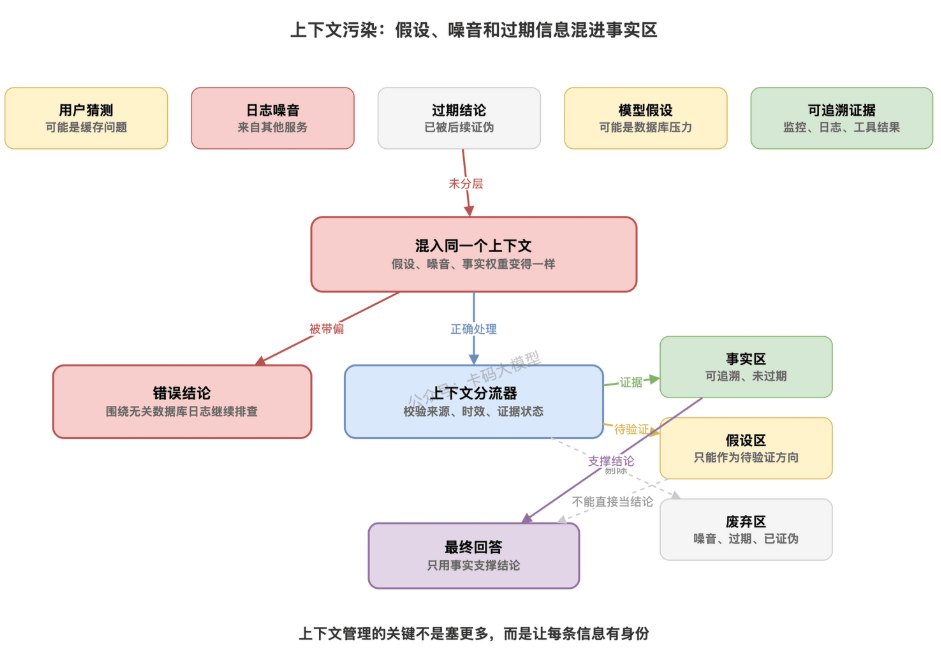
什么叫上下文污染?就是错误信息、过期信息、无关信息、未验证假设,被放进上下文后,影响后续判断。
比如 Agent 查日志时,工具返回了一段无关错误:"数据库连接池等待时间升高。" 但这段日志其实来自另一个服务。Agent 没检查服务名,就把它当成根因。后面每一步都围绕数据库查。最后得出一个错误结论:"支付接口变慢主要是数据库连接池不足。"
再比如:用户前面说 "可能是缓存问题"。这只是用户猜测。Agent 却把它当成事实。后面一直查缓存。最后忽略了真正的发布问题。
上下文污染来自哪里📊
常见来源有四个。
第一,用户猜测。用户说 "我觉得可能是 xx",这不是证据。
第二,工具返回的噪音。日志、搜RAG 片段里经常有无关信息。
第三,过期上下文。前面得到的结论,在后面可能已经被推翻。
第四,模型自己的中间假设。模型说 "可能是数据库问题",如果不标记为假设,很容易被后面当事实。
怎么兜底📑
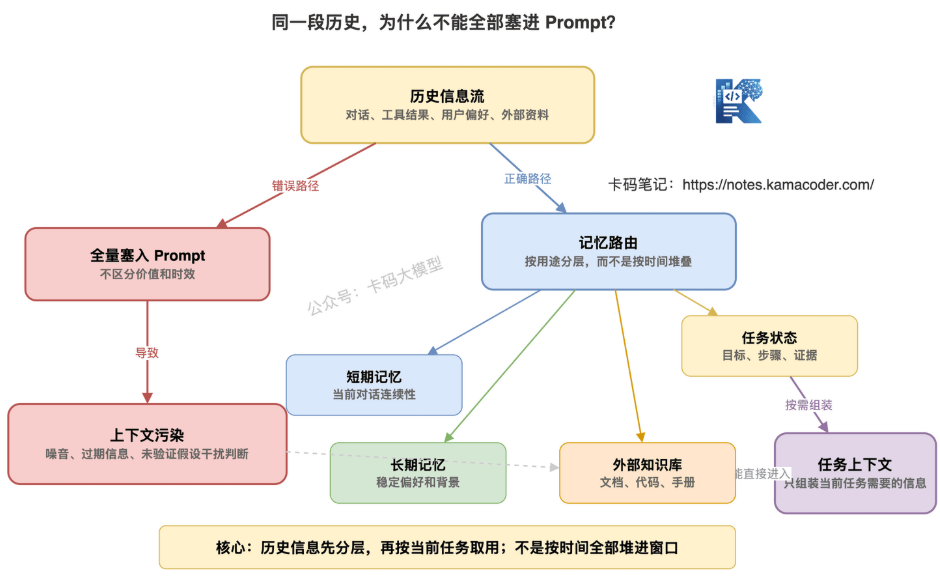
上下文管理要分层。不要把所有东西都丢进同一个上下文。
至少分成三类:
✅事实:来自工具、数据库、日志、监控,而且能追溯来源。
🔍假设:模型推测、用户猜测、待验证的原因。
🗑️废弃信息:已经被验证无关、过期或错误的信息。
Agent 最后输出结论时,必须基于事实。假设只能作为待验证方向。废弃信息不能继续参与推理。 这就是为什么很多成熟 Agent 系统会做状态记录、证据引用、trace 回放。不是为了好看。是为了防止上下文变成一锅粥。
7.6.权限越界
前面几类翻车,大多影响答案质量。权限越界,影响的是安全。这类问题最危险。
比如:用户只是问:"这个订单能不能取消?"Agent 直接调用取消订单工具。 用户只是说:"帮我看看这封邮件怎么回。"Agent 直接发出去了。 用户只是说:"这个配置是不是有问题?"Agent 直接改了生产配置。 这不是体验问题。这是事故。
为什么会权限越界🚨
权限越界通常来自三件事。
第一,工具权限太大。一个工具既能查,又能改。
第二,缺少确认环节。Agent 从 "建议" 直接跳到 "执行"。
第三,Host 没有做权限守门。系统默认相信模型判断。这就很危险。
怎么兜底⚖️
高风险动作要分级。可以简单分三类。
🔹低风险:只读查询。比如查文档、查订单状态、查监控指标。通常可以让 Agent 直接调用。 🔹中风险:生成草稿。比如写邮件草稿、创建退款申请草稿、生成配置修改方案。可以让 Agent 做,但不能直接提交。
🔹高风险:改变外部世界。比如发邮件、退款、删除数据、改生产配置、执行命令。必须用户确认。还要有审计记录。
这和 MCP 文章里讲的安全边界是一致的。Host 要管权限。工具要暴露有限能力。动作要分草稿和执行。不要指望模型自己永远克制。
7.7.错误不可恢复
Agent 翻车还有一个很常见的场景:工具失败了。但 Agent 不知道怎么处理。于是它开始编。
比如工具返回:
{
  "success": false,
  "message": "系统异常"
}
这对 Agent 没什么帮助。它不知道:是缺参数?是权限不足?是工具超时?是数据不存在?是业务规则不允许?能不能重试?应该追问用户吗?
如果错误信息不可恢复,Agent 很容易说:"根据查询结果,订单正在处理中。" 但其实它根本没查到。
怎么兜底🛡️
错误返回要结构化。
至少包含: error_code、recoverable、recommended_action、retry_after、missing_fields、permission_required
比如:
{
  "success": false,
  "error_code": "MISSING_ORDER_ID",
  "recoverable": true,
  "recommended_action": "ask_user_for_order_id",
  "missing_fields": ["order_id"]
}
这样 Agent 就知道下一步不是继续查。而是追问用户。
再比如:
{
  "success": false,
  "error_code": "PERMISSION_DENIED",
  "recoverable": false,
  "recommended_action": "stop_and_explain",
  "permission_required": "refund:submit"
}
这时 Agent 就应该停止。不是换个工具继续试。
7.8.Agent 兜底
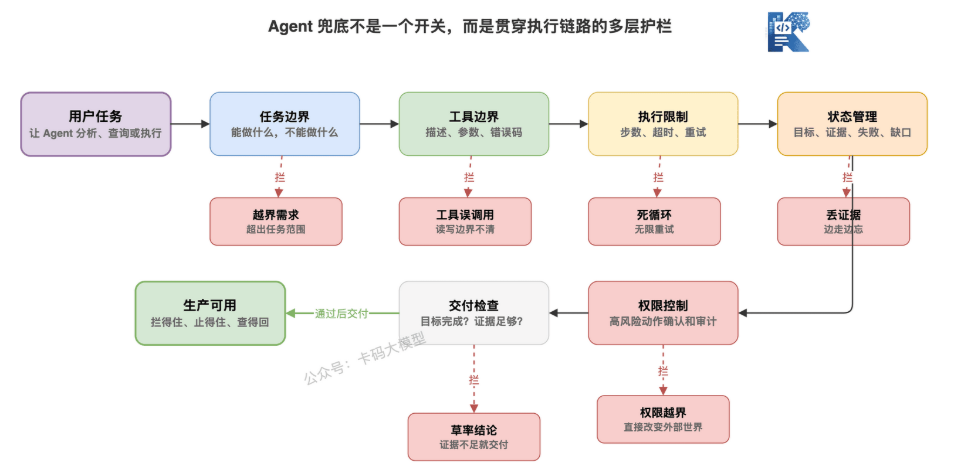
很多人问:"怎么防止 Agent 翻车?" 不要期待一个万能开关。真正的兜底是一套护栏。至少包括六层。
- 任务边界。明确 Agent 能做什么,不能做什么。
- 工具边界。工具描述、参数、返回值、错误码都要清楚。
- 执行边界。最大步数、超时、重试次数、停止条件。
- 状态管理。记录目标、步骤、证据、失败、缺口。
- 权限控制。高风险动作二次确认、权限校验、审计记录。
- 交付检查。最终回答前检查:目标是否完成?证据是否足够?有没有未验证假设?
这里要特别强调一点。 护栏不是为了限制 Agent 的能力。而是为了让它能进入生产环境。 没有护栏的 Agent,Demo 里看起来很聪明。一到真实业务就容易出事。能不能做生产级 Agent,差别就在这里。
7.9.面试官可能会问
Agent 面试里,面试官很喜欢问这类问题。
因为它能看出你是真做过,还是只会讲概念。
面试官问:Agent 为什么容易翻车?
可以这样答:
"Agent 的核心是动态决策 ,它不是固定 Workflow,每一步都会根据中间结果决定下一步。所以它的自由度更高,也更容易出现死循环、工具误调用、上下文污染、多步任务中断和权限越界。工程上不能只靠模型自觉,需要用步数限制、状态记录、工具边界、错误恢复、权限确认和审计来兜底。"
面试官问:怎么防止 Agent 死循环?
可以这样答:
"我会设置最大步数、最大重试次数和停止条件,并记录失败工具和关键参数。如果同一个工具因为同样原因失败,就不能无限重试,要根据错误码选择追问用户、缩小范围、换工具或停止说明。"
面试官问:怎么防止 Agent 调错工具?
可以这样答:
"工具设计上要把查询类和动作类分开,工具描述写清适用场景和不适用场景,参数 Schema 收紧类型、枚举和必填字段。执行前还要做规则校验,高风险动作只能先生成草稿,用户确认后才能调用正式执行工具。"
面试官问:Agent 上下文污染怎么处理?
可以这样答:
"上下文不能混成一锅粥。我会把事实、假设和废弃信息分开管理。工具返回的可追溯结果才能进入事实区,模型推测和用户猜测只能作为假设,已经被证伪或过期的信息要标记废弃。最终回答必须基于事实和证据。"
面试官问:怎么让 Agent 更适合生产环境?
可以这样答:
"生产环境要把 Agent 放在工程护栏里。包括任务边界、工具边界、执行限制、状态管理、权限控制、人工确认、审计日志和交付前检查。Agent 可以动态决策,但系统必须负责守门和回放。"
这套回答很实用。
因为它不是背 ReAct。
它讲的是工程可靠性。
8.第八步:Agent的记忆
短期、长期、RAG到底什么关系?
8.1.Agent 为什么需要记忆
普通问答系统,不一定需要复杂记忆。 用户问一句,模型答一句,对话就此结束。
但 Agent 完全不一样📌。
Agent 的核心场景是多步串行任务。
比如用户说:"帮我分析这个项目的技术债,然后按优先级给修复建议。
" Agent 需要依次执行:先看项目目录 → 再看核心模块 → 定位复杂函数 → 评估测试覆盖度 → 最后汇总输出优先级建议。
在整个任务链路里,它必须持续记住这些信息:
✅ 用户最初的核心目标是什么
✅ 已经扫描过哪些目录
✅ 哪些文件存在代码问题
✅ 有哪些证据支撑当前判断
✅ 哪些工具调用步骤执行失败
✅ 哪些推论仅仅是临时假设
如果缺少记忆能力,Agent 就会边执行边遗忘。 前面刚获取的关键证据,后面直接丢失;已经失败的工具调用,重复重试;用户提前强调的约束条件,中途直接忽略。 这就是很多自研 Agent 表现 "不稳定、前后矛盾" 的根源之一。 不是模型推理能力不足,而是缺少一套可管理、结构化的任务记忆系统。
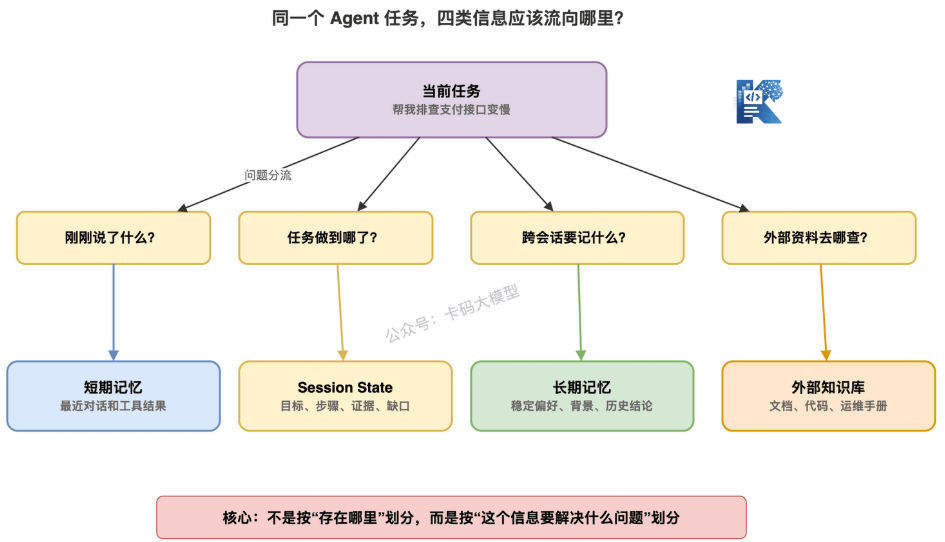
8.2.Agent 记忆至少分四类
聊 Agent 记忆,不要一上来就直接抛出向量数据库。 优先按照业务用途划分,工程上最实用的是四类:短期记忆、Session State、长期记忆、外部知识库,各自解决完全不同的问题。
- 短期记忆:当前对话里刚发生了什么💬
短期记忆本质就是当前会话的上下文窗口。 包含最近几轮对话、最近的工具调用记录、工具返回结果。 特点: 🔸 生命周期很短,绑定当前会话 🔸 和正在执行的任务强相关 🔸 存储在 LLM 上下文窗口内 🔸 会受窗口最大长度限制
举个例子:用户前面提到 "我的项目是 Java 后端,主要用 Spring Boot",后续再问简历项目优化,模型需要复用这句话,这就是短期记忆在发挥作用。
- Session State:当前任务进行到哪一步
📊 Session State 不等同于聊天原文,它是结构化任务状态,也是多步 Agent 的核心。 示例:
{
  "goal": "分析仓库技术债",
  "completed_steps": ["读取目录结构", "定位核心模块"],
  "failed_steps": [
    {
      "step": "读取测试覆盖报告",
      "reason": "文件不存在"
    }
  ],
  "evidence": ["core/payment/PayService.java 方法过长"],
  "missing_info": ["缺少测试覆盖率数据"]
}
它不会把整段对话堆砌进去,而是专门记录任务进度。 做多步任务时,Agent 最容易犯的错误就是中途提前总结、提前交付。 Session State 可以持续提醒 Agent:哪些步骤已完成、哪些证据已收集、信息缺口在哪里、当前阶段是否可以输出最终结论。
- 长期记忆:跨会话保留的稳定信息
⏳ 长期记忆可以跨会话持久保存,用户再次发起对话时可以复用。
分为两类:
👉 用户偏好:用户主要写 Java、正在准备秋招、简历希望突出项目难点、讨厌过于书面化的表达。 👉 业务侧长期状态:客户优先级、项目常用排查入口、团队代码规范。
长期记忆的特点: 🔸 不需要每次对话都加载 🔸 写入前必须经过筛选校验 🔸 支持更新、降级、遗忘 🔸 临时信息不能直接当作长期事实
长期记忆最大的工程坑:不加过滤,把所有聊天全部存入。最后存储的不是记忆,而是杂乱无章的信息垃圾堆🗑️。
- 外部知识库:Agent 可以检索的资料
📖 外部知识库一般依靠 RAG 实现。
内容包括:公司文档、API 手册、产品文档、代码仓库、面试题库、运维手册。
⚠️ 它不属于 "用户记忆",而是独立的外部知识源。 Agent 在需要的时候检索相关片段,再把检索结果送入上下文。
简单区分: ✅ RAG = Agent 的外部资料库
✅ 长期记忆 = Agent 沉淀的用户画像、历史任务经验
8.3.短期记忆
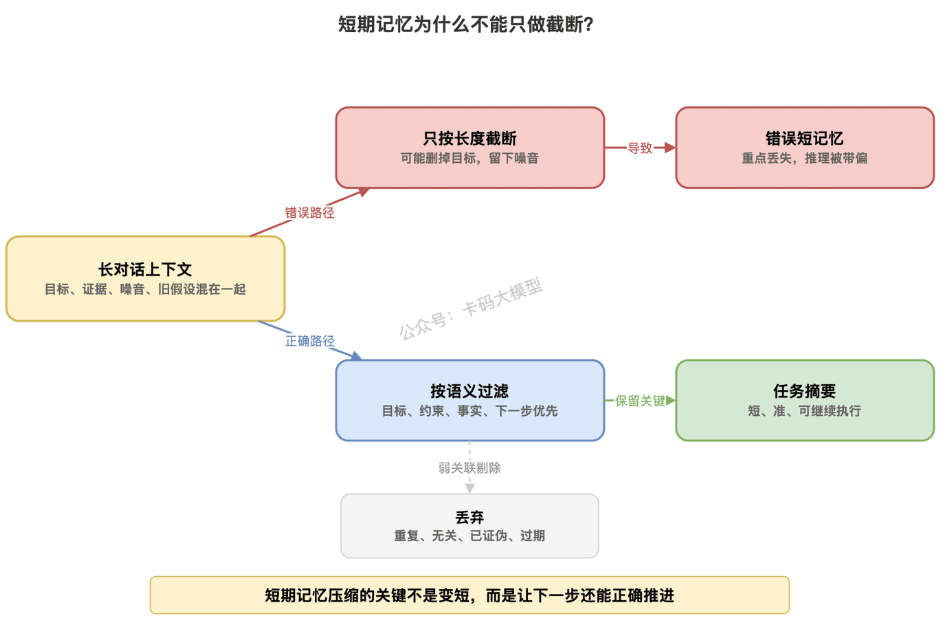
很多人存在误区:上下文窗口越大,短期记忆越强。 这句话只对一半。 更大的上下文窗口,确实可以容纳更多历史内容,但内容越多不等于效果越好。 上下文里混杂大量噪声: 用户临时猜想、工具返回的无关日志、已经证伪的推断、过期中间结论、重复对话内容。 全部塞进窗口,反而会干扰模型判断,也就是上一篇提到的上下文污染。窗口越长,污染风险越高。
所以短期记忆要做两件核心工作:
① 保留任务相关关键信息:目标、约束、工具返回结果、核心证据。
② 剔除无效信息:重复对话、无关日志、已经推翻的假设。
短期记忆不应该是完整聊天记录,而是精简后的当前任务摘要。
举个场景:用户让 Agent 排查接口变慢问题。
原始对话很长:用户猜测数据库问题 → Agent 查询数据库,排除问题 → 检索发布记录,发现 22:05 上线新版本 → 查看日志,定位第三方回调超时。 短期记忆只需要保留精简摘要:
目标:定位接口变慢原因。数据库方向已排除。22:05 发布新版本。22:10 后第三方回调超时增多。下一步验证新版本是否引入回调重试逻辑。
远比全量对话塞入上下文高效。
8.4.Session State
Session State (会话状态)比聊天记录更适合多步任务🗂️
Agent 执行长任务,重点不是 "记住对话原文",而是记住任务推进状态,这正是 Session State 的价值。 故障排查 Agent 的状态样例:
{
  "goal": "定位支付接口变慢原因",
  "current_hypothesis": "第三方支付回调超时可能导致接口变慢",
  "confirmed_facts": [
    "22:10 后 /api/pay P95 从 300ms 升到 3.8s",
    "22:05 发布了 payment-service v2.3.1"
  ],
  "rejected_hypotheses": [
    "数据库慢查询导致接口变慢"
  ],
  "next_actions": [
    "检查 v2.3.1 是否改动回调重试逻辑",
    "查询第三方支付回调错误码分布"
  ]
}
结构化信息分成目标、假设、已确认事实、已排除猜想、下一步动作。 Agent 每一步都对照状态推进,不需要模型在海量聊天文本里自行寻找重点。
生产环境的 Agent,几乎都依赖状态管理。 一旦任务超过 3~5 步,仅靠原始对话缓存(conversation buffer)极易跑偏。 典型场景:故障排查、代码库分析、长文档总结、数据分析报告、多轮客服、简历与面试辅导。 长任务场景,结构化状态是刚需。
8.5.长期记忆
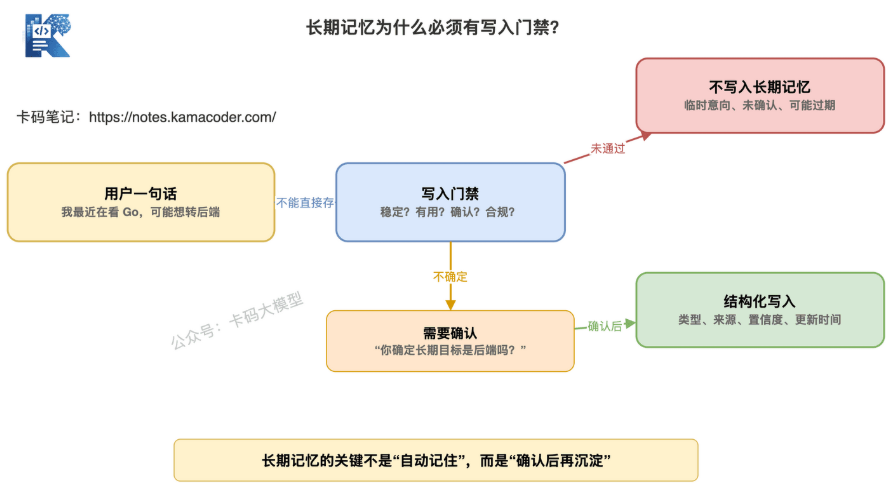
长期记忆听起来很美好:记住用户所有信息,下次对话如同老朋友。 但工程最大陷阱:把临时信息直接固化为长期事实。
举两个例子: 用户今天随口说 "我最近在看 Go",不一定代表长期方向,只是临时学习。 用户提到 "我可能想投后端",属于不稳定意向。 如果直接写入长期记忆:用户目标 = 后端开发,后续会持续误导 Agent。
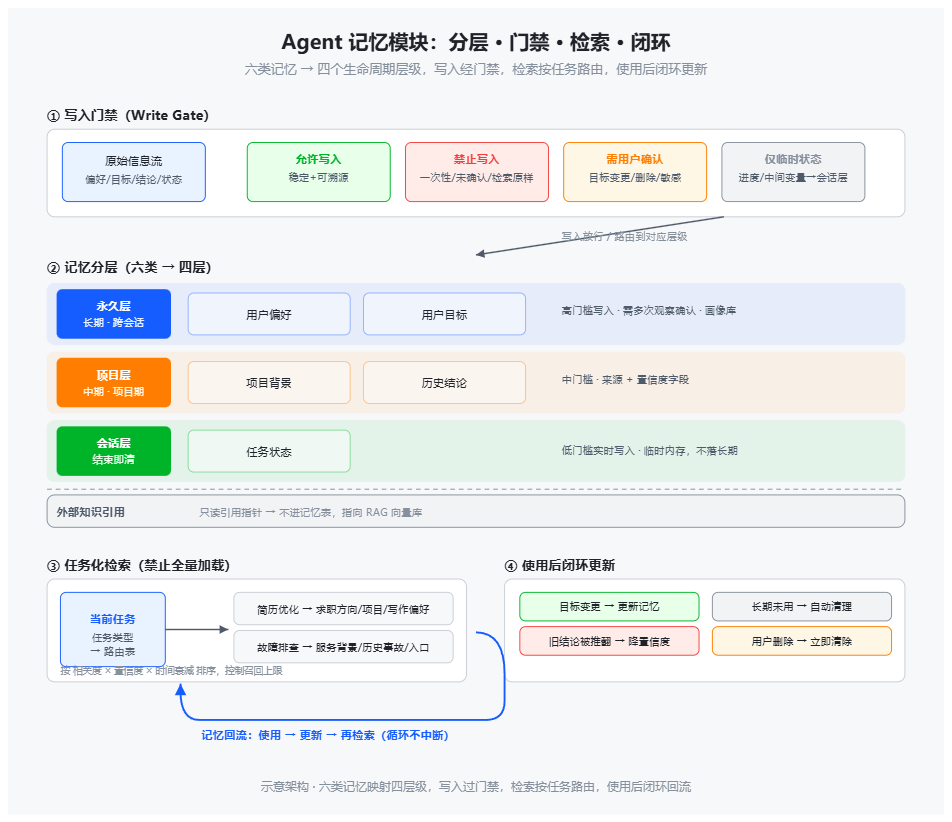
长期记忆写入前,必须校验 4 个问题✅:
- 信息是否具备长期稳定性?比如 "用户主要使用 Java" > "用户今天问了 Go 语言"
- 未来对话是否会复用这条信息?比如用户表达偏好有用;"晚上 9 点提问" 这种时间信息基本无用。
- 信息是否经过用户确认?用户明确陈述 > 模型自动猜测。
- 是否涉及隐私敏感数据?敏感信息存储需要权限、用途、删除机制。
长期记忆写入逻辑类似数据库写入,不是聊天自动追加。 必须配套写入规则、更新规则、删除规则,否则数据会快速脏化。
长期记忆怎么检索:不是全量塞回上下文🔍
存储完长期记忆,很多人会踩坑:每次对话,把用户全部历史记忆一次性塞进 Prompt。
❌ 绝对不可行,和塞入全部聊天记录是同一个问题。 长期记忆需要按需检索。
示例场景:用户要求优化简历项目。
需要召回的记忆:用户求职 Java 后端、正在校招、希望项目描述适配面试、已有 Redis 项目经历。 不需要召回:之前查询 MCP、C++ 智能指针、模型产品偏好这类无关记忆。
完整的长期记忆使用流程:
- 根据当前任务生成检索意图
- 从记忆库检索相关条目
- 过滤过期、低置信度记忆
- 仅将关键记忆送入上下文
- 本轮对话结束后按需更新记忆
它和 RAG 流程相似,但对象不同: 长期记忆检索:用户偏好、历史任务、稳定画像。 RAG 检索:外部文档、业务资料。
8.6.RAG
RAG 不是 Agent 的长期记忆❌
这个概念很容易混淆,面试高频考点。
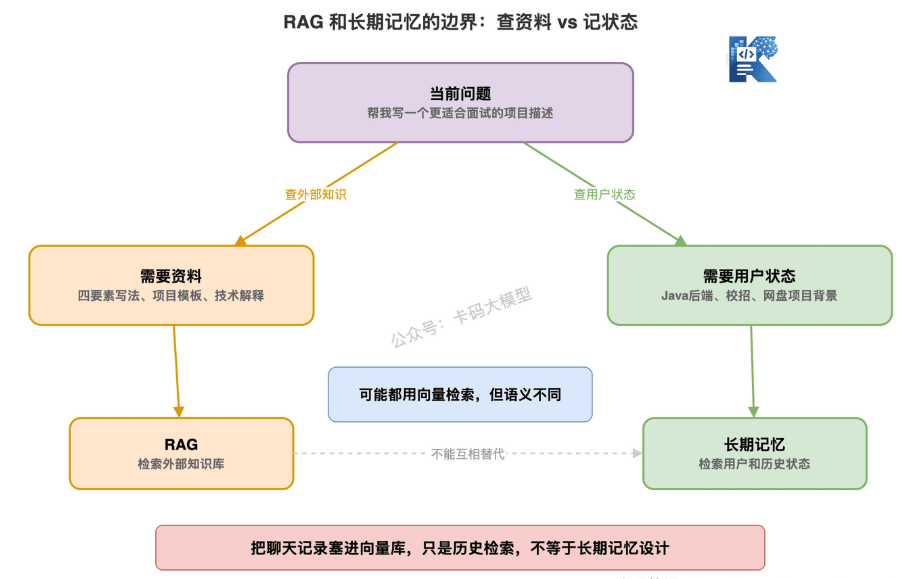
很多人会说:"我把聊天记录存入向量库,检索出来就是长期记忆。" 不完全正确❗ 向量数据库只是存储 + 检索载体,不等于记忆系统本身。 如果只是把原始聊天文本丢进向量库,检索出来的只是历史碎片,只能叫历史对话检索,并不是真正意义的长期记忆。
长期记忆需要提炼结构化信息。 原始对话:"我现在主要准备 Java 后端,项目是一个网盘系统,希望简历不要写得太像流水账。" 存入长期记忆的结构化记录:
{
  "type": "user_profile",
  "content": "用户主要准备 Java 后端方向",
  "confidence": 0.95,
  "source": "用户明确表达",
  "updated_at": "2026-05-26"
}
而不是直接存储整段原文。
简单划分: ✅ RAG 承载外部知识库:公司文档、API 手册、代码库、运维文档。
✅ 长期记忆承载用户侧信息:用户偏好、求职目标、历史任务结论、确认过的项目背景、跨会话 Agent 状态。
面试表述技巧: 不要只说 "我们用向量数据库实现长期记忆",回答会显得很浅。 补充一句:向量数据库只是检索层。长期记忆还需要设计写入规则、记忆类型、置信度、更新时间、冲突处理和删除机制。,这才是工程视角的回答。
八、记忆也要会忘🗑️
记忆不是越多越好,Agent 必须具备遗忘能力。 不做遗忘机制,长期记忆会出现三类问题:
- 信息过期⏱️:用户去年准备 Java 后端,今年转向大模型开发,旧记忆继续生效就会给出错误建议。
- 信息冲突⚔️:用户之前意向投算法,后续明确转应用开发。新旧记忆冲突,不能全部喂给模型,需要更新旧记忆或者降低权重。
- 信息噪音📢:大量低价值记忆堆积,检索时召回大量无关内容。
遗忘机制需要包含:过期时间、置信度打分、更新时间、冲突合并、用户主动删除、低价值记忆自动清理。 记忆系统不是只进不出的仓库,而是一套持续迭代维护的状态系统。
九、Agent 记忆怎么设计更稳✅
落地项目设计 Agent 记忆,可以参考这套完整框架:
8.7.面试官可能会问
Agent 记忆现在面试也越来越容易被问。
尤其是你简历里写了"长期记忆""个性化 Agent""上下文管理",面试官一定会追。
面试官问:Agent 的短期记忆和长期记忆有什么区别?
可以这样答:
"短期记忆主要服务当前会话和当前任务,比如最近几轮对话、工具调用结果、当前任务摘要,通常受上下文窗口限制;
长期记忆是跨会话保留的稳定信息,比如用户偏好、长期目标、项目背景和历史结论。长期记忆不能直接把所有聊天都存起来,需要经过筛选、结构化、更新和遗忘。"
面试官问:Session State 和聊天记录有什么区别?
可以这样答:
"聊天记录是原始对话,噪音比较多;
Session State 是结构化任务状态,记录目标、已完成步骤、失败步骤、证据、假设和下一步动作。Agent 做多步任务时,Session State 比单纯 conversation buffer 更可靠,因为它能防止任务中断、重复调用和提前交付。"
面试官问:RAG 和长期记忆是什么关系?
可以这样答:
"RAG 通常用于检索外部知识,比如文档、代码、知识库;
长期记忆用于保存用户偏好、历史任务和稳定状态。
它们都可能用向量检索,但语义不一样。向量数据库只是存储和检索方式,不等于长期记忆本身。长期记忆还要设计写入规则、置信度、更新时间、冲突处理和删除机制。"
面试官问:长期记忆怎么防止变脏?
可以这样答:
"不能把所有对话自动写入长期记忆。写入前要判断信息是否稳定、是否有用、是否被用户确认、是否合规。记忆条目要有类型、来源、置信度、更新时间。新信息和旧信息冲突时,要更新或降权旧记忆,过期和低价值记忆要清理。"
这套回答基本够用了。