本文不是功能介绍,也不是教程搬运,而是一次完整的 Vibecoding 实战复盘------一个人 + AI,从产品想法到生产环境部署,中间经历了微信审核被拒、色号数据造假危机、素材库三次推倒重来。AI 做得漂亮的地方、犯的错、以及"人类侧"到底该干什么,全部摊开来讲。文末有我沉淀的四步工作流和五条心得,建议先收藏。
一、先看结果:一个人 + AI 交付了什么
先上数字,说话才有底气:
| 交付物 | 规模 |
|---|---|
| 微信小程序(原生) | 22 个页面、16 个工具模块,约 1.7 万行 |
| 内容生产线脚本(JS + Python) | 46 个脚本,约 1.4 万行 |
| 生产环境素材库 | 18,440 张程序化生成的原创像素图纸 |
| 真实色卡数据 | 10 家厂商、1,289 个真实色号(MARD / Artkal / Hama / COCO...) |
| 配套后端 | Spring Boot + MySQL + Redis,Docker 部署在云服务器 |
全部代码由我描述需求、AI 编写,我负责验证、拍板和部署。放到两年前,这是一个小团队至少几个月的活。
项目叫「拼豆图纸乐园」------拼豆(Perler Beads)手工辅助小程序。如果你不知道拼豆是什么:把小塑料珠按图纸摆到钉板上,熨斗一烫成型,是近两年很火的手工品类。
二、这个小程序是干嘛的
一句话:拼豆爱好者的"制图工具 + 素材乐园"。核心能力:
- 图片转图纸:拍照/选图 → Lab 色彩空间 + k-means 限色 → 匹配真实厂商色号 → 生成可编辑的拼豆图纸,附带用料清单(颗数、克重、包数换算)
- 图纸编辑器:canvas 手势画板,画笔/填充/直线/矩形/圆形/取色/橡皮 8 种工具,双指缩放平移,5~60 格画布
- 素材库:18,440 张原创图纸,11 个系列,每日新图轮换、绝版图机制
- 摆豆追踪器:边拼边标记进度,剩余色统计、计时、退出续摆
- 留存体系:签到、成就徽章 19 枚、7 级等级、每周主题挑战
- 图纸码互赠:作品编码成短字符串,好友粘贴即导入------纯点对点,绕开 UGC 审核
架构上有几个设计决策值得说一下:
- 个人主体可过审:无 UGC、无社区、无付费,所有用户数据仅存本机(云同步走自建后端 KV)。这是产品层面的"合规先行",后面拒审故事会印证它的重要性。
- 三层内容通道 :内置
data/兜底 → 自建后端 API → 微信云开发(只读),远端优先、同 id 去重。断网有内容,远端可热更新。 - 本地优先存储 :
storage.set()是唯一写出口,全部业务数据先落本机,后台静默同步到服务端------页面代码对此零感知。
实际界面
体验地址:
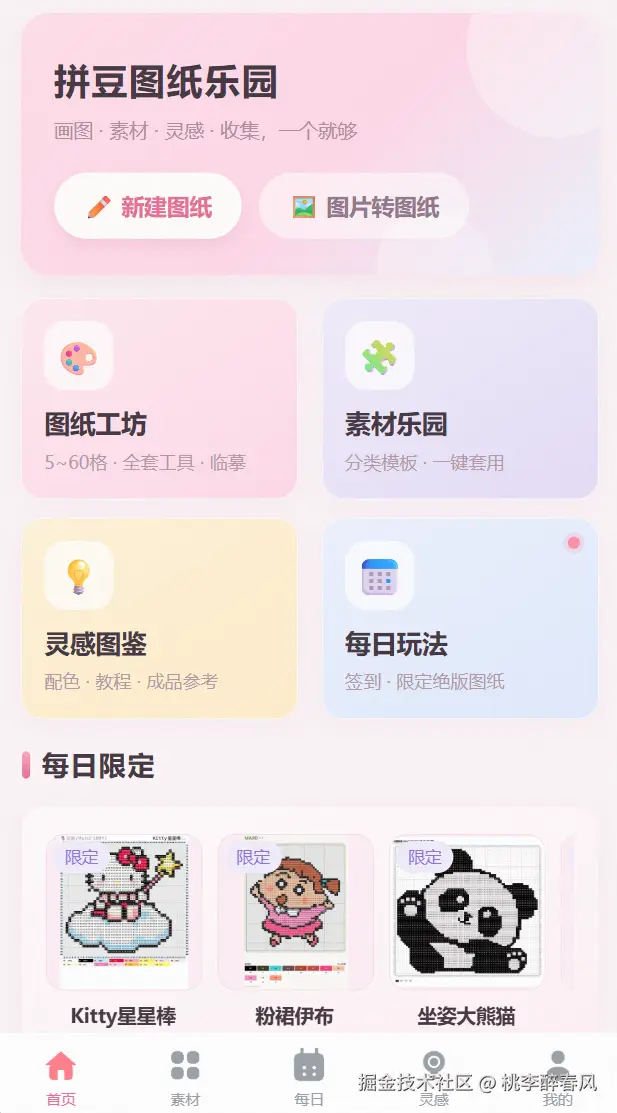
五个一级页面长这样:
首页------每日限定图纸与各模块入口聚合:
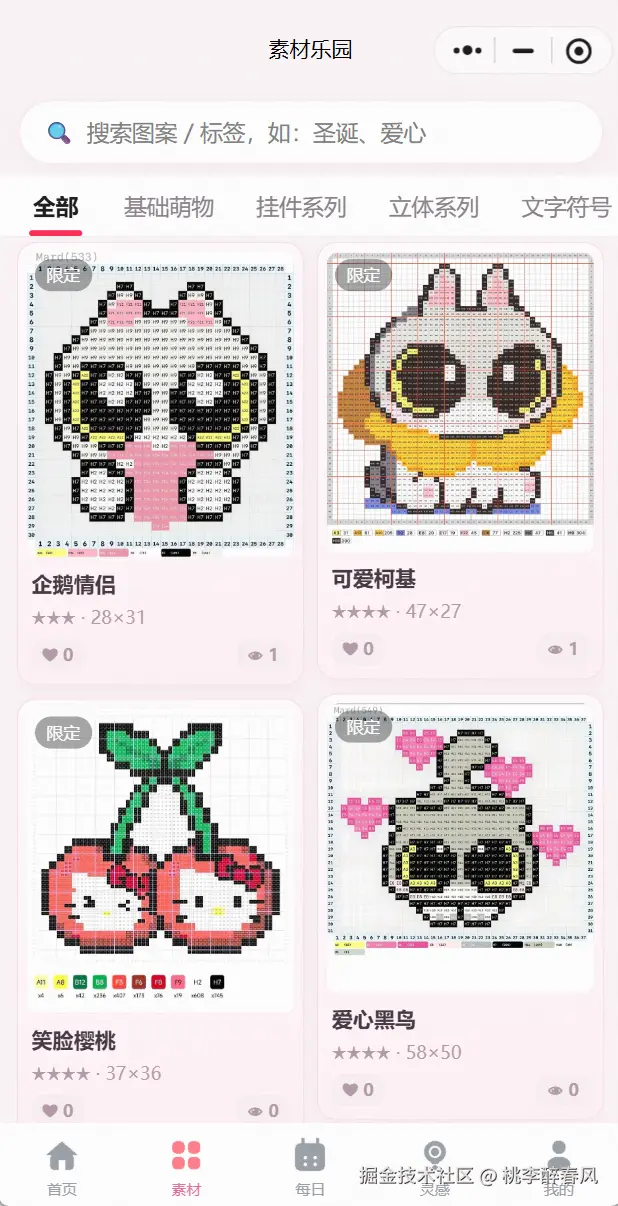
素材乐园------18,440 张图纸按分类瀑布流展示,支持搜索、收藏、待做清单:
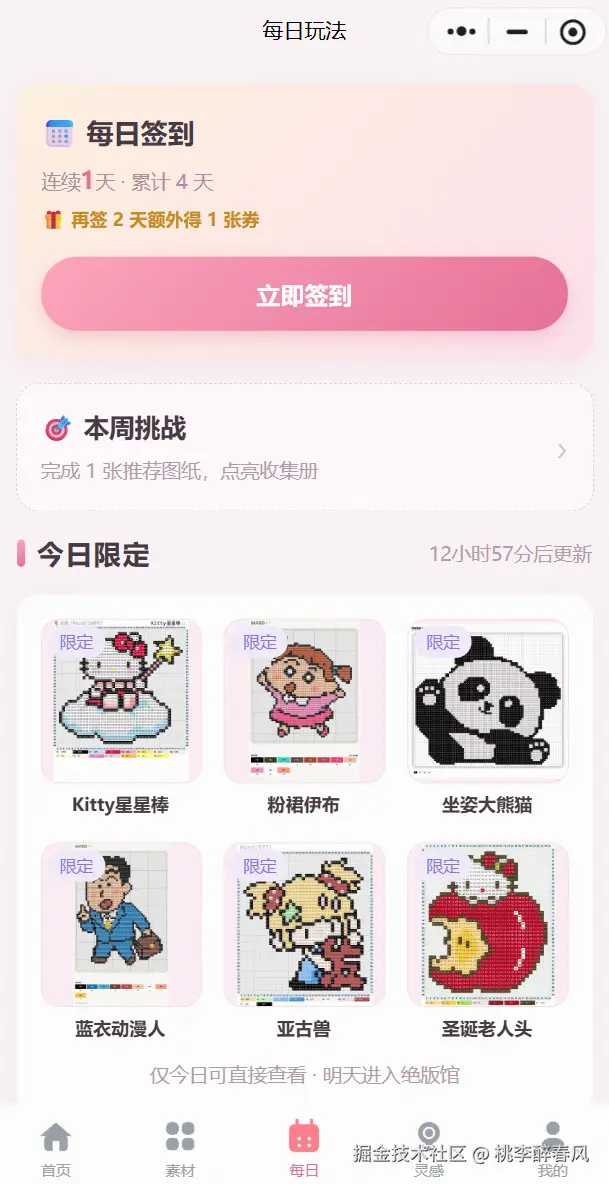
每日玩法------签到送券、今日限定轮换、绝版图纸馆、每周挑战:
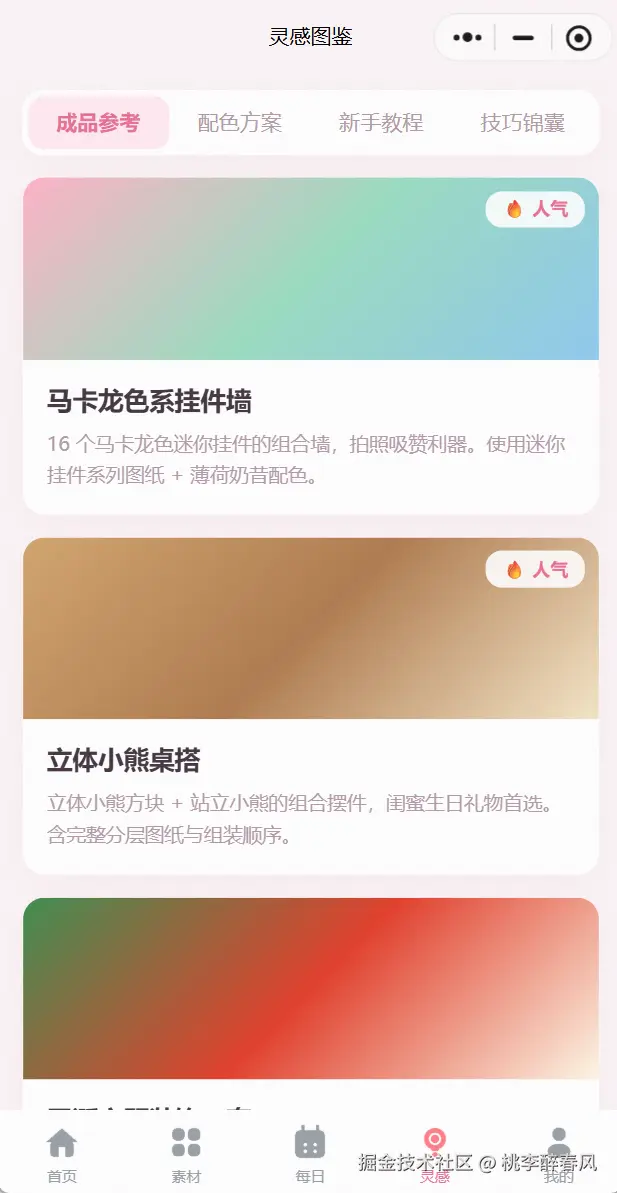
灵感图鉴------成品参考、20 套配色方案、新手图文教程:
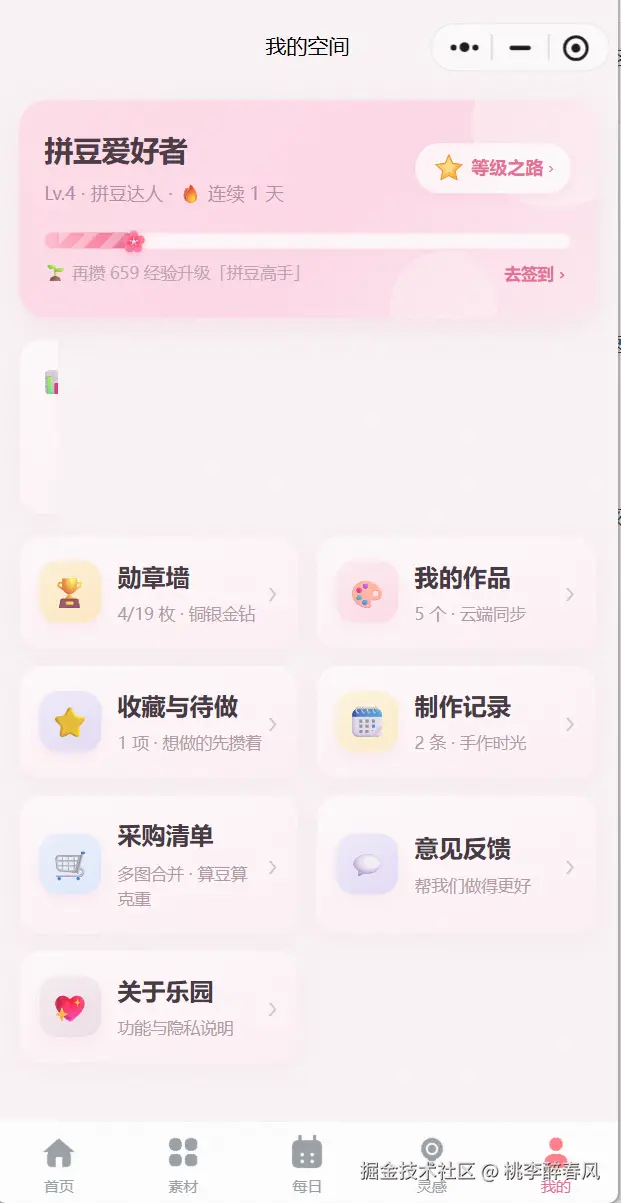
我的空间------作品库云同步、成就徽章墙、多图合并采购清单:
三、技术亮点拆解(代码级)
CSDN 老规矩,上代码。挑四个最有含金量的点。
亮点 1:图片转拼豆图纸------CIELab + k-means 两段式限色
这是整个产品的技术核心:把一张照片变成"每一格都是真实可购买色号"的拼豆图纸。难点在于:直接把像素吸附到最近的色卡色,色彩数会爆炸 (几十上百种,用户没法买);直接量化又容易丢掉小面积关键色(比如红眼珠黑瞳孔)。
解法是两段式:
第一段:k-means 聚出图像主色结构(8/12/16/24/32 档可选)
第二段:把每个聚类中心吸附到最近的色卡色,得到"允许色集合"
第三段:逐格在允许色集合内做最近邻匹配
而且颜色匹配不在 RGB 空间做,在 CIELab 感知色彩空间做(比 RGB 更符合人眼感知),距离函数还对色度做了加权------肤色和渐变的还原明显更好:
// Lab 距离(对色度误差稍加权,肤色/渐变还原更准)
function labDist2(a, b) {
const dl = a[0] - b[0], da = a[1] - b[1], db = a[2] - b[2];
return dl * dl + da * da * 1.6 + db * db * 0.9;
}
// 两段式限色:先聚类保结构,再吸附色卡限色数
let allowed = null; // null = 全色卡;否则为允许的色卡下标集合
if (o.maxColors > 0 && opaque.length) {
const centers = kmeans(opaque, o.maxColors, 8);
const set = new Set();
for (const c of centers) {
let best = 0, bd = Infinity;
for (let i = 0; i < palLab.length; i++) {
const d = labDist2(c, palLab[i]);
if (d < bd) { bd = d; best = i; }
}
set.add(best);
}
if (set.size) allowed = set;
}
// 之后逐格只在 allowed 集合内做最近邻匹配
再叠加一个 despeckle 降噪:孤立异色像素(四邻域零同色票)并入邻居中 ≥3 票的多数色------去掉噪点的同时不会误伤真正的细节。整套算法纯本地、确定性、无 AI 调用,58KB 的模块跑在千元机上毫无压力。
顺带一提:合规文档里明确声明"图片转点阵为本地确定性算法",这也是过审话术的一部分。
亮点 2:零侵入的本地优先云同步引擎
小程序的云同步最常见的写法是每个页面存取都走网络,代码侵入大、弱网体验差。这个项目的做法是把同步做成存储层的旁路:
/**
* 云同步引擎:小程序全部本地数据 <-> 后端 t_user_kv
* 策略:本地优先 + 后台双向同步
* - storage.set() 即标脏,防抖 1.5s 后 PUT 到数据库(失败自动重排重试)
* - 启动登录后 GET 全量回填本地,本地有而服务端没有的键推上去
* - 页面代码零改动(storage.js 的 set() 是唯一写出口)
*/
function markDirty(key) {
if (!CONFIG.API.ENABLED || !hydrated) return;
pending[key] = true;
if (timer) clearTimeout(timer);
timer = setTimeout(flush, DEBOUNCE_MS); // 防抖 1.5s
}
function flush() {
const keys = Object.keys(pending);
pending = {};
keys.forEach(key => {
let value = null;
try { value = wx.getStorageSync(key); } catch (e) { }
api.request('/api/user/kv/' + key, { method: 'PUT', data: { value }, silent: true })
.catch(() => { pending[key] = true; }); // 失败重排,下次触发继续推
});
}
三个细节:防抖合并 高频写入、失败重排 保证最终一致、启动回填完成前不推送(避免旧数据覆盖云端)。22 个页面的业务代码一行都不用改,就获得了多端同步能力。
亮点 3:1.8 万张素材不是靠人画,是"素材工厂"量产的
素材库背后是一条程序化生成流水线:
- 种子随机 + 光影引擎:任意基础形状自动叠亮部/暗部/环境过渡三层着色,同一只猫能生成一百只不重样的橘猫
- 零件库组合生成 :
pix-parts.js零件库 + 十余个生成器(gen-500 / gen-10k / mega / titan...),titan 档每分类 2000 张、≥30 色 - MD5 内容去重:与现库 14,471 个哈希比对,杜绝重复素材
- dry-run 铁律 :所有生成器支持干跑模式,先出统计(数量/唯一性/色数分布/分类占比),人确认后再
--push分块推生产库
这条流水线本身,也是 AI 在开发过程中"自己长出来的"------这正是 Vibecoding 复利的最佳注脚。
亮点 4:小而美的工程细节
- 图纸码互赠:RLE 行程压缩把一张图纸编码成短字符串,走剪贴板点对点传输------不需要服务器中转,也就不构成 UGC
- iOS canvas 4096 上限降档:200×200 图纸超清导出会超 iOS 画布限制,自动降档
- 缩略图离屏渲染 + LRU 缓存:本地图纸用离屏 canvas 渲染成临时图片,LRU 上限 150 张,长列表滚动不卡
- Python 高配版提取管线 :
extract_pattern.py(1054 行)能从一张成品照片反推点阵图纸------多角度自相关去斜、网格相位折叠、链式走线、逐格置信度。给一张别人晒的成品图,它能吐回可编辑的图纸
四、Vibecoding 实战:三个惊险故事
技术亮点是 AI 写的,但真正值钱的是这三个故事------每个都是 AI 和我"协作边界"的一次校准。
故事 1:微信拒审,根因让所有人大跌眼镜
第一次提审被拒:『选择图片』功能需接入内容安全 API。
诡异的是,后端的 imgSecCheck 接口早就写好了 。让 AI 排查,真正的根因链是:前端页面调用了 api.secCheckImage(),但文件顶部忘了 require('../../utils/api')------选图回调直接抛 ReferenceError,内容安全检测代码从未执行过。更早的构建里甚至还有第二层问题:部署到服务器的 jar 包根本没包含 seccheck 模块(源码有、构建产物没有)。
教训:一条功能链路 = 前端调用 + 传输 + 后端接口 + 构建产物 + 部署,任何一环断掉,表现都是"功能不存在"。AI 沿链路逐环验证的能力比人强------它真的会去解包线上 jar 数里面的 class------前提是你要它"验证链路",而不是"看看代码"。
这次事故还催生了一个工具:scan-requires.js,全项目静态扫描"用了某模块但没 require",把运行时才炸的坑变成 CI 级检查。每次事故沉淀一个工具,是 Vibecoding 的正确姿势。
顺带一个冷知识:未发布过线上版本的小程序调内容安全接口必然返回 HTTP 412,这是微信官方预期行为,发布后自动恢复。这种知识人是搜不到的,AI 结合社区经验直接给出了结论和提审备注话术。
故事 2:AI 拒绝编造 1,289 个色号------它的诚实边界
对照竞品补功能时发现:我们的色号和真实厂商对不上。翻开内置数据,文件头注释写着:⚠️ 以下 code 仅为占位编号,并非品牌官方色号。
这时 AI 面临一个选择:编 1,289 个色号(反正长得像就行),还是想办法搞真的?
它做对了:拒绝编造。因为用户会照着色号去买豆子,编错就是事故。它的实际做法是去竞品网站扒前端,找到对方调用的公开色卡 API,抓取了 10 家厂商的真实"色号-色名-色值"全表,并写了一个可复跑的构建脚本重建数据文件。过程中还顺带修了一个潜伏 bug:后端校验色值 ≤300,而 COCO 色卡有 329 色------旧校验逻辑下,新色卡作品的云同步会静默失败。
Vibecoding 里 AI 的"我不知道"和"我编一个"的边界,要靠你在关键数据上明确划出来。 你不划,它有时候真的会编。
故事 3:杯垫只生成出 28/1300 张------确定性与去重的哲学矛盾
扩素材库时遇到灵异事件:生成 6 个新系列,其他系列都正常,杯垫纹样只出 28/1300。
AI 第一轮信誓旦旦地报告"生成完成 1300 条",dry-run 一看只有 28 条。第二轮才定位到根因:杯垫是结构性图案------同尺寸同纹样,布局完全确定,生成一百次都是同一张图,全被 MD5 内容去重杀了。
解法很优雅:把图案里的颜色位随机化,每次尝试产生不同的配色布局,既保留"杯垫"的结构特征,又能通过去重。
dry-run 统计是生成类任务的生命线:数量、唯一性、色数分布、分类占比,四个数字一眼看穿问题,比看 100 张预览图都快。AI 说"完成"只是假设,统计数字才是事实。
五、AI 犯过的五个错(本文最值钱的部分)
- bash 内联脚本转义坑 :
node -e "..."里的正则\b被 shell 吃成退格符,导致一次全项目扫描静默地全部通过(假的"全部正常"最危险)。后来的规矩:超过三行的脚本一律写文件再跑。 - 字母表冲突 :素材生成器的调色字母用了
A...L,其中K和轮廓色字符K撞名,主题色把黑色轮廓覆盖了------所有角色的眼睛不是黑的。肉眼发现,一行修复。这类跨模块约定冲突,AI 单点检查很难发现。 - iOS canvas 4096 上限:这个反而是 AI 主动加的降档保护。平台限制类的知识,AI 比多数人熟,要主动问它"各平台有什么坑"。
- 坐标系混用 :
e.detail.x(页面坐标)减缓存的 rect(视口坐标),页面一滚动点击就偏移。修法是点击时实时查询画布位置。这类"环境性 bug"模式固定,AI 修起来很在行。 - 它会顺着你说 :你说"水印写拼豆制图坊",它就写"拼豆制图坊",哪怕小程序明明叫"拼豆图纸乐园"。关键名词、品牌、数字,永远要自己再读一遍。
六、我沉淀的 Vibecoding 工作流
四步循环
- 需求写成验收标准:不说"加个导出功能",说"导出图片底部展示色号和用豆数,像 beanpindou.com 那样;水印放右下角不压格子;文案引导搜索小程序名"。具体参照物 + 位置 + 约束,直接决定一次成型的质量。
- 让 AI 沉淀工具 :重复任务变成仓库里的幂等脚本(scan-requires、build-palettes、gen-10k、SSH 隧道数据库工具)。Vibecoding 的复利不在对话里,在仓库里。
- 干跑 + 统计 + 真机,验证铁三角:AI 没有手指,点不了小程序;AI 会说"已推送",但要看接口返回和 SQL 统计;破坏性操作前强制备份------AI 提出 DELETE 之前,我要求先 SELECT 出备份文件。
- 决策与执行分离 :做不做 UGC(类目资质风险)、IP 素材删不删(版权风险)、色号能不能编(用户真金白银买豆)------AI 给分析,判断和承担后果的是我。决策定了,AI 一条 SQL 干净利落地执行。
五条心得(可直接抄走)
- 需求写成验收标准:位置、参照物、约束条件,一次说清,省三轮对话
- 让 AI 沉淀工具:重复任务变成仓库里的幂等脚本,复利惊人
- 干跑 + 统计 + 真机是验证铁三角:AI 的"完成"只是假设,数据才是事实
- 破坏性操作人类守门:备份先行、影响面说清、可回滚才执行
- 决策与执行分离:方向、风险、数据真实性人管;实现、排查、批量操作交给 AI
七、写在最后
一个人做一款有后端、有数据库、过审核、跑在生产环境上的小程序,在过去是一个小团队的活。Vibecoding 不是"让 AI 写代码你就不用懂",而是你负责判断和验收,AI 负责一切确定性的执行------这个分工下,个人能做的事情半径被放大了一个数量级。
文中提到的每个功能点------两段式限色、图纸码互赠、摆豆追踪、采购清单------都是线上真实可用的版本,不是 demo 截图。想实际跑一下验证的同学,微信搜「拼豆图纸乐园」,或者扫下面这个码:
这个项目还在继续长:相似色智能合并、图纸合并、圆形/六边形画板都在排期。欢迎评论区交流你的 Vibecoding 实战心得------特别是你被 AI 坑过的那些瞬间,那是全网最稀缺的素材。