2026年9月17日,华为在上海发布全新计算架构Peerium,该架构设计的核心目标只有一个:让百万颗处理器成为一台计算机。10月6日,华为轮值董事长徐直军与海思首席科学家廖恒博士就这一架构与媒体进行了圆桌交流,首次披露了大量技术细节和决策逻辑。这可能是近年来AI基础设施领域最值得深入理解的一次架构级发布。
要理解Peerium的分量,先要看清楚AI集群今天到底卡在哪里。
一、AI算力增长的真正瓶颈,已经不是单芯片
过去十年,行业讨论AI算力,焦点几乎都落在单颗芯片上:制程、晶体管数、峰值算力。但大模型训练的现实其实是另一回事。一个万亿参数模型,权重和中间激活值分布在成千上万颗芯片上,每一次梯度同步都要跨节点搬运数据。模型规模越大,通信开销占比越高。有行业数据显示,跨节点通信开销已经占到部分大模型训练成本的三成以上。
与此同时,芯片算力与互联带宽的增长速度严重失衡。GPU算力每年提升2到3倍,内存带宽年增幅只有15%到30%。这意味着无论单芯片多强,集群越大,算力利用率反而越低,训练中断越频繁。
英伟达的NVL72方案是一个直观注脚。柜内互联带宽达到1.8TB/s,但一出柜就骤降到0.2TB/s。也就是说,机柜内部是一台高性能计算机,机柜之间却退回了普通网络。这种柜内柜外性能断崖,正是大规模集群难以扩展的根本原因。
华为Peerium架构要解决的,就是这个跨节点通信的结构性问题。
二、Peerium的三大支柱:嵌套并行、统一内存寻址、平等互联
华为官方对Peerium的定义是:基于嵌套并行、统一内存寻址、平等互联,实现百万级处理器强扩展的计算架构。
第一根支柱是嵌套并行。Peerium突破了传统图灵范式的串行执行模型,提出Nested BSP,即嵌套批量同步并行。传统BSP模型中,所有处理器本地计算后统一同步,逐层推进。Nested BSP把这种同步机制变成可嵌套、分层的结构,让不同规模的处理器组可以在不同层级并行推进,从而支撑从几百颗到上百万颗处理器的扩展。单颗芯片内部仍然遵循冯·诺依曼逻辑,Peerium的创新发生在系统级:用嵌套同步替代全局串行。
第二根支柱是统一内存寻址。百万级处理器共享一个统一的虚拟地址空间,数据不需要在不同节点间反复搬移,任何处理器可以直接访问全局内存。Atlas 950超节点提供256TB全局统一内存编址空间,这在实际产品中首次实现。
第三根支柱是平等互联。Peerium颠覆了长期沿用的主从架构。传统集群中,主节点负责调度,从节点被动执行,主节点成为性能和可靠性的单点瓶颈。Peerium让所有处理器地位对等,通过统一的互联机制协同工作。
三大支柱缺一不可,把它们串起来的,就是灵衢。
三、灵衢:为什么华为做的是"总线"而不是"网络"
灵衢,英文名UnifiedBus,是Peerium架构的关键互联技术。徐直军在圆桌交流中强调了一个容易被忽略的定位差异:UB做的是总线,不是Link。
网络领域惯用IP协议,时延高,适合尽力而为的传输。计算互联要求的是低时延、超高带宽、确定性传输。华为把灵衢放在计算部门而非网络部门开发,正是为了做出一个符合总线语义的统一协议。
灵衢基于开放协议,可无限扩展地连接CPU、NPU、内存、SSD、网卡和交换机,实现计算、存储、网络的平等互联。相比英伟达NVLink与InfiniBand双协议并行的路线,灵衢用单一协议覆盖Scale-up和Scale-out两个场景,数据包从scale-up网络传输到scale-out网络大约只需要150纳秒,而跨协议转换的开销是微秒级,差距在一个数量级以上。
廖恒博士的比喻很到位:英伟达的方案像一次旅行要换乘飞机、高铁、汽车,每次换乘都有损耗;灵衢是一张直达票,全程高速。
柜间带宽的对比更直观。NVL72柜内1.8TB/s、柜外0.2TB/s,而基于灵衢的Atlas 950柜间带宽最高800GB/s。英伟达最早想做NV256,最终落地的是72;华为910C超节点就做到了384卡,已交付一千多套。这种规模上的差异,本质是互联架构的差异。
灵衢2.0的技术指标此前已经公开:通信带宽提升15倍,单跳时延从2微秒降至200纳秒,降低10倍,支持长距离高可靠全光无损互联,全光Mesh拓扑让柜间带宽提升10倍。
四、Atlas 950:Peerium架构的首代产品
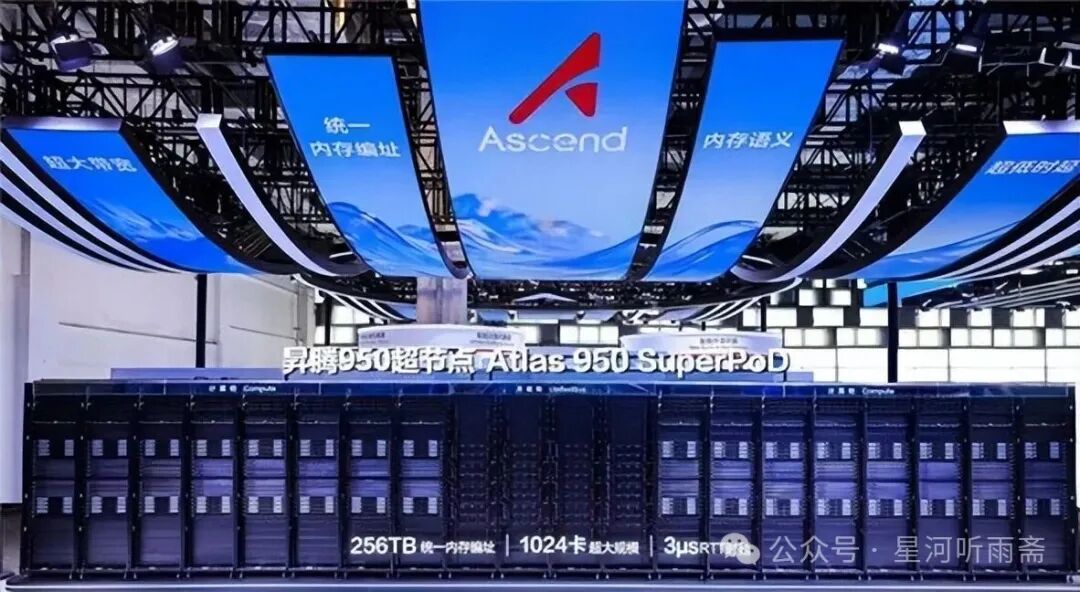
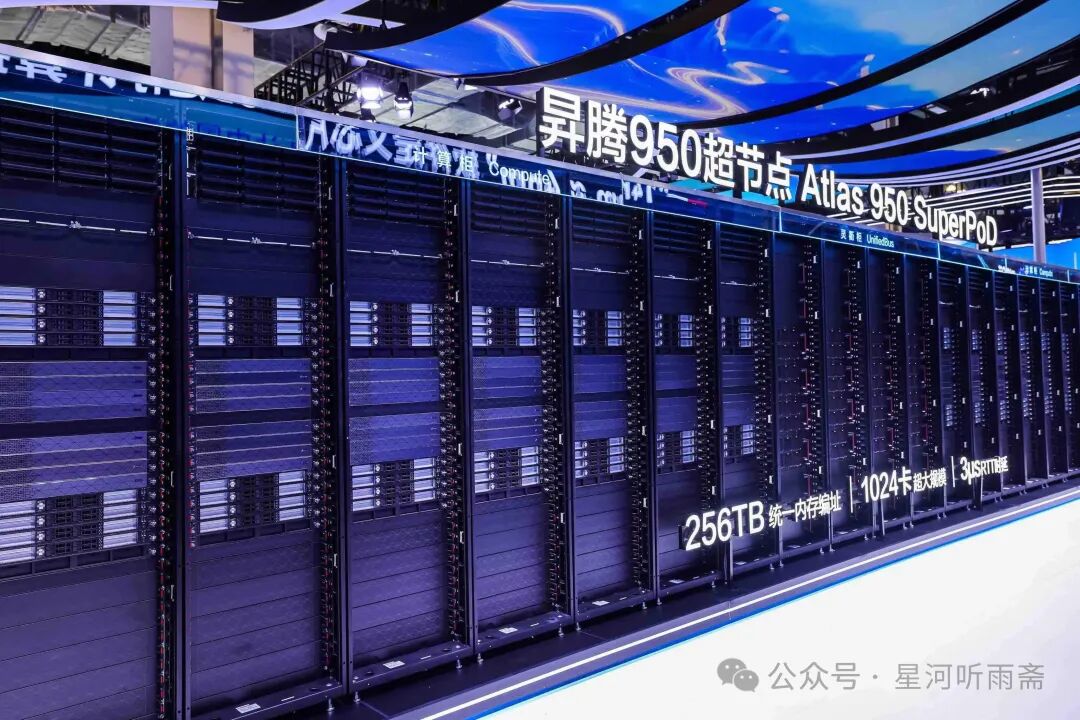
Atlas 950超节点是Peerium架构落地的第一款产品。几个关键数字:
单柜64张昇腾950DT芯片,FP8算力64 PFLOPS,FP4算力128 PFLOPS,内存9.2TB,功耗100kW。单Pod由16个计算柜加4个网络柜组成,共1024张卡,FP8总算力1 EFLOPS,FP4算力2 EFLOPS,256TB统一内存编址,RTT时延3微秒。
满配的Atlas 950超节点集群由128个计算柜、32个互联柜共160个机柜组成,占地面积约1000平方米,FP8算力达到8 EFLOPS,FP4算力16 EFLOPS,互联带宽16.3PB/s。
这些数字的意义不在于单点峰值,而在系统架构。1024张卡共享256TB统一内存,所有节点像一台计算机一样工作,这是此前业界没有做到的。
华为官方披露,25.6万卡的Atlas 950超节点集群已经在部署中。昇腾芯片路线图同步明确:2026年一季度昇腾950PR面向推理,四季度昇腾950DT面向训练,2028年四季度昇腾970。
值得注意的是,就在2026年9月17日华为全联接大会上,昇腾960超节点已经提前正式发布,比原路线图的2027年四季度大幅提前。Peerium架构的产品节奏明显在加速。
廖恒博士解释了25.6万卡规模为什么是必要的:目前前沿模型参数规模已达5万亿级别,未来两年中国预计出现6到7个前沿AI实验室,目标训练10万亿到40万亿参数的基础语言模型。训练这类模型需要的算力和内存规模,与25.6万卡超节点的容量大致匹配。
五、昇腾960超节点:全球首个NPO超节点
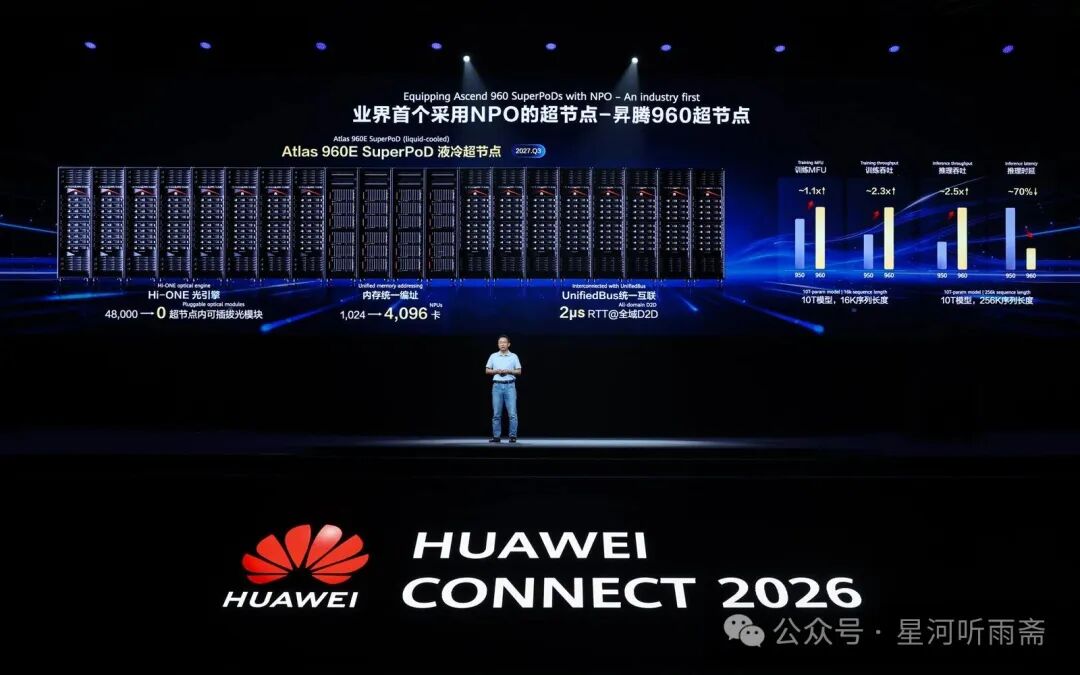
2026年9月17日,华为发布全球首个采用NPO技术的超节点昇腾960超节点(Atlas 960E SuperPod),这也是Peerium架构在950之后的最新落地形态。
昇腾960超节点采用领先的正交架构和全液冷设计,基于灵衢实现内存统一编址,可扩展至4096卡规模,实现8 EFLOPS FP8、16 EFLOPS FP4算力。其核心创新在光互联环节:用5500个Hi-ONE光引擎,替代原本需要的4万8千颗800G光模块,功耗降低超过550千瓦,系统无故障运行时间提升一倍,系统可用度达到99.8%。
多个昇腾960超节点采用灵衢网络或RoCE连接在一起,通过二层CLOS四平面组网,最大集群规模可达到51.2万卡,再结合多轨道拓扑技术,最大可支持100万卡昇腾超节点集群。
同期华为还将超节点架构引入通算系统,升级鲲鹏超节点,基于灵衢全光组网最大支持4096节点,形成256TB统一内存池。
昇腾960的发布说明华为的演进节奏明显加快:950超节点25.6万卡集群刚进入部署,960超节点即以NPO光互连的形态登场,把全光互联从超节点内部延伸到了更广的集群范围。
六、全光互联与Hi-ONE:光引擎距离主芯片只有5厘米
Peerium架构的互联能力,建立在光电技术积累之上。华为发布的Hi-ONE模组,基于NPO近封装光学技术,支持7.2T高带宽,光引擎距离主芯片仅约5厘米,中间只有一小段铜线电连接,基本实现了全光超节点。Hi-ONE还把光源直接封装进模组内部,实现内置光源,是业界首个量产的NPO产品,也是唯一实现内置光源的NPO产品。
徐直军预计,未来两到三年内,其他厂商很难做出同样的产品。廖恒博士补充了技术难度:光学技术涉及大量物理原理,温度稍微变化就会影响二极管特性、改变折射率、影响波导性能。目前大多数厂商选择外置光源路线,用单个光源馈送32路信号,功率必须放大32倍,在耦合接口等环节容易出问题。华为选择内置光源,是经过多次权衡后的工程方案。
全光互联最大的障碍是可靠性焦虑,因为光器件会发生故障。华为选择从5厘米距离的电光混合方案起步,逐步逼近全光,是一条务实的演进路径。昇腾960超节点用5500个Hi-ONE替代4.8万颗光模块,正是这条路径的规模验证:光互连不仅解决了带宽问题,还直接带来了系统可用度的提升。
七、软件生态:开放灵衢的深意
灵衢不只是硬件协议。华为去年发布灵衢2.0技术规范并宣布开放,至今应用使能套件、灵衢云化使能、灵衢系统高阶服务、操作系统灵衢组件、灵衢总线管理五个组件,已经在openEuler、openFuyao、鲲鹏社区全部开源开放,新增180多个API。
徐直军透露,去年开放灵衢协议后,最大的下载量来自硅谷。这从侧面说明,这套互联技术路线具有全球性的技术吸引力。
开放的意义在于生态共建。灵衢是一个开放协议,任何厂家都可以基于灵衢规范构建自己的算力基础设施。这与英伟达封闭的NVLink生态形成鲜明对比。在国产算力自主化的大背景下,开放的互联协议意味着产业链上下游可以围绕统一标准协同,而不是各自为战。
八、产业判断:算力竞争从单芯片转向系统架构
把Peerium、灵衢、Atlas 950、昇腾960放在一起看,华为的算力路线已经非常清晰:不追求单颗芯片在先进制程上的正面追赶,而是通过系统架构创新,把更多芯片高效率地组织起来,以整体系统能力弥补单点差距。
这一判断有现实基础。受制于先进工艺可获得性,国产AI芯片短期内难以依靠单颗芯片追上国际领先水平。但大模型训练的真正瓶颈已经从芯片算力转移到互联带宽、通信时延、内存共享机制和集群调度能力。后摩尔时代,系统架构创新成为比单点性能更有效的突围路径。
徐直军给出的另一个信号值得关注:目前昇腾满足国内市场需求还远远不足,没有全面拓展海外市场的计划。这意味着国产算力供给缺口仍然巨大,产业链扩产是未来几年的主线。
Peerium架构的意义,可以浓缩为一句话:AI集群的扩展,正在从"把更多机器连起来"变成"让百万颗处理器成为一台计算机"。嵌套并行解决同步效率,统一内存寻址解决数据搬运,平等互联解决主从瓶颈,灵衢用单一协议把这些能力串成整体。Atlas 950超节点证明这条路线已经走出实验室,25.6万卡集群进入部署阶段;昇腾960超节点以全球首个NPO超节点的身份登场,把全光互连从方案推向规模部署,也印证了华为超节点路线的演进速度在加快。
这场架构革命的最终效果,取决于三个变量:软件生态的成熟速度、产业链的扩产能力、以及全光互联的可靠性演进。无论结果如何,AI算力基础设施的竞争维度已经永久改变。
免责声明:本文基于公开渠道整理的产业与技术信息,仅用于行业研究与技术科普,不构成任何投资建议,亦不作为任何投资决策的参考依据。文中数据以各官方机构和企业正式发布口径为准。
星河听雨斋
每天一份高质量研报,持续聚焦芯片半导体、AI基础设施、AI智能硬件、具身智能、光通信等硬科技方面的行业研究、产业链分析与技术拆解。欢迎您的关注!