论文标题 :RSIAgent: Autonomous Exploration for Recursive Self-improvement in New Environments
代码 :https://github.com/AetherLabsAI/RSIAgent 项目主页 :https://aetherlabsai.github.io/RSIAgent/
"先广后深"策略(BFS+DFS),证明了仅靠记忆机制即可显著缩小开源与闭源模型差距
-
RSIAgent 是一个 不需要重新训练模型 的多智能体框架:它让 AI 智能体像人类学习新软件一样,先在新环境里"自主练习",把练习中验证过的经验写进一份持久化的"记忆"里,然后在真正做题时直接使用这份记忆。
-
实验显示,让开源模型(Kimi-K3、GLM-5.3)在两个权威基准上 超过 GPT-6 等顶级闭源模型 ,而模型参数本身一行都没有改动。
- 框架层面 :提出 curriculum--actor--verifier 三智能体递归循环,让智能体在无人工标注、无金标准奖励的情况下自主获取、验证、固化环境知识,全程不更新模型参数;
- 策略层面 :设计"先广后深"的两阶段探索------BRS 并行铺开建立广度认知,DRS 串行递进攻坚难点和边界条件,消融实验证明两者缺一不可;
- 实证层面 :让开源模型 Kimi-K3 / GLM-5.3 在 OSWorld-v2 和 Agents' Last Exam 上反超 GPT-6 Astra、Claude Opus 5 等闭源前沿模型,说明智能体层面的自我提升可以显著缩小甚至逆转开源与闭源模型之间的能力差距。
1. 研究背景:AI 智能体面对新环境的困境
现在的数字智能体(digital agent)已经能操作电脑:看屏幕、点鼠标、跑代码。但它们有一个明显的短板------ 预训练知识覆盖不了所有新环境 。
想象一个从未见过某款专业软件(比如 FreeCAD、REAPER 音频编辑器)的智能体。软件的界面布局、工具习惯用法、容易踩的坑,都不在它的训练数据里。传统的解决办法有两种,但都不理想:
- 收集数据再训练 :成本高,而且面对私有环境或不断变化的软件根本来不及训练;
- 简单的经验记忆 :只是记录"上次成功的操作轨迹",没有真正理解"为什么这个动作会导致这个结果"。
论文提出了一个关键问题:
智能体能不能完全自主地从一个新环境中发现因果关系(什么动作在什么条件下会导致什么结果),并把这些知识整理成可复用的记忆,从而让自己变强?
RSIAgent 就是对这个问题给出的肯定答案。它的核心观察是:人类学习新软件是一个递归循环------先想清楚要学什么,再动手尝试,最后从结果中总结知识;而且这个过程不只是积累经验,更是在做 因果发现(causal discovery) 。RSIAgent 把这套流程完整地搬到了 AI 智能体上。
2. 问题的形式化定义
在讲方法之前,先用数学语言把问题钉死。
一个数字智能体接收任务指令 qqq,在环境 E\mathcal{E}E 中执行一串动作 a1,...,aTa_1, \ldots, a_Ta1,...,aT 直到任务完成。在第 ttt 步,智能体 πθ\pi_\thetaπθ 根据任务 qqq、交互历史 ht=(o0,a1,...,at−1,ot−1)h_t = (o_0, a_1, \ldots, a_{t-1}, o_{t-1})ht=(o0,a1,...,at−1,ot−1) 和持久记忆 MMM 生成动作;环境执行动作后转移到新状态并返回新观察:
at∼πθ(⋅∣q,ht,M),(st,ot)∼E(⋅∣st−1,at).a_t \sim \pi_\theta(\cdot \mid q, h_t, M), \qquad(s_t, o_t) \sim \mathcal{E}(\cdot \mid s_{t-1}, a_t).at∼πθ(⋅∣q,ht,M),(st,ot)∼E(⋅∣st−1,at).
其中 sts_tst 是环境的底层状态(智能体未必能直接看到),oto_tot 是返回的观察。注意两个要点:
- 每换一个任务,交互历史 hth_tht 就清空重来;但 记忆 MMM 会一直保留 ,跨任务积累知识;
- 动作 ata_tat 采用 code-as-policy 的形式,即每个动作就是一段可执行的 Python/Bash 程序------这提供了控制各种异构软件的通用接口。
本文研究的问题 :在不更新模型参数 θ\thetaθ 的前提下,如何让智能体在新环境 E\mathcal{E}E 中自主探索,构建出一份捕捉环境知识的持久记忆 MMM,并在测试时直接复用这份记忆完成下游任务。
3. 整体框架:三个智能体的协作循环
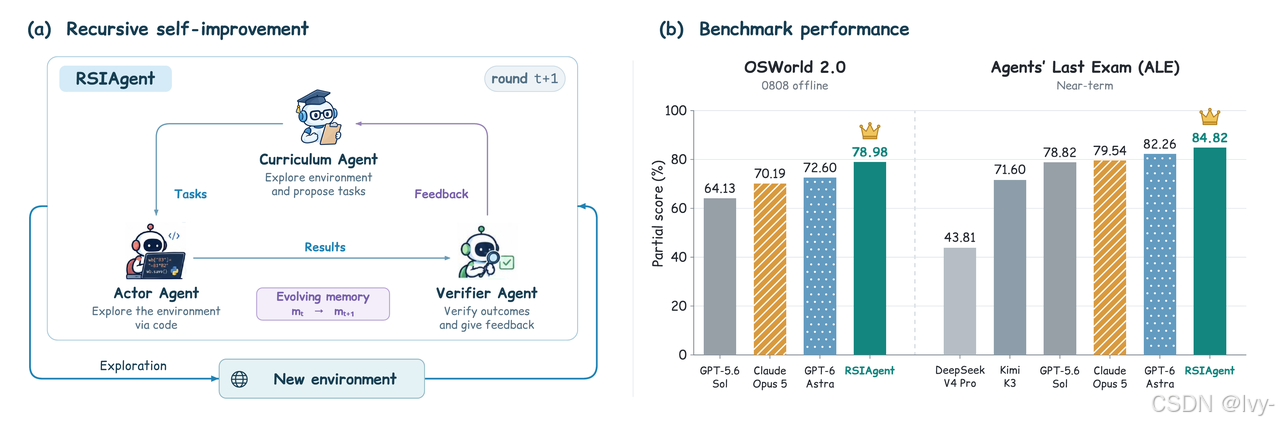
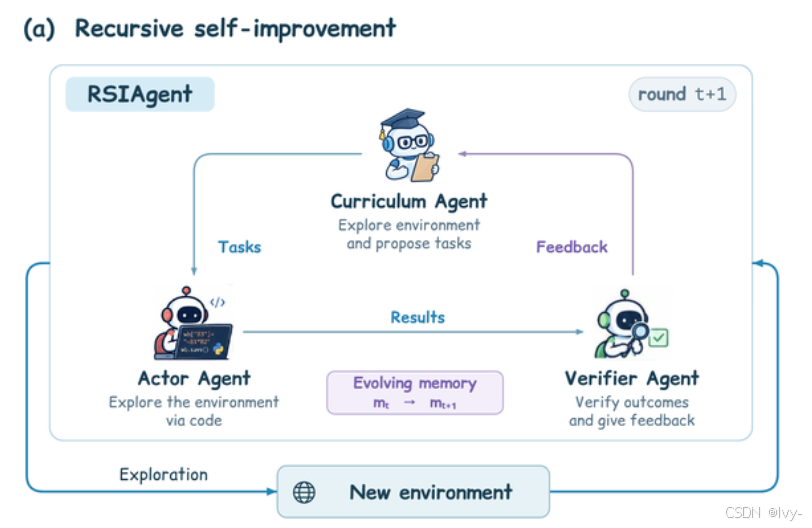
上图(a)展示了 RSIAgent 的整体循环。系统由三个分工明确的智能体角色组成,它们在一个递归循环中协作:
3.1 Actor Agent(演员智能体)------负责干活
这是系统的主力策略模型,负责理解环境、生成并执行代码动作。它配备了一份 可进化的持久记忆(evolvable memory) ,里面存着:
- 环境特有的知识(比如"这款软件的导出按钮藏在哪个菜单");
- 可复用的操作流程和脚本;
- 从过去失败中总结的教训。
每当验证器给出评判结果后,actor 会把经验"沉淀"进记忆:添加新知识、修正或删除过时信息。更新后的记忆会被后续的 actor 实例继承,知识就这样一轮轮积累起来。
3.2 Verifier Agent(验证智能体)------负责判卷
它是独立的"考官",负责判断 actor 的执行结果是否真的满足了任务要求。关键是:
- 它 直接检查环境反馈 (执行结果、界面状态等客观证据),而不是听 actor 自己汇报;
- 它与 actor 的私有推理过程和记忆 完全隔离 ,避免"既当运动员又当裁判"导致的相关性错误;
- 它给出 PASS / FAIL 的判决和支撑证据,只有通过验证的经验才允许写入记忆。
3.3 Curriculum Agent(课程智能体)------负责出练习题
它是全局协调者,决定"下一步该练什么"。它根据目标任务、当前记忆和以往的探索结果,生成合适的练习任务:前置技能、有信息量的变体、针对失败的强化练习、压力测试等。当它判断继续练习已经带不来新知时,探索就停止。
三个角色的信息边界设计得很讲究(论文附录中的接口表):actor 看不到验证器的判卷逻辑,验证器看不到 actor 的记忆和推理,课程智能体只能读记忆的一份一次性副本、不能直接修改它。这种隔离保证了评估的客观性。
4. 两阶段探索策略:先广后深
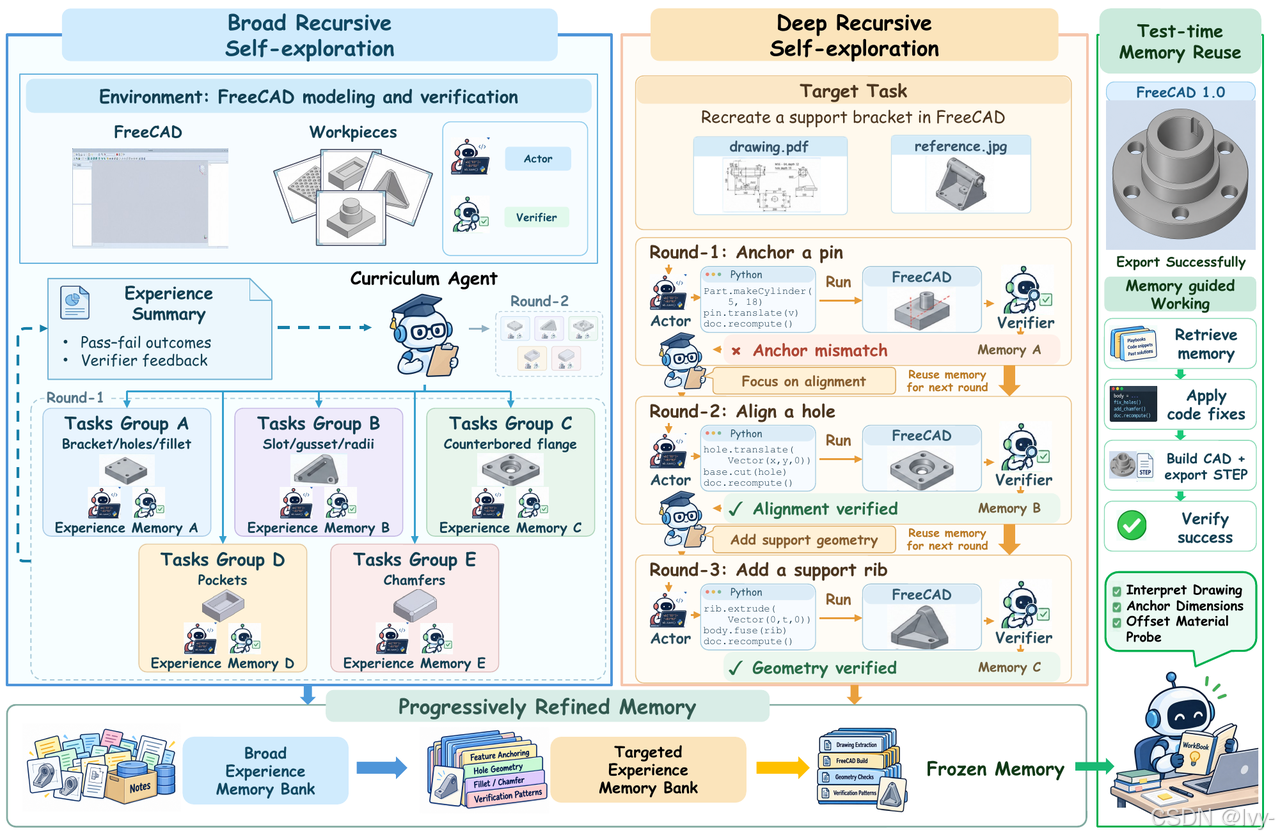
RSIAgent 最核心的设计是 broad-then-deep(先广后深) 的探索策略,分为两个阶段。下图以 FreeCAD 建模任务为例完整展示了整个流程:
4.1 第一阶段:Broad Recursive Self-exploration(BRS,广度递归自我探索)
目标是 快速建立对新环境的整体认识 。流程是一个并行递归循环(对应上图左侧):
- 课程智能体一次性提出 多个不同方向 的练习任务(比如 FreeCAD 例子中分成支架打孔、槽与筋板、沉头法兰、凹腔、倒角等多个任务组);
- 多个 actor 在隔离的环境中 并行执行 这些任务,验证器并行评判;
- 所有结果收集完毕后,课程智能体分析已有经验,找出知识盲区,生成下一轮更有信息量的任务。
有一个重要的工程细节:并行执行时,同一轮的每个项目都从 相同的记忆快照 出发、互相看不到对方;但记忆更新是 串行进行的 ------所有判决落地后,各 actor 按课程智能体指定的顺序依次把自己的经验蒸馏(distillation)并调和(reconciliation,检查与旧条目的矛盾)进最新的主记忆。这样既享受了并行的速度,又保证了记忆的一致性。
4.2 第二阶段:Deep Recursive Self-exploration(DRS,深度递归自我探索)
目标是 针对重点难点做精细化打磨 (对应上图中部)。与 BRS 的并行铺开不同,DRS 是 串行的、难度递增的 递归循环:
- 课程智能体提出一个有挑战性的任务,专门瞄准当前记忆的薄弱环节------容易暴露隐藏约束、边界条件的任务;
- actor 带着积累的记忆去尝试,验证器给出有依据的反馈;
- 每条验证过的经验都先固化进记忆,课程智能体再基于最新结果提出更难的下一题。
在 FreeCAD 例子中可以看到这个递进过程:Round-1 学"锚定圆柱销"(发现锚点对不上 → 记入记忆),Round-2 学"对齐孔位"(复用上轮记忆 → 对齐验证通过),Round-3 学"添加支撑筋板"(几何验证通过)。每一轮都站在上一轮记忆的肩膀上。
作者把这个"先广后深"的过程类比为现代大模型开发中的 预训练 → 后训练 范式:先广泛覆盖,再精炼关键细节。
4.3 测试时记忆复用(Test-time Memory Reuse)
探索结束后(对应上图右侧):
- 记忆被 冻结 (系统记录记忆文件树的哈希值,防止任何写入);
- 课程智能体被禁用,不再产生任何记忆更新;
- actor 直接读取记忆中的流程、约束和失败教训来完成目标任务,验证器照常检查,直到任务要求全部满足。
这一步有点像"开卷考试":平时练习积累的笔记本原封不动带进考场,但考场上不许再往笔记本上写新东西。
5. 实验结果
5.1 主实验:开源模型反超闭源前沿模型
实验在两个基准上进行: OSWorld 2.0 (0808 offline 子集,82 个桌面软件任务)和 Agents' Last Exam(ALE) (Near-term,67 个专业工作流任务)。评价指标有两个(对所有任务取平均):
Partial=100N∑i=1Nsi,Binary=100N∑i=1N1{si=1},\mathrm{Partial} = \frac{100}{N} \sum_{i=1}^{N} s_i, \qquad\mathrm{Binary} = \frac{100}{N} \sum_{i=1}^{N} \mathbf{1}\{s_i = 1\},Partial=N100∑i=1Nsi,Binary=N100∑i=1N1{si=1},
其中 si∈0,1s_i \in 0, 1si∈0,1 是第 iii 个任务的归一化得分。Partial 衡量平均完成度(做对一半也给分),Binary 衡量满分率(只有全对才算数)。
| 模型 / 方法 | OSWorld 2.0 Partial (%) | OSWorld 2.0 Binary (%) | ALE Partial (%) | ALE Binary (%) |
|---|---|---|---|---|
| Kimi-K2.6 | 22.10 | 4.60 | 21.70 | 9.20 |
| DeepSeek V4 Pro | --- | --- | 43.81 | 19.90 |
| Qwen3.8-Max | --- | --- | 52.50 | 27.00 |
| Kimi-K3 | 58.30 | --- | 71.60 | 40.30 |
| Claude Opus 4.8 | 54.80 | 20.60 | 64.00 | 43.30 |
| GPT-5.6 Sol | 64.13 | 28.10 | 78.82 | 47.76 |
| Claude Opus 5 | 70.19 | 34.72 | 79.54 | 46.27 |
| GPT-6 Astra | 72.60 | --- | 82.26 | 52.24 |
| RSIAgent (w/o RSI) | 71.97 | 37.80 | 83.75 | 49.25 |
| RSIAgent(完整版) | 78.98 | 42.68 | 84.82 | 50.75 |
几个值得注意的结论:
- RSI 过程本身有效 :相比不加 RSI 的同一套框架,OSWorld Partial 从 71.97 升到 78.98,Binary 从 37.80 升到 42.68;ALE 两项指标也均有提升。
- 开源反超闭源 :RSIAgent 用的是开源模型(GLM-5.3 当 actor,Kimi-K3 当验证器和课程智能体),Partial 得分却超过了 GPT-6 Astra(OSWorld 高出 6.38 分,ALE 高出 2.56 分),也高于 Claude Opus 5。
- 诚实的脚注 :作者明确指出在 ALE 的 Binary 指标上 RSIAgent(50.75)仍略低于 GPT-6 Astra(52.24),且跨系统对比并非严格同一协议,态度相当严谨。
5.2 RSI 轮次:分数是"顿悟式"跳涨的
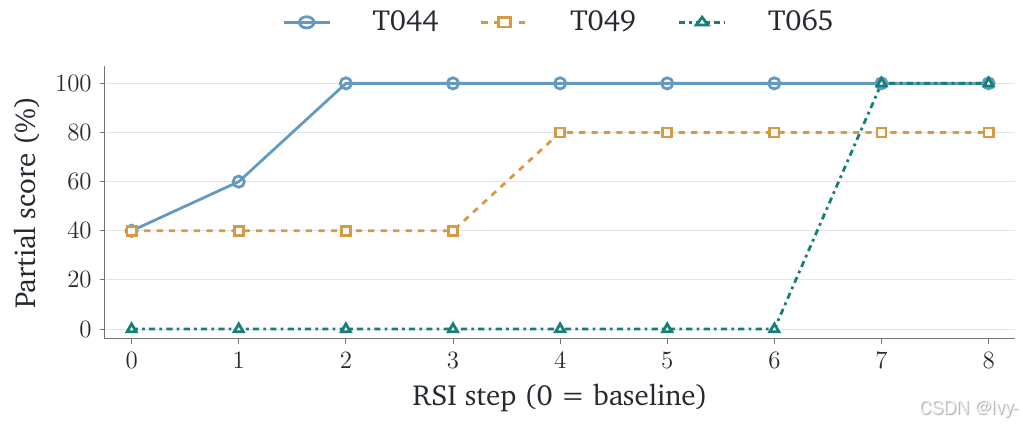
论文跟踪了三个代表性任务(T044 视频编辑、T049 演示文稿修复、T065 火车票预订)在 8 步探索中的得分变化。曲线揭示了一个有趣现象:分数不是平滑上升,而是 长期平台期后的离散跳涨 ------比如 T065 在前 6 步一直是 0 分,第 7 步直接跳到 100 分。
原因很直观:BRS 阶段在记忆里默默积累各种流程和知识,只有当积累覆盖了任务的最后一个关键瓶颈时,分数才会"顿悟式"爆发。这类似"万事俱备只欠东风",东风一到,全盘皆活。
5.3 消融实验:广度和深度缺一不可
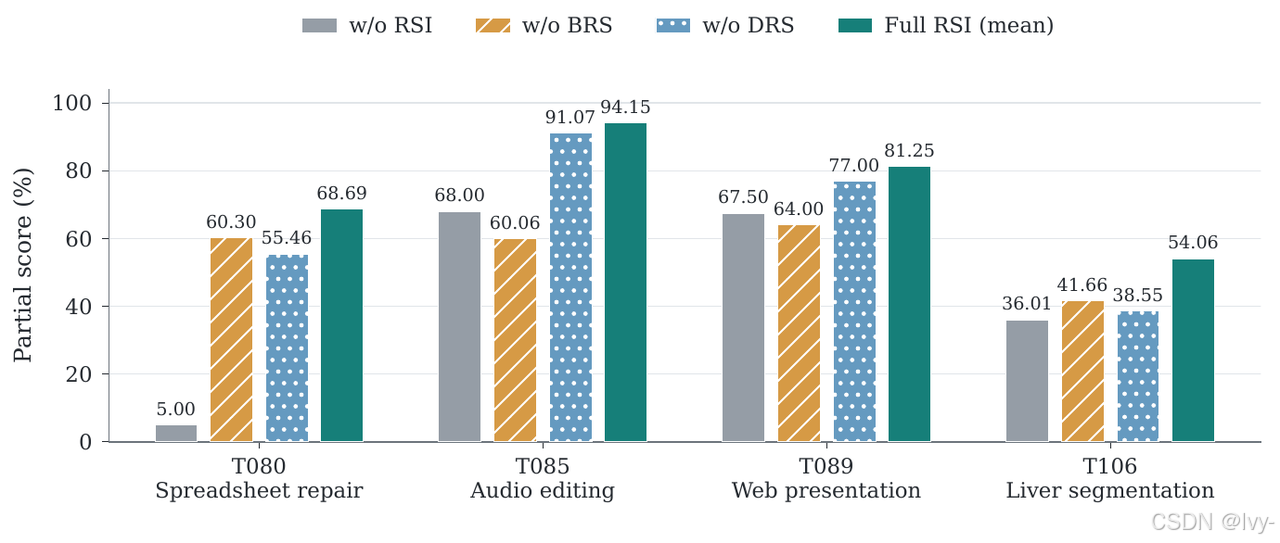
作者在四个任务上对比了四种配置(w/o RSI = 空记忆基线;w/o BRS = 只做深度探索;w/o DRS = 只做广度探索;Full RSI = 完整两阶段):
- Full RSI 在全部四个任务上都是最高分 ,平均分 74.54%,显著高于只广度(65.52%)和只深度(56.50%);
- 只做广度探索在每个任务上都能超过基线,说明 BRS 本身就有稳定价值;
- 只做深度探索在 T085、T089 上 反而低于基线 ------没有广度阶段打下的环境知识地基,深度练习容易"练偏"。
结论清晰:先广后深的组合不是锦上添花,而是缺一不可。
5.4 游戏开发环境:泛化能力验证
作者还在 GameCraft-Bench 上随机抽了 40 个游戏开发任务,与持续迭代基线 Play2Code 对比。结论有三点:
- RSIAgent 在所有基础生成器(GPT-5.5、Kimi-K2.6、GLM-5.3-Flash、Qwen3.8-27B)上都显著提升游戏质量;
- Play2Code 只对弱基础游戏有效,对已经很强的游戏 反而会帮倒忙 (如 GPT-5.5 组从 52.77 降到 51.05);RSIAgent 则能稳定改进强弱两种起点;
- 加入 RSI 探索经验后还能进一步涨分(如 GLM-5.3-Flash 组从 44.73 升到 48.72),说明积累的经验确实可复用。
5.5 记忆增长的实证案例
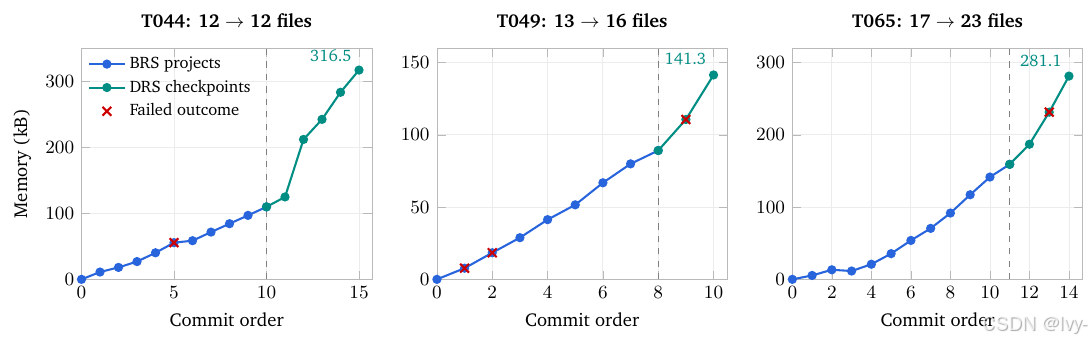
附录的案例研究展示了记忆随探索逐步增长的过程,以及记忆如何在真实执行中发挥作用。下面这组对比很能说明问题------T049 任务(修复 WPS 演示文稿)中,同一份文档在基线方法和记忆加持下的渲染效果差异:
| 基线(无记忆)渲染效果 | 记忆复用后渲染效果 |
|---|---|
 |
|
 |
|
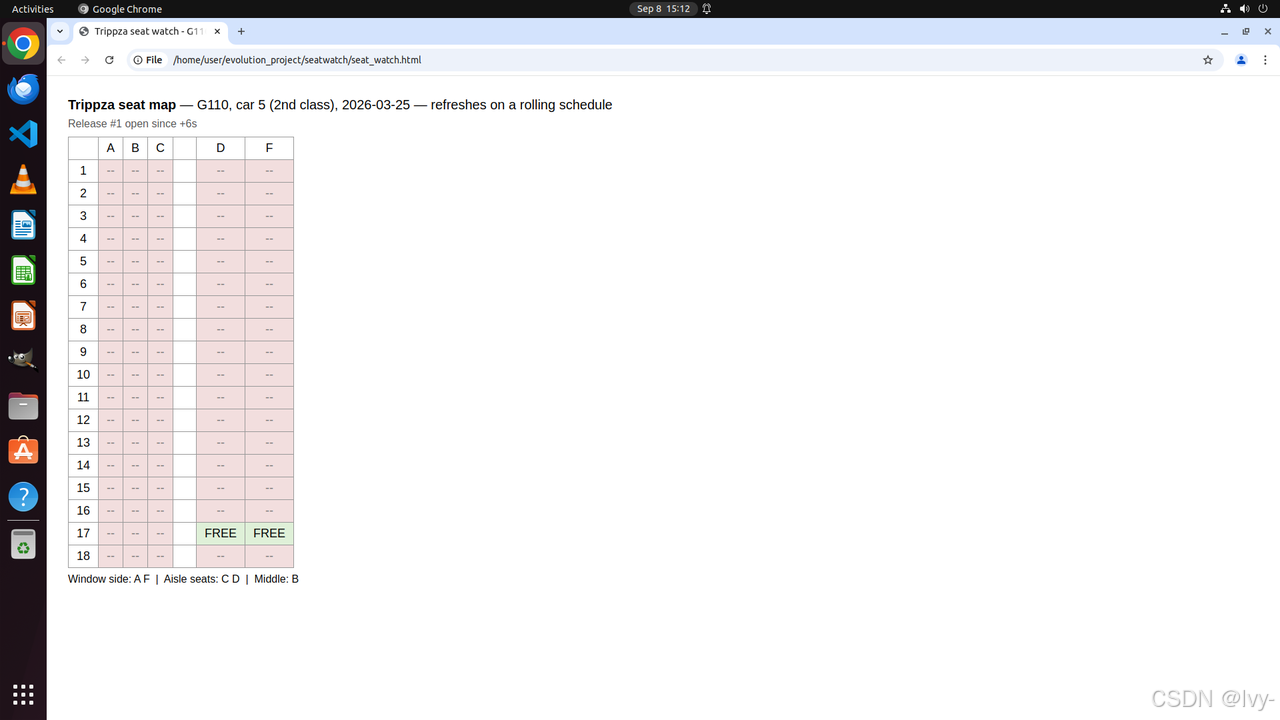
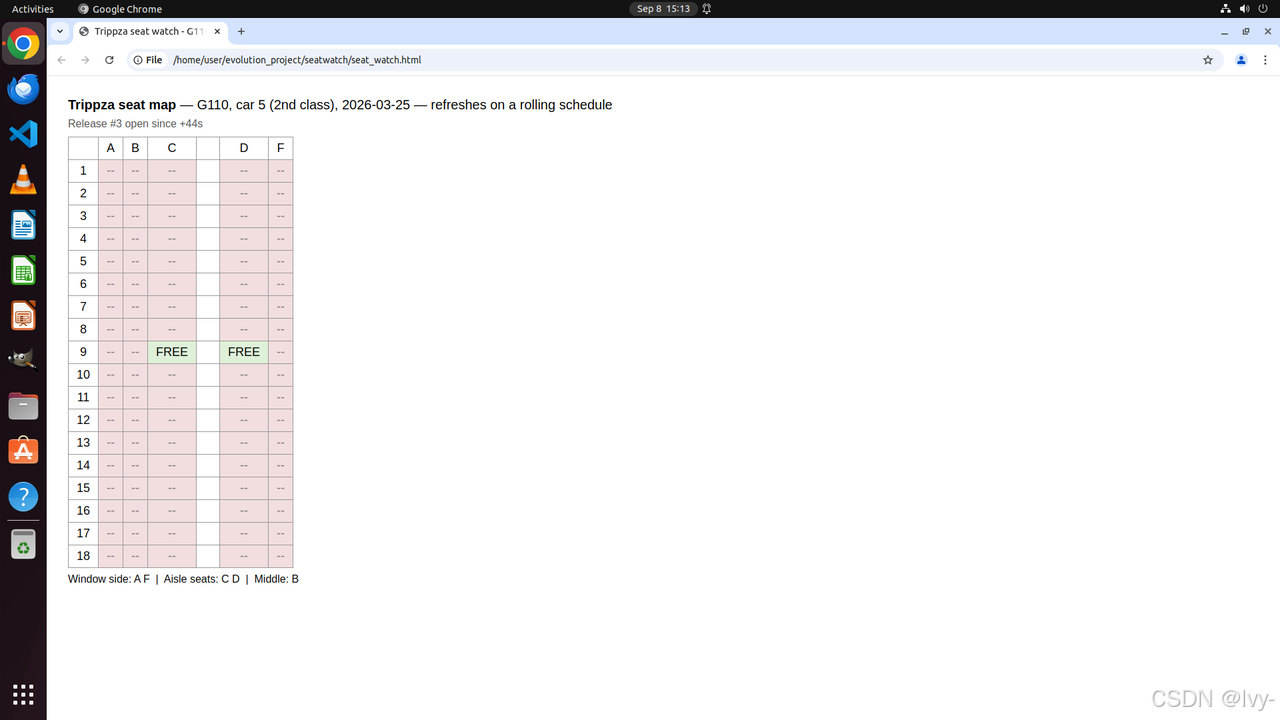
而在 T065(动态火车票预订界面)中,智能体通过探索学会了处理会动态变化的界面元素------先观察到最早的直达班次选项,在被系统拒绝后修正策略:
| 观察动态界面 | 遭遇拒绝后修正 |
|---|---|
 |
|
 |
|
6. 失败模式分析:什么会阻碍自我提升
论文诚实地分析了限制 RSI 效果的三类失败机制:
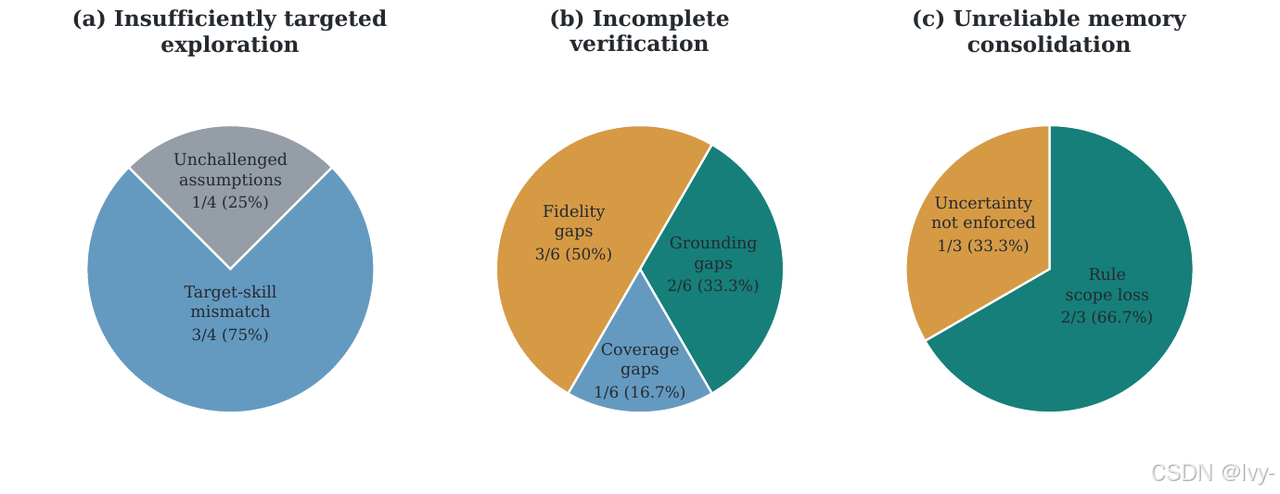
- (a) 探索不够有针对性(Insufficiently targeted exploration) :练习量很大但没有真正挑战薄弱环节。案例中课程智能体安排了文档处理、冲突信息等练习,却从没测试过"用户信息缺失"这个真正的痛点,导致错误的缺信息处理规则一直留在记忆里(其中 75% 是目标技能错位)。
- (b) 验证不完整(Incomplete verification) :验证器做了局部检查就放行,没有核对任务的全部要求(50% 是保真度缺口,33.3% 是落地证据缺口)。被错误放行的结果还会污染后续的记忆更新------错的经验被当成了学习材料。
- © 记忆固化不可靠(Unreliable memory consolidation) :未经验证的结论被写成了通用规则(66.7% 是规则适用范围丢失,33.3% 是不确定性未被保留)。比如把"缺失数据标记"当成合法答案的规则被后续尝试反复套用。
这三类机制会互相强化:一次不完整的验证 → 一条不可靠的规则 → 后续探索方向的偏差。这也指明了未来的改进方向:更严格的验证、记忆里保留经验的适用条件和不确定性。
7. 局限性
作者明确列出了几条局限:
- 测试时的探索练习会带来 可观的额外计算开销 ;
- 效果受限于探索预算、停止策略和记忆质量;
- 验证器本身也是模型,可能误判并污染后续学习;
- 不同环境可能需要不同的工具和探索策略,各组件的贡献尚未完全解耦;
- 伦理上,自主探索软件、执行程序、保留记忆带来了误操作、越权访问和隐私泄露的风险(实验均在受控环境中进行)。
8. 伪代码实现
综合论文第 3、4 节及附录 Algorithm A1(Target-conditioned RSI reference procedure),整个流程可以用下面的伪代码概括:
python
def rsi_agent(target_query q, env, initial_memory M0, budget=8, concurrency=4):
    # ---------- 初始化 ----------
    M = M0                          # 主记忆(canonical memory),跨任务持久
    actor       = ActorAgent()      # 策略模型,动作 = 可执行代码
    verifier    = VerifierAgent()   # 独立判卷,只看环境反馈,与 actor 隔离
    curriculum  = CurriculumAgent() # 决定"下一步练什么"

    # ---------- 阶段一:广度递归自我探索(BRS) ----------
    completed_projects = 0
    while not curriculum.should_stop_broad() and completed_projects < budget:
        # 1. 课程智能体一次提出多个方向的练习项目
        projects = curriculum.propose_projects(
            target=q, memory=M.snapshot(),        # 只给一份一次性副本
            past_outcomes=wave_history)

        # 2. 并行执行:所有项目从同一记忆快照出发,互不可见
        snapshot = M.snapshot()
        results = parallel_run(projects, max_workers=concurrency,
                               fn=lambda p: run_episode(p, actor, verifier,
                                                        env.fork(), snapshot))

        # 3. 串行记忆更新:按课程智能体指定的顺序依次蒸馏+调和
        for r in curriculum_order(results):
            if r.verdict in (PASS, FAIL):         # 只有被验证落地的经验才入库
                lessons  = r.actor.distill(r.verifier_report)
                M        = r.actor.reconcile(M, lessons)   # 修正矛盾、限定适用范围
        completed_projects += len(projects)

    # ---------- 阶段二:深度递归自我探索(DRS) ----------
    while True:
        env.reset()
        verdict = run_episode(q, actor, verifier, env, memory=M)   # 先尝试目标任务
        if verdict in (PASS, FAIL):
            M = actor.learn(M, verifier.report)    # actor 主导的经验固化

        if stopping_policy == "verifier_pass" and verdict == PASS:
            break
        # 课程智能体复盘:是否需要更有挑战性的练习
        decision = curriculum.review(q, verdict, actor.diagnosis, M.snapshot())
        if decision == STOP or (verdict == PASS and decision == NO_PRACTICE):
            break
        if decision == STALLED:
            run_episode(q, actor, verifier, env.reset(), memory=M)  # 最后尝试一次
            break
        # 串行练习:执行 -> 验证 -> 写记忆,一次一个,难度递增
        practice = decision.project
        r = run_episode(practice, actor, verifier, env.fork(), memory=M)
        if r.verdict in (PASS, FAIL):
            M = actor.learn(M, r.verifier_report)

    # ---------- 阶段三:冻结记忆,正式评测 ----------
    frozen = freeze(M)              # 记录文件树哈希,禁止任何写回
    env.reset()
    final = actor_verifier_loop(q, actor, verifier, env, memory=frozen)
    score = official_evaluator(final)   # 官方评分器在智能体上下文之外运行
    assert hash(frozen) == recorded_hash
    return score
其中 run_episode 是底层的 actor--verifier 执行循环:
python
def run_episode(task, actor, verifier, env, memory):
    history = [env.observe()]
    for step in range(MAX_STEPS):
        action = actor.act(task, history, memory)   # 生成可执行 Python/Bash 程序
        obs, done = env.execute(action)             # 也可能是 look / ask / done
        history.append(obs)
        if done:
            break
    # 验证器在候选环境的受保护副本上独立检查,给出 PASS / FAIL / UNVERIFIED
    verdict = verifier.judge(task.requirements, env.inspect_protected_copy())
    return Result(verdict, actor.context, verifier.report)