概览
这讲的目标是
- 了解GPU架构
- 了解影响GPU性能的因素
- 利用这些知识理解最经典的GPU优化:FlashAttention
算力的重要性
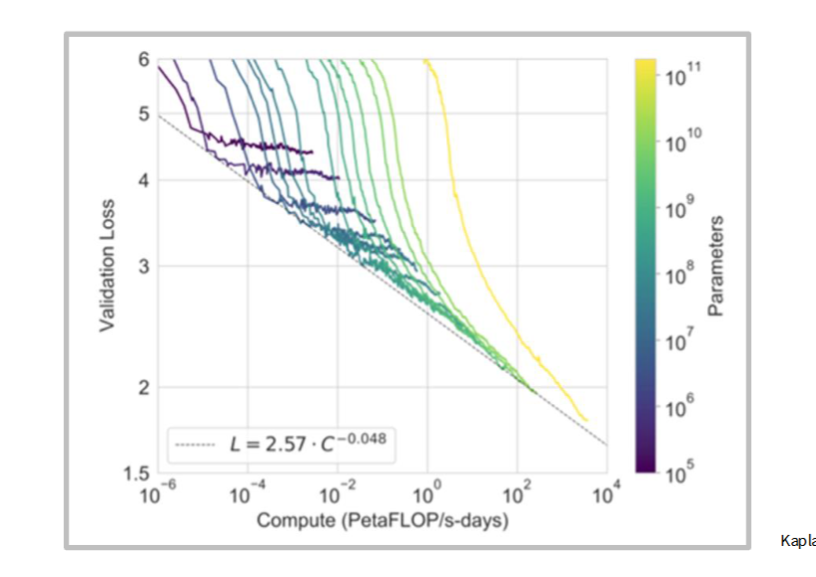
地球上的总算力以指数级增长,才能使得大语言模型的验证集loss以线性降低,可以拟合出一个下界,如图中的虚线描述的直线。所以算力对于AI的发展非常重要。
CPU的发展
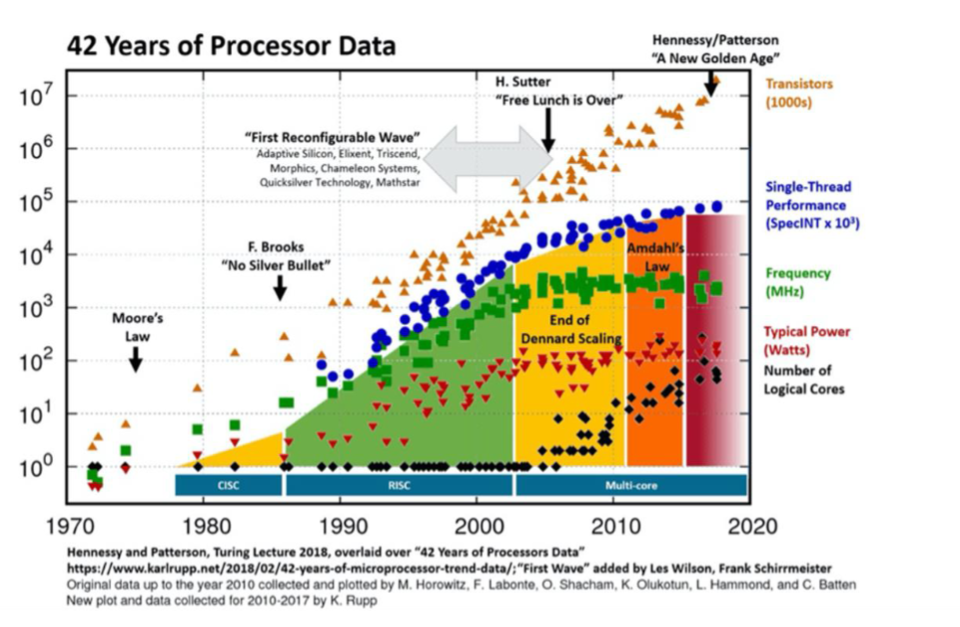
几种颜色的点分别表示了过去几十年里CPU主要指标的发展,注意纵轴是对数坐标轴,也就是说过去很长时间里CPU性能都是指数级增长的,用通俗的角度来理解就是摩尔定律所描述的现象,随着半导体工艺的提升,算力是以指数级增长的。但这个过程在2000年后逐渐减速,到了2010年后几乎趋于平缓。
这样的增速如何满足大模型爆炸式的算力需求?
GPU的缩放定律
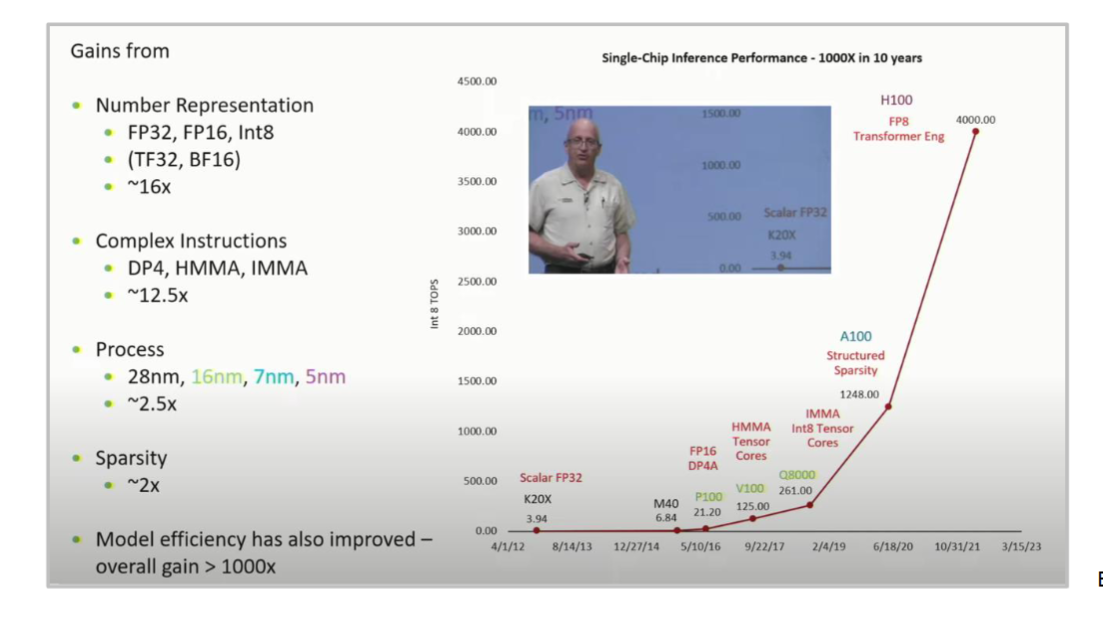
答案是GPU,GPU的算力在过去十年里发生了指数级的增长,几乎提升了1000倍。这正好接替了2010年以来CPU算力缩放定律的放缓。
拆解这1000倍加速的占比
- 数据类型提供了16x,也就是fp16,tf32甚至int8等数据类型,位宽更小,相同面积可以放下更多计算单元。
- 指令集的进步,如MMA,提供了12.5x
- 芯片制程的进步,提供了2.5x
- 结构化稀疏,也就是计算单元可以接受每4个位置,只有2个有效的数据,对于这样的数据可以实现稳定的2x加速。
GPU的性能缩放是大模型的参数缩放的基石。
GPU架构
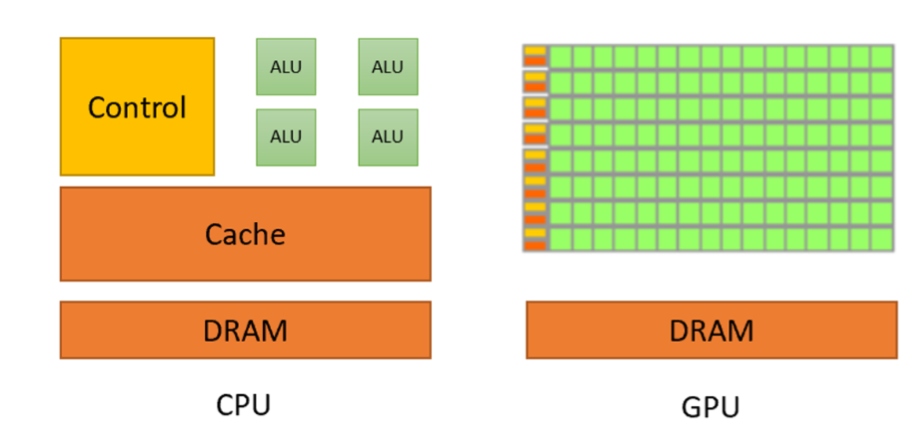
GPU和CPU最大的区别就是降低了单核的能力,但是大幅增加了核心数,如图每个绿色都是一个计算核心,这样做每个核心的算力降低了,能获得缓存也变少了,但是计算核心的数量弥补了这一点,尽管分支控制变弱了,但在数据密集型的任务中能发挥远超CPU的性能。
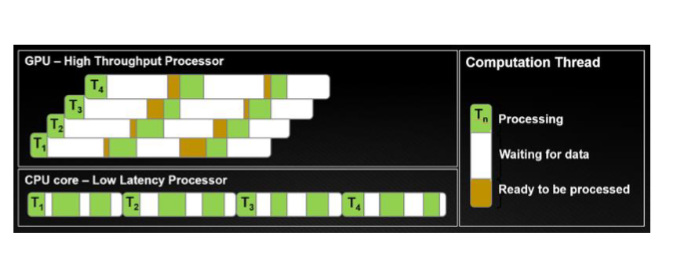
CPU优化的是计算核心的延迟,下方那个一行的图就是一个典型的CPU负载,大部分时候都是计算bound,所以我们想要优化的往往是计算量
GPU则不同,上方那个4进程组成的流水线是典型的GPU负载,这4个线程在一个GPU上,可以发现绿色的计算负载拼起来的话,GPU的计算单元其实是一直满载的,这是因为GPU的计算吞吐非常高,所以优化的关键不是减少计算量,而是优化吞吐,尽量喂饱计算单元。这里开4线程就是为了用一个类似4生产者,1消费者的结构,为计算单元搬运足够多的数据。
SM
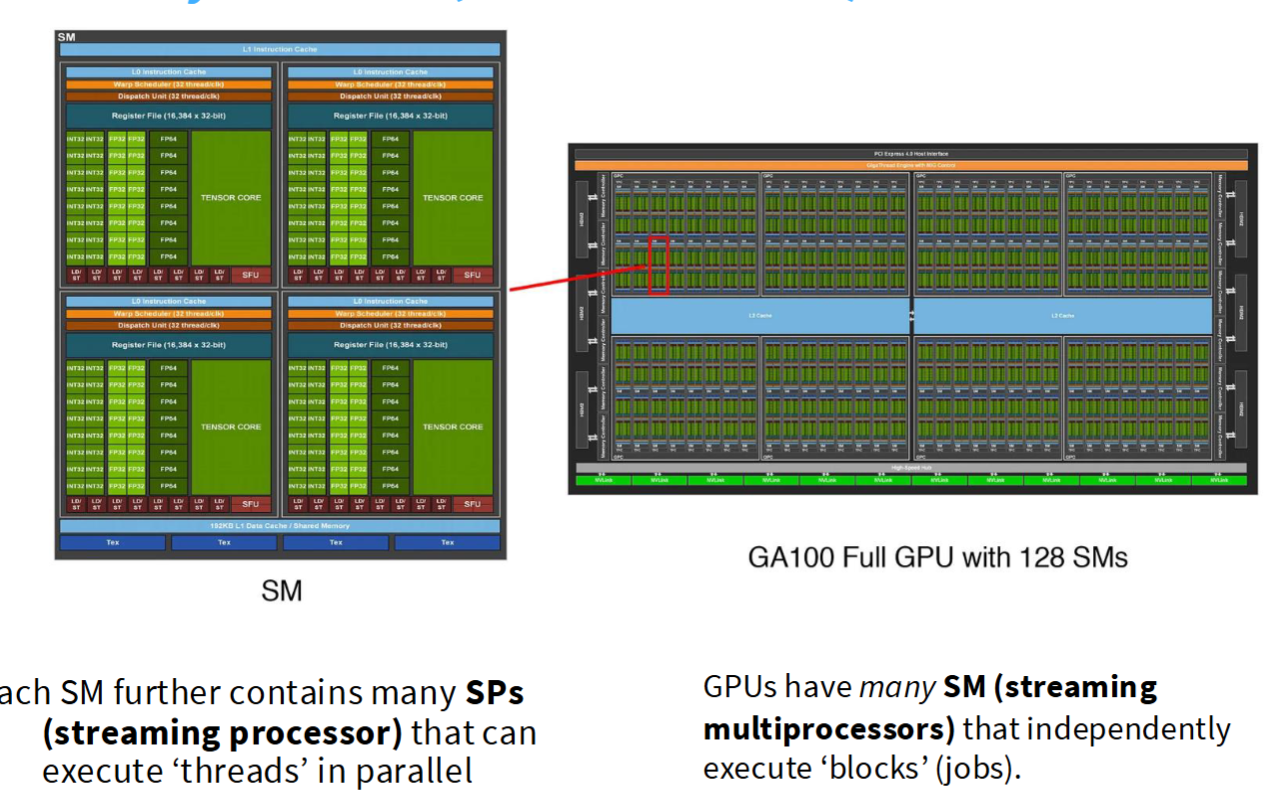
一个GPU上最基本的单元是SP,流处理器,负责一次执行多个线程。多个SP组成一个SM,也就是流多处理器,SM每次负责执行一个block也就是线程块的任务。一般一张卡上的SM数量大概是100-1000这个量级。
内存架构
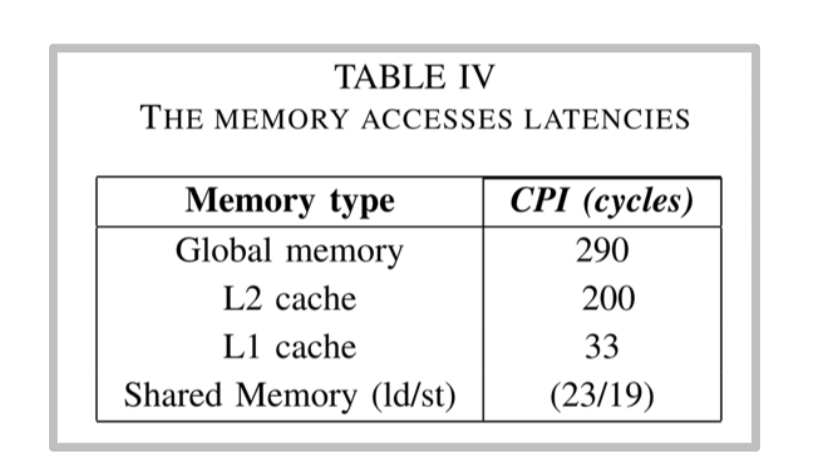
和我们在计算机组成原理里学到一样,GPU的内存也是有层次的,里计算单元越近,访问越快,一次访存指令需要的周期数(CPI)越少。
- 这里全局内存是最慢的,是所有SM共享的。
- L2 cache是全局内存的缓存,也是所有SM都能访问,比全局内存稍快,但也很慢。
- 共享内存是每个SM专属的,离SM最近,也最快。能让编程者用代码直接操作。
- L1 cache和共享内存其实在相同的位置上,他负责给每个SM准备一个全局内存的缓存。定位其实和共享内存类似,但是缓存都是由硬件自动负责,编程者无法操纵。
执行模型
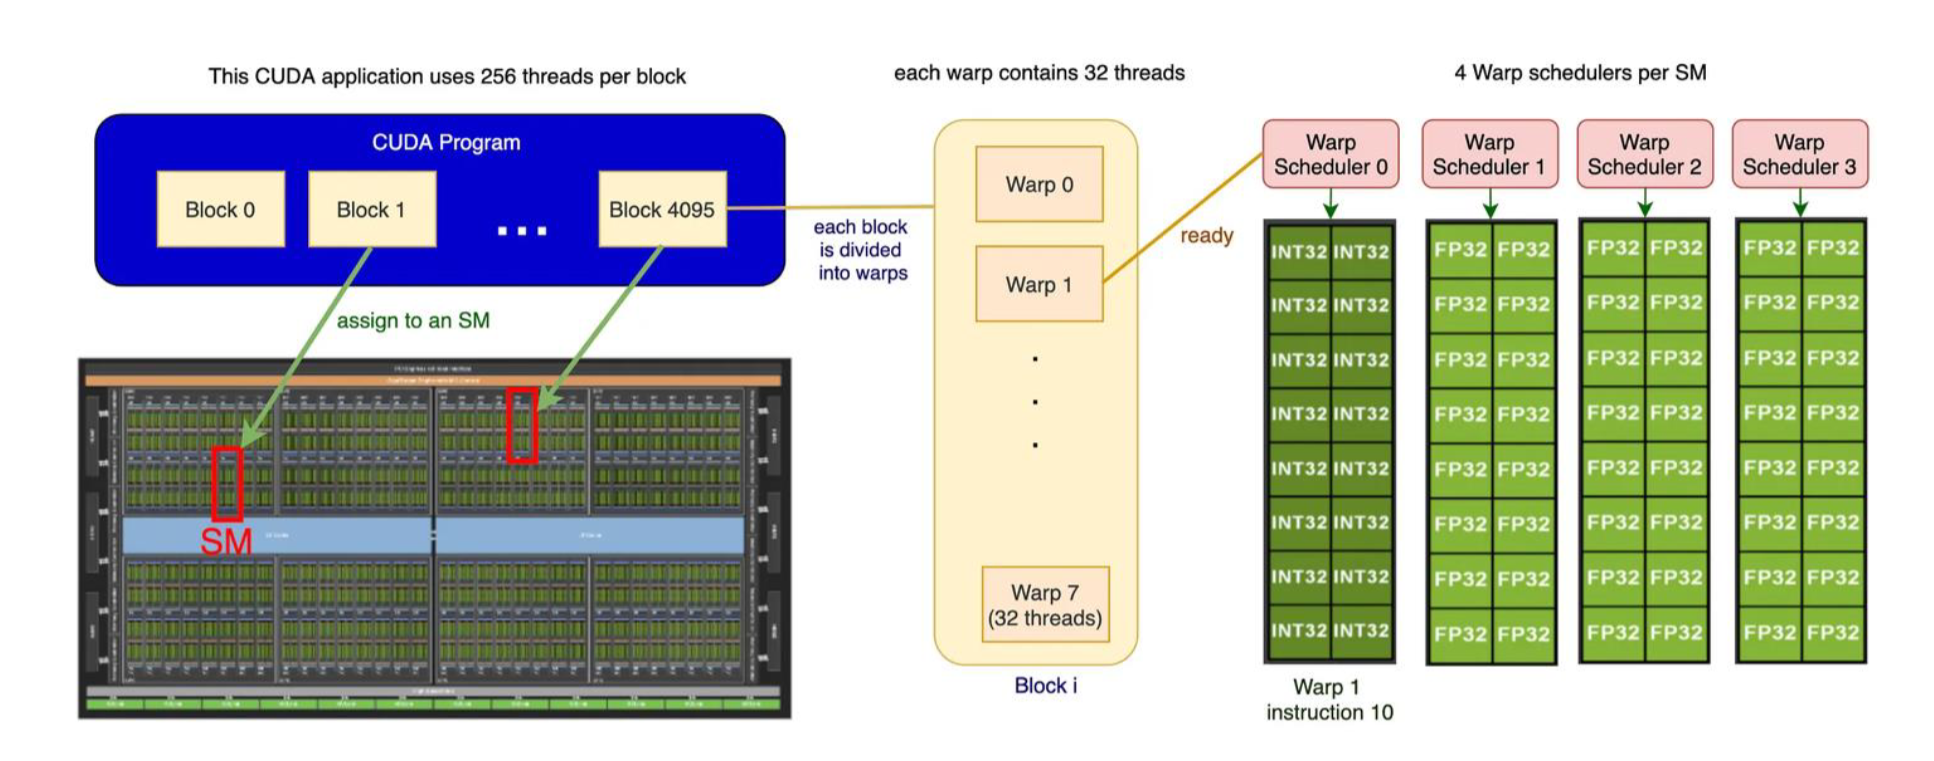
主要有三层:block,warp,thread,也就是线程块,线程束,线程
- 线程是我们在代码里直接操作的,执行具体的计算任务。
- 每32个线程组成一个warp,这是GPU执行时调度的最小单位,也就是每次会把32线程并行执行
- 线程块是我们在编程级别能操纵的另一个东西,一个线程块包含一定量的线程,具体包含多少我们可以规定。这相当于是我们对任务做的划分。每个block会被安排到一个SM上执行,因此block的划分相当于我们想让一个SM处理多少任务
内存模型
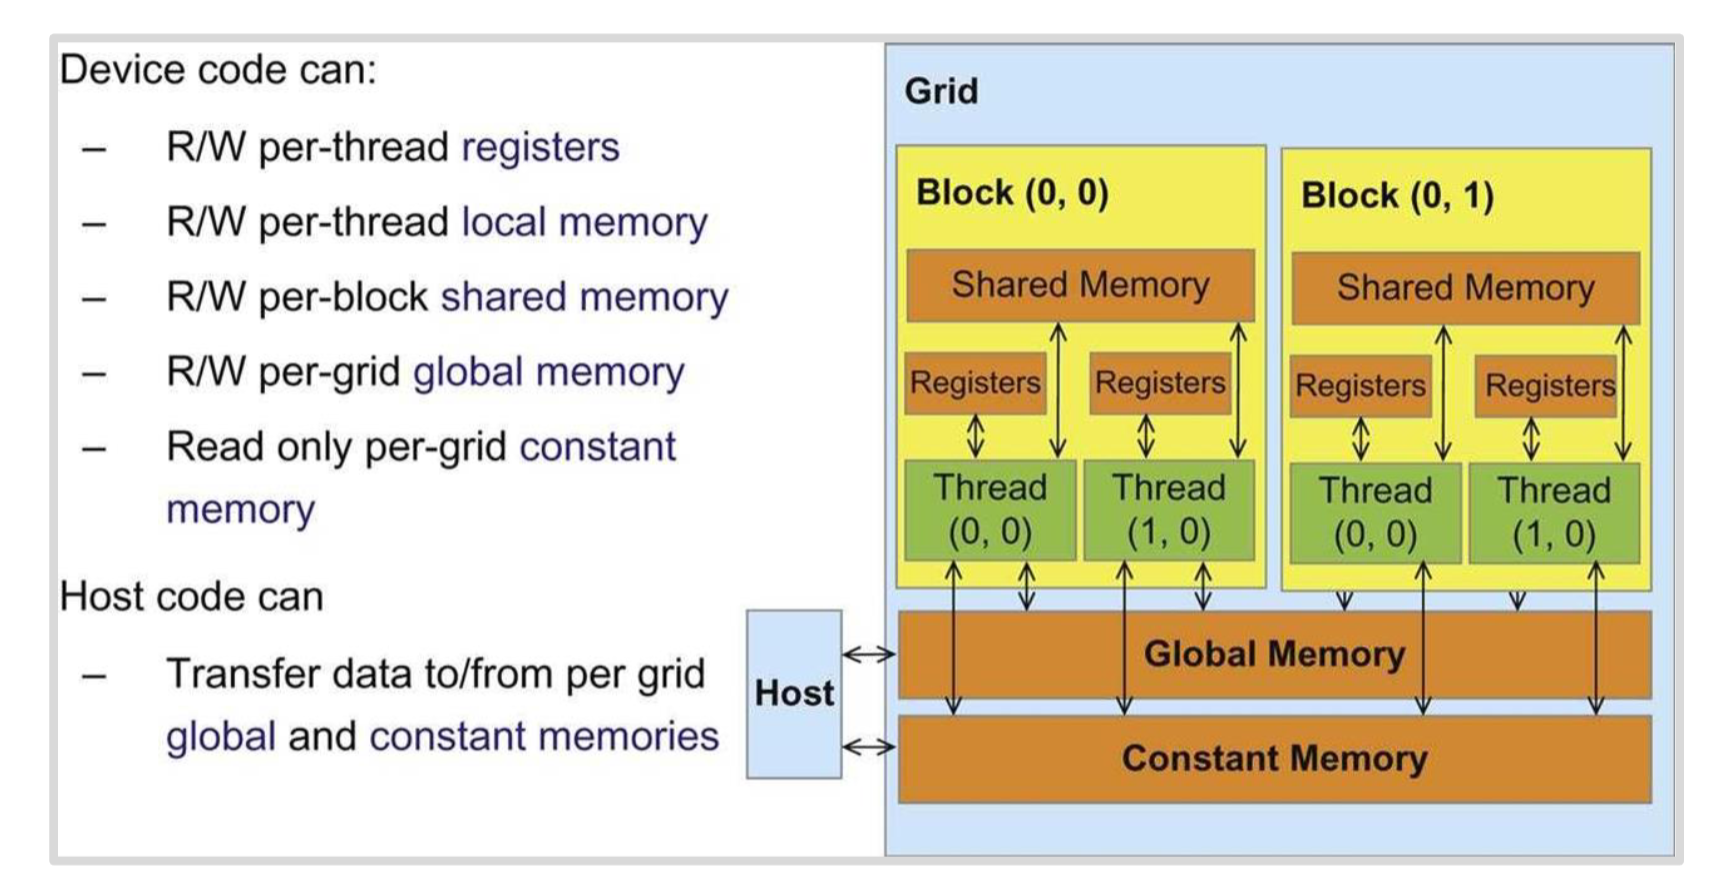
这里的内存模型是我们在编程时能利用的内存类型,和前面的内存架构有对应关系,但并不等同。
- 每个线程有专属的寄存器,这是最快的。
- 每个线程块内的内存共享shared memory(共享内存),这是第二快的
- 所有线程都能访问全局内存,这是最慢的。不同block的通信只能借助全局内存。
- 以及和全局内存存储在相同位置的常量内存(常量在编译时确定,全局共享,因此只保存一份)
- 实际上每个线程还有local memory本地内存这个东西,专属于每个线程。但是实际保存的位置和全局内存一样,访问很慢。在每个线程使用的寄存器内存太多时,超过每个SM的寄存器空间了,溢出的这部分就会被保存到local memory,这被称为寄存器溢出,会导致性能退化,应该尽量避免。
- 最后就是host(CPU)侧的内存,一般不会让GPU线程直接访问,而是在最开始先搬运到GPU全局内存。
TPU
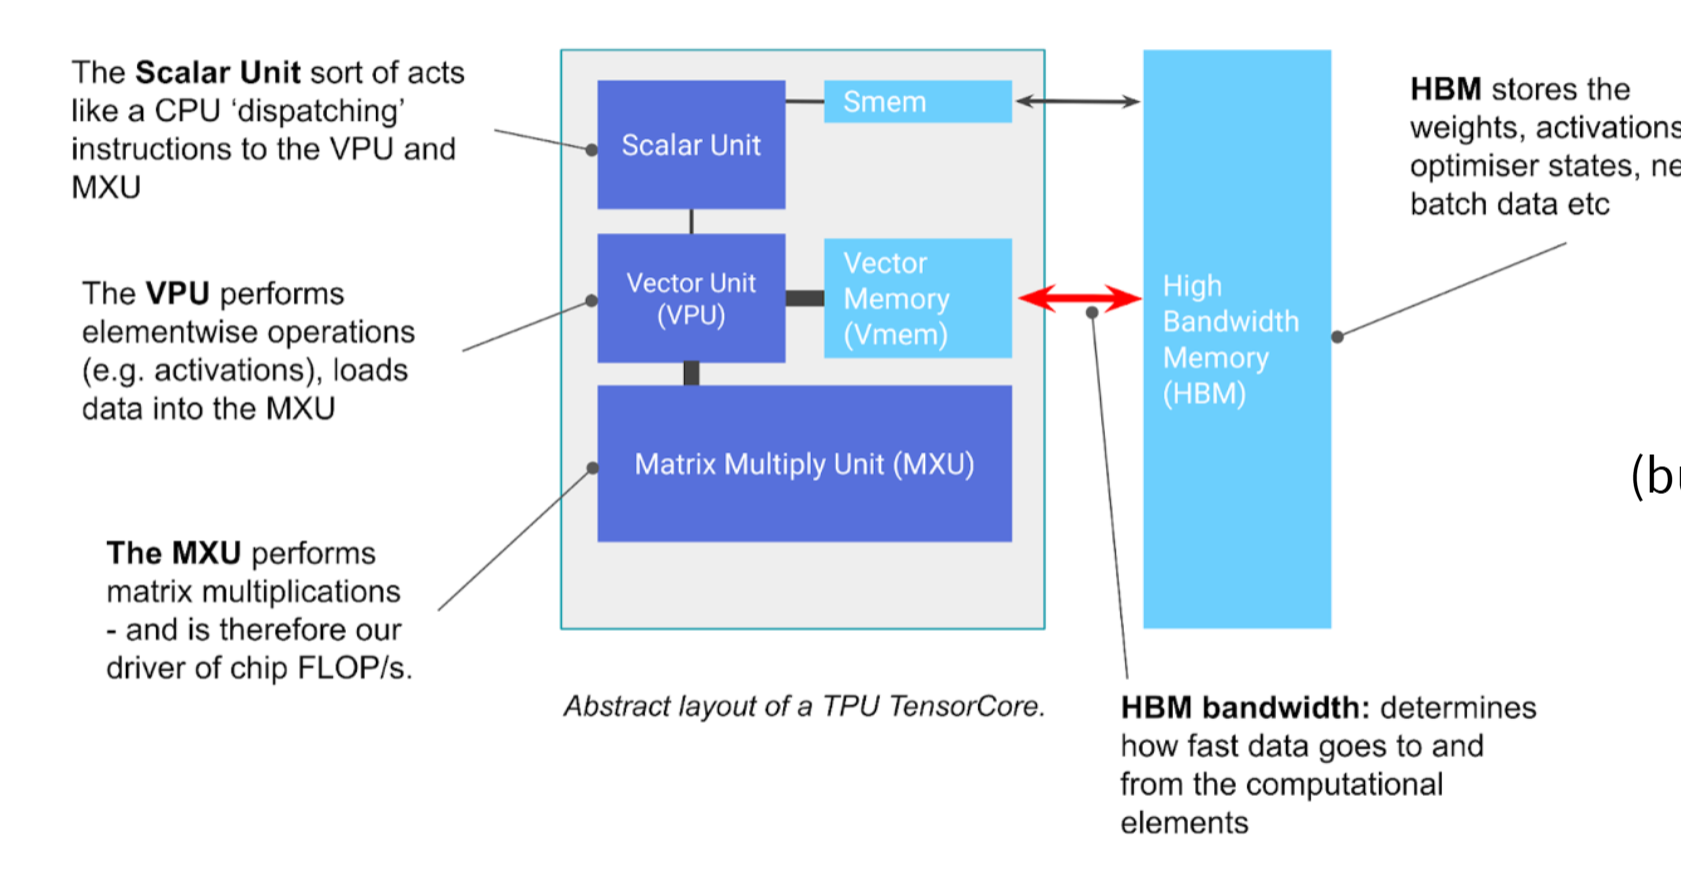
顺便讲讲TPU。TPU没有线程模型,他的计算有几个超大的计算单元:标量单元,向量单元,矩阵乘法单元。这些单元的个数远少于GPU的SP和SM个数,因此控制流很简单,但每个单元的吞吐都很大,因此整体计算吞吐和GPU是同一量级。并且由于没有线程,他的编程模型没有线程,只有类似于分块也就是GPU里划分block的操作。
TPU是谷歌对自家处理器的叫法,类似的还有很多LPU,NPU都是类似的架构,所有不采用线程模型,而是少量几个大计算单元的计算加速卡其实都是类似的。
TPU对GPU的意义是,线程对于矩阵乘法的吞吐还是不足,可以增加一个密集专用的矩阵乘法模块,实际上英伟达显卡的tensor core就是受到了TPU的启发。
早期的GPU矩阵乘法单元
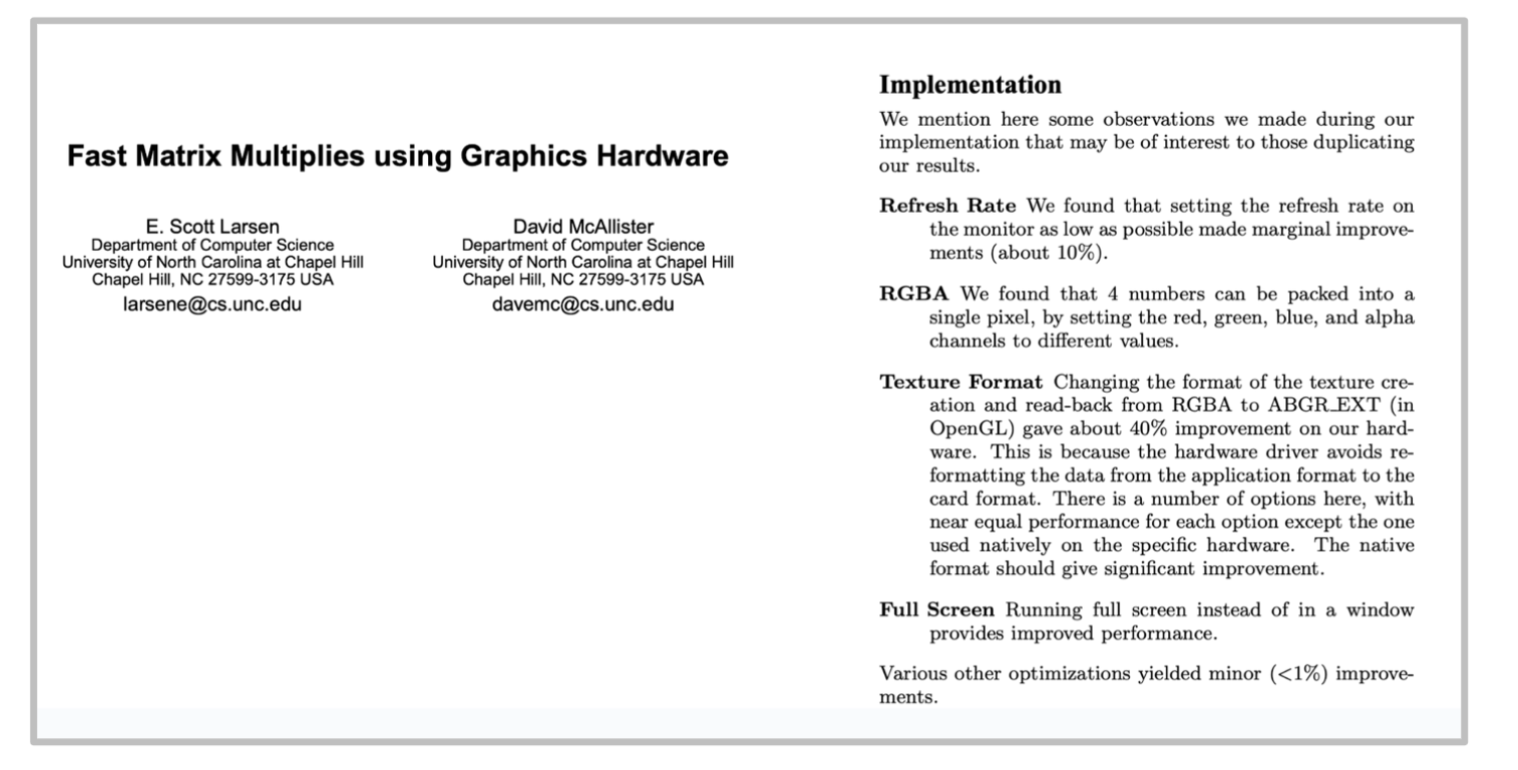
早期的显卡还是顾名思义,主要用途是渲染画面,但那时就有人想利用显卡的高吞吐来做其他任务,这需要先破解使用显卡进行矩阵乘法的方式。利用一种很神奇的方法,实际上我们可以利用画面渲染指令来做矩阵乘法,大概思路是把AB矩阵分别放到画面渲染的两个输入参数里,输出的画面就是矩阵乘法结果。
后来英伟达意识到AI需要GEMM算力,以及用户的反馈,才增加了专用的矩阵乘法单元tensor core。
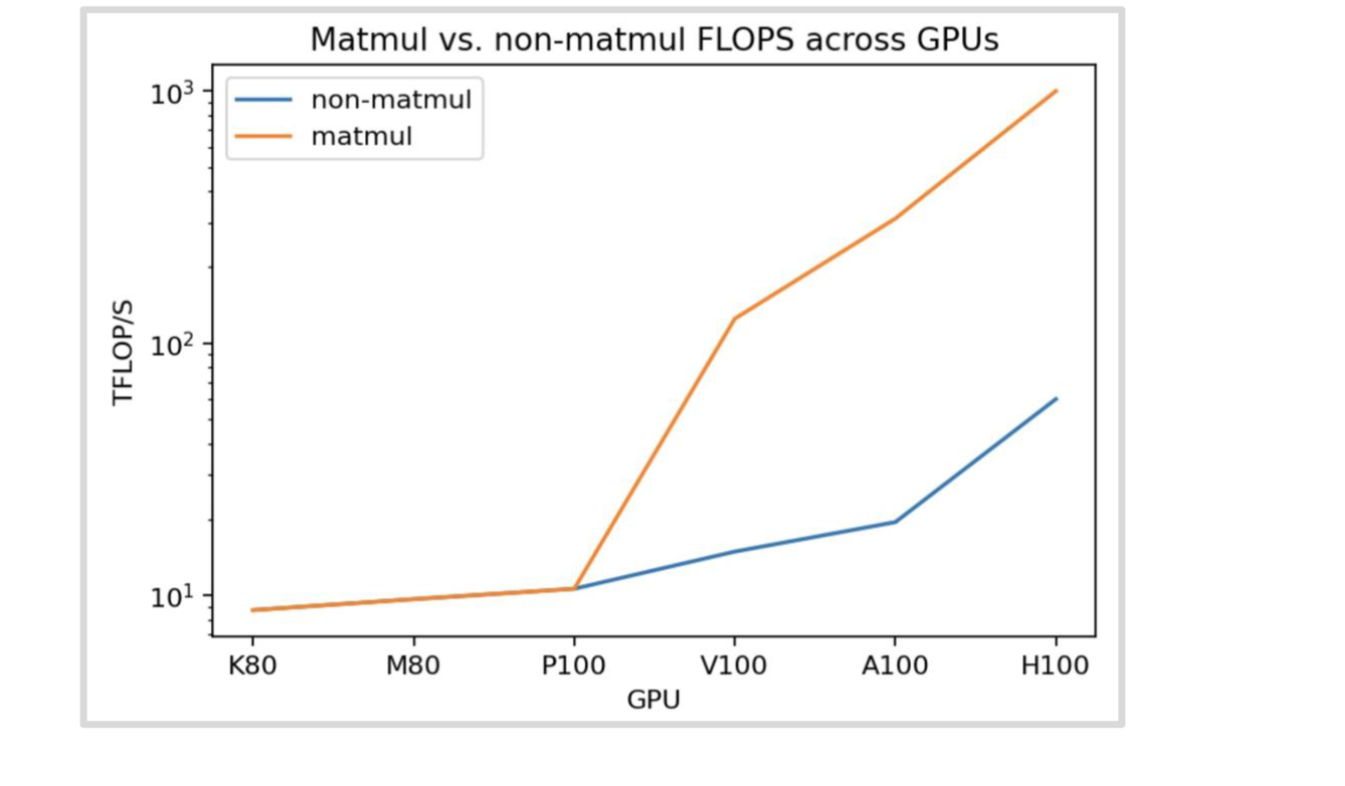
最早是在V100这代引入的,从这代开始矩阵乘法Tensor Core吞吐,和普通CUDA Core吞吐开始有了至少十倍的差距。
内存带宽的发展
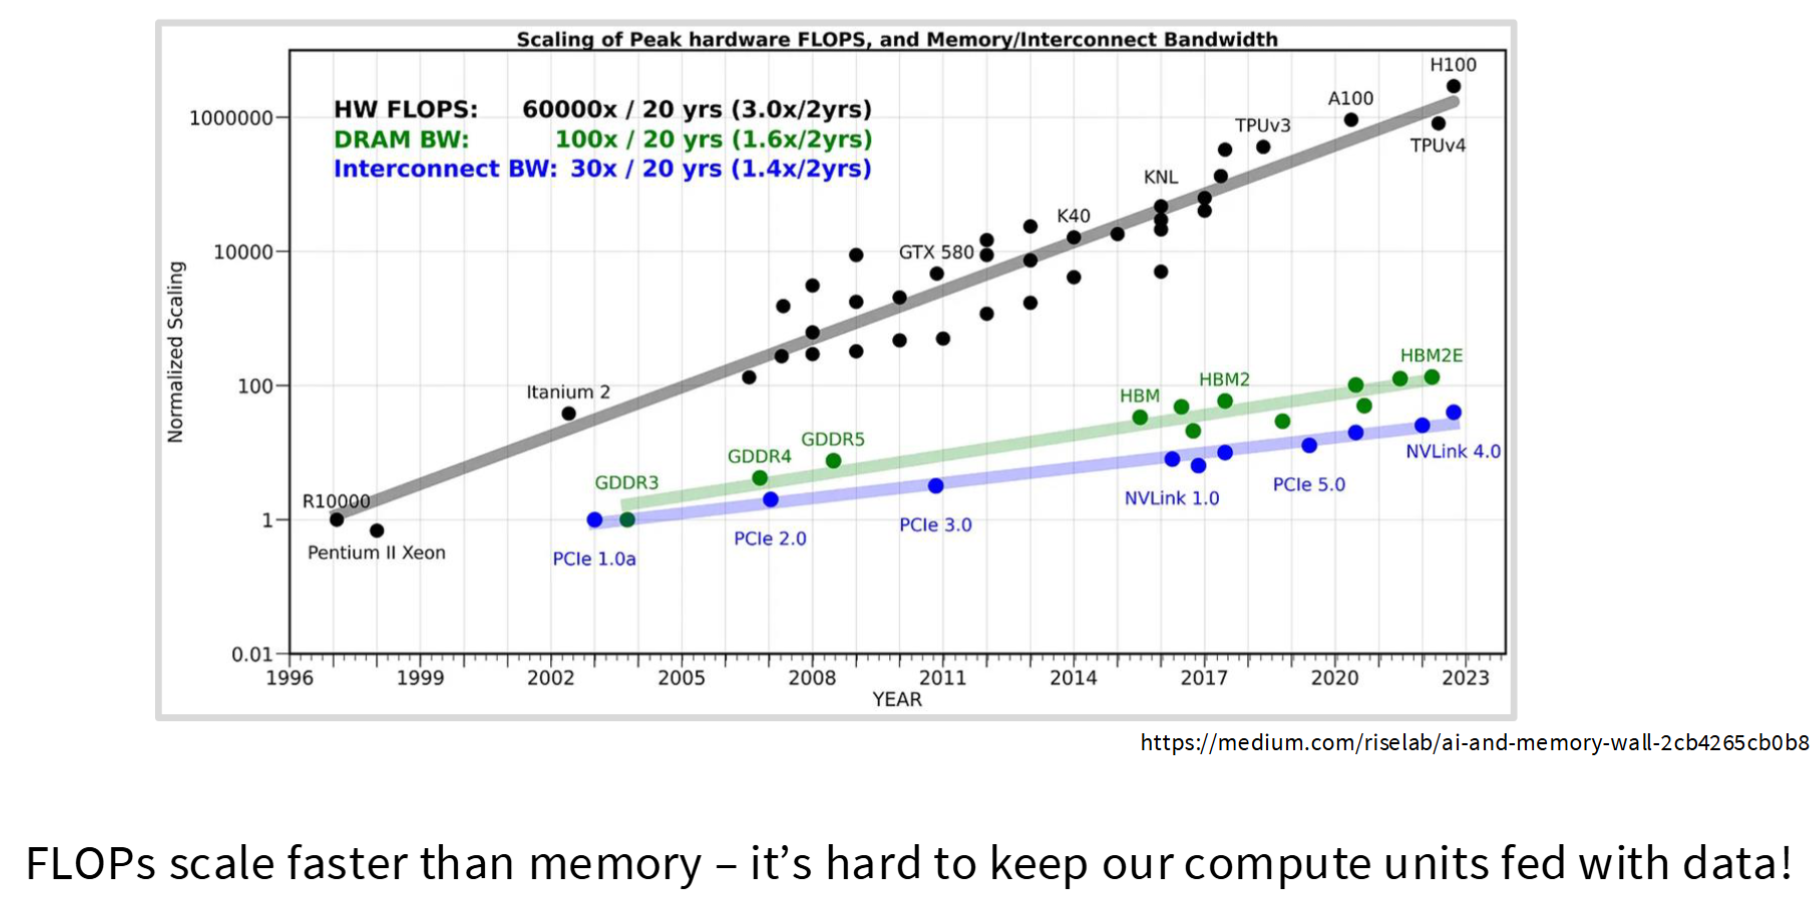
除了算力的发展,另一个重要趋势的是内存带宽的发展,图中灰线是计算吞吐的发展,蓝色和绿色是内存带宽,这是对数坐标轴,可以发现内存带宽的发展落后计算吞吐好几个数量级。
这意味着GPU上的优化,计算速度是远大于数据搬运速度的,核心思路是如何喂饱计算单元。这为后面的GPU优化思路埋下了伏笔。