认识堆
堆是一个完全二叉树,所谓完全二叉树,除最后一层,每一层都是满的,并且最后一层的节点必须全部靠左连续排列。
如下面的就算一个完全二叉树:
text
        1
       / \
      3   2
     /
    7
当然,下面这种也算完全二叉树:
text
        1
       / \
      3   2
     / \
    7   8
但是,下面这种不算,因为最后一层的节点 7 没有从最左边开始:
text
        1
       / \
      3   2
         /
        7
记忆口诀:完全二叉树 = "上面全满,下面靠左"。
如果任一节点的值大于等于其左右孩子,则叫大顶堆(大根堆),堆顶为最大值。如下面这棵完全二叉树就是大顶堆:
text
        10
       /  \
      8    5
     / \
    3   1
如果任一节点的值小于等于其左右孩子,则叫小顶堆(小根堆),堆顶为最小值。如下面这棵完全二叉树就是小顶堆:
text
        1
       / \
      3   2
     / \
    7   6
堆是实现优先队列的常用方法。
因为堆是完全二叉树,所以特别适合使用数组存储。将这个完全二叉树从上到下,从左到右按照顺序将节点一个一个地存储在数组里。数组在内存上是连续的。
例如这颗小顶堆:
text
        1
       / \
      3   2
     / \
    7   6
对应的数组就是:
text
[1, 3, 2, 7, 6]
 0  1  2  3  4
数组下标和树节点之间存在固定关系。
假设下标从 0 开始:
text
父节点:      (i - 1) / 2

左孩子:      2*i + 1

右孩子:      2*i + 2
例如节点 3:
text
数组:

[1, 3, 2, 7, 6]
    ↑
    i = 1
它的孩子:
text
左孩子 = 2*1 + 1 = 3 → 7
右孩子 = 2*1 + 2 = 4 → 6
因此,堆节点的存储不需要额外存储左右孩子节点的指针。堆中找父节点、左右孩子只需要计算下标:
go
parent := (i - 1) / 2
left   := 2*i + 1
right  := 2*i + 2
在 Go 语言中使用堆
在 go 语言中,提供了 container/heap 的堆实现。
要使用 container/heap 中的堆相关的方法,需要实现 go 语言中 heap.Interface 接口。
heap.Interface 接口的定义如下:
go
type Interface interface {
  sort.Interface
  Push(x any) // add x as element Len()
  Pop() any   // remove and return element Len() - 1.
}
其中 sort.Interface 的定义为:
go
type Interface interface {
  Len() int
  Less(i, j int) bool
  Swap(i, j int)
}
heap.Interface 接口的定义中
-
Push函数用于将元素x添加末尾; -
Pop函数用于删除并返回末尾元素。
sort.Interface 接口的定义中:
-
Len()函数返回堆中元素个数,相当于 JS 中的arr.length; -
Less(i, j)函数判断索引 i 处的元素是否应该排在索引 j 处的元素之前。它不一定表示数值更小,也可以用于自定义排序规则。 -
Swap(i, j)函数交换索引 i 和索引 j 处的元素。
在上面认识堆中说过,可以使用数组存储堆,因此,在 go 语言中,要使用堆,还需要定义切片,用于存储堆:
go
// 定义 int 类型的切片,类型名字为 IntHeap
type IntHeap []int
因此,在 Go 语言中,要使用堆,需要定义一个切片数据结构和实现 5 个方法:
go
// 切片数据结构
type IntHeap []int

// 要实现的 5 个方法
func (h IntHeap) Len() int           { /* 有几个元素 */ }
func (h IntHeap) Less(i, j int) bool { /* i 该排在 j 前面吗 */ }
func (h IntHeap) Swap(i, j int)      { /* 交换第 i、j 个 */ }
func (h *IntHeap) Push(x any)        { /* 放到末尾 */ }
func (h *IntHeap) Pop() any          { /* 删掉末尾元素并返回该元素 */ }
注意 Push / Pop 要用「指针接收者」,因为 Push / Pop 要修改 len ,如果是值接收者,你改的是副本的 len,函数返回后原切片毫无变化。
这里有实现小顶堆案例的完整代码:
go
// 小顶堆(min-heap)的最小可运行示例。
package main

import (
  "container/heap"
  "fmt"
)

// IntHeap 是小顶堆:堆顶((*h)[0])永远是当前最小值。
//
// 注意:heap.Interface 需要 5 个方法 ------
// Len/Less/Swap 来自 sort.Interface(值接收者),Push/Pop 是指针接收者
type IntHeap []int

func (h IntHeap) Len() int           { return len(h) }
func (h IntHeap) Less(i, j int) bool { return h[i] < h[j] } // ← 最小堆
func (h IntHeap) Swap(i, j int)      { h[i], h[j] = h[j], h[i] }

func (h *IntHeap) Push(x any) {
  *h = append(*h, x.(int)) // 只负责「放到末尾」,上浮由 heap.Push 完成
}

func (h *IntHeap) Pop() any {
  old := *h
  n := len(old)
  x := old[n-1] // 必须返回「最后一个」,不是 h[0]
  old[n-1] = 0  // 清空引用,帮助 GC
  *h = old[:n-1]
  return x
}

// 编译期断言:类型写错时立刻报错,而不是等到运行时 panic。
var _ heap.Interface = (*IntHeap)(nil)

func section(n int, title string) {
  fmt.Printf("\n=== %d. %s ===\n", n, title)
}

func main() {
  section(1, "基础用法:Init / Push / Pop(最小堆)")

  h := &IntHeap{5, 3, 8, 1} // 乱序数据
  fmt.Println("  原始切片     :", *h)
  fmt.Printf("  Init 之前堆顶 : %d(还不是最小值,此时不算堆)\n", (*h)[0])

  heap.Init(h) // O(n) 建堆
  fmt.Printf("  Init 之后 heap=%v  堆顶=%d\n", *h, (*h)[0])

  heap.Push(h, 2) // O(log n):末尾追加 + 上浮
  heap.Push(h, 0)
  fmt.Printf("  Push 2、0 之后 heap=%v  堆顶=%d\n", *h, (*h)[0])

  fmt.Print("  依次 Pop:")
  for h.Len() > 0 {
    fmt.Print(heap.Pop(h), " ")
  }
  fmt.Println("← 弹出顺序一定是升序")
}
上述代码的运行结果:
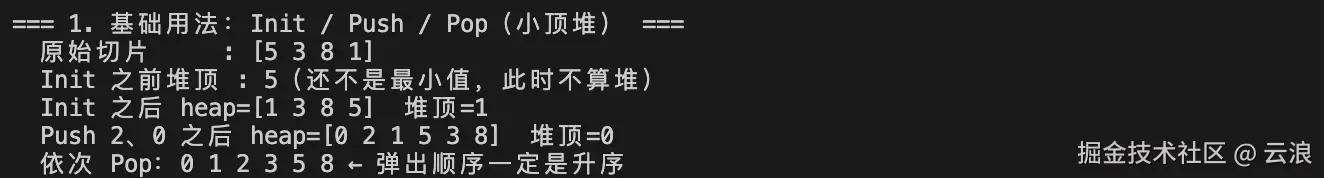
其中:
-
heap.Init -
heap.Push -
heap.Pop
都是标准库 container/heap 提供的方法。
heap.Init 方法的作用是建堆,把一段乱序数据原地整理成合法的堆。
heap.Push 方法的作用是把元素加入堆中。
heap.Pop 方法的作用是弹出堆顶元素。
案例 1:Top-K 问题
比如从 10 亿个数里找出最大的 3 个,内存装不下全部数据(只能流式读取)。
核心思路:维护 K 个元素的最小堆,堆顶就是这 K 个里最小的那个。新元素只要能比堆顶大,就说明它够格进入 Top-K,于是踢掉堆顶、换上新元素。
Top-K 案例的完整代码如下:
go
// Top-K(从一堆数里找出最大的 K 个)的最小可运行示例。
// 核心技巧:用「最小堆」维护当前最大的 K 个元素 ------ 堆顶就是这 K 个里最小的那个,
// 一旦遇到更大的数,就替换堆顶并 heap.Fix。复杂度 O(n log k),不需要全排序。
package main

import (
  "container/heap"
  "fmt"
)

// IntHeap 是最小堆:堆顶((*h)[0])永远是当前最小值。
type IntHeap []int

func (h IntHeap) Len() int           { return len(h) }
func (h IntHeap) Less(i, j int) bool { return h[i] < h[j] } // ← 最小堆
func (h IntHeap) Swap(i, j int)      { h[i], h[j] = h[j], h[i] }

func (h *IntHeap) Push(x any) {
  *h = append(*h, x.(int)) // 只负责「放到末尾」,上浮由 heap.Push 完成
}

func (h *IntHeap) Pop() any {
  old := *h
  n := len(old)
  x := old[n-1] // 必须返回「最后一个」,不是 h[0]
  old[n-1] = 0  // 清空引用,帮助 GC
  *h = old[:n-1]
  return x
}

// 编译期断言:类型写错时立刻报错,而不是等到运行时 panic。
var _ heap.Interface = (*IntHeap)(nil)

func section(n int, title string) {
  fmt.Printf("\n=== %d. %s ===\n", n, title)
}

func main() {
  section(2, "只读堆顶 & Top-K:用最小堆维护「最大的 K 个」")

  h := &IntHeap{}
  heap.Init(h)
  for _, v := range []int{42, 7, 19, 88, 3, 56} {
    heap.Push(h, v)
  }
  fmt.Printf("  堆顶(只看不弹,O(1) 且不改变堆)= %d,堆大小仍为 %d\n", (*h)[0], h.Len())

  nums := []int{42, 7, 19, 88, 3, 56, 91, 23}
  fmt.Printf("  nums=%v\n  最大的 3 个 = %v\n", nums, topK(nums, 3))
}

// topK 返回 nums 中最大的 k 个(降序)。
//
// 技巧:用「最小堆」维护当前最大的 k 个元素 ------ 堆顶就是这 k 个里最小的那个。
// 一旦遇到更大的数,就替换堆顶并 Fix。复杂度 O(n log k),不需要全排序。
func topK(nums []int, k int) []int {
  if k <= 0 || len(nums) == 0 {
    return nil
  }

  h := &IntHeap{}
  heap.Init(h)

  for _, n := range nums {
    if h.Len() < k {
      heap.Push(h, n)
      continue
    }
    if n > (*h)[0] { // 比「K 个里最小的」还大 → 踢掉它
      (*h)[0] = n // 直接改堆顶,再修复堆序
      heap.Fix(h, 0)
    }
  }

  out := make([]int, 0, h.Len())
  for h.Len() > 0 {
    out = append(out, heap.Pop(h).(int)) // 弹出是升序
  }
  for i, j := 0, len(out)-1; i < j; i, j = i+1, j-1 {
    out[i], out[j] = out[j], out[i] // 反转成降序
  }
  return out
}
运行结果:

heap.Fix() 方法是 Go 语言标准库提供的方法,作用是当堆中某个元素的值发生变化后,重新调整堆结构,让它继续满足堆的性质。
案例 2:任务调度器
堆(Heap)是实现优先队列的常用方式。
实际开发中有多个不同优先级的任务时,可以将这些任务构造成优先级队列,然后依据不同的优先级出队执行任务。
任务调度器案例的完整代码如下:
go
// 优先级队列(Priority Queue):container/heap 最经典的用途。
//
//(Enqueue / Dequeue / Peek / Update / Cancel),使用方不必直接接触 container/heap。

package main

import (
  "container/heap"
  "fmt"
  "strings"
)

// Item 是队列中的一个元素。
//
// Value 是业务载荷(任务名、工单号、订单 ID......);Priority 是优先级,
// **数字越大越先被处理**。
type Item struct {
  Value    string
  Priority int
  index    int // 在堆中的下标,由 heap.Interface 的实现维护;-1 表示不在堆中
}

// PriorityQueue 是 Item 的优先队列,堆顶((*pq)[0])永远是优先级最高的元素。
type PriorityQueue []*Item

func (pq PriorityQueue) Len() int { return len(pq) }

// Less 决定「谁排前面」,也就是「谁先出队」。
//
// ⚠️注意这里用的是 `>` 而不是 `<`:
// container/heap 弹出的是 Less 意义上的「最小元素」,我们让「优先级大」等价于「更小」,
// 于是堆顶就成了优先级最高的元素 ------ 这就把小顶堆变成大顶堆了。
func (pq PriorityQueue) Less(i, j int) bool {
  return pq[i].Priority > pq[j].Priority
}

// Swap 是堆算法唯一会移动元素的地方(上浮/下沉都靠它),
// 所以反向索引只需要在这一个地方维护。
func (pq PriorityQueue) Swap(i, j int) {
  pq[i], pq[j] = pq[j], pq[i]
  pq[i].index = i
  pq[j].index = j
}

// Push 只负责「放到末尾」,上浮由 heap.Push 完成。
func (pq *PriorityQueue) Push(x any) {
  n := len(*pq)
  item := x.(*Item)
  item.index = n
  *pq = append(*pq, item)
}

// Pop 只负责「删掉末尾并返回」,下沉由 heap.Pop 完成。
func (pq *PriorityQueue) Pop() any {
  old := *pq
  n := len(old)
  item := old[n-1]
  old[n-1] = nil  // 元素是指针,置 nil 才能让被删元素被 GC 回收
  item.index = -1 // 标记「已不在堆中」,Update/Cancel 据此判断
  *pq = old[:n-1]
  return item
}

// 编译期断言:签名写错时立刻报错,而不是等到运行时 panic。
var _ heap.Interface = (*PriorityQueue)(nil)

// ---------------------------------------------------------------- 业务 API

// Enqueue 入队。
func (pq *PriorityQueue) Enqueue(item *Item) {
  heap.Push(pq, item)
}

// Dequeue 出队(优先级最高者)。队列为空时返回 nil。
func (pq *PriorityQueue) Dequeue() *Item {
  if pq.Len() == 0 {
    return nil
  }
  return heap.Pop(pq).(*Item)
}

// Peek 只看队首(优先级最高者),不改变队列。空队列返回 nil。
func (pq *PriorityQueue) Peek() *Item {
  if pq.Len() == 0 {
    return nil
  }
  return (*pq)[0]
}

// Update 修改优先级并修复堆序。
//
// ⚠️ 直接写 item.Priority = x 而不调用本方法,堆序会被破坏(静默出错):
// 元素在数组里的位置没变,但它和父/子的大小关系可能已经不成立了。
func (pq *PriorityQueue) Update(item *Item, priority int) {
  item.Priority = priority
  heap.Fix(pq, item.index) // 比 Remove + Push 便宜
}

// Cancel 把某个元素从队列中移除。O(log n)
//
// 返回 false 表示它已经不在队列中(已出队或已被取消)。
func (pq *PriorityQueue) Cancel(item *Item) bool {
  // 用「下标有效 + 指针身份一致」双重校验,避免误删别人
  if item.index < 0 || item.index >= pq.Len() || (*pq)[item.index] != item {
    return false
  }
  heap.Remove(pq, item.index)
  return true
}

// dump 打印堆的内部数组(注意:这是堆序,不是优先级顺序)。
func dump(label string, pq *PriorityQueue) {
  parts := make([]string, 0, pq.Len())
  for _, it := range *pq {
    parts = append(parts, fmt.Sprintf("%s(p=%d,idx=%d)", it.Value, it.Priority, it.index))
  }
  fmt.Printf("  %s: [%s]\n", label, strings.Join(parts, ", "))
}

func section(n int, title string) {
  fmt.Printf("\n=== %d. %s ===\n", n, title)
}

func main() {
  section(3, "优先级队列:数字越大越先处理")

  taskA := &Item{Value: "任务A", Priority: 3}
  taskB := &Item{Value: "任务B", Priority: 1}
  taskC := &Item{Value: "任务C", Priority: 5}
  taskD := &Item{Value: "任务D", Priority: 2}
  taskE := &Item{Value: "任务E", Priority: 4}

  // ① 批量建堆:模拟「从数据库恢复一批待办任务」
  pq := make(PriorityQueue, 0, 5)
  for i, it := range []*Item{taskA, taskB, taskC} {
    it.index = i // ⚠️ 直接批量建堆时必须自己把下标设对,否则 Update/Cancel 会定位错元素
    pq = append(pq, it)
  }
  heap.Init(&pq) // O(n) 原地建堆,比逐个 Push 的 O(n log n) 更快
  dump("批量建堆 A=3 B=1 C=5", &pq)

  // ② 逐个入队
  pq.Enqueue(taskD)
  pq.Enqueue(taskE)
  dump("入队 D=2 E=4 后    ", &pq)

  // ③ Peek:只看不弹,O(1)
  if top := pq.Peek(); top != nil {
    fmt.Printf("队首(只看不弹)= %s(优先级 %d)\n", top.Value, top.Priority)
  }

  // ④ 动态提升优先级:A 从 3 提到 6,一次 Fix 归位
  pq.Update(taskA, 6)
  top := pq.Peek()
  fmt.Printf("A 的优先级 3 → 6,队首变为 %s(优先级 %d)\n", top.Value, top.Priority)

  // ⑤ 取消任务
  fmt.Printf("取消 D(优先级 %d)→ %v\n", taskD.Priority, pq.Cancel(taskD))
  fmt.Printf("   再取消一次 D → %v(已不在队列中,幂等返回 false)\n", pq.Cancel(taskD))

  // ⑥ 依次出队:优先级高的先出
  fmt.Print("依次出队:")
  for it := pq.Dequeue(); it != nil; it = pq.Dequeue() {
    fmt.Printf("%s(p=%d) ", it.Value, it.Priority)
  }
  fmt.Println()

  // ⑦ 空队列是安全的
  fmt.Printf("队列已空:Peek()=%v  Dequeue()=%v  Len()=%d\n", pq.Peek(), pq.Dequeue(), pq.Len())
}
运行结果:
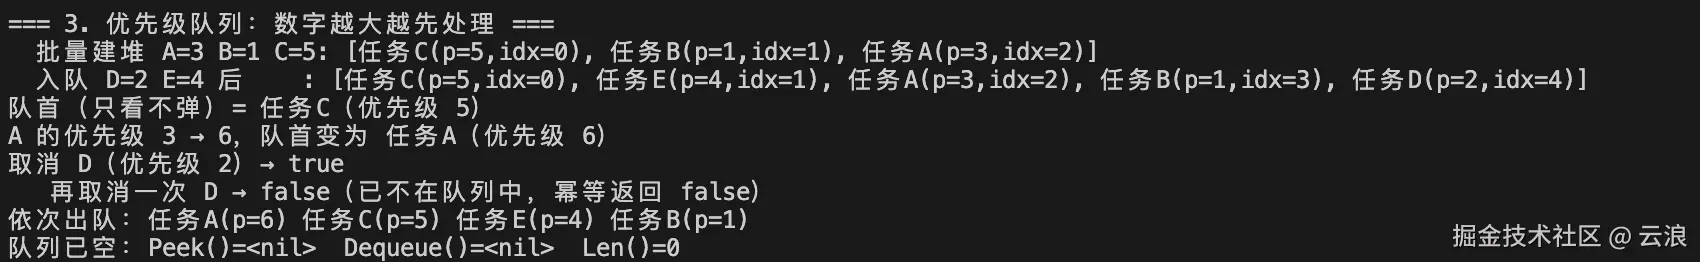
heap.Remove() 方法是 Go 语言标准库提供的方法,作用是删除堆中指定索引位置的元素,同时维护堆的结构和堆序性,并返回被删除的元素。
总结
堆本质上是用数组存储的完全二叉树 :节点之间不需要指针,靠 parent = (i-1)/2、left = 2*i+1、right = 2*i+2 三个公式就能定位。
Go 采用接口 + 组合 的设计:heap.Interface 组合了 sort.Interface,所以我们只要为自己的切片类型实现 Len、Less、Swap、Push、Pop 这 5 个方法,就能复用标准库的建堆与堆化算法(Init、 上浮/下沉)。
其中 Less 是唯一决定"谁先出队"的方法------写 < 是小顶堆,写 > 就是大顶堆,这也是堆能灵活支撑不同业务优先级的关键。
只要掌握了这套接口,就能轻松实现优先队列 、Top-K 、任务调度等场景。