自动数据库索引压缩合并
一直以来,我们都习惯在 SQL Server数据库实例中部署一项固定任务:夜间或每周执行一次索引维护作业。我们先检查索引碎片率,碎片率介于5%~30%时执行索引重组(REORGANIZE),高于30%则执行索引重建(REBUILD),并且寄希望于该作业能够在业务日开始前执行完毕。当然,索引管理也没有一套通用的标准方案。有人也会使用Ola Hallengren的索引与统计信息维护脚本https://ola.hallengren.com/sql-server-index-and-statistics-maintenance.html
微软在2026年年初推出了一项新功能,该功能目前还在公开预览阶段:自动数据库索引压缩合并(automatic index compaction) 。数据库引擎会在数据发生变更时,于后台自动完成索引压缩合并工作,无需人工维护作业、无需预留维护窗口、也不用维护脚本。
它能够解决哪些问题?
自动索引压缩,是微软针对索引维护作业这一常规运维任务给出的合适解法。
传统索引维护作业存在如下痛点:
- CPU 和 I/O 开销巨大:索引重建需要读取并重写整个索引
- 执行耗时长,而可用的维护窗口持续缩短
- 会生成大量事务日志,对日志备份与 Always On 复制链路造成影响
- 可能阻塞业务应用:离线重建会锁定整张表;即便是在线重建,在任务起始与结束阶段也需要短暂的排他锁
- 需要专人部署、监控,作业失败时还要排查修复
还有一个不太容易被察觉的问题:多年来,这类维护作业一直在针对错误指标做优化
使用前提
该功能目前处于公开预览,只支持部署在以下数据库服务:
- Azure SQL 数据库
- Azure SQL 托管实例(需开启Always-up-to-date更新策略)
- Microsoft Fabric 中的 SQL 数据库
本地部署版 SQL Server(包括 SQL Server 2025)暂不支持该功能。
无需额外安装组件。该功能依托数据库引擎已在运行的后台线程(ADR 清理线程)实现;并且 Azure SQL 数据库、Azure SQL 托管实例、Fabric SQL 数据库均默认开启加速数据库恢复(Accelerated Database Recovery,ADR)。
内部碎片与外部碎片
谈及索引碎片时,实际上包含两种完全不同的现象。二者可通过 sys.dm_db_index_physical_stats 里两个不同字段进行度量,成因各不相同,最重要的是二者带来的性能开销差异巨大。
数据文件的组织形式
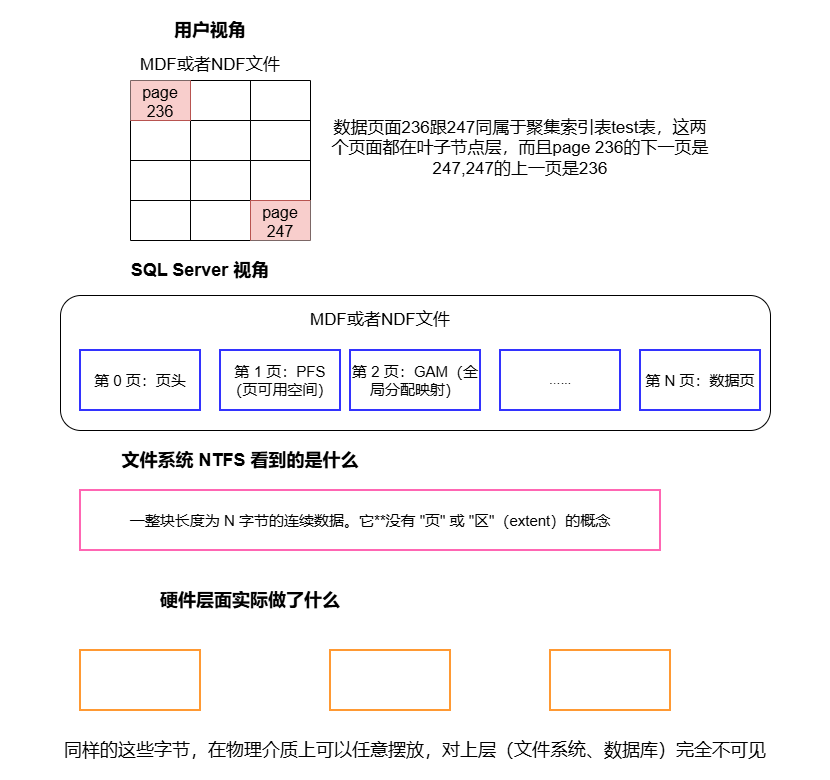
想要理解碎片,先要搞清楚 SQL Server 如何看待数据文件。
对普通程序而言,文件就是操作系统提供给程序的字节数组:字节0、字节1、字节2,依此类推。程序读取文件就是请求一段连续范围:文件偏移量 + 读取长度。
SQL Server 将这一字节数组切分为8KB大小,8KB大小就是一个数据页 。第N号页,对应的字节范围就是 N × 8192 至 (N+1) × 8192 − 1。页ID不只是一个标识,它是文件内的地址。
文件底层的所有存储层(NTFS簇、SSD、SAN卷)都由存储栈做地址转换并对数据库屏蔽。
下文中提到的物理顺序 ,均指数据文件内部的数据页排列顺序,而非硬件磁盘上的实际存放位置。
碎片形态
1. 内部碎片:数据页没有填满
内部碎片指索引的数据页中存在空闲空间。可通过avg_page_space_used_in_percent(平均页空间使用率百分比)衡量,该指标也叫页密度。
内部碎片从何产生?
- delete语句删除操作,尤其是零散删除:数据行被移除,但数据页仍然保留。
- 页拆分:当一个数据页已满,在键值区间中间位置执行插入,或是更新操作导致行长度变大时,会把约一半的数据行迁移到新分配的数据页上。拆分后的两个页面的填充程度大约都只有 50%。
- 会缩短变长列长度的更新操作。
- 难以紧凑存放的大行长行:一行数据 5000 字节,意味着每页只能存一行,每页会固定有约 38% 的空间被浪费。
注意:存在一部分空闲空间一般属于正常现象,有的甚至是刻意预留的:填充因子(fill factor)预留的空间就是人为制造的内部碎片,目的是承接后续的插入操作,避免触发页拆分。
内部碎片是什么表现?
CREATE DATABASE DemoFrag
GO

ALTER DATABASE DemoFrag SET RECOVERY SIMPLE
GO

USE DemoFrag
GO

CREATE TABLE dbo.SplitDemo (
    Id      int NOT NULL CONSTRAINT PK_SplitDemo PRIMARY KEY CLUSTERED,
    Payload varchar(8000) NOT NULL
);

-- 2 lines about 4000 bytes per page
INSERT INTO dbo.SplitDemo VALUES
(1, REPLICATE('A', 4000)), (2, REPLICATE('B', 4000));
页面几乎已满: 
为什么它会产生开销?
因为同样的数据行分散到了多于必要数量的数据页上,SQL Server 的所有操作都以数据页为单位:缓冲池缓存的是数据页,而不是数据行。填充密度为 40% 的数据页,会浪费其所占内存的 60%。无论是逻辑读还是物理读,
1.读取相同数据都需要处理更多的数据页。
2.备份文件体积更大
3.数据库完整性校验耗时更久。
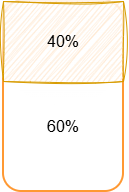
重点在于:内部碎片会随数据存在于各处,包括内存中。它会持续占用内存、I/O 和 CPU 资源,而外部碎片则并非如此。
2. 外部碎片:页偏移量不再遵循逻辑顺序
在B树的叶子层级,数据页按照索引键的顺序串联成链表,每个页面的页头中保存两个指针(m_nextPage、m_prevPage)。这条链表就是逻辑顺序,它本身不会出错:根据索引定义,该顺序就是键值的排序顺序。
**外部碎片(也叫逻辑碎片)**指的是:顺着这条链表遍历页,不再等同于按顺序读取磁盘文件。数据页在逻辑上有序,但它们在文件内的偏移位置是无序的。它分为两种形态:
- 空洞:索引的数据页不处于连续偏移位置,中间夹杂着其他对象的数据页或者空闲页。
- 乱序:页的偏移位置是连续的,但链表的前后顺序和物理位置顺序不一致。
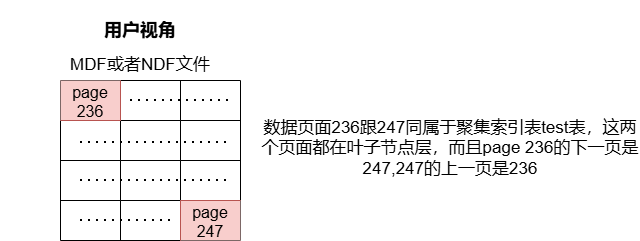
页236和页247之间的空间就是属于test表的空洞
avg_fragmentation_in_percent字段只统计这两种碎片,不做区分。
fragment_count 和 avg_fragment_size_in_pages 这两个指标才是反映实际开销:它们用来度量连续页块的长度。
外部碎片从何而来?
- 多个对象同时扩容:数据库引擎按照分配请求的先后顺序分配区,因此不同对象的页在文件里交错分布,这是数据库运行中的常态。
- 页拆分(Page Split):新页会在能找到空闲空间的位置分配,很少分配在原页旁边。
- 页释放:大量删除操作,以及索引自动压缩本身,都会造成页释放。
具体效果是怎样的?
USE DemoFrag
GO
CREATE TABLE dbo.SplitDemo (
    Id      int NOT NULL CONSTRAINT PK_SplitDemo PRIMARY KEY CLUSTERED,
    Payload varchar(8000) NOT NULL
);
-- 每页存放两行,每行约4000字节:第1、2行在1个页,3、4行在下一个页
INSERT INTO dbo.SplitDemo
VALUES (1, REPLICATE('A', 4000)), (2, REPLICATE('B', 4000)),
       (3, REPLICATE('C', 4000)), (4, REPLICATE('D', 4000))

-- 查看行位置(文件号:页号:槽号)
SELECT Id, sys.fn_PhysLocFormatter(%%physloc%%) AS physical_location
FROM dbo.SplitDemo;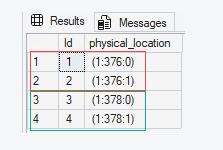
表的前两行数据位于376号页,后两行位于378号页。
那377号页里面存了什么?为什么页不是连续的?
因为这张表在Id列上建有聚集索引,所以表以B树数据结构存储。我们查看一下这个B树的分配情况
SELECT allocated_page_page_id, page_type_desc, page_level, previous_page_page_id, next_page_page_id
FROM sys.dm_db_database_page_allocations(DB_ID(), OBJECT_ID('dbo.SplitDemo'),1, NULL, 'DETAILED');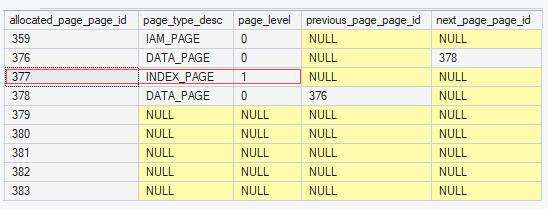
很明显可以看到377是索引中间节点页面
页面内部数据
SELECT * FROM sys.dm_db_page_info (10, 1, 376, DEFAULT);
SELECT * FROM sys.dm_db_page_info (10, 1, 378, DEFAULT);
执行下面操作进而引发外部碎片的页拆分:
-- 触发页拆分
UPDATE dbo.SplitDemo SET Payload = REPLICATE('B', 4100) WHERE Id = 2;

-- 查看页填充密度
SELECT index_level, page_count, avg_page_space_used_in_percent, avg_fragmentation_in_percent, record_count, ghost_record_count, version_ghost_record_count
FROM sys.dm_db_index_physical_stats(DB_ID(), OBJECT_ID('dbo.SplitDemo'),1, NULL, 'SAMPLED')
WHERE alloc_unit_type_desc = 'IN_ROW_DATA';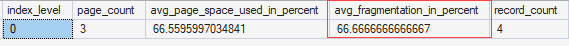
页拆分之后: 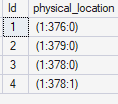
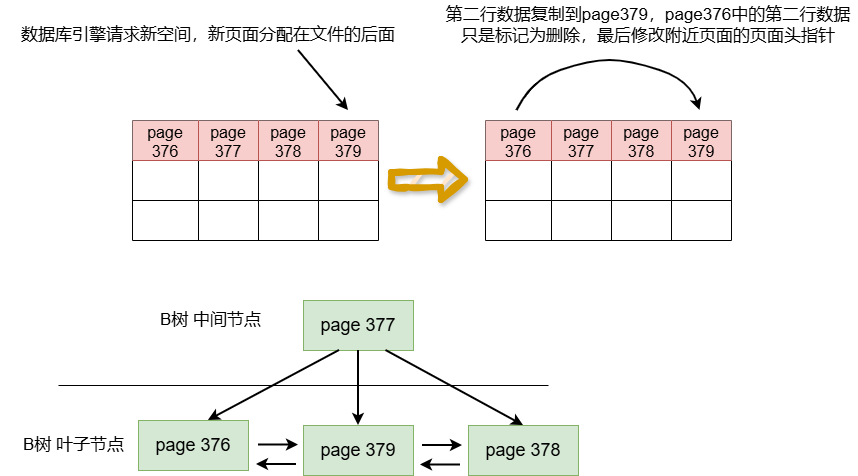
第1行数据位于376号页面
第2行数据位于379号页面
第3行数据位于378号页面
第4行数据位于378号页面 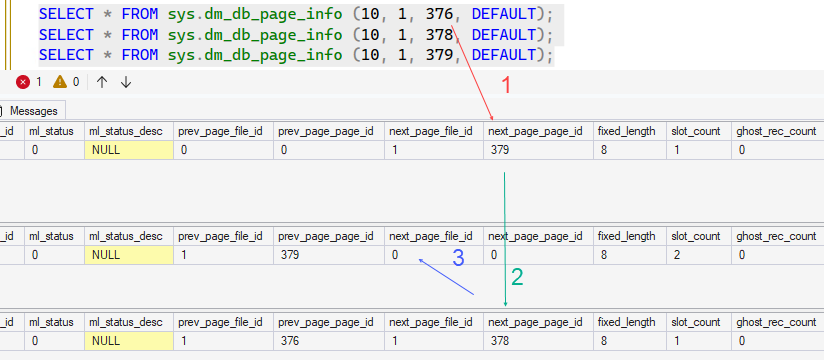
数据库引擎请求新空间,新页面分配在文件的后面,第二行数据复制到第379页,相应的页头指针也要修改,所以一次页拆分往往涉及到几个页面
为什么如今外部碎片带来的开销已经很小?
预读(read-ahead)机制可以很好的降低外部碎片产生的性能损耗。扫描索引时,数据库引擎会通过大规模I/O预取数据页,一次I/O读取文件中一段连续范围:一个起始偏移量、一个长度,最大可达512KB。索引页连续时,一次I/O就能读取64个数据页;如果不连续,同样一批表数据页就要通过多次更小的I/O读取。
- 零散I/O会在什么时候产生明显负面影响?必须同时满足三个条件:
- 数据为冷数据:页如果已经在缓冲池中,完全不会产生物理I/O;
- 查询操作是大范围扫描:索引查找是依靠页ID遍历B树,并不关心数据页的物理顺序;
- 每多一次物理I/O都要付出可观耗时。
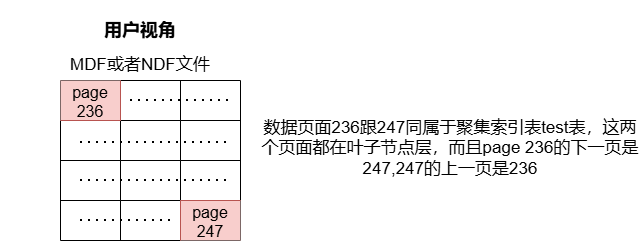
从用户最直接的视角来看,如果页面号距离相差太大,一次预读可能覆盖不到所需要的结果页面(假如预读只读取了page178到page242 总共64个页面),但是结果页面需要page247,那么就需要再增加一次物理读把所需页面读进内存。
在SSD、NVMe以及ESSD云盘云存储上,新增一次物理I/O通常只需要数十微秒,而且文件下层的物理存放位置本身就是不固定的(SSD固态硬盘控制器、SAN存储局域网可以随意放置数据块)。 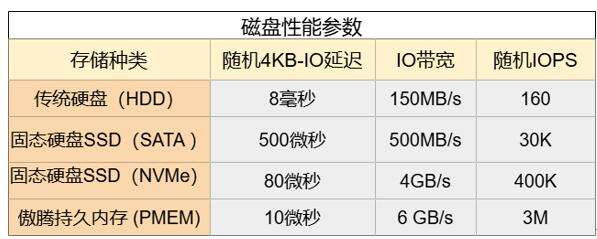
外部碎片指标至今仍被关注是因为还有另一个原因:它是一个很好的信号指标。外部碎片增多往往源于页拆分,而页拆分又会降低页填充密度(增加内部碎片)、放大数据库事务日志的写入量。
为什么索引碎片的影响不像以前那么大了?
逻辑碎片在机械硬盘时代是个难题,对存在碎片的索引执行有序扫描时,预读机制会被拆分成多次小规模I/O,每一次地址跳转都需要移动磁头。而在SSD、NVMe和云存储上,非顺序读取带来的性能损耗几乎微乎其微。另外,我们过去费心维护的"物理顺序",仅仅是数据库数据文件内部数据页的顺序;在这一层之下,文件系统、SSD控制器以及存储层可以随意存放数据块。
对应关系:
-
内部碎片 = 页填充密度 (AIC功能可以处理这种问题)
-
外部碎片 = 页的逻辑顺序 (AIC功能无办法处理,甚至可能造成更多外部碎片)
索引自动压缩AIC的工作原理是什么?
索引自动压缩并不是一个独立的隐藏维护任务,它的功能由一个已有的后台线程额外承担:PVS清理器是加速数据库恢复(ADR) 的其中一个组件。要提醒的是,即使不开启ADR功能PVS清理器线程默认也会启动。
核心原理
PVS清理器会定期访问近期发生过修改(插入、更新、删除)的数据页,清理过时的行版本(如果开启了ADR功能)。 当开启索引自动压缩时,该清理器还会检查当前访问页是否存在空闲空间(fill factor填充因子预留的空间除外)。 如果有空闲空间,它会把下一页的数据行迁移到当前页,只要能容纳数据行就会持续不断执行,并且会对几组连续的页面重复执行该操作。 如果某个页面因此变为空页,就会释放该页面。
达到的效果: 数据页数量减少、页填充密度提升,存储空间、I/O、CPU以及缓冲池的资源消耗随之下降。
索引自动压缩的运行机制开销极低,因为它只处理近期被修改过的页面;索引重建或索引重组则会处理全部页面,二者不一样。和索引重组类似,索引自动压缩操作也会获取短期的页排他锁来迁移数据行。如果无法立刻获取锁,就先跳过该页面,后续再尝试处理。
一条命令即可开启,无需重启数据库,不需要独占访问。压缩操作在几分钟内就会启动。
-- Enable the feature
ALTER DATABASE [SQL-DB-1] SET AUTOMATIC_INDEX_COMPACTION = ON;

-- Check if it's enabled
SELECT name, is_automatic_index_compaction_on FROM sys.databases;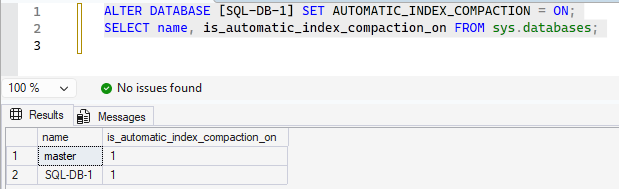
开启该功能前有一个重点需要注意
PVS清理器线程只处理开启功能之后发生修改的数据页。如果你的索引当前页填充密度已经很低,可能需要先执行一次索引重组或索引重建来修复存量问题。在此之后,自动压缩机制会持续维持索引的紧凑状态,无需人工干预。
演示流程
- 创建一张带聚集主键的表,并插入500万行数据
- 采集基准指标:页数量、页填充密度、碎片程度
- 删除三分之二的数据行,删除操作分散在整张表中,以此模拟索引膨胀
- 再次采集指标,然后等待数据库引擎执行索引自动压缩
我们先建表,插入5万行数据:
CREATE TABLE dbo.Demo (
    Id      int IDENTITY CONSTRAINT PK_Demo PRIMARY KEY CLUSTERED,
    Payload char(400) NOT NULL DEFAULT REPLICATE('X', 400)
);

INSERT INTO dbo.Demo (Payload)
SELECT TOP (50000) REPLICATE('X', 400)
FROM sys.all_columns a CROSS JOIN sys.all_columns b;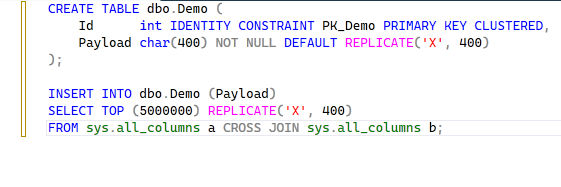
采集基准指标:
SELECT index_level, page_count, avg_page_space_used_in_percent,
       avg_fragmentation_in_percent, record_count
FROM sys.dm_db_index_physical_stats(DB_ID(), OBJECT_ID('dbo.Demo'),1, NULL, 'SAMPLED')
WHERE alloc_unit_type_desc = 'IN_ROW_DATA';
此时内部碎片水平较低。 得到的结果如下: 
当前数据库中的页面类似于下面这样,比较稠密 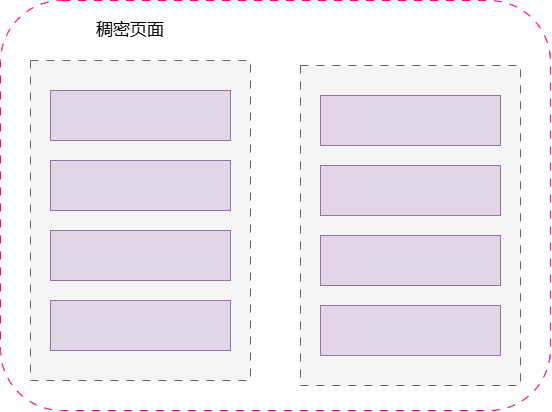
人为制造索引膨胀
我们删除表中三分之二的数据行,删除记录均匀分布在整张表里。没有任何数据页变为空页,每个页面大约只保留三分之一的数据行,页填充密度随之下降:
DELETE FROM dbo.Demo WHERE Id % 3 <> 0;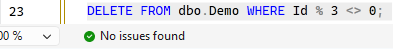
如果没有开启索引自动压缩AIC,页面数量维持在2778(单纯delete删除不会释放非空数据页),页密度降至约31%(94.93%的三分之一),数据行只剩下16666行。
再次采集指标 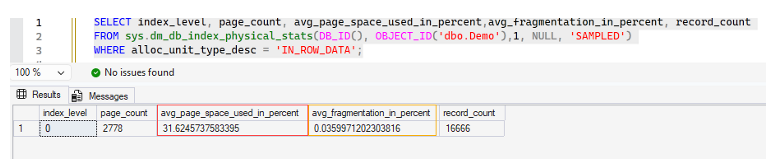
当前数据库中的页面类似于下面这样,比较稀疏 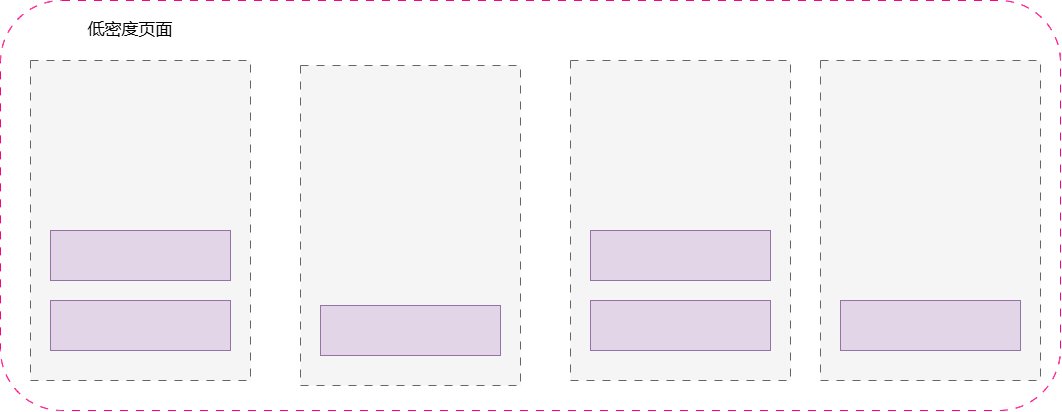
这时候开启索引自动压缩AIC功能,等待数据库引擎完成后台处理,再次核查指标  数据库在全程正常对外提供服务的同时,由后台数据库引擎完成索引压缩合并工作。 可以看到页面数量减少到929,页密度增加约94%,数据行依然是16666行。
目前的一些限制
-
自动数据库索引压缩合并功能不会更新统计信息。索引重建会更新统计信息,如果你原本依靠索引重建任务更新统计信息,仍然需要保留统计信息更新任务。
-
它无法降低外部碎片(逻辑碎片),正如演示中所见,外部碎片甚至可能升高。对绝大多数业务负载而言,不会产生可观测的性能影响。
-
它不会重新生成填充因子预留的空闲空间,只有索引重建任务才会。对于需要将填充因子设置为小于100%以减少页拆分的业务场景,仍然需要不定期执行索引重建任务。
-
它不会收缩数据文件。数据的已使用空间会减少,但数据文件的已分配大小保持不变。
-
该功能仅适用于行内数据(IN_ROW_DATA)分配单元中B树索引的叶子层级。堆表、大对象(LOB)数据、行溢出数据、已压缩的列存储行组以及内存优化表均不在支持范围内。
-
禁用页锁(ALLOW_PAGE_LOCKS = OFF)的索引无法使用该功能。
-
目前我们依然需要 Ola Hallengren 脚本或是自研的运维方案,Ola Hallengren脚本原本是同时维护索引 + 统计信息。由于自动数据库索引压缩合并功能并不维护统计信息,如果不执行单独的统计信息维护作业,后续很可能会出现性能问题。
参考
本文版权归作者所有,未经作者同意不得转载。