随机测试容易给人留下无脑蛮干的印象,它在摸进测试输入空间的大门之后,便彻底放飞自我,把理想和现实全部抛诸脑后。这种略显稚拙的方法似乎难登大雅之堂,Myers就曾说过:"最差劲的测试用例设计方法,可能就是随机选取测试输入了......"
相对而言,分割测试则要成熟稳重得多。它全面细致地分析被测对象期望和实现结构,进而将测试输入空间分割成一系列子空间,从每个子空间中挑选用例。如果能够分割出同质子空间,那么只需要从其中任选一个测试输入点作为代表。但这样的要求过于苛刻,工程实践上一般会在子空间里多选一些点,以提高检出缺陷的概率。
可见,分割测试不仅利用了更多信息,设计上也相对精致。直觉来讲,其缺陷检出能力应该会明显优于随机测试。事实真的如此吗?
假设在某个期望的测试输入空间中,被测对象的预期失效率为θθθ。也就是说,采用基于事件分布列的随机测试,每个用例触发失效的概率均为θθθ。设随机测试集的用例数为n ,则n 个用例都没有检出缺陷的概率为(1−θ)n\left(1−θ\right)^{n}(1−θ)n,至少检出一个缺陷的概率为Pr=1−(1−θ)nP_{r}=1−\left(1−θ\right)^{n}Pr=1−(1−θ)n。
另一方面,考虑采用分割测试的情况。假设测试输入空间被分割为k个子空间D1,D2,...,DkD_{1},D_{2},...,D_{k}D1,D2,...,Dk,被测对象在子空间DiD_{i}Di中的预期失效率为θiθ_{i}θi,分割测试在DiD_{i}Di中选取nin_{i}ni个用例,则在整个测试输入空间中至少检出一个缺陷的概率为Pp=1−∏i=1k(1−θi)niP_{p}=1−\prod_{i=1}^{k}\left(1−θ_{i}\right)^{n_{i}}Pp=1−∏i=1k(1−θi)ni。
整个测试输入空间的失效率θθθ与子空间的失效率θiθ_{i}θi之间存在如下关联:如果基于事件分布列从整个测试输入空间中选取的随机测试用例落入子空间DiD_{i}Di的概率为pip_{i}pi,则有θ=∑i=1kpiθiθ=\sum_{i=1}^{k}p_{i}θ_{i}θ=∑i=1kpiθi。因此,Pr=1−(1−θ)n=1−(1−∑i=1kpiθi)nP_{r}=1−\left(1−θ\right)^{n}=1−\left(1−\sum_{i=1}^{k}p_{i}θ_{i}\right)^{n}Pr=1−(1−θ)n=1−(1−∑i=1kpiθi)n。
以上述分析为基础,有学者开展了一系列模拟实验。结果表明,PrP_{r}Pr和PpP_{p}Pp并不存在一致的大小关系,统计指标上的差距非常小:
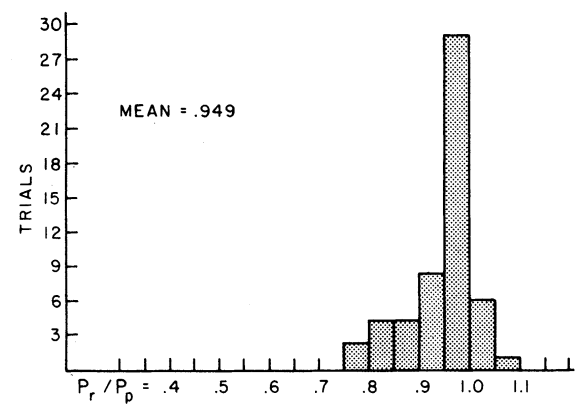
这样的结果有些出人意料。考虑到分割测试在设计环节的难度和成本,就性价比而言,随机测试反而更具竞争力。
下面这个例子,可以更直观地比较分割测试和随机测试的缺陷检出能力。
假设测试输入空间中共有100个测试输入点,其中8个可以揭示缺陷,即θ=0.08θ=0.08θ=0.08。随机测试和分割测试可选的用例数都是2个,因此Pr=1−(1−θ)n=1−0.922=0.15P_{r}=1−\left(1−θ\right)^{n}=1−0.92^{2}=0.15Pr=1−(1−θ)n=1−0.922=0.15。分割测试将测试输入空间分割为2个子空间,从每个子空间中选取1个用例,即k=2k=2k=2,n1=n2=1n_{1}=n_{2}=1n1=n2=1。
- 情况1:设两个子空间中的测试输入点数相同,即d1=d2=50d_{1}=d_{2}=50d1=d2=50。子空间D1D_{1}D1和D2D_{2}D2中均包含4个可揭示缺陷的测试输入点,因此θ1=θ2=4/50=0.08θ_{1}=θ_{2}=4/50=0.08θ1=θ2=4/50=0.08。此时有Pp=1−∏i=1k(1−θi)ni=1−0.922=0.15=PrP_{p}=1−\prod_{i=1}^{k}\left(1−θ_{i}\right)^{n_{i}}=1−0.92^{2}=0.15=P_{r}Pp=1−∏i=1k(1−θi)ni=1−0.922=0.15=Pr,即分割测试和随机测试的缺陷检出能力相同;
- 情况2:设d1=92d_{1}=92d1=92,d2=8d_{2}=8d2=8。子空间D2D_{2}D2中包含全部8个可揭示缺陷的测试输入点,因此θ1=0θ_{1}=0θ1=0,θ2=8/8=1θ_{2}=8/8=1θ2=8/8=1。此时有Pp=1−∏i=1k(1−θi)ni=1>PrP_{p}=1−\prod_{i=1}^{k}\left(1−θ_{i}\right)^{n_{i}}=1>P_{r}Pp=1−∏i=1k(1−θi)ni=1>Pr,即分割测试的缺陷检出能力优于随机测试;
- 情况3:设d1=1d_{1}=1d1=1,d2=99d_{2}=99d2=99。子空间D2D_{2}D2中包含全部8个可揭示缺陷的测试输入点因此θ1=0θ_{1}=0θ1=0,θ2=8/99≈0.08θ_{2}=8/99≈0.08θ2=8/99≈0.08。此时有Pp=1−∏i=1k(1−θi)ni≈0.08<PrP_{p}=1−\prod_{i=1}^{k}\left(1−θ_{i}\right)^{n_{i}}≈0.08<P_{r}Pp=1−∏i=1k(1−θi)ni≈0.08<Pr,即分割测试的缺陷检出能力劣于随机测试。
可见,分割测试的缺陷检出能力并不一定优于随机测试,关键在于分割子空间的策略是否合理。如果分割策略并未着眼于缺陷分布,无法促成子空间的高失效率,那么在检出缺陷的意义上,分割测试就难以展现其价值,对理想和现实的信息也会消化不良。
话虽如此,基于缺陷的分割策略要想在实践中落地,却并非易事。因为在测试设计阶段,我们无从获知关于缺陷分布的确切情报,通常只能依赖经验或某些启发式原则,来猜测缺陷聚居地的所在。最终的效果是否优于随机测试,一般也难以验证。
那么,有没有更具实操性的方法,可以为分割测试的缺陷检出能力提供保障呢?有的,这就是"等比例采样策略",即要求"从各个子空间选取的用例数比例,与子空间大小比例一致",这样就能确保Pp≥PrP_{p}\geq P_{r}Pp≥Pr。要实现等比例采样,通常有两种做法:
- 第一种,在根据期望或结构进行分割之后,计算各个子空间的大小比例,并依据该比例分配各个子空间的用例数;
- 第二种,在根据期望或结构进行分割之后,进一步对子空间进行细分,使得各个子空间大小都相同,接下来只需要从每个子空间中选取相同数量的用例即可。
"等比例采样策略"虽然简单,实际应用时仍可能遇到一些具体问题,需要我们灵活应对。举个例子,被测程序如下:
java
	/**
     * 根据收入计算税额
     * @param income 收入(整数类型)
     * @return 计算得到的税额
     */
    public static double calculateTax(int income) {
        double tax;
        if (income <= 20000) {
            tax = 0;
        } else if (income <= 30000) {
            tax = 0.12 * 10000;
        } else if (income <= 40000) {
            tax = 0.12 * 10000 + 0.14 * 10000;
        } else if (income <= 50000) {
            tax = 0.12 * 10000 + 0.14 * 10000 + 0.17 * 10000;
        } else if (income <= 500000) {
            tax = income * 0.15;
        } else {
            tax = income * 0.165;
        }
        return tax;
    }
假设输入变量income的取值范围为{income∣0≤income≤1400000}\left\{income|0\leq income\leq 1400000\right\}{income∣0≤income≤1400000},此即被测程序的测试输入空间D 。根据程序的控制流结构,我们可以将D初步分割为如下6个子空间:
D1:{income∣0≤income≤20000}D_{1}:\left\{income|0\leq income\leq 20000\right\}D1:{income∣0≤income≤20000}
D2:{income∣20000<income≤30000}D_{2}:\left\{income|20000<income\leq 30000\right\}D2:{income∣20000<income≤30000}
D3:{income∣30000<income≤40000}D_{3}:\left\{income|30000<income\leq 40000\right\}D3:{income∣30000<income≤40000}
D4:{income∣40000<income≤50000}D_{4}:\left\{income|40000<income\leq 50000\right\}D4:{income∣40000<income≤50000}
D5:{income∣50000<income≤500000}D_{5}:\left\{income|50000<income\leq 500000\right\}D5:{income∣50000<income≤500000}
D6:{income∣500000<income≤1400000}D_{6}:\left\{income|500000<income\leq 1400000\right\}D6:{income∣500000<income≤1400000}
6个子空间的大小差异很大,比例为2:1:1:1:45:90。如果测试资源非常有限,比如可选取的测试用例总数只有10个,此时无论是严格按子空间大小比例进行分配,抑或将子空间继续细分为相同规模,都是不可行的。
的测试用例总数只有10个,此时无论是严格按子空间大小比例进行分配,抑或将子空间继续细分为相同规模,都是不可行的。
怎么办呢?只能接受一定程度的近似。分割测试有个基本原则:无论子空间多小,其中都至少要有一个测试输入点入选。因此在这个例子中,相对合理的采样方式是:在规模较小的4个子空间中各取一个用例,剩余用例在规模较大的2个子空间中按比例分配。最终各个子空间的用例数分别为1、1、1、1、2、4。