9 月 22 日,阿里云在云栖大会 AI 实时数据智能论坛上正式发布 Kafka 流算湖一体化实时数据平台------从统一实时数据入口,到数据进来即算、处理后原生入湖,云消息队列 Kafka 版加速向实时数据平台演进。
当大模型和智能体开始进入企业的生产系统,AI 应用竞争正在从"模型能力"延伸到"数据供给能力"。模型能否及时获得新鲜、可信且具备业务上下文的数据,逐渐成为实时推荐、智能检索、风险识别、内容理解和自动决策等场景落地的关键。
在这一背景下,Kafka 的角色也在改变。
从 2018 年基于 RocketMQ 内核支持 Kafka 协议,到 2023 年发布兼容 Apache Kafka 的 V2 版本并增强跨可用区容灾能力;从 2024 年落地存算分离架构、推出 Kafka V3 Serverless,到 2025 年进一步丰富 Serverless 产品形态,并拓展 MQTT 接入与 Schema 管理能力,云消息队列 Kafka 版持续围绕稳定可靠、弹性效率和数据生态演进。
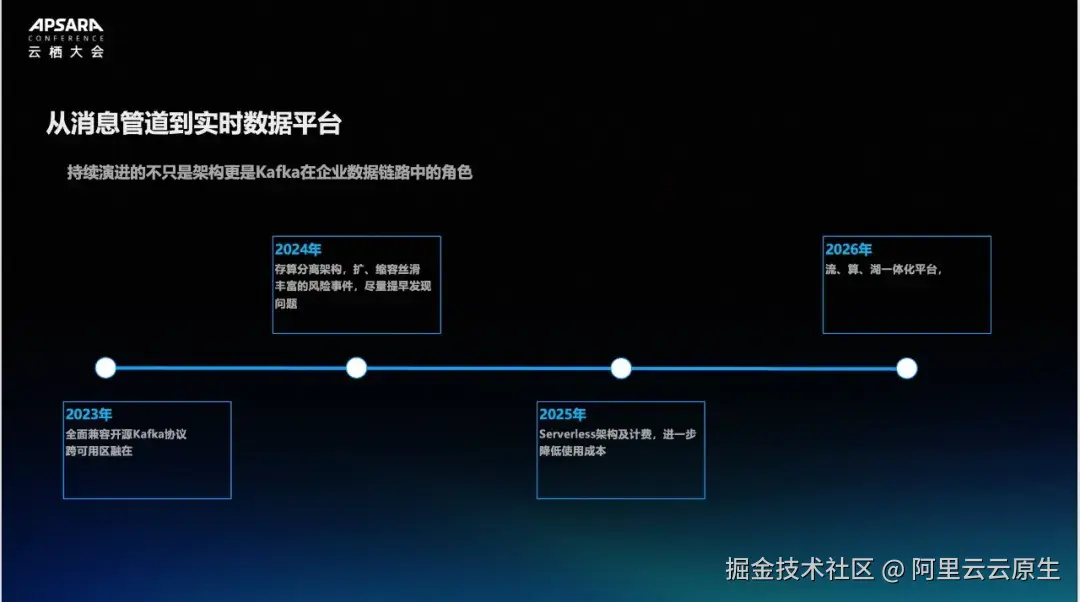
此次发布将实时计算、AI 数据处理和原生入湖纳入统一产品体系,推动 Kafka 从承担消息传输和流量缓冲的"消息管道",进一步升级为覆盖实时数据采集、计算和入湖的一体化平台。
AI 时代,实时数据正在成为核心生产资料
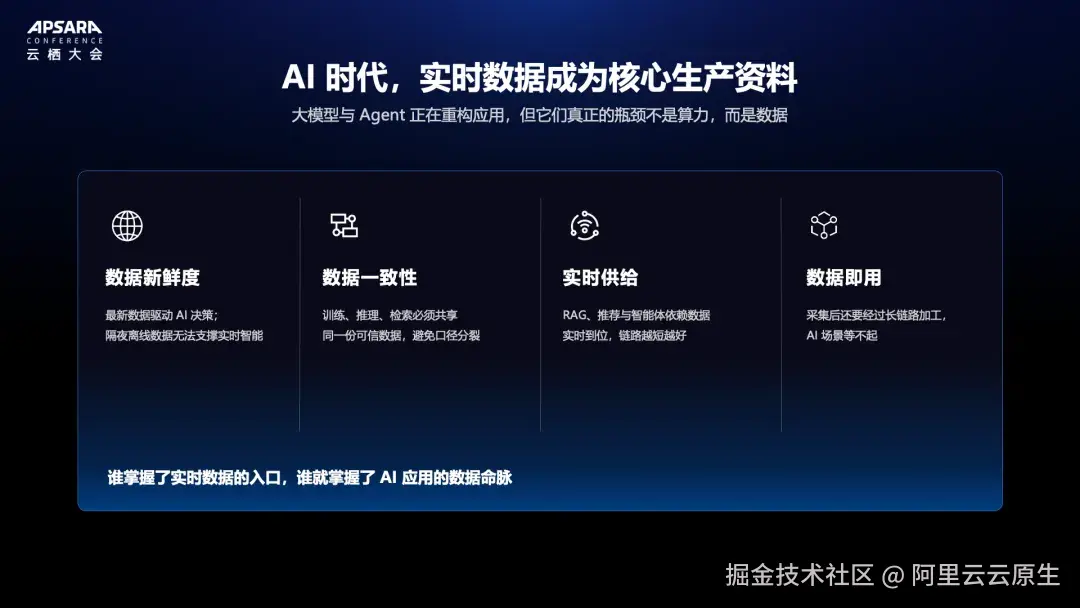
大模型和 Agent 正在重构应用,但模型不能脱离数据独立创造业务价值。对于实时推荐、智能检索、风险识别和 Agent 决策等在线场景,应用需要持续获得与业务同步变化的数据;训练、推理与检索还应尽量基于一致、可信的数据口径。
与传统离线分析相比,这些 AI 应用对数据链路提出了更高要求:数据需要足够新鲜,RAG、推荐与智能体需要及时获得事件和上下文,数据采集后还要尽快完成清洗、转换和供给。
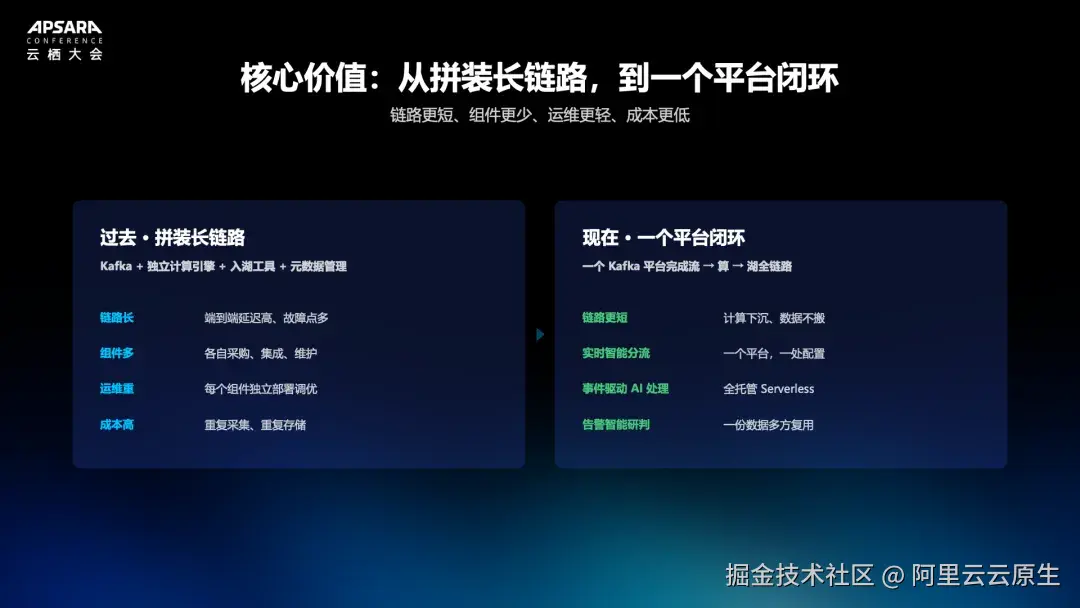
过去,企业要实现 "实时采集---计算---入湖",通常需要组合 Kafka、独立计算引擎、入湖工具和元数据管理系统。多个组件分别采购、部署、扩缩容和运维,数据还需要在系统之间多次流转。链路每增加一跳,端到端延迟、故障点、集成复杂度和资源成本都可能随之增加。
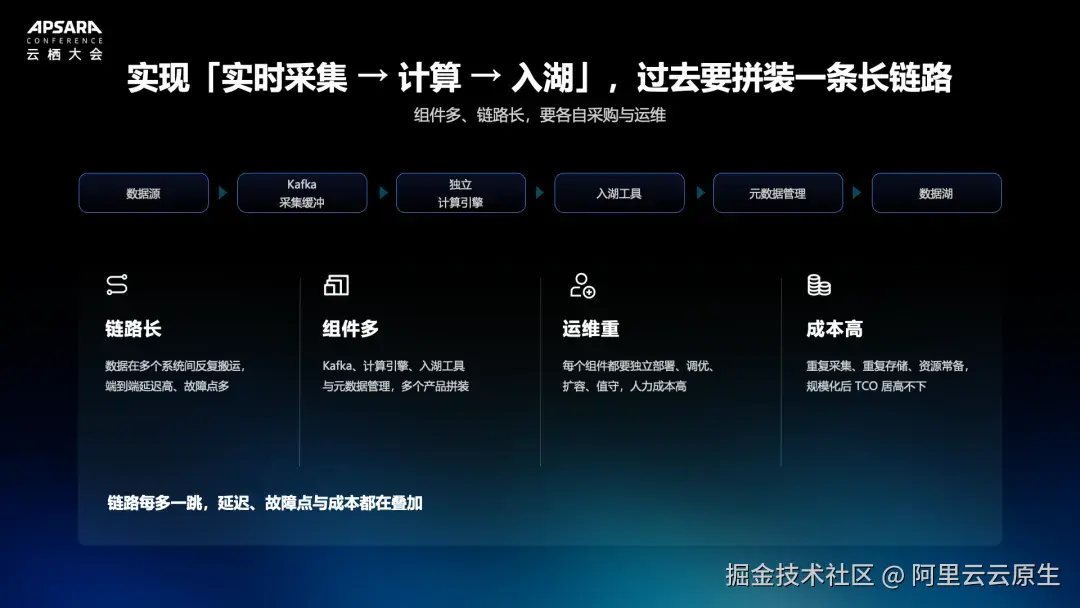
AI 时代的数据基础设施需要重新收敛:实时数据入口不应只是把消息送到下游,还应成为数据加工、治理与沉淀的起点。让计算更靠近数据,让处理结果直接进入开放数据湖,可以缩短从事件发生到数据可用的路径,为实时业务与 AI 应用持续提供更及时的数据上下文。
Kafka 流算湖一体化:统一承载数据接入、计算与入湖
本次发布的云消息队列 Kafka 版流算湖一体化实时数据平台,围绕同一份实时数据构建"流、算、湖"三层能力:以 Kafka 承接数据进入,在平台内完成实时加工,再将原始数据或处理结果原生沉淀到数据湖。
业务数据库、日志、IoT、埋点和 CDC 等数据统一进入 Kafka 后,可以按需执行 SQL、Embedding 或 Streaming Agent 处理,并将结果写回 Topic、推送至下游系统,或写入阿里云对象存储 OSS 的开放表。各项能力既可独立使用,也可组合成端到端实时数据链路。
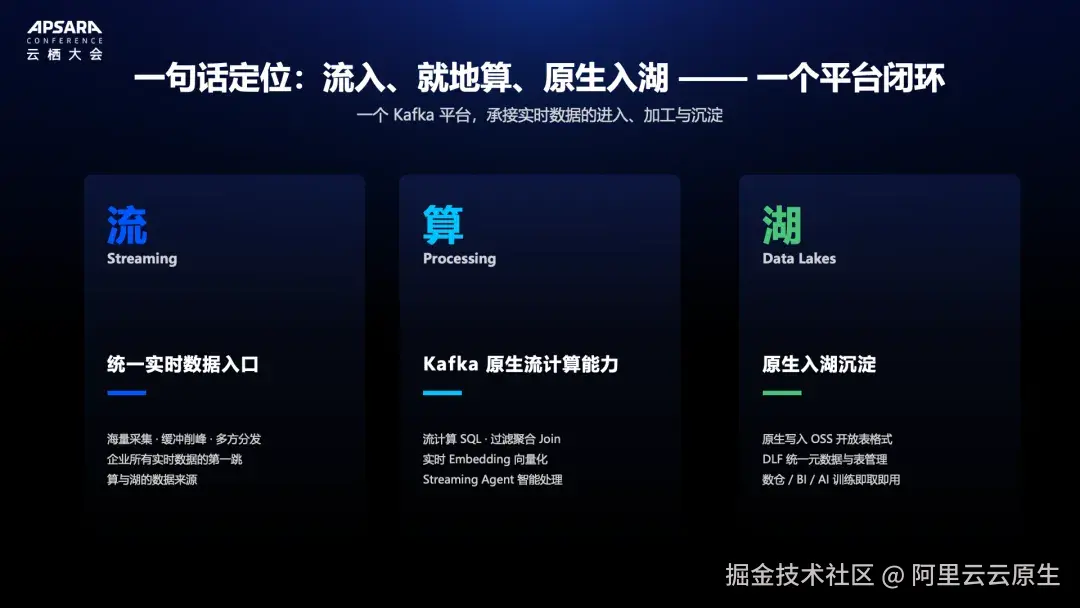
流:统一承接企业实时数据
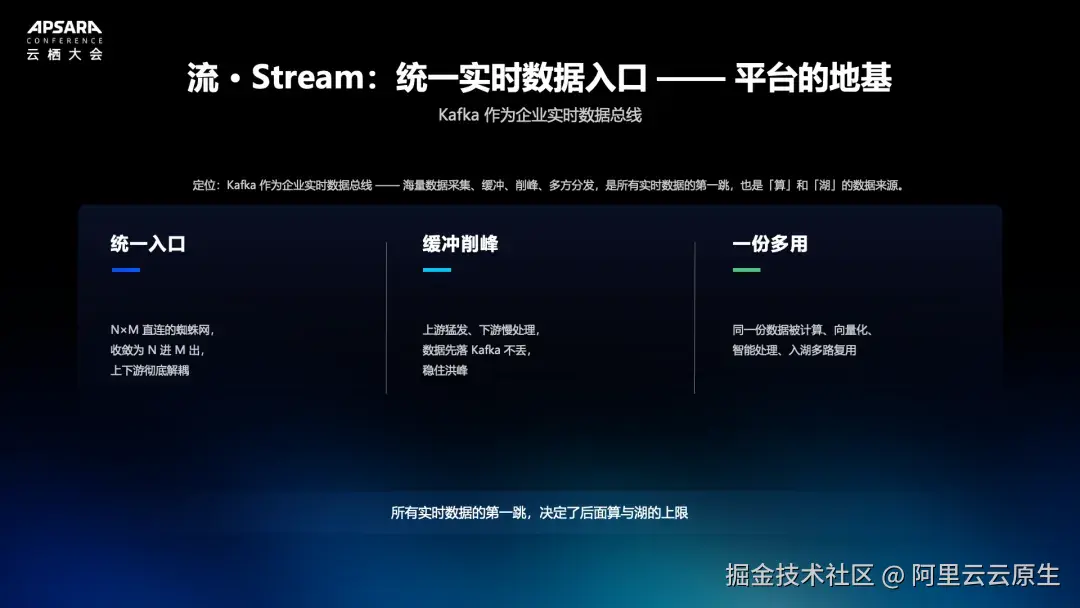
在"流"这一层,Kafka 继续发挥实时数据入口的核心价值,为海量数据提供采集、缓冲削峰和多方分发能力。
通过统一入口,原本上下游之间复杂的点对点连接可以收敛为围绕 Kafka 的数据流转关系。面对突发流量,数据可先进入 Kafka,由下游按照自身处理能力持续消费;同一份数据也可被实时计算、向量化、智能处理和入湖链路按需复用,从而减少重复采集以及为不同场景反复建设数据通道的工作量。
算:数据进入 Kafka,即可就地处理
在"算"这一层,云消息队列 Kafka 版将 SQL、实时 Embedding 和 Streaming Agent 纳入统一产品体系,让实时数据在流动过程中完成计算、理解和分发。
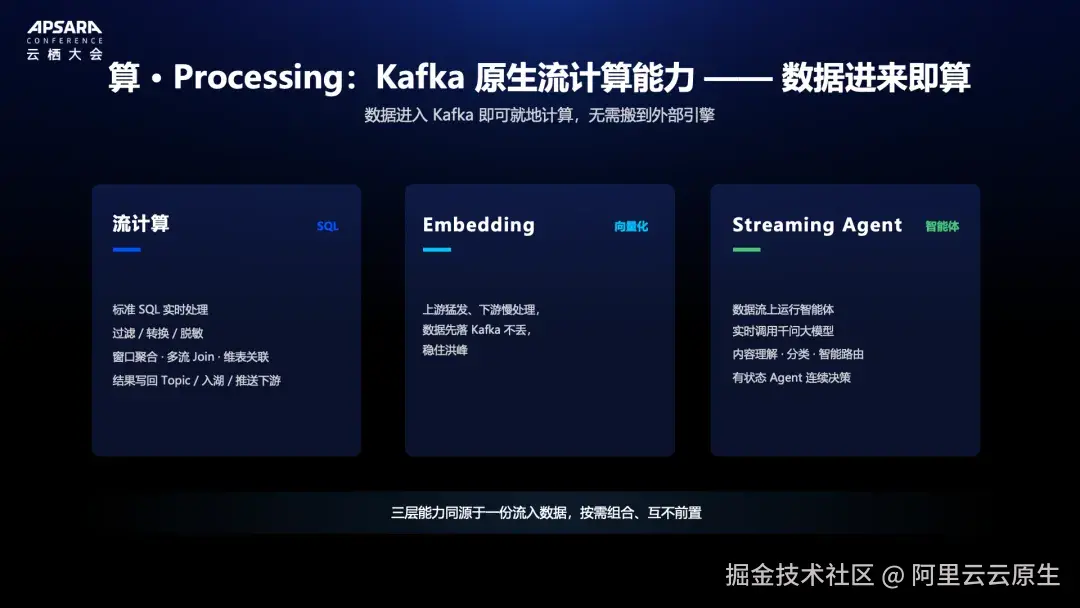
产品内 SQL 让开发者可以使用熟悉的 SQL 描述流式处理逻辑,完成过滤、转换、脱敏、窗口聚合、多流 Join 和维表关联等操作。结果可以写回新的 Topic,也可以通过 Connector 写入业务系统、数仓或湖表,适用于实时 ETL、指标聚合、数据清洗标准化和实时宽表构建等场景。
SQL 以独立计算任务运行,不进入 Broker 的消息热路径。Broker 继续负责 Kafka 协议、Leader 管理和消息传输,SQL 任务通过 Topic 或 Connector 读写数据。产品提供统一的开发、部署和观测入口,并通过 Serverless 方式按负载使用计算资源,使消息传输与流式计算保持清晰的职责和故障边界。
面向 AI 应用,实时 Embedding 可以在数据流经 Kafka 时完成向量化,并将结果写入向量存储或随数据入湖,用于知识库更新、推荐与搜索向量特征更新、内容语义索引等场景。批量向量化、失败重试和结果缓存有助于降低模型调用成本,减少对离线向量加工的依赖。
Streaming Agent 则让数据在流动过程中被实时理解和处理。该能力可调用千问大模型,并与阿里云百炼智能体平台协同,对消息进行内容理解、分类、抽取和智能路由;也可结合历史上下文进行有状态处理,为内容识别、工单分流、事件驱动响应和告警研判提供支持。实际应用仍需结合业务规则、模型评估和必要的人工复核。
湖:让 Topic 持续沉淀为开放数据资产
在"湖"这一层,云消息队列 Kafka 版支持将原始数据或计算结果以 Iceberg 等开放表格式写入阿里云对象存储 OSS。Table Topic 面向 OSS Table Bucket 托管成表,SQL 入湖路径可对接阿里云数据湖构建(Data Lake Formation,DLF)2.0。下游计算引擎、数仓、BI 和 AI 训练任务可以基于开放格式读取已提交的数据,降低对单一处理引擎的依赖。
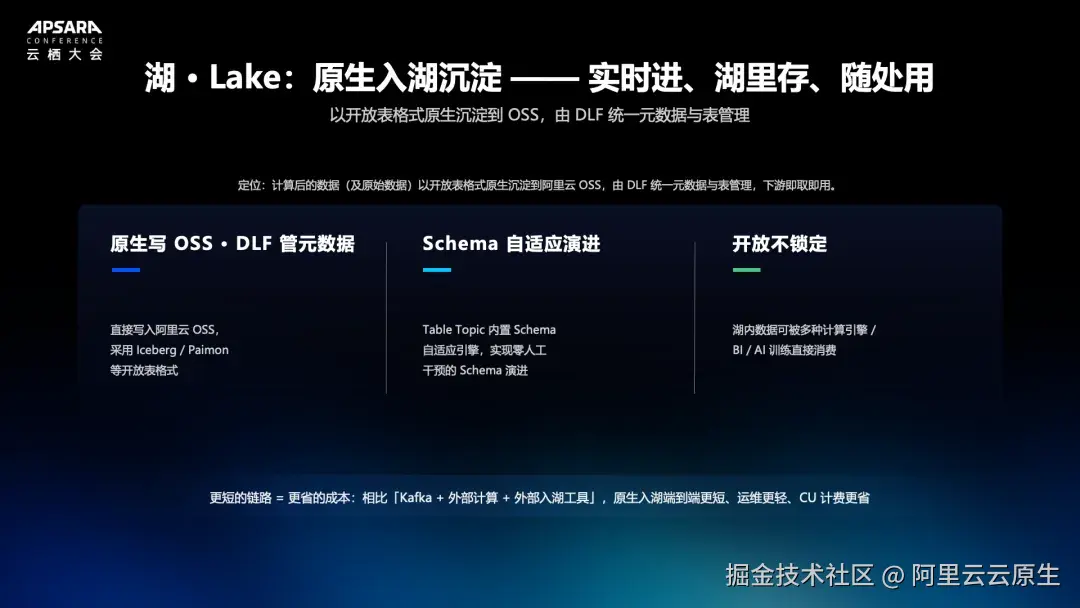
此次发布的 Table Topic 能力将过去依赖外部 Flink、Spark 或 Connector 任务持续成表的过程,收敛为由平台托管的 Topic---Table 关系。用户为 Topic 配置目标湖表后,平台承接记录映射、Schema 对齐、文件布局、提交、恢复和后台维护等工作。
Table Topic 的关键不只是"写出文件",而是让消息位点和表的 Snapshot 协同推进。数据文件生成后,通过元数据的原子提交让成功快照对读者可见;提交成功后再推进已提交位点,失败时重试未提交区间。在兼容性规则允许的范围内,平台支持 Schema 演进;对于不兼容变化则明确阻断,帮助维护湖表数据的一致性和可恢复性。
针对实时写入容易产生的小文件、快照累积和未引用文件等问题,OSS Table Bucket 可在后台执行 Compaction、快照过期及未引用文件清理,无需用户侧常驻维护任务,让实时数据不仅能够进入湖,也能够形成持续可管理、可复用的开放数据资产。
一套底座,两条独立闭环
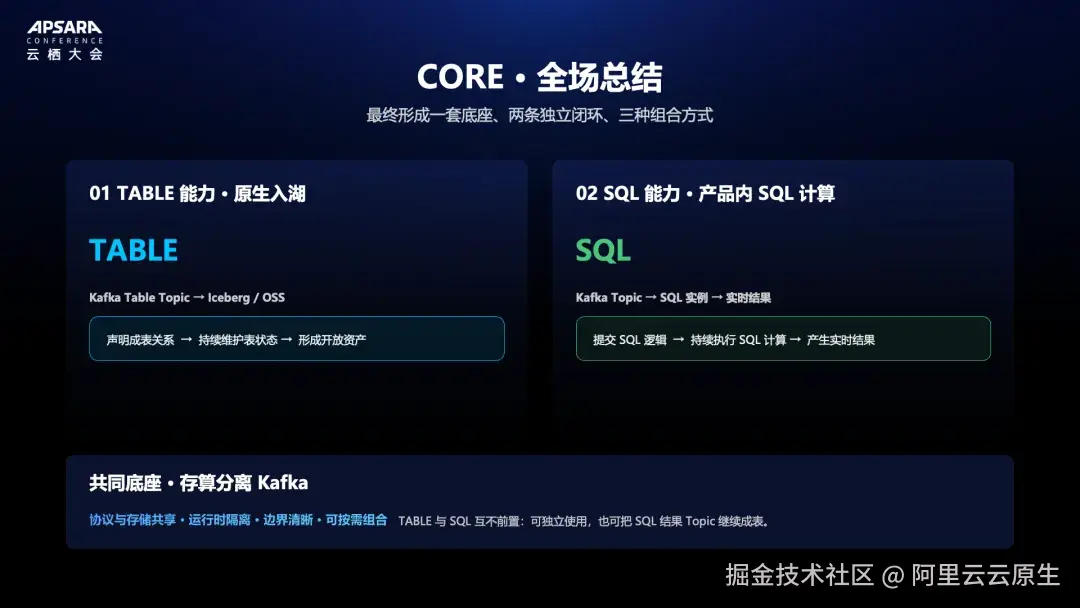
流算湖一体化并不是把所有能力强耦合在一起。云消息队列 Kafka 版采用"一套底座、两条独立闭环"的设计:Table Topic 面向完整历史与可追溯的数据沉淀,产品内 SQL 面向实时计算和在线决策;两条路径共享 Kafka 协议与存储底座,但任务运行时和故障域保持隔离。
企业可以直接将原始 Topic 持续写入湖表,也可以先通过 SQL 完成清洗、聚合或 Join,再将结果 Topic 配置为 Table Topic。两条路径互不前置,可以根据业务复杂度选择标准化直入,或加工后再入湖。
支撑这些能力的是云消息队列 Kafka 版的存算分离底座。Broker 主要承担协议处理和读写计算,分区数据持久化到共享存储。主从切换时,新 Leader 可以复用共享 Segment,减少历史数据搬迁;Meta Fence、Data Fence 与 Epoch CAS 等机制用于限制旧 Leader 继续写入,维护切换过程中的单写边界。
这一设计让平台能够在消息传输、实时计算和数据入湖之间建立更清晰的责任边界:计算任务或入湖任务的故障不会直接进入 Broker 热路径,企业也可以按需组合能力,而不必一次性启用整套链路。
从实时数仓到 AI 供给,覆盖四类高频场景
围绕统一数据入口、就地计算和开放入湖,云消息队列 Kafka 版可支持多类实时数据场景。
- 在实时数仓与湖仓一体场景中,企业可以对业务事件进行实时清洗、聚合和标准化,并将原始数据或处理结果持续写入湖中,减少外部链路拼装。
- 在 AI 应用实时供给场景中,平台可以为 RAG、推荐、搜索和智能体持续提供更新的数据、向量特征及事件上下文,缩短从数据变化到应用可用的链路。
- 在 IoT 和车联网场景中,平台可以承接海量设备数据的接入、清洗、聚合与入湖分析。
- 在日志实时分析场景中,则可以将日志采集、流式处理、智能研判和入湖串联起来,为后续查询、分析与治理提供数据基础。
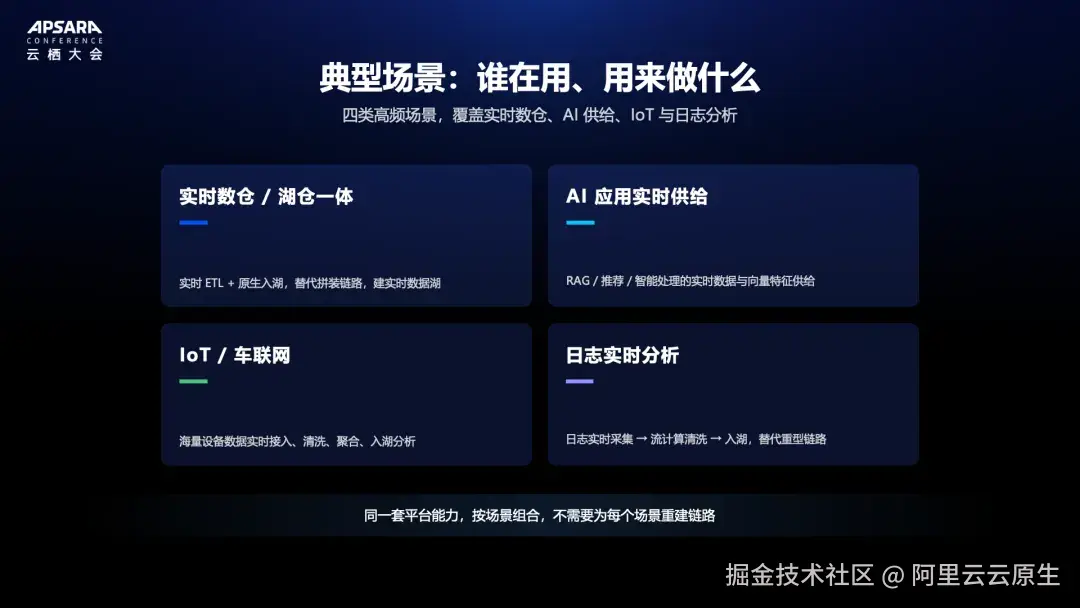
同一套平台能力可以按照场景灵活组合。企业可以选择仅使用原生入湖、先计算再分发、向量化后供给 AI 系统,或将 SQL 处理结果继续沉淀为开放表,从而减少为不同场景分别建设数据链路的工作量。
Kafka 正在走向实时数据平台
从协议兼容和稳定性建设,到存算分离与 Serverless,再到流算湖一体化,云消息队列 Kafka 版的能力边界正在从"把消息可靠送达",拓展到"让实时数据更快产生价值"。
- 首先,AI 时代的数据价值越来越取决于新鲜度。离线数据仍然重要,但实时推荐、智能检索、风险识别和 Agent 决策需要持续获得业务正在发生的变化。Kafka 作为实时数据入口,天然处于连接数据源、计算和应用的关键位置。
- 其次,实时数据链路需要从多组件拼装走向平台化协同。将计算带到数据所在的位置,并让结果直接进入开放数据湖,有助于减少数据搬运、系统集成和重复运维,让团队把更多精力投入业务逻辑,而不是维护复杂的数据管道。
- 最后,一体化不等于封闭。SQL 与 Table Topic 可以独立运行,湖内数据采用开放表格式,并可由多种下游引擎读取。保持开放格式、清晰边界与按需组合,能够让实时数据平台更好地适应企业长期演进的技术体系。
Kafka 不止于消息。关键不在于简单叠加功能,而在于建立高可用切换、开放入湖、计算隔离和 AI 治理等工程闭环,让同一份实时数据以更短链路服务实时业务、数据分析与 AI 应用。
面向未来,云消息队列 Kafka 版将继续围绕实时数据的流动、加工和开放沉淀演进,让企业在 AI 时代更高效地释放实时数据价值。欢迎加入钉钉交流群,与产品和技术团队交流流算湖一体化能力、应用场景与落地实践。
钉钉搜索群号(193120010825)立即进入Kafka流算湖一体化交流群!
点击此处回看本场论坛直播。