0. 现场
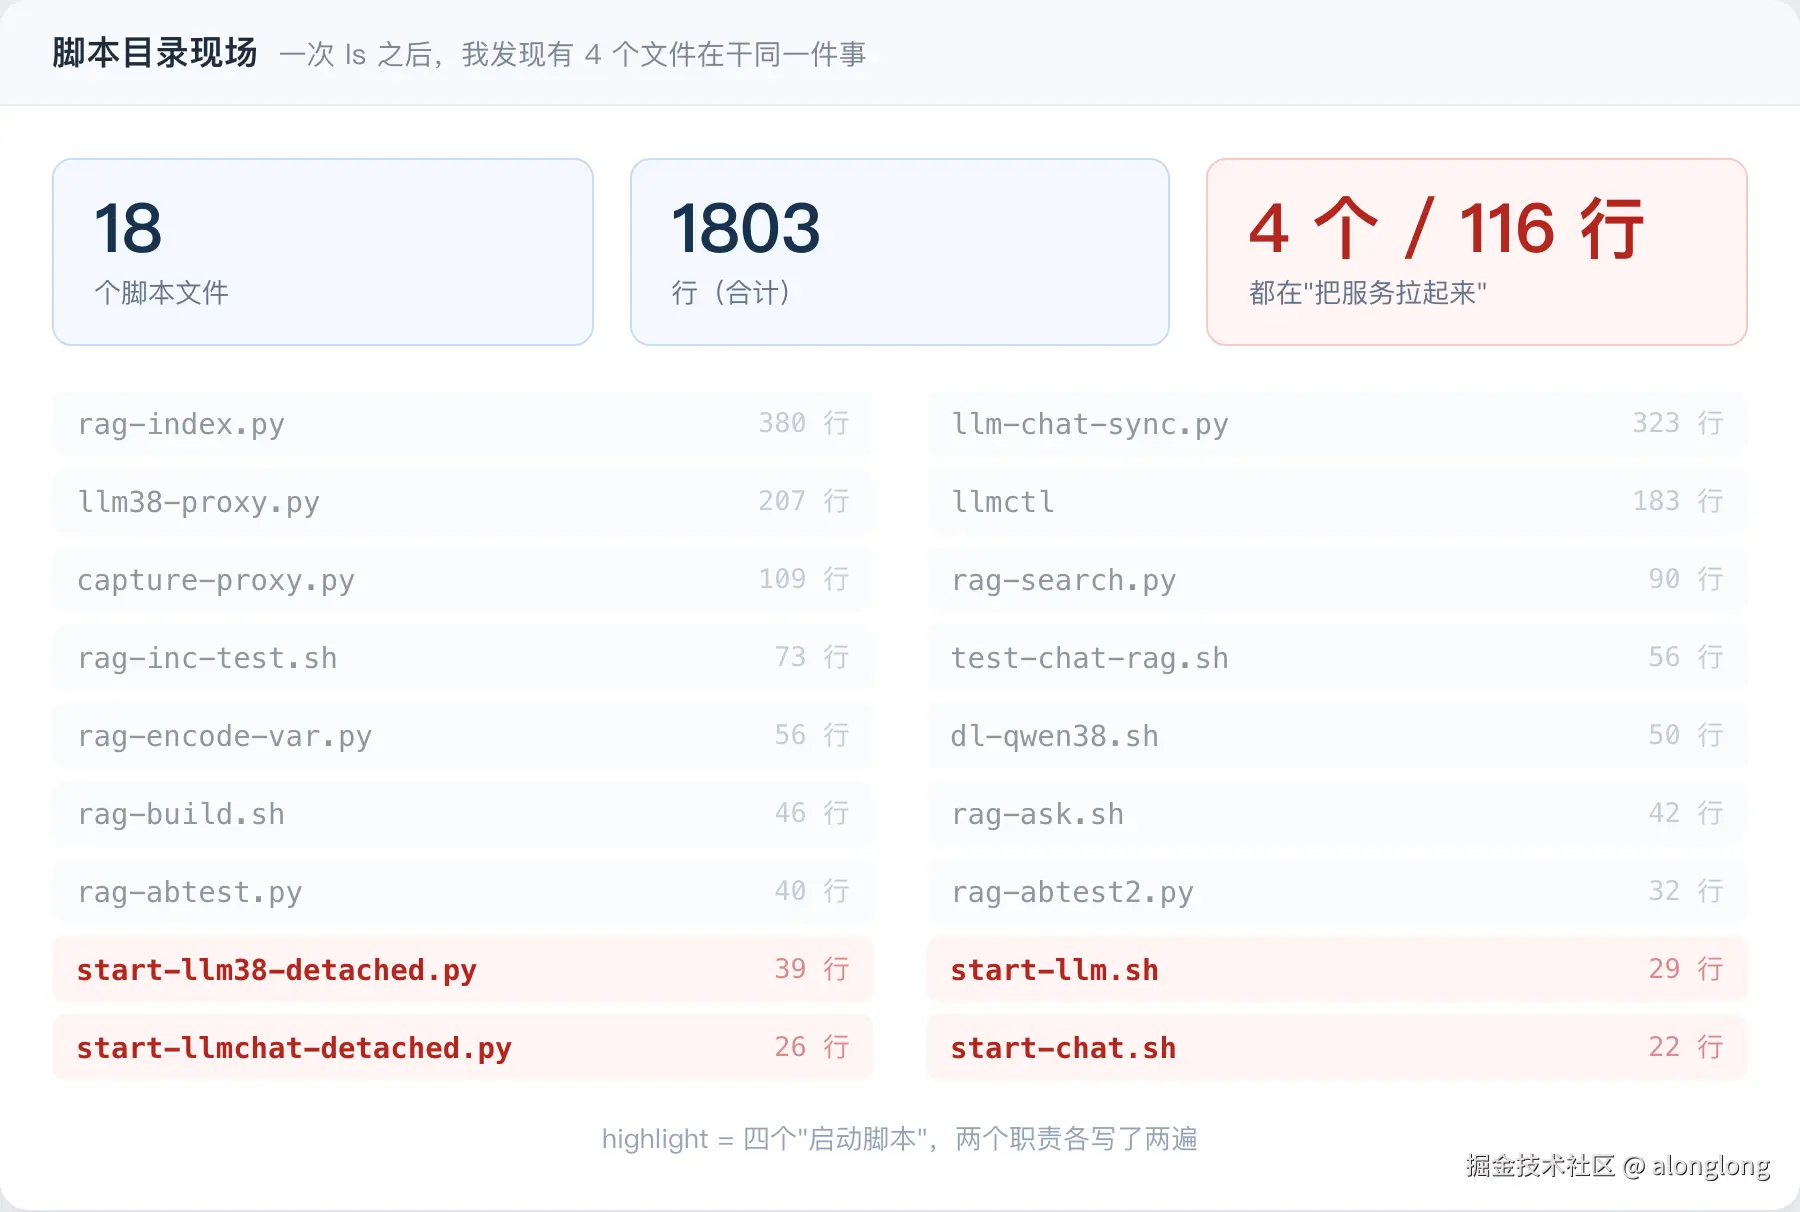
一个放零散工具的目录,ls 出来是这样:
sql
$ wc -l * | sort -rn
    1803 total
     380 rag-index.py
     323 llm-chat-sync.py
     207 llm38-proxy.py
     183 llmctl
     109 capture-proxy.py
      90 rag-search.py
      73 rag-inc-test.sh
      56 test-chat-rag.sh
      56 rag-encode-var.py
      50 dl-qwen38.sh
      46 rag-build.sh
      42 rag-ask.sh
      40 rag-abtest.py
      39 start-llm38-detached.py
      32 rag-abtest2.py
      29 start-llm.sh
      26 start-llmchat-detached.py
      22 start-chat.sh
18 个文件、1803 行。其中最扎眼的是最后四行 ------四个"启动脚本",start-llm.sh(29)、start-llm38-detached.py(39)、start-chat.sh(22)、start-llmchat-detached.py(26),加起来 116 行。
四个文件,两个职责(起模型 / 起界面),各写了两遍。
1. 四个启动脚本是怎么长出来的
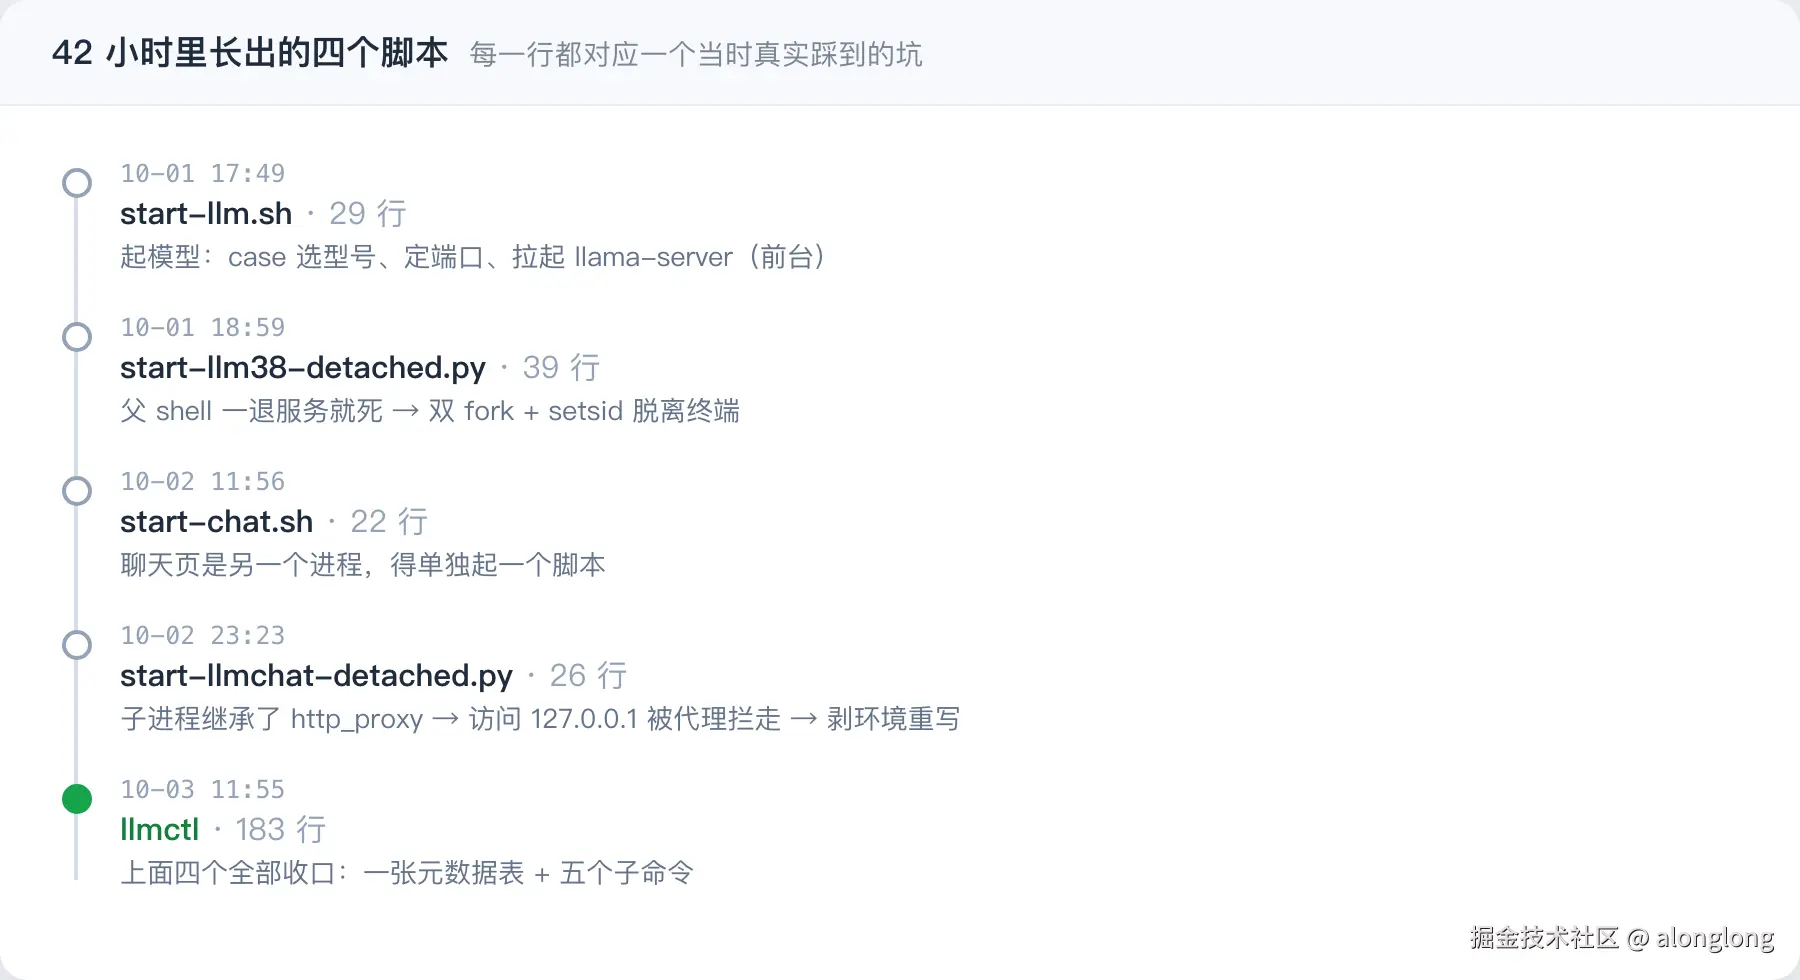
把 mtime 拉出来排一下,因果链很清楚:
| 时间 | 文件 | 行数 | 引入它的那个约束 |
|---|---|---|---|
| 10-01 17:49 | start-llm.sh |
29 | 起模型:case 选型号 → --port → 前台跑 |
| 10-01 18:59 | start-llm38-detached.py |
39 | 父 shell 一退服务就死 → 双 fork + setsid 脱离 |
| 10-02 11:56 | start-chat.sh |
22 | 聊天页是另一个进程,需单独起 |
| 10-02 23:23 | start-llmchat-detached.py |
26 | 子进程继承了 http_proxy → 访问 127.0.0.1 被代理拦走 → 剥环境重写 |
| 10-03 11:55 | llmctl |
183 | 上面四个全部收掉 |
坑 1:nohup 不够,得真正脱离
第一版 start-llm.sh 是前台跑的("$LLAMA" ... "$@"),把终端占住;换成 nohup ... & 之后,父 shell 一退出进程还是没了 。最终解法是 start-llm38-detached.py 里的双 fork:
python
pid = os.fork()
if pid > 0:
    sys.exit(0)
os.setsid()
pid = os.fork()
if pid > 0:
    sys.exit(0)
os.execvpe(PY, [PY, SERVER], env)
坑 2:环境变量会被继承,包括不该继承的那些
start-llmchat-detached.py 多出来的那几行,是这篇文章里我最想强调的一处:
python
env = dict(os.environ)
for k in ("HTTP_PROXY", "HTTPS_PROXY", "http_proxy", "https_proxy"):
    env.pop(k, None)
env["NO_PROXY"] = "127.0.0.1,localhost"
症状 :服务在跑、端口在听,客户端就是连不上。 根因 :子进程从调用方继承了 http_proxy,于是对 127.0.0.1 的请求也被送进了代理 ,代理当然不认识这个地址。 修法 :显式剥掉四个代理变量,并把本机地址加进 NO_PROXY。
这条规矩后来被我固化成两个动作:任何脚本里对
127.0.0.1的探测,要么curl --noproxy '*',要么先把代理变量清干净。
到这里,"启动服务"这件事被拆成了 4 个脚本。每个都只记住"上一次的坑"。
2. 收口:一个 CLI、五个子命令
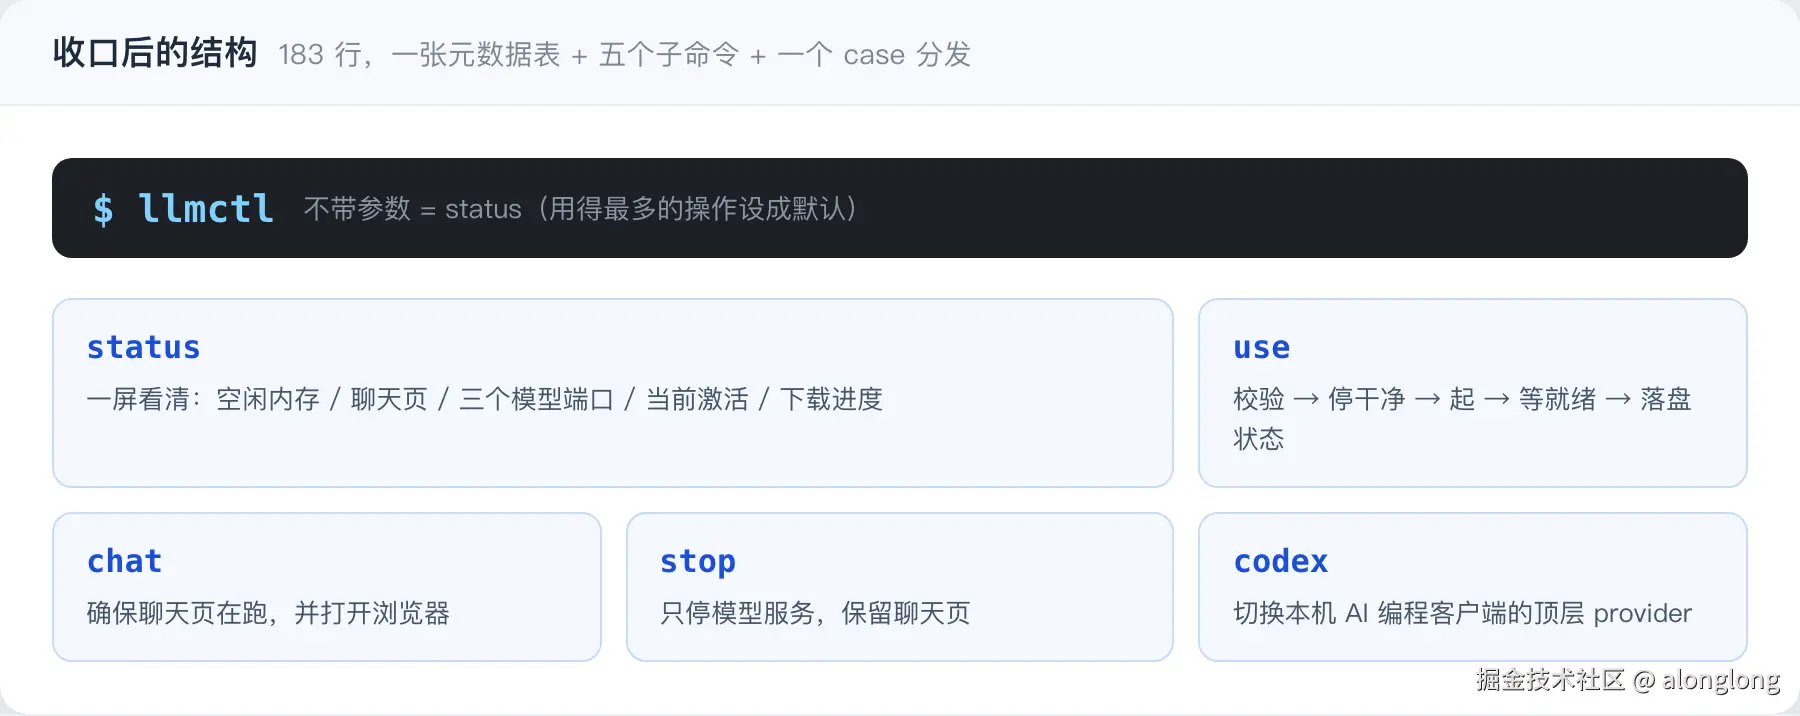
llmctl 的结构非常朴素------一张元数据表 + 五个函数 + 一个 case 分发。
2.1 元数据集中在一处
bash
# 模型 key -> "显示名|文件名|端口|alias|是否多模态(0/1)"
meta() {
  case "$1" in
    30)  echo "Qwen3-Coder-30B-A3B Q8_0|Qwen3-Coder-30B-A3B-Instruct-Q8_0.gguf|8080|qwen3-coder-30b-local|0";;
    38)  echo "Qwen3.8-27B Q8_0|Qwen3.8-27B-Q8_0.gguf|8082|qwen3.8-27b-local|1";;
    32b) echo "Qwen2.5-Coder-32B Q4_K_M|qwen2.5-coder-32b-instruct-q4_k_m.gguf|8081|qwen2.5-coder-32b-local|0";;
    *)   echo "";;
  esac
}
一个模型的所有属性(名字、文件名、端口、别名、是否多模态)只在这一处定义。 之前散在四个脚本里的时候,加一个模型要改四处,漏一处就是"端口对不上"。
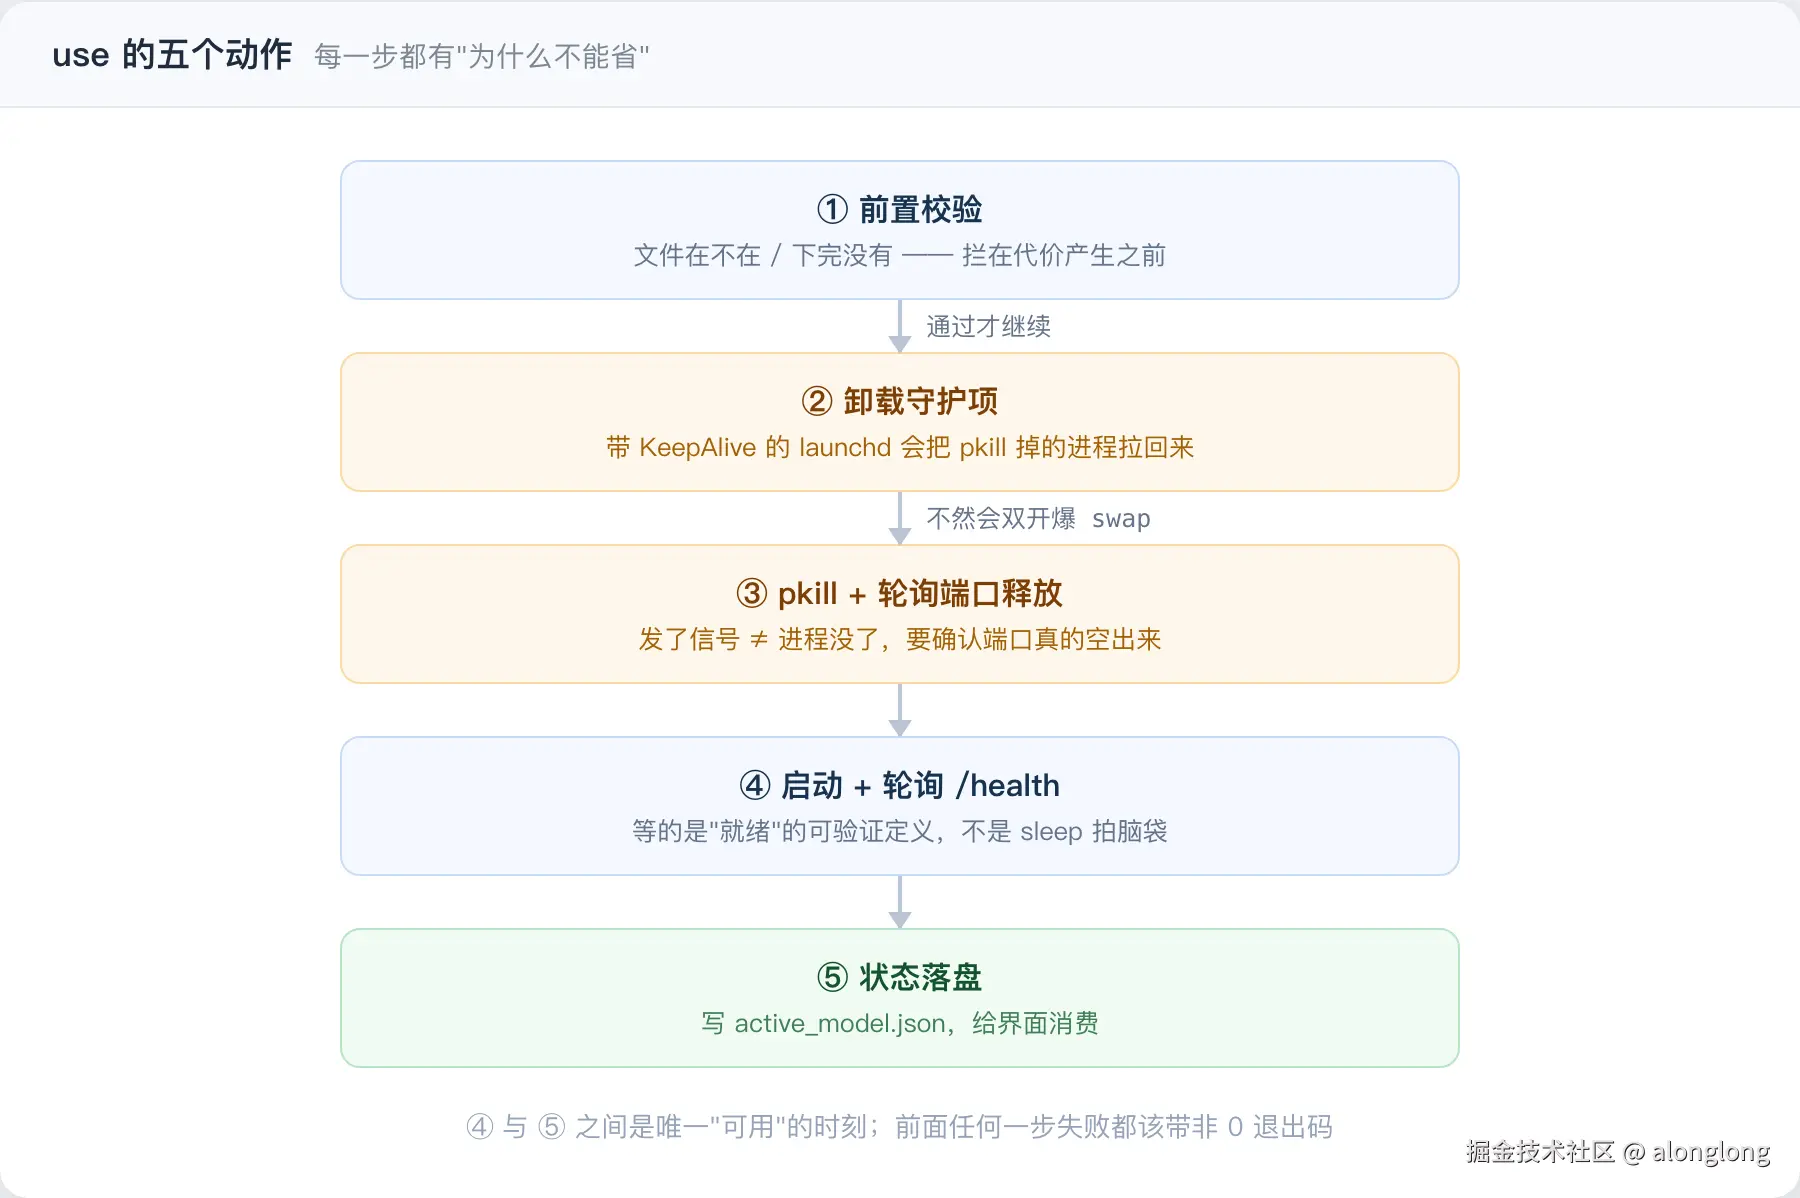
2.2 use:先停干净,再起,再等就绪
这是核心子命令,完整流程如下(有删节):
bash
use() {
  local key="$1"
  local m=$(meta "$key")
  [ -z "$m" ] && { echo "❌ 未知模型:$key (用 30 / 38 / 32b)"; exit 1; }
  local NAME FILE PORT ALIAS VISION; IFS='|' read -r NAME FILE PORT ALIAS VISION <<< "$m"
  local PATH_="$MODELS/$FILE"
① 前置校验:拦在启动之前
bash
  [ -f "$PATH_" ] || { echo "❌ 模型文件不存在:$PATH_"; exit 1; }
  # 体积不够也不让起(会拉爆/报错)
  if [ "$key" = "38" ]; then
    local sz=$(stat -f%z "$PATH_" 2>/dev/null)
    if [ "${sz:-0}" -lt 26000000000 ]; then
      echo "❌ 还没下完(当前 $((sz/1000000000))GB / 26GB),等下载完成再 use 38"
      exit 1
    fi
  fi
② 停:先卸守护项,再杀进程,再等端口真空出来
bash
  # 带 KeepAlive 的 launchd 守护项会把 pkill 掉的进程自动拉回来 → 必须先后台卸载它
  local PLIST="$HOME/Library/LaunchAgents/com.user.llm38.plist"
  if [ -f "$PLIST" ] && launchctl print "gui/$(id -u)/com.user.llm38" >/dev/null 2>&1; then
    launchctl unload "$PLIST" 2>/dev/null && echo "  已卸载守护项"
  fi
  pkill -f "llama-b11306/llama-server" 2>/dev/null

  # 关键:不能 kill 完就走,要轮询确认端口真的释放(发了信号 ≠ 进程没了)
  local i=0
  while lsof -nP -iTCP:"$PORT" -sTCP:LISTEN >/dev/null 2>&1 && [ $i -lt 20 ]; do
    sleep 0.5; i=$((i+1))
  done
③ 起 + 等就绪(轮询健康检查,不是 sleep)
bash
  nohup "$LLAMA" --model "$PATH_" --alias "$ALIAS" -ngl 99 -c 16384 \
    --host 127.0.0.1 --port "$PORT" $EXTRA > "/tmp/llm_${key}.log" 2>&1 &

  i=0
  while ! curl -s -o /dev/null -m 2 "http://127.0.0.1:$PORT/health" && [ $i -lt 120 ]; do
    sleep 1; i=$((i+1))
  done
  if curl -s -o /dev/null -m 2 "http://127.0.0.1:$PORT/health"; then
    echo "  ✅ 就绪"
  else
    echo "  ⚠️ 超时未就绪,看日志:/tmp/llm_${key}.log"
  fi
④ 状态落盘(给别的组件读)
bash
  cat > "$STATE" <<JSON
{
  "port": ${PORT:-0},
  "model": "${ALIAS:-}",
  "name": "${NAME:-}",
  "vision": ${VISION:-0}
}
JSON界面读这个文件,就知道该把请求发到哪个端口------这就是"收口"的价值:四个脚本时代,界面得靠人去启动参数里对端口。
2.3 status:一屏看清
bash
mem_free_gb() {   # 用 vm_stat 算 free + speculative,比"看了活动监视器估一个"靠谱
  local pf=$(vm_stat | awk '/Pages free:/{gsub("\\.","",$3);print $3}')
  local ps=$(vm_stat | awk '/Pages speculative:/{gsub("\\.","",$3);print $3}')
  echo $(( (${pf:-0}+${ps:-0}) * 16384 / 1000000000 ))
}

listening() {   # 判"端口在不在听"------所有状态的唯一真相源
  lsof -nP -iTCP:"$1" -sTCP:LISTEN >/dev/null 2>&1 && echo "🟢" || echo "⚪️"
}
实测输出:
bash
════════ 本地 LLM 状态 ═════════
空闲内存:约 11GB / 64GB
聊天页  :http://127.0.0.1:3000  🟢
对话落盘:今日 0 轮  →  $MODELS/llm-chat/chats/2026-10-09.jsonl

模型端口:
  30B    Qwen3-Coder-30B Q8  :8080          ⚪️
  38     Qwen3.8-27B Q8    :8082            🟢
  32B    Qwen2.5-Coder-32B :8081            ⚪️

当前激活:⚪️ Qwen3-Coder-30B-A3B Q8_0
════════════════════════════════
先记住这一屏。下面第五节要拿它开刀。
2.4 分发:默认子命令
bash
case "${1:-status}" in
  status) status;;
  use)    use "${2:-}";;
  chat)   chat;;
  stop)   stop;;
  codex)  codex "${2:-}";;
  *) echo "用法:llmctl [status|use 30|38|32b|chat|stop|codex 30|38|32b|cloud]";;
esac${1:-status}------不带参数就是查状态,这是用得最多的操作,值得设成默认。
3. 五条设计原则(每条都有对应代码)
| # | 原则 | 在 llmctl 里的落点 |
|---|---|---|
| 1 | 状态要"探",不要"记" | listening() 用 lsof 探端口;状态文件只记"意图" |
| 2 | 互斥关系写成代码 | use 第一步永远是"全停"(64GB 装不下两个) |
| 3 | 停不干净会连累后续 | 先 launchctl unload 再 pkill,再轮询端口释放 |
| 4 | 前置校验拦在代价之前 | 文件存在性 + 体积阈值,都在启动前 |
| 5 | "就绪"要有可验证的定义 | 轮询 /health,超时报日志路径 |
第 3 条值得展开一句,因为它踩过:pkill 返回成功 ≠ 端口已释放。"执行了动作"与"结果发生"是两件事,中间要加确认。
4. 边界:什么不该塞进来
llmctl 只有 183 行,比它收掉的四个脚本(116 行)多不了多少------多出来的部分是状态可见与错误处理,不是功能。这是刻意的:
- 不含业务逻辑:本机那套本地检索(切块 / 向量化 / 排序)一行都没进来。总控只负责"把检索服务拉起来",不知道"文档怎么切"。
- 不做自动决策 :没有"自动挑最合适的模型"这类逻辑。总控要的是确定性------出问题时只调试一套逻辑。
- 不收一次性任务:检索入口脚本的行为是"用时起、用完停",不需要常驻,也就不需要进总控。
判断标准一句话:常驻服务归总控,随用随走的工具归自己。
5. 实测出来的三个缺陷(含没修的)
写完不测等于没写。我拿这个 CLI 做了几组实测,挖出三个问题------三个都还没修。
缺陷 1:状态文件与实际进程漂移(未修)
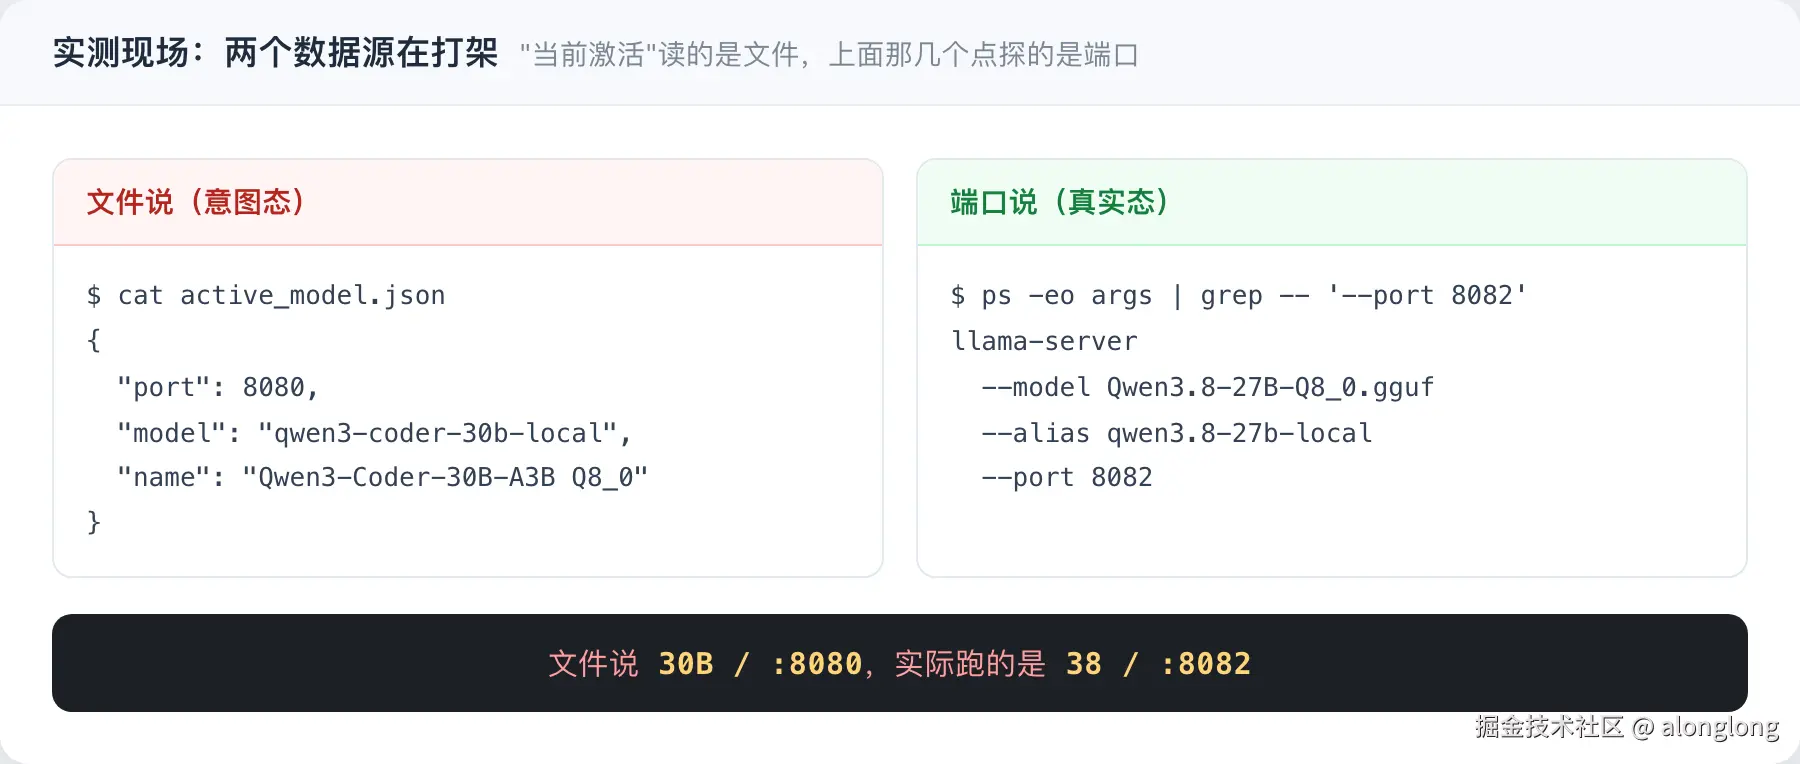
回到 2.3 那屏输出。上半段是探测 的(8082 🟢),"当前激活"那行是读文件的(说 30B)。两个数据源打架。
对数:
bash
$ cat $STATE                      # 意图态
{
  "port": 8080,
  "model": "qwen3-coder-30b-local",
  "name": "Qwen3-Coder-30B-A3B Q8_0"
}

$ ps -eo args | grep -- '--port 8082'   # 真实态
llama-server --model Qwen3.8-27B-Q8_0.gguf --alias qwen3.8-27b-local --port 8082
文件说 30B / 8080,实际跑的是 38 / 8082。
问题代码就是 status 里这段------它只读文件,不探端口:
bash
if [ -f "$STATE" ]; then
  local nm=$(grep -o '"name"[ ]*:[ ]*"[^"]*"' "$STATE" | head -1 | sed 's/.*:[ ]*"//;s/"//')
  echo "当前激活:$(listening $(grep -o '"port"[ ]*:[ ]*[0-9]*' "$STATE" | grep -o '[0-9]*')) $nm"
fi注意它甚至同时用了两种来源:端口状态(探的)和模型名(读的)------所以才会出现"⚪️ + 30B"这种自相矛盾的输出。
修法:谁在听端口谁就是激活的,从探测结果反推;文件只用来提示"记录可能陈旧"。
为什么先写出来不先修 :这个状态漂移是我这次最想留下的记录。一个总控最容易骗的人是它自己的作者------它会打印一屏绿色,其中一半真探测、一半读文件,而它不会告诉你哪半是哪个。
缺陷 2:退出码不一致(未修)
bash
$ llmctl foobar;  echo $?
用法:llmctl [status|use 30|38|32b|chat|stop|codex 30|38|32b|cloud]
0                                   # ← 参数写错,却报成功

$ llmctl use 99;  echo $?
❌ 未知模型:99 (用 30 / 38 / 32b)
1                                   # ← 同一个脚本,另一种态度
case 的 *) 分支只 echo 没 exit 1。危害是:别的脚本用 llmctl xxx && next 串它时,参数写错会被当成成功,继续往下走。
一致性约定应该是:只要没办成你要的事,退出码就不该是 0。
缺陷 3:同一个阈值写了两遍(未修)
"模型下完了没有"这个判断,代码里的阈值是 26000000000(26GB),而 status 打印的是 26.6GB。两个数都是我写的,只是从来没对过。
这类问题和前两个同源:脚本里凡是"应该一致"的东西,只要不主动让它一致,它就会不一致。
6. 复现清单
本文引用的文件与实测行数:
| 文件 | 行数 | 作用 |
|---|---|---|
llmctl |
183 | 总控 CLI(本文主角,5 个子命令) |
rag-index.py |
380 | 语义索引构建(不属于总控,边界示例) |
rag-search.py |
90 | 检索查询(同上) |
rag-build.sh |
46 | 索引构建入口 |
rag-ask.sh |
42 | 检索入口(按需起停,一次性任务,不进总控) |
四个被收掉的启动脚本合计 116 行 (start-llm.sh 29 + start-llm38-detached.py 39 + start-chat.sh 22 + start-llmchat-detached.py 26);整目录 18 个文件、1803 行。
实测命令(全部只读,可直接复现):
bash
wc -l * | sort -rn                    # 脚本清单与行数
llmctl status                         # 一屏状态(含第五节那个漂移现场)
llmctl foobar; echo $?                # 缺陷 2:退出码 0
llmctl use 99; echo $?                # 对照:退出码 1
7. 小结
- 总控管的是状态,不是功能。 它要的不是聪明,是诚实:状态探测得来、动作执行完要确认、失败要能用退出码表达。
- 补丁堆到第四个就该换结构。 出现"第四个启动脚本"时,缺的已经不是功能,是一个统一入口。
- 写脚本的尽头不是更自动化,是更可观测。 自动化省几次敲键盘,可观测性让你在出问题时不用猜。