1. 概述
大语言模型(LLMs)在多语言翻译领域取得了显著进展,但普遍存在系统性的"跨语言冗长偏差"(Verbosity Bias),导致译文往往过于啰嗦,难以满足字幕翻译、视频配音等对时间预算(Time Budget)有严格要求的场景。现有的提示工程等难以在语义忠实度与长度约束之间取得平衡。为此,本研究首先提出了 Sand-Glass 基准测试,专门用于评估音节级长度约束下的翻译表现。随后,我们提出了 HOMURA 强化学习框架,通过 KL 正则化目标函数结合创新的"动态音节比例奖励",显式优化语义保留与时间合规性之间的权衡。实验结果表明,HOMURA 能够精准"驯服"输出长度,在尊重不同语言密度差异的同时,显著优于主流 LLM 基线模型,实现了高质量、高合规性的时间受限翻译。当前HOMURA已经大规模应用于bilibili视频原声翻译 场景中,为实现高质量、高合规性的时间受限翻译提供了可行的技术路径。论文链接:arxiv.org/pdf/2601.10...
HOMURA 已被 EMNLP 2026 接收为 Oral(口头报告)!
HOMURA 的音节控制方法也应用于哔哩哔哩 Index LLM 团队推出的 Index-Translate 系列。该系列的文本翻译模型覆盖 150 种语言,提供 2B、9B 和 35B-A3B(preview)三种规模,支持术语、格式、风格与上下文指令,并扩展出语音翻译模型 Index-Echo、音节控制模型 Index-Homura 和长文档翻译模型 Index-NativeLong。其中,Index-Homura 根据指定音节数调整译文,为字幕和配音等时间受限场景提供长度控制能力。
-
在线 Demo :index-translate.bilibili.com/
-
GitHub:github.com/bilibili/In...
-
Hugging Face:huggingface.co/collections...
-
免费 API:github.com/bilibili/In...
-
Index-Translate 技术报告:arxiv.org/abs/2609.40...
2. 研究背景与挑战(Background & Challenges)
随着大语言模型(LLMs)的飞速发展,其在神经机器翻译(NMT)中表现出了卓越的语义准确性。然而,这种语言能力伴随着一种系统性的**"跨语言冗长偏差"**。
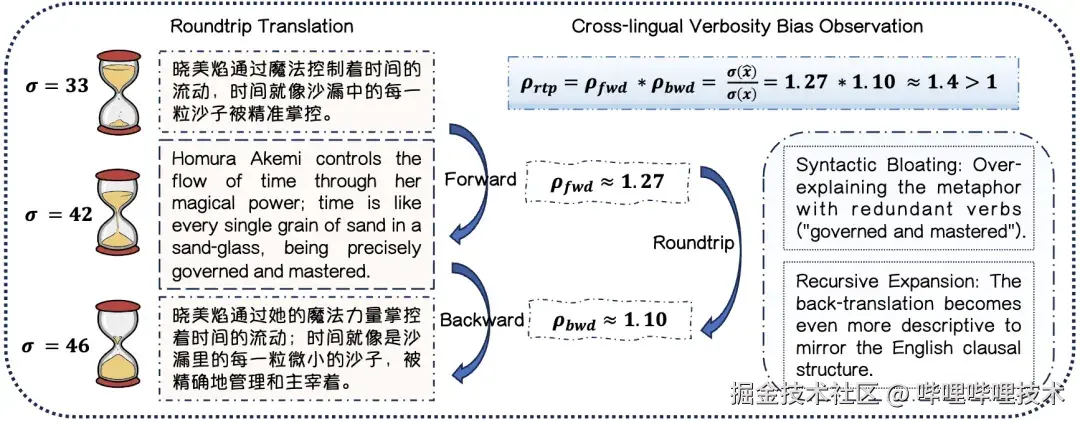
如上图所示,论文提出的**回环膨胀率(Roundtrip Expansion Ratio)揭示了一个关键问题:即使语义内容保持不变,LLM 生成的译文往往比源话语显著更长。传统的评估指标往往忽略了这一点,但这种"喋喋不休"的特性在时间受限(Time-Constrained)**的场景(如字幕翻译、视频配音及同声传译)中是致命的。在这些场景下,译文长度构成了一个刚性的"时间预算",直接决定了输出内容能否与画面或原声同步。
从信息论的角度来看,时间预算充当了严格的"速率约束"。模型必须在有限的音节配额内,通过词汇整合和句法重构,将最大化的信息密度压缩进最短的长度中。然而,现有的 LLM 很难自发实现这种平衡。这不仅是因为语言间的密度差异(如德语、西班牙语天然比中文占空间),更深层的原因在于 LLM 的对齐过程------现有的奖励模型往往存在"长度偏差",倾向于给更长、更详细的回答打高分。因此,如何"驯服"模型的长度,使其在不损失核心语义的前提下满足严苛的时间约束,成为了多语言本地化领域亟待解决的建模挑战。
本文核心贡献总结:
-
诊断分析: 系统量化了 LLM 翻译中的冗长偏差,并提出了回环膨胀率等跨语言诊断指标。
-
基准构建: 引入了 Sand-Glass 数据集,通过音节级预算模拟真实的配音与字幕约束场景。
-
方法创新: 提出了 HOMURA 强化学习框架,有效平衡了严苛的长度约束与语义保留。
3.基准测试与冗长偏差分析(Pilot Study)
为了量化时间受限场景下的翻译挑战,本研究构建了 Sand-Glass 基准测试,并对大语言模型的冗长偏差进行了深入诊断。
3.1 Sand-Glass 基准与音节度量
Sand-Glass 是一个源自真实视频语料的翻译基准。不同于通用翻译数据集,它引入了**音节(Syllable)**作为时间的代理指标。
-
等信息量原则(Iso-Information Principle): 科学研究表明,虽然不同语言的音节速率(SR)差异巨大(如西班牙语极快,汉语较慢),但全人类的信息传输速率恒定在约 39 bits/s。
-
语言密度差异: 如下表所示,汉语的信息密度(0.94)远高于西班牙语(0.63)。这意味着从汉语翻译到西班牙语时,为了保持语义完整,译文长度天然需要膨胀约 1.49 倍。
3.2 诊断指标:回环膨胀率
传统的"正向膨胀率"无法区分译文变长是因为"语言本身的密度差异"还是因为"模型废话多"。为此,论文提出了回环膨胀率(Roundtrip Expansion Ratio):
1.将源文翻译为译文。
2.将译文回译为源语言。
3.计算膨胀率:
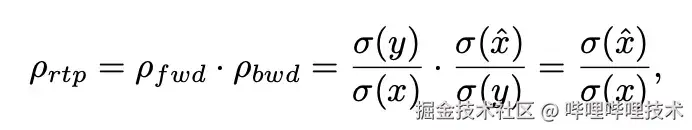
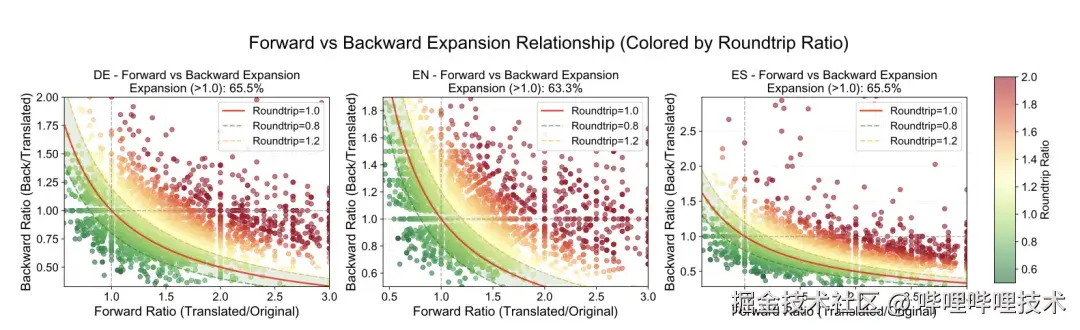
结论: 在理想状态下,同语言对比的回环膨胀率 应接近 1.0。但在 Sand-Glass 上的测试显示(见下图),主流模型的 ρrtp 普遍大于 1。这证明了 LLM 存在系统性的、与语言种类无关的冗长倾向。 (上图展示了大模型翻译下的语言膨胀分布图)
3.3 校准目标区间
为了打破这种偏差,本研究对比了"理论膨胀率"与"LLM 实际膨胀率",发现 LLM 普遍存在 30%-40%的额外冗余(Bias)。
基于此,HOMURA 框架设定了严苛的目标音节区间(Target Bounds):
- 英语 (En): 设定为 0.8, 0.9(强制模型进行摘要式精简)。
- 德语 (De): 设定为 0.9, 1.0。
- 西班牙语 (Es): 将原本1.84倍的音节比大幅压低至 1.0, 1.1。
这种设定强制模型通过改写(Rewriting)而非简单删减,在极短的时间预算内实现信息的最大化对齐。
4. HOMURA 框架设计 (Methodology)
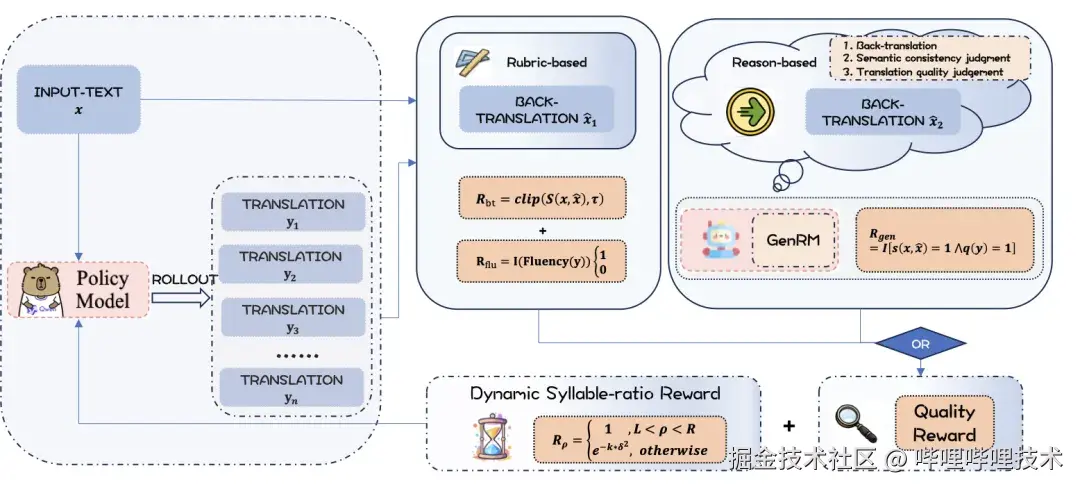
本研究将音节级控制建模为"可控文本生成"任务,目标是在满足严格音节比例约束的同时,最大化翻译质量。
4.1 KL 正则化目标与 GRPO 优化
为了实现精准控制,HOMURA 采用了基于 KL 正则化 的强化学习目标。其核心思想是:通过一个奖励函数 R(x,c,y) 鼓励模型满足长度约束,同时最大化模型翻译的生成质量。
- 优化算法: 采用 GRPO(Group Relative Policy Optimization) 算法。该算法无需额外的 Critic 网络,通过在同一组样本内进行归一化来计算优势(Advantage),极大降低了计算开销,适合序列级别的奖励优化。
4.2 奖励机制设计 (Reward Design)
这是 HOMURA 能够精准"驯服"长度的关键。奖励函数由长度合规奖励 和质量奖励两部分加权组成:
1. 动态音节比例奖励:
- 动态区间设定: 基于前述的语言密度分级设定基础目标区间 L_0, R_0。
- 短句平滑处理: 针对短句子(音节数少),微小的长度变化会导致比例剧烈波动(离散噪声)。本研究引入了动态缩放因子,对短句适度放宽下限。
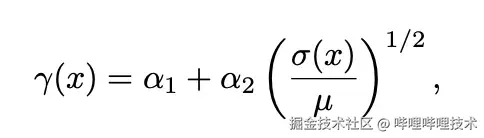
- 平滑奖励函数: 采用平方指数衰减函数而非简单的 0/1 判定,为优化过程提供连续的梯度引导,使模型逐渐向目标区间收敛。
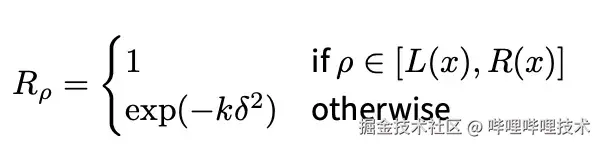
- 质量奖励:
为了确保压缩长度不会导致语义丢失或语句破碎,研究设计了两种质量评估路径:
- 基于准则的评估 (Rubric-based):
- 语义忠实度: 利用回译(Back-translation)机制,将生成的译文重新翻译回源语言,通过计算其与原句的**嵌入向量相似度(Embedding Similarity)**来衡量语义保留程度。
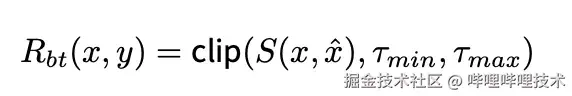
- 语言流利度: 使用大模型作为裁判,针对语法、可读性和语言一致性进行打分。
- 基于推理的评估 (Reason-based / GenRM):
通过训练一个专门的生成式奖励模型(GenRM),使其能够产生思维链(CoT)推理。该模型会先在内部进行回译和语义对比,再对流畅度做出判断,最后给出一个具备可解释性的二进制奖励信号。这种"先推理、后打分"的方式显著提升了奖励的鲁棒性。
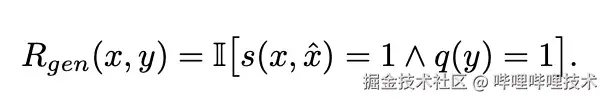
5. 实验结果与分析(Experimental Results)
本研究在 Sand-Glass 基准测试上对 HOMURA 进行了全面评估,并与 GPT-5、Claude-4.1 及 Gemini-pro-2.5 等主流模型进行了对比。
5.1 长度合规性与质量的权衡
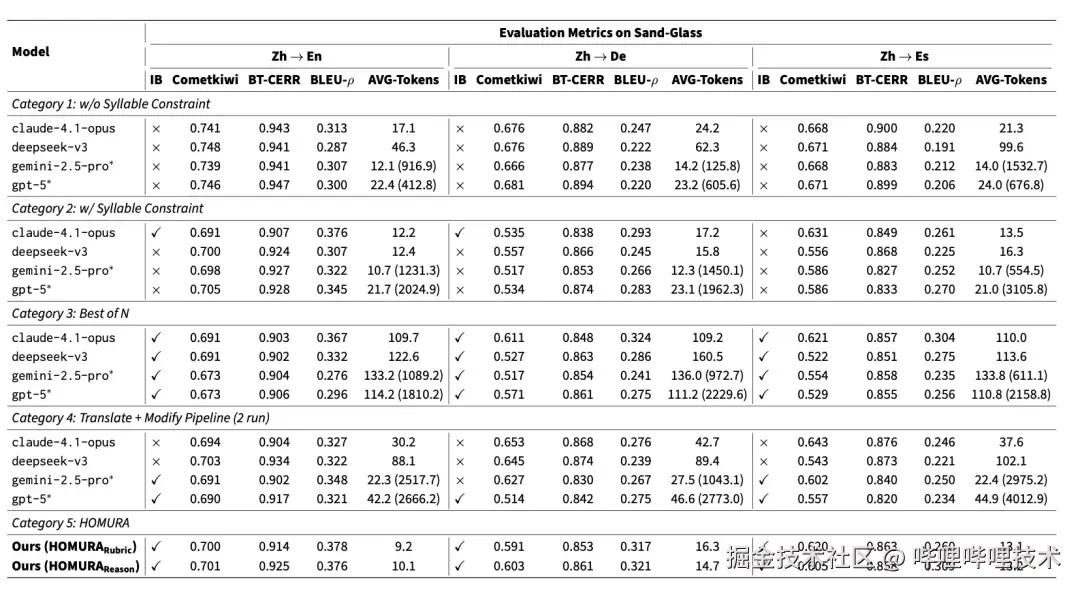
实验结果表明,HOMURA 在满足严苛时间预算方面表现出显著优势。
-
精准的长度控制: 相比于仅依靠提示词的模型,HOMURA 能够极高比例地将译文压缩在目标区间内。在英语、德语和西班牙语等多个语向中,HOMURA 的超限率(Over-length rate)远低于基线模型。
-
语义密度的提升: 论文引入了语义密度指标,用于衡量单位音节内的语义价值。结果显示,HOMURA 在压缩长度的同时,保持了极高的语义保留率。这证明模型并非通过简单"删减"来缩短长度,而是通过**语义巩固(Semantic Consolidation)**实现了更高的信息密度。
5.2 强化学习过程中的行为分析
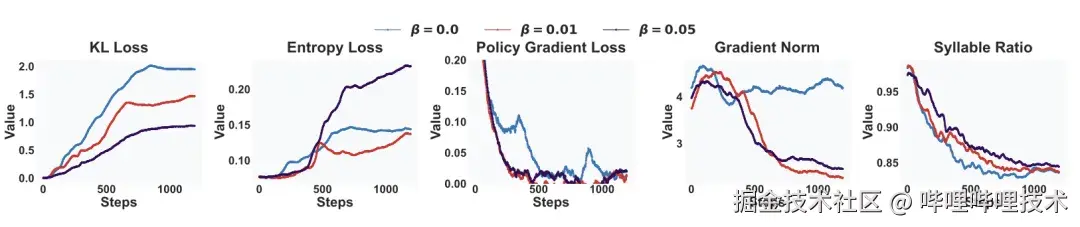
通过对训练过程的监控,我们观察到了模型策略的显著演变:
- 打破冗长先验(beta参数的影响): 实验中一个重要的发现是,当 KL 惩罚系数 beta > 0 时,模型往往会陷入"保守陷阱",不敢大幅度重构句子。而当 beta = 0 时,模型能够彻底摆脱基座模型的啰嗦倾向,学会更激进且高效的表达方式。
- 梯度范数与优化动量: 监控曲线显示,HOMURA 在优化过程中保持了稳定的梯度更新,能够有效地向"率失真(Rate-Distortion)"的前沿边界移动。
5.3 "压缩墙"的发现(The Compression Wall)
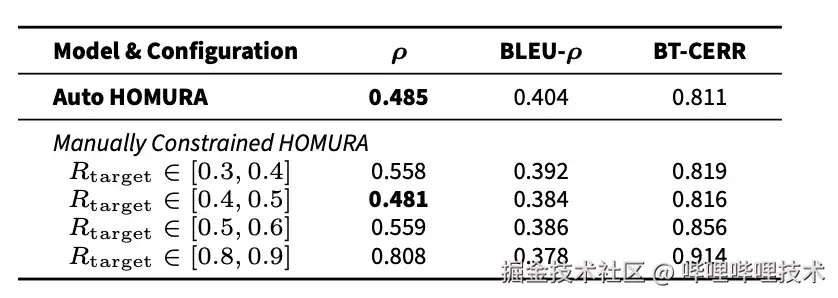
研究进一步探测了语义压缩的物理极限,我们基于设计自动压缩寻找最低极限。
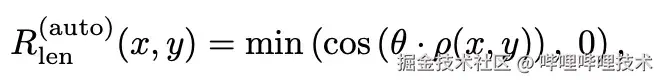
实验发现,对于语言对,存在一个"有效压缩阈值"(如中英翻译约为 0.49)。一旦压缩要求低于这个阈值,语义准确性会发生非线性崩塌。HOMURA 的优势在于它能够极其接近这一极限而依然保持译文的流利度。
5.4 质量-压缩权衡分析(Quality-Compression Trade-off)
为了深入探讨模型在不同长度限制下的表现,本研究从"率失真(Rate-Distortion)"视角分析了翻译质量与输出长度之间的权衡关系。
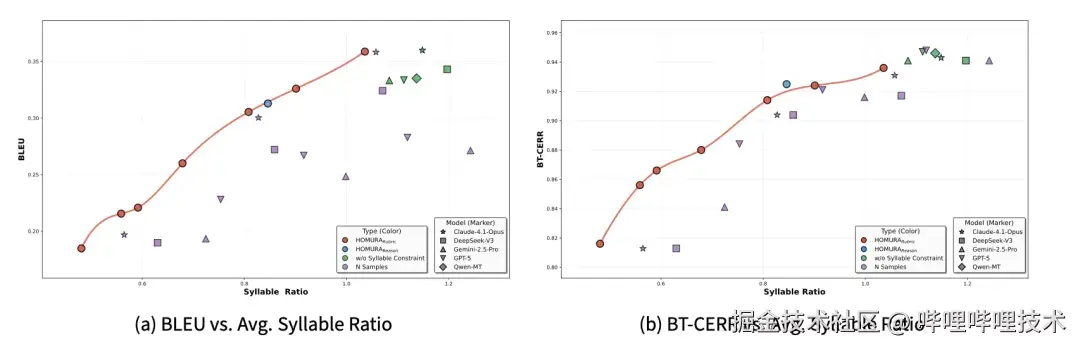
-
基线模型的局限性: 如图所示,未经约束的基线模型通常聚集在"高质量、长文本"区域。虽然可以通过提示词迫使 LLM 缩短译文,但其翻译质量会随着压缩率的增加而剧烈下降。这表明普通 LLM 在降低"音节速率"时效率较低,难以在极短的预算内识别并保留核心语义信息。
-
HOMURA 的高效权衡: 相比之下,HOMURA 展示了显著更高的率失真效率。在相同的音节预算下,HOMURA 的语义保真度显著优于基线;或者说,在保持相同质量水平的前提下,HOMURA 能实现更短的译文长度。
6. 结论 (Conclusion)
本研究深入探讨并解决了大语言模型(LLM)翻译中普遍存在的系统性"跨语言冗长偏差",这一偏差是实现字幕翻译、视频配音等时间受限任务的主要障碍。
- 基准构建: 本研究引入了 Sand-Glass 基准测试。该基准基于"等信息量原则(Iso-Information Principle)",利用音节预算模拟真实世界的时间约束,为量化评价翻译的"时间可行性"提供了科学工具。
- 方法突破: 提出了 HOMURA 强化学习框架。通过结合 KL 正则化目标函数与创新的"动态音节比例奖励",该框架在无需参考译文的情况下,实现了极其严格的长度合规性,并显著提升了单位长度内的信息密度。
本研究不仅在工程上实现了精准的长度控制,更在理论上界定了语义压缩的边界(例如中英翻译中0.49的可行性阈值)。未来的工作将进一步验证该压缩边界在更多语言对中的普适性,并计划将 HOMURA 扩展至端到端语音翻译领域,探索语义与时长联合优化的更多可能性。
7. B站原声翻译效果展示
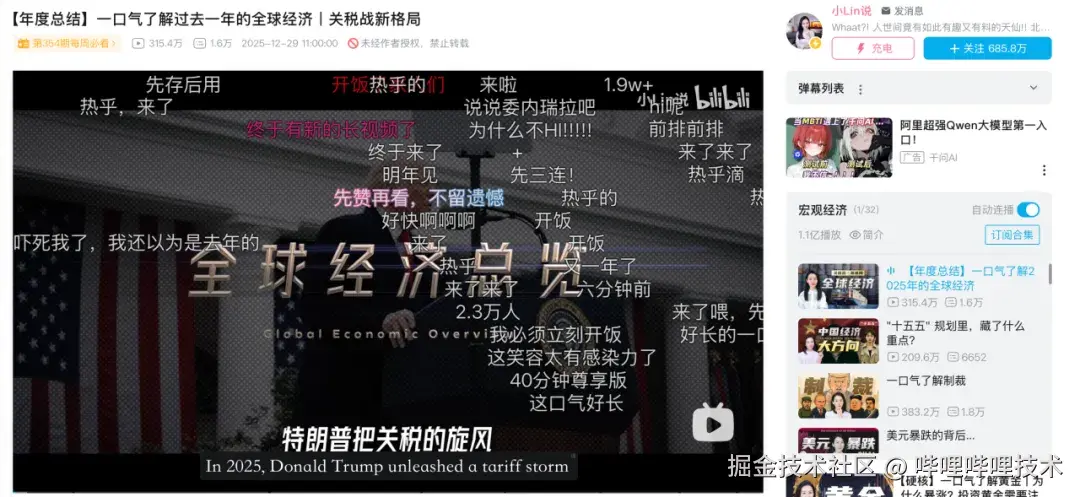
该功能依托 HOMURA 对时长的精准把控,生成了与原视频时间轴严格对齐的译文,从根本上解决了机器配音中'音画不同步'或'语速异常'的行业痛点,为用户带来了如同原生般的沉浸式视听体验。
www.bilibili.com/video/BV111...
8. HOMURA 入选 EMNLP 2026 Oral现场见
如果你也会参加 EMNLP,欢迎来听我们的 oral 、到 poster 现场交流,一起聊聊翻译、强化学习和多语言内容生产。
HOMURA 已被 EMNLP 2026 接收为 Oral(口头报告)。报告 已安排在 2026 年 10 月 27 日 09:00--10:30 的 Machine Translation and Semantics session,地点 F9-10。
我们也会参加 Poster Session D(10 月 26 日 11:00--12:30,Hall H) ,以及 WMT poster session ,欢迎到现场交流。以上时间均为布达佩斯当地时间,具体安排请以 EMNLP 官方日程(2026.emnlp.org/program/ )和 WMT 官方日程(*www2.statmt.org/wmt26/progr...
现场还会发放精美谷子,欢迎来交流技术与使用体验,把喜欢的周边带回去。我们 EMNLP 见!
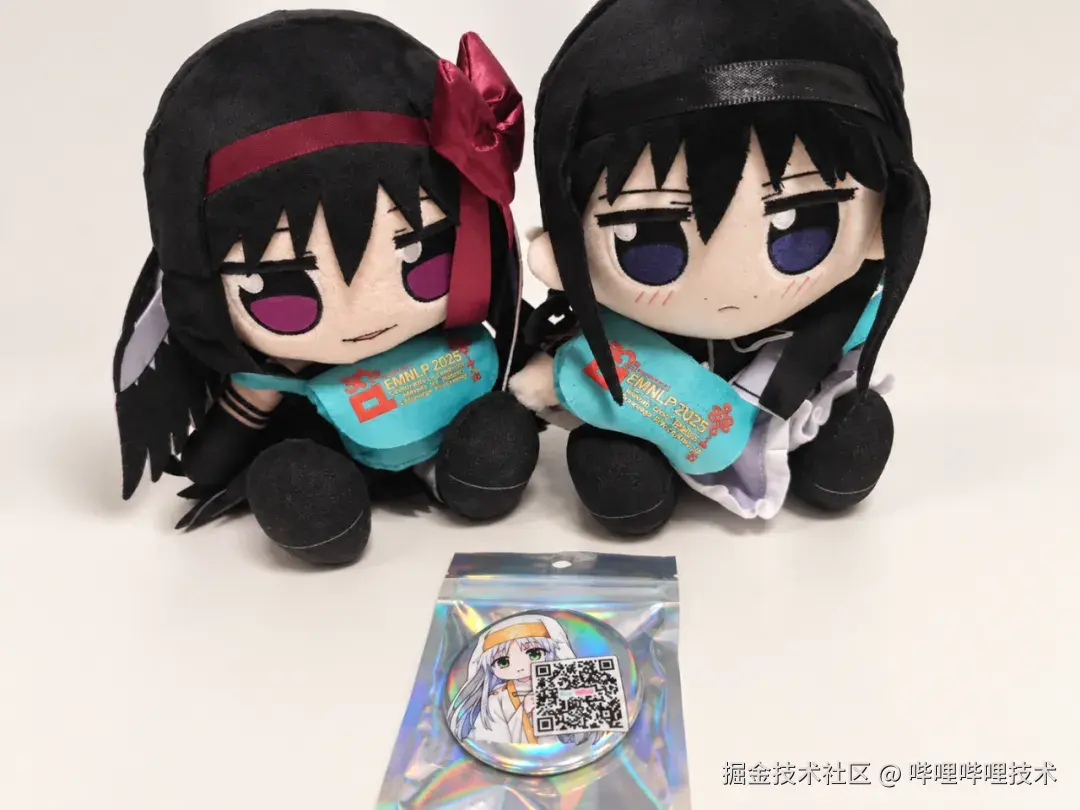
团队周边展示
-End-
作者丨Index LLM Team