我那个做文档处理的小站最近想加个截图转文字的入口。起因很俗。外包客户总把需求发成聊天截图害我一段段往文档里敲到眼花。最初的方案是前端先转灰度再按固定阈值 128 二值化然后送去识别。网上搜「OCR 预处理 二值化」能搜到不少这么教的文章。可这个站只有我一个人维护也没有测试同事帮我兜底,写到一半我心里开始发虚。这活没人替我验。万一哪种截图被二值化弄坏了用户只会拿到一个错的结果,我这边什么消息都收不到。于是我想先给这道二值化加个保险让它坏了就自动退回原图。下面写的都是给这个到今天还没上线的功能做的试验。
二值化前我想先加一道保险
保险的想法很简单。二值化之后数一下图里还剩多少个黑像素。剩 0 个就说明字全被洗掉了,这时候直接送原图不用处理过的图。这一步只要几行 OpenCV 用不着调识别,识别本身放在浏览器里跑也不用我再多掏一份服务器的钱。我先拿最可能出事的灰字开刀。那是我自己写的网页里一行 11 px 的灰色页脚,#f5f5f5 的浅灰底上放着 #999 的灰字。普通屏和 Retina 屏我各截了一张图。
python
def ink_after_cut(png, cuts=(100, 128, 160, 200)):
    g = imread(png, IMREAD_GRAYSCALE)
    for t in cuts:
        _, bw = threshold(g, t, 255, THRESH_BINARY)
        print(t, int((bw == 0).sum()))
    return int(g.min())
这段代码里的 threshold 用的是普通的 THRESH_BINARY,图是按灰度读进来的,每个阈值打印一行剩下的黑点数,最后返回这张图最暗的那个灰度值。灰度高于阈值的变白、其余变黑。最后数值为 0 的像素就是剩下的「黑点」。我量了这块截图发现文字最暗的像素是 153,这比 128 还要亮。阈值 100 和 128 一跑完黑点就是 0 个,整块都白了。保险就是为这个准备的。Retina 那张最暗同样是 153,在阈值 160 和 200 下分别剩 8127 个和 13232 个黑点。
剩0个黑点时字已经全没了
剩 0 个黑点这种情况保险确实拦得住。为了确认这不是我脚本的问题,我把阈值 128 处理过的图真拿去识别了一遍。识别我用的是图映(imging.cn/)的图片文字识别,默认... OCR 档和极速 OCR、极致 OCR 三档都跑了,样本是我自写网页截下来的 10 块裁切。我的测试机是一台 M4 芯片的 Mac 加 Chromium 149 开源构建的浏览器。对照的引擎是配了 chi_sim+eng 语言包的 tesseract.js 5,参数一个没改。三个档位和两种截图倍率再加上 tesseract.js 全是 0 字。图映进度面板上那句提示是说没找到可靠的字,可以转转图、关掉扫描增强或者往上换一档。
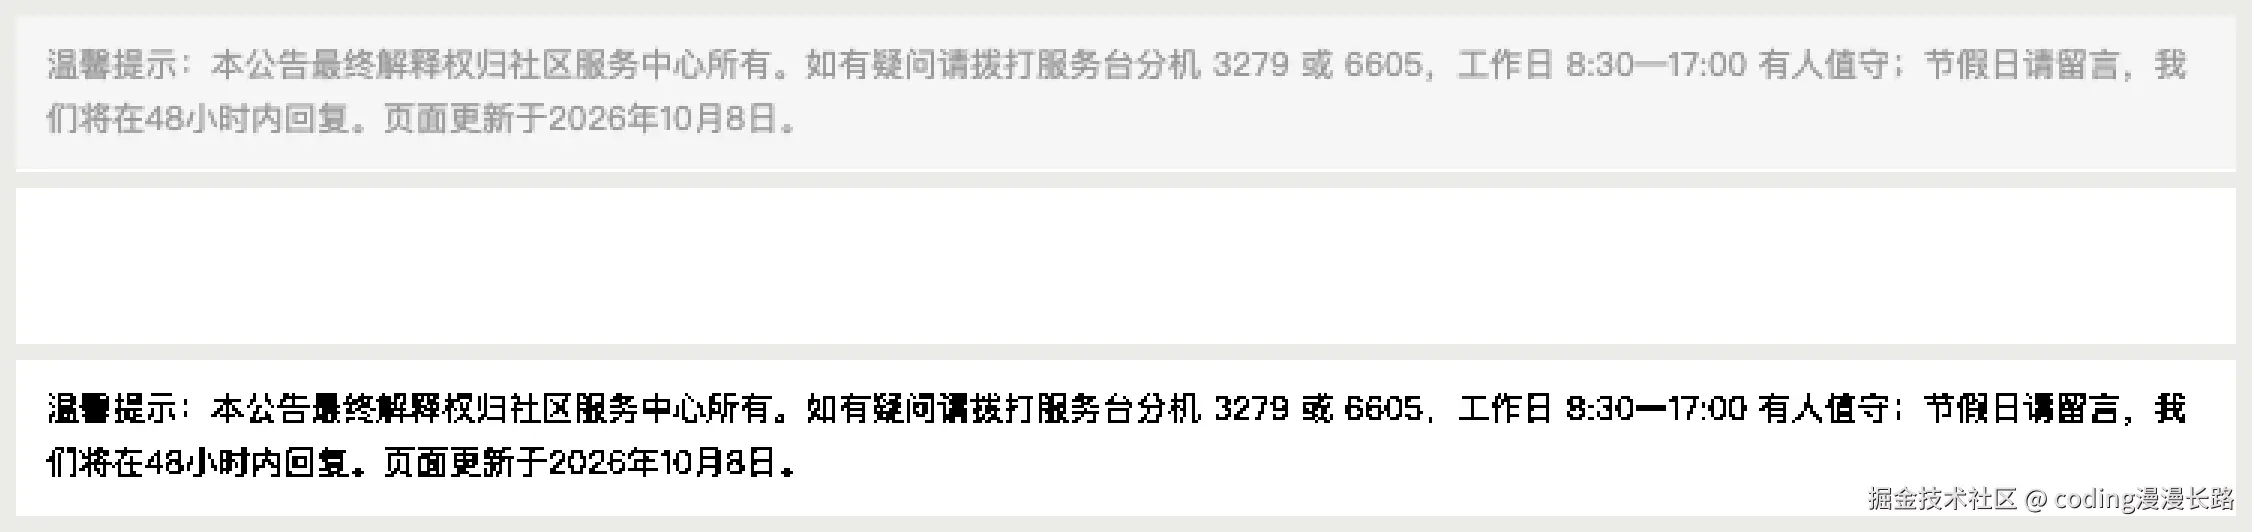
这张图中间那条是阈值 128 的结果,一个像素的字都没剩下也正好对上脚本数出来的 0。最下面阈值 200 的字还在而且笔画比原图还黑一些。
剩1212个黑点照样认成乱码
麻烦出在阈值 160 上,它刚好高过最暗那几个像素于是剩下了 1212 个黑点。按我的保险逻辑黑点不为 0 就会放行这张图送去识别。我把它的识别原文拿出来对答案,专业档错了 75.5%。认出来的是「洛た小↓公告终双社差有如有关公3279025...」这么一串夹着日文假名的东西。保险没响。黑点是有的,只是每一笔只剩正中间最深的那点芯已经拼不成字了。Retina 截图的笔画粗一些,同样是阈值 160 错误率只有 1.0%。同一套代码换一块屏幕截出来就是两种结果,这种问题我在自己电脑上很难复现。
我的第二个念头是把保险改严一点不看黑点改看字数。识别完数一数认出几个字,比原图少一大截就退回原图。为了看这条路走不走得通,我另写了一段字符错误率的计算,把四个版本的识别原文和答案逐个对了一遍。
python
def miss_rate(got, truth):
    got, truth = tidy(got), tidy(truth)
    cost = list(range(len(truth) + 1))
    for i, ch in enumerate(got, 1):
        corner, cost[0] = cost[0], i
        for j, want in enumerate(truth, 1):
            corner, cost[j] = cost[j], min(cost[j] + 1, cost[j - 1] + 1, corner + (ch != want))
    return cost[-1] / len(truth), len(got)
第二段代码里调用的 tidy 没贴出来。它先做全角半角归一再删掉空白,然后把各种横线统一成一种免得标点写法不同也被算成错。miss_rate 就是编辑距离除以答案字数再顺手把认出的字数一起返回。这套口径是我按之前核验的规则重写的。跑出来原图错 0.0% 认出 98 字、阈值 128 错 100.0% 认出 0 字、阈值 160 错 75.5% 认出 54 字、阈值 200 错 3.1% 认出 98 字。四个错误率和之前的记录逐位对得上。
字数对上了也不代表没认错
问题出在最后一行的阈值 200 上,它认出的 98 个字跟原图一模一样可错误率是 3.1%。字数对上了,字没对上。我把原文翻出来一看一共错了 3 处。「温馨」认成了「温暑」、工作时间里那道长横线认成了「一」、「值守」后面的分号变成了冒号。这种结果字数守卫会当成正常的放过去,用户复制走的就是一份带错字的通知。电话号码那几位数倒是全对,他大概率发现不了。到这里我才想明白线上根本没有标准答案可对,不管数黑点还是数字数都一样。保险只能拦住最极端的全白,字被削成乱码或者悄悄错几个字的情况它都拦不住。
我又回头看了 10 块裁切合起来的数。专业档原图和转灰度都是 0.1%,开图映界面上的「扫描增强」是 0.2% 基本持平。Otsu 自动阈值是 1.1%,固定阈值 128 是 25.8%。三个档位的原图分别是 0.8%、0.1% 和 0.7%,彼此差不到 1 个百分点。这数我看了两遍。我花心思补保险的这道二值化其实本来就在扣分。这下算是白忙了。那个默认关着的「扫描增强」开关旁边写着「仅轻度灰度、对比度与锐化,不强制二值化」。我原本以为它是个提识别率的按钮,可在这批样本上它并没有带来变化。隐私这块我也顺手看了一眼,识别是在本机的 Worker 里跑的。这一轮大约 800 次识别里非 GET 请求一次都没有。首次打开要下载的是模型而不是上传图片。
竖排是另一回事。原本不在计划里的还有网页上一段四列从右往左读的 16 px 竖排文字。原样识别时专业档的字符错误率是 92.3%,乍一看像全认错了。换成不计顺序的算法再算只有 0 到 7.7%。字基本都对,毛病出在列的顺序整个反了。点界面上的「↶ 左转 90°」再识别就变成了四行,Retina 截图三档都是 0 错。普通屏的小图转过来以后极速档和专业档还丢了 2 个标点,错误率是 5.1%,字倒是一个没错。阈值和去噪都救不回这个顺序只能靠旋转。旋转按钮我估计半天就能写完,比调一套阈值省事多了。
最后我把默认二值化拿掉了
改完的方案比原来还短。就三条。用户传上来的截图原样送去识别,前端不做二值化也不做任何默认的「增强」。碰上竖排就在界面上放个旋转按钮,让用户自己转过来。识别出 0 字时结果区要给一句提示让他把图转一下再试,别只留个空框。数黑点那段代码我没删而是留在本地当自检脚本用。以后要试新的处理方式就先跑一遍看会不会剩 0 个黑点。线上我不放它。它能拦的那种情况只要前端不做二值化就根本不会发生。我还顺手算了一笔时间账。同一档里各个预处理版本的识别墙钟中位数在极速档和专业档上相差不到 20 毫秒。预处理并不会让识别变快。真正花时间的是头一回打开,专业档从下载模型到初始化完大约 23.0 s,其中下载 29.8 MB 只用了约 3 s,剩下的时间都停在「初始化识别引擎」。这笔时间跟做不做预处理没有关系,而且这是 M4 上的数,用户的旧手机上要等多久我也还没测过。我在意的是用户头一回点进来时等不等得住,这个我打算在按钮旁边写一句提示首次要加载模型。我泡了一壶便宜的口粮茶把那半截写好的保险逻辑整个删了。删完反倒轻松。
这轮试验能说明的范围不大。我记几条。截图都来自我自己写的网页,用的是苹方字体和 11 到 16 px 的字号。另有两块是从网上找的一张放假通知模板里裁出来的。数黑点和数字数这两段我只在那一块灰字页脚上跑过,换一种灰度或者换一种底色会不会也是这个走向我没再去试。拍照件我只有两张程序合成的模拟拍照样本。真实手机拍的照片还没测,用户要是传纸质通知的照片我现在说不准会怎样。每种组合我只跑了 1 次所以 1 到 2 个百分点的差可能只是随机波动。浏览器也只试了 Chromium 149 开源构建,手机上没试过。
打算给用户截图加预处理的话可以先挑一块浅灰字的截图量一下文字最暗的像素再拿它对照你的阈值。阈值比它低的话,这道二值化就先别上。拿不准就别做。把原图直接送进去,在我这批截图上原图就是错得最少的那一版。