发布日期:2026-10-09
OpenCode 报错 Rate limit exceeded. Please try again later.,通常表示当前请求被 OpenCode 所连接的模型供应商、网关或账号套餐暂时拒绝,并不自动等于 OpenCode 安装损坏。2026 年 10 月的排查顺序应是:先确认实际供应商和模型,再看 HTTP 状态码、响应体、请求头和日志,最后根据是 RPM/TPM、并发、月度额度、余额还是供应商临时拥塞采取不同处理。
先判断:限流发生在哪一层
OpenCode 是客户端和编排层,不是所有模型请求的最终计费方。官方文档说明,OpenCode 通过 AI SDK 和 Models.dev 支持多家供应商;配置中的 baseURL 还可以把请求发往代理服务、自建网关或兼容 OpenAI API 的端点。
因此,同一条英文提示可能来自五个位置:
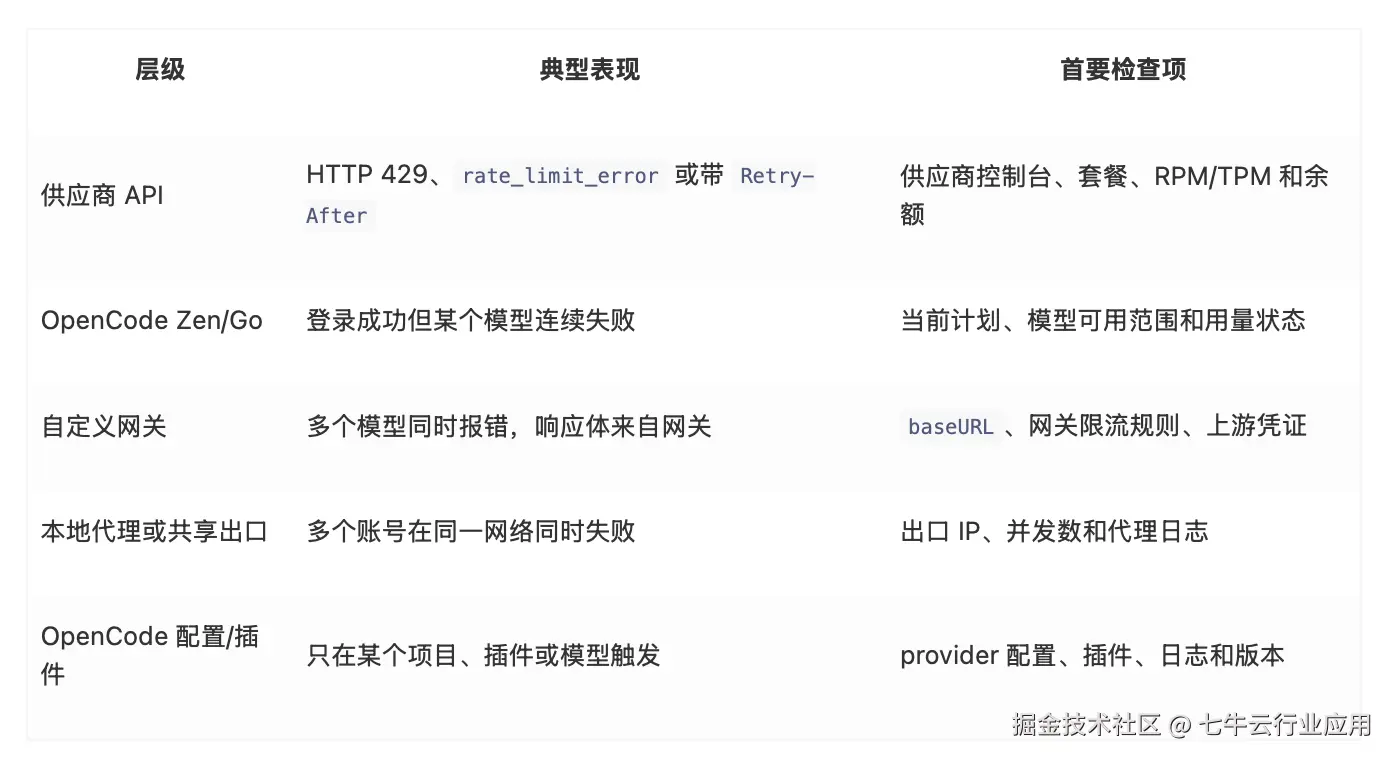
OpenCode 官方代码会保留上游错误的状态码、响应头、响应体和 URL 元数据,并将可重试性传给上层。看到"Rate limit exceeded"时,不能只重装 OpenCode 或盲目换模型。
常见原因:RPM、TPM、并发和额度不是一回事
"限流"至少包含四种不同问题。RPM 是单位时间请求数超限;TPM 是单位时间输入或输出 Token 超限;并发限制是同时进行的请求过多;月度额度或消费上限则可能让请求持续失败,等待几分钟也不会自动恢复。
Anthropic 的 API 错误文档把 429 定义为组织触发速率限制、达到套餐月度消费上限,或达到 Claude Code 工作区消费限制。部分消费上限没有 Retry-After,会持续失败直到额度恢复。该文档还提醒,流量突然加速可能触发加速限制,稳定、渐进的流量更容易维持可用性。
这意味着"请稍后重试"只适合短时速率限制或供应商拥塞。若同一模型在等待后仍返回 429,应优先查看账户额度、工作区消费上限和供应商控制台,而不是不断点击重试。
第一步:拿到真实状态码和请求日志
OpenCode 官方 Troubleshooting 文档建议先检查日志。macOS/Linux 日志目录是 ~/.local/share/opencode/log/,Windows 日志目录是 %USERPROFILE%\\.local\\share\\opencode\\log;日志按时间命名,默认保留最近 10 个文件。
可以先用更详细的日志启动:
c
opencode --log-level DEBUG排错时重点记录四项:HTTP 状态码、供应商或网关 URL、错误响应体、是否出现 Retry-After。不要把 API Key、完整 Authorization 请求头或含密钥的 auth.json 上传到公开 issue。
如果需要把终端输出一起保留,可使用官方文档提到的:
arduino
opencode --print-logs日志能区分"真正的 429"与"网关把 403、余额不足或上游超时改写成 Rate limit exceeded"。这一步比清空缓存更有价值。
第二步:确认 OpenCode 当前用的是谁和哪个模型
在 TUI 中运行 /models 查看可用模型,并检查当前模型的 provider 前缀。官方示例使用 openai/gpt-4.1、openrouter/google/gemini-2.5-flash 和 opencode/kimi-k2 这类 provider/model 形式。
再运行 /connect 重新认证当前供应商。OpenCode 官方文档说明,使用 /connect 保存的凭证位于 ~/.local/share/opencode/auth.json。如果是 API Key 失效、撤销或填错,通常会更接近 401;如果是模型不可用,通常应先检查 provider 和 model ID,而不是把它归类为限流。
如果配置了自定义端点,检查 opencode.json 中的 provider.<id>.options.baseURL。OpenCode 文档明确支持用 baseURL 指向自定义端点;因此错误可能来自该端点的限流策略,而不是官方模型服务。
第三步:按原因选择修复动作
只是短时 429 或供应商拥塞
停止连续点击重试,等待响应头给出的时间;没有 Retry-After 时采用逐步延长的退避,例如 5 秒、15 秒、30 秒。多个终端或插件同时运行时,先关闭重复任务,避免等待期间继续消耗请求额度。
RPM、TPM 或并发超限
减少并发会话,拆小任务,降低上下文和输出长度,并避免让多个自动化任务同时调用同一 Key。对批处理任务设置队列和退避,不要用循环立即重发失败请求。
月度额度、余额或工作区上限
登录对应供应商控制台,确认余额、月度消费上限、工作区预算和模型权限。等待不会解决已经达到消费上限的 429;需要调整计划、预算或切换到有额度的 provider。
OpenCode Zen/Go 或共享服务限额
确认当前登录账号与计划,查看服务方的用量状态和开放模型。不要把"能在 /models 里看到"理解为"当前一定有剩余额度";模型目录和实时配额是两件事。
自定义网关或中转端点限流
临时把 baseURL 恢复为供应商官方端点,或用同一 Key 做一次最小请求对比。若官方端点成功而自定义端点失败,优先检查网关的令牌桶、并发、上游 Key 和错误码映射。
第四步:用最小配置复现
为了排除插件和项目配置影响,可以在一个干净目录中启动 OpenCode,只连接一个 provider、一个模型和一个 API Key。先运行短问题,再逐步增加上下文、工具调用和并发。
不要先删除整个 ~/.local/share/opencode。官方 Troubleshooting 将清除存储作为 ProviderInitError 等配置损坏问题的处理手段;它会涉及 auth.json、日志、项目会话和消息数据。对 Rate limit exceeded,优先保留日志和会话证据,只有确认配置损坏时才备份后清理。
如果错误只在桌面端出现,官方建议检查插件、缓存和本地 server 设置。缓存目录通常是 ~/.cache/opencode;清除缓存可能修复 provider package 兼容问题,但不会提高供应商的 RPM、TPM 或账户额度。
什么时候该换模型,什么时候不该换
如果只有一个模型触发 429,且同一 provider 的其他模型可用,可以暂时切换到有额度的模型,并降低请求频率。如果同一 provider 的所有模型都失败,换模型通常没有意义,应先查账户额度、共享出口或网关规则。
如果多个 provider 同时报错,优先检查网络、代理、系统时间和本地配置。如果只有某个自定义 baseURL 失败,优先回滚端点并核对网关日志。换模型不能修复失效 API Key、错误 URL 或达到月度消费上限。
一份可执行的排错清单
-
记录错误发生时间、模型 ID、provider、HTTP 状态码和响应体。
-
使用
opencode --log-level DEBUG或opencode --print-logs复现一次。 -
运行
/models确认模型 ID,运行/connect检查认证状态。 -
检查供应商的 RPM、TPM、并发、余额、月度额度和工作区上限。
-
暂停重复终端、插件和后台任务,采用指数退避。
-
检查
baseURL是否指向自定义网关,必要时用官方端点做对照。 -
只在确认配置或 provider package 损坏时清缓存,先备份会话与认证信息。
-
提交 issue 时脱敏 API Key、Authorization 头、完整请求体和私有代码。
结论
OpenCode 的 Rate limit exceeded. Please try again later. 是一个排查入口,不是单一故障结论。先拿到状态码和响应体,再区分短时 429、RPM/TPM、并发、消费上限、认证和自定义网关,修复动作才不会跑偏。
本文数据截至 2026 年 10 月 9 日。OpenCode 的 provider 与 Troubleshooting 文档、GitHub 源码和 Anthropic API 错误文档均可能继续更新,遇到新版本时应以当前页面和实际日志为准。