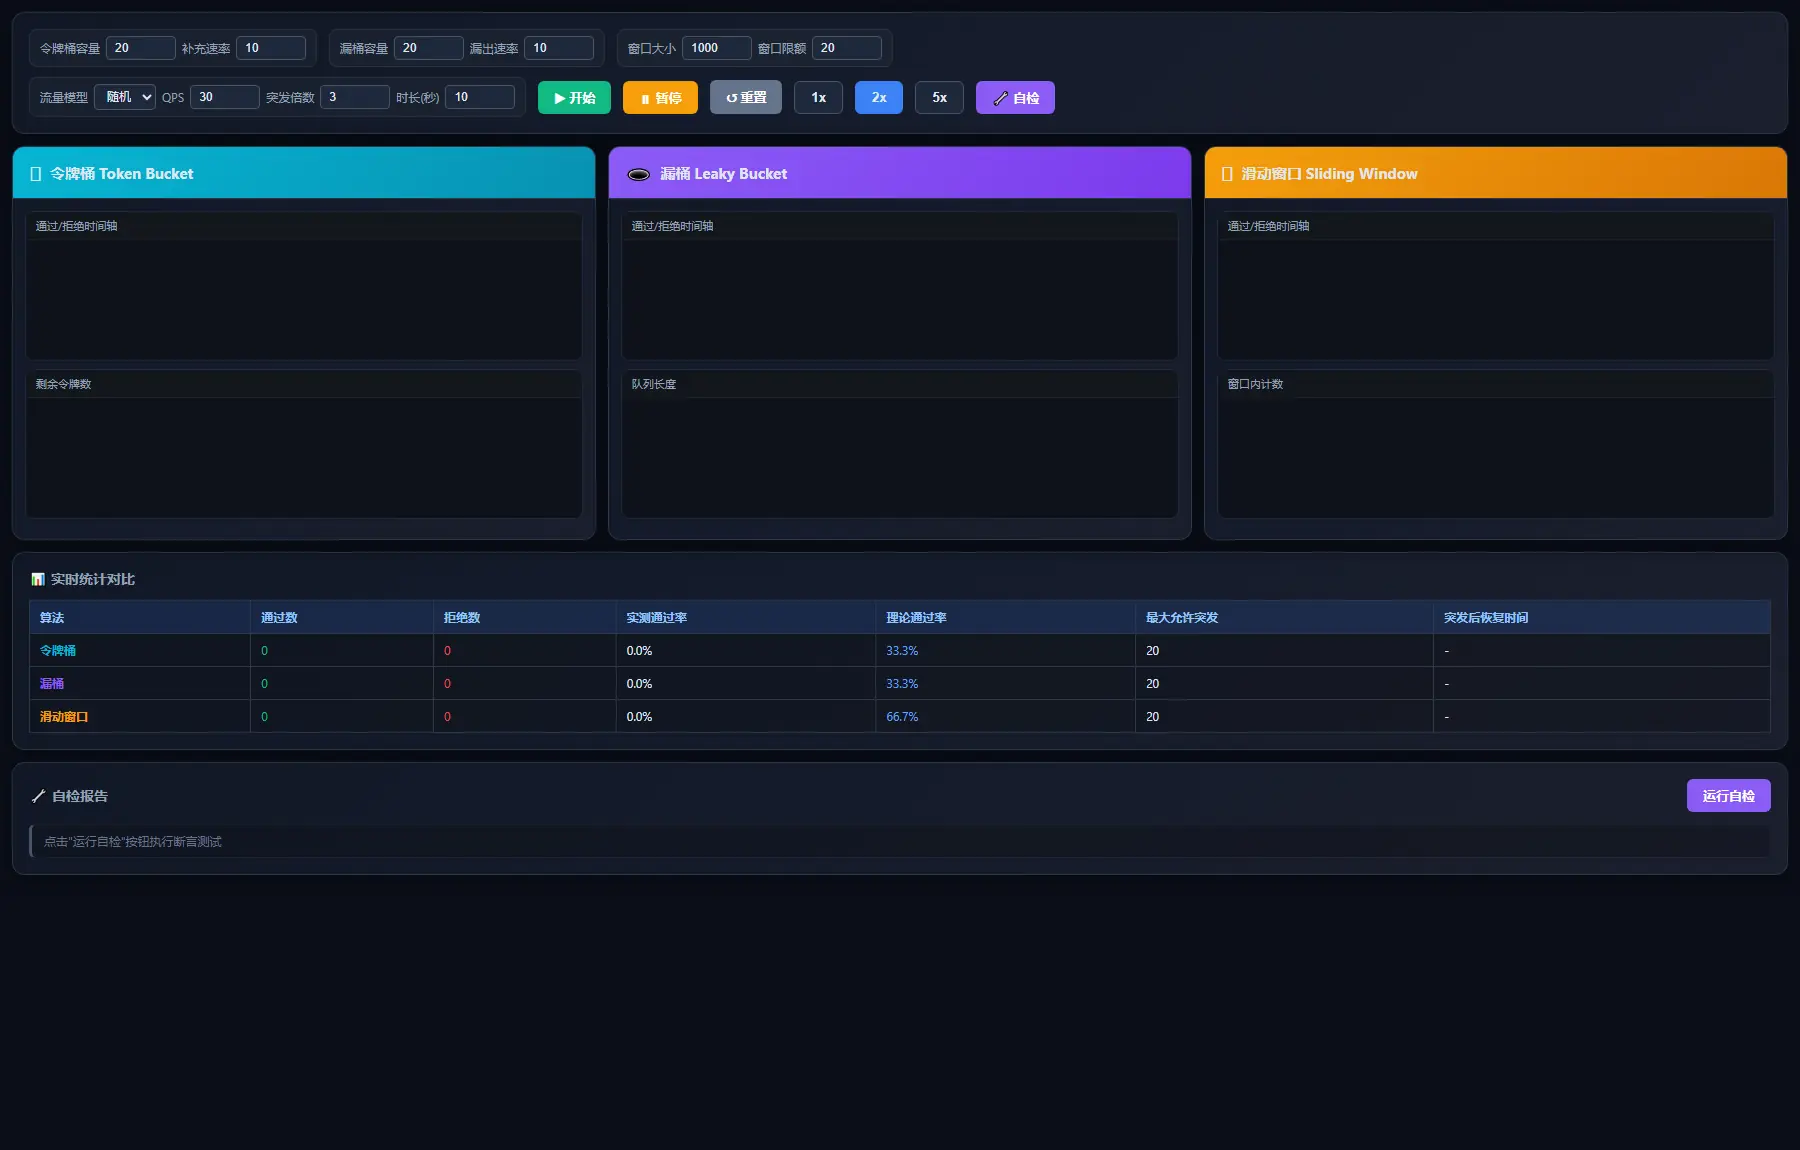
同一个 QPS、同一份参数,我把流量同时打进令牌桶、漏桶和滑动窗口。
页面算给我的理论通过率是 33.3%、33.3%、66.7%。
真跑起来完全不是这个数。
我只改了一个参数,倍速:1x 时三种算法一个请求都没拒,2x 时令牌桶掉到 61.0%,5x 时只剩 29.8%。
算法一行没改,参数一个没动。
这一轮我跑出三件事:理论公式里少算的那一笔、倍速偷偷改掉的 QPS 上限,还有 16 条自检里那条一直红的。
| 我关心的 | 跑出来的结果 |
|---|---|
| 令牌桶通过率 / 页面理论值 | 29.8% / 25.0% |
| 漏桶通过率 / 页面理论值 | 27.8% / 25.0% |
| 滑动窗口通过率 / 页面理论值 | 50.0% / 50.0% |
| 自检断言 | 15 / 16 通过 |
| 1x 倍速实际发出 | 98 个请求,QPS 填的是 30 |
| 5x 倍速实际发出 | 400 个请求,和 QPS 40 对得上 |
成品是一个 index.html,双击就能跑,不联网、不引第三方库、没有构建步骤。
案例目录在这里,下载下来直接打开:
text
https://atomgit.com/deli007/demo_park/tree/main/codearts-rate-limiter-lab边界交代一句:这是个把算法摊开的教学沙盘,不是能塞进网关的限流组件。
它跑在浏览器主线程里,流量由页面自己生成,所以它测的是算法行为,不是真实网关的吞吐。
为什么值得看:限流配错了不报错,只会悄悄多放或者少放
限流参数是少数几个配错也不会报错的东西。
QPS 填小了,线上只是偶尔多进来几个请求,监控上看不出异常。
填大了,下游被打挂的锅还会算到别人头上。
面试里也爱问令牌桶和漏桶的区别,背答案容易,把两条曲线并排跑起来才知道差别在哪一段。
我前两天做过一个 SQL 分组语义沙盘,那次的教训是:能跑通、不报错、数字偏了,才是最坑的一类问题。
限流是同一个道理,而且更难发现,因为它的错误表现为「少拒了几个」。
一、先看结果:一波突发流量打进去,三种算法给出三个答案
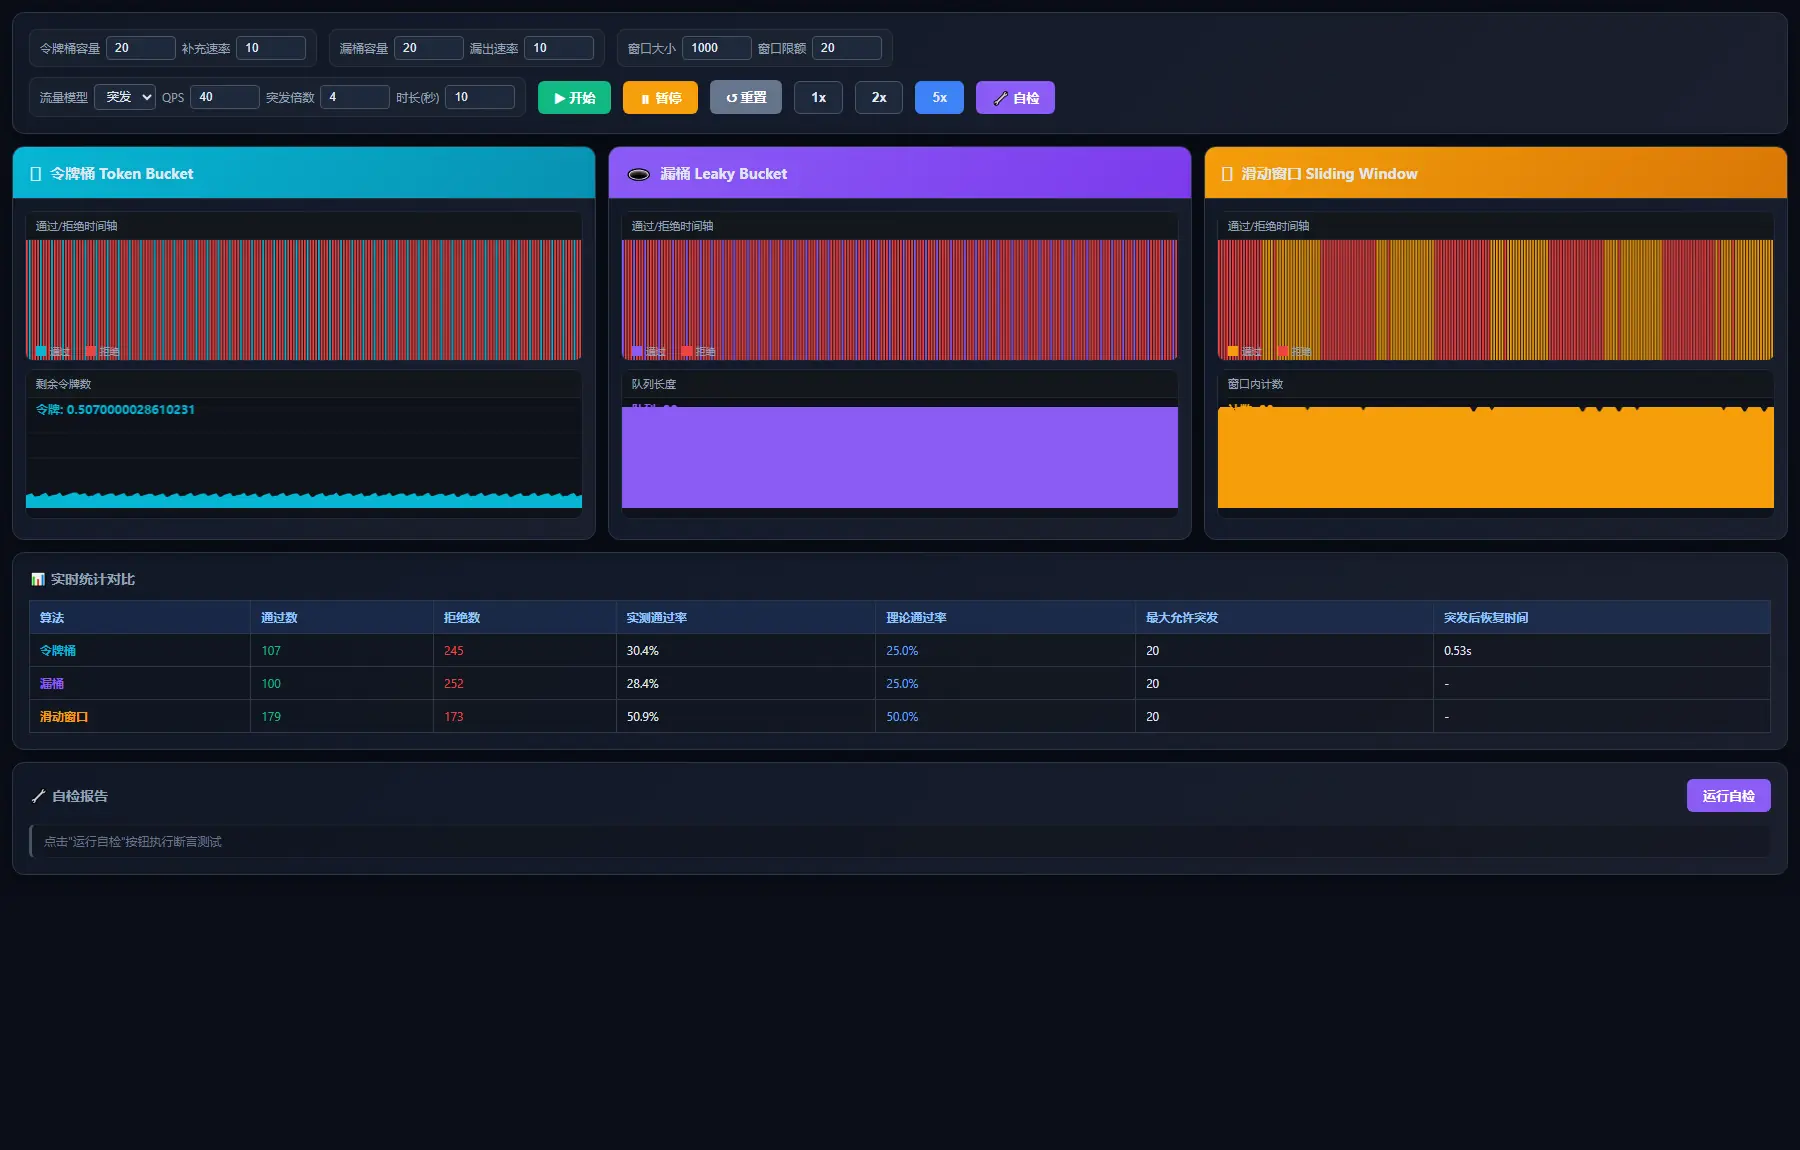
三块面板收到的是同一波请求,处理方式完全不同。
令牌桶一开始是满的,20 个令牌直接兑出去,所以前面一段全绿。
令牌用光以后它只能按每秒 10 个补充,QPS 40 里就只有 10 个能过。
漏桶的队列容量也是 20,先把请求兜住,队列满到 20 才开始拒。
滑动窗口没有桶,它是纯粹的「一秒之内最多 20 个」。
跑满 20 个之后,必须等最早那个请求滑出窗口,才腾得出名额。
三块面板的纵轴也不一样:令牌桶画剩余令牌数,漏桶画队列长度,滑动窗口画窗口内计数。
同一个负载,三条曲线形状完全不同。令牌桶是打完贴底再慢慢爬,漏桶是堆高然后走平,滑动窗口是锯齿。
二、理论公式少算了启动那一笔
页面给的「理论通过率」用的是最朴素的式子。
令牌桶和漏桶写的是补充速率除以 QPS,滑动窗口写的是窗口限额除以窗口时长再除以 QPS。
拿 QPS 40、补充 10 个每秒、容量 20 这组参数代进去,令牌桶和漏桶都是 25.0%,滑动窗口 50.0%。
实测跑出来是 29.8%、27.8%、50.0%。
滑动窗口一分不差,带桶的两个都偏高。
偏高的那一笔是启动额度,桶一开始就是满的,那 20 个令牌等于白送。
20 除以 400 个请求正好 5 个百分点,对上令牌桶那 4.8 个点的差。
漏桶的差小一点,2.8 个点,因为它跑完那一刻队列还是满的 20 个,这批请求算了通过、其实还没漏出去。
| 算法 | 发出请求 | 实测通过 | 实测通过率 | 理论通过率 | 差值 |
|---|---|---|---|---|---|
| 令牌桶 | 400 | 119 | 29.8% | 25.0% | +4.8 |
| 漏桶 | 400 | 111 | 27.8% | 25.0% | +2.8 |
| 滑动窗口 | 400 | 200 | 50.0% | 50.0% | 0 |
所以别拿这个理论值去卡容量,它算的是稳态,不含启动那一段。
真要估,得把桶容量也算进去:桶容量加补充速率乘时长,再除以总请求数。
反复跑同一组参数,数字会抖 ±2 个请求,因为仿真按真实时间推进,不是均匀切片的。
三、验证与踩坑:倍速不是一个无关参数
这是这轮最有意思的地方。
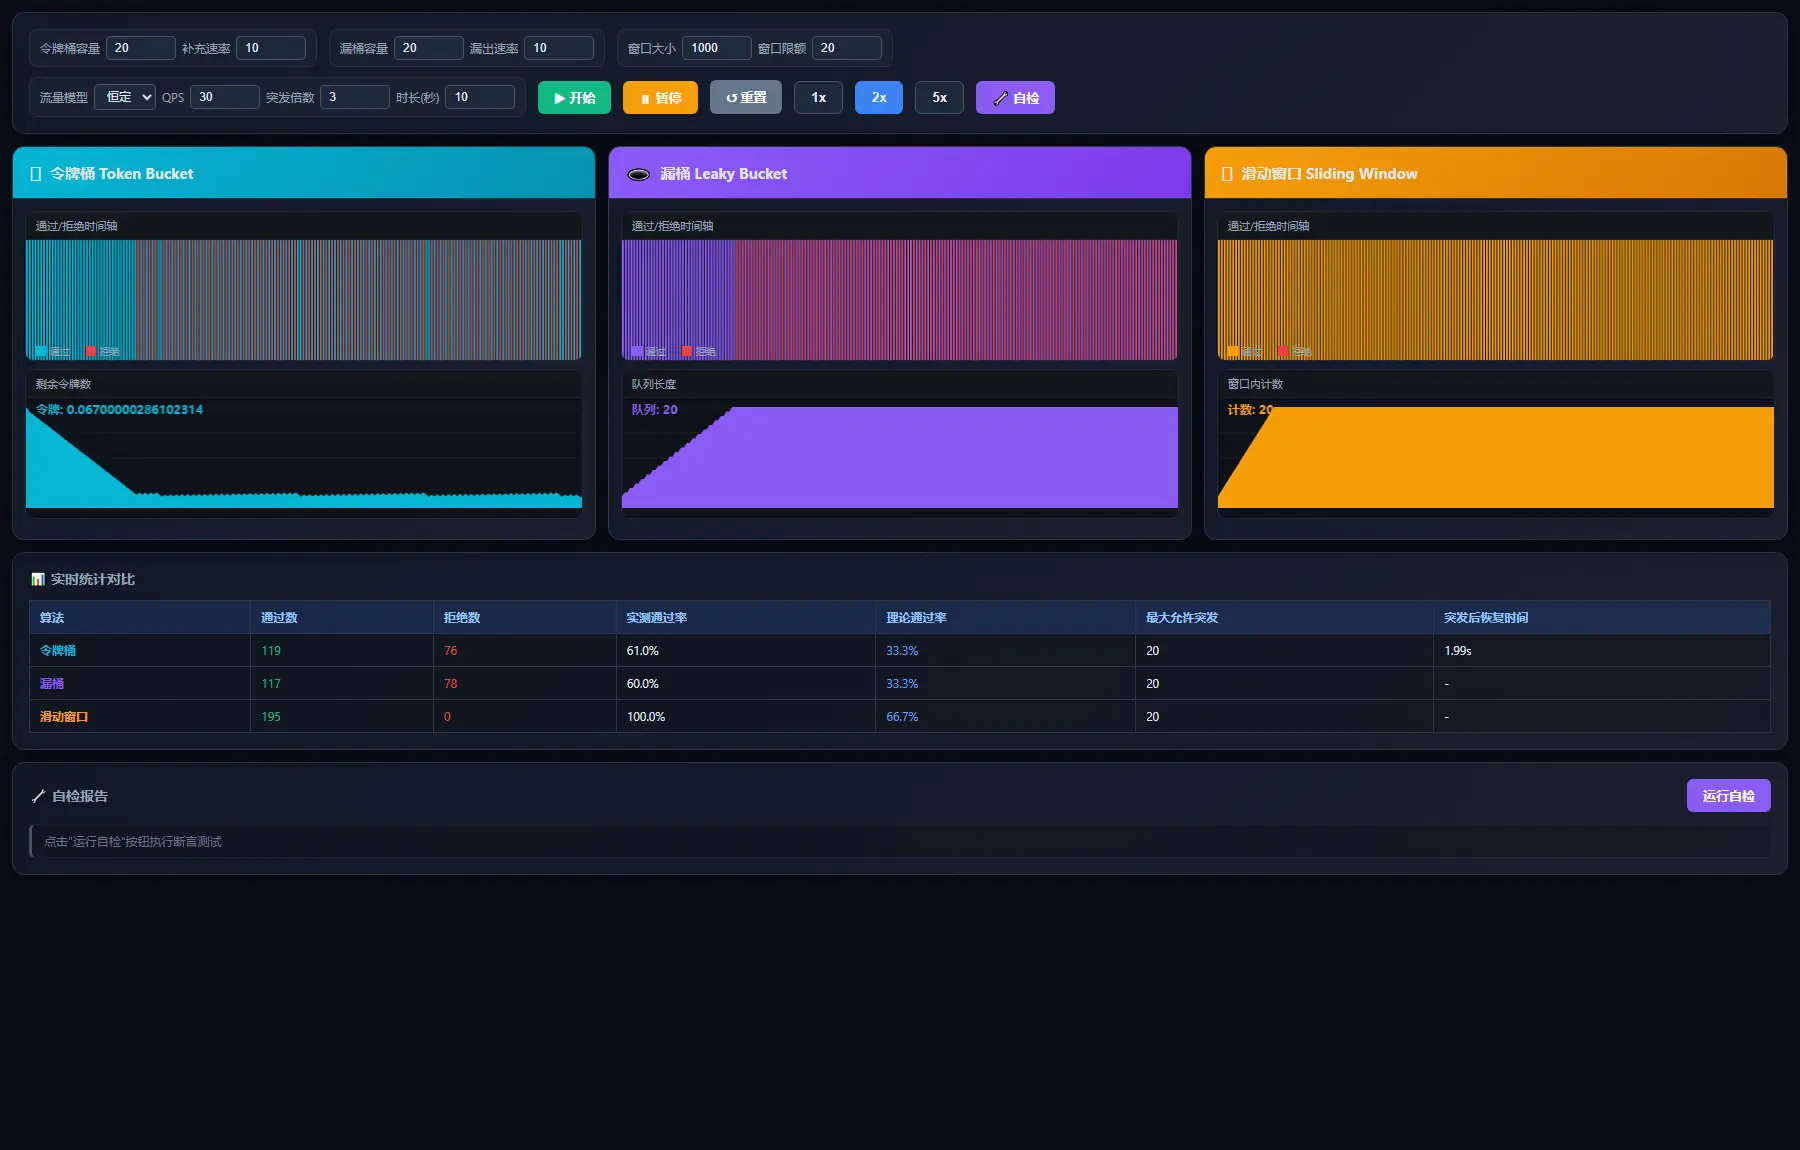
我把 QPS 定成 30、流量模型选恒定、时长 10 秒,只把倍速从 1x 换到 5x,重新跑。
1x 那次三种算法一条拒绝都没有。
2x 时令牌桶掉到 61.0%,漏桶 60.0%,滑动窗口仍然全过。
5x 才掉到 29.8%、27.8%、50.0%。
原因在流量生成器上:仿真每一步只放行一个请求,而每一步之间的间隔写死成 100 除以倍速毫秒。
1x 时一步 100 毫秒,上限就是每秒 10 个请求。
QPS 填 30,实际只发得出来 10 个。
所以 1x 那次跑的根本不是 QPS 30,是 QPS 10;补充速率也是每秒 10 个,两边相等,一个都不拒。
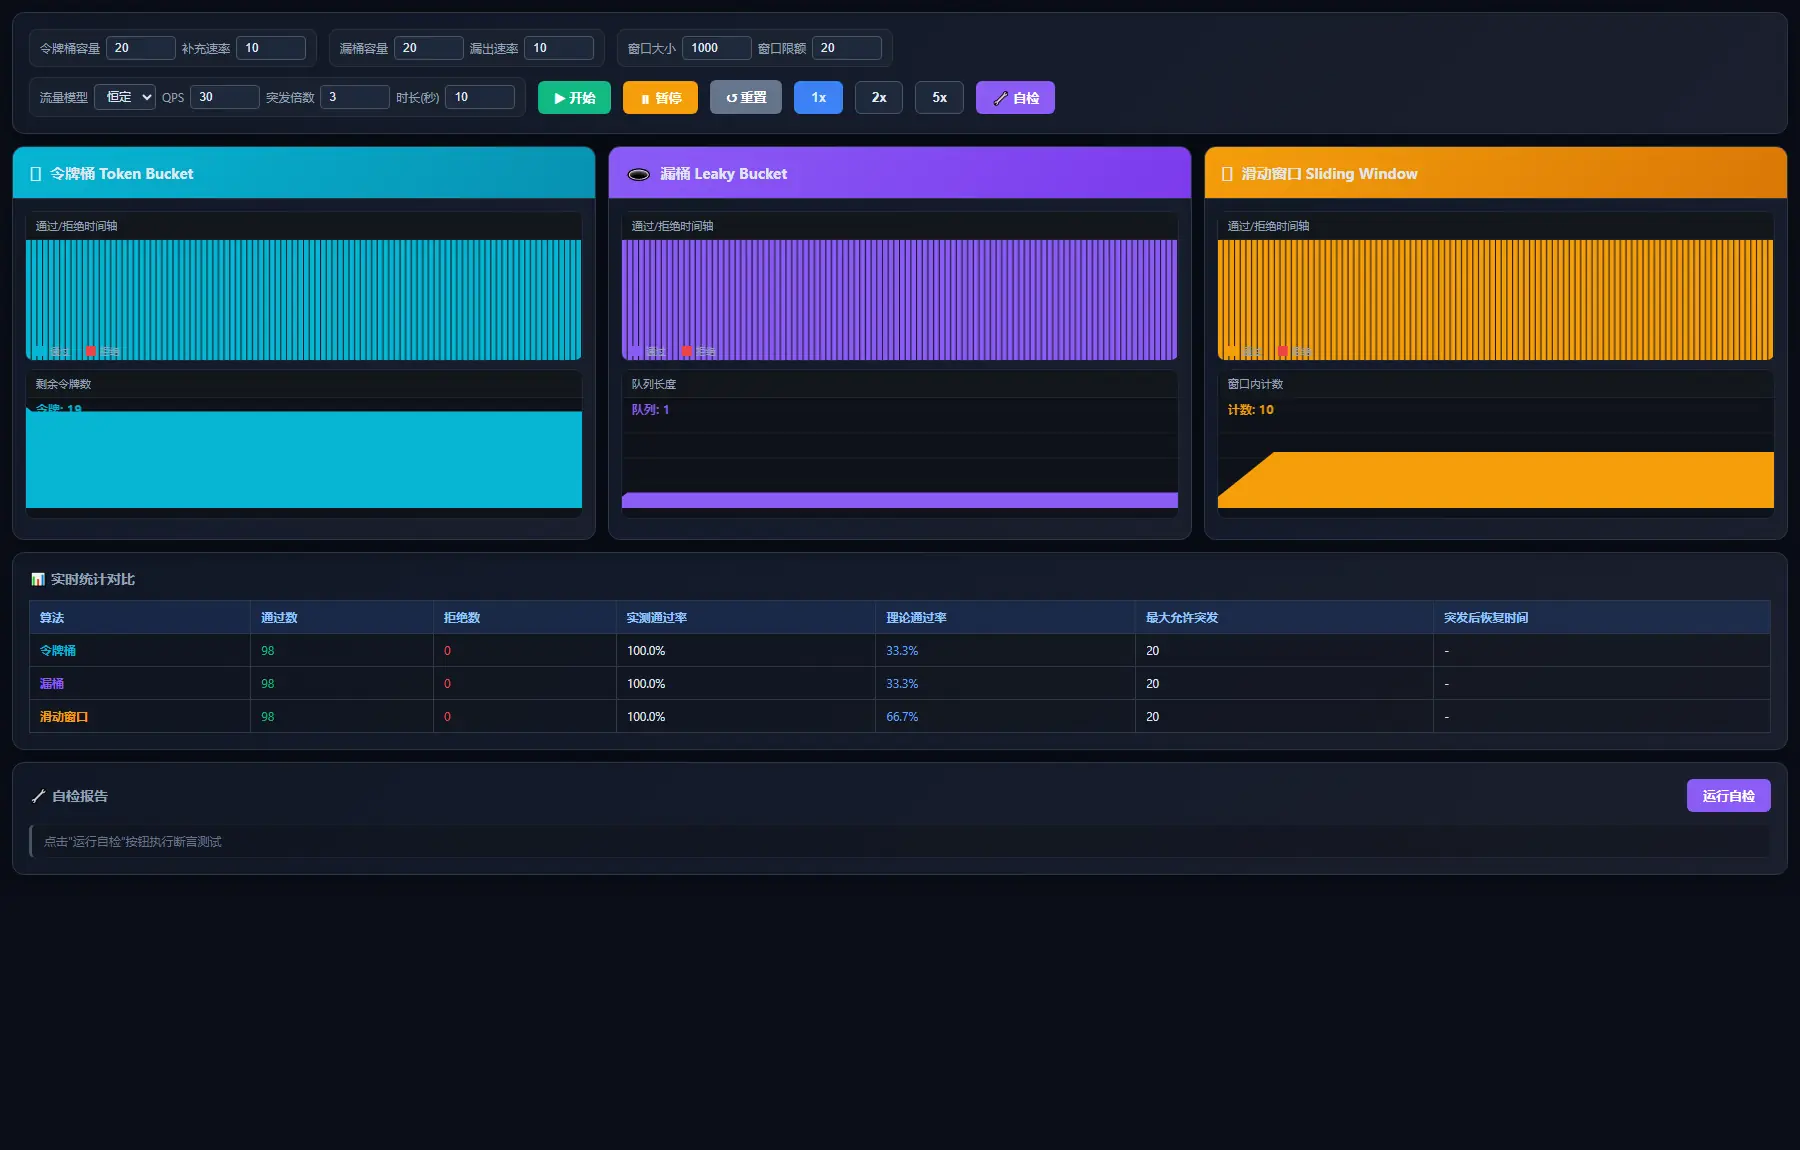
98 个请求,正好对上每秒 10 个跑 10 秒。
这个坑很隐蔽:页面不报错,统计表也不报错,只有「实测」和「理论」两列对不上时才看得出来。
修法不难,让流量生成器按累计应发数补发,而不是每步只发一个;倍速只该影响仿真推进,不该影响发得出来的上限。
四、自检 16 条里红了一条
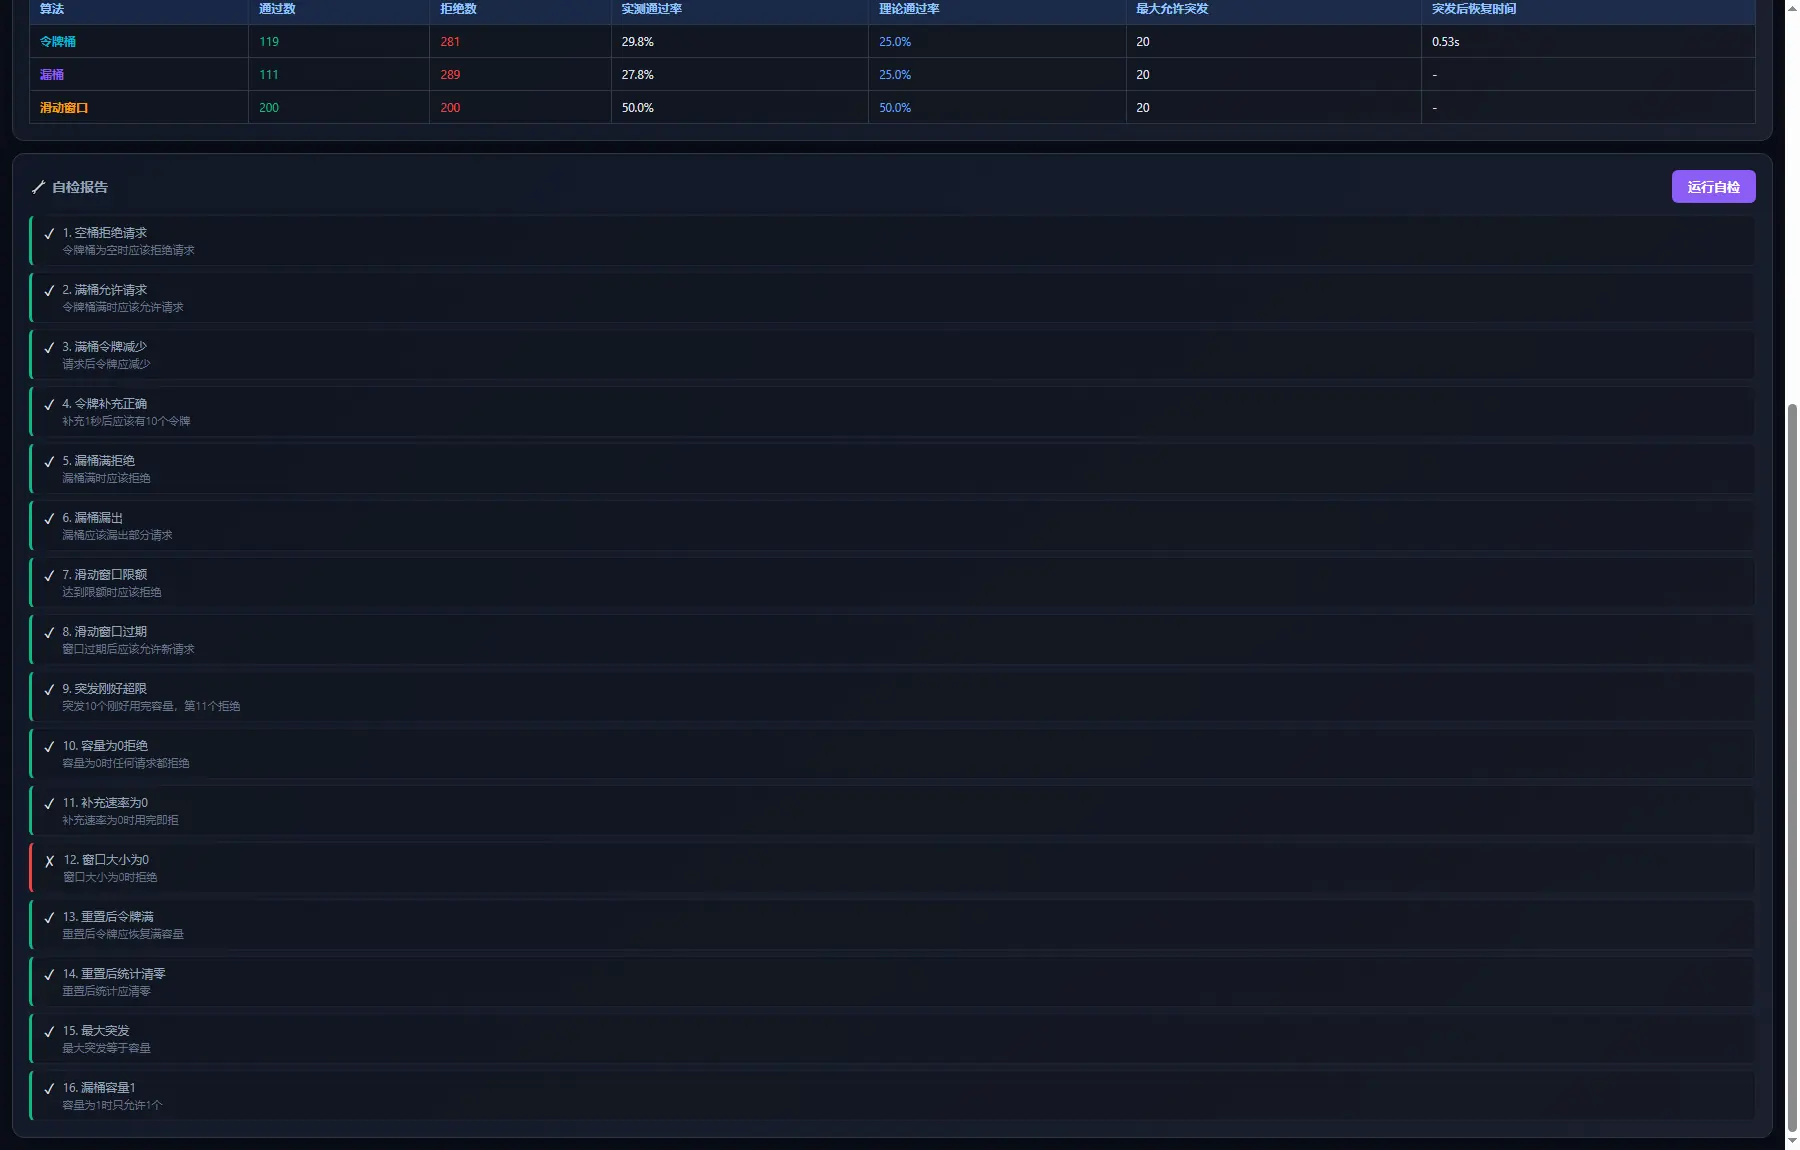
我在需求里要求页面自带自检,把每条断言的期望值和实际值渲染出来,它给了 16 条。
跑完 15 条绿,1 条红。
红的那条是「窗口大小为 0 时应该拒绝」。
根因在滑动窗口的过滤条件:它每次都拿当前时间减掉历史请求的时间戳,只留下差值小于窗口大小的那些。
窗口大小为 0 时,所有历史请求都被这个条件剔除,窗口内计数恒等于 0。
计数永远是 0,限额永远够用,于是每个请求都放行。
这是参数为 0 这种边界没有被定义,不是算法本身错了。
顺手说另外两条。
漏桶和滑动窗口的「突发后恢复时间」这一列,从我按下开始到最后一直是短横线。
代码里的赋值条件写着「拒绝发生时队列为空」,而拒绝那一刻队列恰好是满的,所以这条分支永远走不到。
令牌桶这一列有值,但它算的是从第一次扣减到第一次拒绝的间隔,其实就是「桶被打空用了多久」,名字和含义对不上。
这三条失败路径我都原样记在文章里,没有动页面代码。
我想看的是它生成出来的东西哪里不牢,自己上手改完,文章就变成我写的了。
五、三种算法怎么选
| 你要的效果 | 选它 | 关键参数 |
|---|---|---|
| 允许突发,但突发有上限 | 令牌桶 | 桶容量就是允许的最大突发数 |
| 出口绝对平滑,宁可排队 | 漏桶 | 漏出速率就是出口硬上限 |
| 按时间窗给配额,精确到秒 | 滑动窗口 | 窗口大小与窗口限额共同决定速率 |
一句话记法:令牌桶管入口,漏桶管出口,滑动窗口管配额。
沙盘里三种算法的稳态速率都能调成每秒 10 个,但突发行为差得很远,选型时要看的正是这一段。
还有一点值得留意:这个滑动窗口是真按请求时间戳存日志的,内存随 QPS 乘窗口大小线性涨。
真实网关里更常见的是分桶计数,精度换内存,沙盘没做这个取舍。
六、本地复现
文章里的每个数字都能自己跑一遍。
bash
git clone https://atomgit.com/deli007/demo_park.git
cd demo_park/codearts-rate-limiter-lab
python -m http.server 8000
浏览器打开 http://localhost:8000 就是同一块面板。
要复现第三节那组对照,按这个顺序点:
- 流量模型选「恒定」,QPS 填 30,时长填 10 秒
- 倍速选 1x,点开始,等跑完,记下三列实测通过率
- 点重置,倍速换 5x,其余不动,再跑一次
- 对比两次的实测通过率
自检按钮在页面底部,点一下会重新跑 16 条断言。
准备环境:码道 Web 入口
这个页面是用码道生成出来的。
码道有三种使用方式:WebUI、TUI 和桌面 IDE。本文用的是 WebUI。
浏览器打开码道 Web 版:devcloud.cn-north-4.huaweicloud.com/chat/home ,登录后直接在对话窗口里描述需求,不用装软件。
我这次把需求写得比较细:三块面板、控制条、统计表、自检区一次说完,末尾加了一句「完成后打开预览」。
它一次就给了完整的 index.html。
使用码道体会
三条。
第一,把「自检」写进需求是这轮最值钱的一句话。页面里那 16 条断言不是我事后补的,是它生成的,所以我能拿它当验收依据。
第二,需求里要指定验收方式。「完成后打开预览,让我直接看到运行效果」这一句省掉了好几轮来回。
第三,我提了一轮修改点,想让它把那条红断言和画布上压字的实时数值一起修掉,这一轮没跑起来,所以文章里保留了第一版。
总结
限流三件套的差别不在稳态速率,在突发怎么处理。
理论通过率算的是稳态,估容量时得把桶容量和结束时刻的队列一起算进去。
倍速这种看起来无关的参数,可能正在改你的 QPS 上限,实测和理论对不上时优先怀疑它。
16 条断言红了 1 条,说明参数为 0 这类边界还是得自己盯。