我给自己写了一页测试用的对账单,标题想用站酷快乐体,正文用思源黑体(Noto Sans SC)。内容全是「某某公司」这种占位文字。我不想看哪台机器装了什么字体,干脆把两个整份 TTF 转成 base64 写进 @font-face。HTML 一下子变成 18,509,266 字节。我本来做好了 PDF 跟着变胖的准备,结果本机 Chromium 149 开源构建打印出来只有 71,102 字节。完全不带字体、只用系统苹方的那一版是 154,603 字节,带字体的反倒小了一半多。这个反差让我把字体和 PDF 体积的关系从头测了一遍。顺手还发现换一台机器生成时,整份字体带上了也不一定用得上。
PDF体积和字体文件大小无关
先看三种字体来源各自的账,字节数都是同一页在同一台 M4 的 Mac 上量的。我把页面加载的字体字节和最后 PDF 的字节放在一起比。
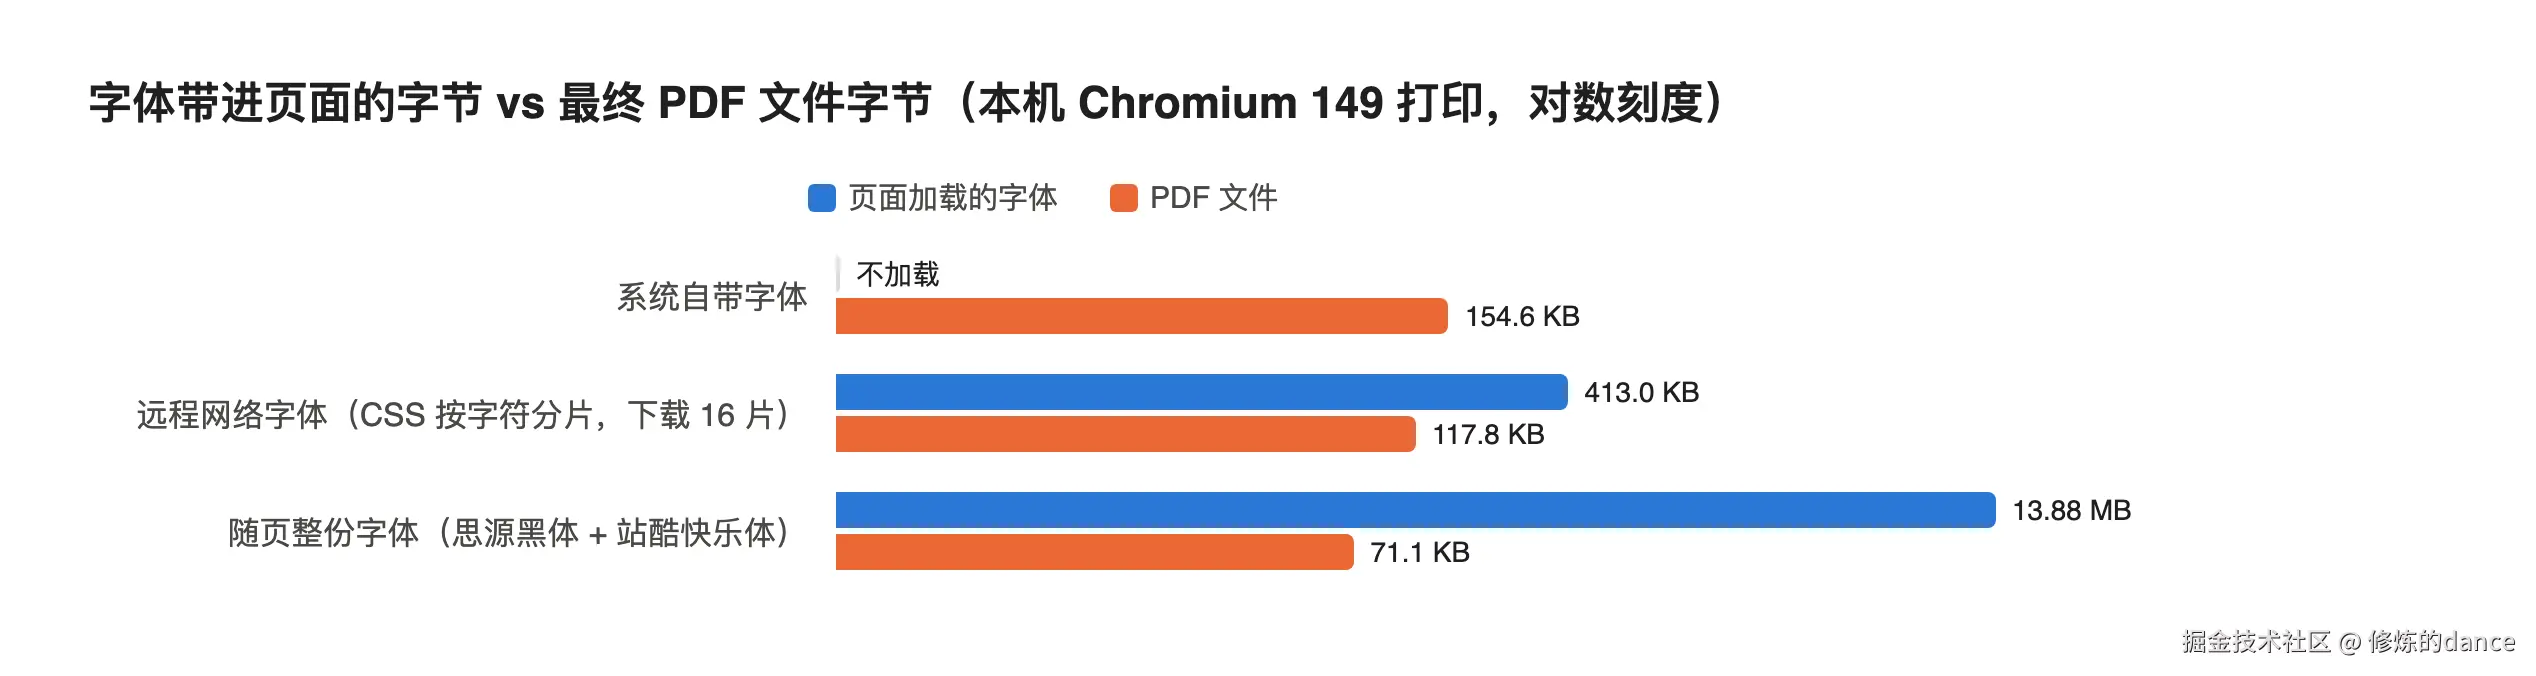
这张图里蓝条和橙条不成比例。系统字体那组一个字体都不加载,PDF 却是三组里最大的 154.6 KB。远程字体那组按字符分片下了 16 片共 412,984 字节,PDF 是 117,799 字节。随页整份字体那组加载了 13,880,960 字节,PDF 反倒最小。
我用 PyMuPDF 把第一页的字体表读了出来,顺手取了每个字体程序的字节数。下面是我跑的几行,文件就是那份 71,102 字节的 PDF。
python
pdf = fitz.open("对账单-整份字体.pdf")
for item in pdf.get_page_fonts(0, full=True):
    xref, kind, name = item[0], item[2], item[3]
    _, ext, _, program = pdf.extract_font(xref)
    print(kind, name, ext, len(program))
text
Type0 AAAAAA+ZCOOLKuaiLe-Regular ttf 48088
Type0 BAAAAA+NotoSansSC-Regular ttf 326296
Type3  n/a 0
(后面还有 5 行同样的 Type3,名字为空,省略)代码说明:get_page_fonts 列出这一页引用的字体,extract_font 把嵌在 PDF 里的字体程序原样取出来。名字前面 6 个大写字母加一个加号是子集标记,表示这份字体被裁过只剩本页用到的字。快乐体从 3,274,128 字节裁到 48,088 字节。思源黑体从 10,606,832 字节裁到 326,296 字节。它裁完还这么大是因为子集保留了原来的字形编号,有几张表还是全表长度。我还做了一组对照来确认体积跟字体文件没关系。只给标题带整份快乐体打一份,再只带 48 KB 的子集打一份。两份 PDF 都是 140,479 字节,一字不差。看来 Chromium 打印时总会自己做子集化。PDF 多大看的是这一页一共用了多少个字,跟塞进去的字体文件有多大基本没关系。那几个名字为空的 Type3 也不是真没名字。Type3 的名字得去 FontDescriptor 里找。我第一版脚本只看了表面那一栏,差点以为它们没名字。
苹方那版为啥最大我也瞄了一眼。它在打印时变成了 39 个 Type3 字形字体。它没走子集嵌入那条路,体积自然就上去了。为什么会转成 Type3 我没往下查。
交给服务端时整份字体没用上
本机走通了以后我就想换一台装了别的字体的机器来生成。这一步我用的是图映(imging.cn/)的 HTML 转 PDF,测试页还是同一份占位对账单,单文件和整个文件夹两种导入都跑了。它的导入和预览都在浏览器本地,状态行也写明这时还没开始转换或上传。点了转换以后它把去掉脚本的快照用一次 POST 交给服务端的 Chromium 151(Linux)去生成。我在页面里数过请求。点转换之前非 GET 请求是 0 次,点完正好 1 次。图映的文档功能里只有这一项走服务端,字体用不用得上就看快照里带了什么、服务端认不认。
快照里字体确实带上了。单文件内联那份请求体是 18,509,983 字节。文件夹导入时相对路径的字体也被内联成了 data:,请求体 18,509,987 字节,和单文件那份只差 4 个字节。可服务端吐回来的 PDF 标题不是快乐体。字体表里只有 Noto Sans CJK SC,这是服务端自己装的中文字体。我又分开测了只带整份快乐体和只带整份得意黑。快乐体那份请求体 4,367,378 字节,两次复跑结果相同。快乐体和得意黑这两份的标题都没能用上。整份的像素字体(2.05 MB)倒是用上了。最让我意外的是 48 KB 的快乐体子集,它的请求体只有 65,984 字节,标题却用上了。我再给同一个子集塞了个没用的表,填到和整份快乐体一模一样的 3,274,144 字节。这回上传 4,367,392 字节,标题照样用上了。看来卡住它的不是上传大小或快照大小。到底是什么原因我从外面看不出来,这里只记现象。
让我多留个心眼的是整份字体那几份在本地预览里标题明明是快乐体,生成的 PDF 却换了字。质量报告只说等过了 document.fonts 和页面图片,没有字体没用上的提示。光看预览的话会以为一切正常没出问题。
远程字体在这条路上更干脆。它直接就用不上。
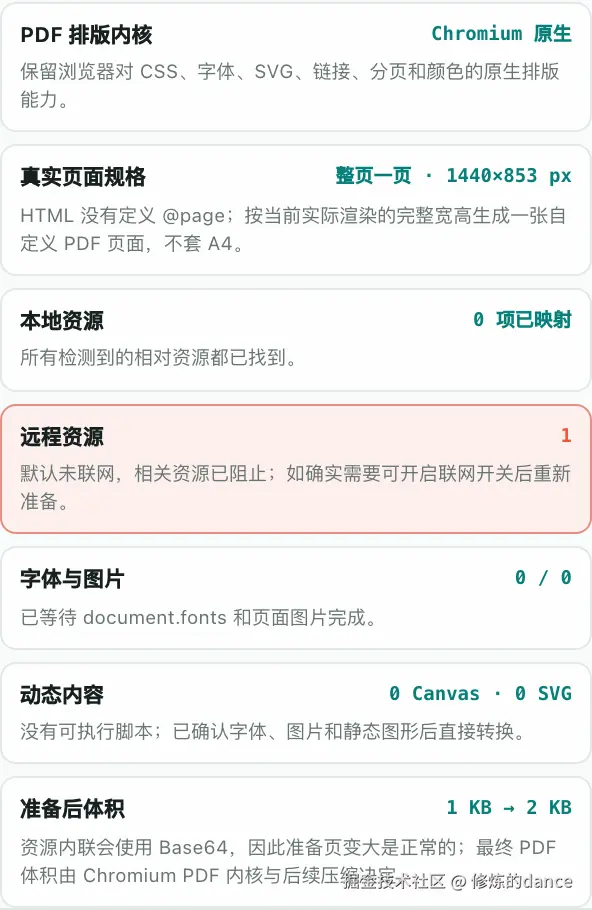
这张是 Google Fonts 那份测试页转换后的质量报告。要看的是那张红卡上的原话「默认未联网,相关资源已阻止」。我把联网开关打开又跑了一次。预览确实去下载了字体。可快照里还是原样保留那个 <link> 上传,服务端 PDF 依旧是 Noto Sans CJK SC。我猜服务端那边连不到外网,只是从结果推的。它最后还有一步无损最小化,只合并数学上等价的重复资源,不动可见字体也不重采样图片。整份内联的那份 PDF 从服务端原始的 129,969 字节变成了 59,760 字节。不过这和字体到底用没用上是两回事。
从本机PDF里抠出子集再带上
既然子集能用上,那正经做法是拿 pyftsubset 这类工具按页面用字裁一份。可我这台机器上没装 fontTools,也懒得为这点事配环境。于是我就走了条有点土但能用的野路子。前面那份本机打印的 PDF 里本来就躺着 Chromium 裁好的子集,抠出来写回页面就行。
python
kuaile = [f[0] for f in pdf.get_page_fonts(0, full=True) if "ZCOOL" in f[3]][0]
_, ext, _, program = pdf.extract_font(kuaile)
face = "@font-face{font-family:'KuaiLe Sub';src:url(data:font/ttf;base64,%s)}" % base64.b64encode(program).decode()
代码说明:按名字找到快乐体那一项的 xref,取出 48,088 字节的字体程序。转成 base64 拼成一条 @font-face 后再把标题的 font-family 指到 KuaiLe Sub 上。思源黑体也照同样的办法从那份 PDF 里抠一份。两个子集一起带进页面再交给图映生成时,请求体从 18.5 MB 降到 501,152 字节。标题和正文的字体都用上了。最后的 PDF 是 44,084 字节。只带快乐体的那组前面说过,本机打印时子集版和整份版的 PDF 字节完全一样。
打印时机这件事我也没敢省。随页字体在本机打印里能用上的前提是打印前已经加载完。我拿目录里相对路径引字体的那一版试过。在 domcontentloaded 之后马上打印的话,8 次里有 4 次正文和表格文字全没了只剩标题。等到 load 再打就都正常。我现在的打印脚本都会先 await document.fonts.ready 再调 page.pdf(),多等这一下不费事。
子集只认这一页用过的字
这个野路子有个明显的边界。抠出来的子集只有这一页出现过的字,页面内容一改新出现的字就会回落成别的字体。它只适合内容固定的页面,比如模板定死、只换几个数字的对账单。我打算以后把数字和常用标点先在打印源页面里全写一遍再抠。不然改个金额就可能出现半截快乐体半截黑体。内容天天变的报表还是得在生成那一步按用字现裁。字体许可也要自己看一眼。我用的快乐体和思源黑体都是允许裁剪改动的 OFL 字体,商用字体就不一定了。
到现在还没弄明白的有两件事。整份快乐体和得意黑在服务端没用上,整份像素字体却用上了。阈值和原因我都不知道,也只测了这几种字体。WOFF2 格式的随页字体我也没测,本机没工具能转。这次服务端的结果是 2026-09-30 当晚测的。服务端会更新,以后再跑可能不一样。我现在的习惯是生成完先用上面那几行把 PDF 字体表读一遍。看到自己的字体名带着子集前缀出现在里面才算这份字体真进了 PDF。