项目地址:
yolo-object-detection-lab:基于 FastAPI 与 Ultralytics YOLO 的图像目标检测实验项目 - AtomGit
前面几篇里,这个项目已经从单张图片检测,一路做到了视频检测、ByteTrack 多目标跟踪和 Line Crossing 过线计数。
上一版 Line Crossing 可以回答:
某个目标有没有真正经过我指定的一条线?
但实际的视频分析里,还有另一类很常见的问题:
哪些目标进入过指定区域?
区域里同时最多有多少目标?
一个目标在区域里停留了多久?
所以这一次,我继续使用码道 Agent,在现有 YOLO + ByteTrack 项目上加入了第六种模式:
ROI Analysis最终实现:
Polygon ROI
+
Entry / Exit
+
Occupancy
+
Dwell Time
也就是基于任意多边形区域的占用与停留分析。
一、现在项目已经有 6 种模式
目前项目顶部已经扩展为:
Single Image
Batch Images
Video
Tracking
Line Crossing
ROI Analysis
整个项目的发展路线也越来越完整:
图片目标检测
↓
批量图片检测
↓
视频检测
↓
ByteTrack 多目标跟踪
↓
虚拟线过线计数
↓
ROI 区域占用与停留分析
这次 ROI Analysis 没有重新写一套检测和跟踪系统,而是继续复用之前已经验证过的:
YOLO
+
ByteTrack
在 Track ID 基础上继续做区域状态分析。

二、直接在视频首帧上画多边形 ROI
Line Crossing 只需要两个点:
A → B但是 ROI 显然不能只用一条线。
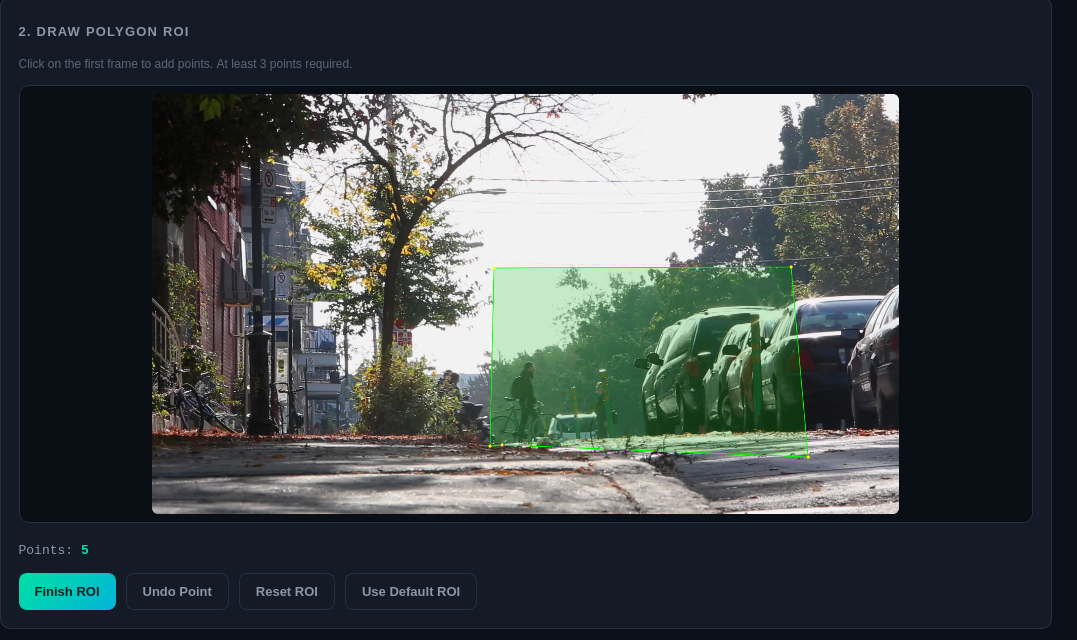
所以这一次前端增加了 Polygon Canvas,可以直接在视频第一帧上点击多个点。
我这次真实测试时画了一个 5 点多边形区域,大致覆盖道路中央和右侧车辆经过的位置。
页面支持:
Finish ROI
Undo Point
Reset ROI
Use Default ROI
至少需要 3 个点才能形成有效区域。
为了避免浏览器缩放、Canvas 尺寸和原始视频分辨率不一致的问题,前端保存的也不是绝对像素,而是:
Normalized Coordinates也就是:
0.0 ~ 1.0后端真正处理 1920×1080 视频时,再转换回真实坐标。
例如:
real_x = nx * widthreal_y = ny * height这样无论前端预览图显示多大,ROI 在原视频中的位置都不会改变。
三、目标到底算不算进入 ROI?
这里仍然沿用了 Tracking 里的:
Bottom-center Anchor也就是目标框底边中点:
anchor_x = (x1 + x2) / 2anchor_y = y2为什么不用 bbox 中心?
因为对于道路场景:
- 行人的 bottom-center 更接近脚的位置;
- 汽车的 bottom-center 更接近车辆与地面的接触位置。
所以判断目标有没有进入一个地面区域时,比 bbox 中心更加自然。
四、任意多边形怎么判断 Inside / Outside?
这次 ROI 不是固定矩形,而是允许用户任意画多边形。
后端通过 OpenCV:
cv2.pointPolygonTest()判断目标 anchor 和多边形之间的关系。
它可以返回带符号距离:
distance > 0
目标在 ROI 内部

distance < 0
目标在 ROI 外部

distance = 0
目标恰好在边界
这样一个五边形、六边形甚至更复杂的区域,都可以使用同一套逻辑。
五、为什么还要加 Border Tolerance?
如果只写:
distance > 0 → INSIDE
distance < 0 → OUTSIDE
其实很容易出现问题。
检测框在 ROI 边缘会有轻微抖动:
INSIDE
OUTSIDE
INSIDE
OUTSIDE
结果同一个人站在边界附近,可能瞬间产生大量:
ENTRY
EXIT
ENTRY
EXIT
所以这次增加了:
Border Tolerance我实际测试设置为:
8 px判断逻辑变成:
distance > tolerance
→ INSIDE

distance < -tolerance
→ OUTSIDE

|distance| <= tolerance
→ BORDER ZONE
进入 Border Zone 时,不立刻修改 Track 的稳定状态。
这样就能过滤掉边缘抖动产生的假 Entry / Exit。
六、Entry 和 Exit 其实是状态机
每一个 ByteTrack Track 都维护自己的 ROI 状态。
核心变化只有两种:
OUTSIDE → INSIDE生成:
ENTRY以及:
INSIDE → OUTSIDE生成:
EXIT这样我们就不再是对每一帧独立判断,而是真正跟踪一个目标从进入区域到离开区域的完整过程。
七、一个很重要的问题:第一次出现就在 ROI 里面怎么办?
这是我觉得这一版比较重要的一个细节。
假设一个 Person 第一次被 YOLO + ByteTrack 检测到的时候,它已经位于 ROI 内部。
此时状态实际上是:
UNKNOWN → INSIDE如果直接把它算成 ENTRY,就等于人为制造了一个不存在的"进入事件"。
所以现在的设计是:
UNKNOWN → INSIDE不生成 ENTRY。
但是会记录:
first_seen_inside = true并把它计入:
Unique Tracks Inside这一点在这次真实结果里也体现得非常明显。
八、真实测试:37 个目标中,24 个进入过 ROI
这次仍然使用之前那段真实测试视频:
Resolution: 1920×1080
FPS: 29.97
Total Frames: 962
Duration: 32.10 s
参数设置:
Confidence Threshold: 0.50
Frame Interval: Every Frame
Border Tolerance: 8 px
Dwell Threshold: 3 s
Track Trails: ON
Trail Length: 30
完整跑完:
962 / 962 Frames
100%
最终得到:
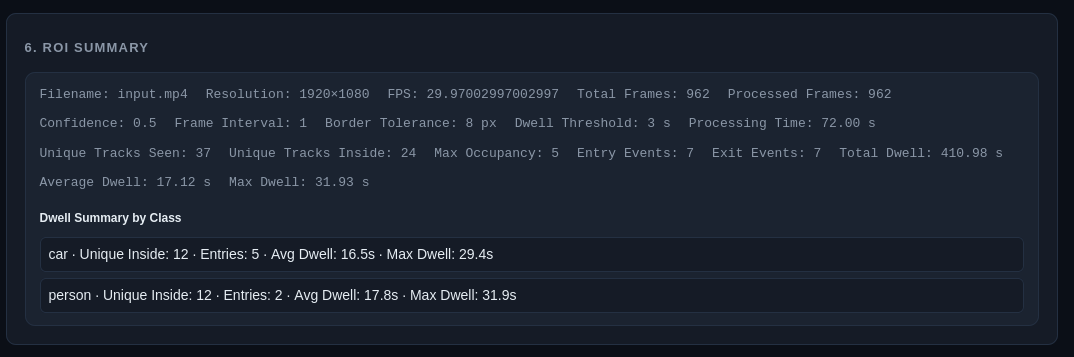
Unique Tracks Seen: 37
Unique Tracks Inside: 24
Max Occupancy: 5
也就是说:
整段视频中,ByteTrack 一共识别到:
37 个不同目标其中真正进入过这个 ROI 的有:
24 个而整个视频过程中,这个区域里同时存在目标最多的一帧是:
5 个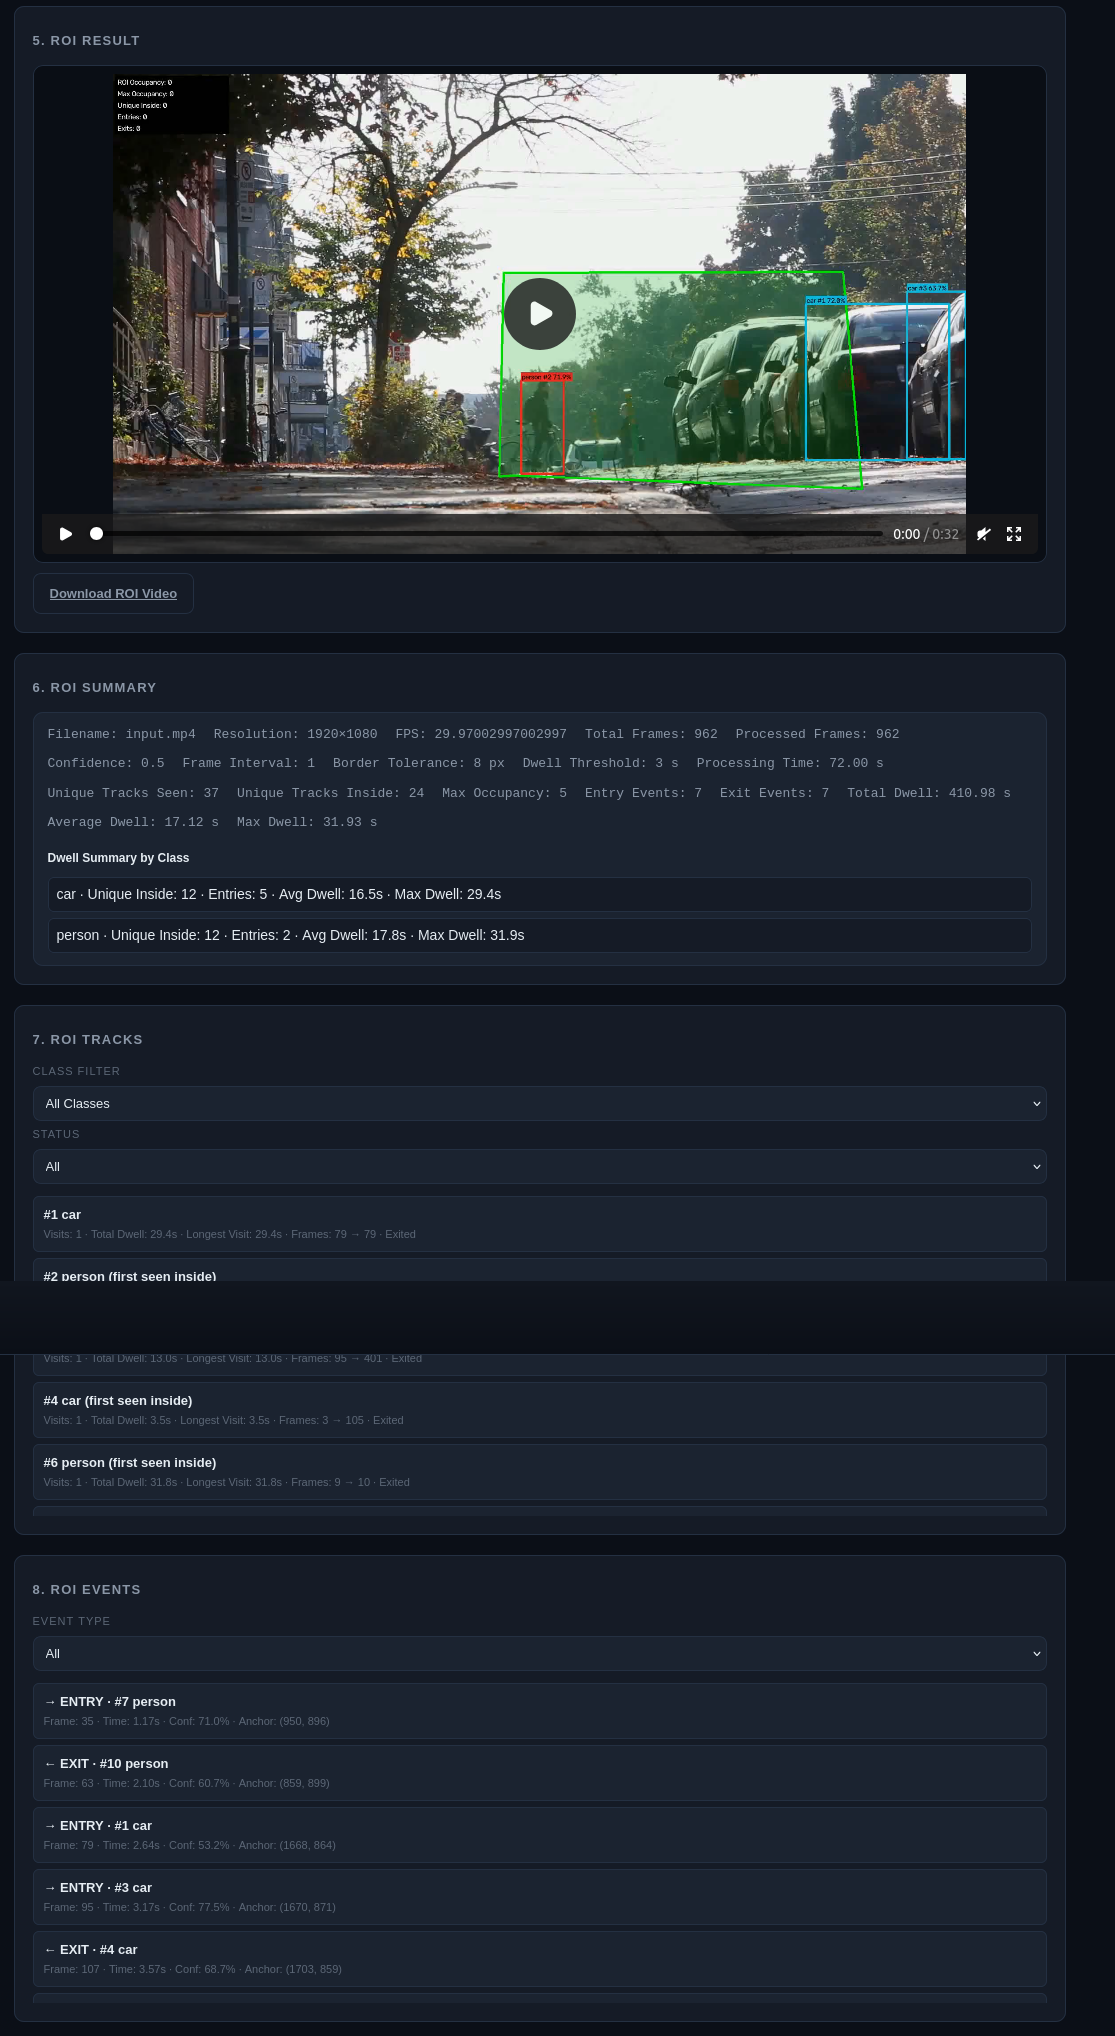
九、为什么 Unique Inside = 24,但 Entry Events 只有 7?
这正好可以验证前面的:
first_seen_inside逻辑。
本次实际结果中:
Unique Tracks Inside: 24
Entry Events: 7
Exit Events: 7
第一眼可能会觉得:
24 个目标进过 ROI,为什么只有 7 个 ENTRY?
原因是很多 Track 第一次被检测到的时候,就已经位于 ROI 内部。
这些目标:
会计入 Unique Tracks Inside但不会伪造:
ENTRY Event所以:
Unique Inside
≠
Entry Events
这是两种完全不同的统计指标。
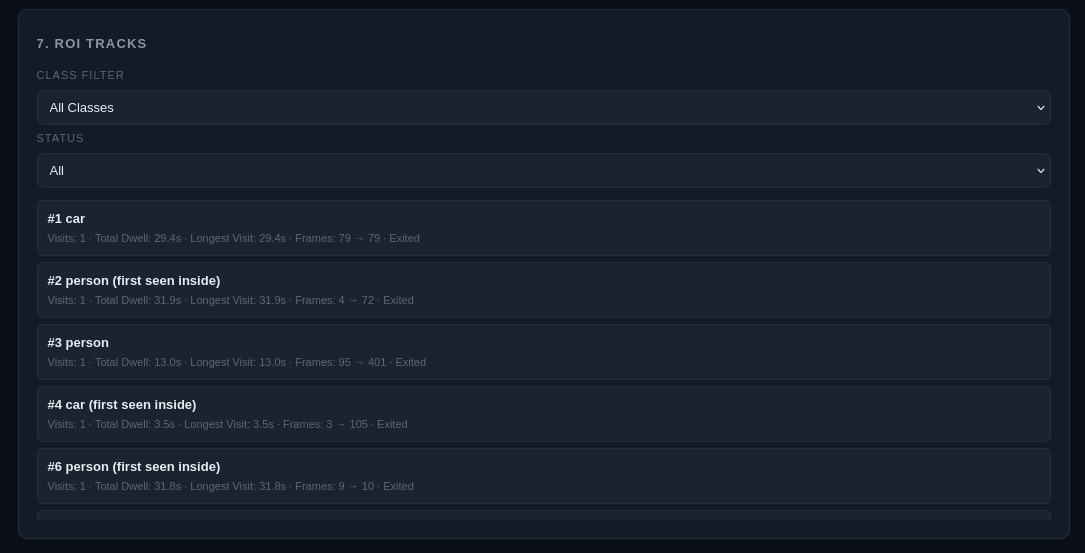
在页面的 Track 列表中,也可以直接看到:
first seen inside这样的状态。
十、Occupancy 和 Unique Inside 也不是一回事
这几个指标非常容易混淆。
Unique Tracks Inside
表示整段视频里:
一共有多少个不同 Track 曾经进入过 ROI?
这次是:
24Current Occupancy
表示:
当前这一帧区域里还有几个 Track?
视频最后一帧:
Current Occupancy = 0并不代表没有目标进入过区域。
只代表:
到最后一帧时,已经没有目标留在 ROI 里。
Max Occupancy
表示:
整个视频所有帧中,ROI 同时存在目标最多是多少?
这次为:
Max Occupancy = 5所以三个数字描述的是三件不同的事情。
十一、Dwell Time:目标到底停留了多久?
ROI Analysis 不只是判断:
进没进去还会记录:
进去以后待了多久当 Track 产生 ENTRY 后,就会保存:
entry_timestamp当产生 EXIT:
exit_timestamp这一段访问的停留时间就是:
dwell =
exit_timestamp - entry_timestamp
如果同一个 Track 后面再次进入 ROI:
Visit 1
+
Visit 2
+
Visit 3
每一次访问都会分别统计,最后再累计到:
total_dwell所以它不仅支持一次进出,也支持:
Multiple Visits十二、视频结束了,但目标还没有出去怎么办?
这个问题也需要单独处理。
例如一个 Car 在:
30 秒进入 ROI。
但是视频:
32.1 秒就结束了。
此时根本不存在 EXIT Event。
如果什么都不做,这两秒停留时间就会丢掉。
所以视频结束时会执行:
finalize_open_visit()使用:
video_end_timestamp - entry_timestamp关闭还没结束的 Visit。
这样可以保证 Dwell Time 不会因为视频结束而缺失。
十三、DWELLING 状态
这次还增加了:
Dwell Threshold我测试时设置的是:
3 s如果目标进入 ROI 以后:
current_visit_dwell < 3s页面显示:
INSIDE超过:
3s以后显示:
DWELLING注意:
DWELLING只是一个显示状态。
它不会改变真实的 Entry / Exit,也不会修改真实 Dwell Time。
它的作用主要是快速找出:
在 ROI 内停留时间比较长的目标。
十四、真实结果还能按类别统计停留时间
本次测试中,进入 ROI 的目标主要包括:
Car
Person
页面会进一步按类别生成:
Dwell Summary by Class包括:
Unique Inside
Entries
Average Dwell
Max Dwell
这就意味着系统已经可以回答类似:
一共有多少辆车进入这个区域?
行人在这个区域平均停留多久?
哪一类目标停留时间最长?
相比最开始的:
YOLO → 有什么目标已经完全变成了视频行为统计。
十五、ROI Tracks 可以看到每一个目标
Summary 看的是整体。
而 ROI Tracks 则是:
Track-level每一个 Track 都可以独立查看:
Track ID
Class
First Seen Inside
Visits
Total Dwell
Longest Visit
Frames Seen
Current Status
而且支持按照:
Class
Status
筛选。
例如:
INSIDE
EXITED
DWELLING
筛选只是改变页面展示,不会修改底层真实数据。
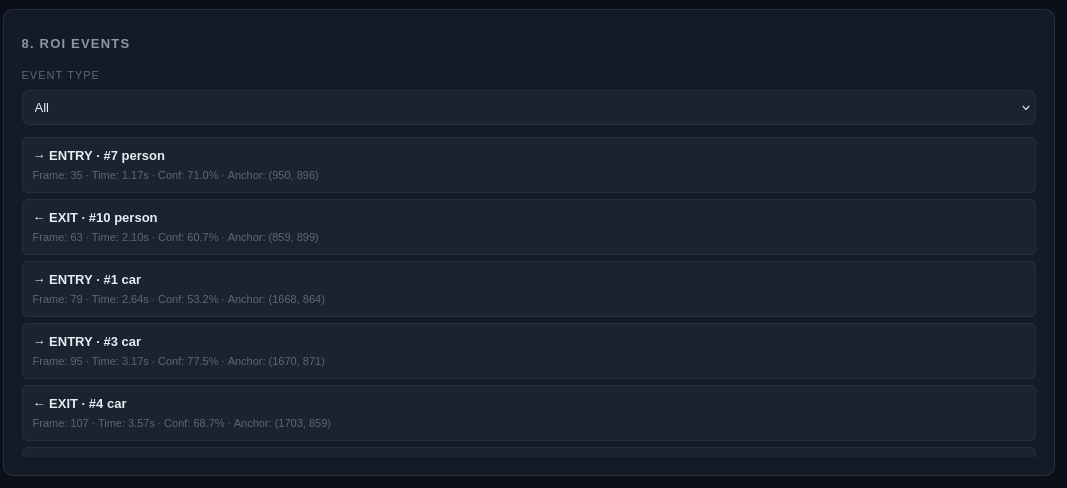
十六、ROI Events 记录每一次 Entry / Exit
除了 Track 列表,还有 Event 列表。
每一次真正的:
ENTRY或者:
EXIT都会形成一条事件。
记录内容包括:
Event Type
Track ID
Class
Frame
Timestamp
Anchor
这就不再只是一个:
count += 1而是完整的结构化事件记录。
十七、支持三种结果导出
这一次一共做了三个导出按钮:
Export ROI JSON
Export ROI Tracks CSV
Export ROI Events CSV
ROI JSON
保存整个分析结果:
ROI polygon
settings
summary
tracks
events
Tracks CSV
一个 Track 一行,适合分析:
每个目标的总停留时间
访问次数
最长单次停留
最终状态
Events CSV
一个 ENTRY / EXIT Event 一行。
适合后续:
Excel
Pandas
统计分析
而且这些导出都直接基于已经完成的真实结果:
不会重新跑 YOLO十八、从 3989 次检测,到真正的区域行为分析
做到这里以后,可以把整个视频分析路线连起来看。
最开始 Video Detection 得到的是:
3989 Detection Events它描述:
每一帧检测到了多少目标。
加入 ByteTrack 后:
37 Unique Objects它回答:
整段视频到底有多少个不同目标?
Line Crossing:
1 Crossing Event回答:
有多少目标真正经过指定位置?
而现在 ROI:
37 Unique Tracks Seen
↓
24 Unique Tracks Inside
↓
Max Occupancy = 5
↓
Entry / Exit
↓
Dwell Time
开始回答:
目标进入了哪里,又在那里停留了多久?
这已经从简单目标检测,逐渐变成了一套基础的视频场景分析系统。
十九、集成后测试:215 个 pytest 全部通过
这次 ROI 一开始是在独立分支:
feat/roi-dwell开发的。
因为同时还有 Line Crossing 在另外一条开发线上,所以最后又把 ROI rebase 到最新 main,解决了:
app/main.py
app/schemas.py
static/app.js
static/index.html
static/style.css
tests/test_frontend_logic.js
等冲突。
最终集成后的结果:
215 passed前端逻辑测试:
126 assertions passed而且:
Single Image
Batch Images
Video
Tracking
Line Crossing
ROI Analysis
六种模式全部保留。
总结
这一次最大的变化,是项目开始真正分析:
空间
+
时间
Line Crossing 关注的是:
有没有跨过某条边界?
ROI Analysis 关注的是:
有没有进入某个区域?
区域里现在有几个目标?
最多同时有几个?
每个目标停留了多久?
最终整个技术链路变成:
YOLO
↓
ByteTrack
↓
Track ID
↓
Bottom-center Anchor
↓
Polygon ROI
↓
Point-in-polygon
↓
Border Tolerance
↓
Entry / Exit State Machine
↓
Occupancy
↓
Dwell Time
这次真实实验中:
37 Unique Tracks Seen
24 Unique Tracks Inside
Max Occupancy = 5
Entry Events = 7
Exit Events = 7
相比最开始只在图片上画一个 Bounding Box,现在已经可以从视频中分析目标的:
出现
跟踪
过线
进入区域
离开区域
占用情况
停留时间
项目地址:
yolo-object-detection-lab:基于 FastAPI 与 Ultralytics YOLO 的图像目标检测实验项目 - AtomGit
下一步如果继续往下做,我准备从 ROI 和 Tracking 的数据继续扩展,例如:
轨迹热力图
区域流转统计
不同 ROI 之间的转移分析
把单个目标的轨迹进一步变成可统计的视频行为数据。