【声明】本博客所有内容均为个人业余时间创作,所述技术案例均来自公开开源项目(如Github,Apache基金会),不涉及任何企业机密或未公开技术,如有侵权请联系删除
标题
247、【AI】【模型部署】基座模型研究:RoPE 用在前向还是反向------训练、推理与 KV cache
背景
上篇 blog
【AI】【模型部署】基座模型研究:RoPE 的维度与频率------32 对、多频率与 rope_theta
把频率讲透了:第 i i i 对的角速度是 inv_freq i = 1 / θ 2 i / d \text{inv\_freq}i=1/\theta^{2i/d} inv_freqi=1/θ2i/d,head_dim=64 得到 32 个频率,它们按几何级数排开、低维转得快(近处)、高维转得慢(远处);波长 2 π θ 2 i / d 2\pi\,\theta^{2i/d} 2πθ2i/d 随 i i i 指数增长,最慢的波长决定"能分辨多远";rope_theta 越大波长越长、量程越宽,Qwen2 取 10 6 10^6 106 是为长上下文;还提到 partial rotary 与"位置 0 的 cos 全是 1"。
到这里,RoPE 的数学 (245:点积只依赖 n − m n-m n−m)和频率设计 (246:32 对、多尺度)都清楚了。本篇从数学转到工程,回答一个很实际的问题:旋转到底发生在哪个阶段------前向还是反向?训练还是推理?它和 243 篇的 KV cache 又是怎么配合的?
模型部署
先给结论:旋转只发生在每一层注意力的前向里,训练和推理都做,而且它没有任何可训练参数。 这四个关键词------前向、训练、推理、无参数------每个都值得展开,尤其是"和 KV cache 的配合",因为那正是 243 篇留下的接口。理解了这一篇,227 篇里那些 apply_rotary_pos_emb 的调用时机、以及"为什么缓存的是旋转后的 K",就都串起来了。
🧩 旋转发生在前向
RoPE 不是训练前预处理,也不是训练后补丁,而是每一层注意力前向计算的一部分 :拿到 q , k q,k q,k 之后、算 q ⋅ k q\cdot k q⋅k 之前,按位置把它们旋转一下。计算图上是这样一条链:
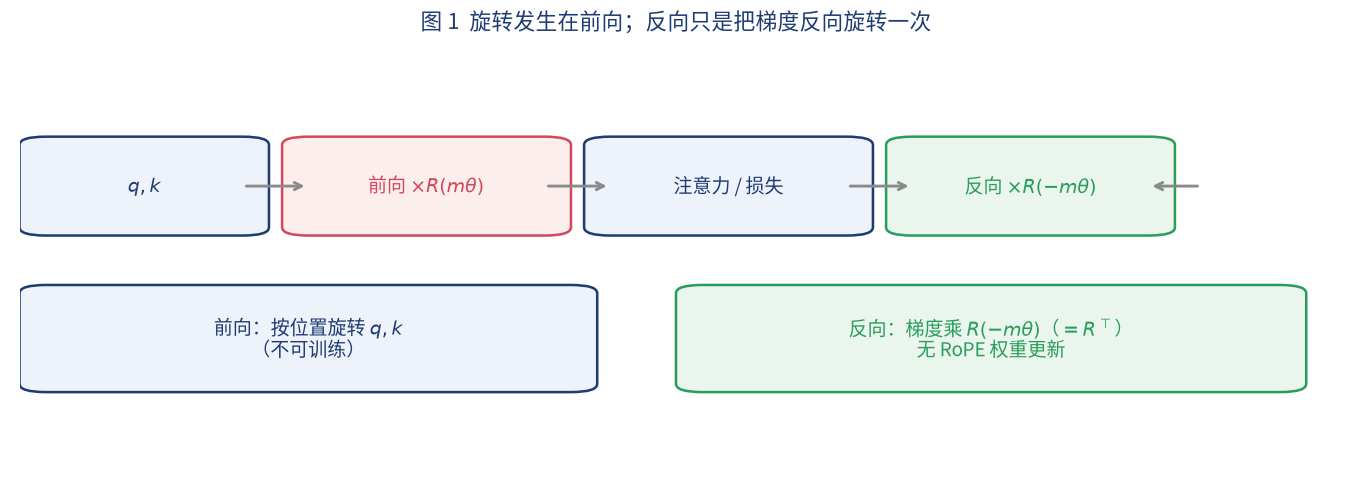
图 1 上半部分是前向: q , k q,k q,k 先乘上 R ( m θ ) R(m\theta) R(mθ) 完成旋转,再送入注意力、算出损失。没有位置参数、没有查表、没有预处理开关------旋转就是一次固定的乘加,藏在注意力里面。
🧩 它有没有可训练参数
没有。245 篇的旋转角由位置和频率算出来,频率又是 inv_freq = 1/θ^{2i/d} 这条公式现算的(在实现里作为 buffer 存在,不是 nn.Parameter),cos/sin 也可以预先算好缓存。所以:
- 优化器不会、也不该去"学习"旋转角;
- 反向传播里没有"RoPE 的权重梯度"这一项;
- 训练前后,RoPE 的这部分计算完全不变------它是固定的几何操作,不是学出来的层。
这一点常被误解成"RoPE 是某种可学习的位置嵌入"。不是:它是公式驱动的旋转 ,参数只有配置层面的 rope_theta(超参数,不参与梯度更新)。
🧩 反向传播时发生什么
虽然 RoPE 没有参数,但它是可微的 ,梯度会穿过它。旋转是线性正交变换,它的转置就是反向旋转:如果前向是乘 R ( m θ ) R(m\theta) R(mθ),那么反向回传的梯度就乘 R ( m θ ) ⊤ = R ( − m θ ) R(m\theta)^\top=R(-m\theta) R(mθ)⊤=R(−mθ)。
回到图 1 的下半部分:前向按位置把 q , k q,k q,k 转过去,反向只是把梯度按同样角度反向转回来 ,继续传给前面的层。因为旋转保长度( 245 245 245 篇),这一步既不会放大也不会缩小梯度,非常干净。所以"RoPE 用在反向"这个说法要修正:反向里发生的是"梯度的反向旋转",不是位置编码本身被更新。
🧩 训练:整段并行
训练时序列是完整已知的,位置编号就是 0 , 1 , ... , L − 1 0,1,\dots,L-1 0,1,...,L−1。注意力对所有位置并行计算,RoPE 也一次性把整段的 q , k q,k q,k 都旋转好------每个位置用它自己的角。这和在序列上"逐个"处理在数学上等价,只是训练可以并行、效率更高。
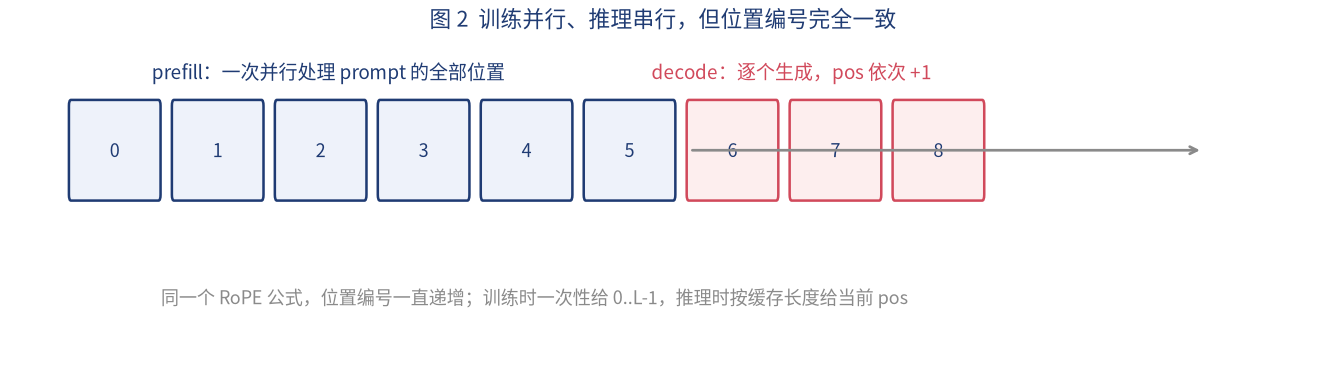
图 2 左边画的就是训练(以及推理里的 prefill):所有位置一起处理,位置编号从 0 排到 L − 1 L-1 L−1。
🧩 推理:prefill 与 decode
推理分成两段,243 篇讲过:prefill 一次并行处理 prompt 的全部位置(编号 0 0 0 到 L − 1 L-1 L−1),decode 之后逐个生成 token。RoPE 在两段都做,区别只是位置编号:
- prefill:和训练一样,一次性旋转整段;
- decode:每生成一个 token,就用它在整段里的位置编号(等于"已经有多少个 token")旋转这个新 token 的 q , k q,k q,k。
图 2 右边是 decode:位置编号继续 L , L + 1 , L + 2 , ... L, L+1, L+2,\dots L,L+1,L+2,... 递增。关键是:无论训练还是推理,同一个位置永远用同一个角度、同一个公式------这一点后面会再强调。
🧩 和 KV cache 怎么配合
这是本篇的核心。243 篇说 KV cache 缓存的是 k , v k,v k,v,那么缓存里的 k k k 到底是旋转前还是旋转后的? 答案是:旋转后的。
原因藏在"相对位置"里。设缓存里第 n n n 个位置的键已经旋转成 R ( n θ ) k R(n\theta)k R(nθ)k;当前新 token 在位置 t t t,它的查询旋转成 R ( t θ ) q R(t\theta)q R(tθ)q。两者做点积:
( R ( t θ ) q ) ⊤ ( R ( n θ ) k ) = q ⊤ R ( ( t − n ) θ ) k \big(R(t\theta)q\big)^\top\big(R(n\theta)k\big)=q^\top R\big((t-n)\theta\big)k (R(tθ)q)⊤(R(nθ)k)=q⊤R((t−n)θ)k
只有 ( t − n ) (t-n) (t−n),正是想要的相对距离。 如果缓存里存的是没旋转 的原始 k k k,那每生成一步,就得把缓存里所有历史 K K K 各自按它们的位置重新旋转一遍------缓存的意义就没了。存旋转后的 K,才能做到"新查询转一次、旧键直接拿来用"。
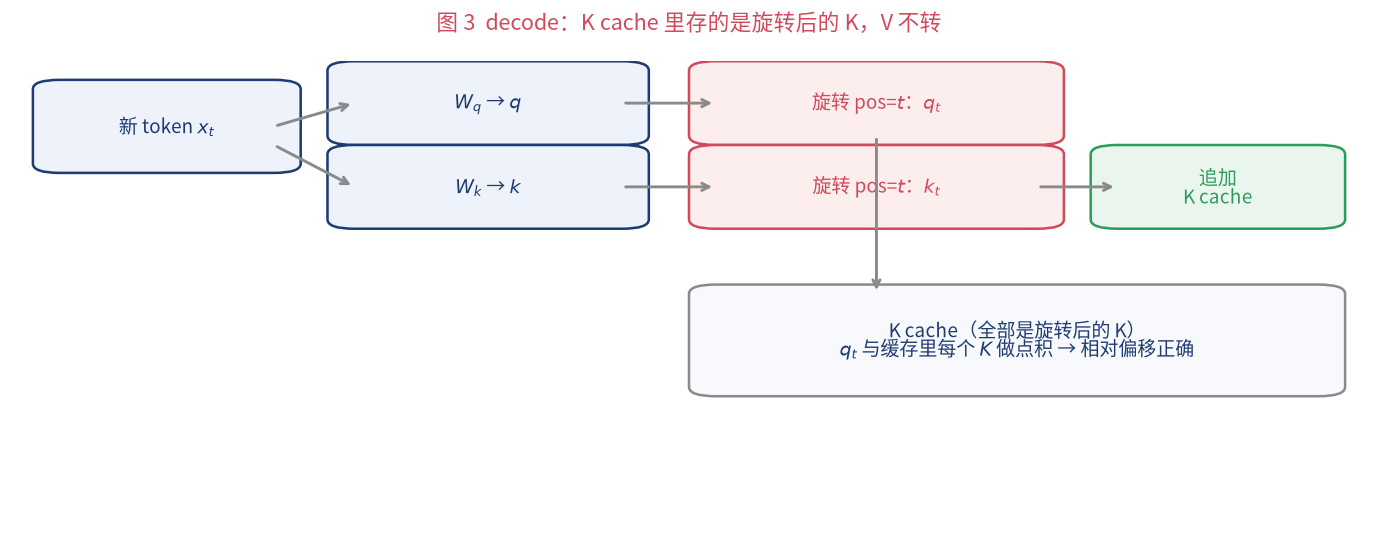
图 3 画了这个流程:新 token 的 k k k 旋转后用当前位置追加进缓存;它的 q q q 也旋转后,去和缓存里全部已旋转的 K 做点积。 V V V 不参与旋转(245 篇讲过原因),原样缓存。243 那句"缓存 k / v k/v k/v",补全起来是"缓存旋转后的 k k k、未旋转的 v v v"。
🧩 一次 decode 的完整数据流
把上面几步串成一个 decode 步的清单,就非常清楚了:
- 新 token x t x_t xt 进入这一层;
- 投影出 q t , k t , v t q_t,k_t,v_t qt,kt,vt;
- 用位置编号 t t t 把 q t , k t q_t,k_t qt,kt 旋转( v t v_t vt 不动);
- 把旋转后的 k t k_t kt 和原样的 v t v_t vt 追加进缓存;
- q t q_t qt 与缓存里全部 K K K 做点积、softmax、对全部 V V V 加权求和,得到输出。
第 4、5 步就是 243 篇的缓存流程,而本篇补上了"缓存前先旋转、 V V V 不旋转"这两个细节。每一层都重复这套动作,位置编号在各层之间是一致的。
🧩 训练与推理必须一致
由此能推出一个实践上很重要的规则:训练用的旋转方式,推理时必须一模一样。 具体来说:
- 位置编号要对齐(训练 0.. L − 1 0..L-1 0..L−1,推理也从 0 0 0 开始连续递增,不跳号、不重置);
- 频率、
rope_theta、配对方式、要旋转的维度,训练和推理必须相同; - 不能在推理时把旋转关掉 。一旦关掉,模型看到的是"没有位置的 q , k q,k q,k",与训练分布严重不符,输出会明显退化。
常见的坑也来自这里,列几个:
| 错误做法 | 后果 |
|---|---|
| 推理时关闭旋转 | 模型看不到位置,输出严重退化 |
| 缓存里存未旋转的 K,只转新 q q q | 新旧键不在同一坐标,相对偏移错乱 |
| 把已旋转的 K 再转一次 | 位置角翻倍,点积含义被破坏 |
| 位置编号每步从 0 重来 | 相对偏移整体错位,长文本尤其明显 |
训练与推理的 rope_theta/维度不一致 |
频率对不上,等于换了套位置编码 |
| 推理位置远超训练长度 | 落入未见过的角度区间,效果下降(外推问题,见 #249/#250) |
这些错误的共同点,都是破坏了"同一个位置用同一个角度"这条约定。只要训练和推理严格共用同一套旋转参数与编号规则,RoPE 就不会出问题。
🧩 这套设计换来了什么
回到最初的三个问题,可以给出一个统一的回答:
- 前向还是反向------旋转本身在前向;反向只是把梯度反向旋转一次、继续回传,没有 RoPE 权重更新;
- 训练还是推理------两者都做,且必须一致;
- 和 KV cache 的关系------缓存旋转后的 K、未旋转的 V,使"新查询一次旋转 + 旧键直接复用"成为可能。
好处也很清楚:无参数 (不占权重、不增加训练变量)、相对位置 (点积只依赖 n − m n-m n−m)、和缓存天然兼容(旋转后的 K 可以直接存)。这三条合起来,就是 RoPE 成为主流位置编码的工程原因。
🧩 三个常见疑问
- "缓存的 K 是旋转前还是后?":后。这是为了让新查询旋转一次就能和历史键直接点积、自动得到相对距离;存旋转前的 K 会逼着每步重算,违背缓存初衷。
- "推理时新 token 的位置编号取多少?" :取"它前面已有多少个 token"。prompt 有 L L L 个 token,那第一个生成 token 的位置是 L L L,依此类推。
- "RoPE 有参数,是不是也算训练的一部分?" :它参与前向和反向的计算,但没有可训练参数 ------
rope_theta、频率都是配置或公式,优化器不更新它们。训练到底改的还是 W q , W k , W v W_q,W_k,W_v Wq,Wk,Wv 这些投影权重。
📌 一句话记忆
RoPE 只发生在每层注意力的前向 里,训练和推理都做;它没有可训练参数 ,反向传播只是把梯度反向旋转(乘 R ⊤ R^\top R⊤)后继续回传。训练整段并行、位置 0.. L − 1 0..L-1 0..L−1;推理按 prefill(并行)+ decode(逐 token)给位置编号。和
243的 KV cache 配合的关键是:缓存里存的是旋转后的 K、未旋转的 V ,这样新查询转一次就能和历史键点积、自动得到相对偏移 ( t − n ) (t-n) (t−n)。训练与推理的旋转方式必须严格一致,推理时不能关闭旋转。下一篇换一个方向:不旋转,还有哪些位置编码方案,各自适合什么场景。
OK,本篇先到这里,如有疑问,欢迎评论区留言讨论,祝各位功力大涨,技术更上一层楼!!!更多内容见下篇 blog