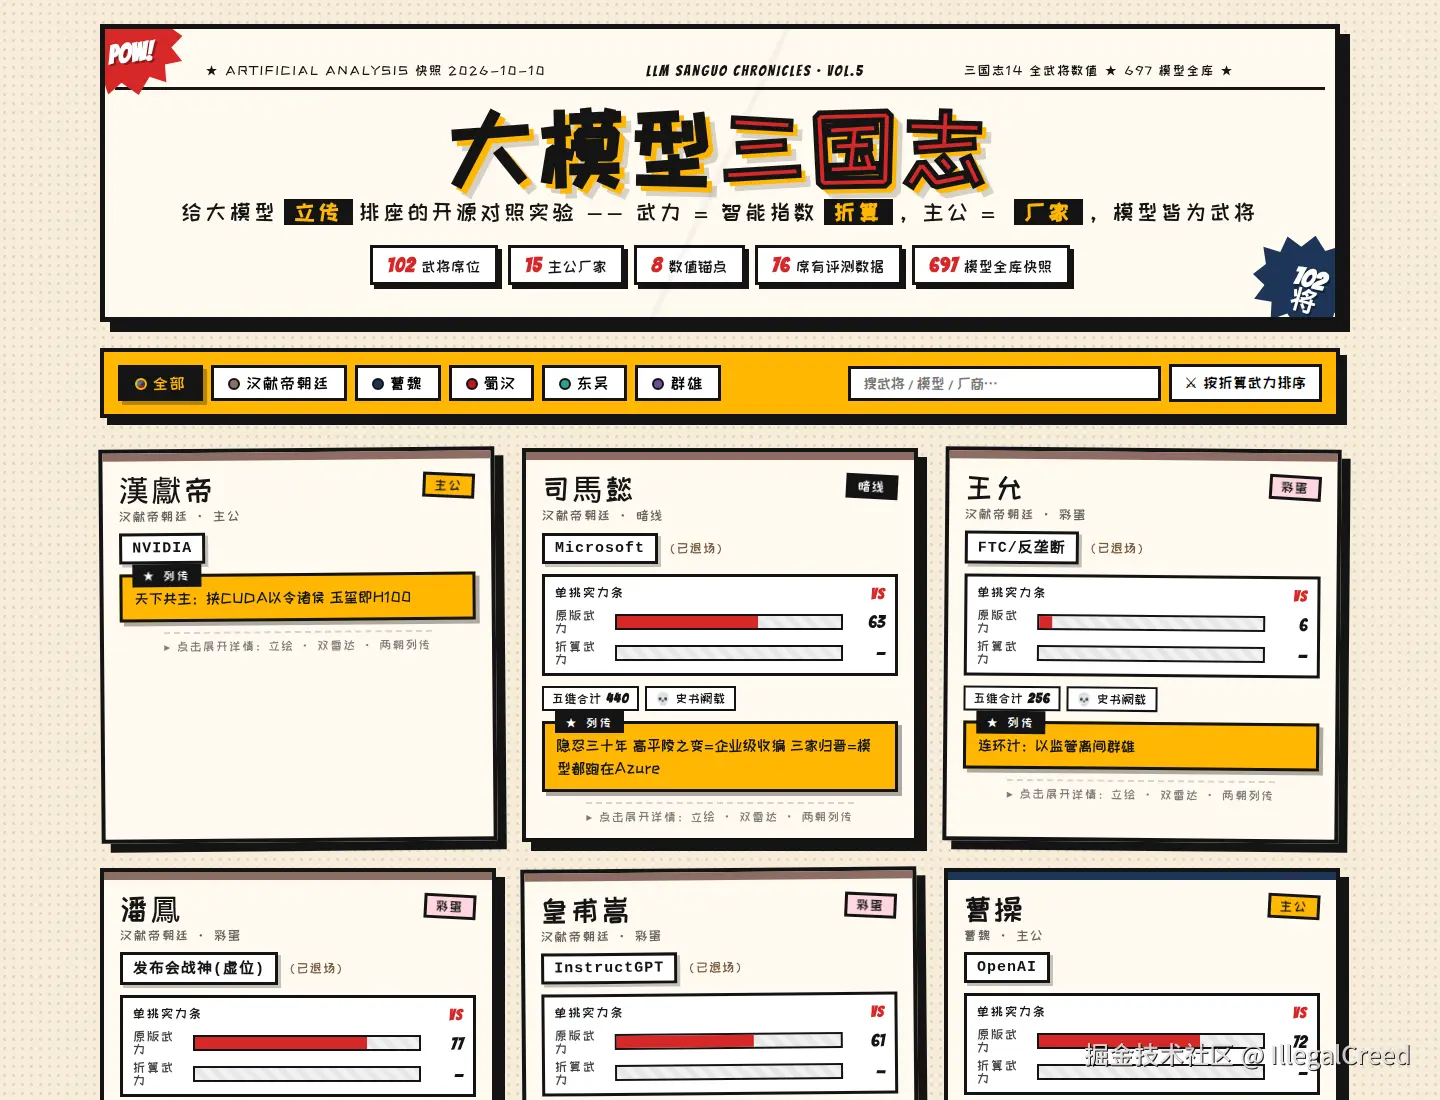
天天刷模型榜单,看到第 N 个"新 SOTA"的时候,我冒出一个念头:这些模型要是放到三国里,谁是吕布,谁是诸葛亮?光嘴上说太主观,我想用数据把它对出来。于是 10 月 10 日那个周末,我提交了第一个 commit,一天半以后,「大模型三国志」上线了。
一、两份"史源"
项目规矩只有一条:先看数据,再谈演义。数据来自两处:
- Artificial Analysis 模型榜单:2026-10-10 的全库快照,共 697 个模型,其中 687 个有 Intelligence Index(下文简称 II),还有每任务成本、输出速度和首字延迟。
- 《三国志14 威力加强版》武将数据:Nobuwiki 整理的 1180 名武将五维(统率、武力、智力、政治、魅力)。数值和立绘的版权都归 KOEI TECMO,仓库里的 NOTICE 写明了出处。
清洗时最麻烦的是模型名。同一个模型在榜单上会按推理档位拆成好几行,比如 (max)、(xhigh),还有 max with fallback。我统一去掉档位后缀,数值取最高档。build_site.py 里是这样写的:
python
def canonical_name(name):
    def clean(m):
        tokens = [t.strip() for t in m.group(1).split(",")]
        kept = [t for t in tokens if not _is_effort_token(t)]
        return "(" + ", ".join(kept) + ")" if kept else ""
    return re.sub(r"\(([^()]*)\)", clean, name).strip()
武将名在数据文件里保留游戏原表的繁体(呂布、諸葛亮),正文叙述用简体。
采集过程中也踩过坑。我一开始用的是榜单表格导出,只有 267 行现役模型,退役的模型虽然有页面、有分数,却不在表格里。后来改成直接解析 leaderboard 页面内嵌的完整模型数组,一次拿到全库,这才有了现在的 697 个模型。最早那份导出我留在 data/aa_models_raw.tsv 里存档,不参与现行折算。另一个教训是一定要和网页对账:有一次导出后,我拿站点逐条核对,发现 GPT-6 Sol 和 GPT-5.5 两条主线带分的记录缺了,是人工比对才补回来的。榜单数据的时效性很强,凡是涉及版本号的地方,我都会先确认快照日期。
二、映射规则:武力看智能,智力看性价比
五个维度我按权重分了三级。
一级:武力 ↔ II。 武力就是单挑硬实力,对应模型的峰值智能。以快照榜首为 100 折算,当前榜首是 Claude Opus 5.5,II 57.6。enrich_mapping.py 里只有一行:
python
"derived_warfare": round(ii / top_ii * 100) if ii else "",二级:智力 ↔ 性价比。 谋士以计破力,模型靠便宜对抗算力军备,所以每任务成本越低,智力越高。统率、政治、魅力分别对应 agentic 能力、对齐和调用量。快照里还没有这几列,目前是人工填的。
三级:阵营和典故。 只用来讲故事和打破并列,不参与打分。
自动匹配(我叫它"天命版")不比原始值,比百分位。II 57.6 和武力 100 不在同一个尺度上,但"在模型里排第几"和"在武将里排第几"是可以直接比的。百分位函数很朴素:
python
def percentile_ranks(values):
    """值 -> 群体内百分位(0~1),None 保留为 None。"""
    valid = sorted(v for v in values if v is not None)
    n = len(valid)
    out = []
    for v in values:
        if v is None:
            out.append(None)
        else:
            out.append(sum(1 for x in valid if x <= v) / n)
    return out
打分对每个模型遍历 1180 名武将,取加权距离最小的几位:
python
d1 = abs(s["ii_pct"] - war_pct[j])
d2 = abs((s["cheap_pct"] or 0) - int_pct[j]) if s["cheap_pct"] is not None else None
score = 0.7 * d1 + (0.3 * d2 if d2 is not None else 0.15)
缺成本数据的模型,智力这一项按固定的 0.15 惩罚计入,不至于因为缺数据反而占便宜。性价比的百分位是对成本取负数再排的(-c),越便宜排得越高。
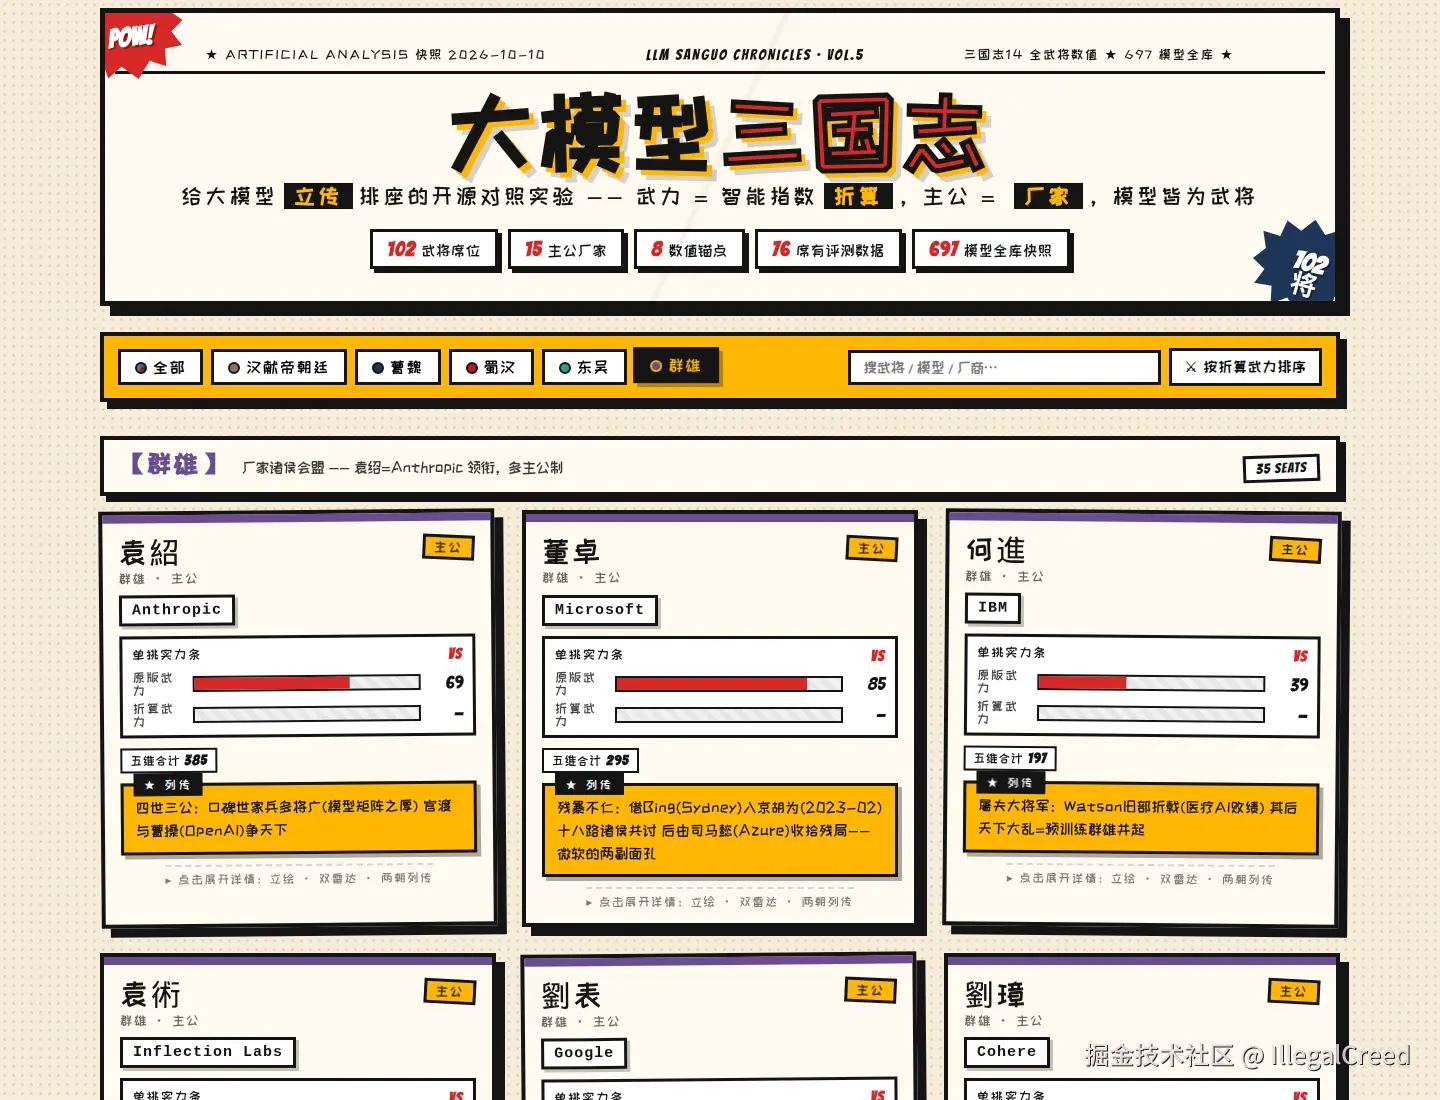
站点上展示的 102 席是另一套"演义版":人工编排,阵营优先,但折算武力仍然受公式约束。两套结果允许不一样,这也是我觉得最有意思的地方:数据说一套,演义说一套,摆在一起看。
三、一页纯静态站是怎么生成的
我是前端,但这次刻意没用任何框架。整个站点就是 docs/index.html 一个文件,由 build_site.py 生成:Python 读 mapping_v0.5.csv,拼好数据,塞进一个 HTML 模板字符串的占位符里。
python
def main():
    data = load_data()
    html = (TEMPLATE
            .replace("__FACTIONS__", json.dumps(FACTION_META, ensure_ascii=False))
            .replace("__DATA__", json.dumps(data, ensure_ascii=False)))
    out = os.path.join(ROOT, "docs", "index.html")
    with open(out, "w", encoding="utf-8") as f:
        f.write(html)
模板里就是 const DATA = __DATA__;,前端的阵营切换、搜索和排序都直接对这个数组 filter/sort。没有请求,不需要 API Key,也不调用任何模型接口。只用 Python 3 标准库,GitHub Pages 直接发布 docs/ 目录,改完映射重跑一次脚本就行。
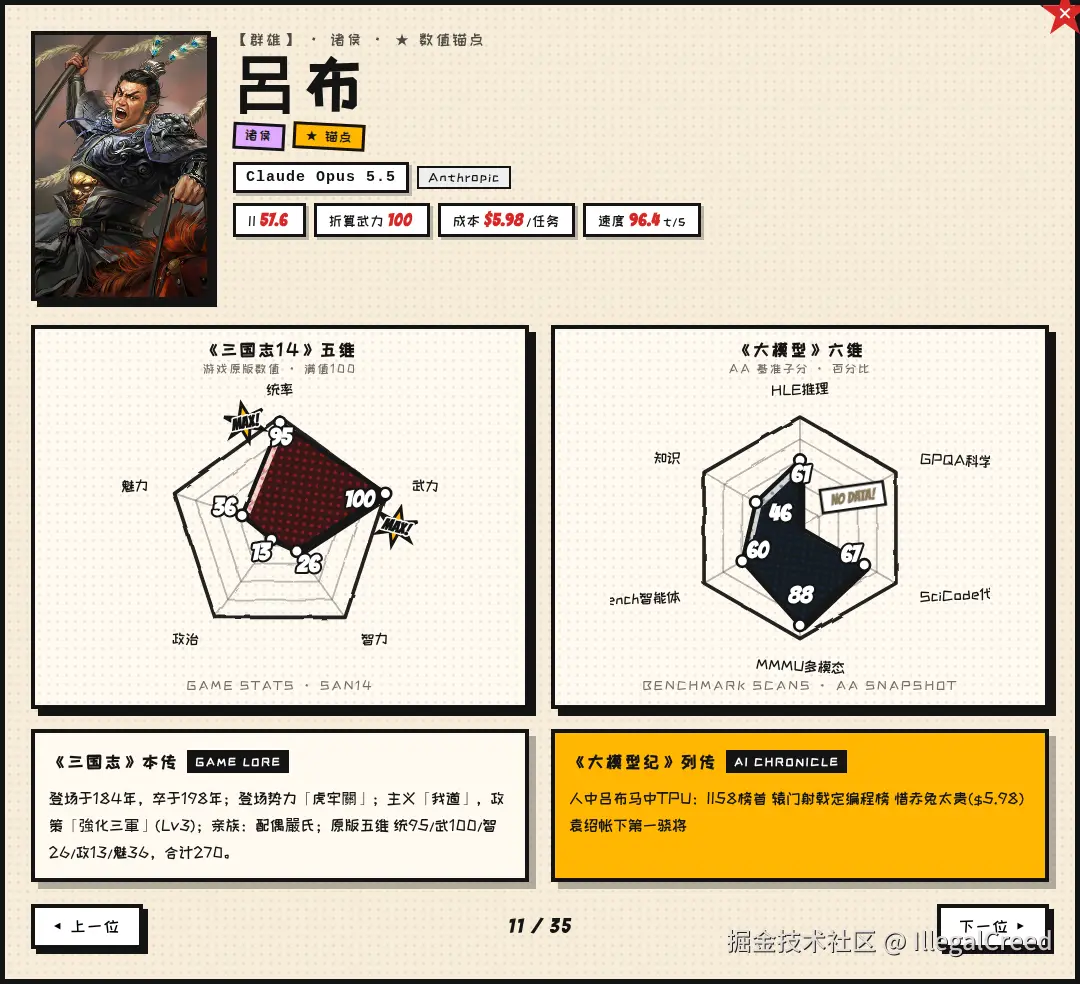
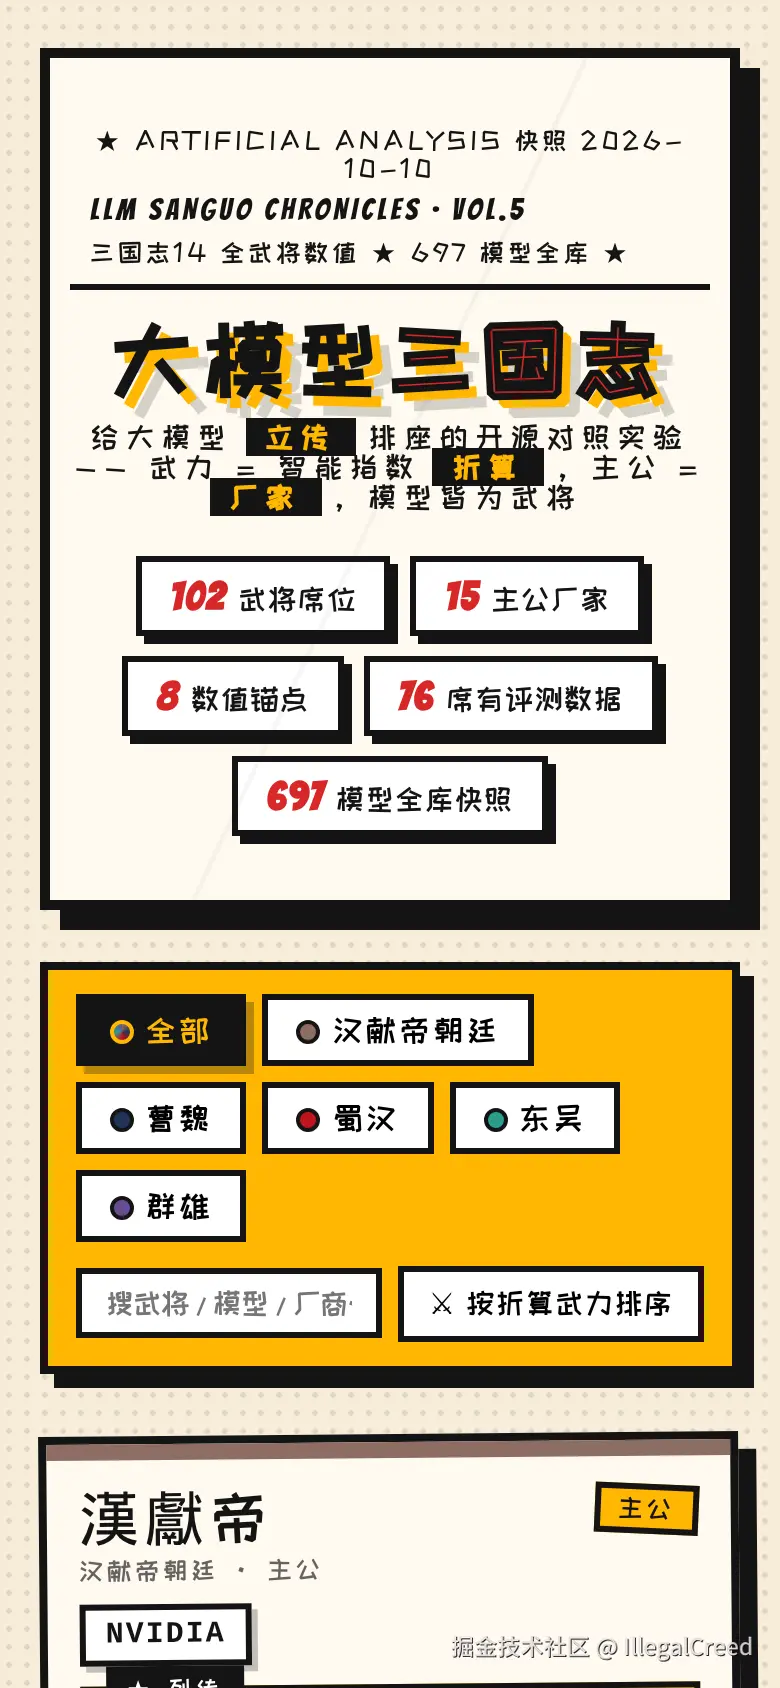
视觉上我选了美漫风:网点填充、手绘抖线、硬阴影,满分项盖一个 MAX 爆炸章。详情层放两张 SVG 雷达图,一张是游戏五维,一张是模型基准,再配一段"两朝列传"。雷达图的数值和章位最早会互相压字,后来按几何位置重新排了布局才修好。手机宽度下也能正常看。
四、为什么主公位只坐厂家
早期版本里,我让具体模型去坐主公位,结果很快就乱套了:一家公司每隔几个月就出一个新旗舰,主公的位子总不能跟着换。所以从 v0.4 开始,我定了一条硬规则:主公位只写公司名,数值永远空着;模型只能坐武将或诸侯位,退役的模型在列传里注明,不另设"已故"角色。
这样还有两个好处。第一,同一家的模型自然归在同一个主公帐下,比如 Claude 系几代模型都在袁绍门下,各个阵营的家底一眼就能看清。第二,"血缘"有了现成的对应:父子兄弟武将统一分给同一家厂商。另外还有一条约束:客将不能离开本家去敌营效力,Anthropic 的模型只会出现在袁绍营里。
规则一多,好处是换将有据可依,别人提 PR 时也知道该怎么改;代价是演义版的人工成分更重,所以我保留了纯数值的天命版做对照。
五、几组好玩的结果
站点上标了星的八组锚点,都是折算武力和游戏原版武力几乎重合的:
| 模型 | 武将 | 折算 : 原版 |
|---|---|---|
| Claude Opus 5.5 | 吕布 | 100 : 100 |
| Claude Fable 5.1 | 文丑 | 93 : 94 |
| GPT-6 Astra | 曹彰 | 91 : 90 |
| Claude Opus 5 | 高顺 | 88 : 86 |
| GPT-5.6 Sol | 文聘 | 82 : 82 |
| Claude Haiku 5.5 | 曹性 | 75 : 74 |
| GPT-4 | 荀彧 | 12 : 14 |
| Olmo 3.1 32B Think | 顾雍 | 12 : 18 |
- 颜良、文丑 = Claude Fable 5 / 5.1:袁绍帐下的两员大将,折算武力分别是 86 和 93。
- Opus 5.5 = 吕布:II 榜首,折算武力 100,正好对上原版吕布的武力 100。而且一样"贵":每任务 $5.98,吕布原版政治只有 13。人中吕布,马中赤兔,卡中 Blackwell。
- 主公位只坐厂家,相当于各家站队:曹操 = OpenAI,刘备 = 幻方量化,孙权 = Meta,袁绍 = Anthropic,Claude 系的模型都在袁绍帐下。
- 汉献帝 = NVIDIA:列传写的是"挟 CUDA 以令诸侯,玉玺即 H100"。游戏不收录皇帝,所以他的五维是空的,是故意留空的。
- 诸葛亮 = DeepSeek V4 Pro 0813:折算武力 62,原版武力 38。丞相本来就不以武力见长,这一席是演义版按叙事排的。
六、局限
- 时效:所有数值都来自 2026-10-10 的快照,榜单一更新就会过时。后续计划保留历史快照,做"武将成长曲线"。
- 权重是主观的:0.7 / 0.3 是我定的。统率、政治、魅力还是人工填的,打算接入 AA 的 Agentic/Coding 指数和 OpenRouter 调用份额来补。
- 只是娱乐类比:阵营和典故是叙事调味,不代表我对哪家厂商有评价。
欢迎提 issue 或 PR 来换将、补将。只有一个要求:改映射时请引用两份史源的数据。