前言: 上一篇把容器、Pod 和 Node 的关系捋了一遍,我随手想到一个更贴近日常维护的问题:图片预览接口已经跑在 Pod 里,如果这个 Pod 没了,接口该怎么办?正常情况是补出一个同样的实例,我第一反应却是"容器不是会自动重启吗"。翻了 Kubernetes 官方关于 Pod 的说明才发现,我把"同一个 Pod 里的容器重启"和"整个 Pod 被替换"混成了一件事。于是我想弄明白:
text
1. 没有管理对象时,我们怎么保证 Pod 还在?
2. 用了 Deployment 以后,为什么还不能直接把它当成服务已经可用了?
这篇只围绕"少了一个 Pod 怎么补"来聊,先不展开滚动更新和调度策略。下面的图片预览接口是示意场景;示例清单核对了官方文档,但我没有连接集群执行它。
一. 一个 Pod 消失后,事情不一定像我想的那样
-
假设我们有个图片预览接口,每次上传图片后,页面会请求它生成一张缩略图。前一篇说过,应用容器可以放在 Pod 里运行。开发时手动创建一个 Pod,接口能响应,看起来已经完成部署了。
-
现在想象这台机器要维护,或者有人把那个 Pod 删掉了。我最初以为"自动重启"会把它救回来。可容器重启处理的是 Pod 内部的容器进程;Pod 本身被删掉时,单独创建的 Pod 没有一个上层对象负责按原样重建。官方也建议,长期运行的工作负载通常通过控制器创建和管理 Pod。
-
这就像店里只有一位值班员:人临时离开座位,可以叫他回来;岗位本身从排班表里被删掉,就没人知道还需要补一个人。这里的"排班表",后面正是我们要找的东西。
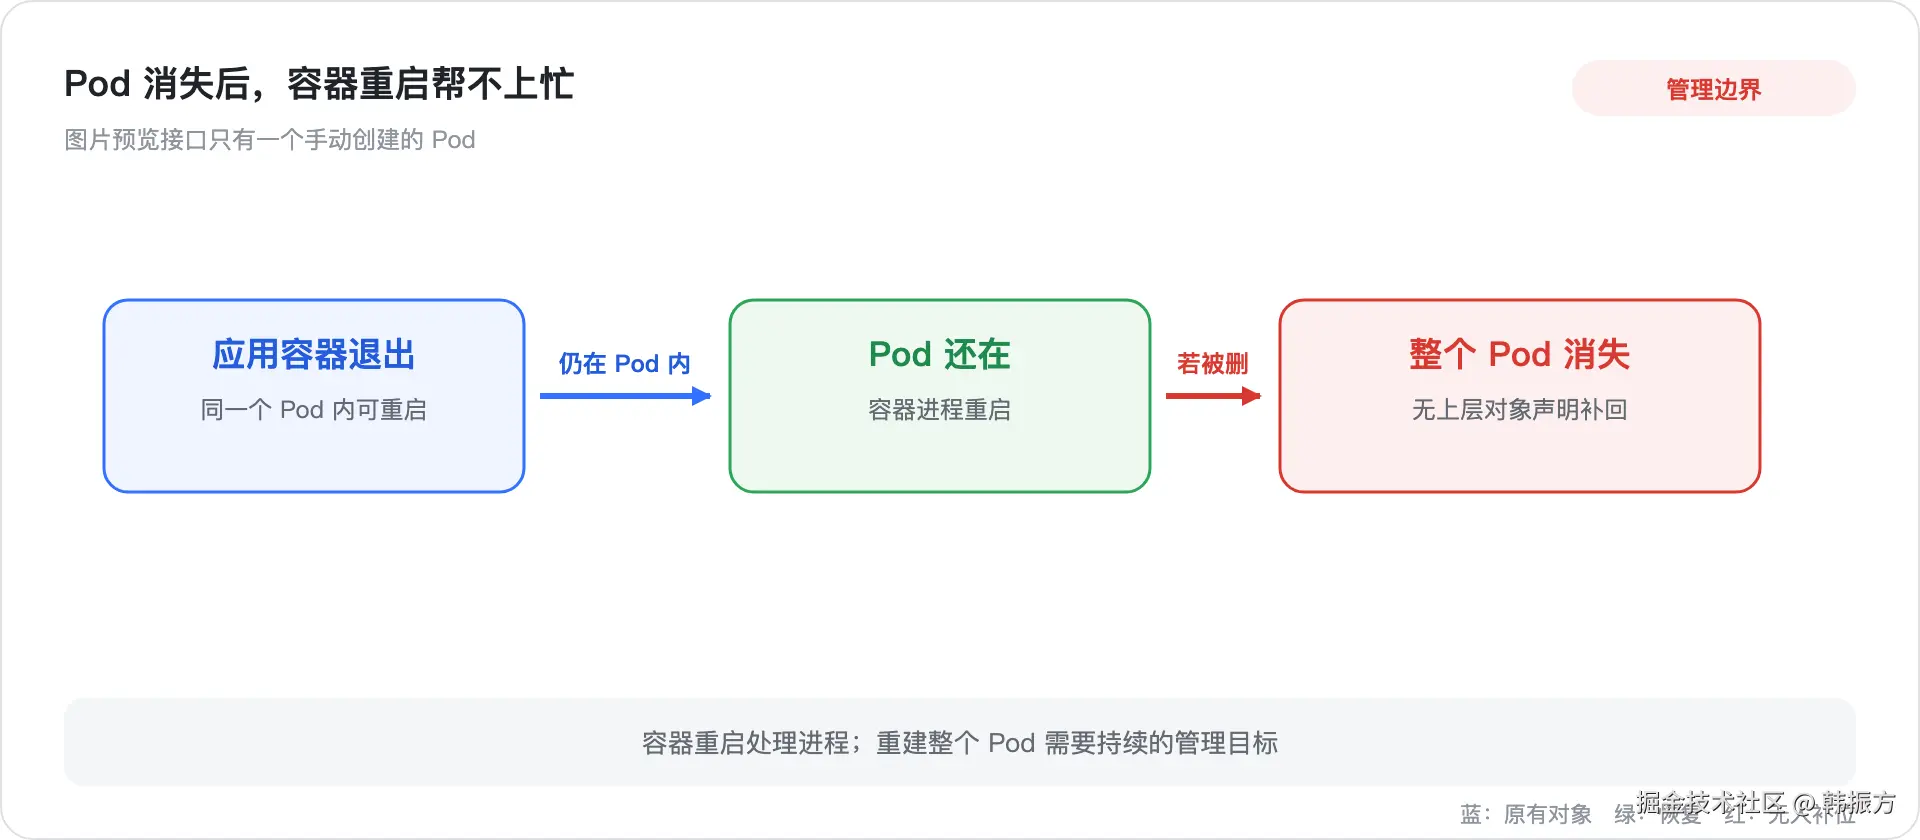
图里重点看右侧:容器重启的边界在 Pod 内,不能替代"重建一个 Pod"的职责。
二. 我先试着把"补人"这件事交给自己
-
最粗暴的办法是发现接口不通,就手动再执行一次创建命令。它能救急,但值班的人得一直盯着;夜里出问题时,手工补救的速度也不可控。
-
稍微好一点,可以写个脚本定期检查 Pod 数量,不足就重建。我也会这么想,但脚本很快就得处理重复创建、并发执行、模板变更以及"旧 Pod 正在退出"这类细节。它开始像一个简化版控制器了,维护成本却落在自己身上。
| 做法 | 谁判断少了一个 | 少了以后怎么办 |
|---|---|---|
| 手动创建 Pod | 值班的人 | 再敲一次创建命令 |
| 自写巡检脚本 | 定时脚本 | 自己处理计数、重复与重试 |
| 声明工作负载 | 集群控制器 | 按声明的模板和数量调整 |
- 对图片预览这种要持续提供服务的应用,我们真正想表达的不是"现在创建一个",而是"以后应该一直有一个"。这句话听起来只改了几个字,责任却从一次性操作变成了持续维护。
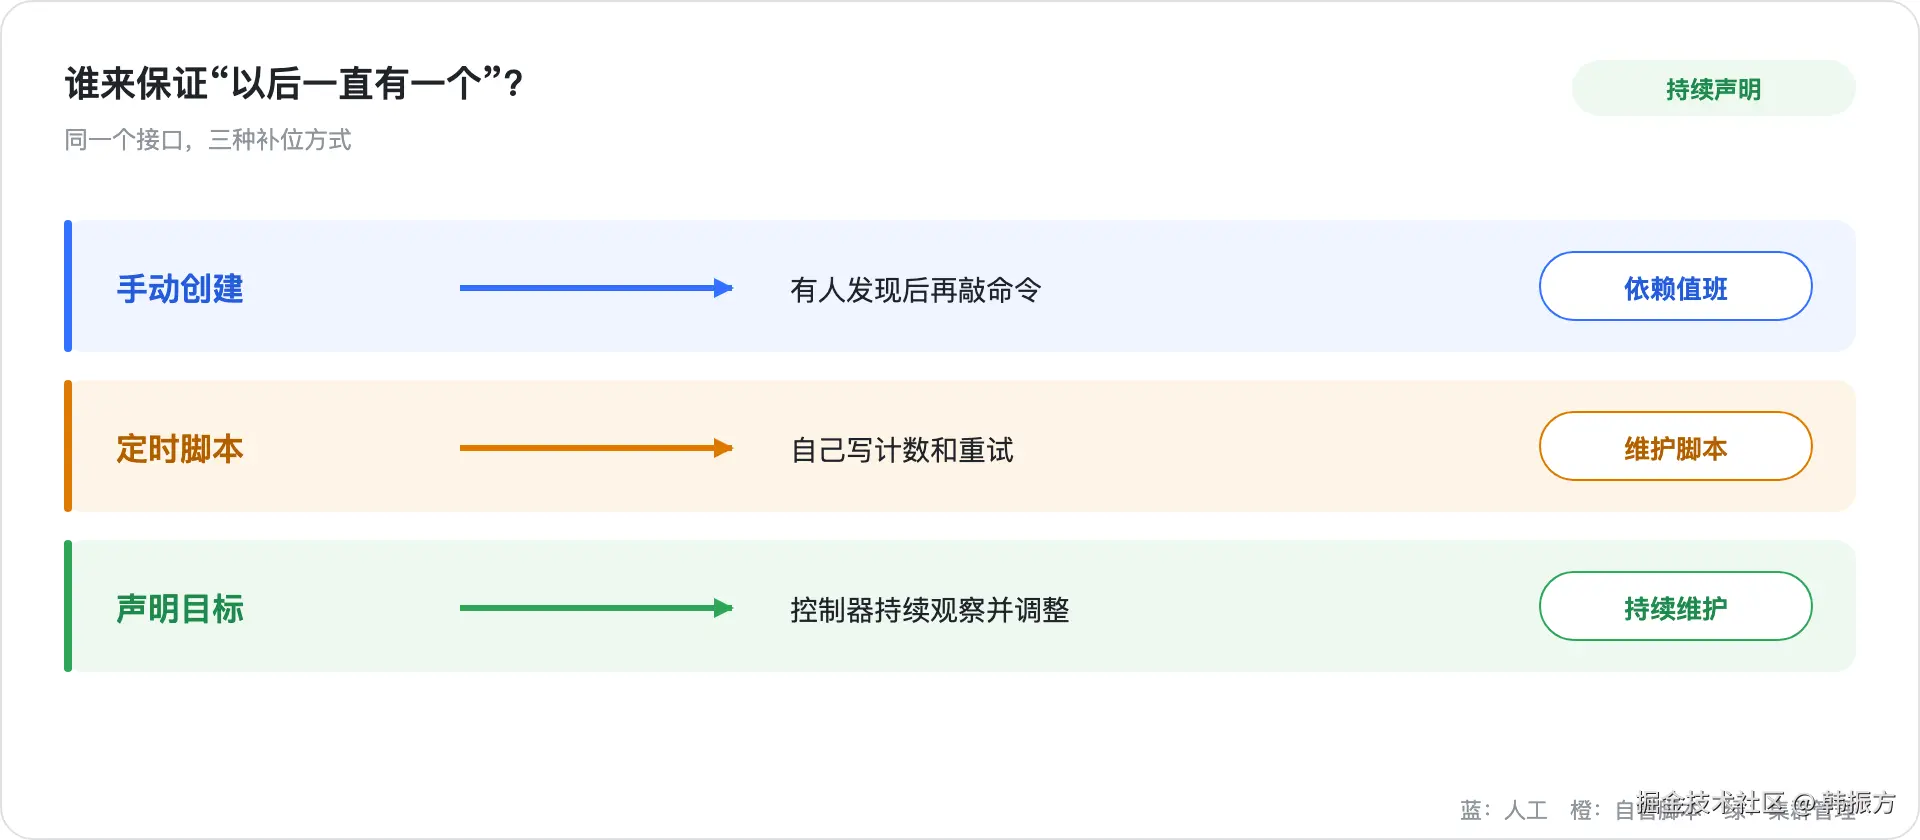
图里蓝色路径需要人反复介入;绿色路径保留一份持续生效的目标。
三. Deployment 写下的是"以后都要这样"
-
到这里再引入 Deployment 就顺了。官方 Deployment 文档把它描述为声明式更新 Pod 和 ReplicaSet 的工作负载对象。我们给它一份 Pod 模板和想要的数量,它负责让实际情况朝这个目标靠近。
-
先只要一份图片预览服务。下面清单的
replicas: 1是期望数量;template是以后补新 Pod 时使用的模板。selector.matchLabels与模板里的labels必须对得上。镜像名只是示例,实际使用时要换成你能拉取且会启动服务的镜像。
yaml
apiVersion: apps/v1
kind: Deployment
metadata:
  name: preview-api
spec:
  replicas: 1 # !!! 注意:希望持续保留一份 Pod
  selector:
    matchLabels:
      app: preview-api
  template:
    metadata:
      labels:
        app: preview-api
    spec:
      containers:
        - name: preview-api
image: registry.example.com/preview-api:v1 # 换成可拉取的实际镜像- 如果它管理的 Pod 消失,Deployment 不是亲自去运行容器。它管理 ReplicaSet ,后者按模板维护指定数量的 Pod 。为了先建立认知,可以记成一条关系:Deployment → ReplicaSet → Pod → 容器。具体控制循环暂时不用背。
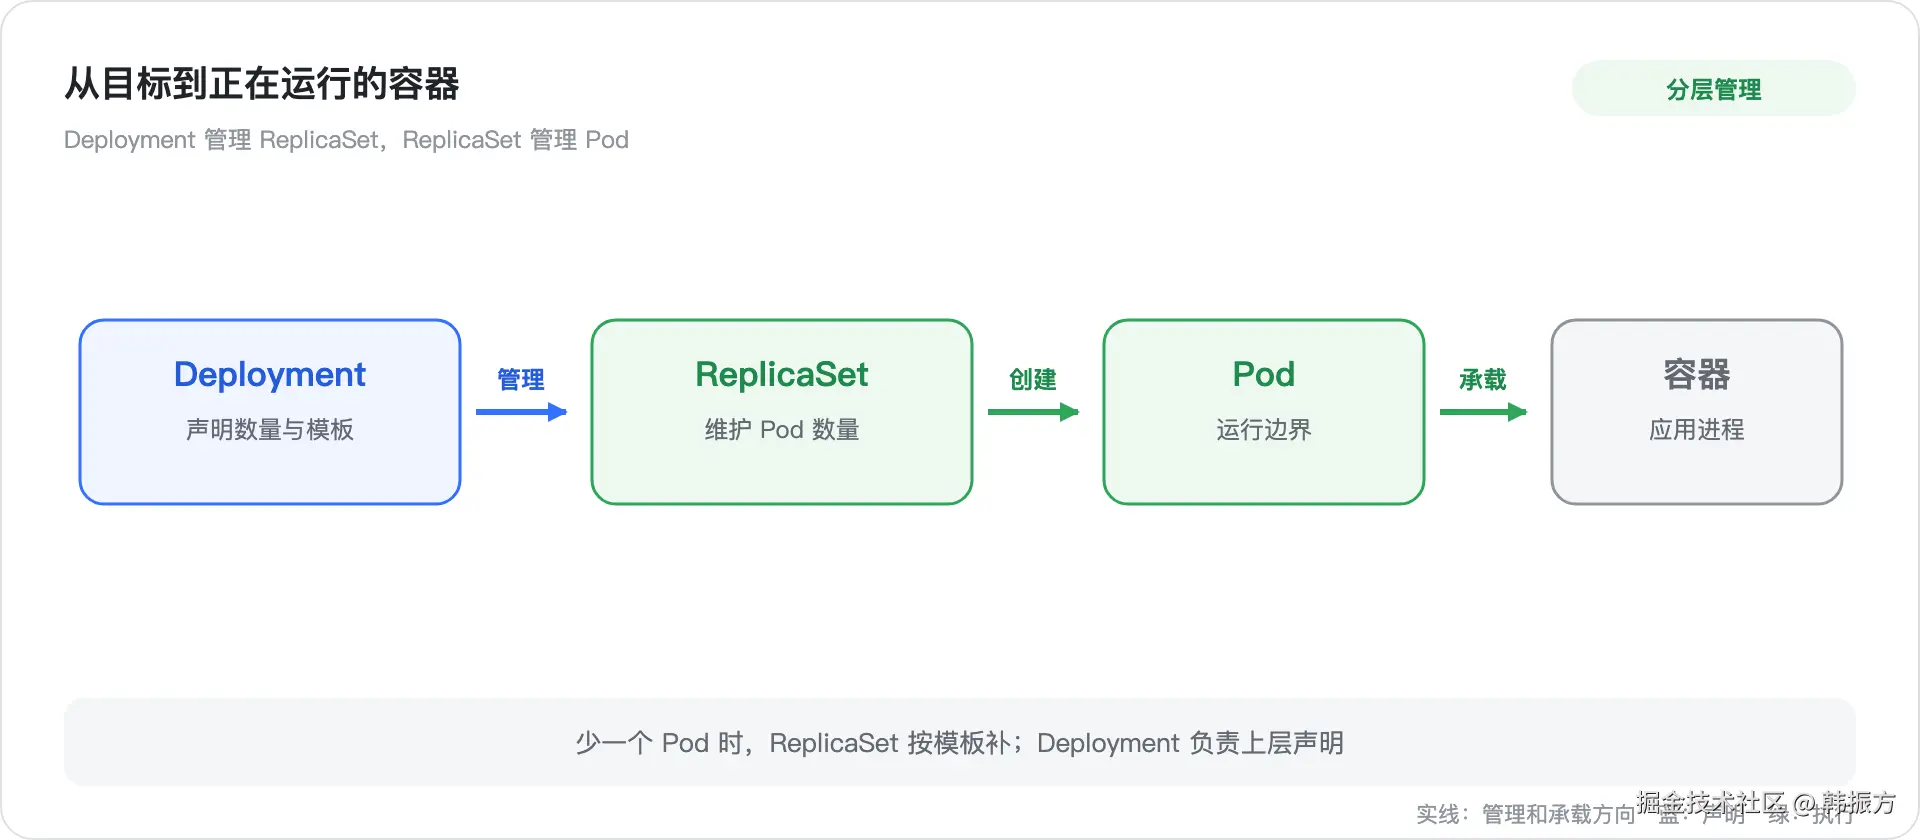
图里重点看箭头的管理关系:声明写在 Deployment ,实际运行的仍是 Pod 里的容器。
四. 排班表有了,还得看人有没有到岗
-
继续沿用排班的比方:Deployment 像"这个岗位长期需要一人"的排班要求,ReplicaSet 像照着排班表补人的执行环节,Pod 是到岗的那个人。人换了,岗位要求还在;所以新 Pod 可能有新名字,它不是原来那一个复活了。
-
如果手边有可用集群,可以把上面的清单保存为
preview.yaml,换好真实镜像后观察这三层对象。命令来自官方的kubectl apply用法;下面只给出观察路径,不把输出写成实测结果。
bash
kubectl apply -f preview.yaml
kubectl get deployment preview-api
kubectl get replicaset -l app=preview-api
kubectl get pods -l app=preview-api- 看
kubectl get deployment时,先比较期望数量和就绪数量。假如期望是 1,实际还没准备好,不要急着断言控制器失效:它可能还在拉镜像、等待调度,或者应用本身启动失败。这时再看 Pod 的状态和事件,才知道卡在"没创建""没跑起来"还是"没准备好"。
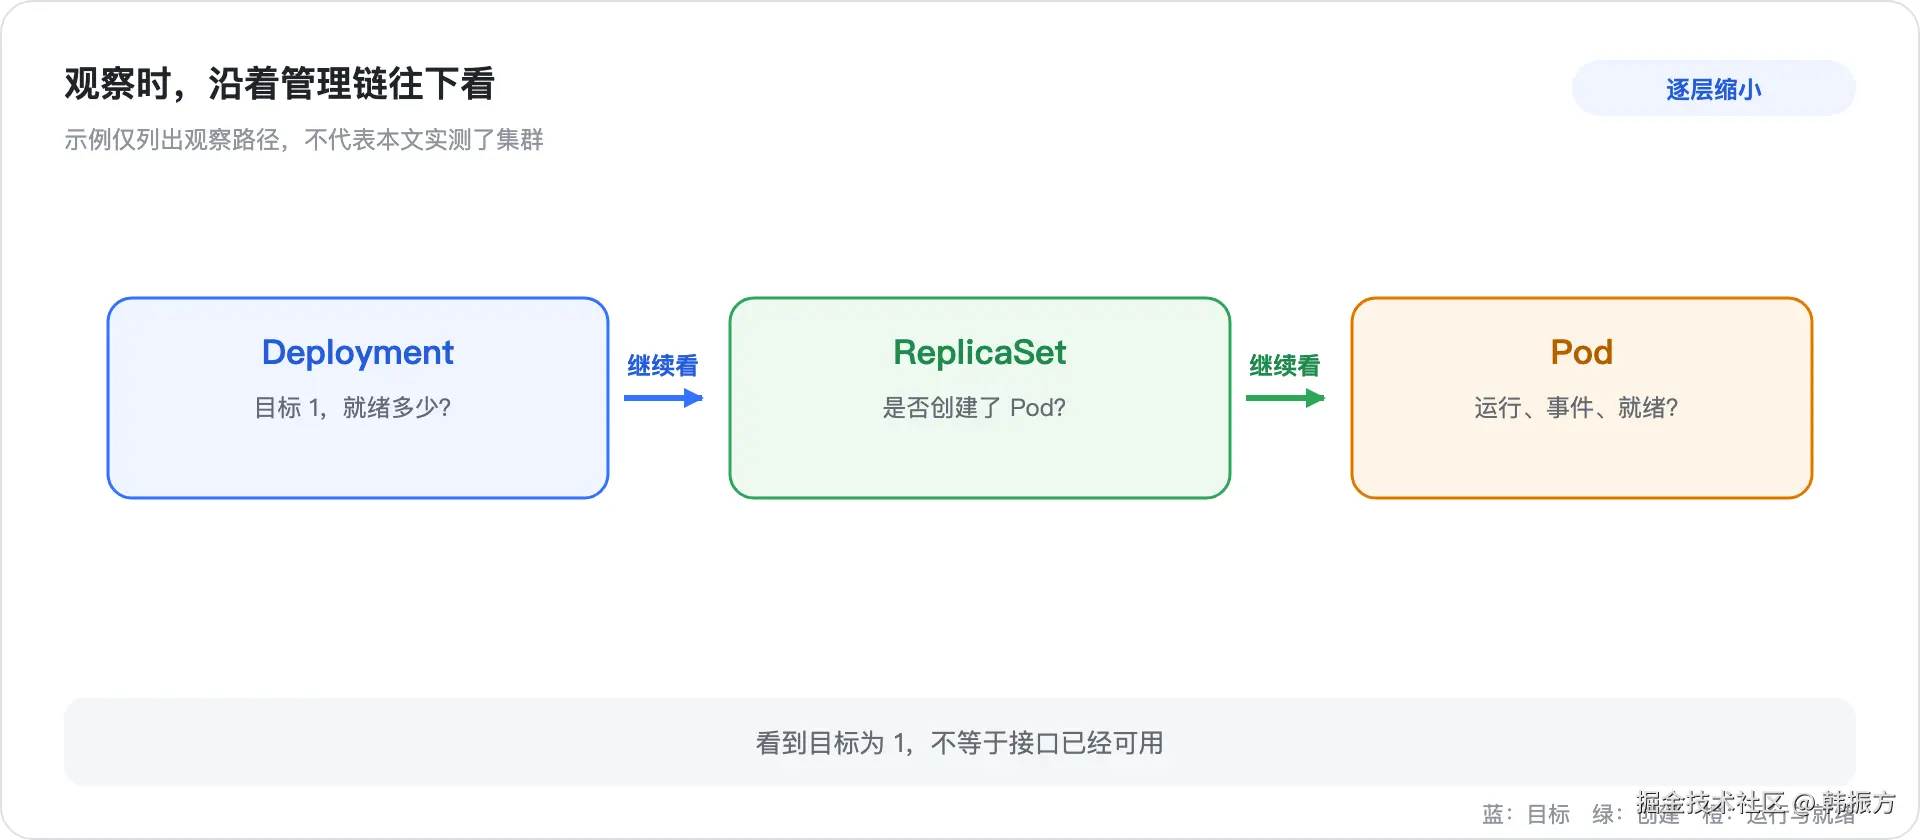
图里重点看三个检查点,别把"目标写了 1"直接读成"接口已能服务"。
五. 用了 Deployment,也不能把它当成万能保活
-
Deployment 能维护工作负载的目标数量,但不保证每次调整都立刻成功。如果镜像拉不到、节点资源不足,新的 Pod 可能迟迟不能运行;如果程序启动后还没准备好接请求,"有一个 Pod"也不等于接口已经可用。
-
还有一个常见误会:把
replicas: 1改成 2,只说明希望有两份 Pod ,并不自动解决客户端该访问谁的问题。稳定入口需要后面要讲的 Service 。这也是为什么我不想把 Deployment 解释成"部署完就什么都好了"。 -
真排查时,先分清是哪一层出了问题:Deployment 有没有声明正确的目标;ReplicaSet 是否在创建 Pod ;Pod 是否运行并就绪;应用是否真的能处理请求。这样问比看到接口不通就重启所有东西更有方向。
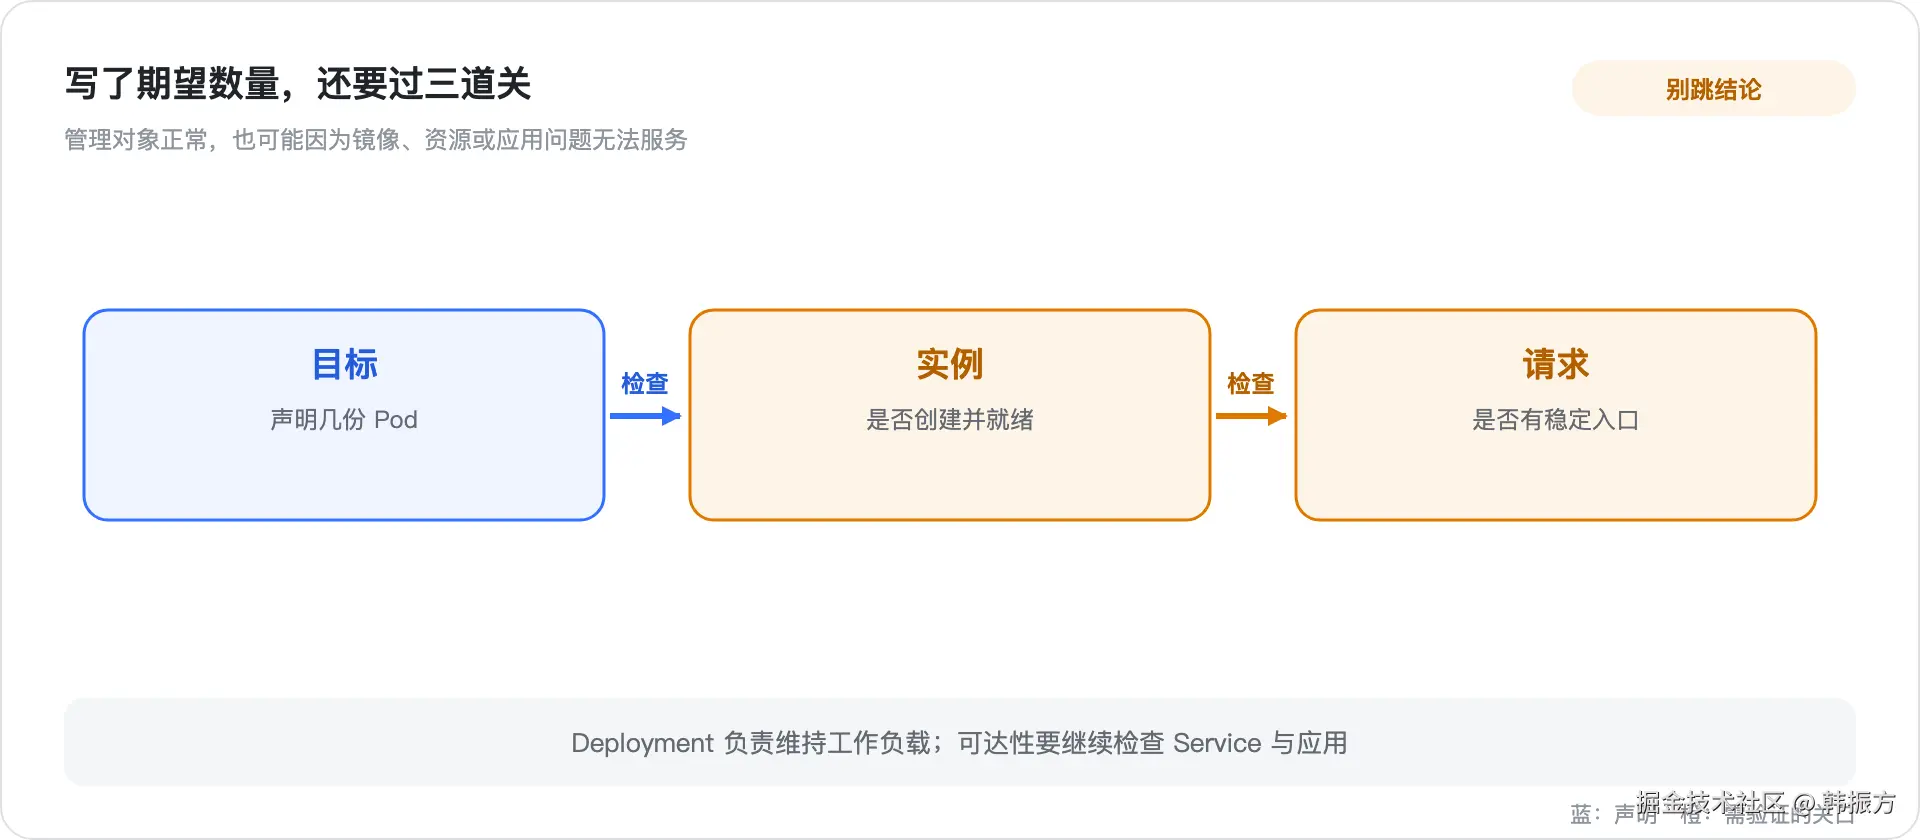
图里橙色的两道关口提醒我们:补出对象只是第一步,还需要检查运行和访问。
六. 总结:下次少一个 Pod,先找谁在管它
- 回到开头的图片预览接口。如果只是手动创建一个 Pod ,它消失后不能指望"容器自动重启"把整个 Pod 带回来。长期运行的服务需要把期望写给上层工作负载对象;常见的无状态服务可以从 Deployment 开始。
text
先看 Pod 有没有上层管理者
再看 Deployment 的目标数量与就绪数量
接着沿 ReplicaSet、Pod 查到具体卡点
最后单独确认应用和访问入口是否可用- 这篇先记住 Deployment → ReplicaSet → Pod 这条管理链就够了。下次再看到"明明写了两份,为什么请求还是打不到服务",就知道要把"维持实例"和"给请求一个稳定入口"拆开;下一篇我们正好从 Service 继续。
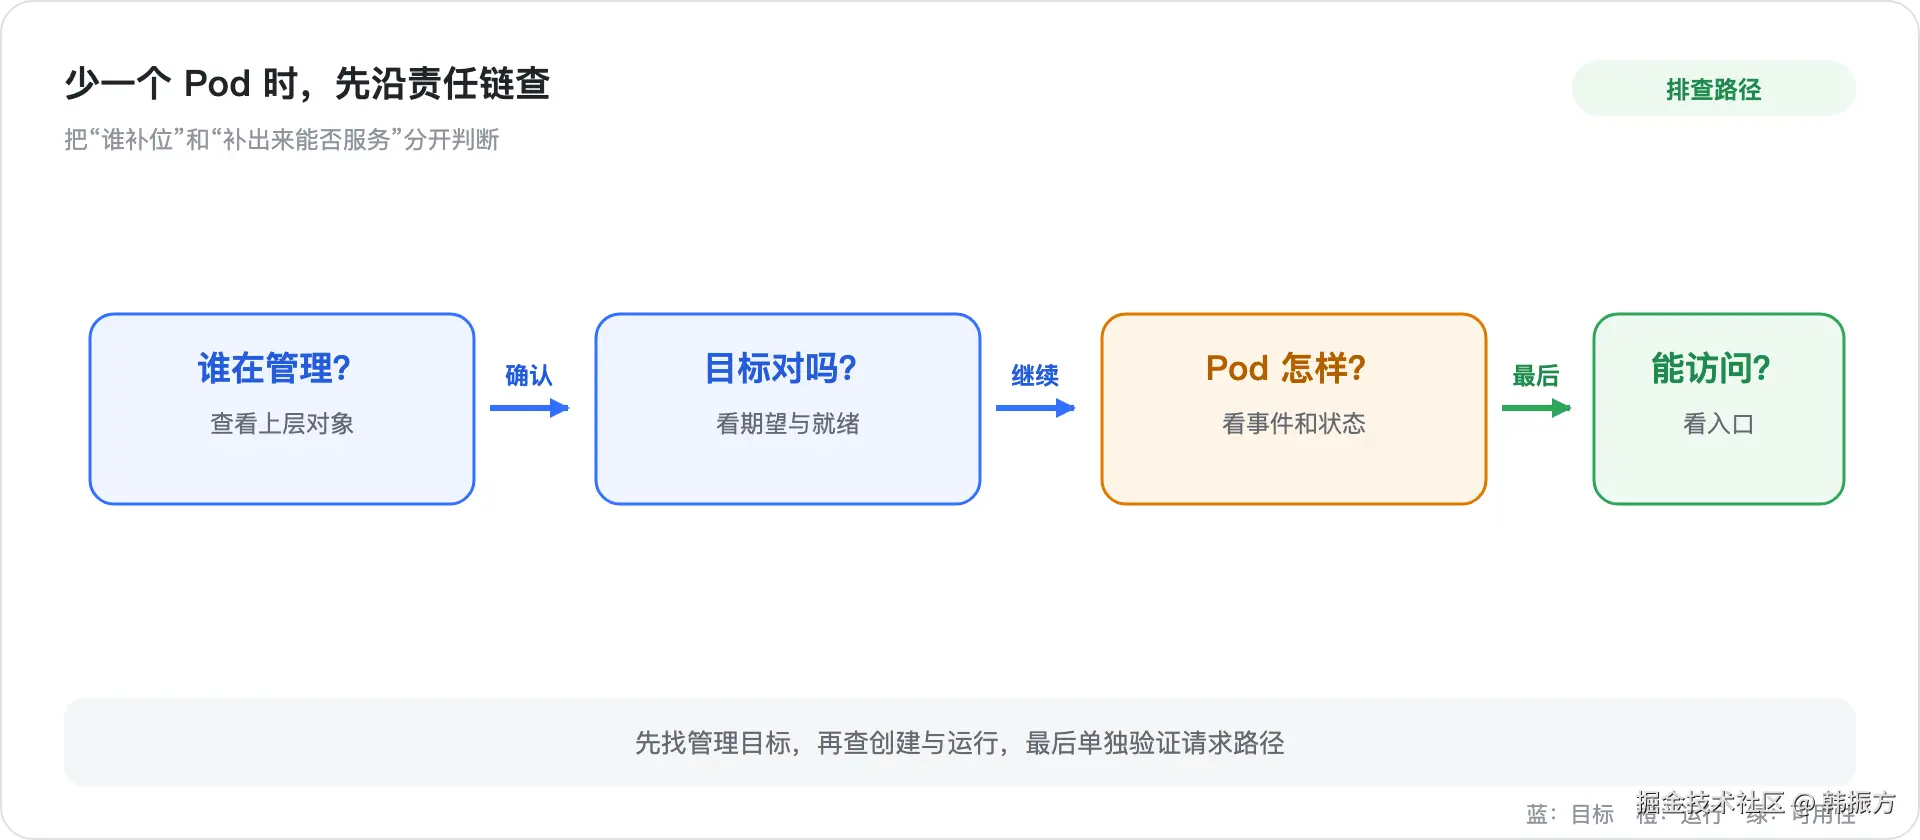
图里从左到右是一条排查路线:先确认谁负责补,再确认补出来的实例能否真正服务。