长尾分布:训练集里少数头部类别样本极多,大量尾部类别样本很少,模型容易偏向头部类,尾部召回差。下面按大类整理主流方法。
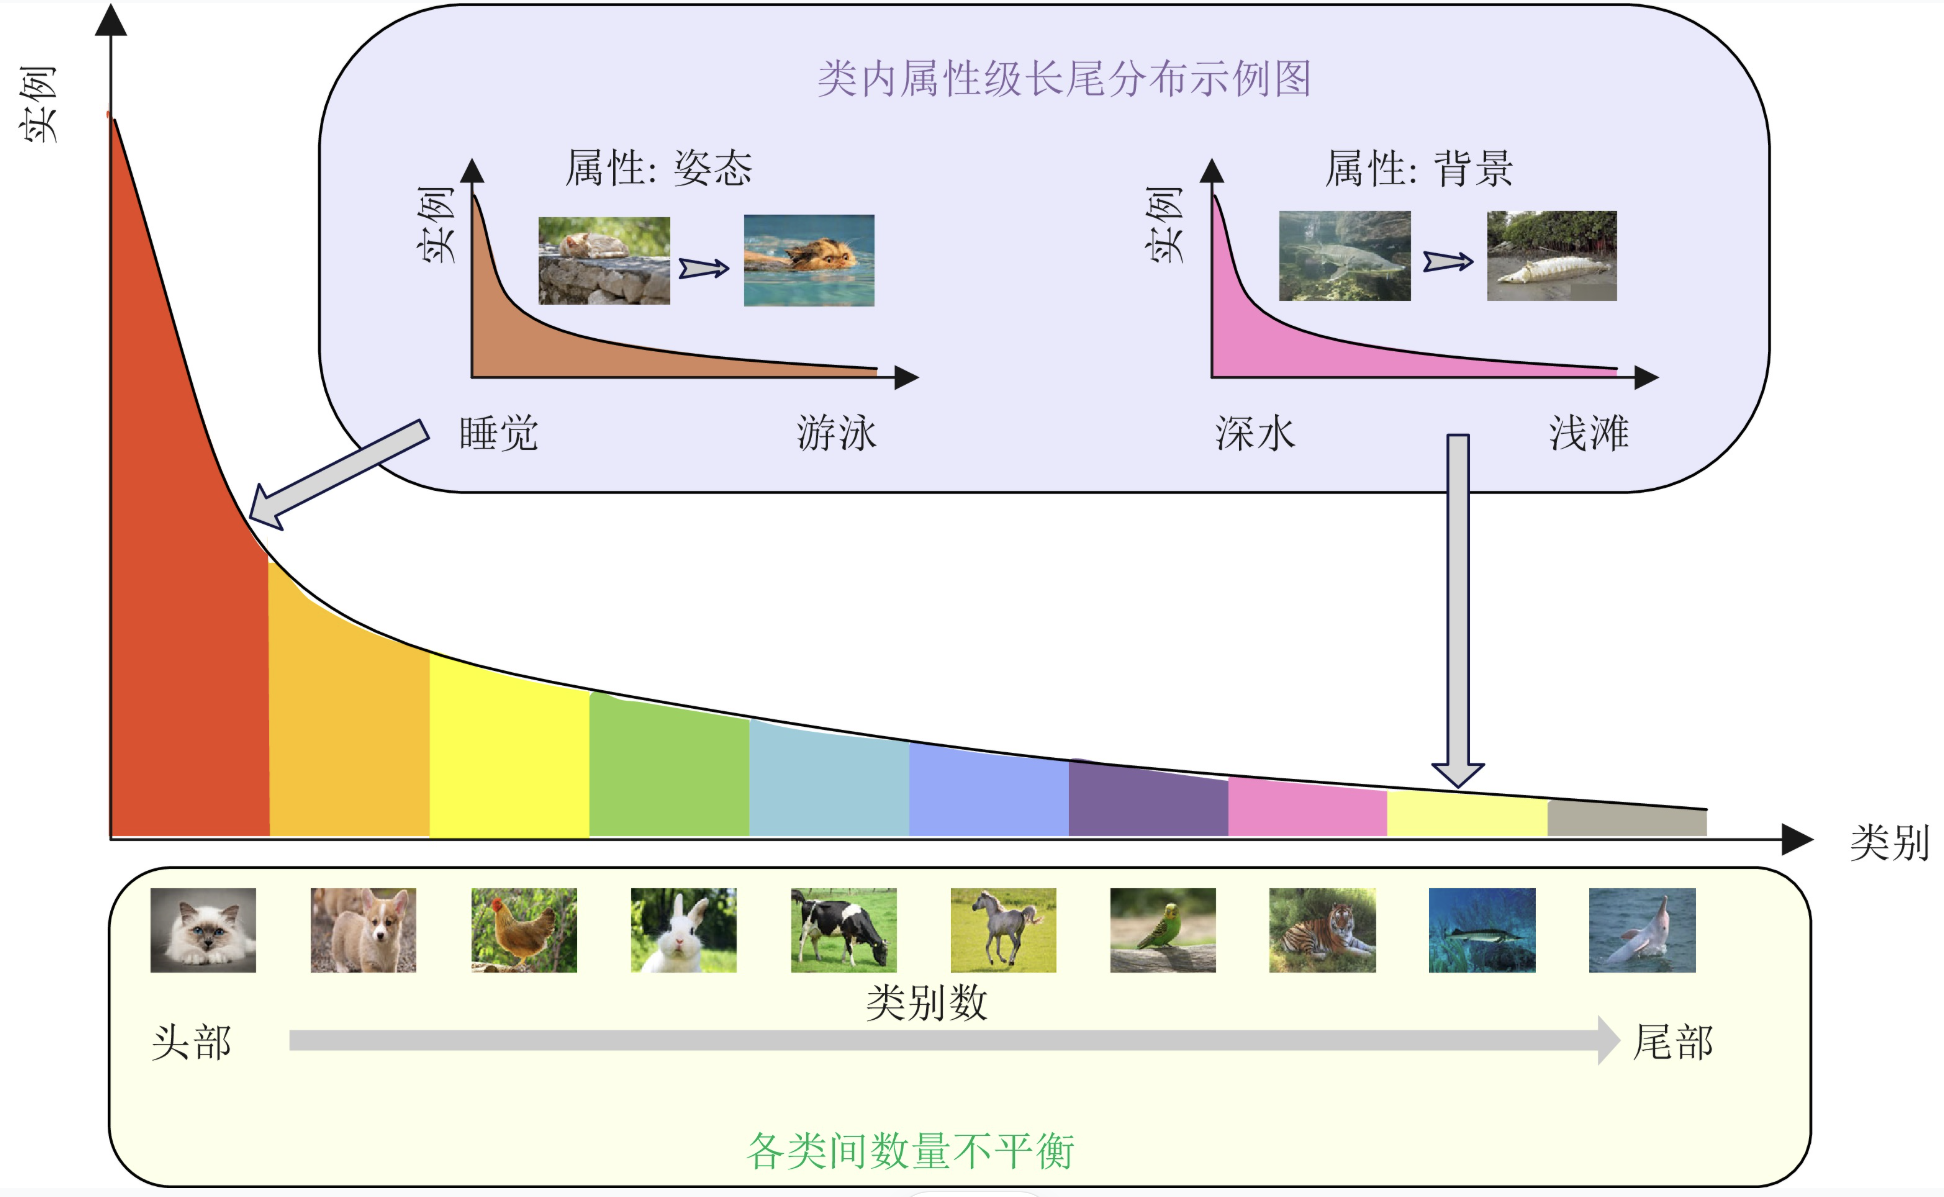
从左到右样本数递减;左边头部类别样本充足,右边尾部类别样本稀少。模型直接训练时,会优先拟合头部样本,尾部类别学到的特征聚类中心弱、决策边界容易被头部 "挤压"。
一、数据层面(Data-level)
1. 重采样 Re-sampling
- 过采样 Oversampling:重复抽取尾部类样本,增加尾部数据量;缺点:尾部容易过拟合。
- 欠采样 Undersampling:减少头部类样本数量,平衡类别;缺点:丢失头部信息。
- 自适应重采样(Class-balanced sampling):按类别有效样本数采样,最常用,很多长尾 baseline 标配。
2. 数据增强 Data Augmentation
- 基础增强:随机裁剪、翻转、色彩抖动
- 针对长尾的强增强:Mixup、CutMix、AugMix、SMOTE(传统机器学习)
- 尾部专属增强:Tail augmentation,专门对少样本类别做更多增强;
- 生成式增强:GAN、Diffusion 生成尾部类样本,弥补数据稀缺,代价高。
二、损失函数层面(Loss-level,最常用)
1. 类别权重加权
- Class-balanced Loss(CB Loss):引入有效样本数计算每类权重,样本越少权重越高。
- Balanced Softmax :修正 softmax,把类别样本量放进 logit,解决长尾下分类器偏向头部,现在非常热门。
- Focal Loss:降低简单头部样本权重,聚焦难例(尾部 + 困难样本);原始 Focal 不直接针对长尾,常和 CB 结合。
Class-Balanced Loss Based on Effective Number of Samples(CVPR2019,CB Loss)
arXiv:https://arxiv.org/pdf/1901.05555.pdf
Balanced Softmax for Long-Tailed Visual Recognition(NeurIPS2021,Balanced Softmax)
arXiv:https://arxiv.org/pdf/2007.10740.pdf
Focal Loss for Dense Object Detection(ICCV2017,Focal Loss,长尾常用 baseline)
2. Logit 调整(Logit Adjustment)
核心:在分类得分 logit 上直接加类别先验偏移,抵消数据分布偏置
- Logit Adjustment(LA):\(z_i' = z_i + \tau \log n_i\),\(n_i\)为类别样本数;简单高效,消融实验高频使用。
- Tau-Normalized:归一化分类权重,减少头部类别权重范数偏大问题。
Long-tail Learning via Logit Adjustment(ICLR2021,LA Logit 调整)
3. 其他改进损失
- LDAM Loss:在 logit 调整基础上,加上边际 margin,拉大尾部类别间隔,经典长尾 baseline。
- RRT Loss、DRO(Distributionally Robust Optimization):鲁棒优化,约束最差类别性能。
三、特征 / 分类器层面(Representation & Classifier)
1. 两阶段训练(Two-stage)
长尾领域经典范式:
- Stage1:普通训练,用原始长尾数据学习通用特征(冻结主干)
- Stage2:重平衡微调,只微调分类头,使用 balanced sampler /balanced softmax / LA
代表论文:Balanced Softmax、Logit Adjustment,大量实验证明两阶段效果优于单阶段。
2. 解耦学习 Decoupled Learning
把特征提取器(backbone) 和分类器(classifier) 分开优化:
- Stage1:特征学习阶段 :用原始长尾数据 + instance-balanced 采样(按样本实例采样)+ 普通交叉熵,训练主干网络,不做重平衡。目标:学习通用视觉特征;过早重平衡会破坏全局特征提取能力。
- Stage2:分类器重校准阶段 :冻结 Backbone 主干,只重新训练分类头,使用 class-balanced 采样(按类别采样,每个类别被采样概率均等),即 cRT(classifier re-training)。
论文核心结论:特征学习和分类器学习目标不一样,不能一起联合重平衡。普通联合训练会让分类器权重范数随类别样本数变大(头部分类器权重 L2 范数更大),产生固有偏置。
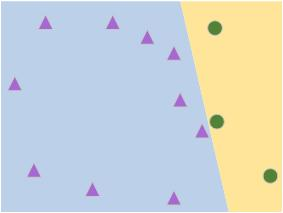 (a) 普通 CE 联合训练
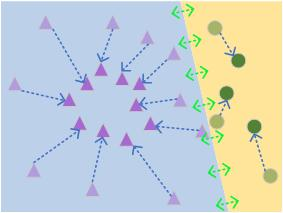 (b) 解耦学习
- (a) 普通 CE 联合训练:紫色三角 = 头部,绿色圆 = 尾部;尾部特征少,决策边界被头部挤压,尾部容易被错分。
- (b) 解耦学习:主干学到好的特征,固定特征后单独调整分类器,重新划分决策边界,保护尾部类别。
论文:Kang B, et al. Decoupling Representation and Classifier for Long-Tailed Recognition, ICLR, 2020
arXiv:https://arxiv.org/pdf/1910.09217v2
这篇论文奠定了两阶段解耦的主流框架,几乎所有长尾 baseline 都基于这个思路。
3. 分类器归一化
- Normed-Classifier:对分类权重做 L2 归一化,消除头部类别权重 norm 更大的偏差。
四、迁移学习 / 预训练 + 少样本范式
适合尾部样本极少(极端长尾)
- 大模型预训练(ImageNet 预训练 / CLIP 等对比学习预训练),主干学到通用特征,尾部只微调分类头
- 元学习(Meta-learning):MAML 等,用少量尾部样本快速适配
- 对比学习:MoCo、SimCLR 先自监督预训练,不需要标签,对长尾友好,提升特征质量。
五、专家 / 分支模型(Mixture of Experts,MoE 类)
- Dynamic MoE / Multi-expert:多个专家分支,不同专家分别负责头部、中部、尾部类别。 例:Long-tailed Mixture of Experts,将类别分组,不同专家学习不同分组,避免头部压制尾部。
- 分支划分:Head expert / Tail expert,最后融合预测。
- 缺点:参数量大、训练成本高。
RIDE: Long-tailed Recognition by Routing Diverse Distribution-Aware Experts(ICLR2021,多专家 MoE)
六、知识蒸馏 Knowledge Distillation
- 用在均衡数据集训练的教师模型,蒸馏知识给长尾学生模型;
- 或者用强头部样本学到的特征,蒸馏辅助尾部类别学习;
- 代表:Balanced KD,跨类别蒸馏。
七、其他小众方向
- 因果推断:消除 "样本数量带来的伪相关",去混杂(Causal Inference for Long-tail)
- 标签感知正则化、迁移原型学习:为尾部类别构造原型特征
- 半监督长尾:利用无标签数据补充尾部类别(Semi-supervised long-tailed)
常用 Baseline 推荐(做实验优先试)
- 基础:Class-balanced Sampling + Focal Loss
- 性价比首选:两阶段 + Logit Adjustment
- SOTA 常用:两阶段 + Balanced Softmax
- 强基线:LDAM-DRW(LDAM loss + 动态重权重 DRW)
论文常用对比可视化
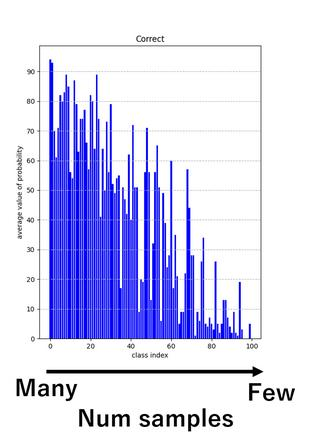 普通 CE 训练各类精度
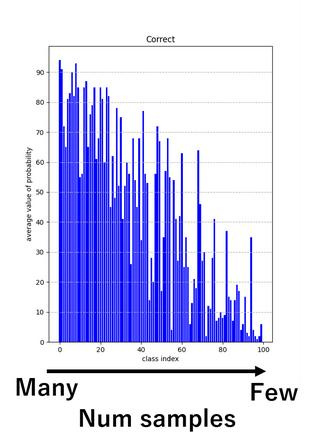 长尾方法各类精度
- 左图:普通 CE 训练,类别按样本数从多到少排序;头部类别精度很高,尾部精度断崖下跌。
- 右图:长尾方法(如 LA/BalancedSoftmax),头部精度轻微下降,但尾部类别精度显著提升,各类别精度更加均衡。
综述论文(Deep Long-Tailed Learning: A Survey,TPAMI2023,自动化学报中文综述配套参考)