0. 一个容易被忽视的 RAG 检索问题
做 RAG 时,我们很容易形成一种直觉:
只要知识库中存在正确答案,并且向量检索成功召回了对应 Chunk,后面的事情似乎就简单了。
但实际上,检索到正确知识,不代表它一定会进入最终提供给 LLM 的上下文。
举个例子。
用户询问:
「EVM-RK3588 开发板如何开启 SSH 服务?」
知识库中存在多篇相关文档,包括 RK3588、RK3568 等型号的说明,以及 SSH 安装、连接、服务配置等内容。
初始检索时,包含正确操作步骤的 Chunk 已经被召回。
但经过后续融合、排序和 Top-K 筛选,最终留下的可能是几段高度相关、却不能直接回答问题的内容。
于是,我们需要追问:
正确知识究竟在哪一步被淘汰了?
这篇文章不讨论 LLM 已经看到正确证据却仍然回答错误的情况,而是聚焦于检索阶段,研究正确证据为什么没能进入最终 Top-K。
以下以常见的 Dense + BM25 + RRF + Rerank 混合检索架构为例展开分析,并不代表每个 RAG 项目都包含这些模块。
1. 为什么不能只依赖向量相似度?
向量检索的优势在于语义匹配。
例如:
「怎样远程登录开发板?」
和
「开发板 SSH 连接配置方法」
虽然字面表达不同,但语义接近,Embedding 模型有机会把它们映射到相近的向量空间。
但企业知识库中经常会出现另一类内容:
设备型号、接口名称、错误码、产品编号以及其他专有名词。
比如:
-
EVM-RK3588
-
RK3588
-
RK3568
这些名称可能拥有非常接近的上下文语义,但它们并不是同一个型号。
Embedding 能够帮助我们找到语义相近的内容,却不保证严格区分所有字符级差异。
这时候,就需要引入关键词检索。
BM25 补充的是词法匹配能力
BM25 是经典的文本相关性评分算法,它会综合词频、逆文档频率和文档长度等因素进行排序。
对于设备型号、专有名词等场景,BM25 可以与 Dense Retrieval 形成互补。
但这里还要区分三个概念:
自定义词典负责改善分词效果,让完整型号尽可能被正确识别。
BM25负责根据匹配到的词项计算相关性分数。
关键词 Boost则是在具体检索实现中,对型号字段或精确匹配结果施加额外权重。
它们可以配合使用,但不是同一回事。
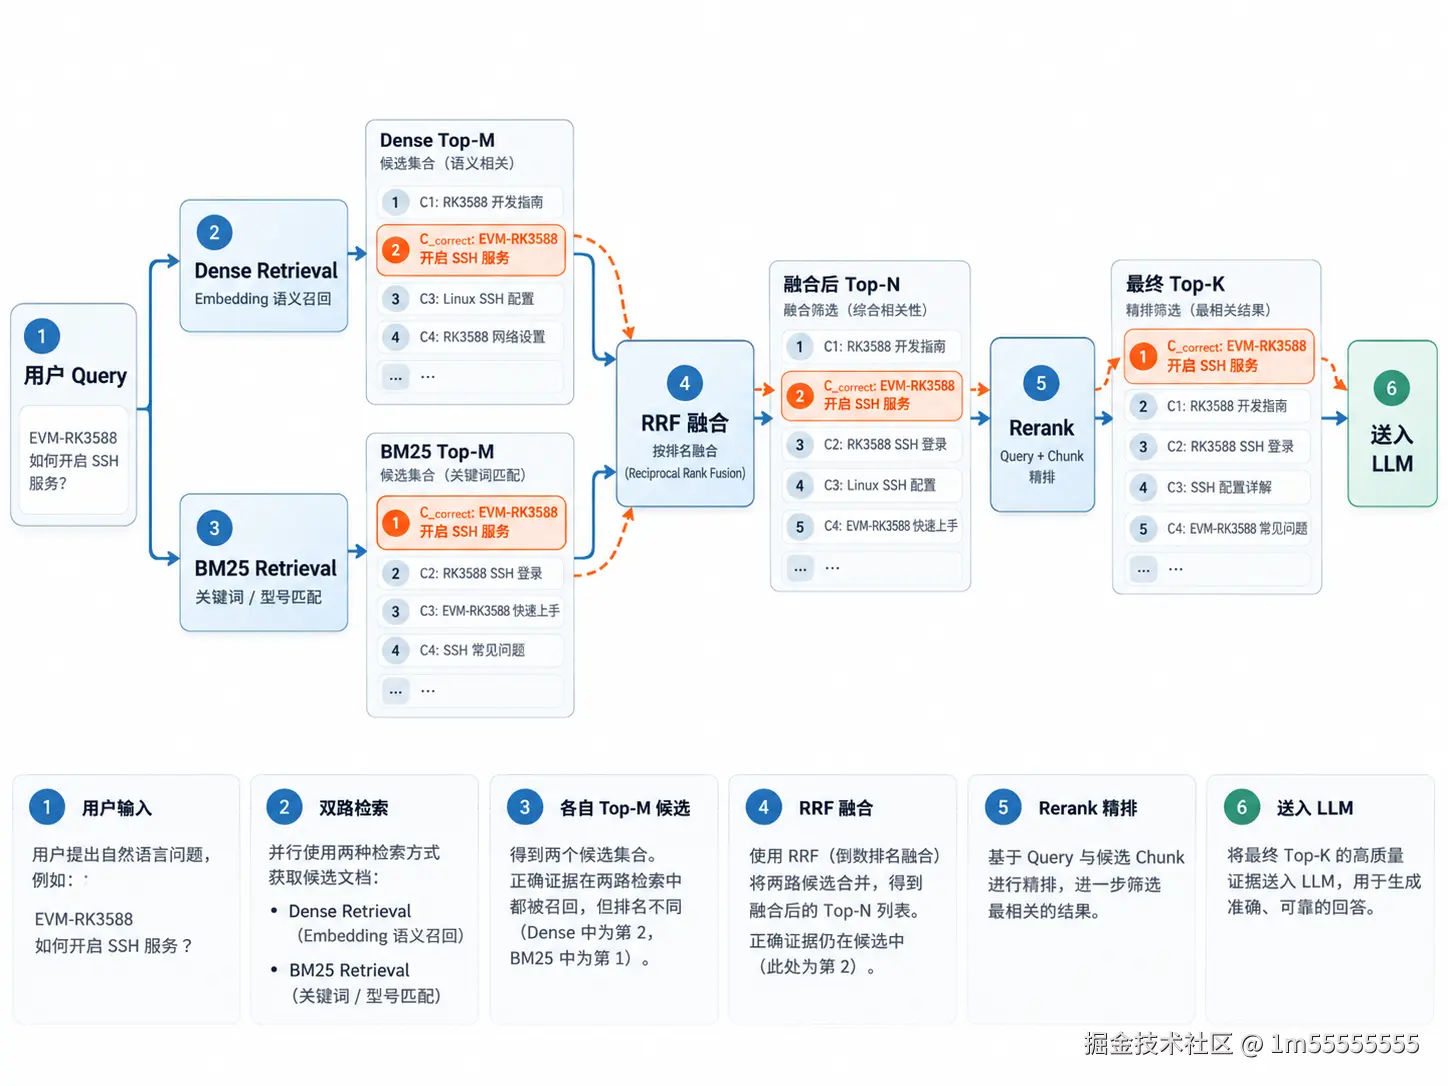
因此,一种常见方案就是:
Dense 负责语义召回,BM25 负责词法召回,然后将两路候选进行融合。
2. RRF 融合:两路都找到了,为什么还可能漏?
Dense 和 BM25 返回的分数并不在同一个尺度上。
直接将向量相似度和 BM25 分数相加,通常缺乏合理依据。
因此,RRF(Reciprocal Rank Fusion)成为一种常见的排名融合方案。
其核心公式为:
bash
RRF(d) = Σ [1 / (k + rank_r(d))]其中,rank 表示候选在某一路检索中的排名,k 是平滑常数,常见示例取 60。
RRF 不直接比较原始相似度,而是根据不同检索列表中的排名,为同一候选累加分数。
一个候选如果在多路检索中都排名靠前,通常会获得更大的融合优势。
这看起来非常合理。
但 RRF 衡量的是跨检索路径的排名共识,并不是对业务事实正确性的验证。
假设某条包含准确型号配置的 Chunk,在 BM25 中排名很靠前,但 Dense 没有召回它。
另一条泛化的 SSH 使用说明,同时在 Dense 和 BM25 中获得较高排名。
融合之后,后者就有可能排在正确证据前面。
这并不意味着 RRF 算错了。
而是我们必须认识到:
两路检索都认为某段内容相关,不代表它就是最能回答用户问题的证据。
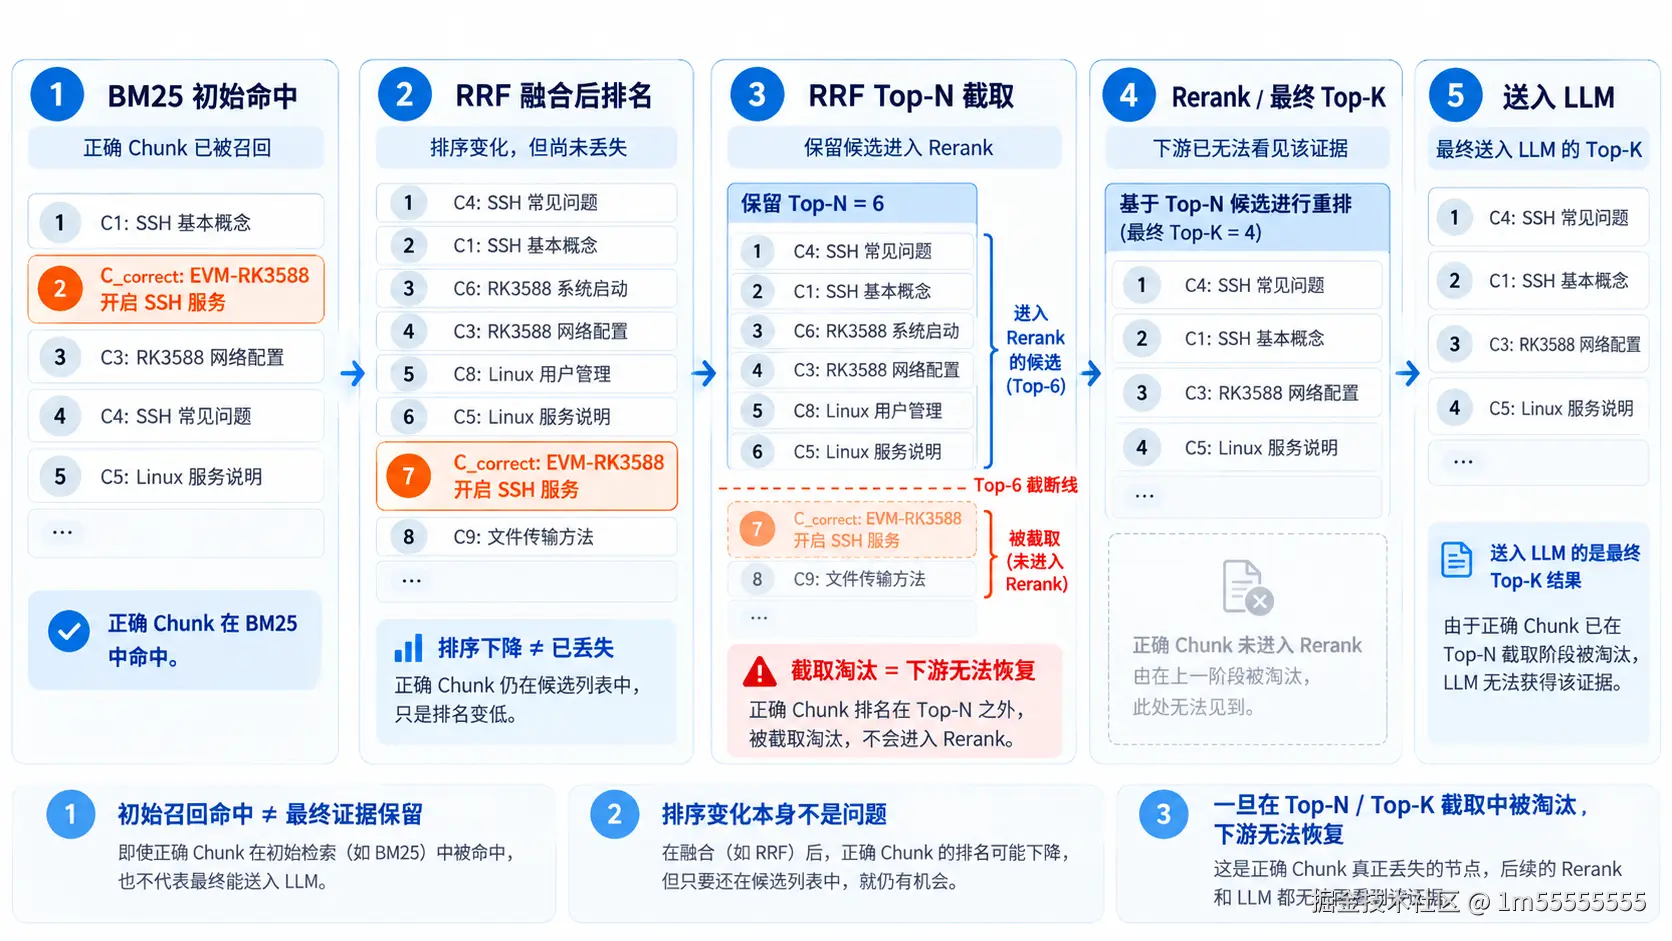
不过,仅仅排名下降还不等于证据丢失。
真正关键的是下一步:
RRF 融合完成后,系统通常只保留前 N 个候选。
如果正确 Chunk 排在第 N+1 名,那么它就没有机会进入后续 Rerank。
这才是第一个需要重点关注的候选淘汰节点。
3. Rerank:为什么精排也不一定能救回来?
为了进一步提高检索质量,很多系统会在融合召回之后增加 Rerank。
典型流程是:
bash
Dense Top-M       BM25 Top-M
      \             /
       \           /
          RRF
           ↓
       候选 Top-N
           ↓
    Rerank(Query, Chunks)
           ↓
       最终 Top-K
           ↓
           LLM
与初始向量召回不同,Reranker 通常会结合用户 Query 和候选 Chunk 的具体文本,重新评估两者的相关性。
它有机会纠正前面排序不合理的问题。
但有两个限制。
3.1 Rerank 无法处理没有传给它的 Chunk
假设正确 Chunk 在 RRF 融合后排名第 12,但系统只保留 Top-10 进入 Rerank。
那么,无论 Reranker 多强,都不可能把它重新排回来。
因为它从未见过这条证据。
这也说明:
Rerank 的效果不仅取决于模型本身,还取决于前一阶段提供的候选集合。
3.2 Rerank 的相关性评分也可能出错
即使正确 Chunk 进入了 Rerank,也不代表它一定排名第一。
例如用户询问 RK3588 的具体配置,但候选中同时出现了大量 RK3568 的相似操作说明。
Reranker 是否能够正确识别型号差异,需要结合实际模型与测试数据验证。
如果它将正确 Chunk 排到最终 Top-K 之外,正确证据依旧无法进入 LLM。
因此,我认为需要区分两件事:
-
排序变化: 正确证据的名次下降,但仍留在候选集合中。
-
候选淘汰: 排序后执行 Top-N 或 Top-K 截取,正确证据被真正排除。
前者不一定造成最终问题,后者才会让下游失去使用这条证据的机会。
4. 真正排查时,应该看哪些数据?
当最终 Top-K 缺少正确证据时,我认为不应该第一时间去修改 RRF 参数或更换 Rerank 模型。
应该先定位正确证据第一次消失的位置。
我们可以为同一次 Query 记录各阶段的 Chunk ID 和排名。
例如下面这组构造数据:
| 检索阶段 | 正确 Chunk C 的情况 |
|---|---|
| Dense 召回 | 未命中 |
| BM25 召回 | 第 2 名 |
| RRF 融合 | 第 7 名 |
| RRF Top-N | N=10,成功保留 |
| Rerank | 第 6 名 |
| 最终 Top-K | K=5,被淘汰 |
以上仅为说明排查方法的假设案例,并非真实项目日志。
通过这条记录,可以得到几个明确结论:
首先,Dense 没有召回正确 Chunk,但 BM25 弥补了这一不足。
其次,RRF 虽然改变了它的排名,但并没有直接导致最终丢失。
最后,正确证据进入了精排候选集合,却在 Rerank 后的 Top-K 筛选中被淘汰。
这样,我们至少知道应该从哪里开始分析,而不是笼统地说"RAG 检索效果不好"。
不要只记录最终 Top-K
如果只记录最终返回给 LLM 的五个 Chunk,实际上很难判断是哪一步出现了问题。
我更建议记录:
-
Dense / BM25 各自的候选 ID 与原始排名。
-
RRF 融合后的候选排名。
-
进入 Rerank 的 Top-N 集合。
-
Rerank 后的排名及最终 Top-K。
-
每一步的执行耗时。
这些记录最好使用稳定的 Chunk ID 关联,避免仅凭文本或局部排名判断是否属于同一条证据。
对于已经人工标注正确证据的测试问题,还可以统计不同阶段的证据保留情况。
例如:
正确证据保留率(S)
= 最终 Top-K 保留正确证据的问题数
÷ 初始候选集合包含正确证据的问题数 × 100%
这里的 S 是为了分析检索链路而定义的条件保留率,不是一个必须采用的行业标准指标。
它能够帮助我们区分:
到底是最初没有召回正确知识,还是召回成功后又被淘汰?
5. Top-N 和 Top-K 应该怎么选择?
这可能是实际工程中最需要权衡的问题。
RRF 后保留的 Top-N 太小,意味着较多候选可能提前被淘汰,Reranker 的纠错空间有限。
但 Top-N 过大,又会增加精排计算量和请求延迟。
同样,最终 Top-K 太小,可能遗漏必要证据;太大,则可能引入更多噪声和 Token 成本。
因此,不能简单认为把 Top-N、Top-K 全部调大就能解决问题。
我认为更合理的方法是设计一组对照实验。
例如固定知识库和测试问题,对比:
| 方案 | 检索链路 |
|---|---|
| A | Dense → Top-K |
| B | BM25 → Top-K |
| C | Dense + BM25 → RRF → Top-K |
| D | Dense + BM25 → RRF Top-N → Rerank Top-K |
测试问题可以覆盖三类场景:
普通语义问题: 用户表达与文档原文存在较大差异。
精确关键词问题: 包含设备型号、错误码、接口名称等信息。
多证据问题: 需要多个 Chunk 共同提供完整答案。
重点观察三个指标:
-
正确证据是否进入最终 Top-K。
-
正确证据在哪一阶段第一次被淘汰。
-
不同方案带来的检索耗时与精排开销。
另外,还可以固定最终 K,调整 RRF 输出的 N,观察更多候选是否真的提高了最终证据覆盖率。
目录
[0. 一个容易被忽视的 RAG 检索问题](#0. 一个容易被忽视的 RAG 检索问题 "#0.%20%E4%B8%80%E4%B8%AA%E5%AE%B9%E6%98%93%E8%A2%AB%E5%BF%BD%E8%A7%86%E7%9A%84%20RAG%20%E6%A3%80%E7%B4%A2%E9%97%AE%E9%A2%98")
[1. 为什么不能只依赖向量相似度?](#1. 为什么不能只依赖向量相似度? "#1.%20%E4%B8%BA%E4%BB%80%E4%B9%88%E4%B8%8D%E8%83%BD%E5%8F%AA%E4%BE%9D%E8%B5%96%E5%90%91%E9%87%8F%E7%9B%B8%E4%BC%BC%E5%BA%A6%EF%BC%9F")
[BM25 补充的是词法匹配能力](#BM25 补充的是词法匹配能力 "#BM25%20%E8%A1%A5%E5%85%85%E7%9A%84%E6%98%AF%E8%AF%8D%E6%B3%95%E5%8C%B9%E9%85%8D%E8%83%BD%E5%8A%9B")
[2. RRF 融合:两路都找到了,为什么还可能漏?](#2. RRF 融合:两路都找到了,为什么还可能漏? "#2.%20RRF%20%E8%9E%8D%E5%90%88%EF%BC%9A%E4%B8%A4%E8%B7%AF%E9%83%BD%E6%89%BE%E5%88%B0%E4%BA%86%EF%BC%8C%E4%B8%BA%E4%BB%80%E4%B9%88%E8%BF%98%E5%8F%AF%E8%83%BD%E6%BC%8F%EF%BC%9F")
[3. Rerank:为什么精排也不一定能救回来?](#3. Rerank:为什么精排也不一定能救回来? "#3.%20Rerank%EF%BC%9A%E4%B8%BA%E4%BB%80%E4%B9%88%E7%B2%BE%E6%8E%92%E4%B9%9F%E4%B8%8D%E4%B8%80%E5%AE%9A%E8%83%BD%E6%95%91%E5%9B%9E%E6%9D%A5%EF%BC%9F")
[3.1 Rerank 无法处理没有传给它的 Chunk](#3.1 Rerank 无法处理没有传给它的 Chunk "#3.1%20Rerank%20%E6%97%A0%E6%B3%95%E5%A4%84%E7%90%86%E6%B2%A1%E6%9C%89%E4%BC%A0%E7%BB%99%E5%AE%83%E7%9A%84%20Chunk")
[3.2 Rerank 的相关性评分也可能出错](#3.2 Rerank 的相关性评分也可能出错 "#3.2%20Rerank%20%E7%9A%84%E7%9B%B8%E5%85%B3%E6%80%A7%E8%AF%84%E5%88%86%E4%B9%9F%E5%8F%AF%E8%83%BD%E5%87%BA%E9%94%99")
[4. 真正排查时,应该看哪些数据?](#4. 真正排查时,应该看哪些数据? "#4.%20%E7%9C%9F%E6%AD%A3%E6%8E%92%E6%9F%A5%E6%97%B6%EF%BC%8C%E5%BA%94%E8%AF%A5%E7%9C%8B%E5%93%AA%E4%BA%9B%E6%95%B0%E6%8D%AE%EF%BC%9F")
[不要只记录最终 Top-K](#不要只记录最终 Top-K "#%E4%B8%8D%E8%A6%81%E5%8F%AA%E8%AE%B0%E5%BD%95%E6%9C%80%E7%BB%88%20Top-K")
[5. Top-N 和 Top-K 应该怎么选择?](#5. Top-N 和 Top-K 应该怎么选择? "#5.%20Top-N%20%E5%92%8C%20Top-K%20%E5%BA%94%E8%AF%A5%E6%80%8E%E4%B9%88%E9%80%89%E6%8B%A9%EF%BC%9F")
[6. 我的工程取舍](#6. 我的工程取舍 "#6.%20%E6%88%91%E7%9A%84%E5%B7%A5%E7%A8%8B%E5%8F%96%E8%88%8D")
这里需要强调:Rerank 不一定在所有数据集上都优于 RRF,BM25 也不一定在所有型号查询中都能正确召回。
真正的效果应该通过具体知识库和测试问题验证。
6. 我的工程取舍
经过这轮分析,我更倾向于按照问题发生的阶段进行优化,而不是盲目叠加检索算法。
如果 初始候选就缺少正确证据,应该优先检查语义召回、BM25 分词、精确型号匹配以及各路召回数量。
如果 正确证据在 RRF Top-N 时被淘汰,应该分析融合排名和候选规模,而不是直接责怪 Reranker。
如果 正确证据进入精排却没进入最终 Top-K,才重点评估 Rerank 模型、输入内容和最终 K 的选择。
另外,对于设备型号、版本号等明确约束,我更倾向于在适当场景下结合结构化字段或精确匹配过滤,而不是把一切都交给向量相似度或 Rerank 模型判断。
归根结底:
每个检索环节解决的问题不同,优化之前必须先找到真正的瓶颈。
最后
RAG 的检索质量,不应该只看某一路是否召回了正确 Chunk,也不应该单纯相信"多加一个 Rerank 就会更准确"。
从 Dense、BM25 到 RRF,再到 Rerank,整条链路实际上在不断调整候选的排名,并逐步缩小候选范围。
真正需要关注的是:
能回答用户问题的正确证据,是否最终进入了提供给 LLM 的 Top-K。
对我来说,这也是多阶段检索最值得关注的工程细节:
召回决定系统有没有机会找到答案,而后续融合、精排与候选截取,决定这份证据能不能最终被使用。
至于正确证据已经完整进入 Prompt,但大模型仍然回答错误,那又是另一个值得单独讨论的问题了。
参考资料