使用JDK21新特性虚拟线程时遇到的坑
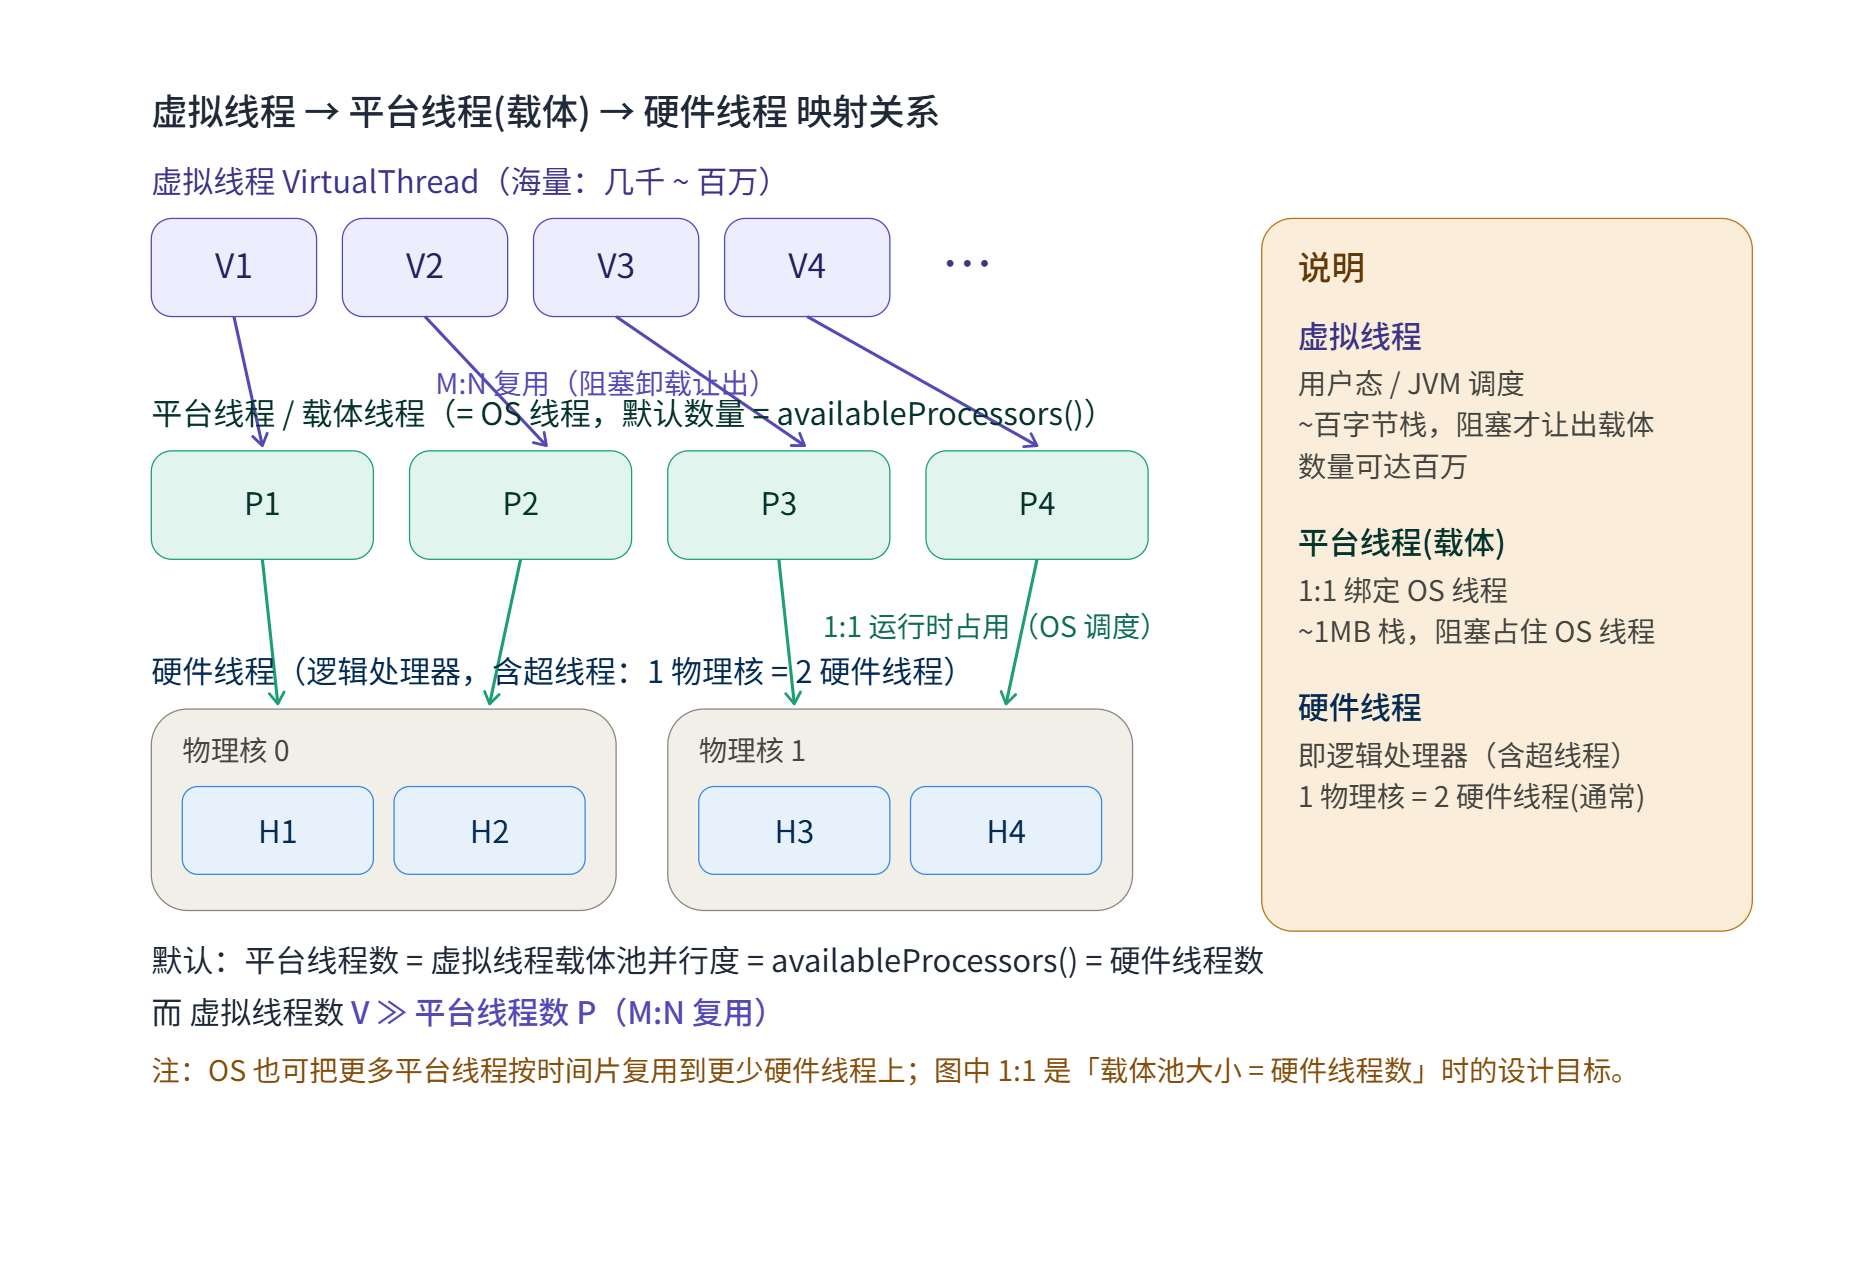
JDK虚拟线程、平台线程、硬件线程之间的关系:
现象说明
- 入口现象:Feign 远程调用永久阻塞,不触发任何超时异常,且被调用方无日志。
- 影响范围:该服务的所有远程调用均陷入阻塞。
- 运行环境:JDK 21.0.11 / Spring Boot 4 / Spring Cloud 2025.1 / Caffeine 3.2.x
- 初步结论 :其余服务均运行正常。根因在于虚拟线程 的执行依赖平台线程 作为载体,虚拟线程 在synchronized 代码块中执行了IO操作以及远程调用,而远程调用使用了虚拟线程 ,远程调用执行时虚拟线程 又请求不到载体线程(被耗尽),导致永久等待。
0. 摘要
SnapshotService.load() 使用 cache.get(serviceId, loader::load)。Caffeine 为保证「同 key 并发只加载一次」,
将该 loader 放在 ConcurrentHashMap.compute 的 synchronized 块内执行,而该 loader 内部调用 Feign 阻塞等待 HTTP 响应。
JDK 21 下「虚拟线程在 synchronized 内阻塞」会触发 pin :VM 拒绝卸载该虚拟线程,载体线程被一并阻塞且无法回收。
启动预热并发加载 29 个服务,载体线程仅 20 个(= availableProcessors()),20 个载体被瞬间 pin 满,此后:
- HttpClient 的 exchange 虚拟线程无法被调度 → 请求根本没有发出网卡
HttpRequest.timeout(readTimeout=10s)由同一套无法运行的 exchange 机制计时 → 超时永不触发
结果:不到 1 秒全局锁死,之后状态恒定。
1. 现象与初筛证据
| 检查项 | 结果 | 推论 |
|---|---|---|
直连 dms POST /wayBill/getList(curl + 内部 token) |
200,0.13s |
dms 健康,排除下游 |
fms GET /pricing/loadWayBillInfo(同一业务路径) |
2 次均 120s 超时(HTTP=000,零字节) |
100% 复现,问题在 fms 进程内 |
jstack |
30 个 http-nio-8087-exec-* 阻塞于 GenesisJdkHttpClient.execute:109 → HttpClientImpl.send:934 → CompletableFuture.get |
阻塞在等待 HTTP 响应 |
netstat -ano(按 fms PID 过滤) |
无任何到 18082 的 TCP 连接 | 请求未出网卡 |
HttpClient-1-SelectorManager |
空转于 WEPoll.wait,无 exchange 注册 |
连接池未被使用 |
ForkJoinPool-1 |
20 个 worker,20 个均 Carrying virtual thread,0 空闲 |
虚拟线程调度器已耗尽 |
| 虚拟线程总数 | 492,其中 211 个从未启动(无栈) | 无载体可用,任务积压在队列 |
nproc |
20 | 载体数 = availableProcessors() |
排查口诀:下游直连健康 + 本机无出站连接 + 超时不触发 ⇒ 停止排查下游,转向本进程的线程/载体状态。
2. 术语与机制前提
后面会反复用到这几个概念,先给准确定义。
2.1 虚拟线程 / 载体线程 / 调度器
| 概念 | 定义 |
|---|---|
| 虚拟线程(VirtualThread) | JDK 21 的轻量线程。数量无上限,每个任务一个;本身不绑定 OS 线程 |
载体线程 (carrier / CarrierThread) |
真正承载执行的平台线程,jdk.internal.misc.CarrierThread extends ForkJoinWorkerThread extends Thread。数量 = availableProcessors() |
| 调度器 | JDK 内部一个进程级共享 的 ForkJoinPool,parallelism = availableProcessors(),maxPoolSize = max(parallelism, 256)。线程名 ForkJoinPool-1-worker-N |
注意 :业务代码里的 Executors.newVirtualThreadPerTaskExecutor() 与 common-feign 中 GenesisJdkHttpClient
使用的执行器,共用同一个默认调度器。
2.2 挂载 / 卸载(mount / unmount)
虚拟线程的栈存放在堆上的 StackChunk(continuation 栈)中,不在载体线程栈上。
挂载 (thaw)  :Continuation.thaw() 把 StackChunk 中的栈帧搬到载体线程栈上 → 开始执行
卸载 (freeze):虚拟线程阻塞时 Continuation.freeze() 把栈帧搬回 StackChunk
                → 载体线程返回 ForkJoinPool.runWorker() 的任务循环,可服务下一个虚拟线程
关键点:载体线程的释放发生在「虚拟线程阻塞」时,而不是「执行完成」时。
这就是 20 个载体能支撑数十万虚拟线程的原因 ------ 载体是按时段借出的,虚拟线程每次阻塞就归还一次。
2.3 pin(钉住)
pin(钉住) :虚拟线程阻塞时,VM 拒绝执行 unmount(
Continuation.yield()返回false)。结果是虚拟线程的栈帧仍留在载体线程栈上,载体线程被一并阻塞、无法回到任务循环,因此无法被调度器回收。
一句话:载体线程本来可以在虚拟线程阻塞时被释放,pin 之后释放不了。
JDK 21 的 pin 触发条件:
- 虚拟线程处于
synchronized块/方法内(本次就是这个) - 虚拟线程阻塞在 monitor entry (等待进入
synchronized) - 栈上存在 native 帧 / JNI 调用
Object.wait()
为什么 synchronized 会导致 pin :JDK 21 的 synchronized 编译为 monitorenter/monitorexit,
操作 ObjectMonitor,其 owner 字段指向具体的 OS 线程。若允许卸载,则:
- 锁的 owner 变成一条未运行的线程
- 虚拟线程重新挂载时可能落在另一条 载体线程上,此时执行
monitorexit,owner 不匹配
ObjectMonitor 不支持 owner 在载体线程间迁移(还需处理 entry list / wait set 上排队的线程),
因此 VM 只能选择「持有 monitor 期间不卸载」。这是 JDK 21 的实现限制,JDK 24 的 JEP 491 已重构。
pin 之后的 fallback:
java
// java.lang.VirtualThread#park
boolean yielded = yieldContinuation();   // 返回 false 表示卸载失败
if (!yielded) {
    parkOnCarrierThread(timed, nanos);   // 内部为 Unsafe.park ------ 挂起的是载体线程本身
}
判定方法 :栈中出现 VirtualThread.parkOnCarrierThread 即 pin(普通 park 只有 VirtualThread.park)。
⚠️ 该判据只能识别「Java 层 park 型」的 pin 。阻塞在 monitor entry 的虚拟线程栈顶直接是
synchronized所在行,没有 park 帧,无法用这个方法识别 ------ 现场 20 个被 pin 的虚拟线程里,只有 10 个能这样认出,另外 10 个需要靠「载体全占 + 线程数对不上」反推。
2.4 载体线程被 pin 后的状态
- 未返回
ForkJoinPool.runWorker()任务循环 → 池视角为 busy,非 idle,不可回收 WorkQueue顶部仍是该虚拟线程,无法重新分配- 不可逆 :即使 park 被唤醒,载体线程也只能继续执行同一个 虚拟线程(
monitorexit必须由 owner 执行),
无法转交。因此 pin 的持续范围 = 该虚拟线程走出synchronized块为止
2.5 为什么 readTimeout 不生效
HttpRequest.timeout 由 HttpClient 的 exchange 机制在 SelectorManager 中注册定时器实现。
exchange 本身也是提交到虚拟线程执行器的任务 ------ 载体被 pin 满后 exchange 从未启动,定时器从未注册。
所以现象是「永久阻塞」,而非「10s 后 HttpTimeoutException」。
看到「超时不生效」,应立刻怀疑线程/载体层面,而不是超时配置。
3. 完整因果链
3.1 调用链(8 张源码截图,按调用顺序)
① 并发源:预热一次性提交 N 个虚拟线程
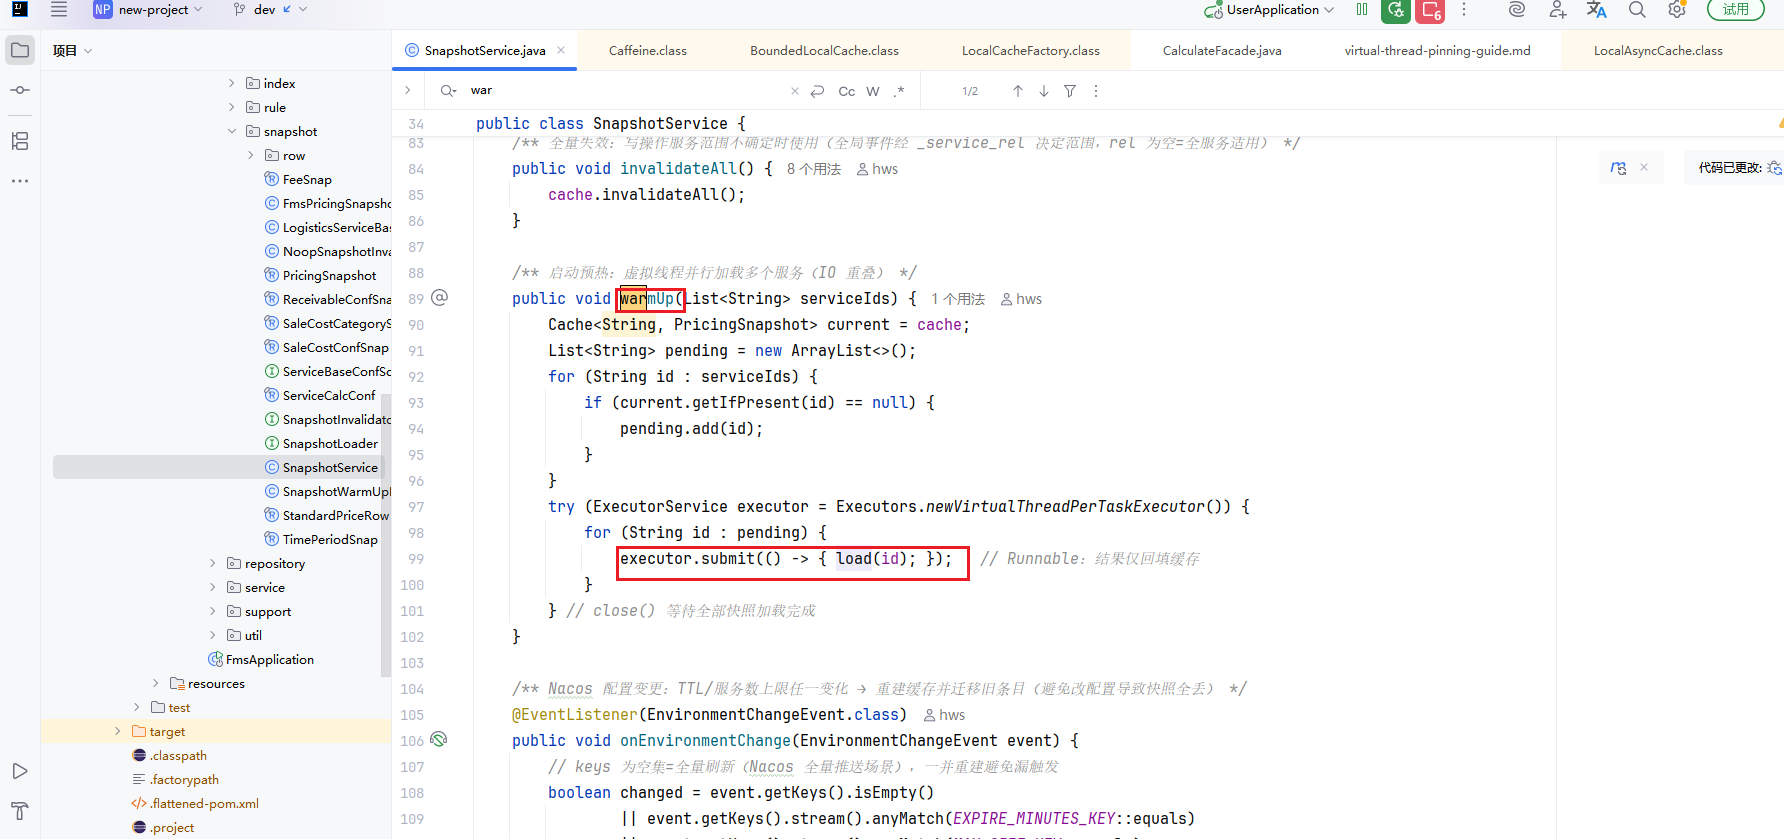
java
try (ExecutorService executor = Executors.newVirtualThreadPerTaskExecutor()) {
    for (String id : pending) {
        executor.submit(() -> { load(id); });   // 每服务一个虚拟线程,无分批
    }
}
② 将 loader 交给 Caffeine ------ 锁的入口
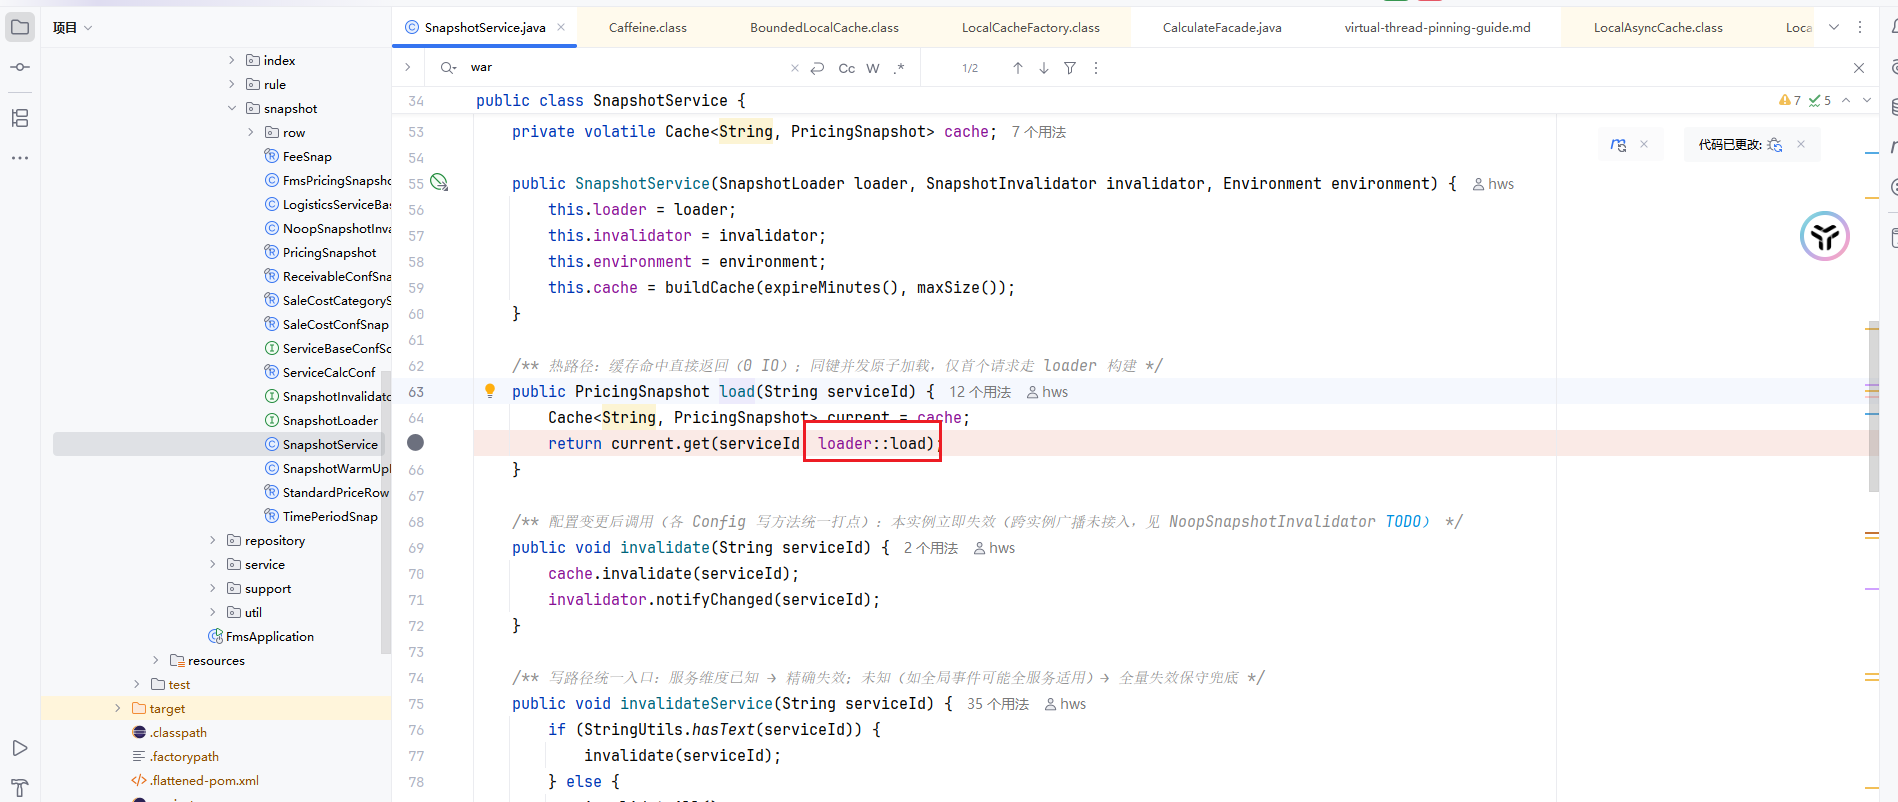
java
public PricingSnapshot load(String serviceId) {
    Cache<String, PricingSnapshot> current = cache;
    return current.get(serviceId, loader::load);   // ← 根因位置
}
③ loader 内为阻塞远程调用
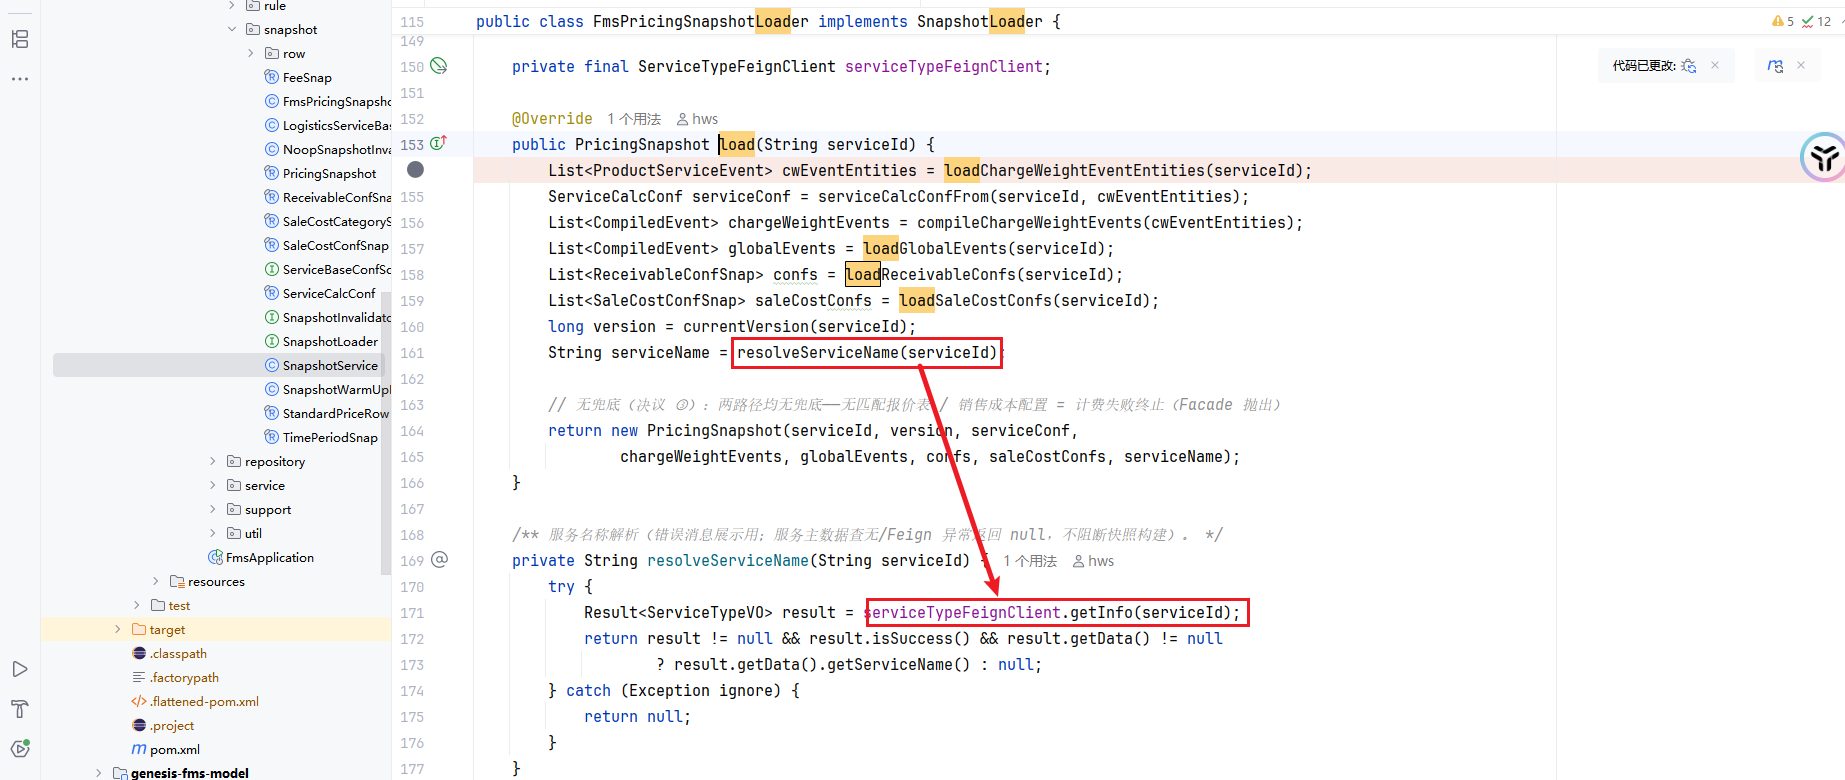
FmsPricingSnapshotLoader 内部通过 serviceTypeFeignClient 发起远程调用。
图中高亮的是 resolveServiceName:171 处的 getInfo;本次事故栈里走的是同一类的另一处 :
load:155 → serviceCalcConfFrom:211 → LogisticsServiceBaseConfSource.load:32 → 同样落到
serviceTypeFeignClient.getInfo。两个调用点是同一个 Feign 方法,结论一致。
代码本身正确 ------ 它就是要远程取服务配置。问题在执行位置。
④ 放大器:Feign 的 HttpClient 同样使用虚拟线程执行器
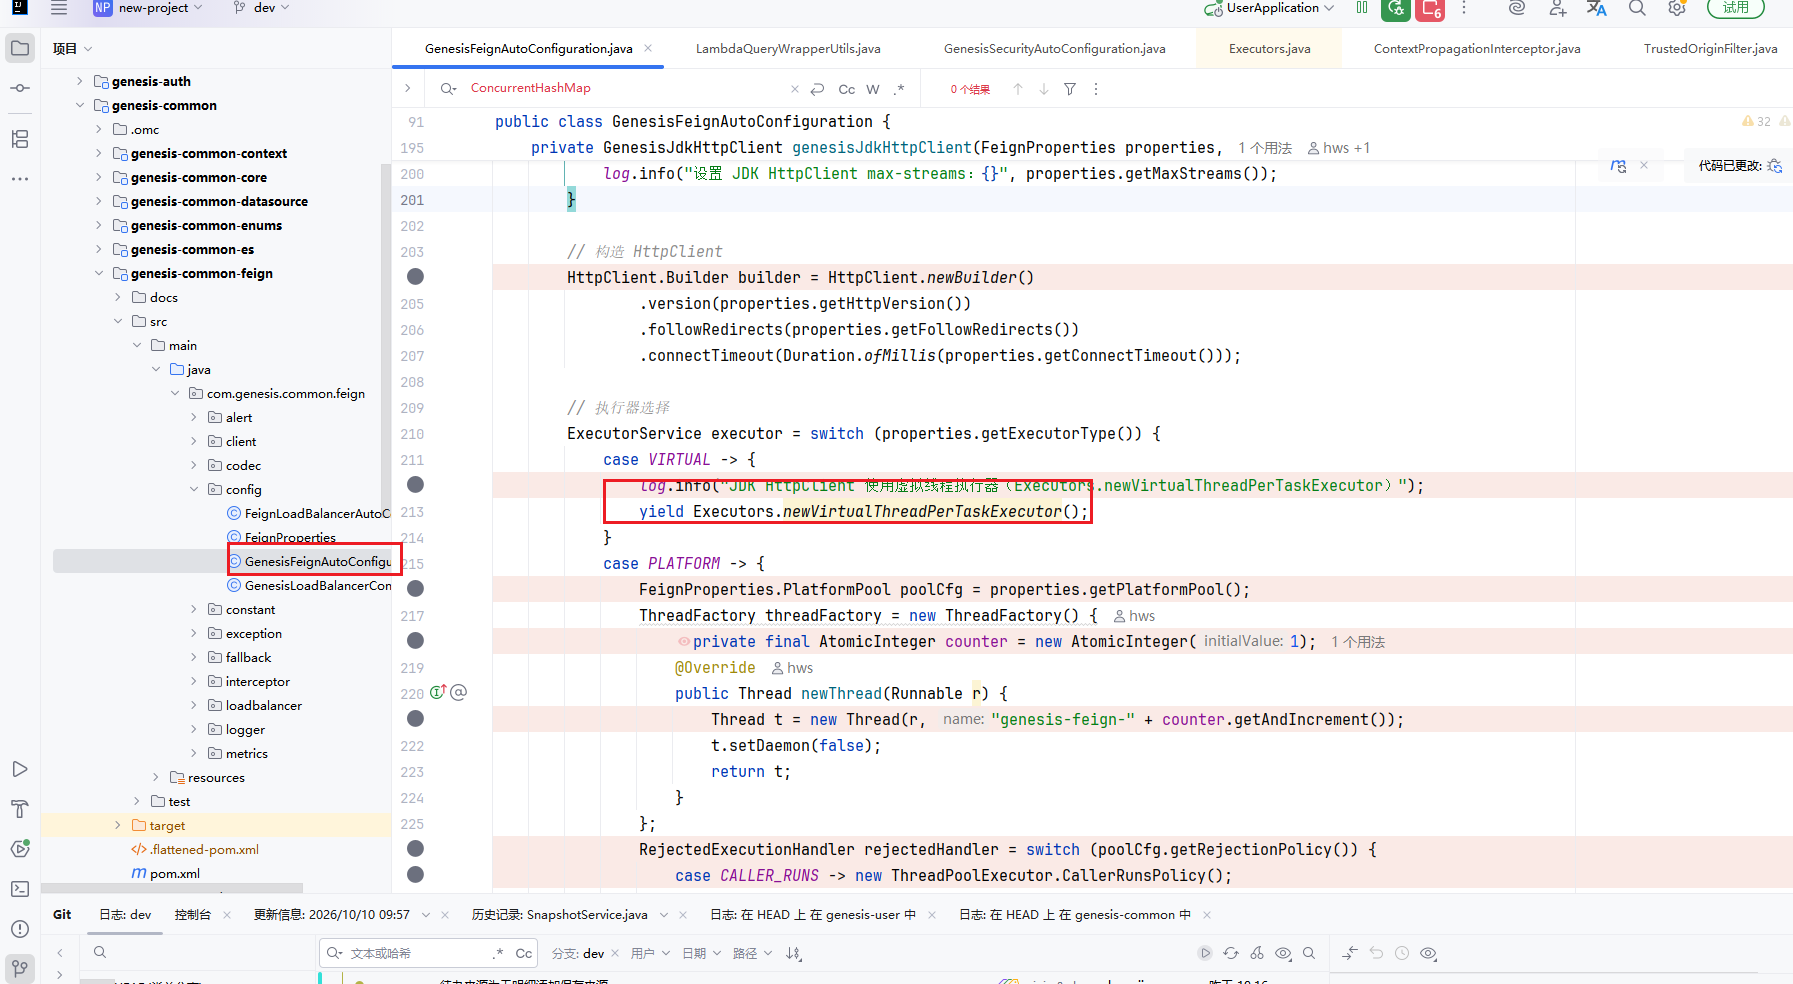
java
case VIRTUAL -> Executors.newVirtualThreadPerTaskExecutor();与预热共用同一个默认调度器,因此业务侧 pin 会直接饿死 Feign。
⑤ 闭环另一半:同步 Feign = sendAsync + 阻塞等待
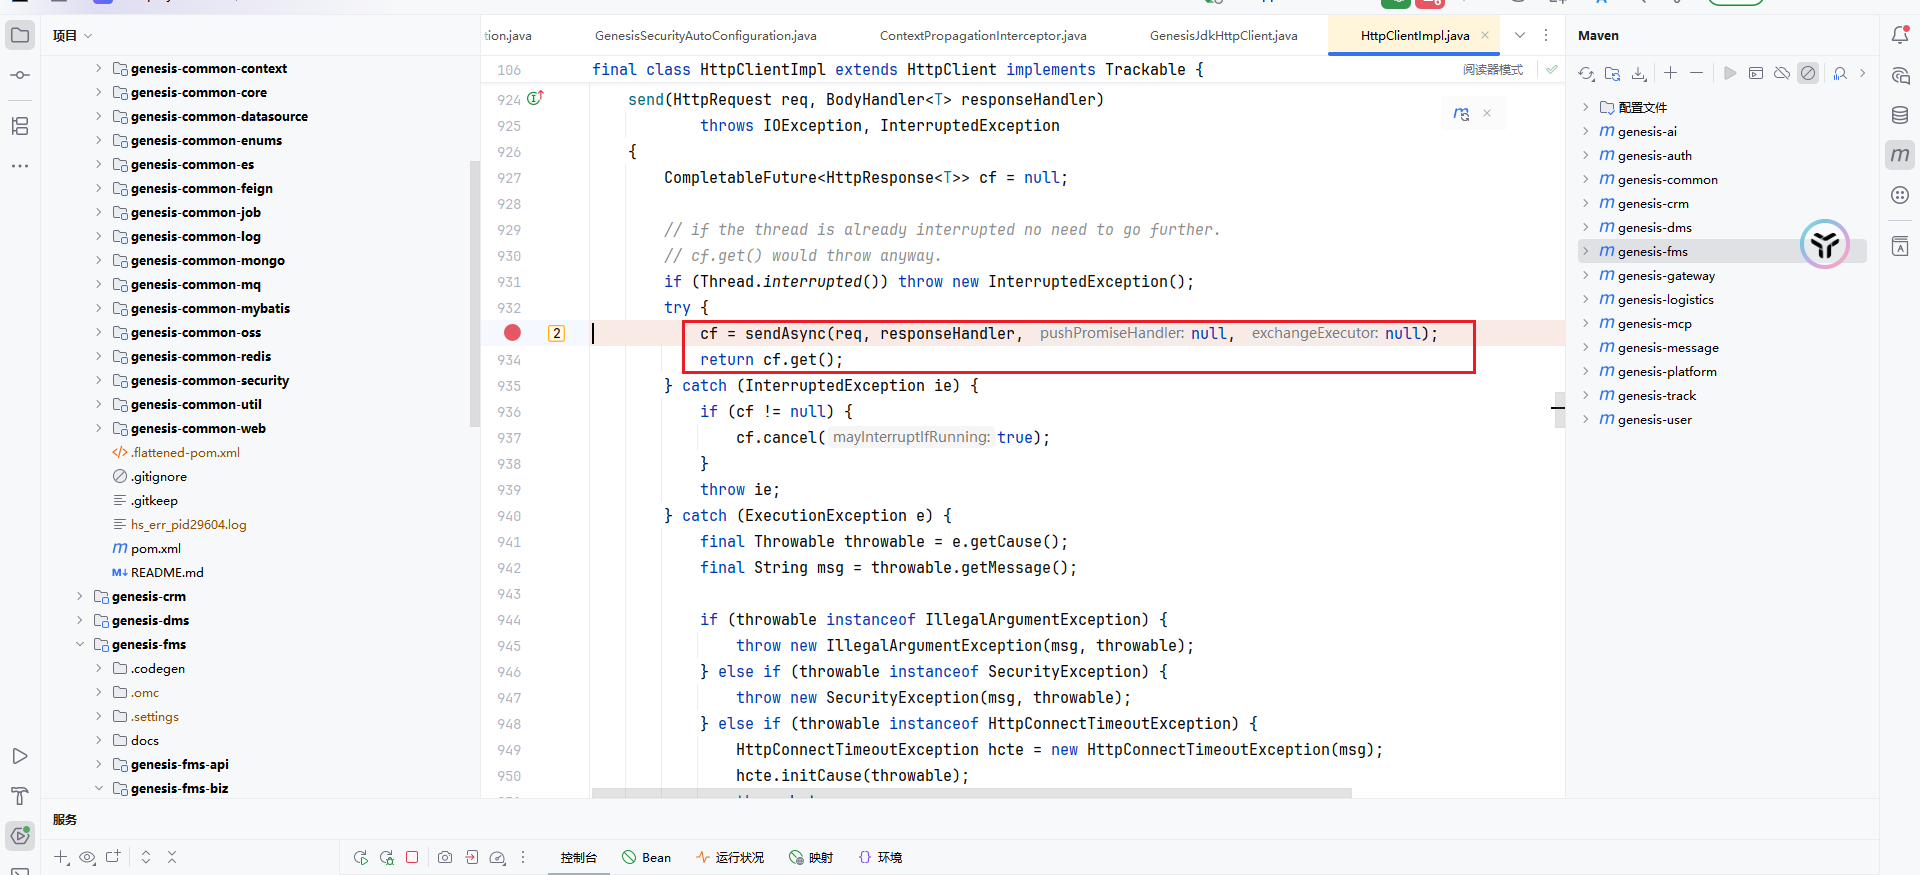
java
cf = sendAsync(req, responseHandler, null, null);
return cf.get();          // exchange 由另一个虚拟线程承担 → 它也需要载体
⑥ 锁由 Caffeine 引入,业务代码未显式加锁
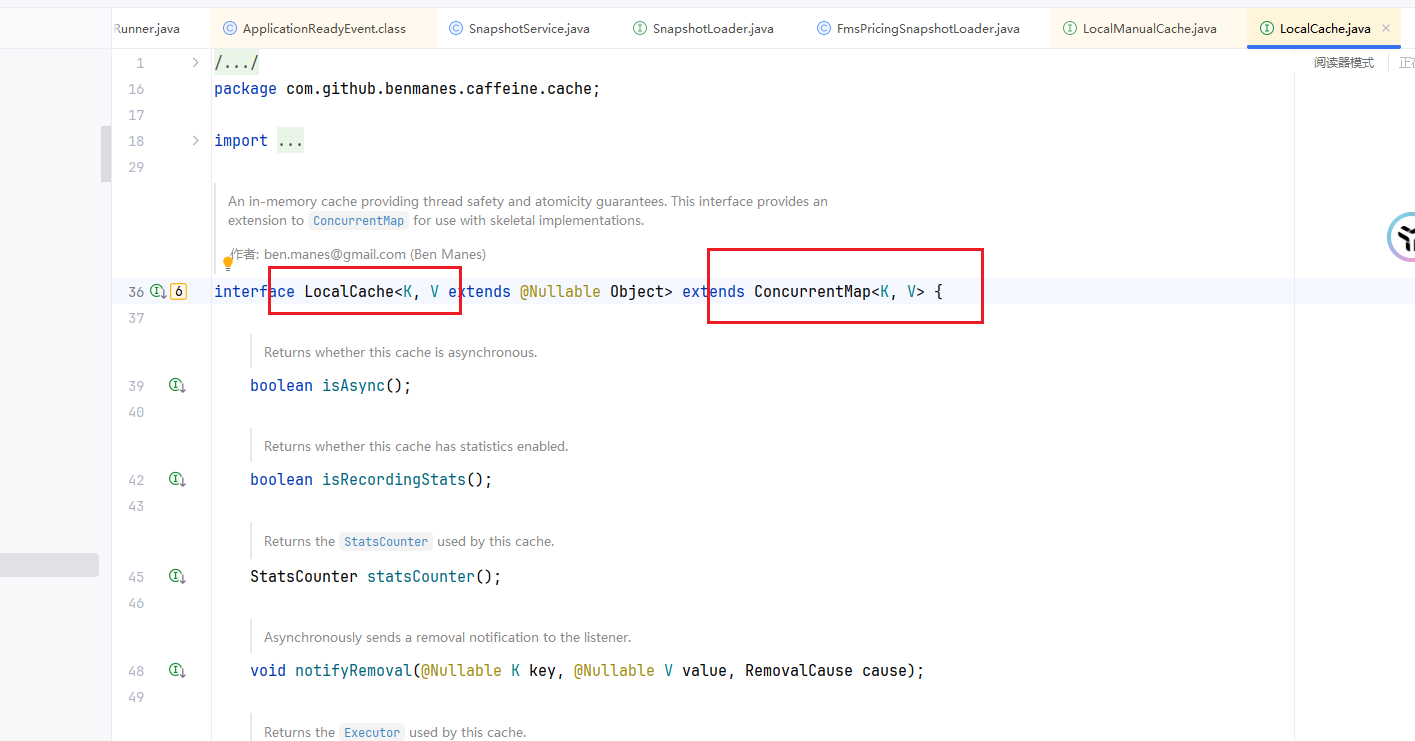
⑦ 铁证:mapping function 在 synchronized 块内执行
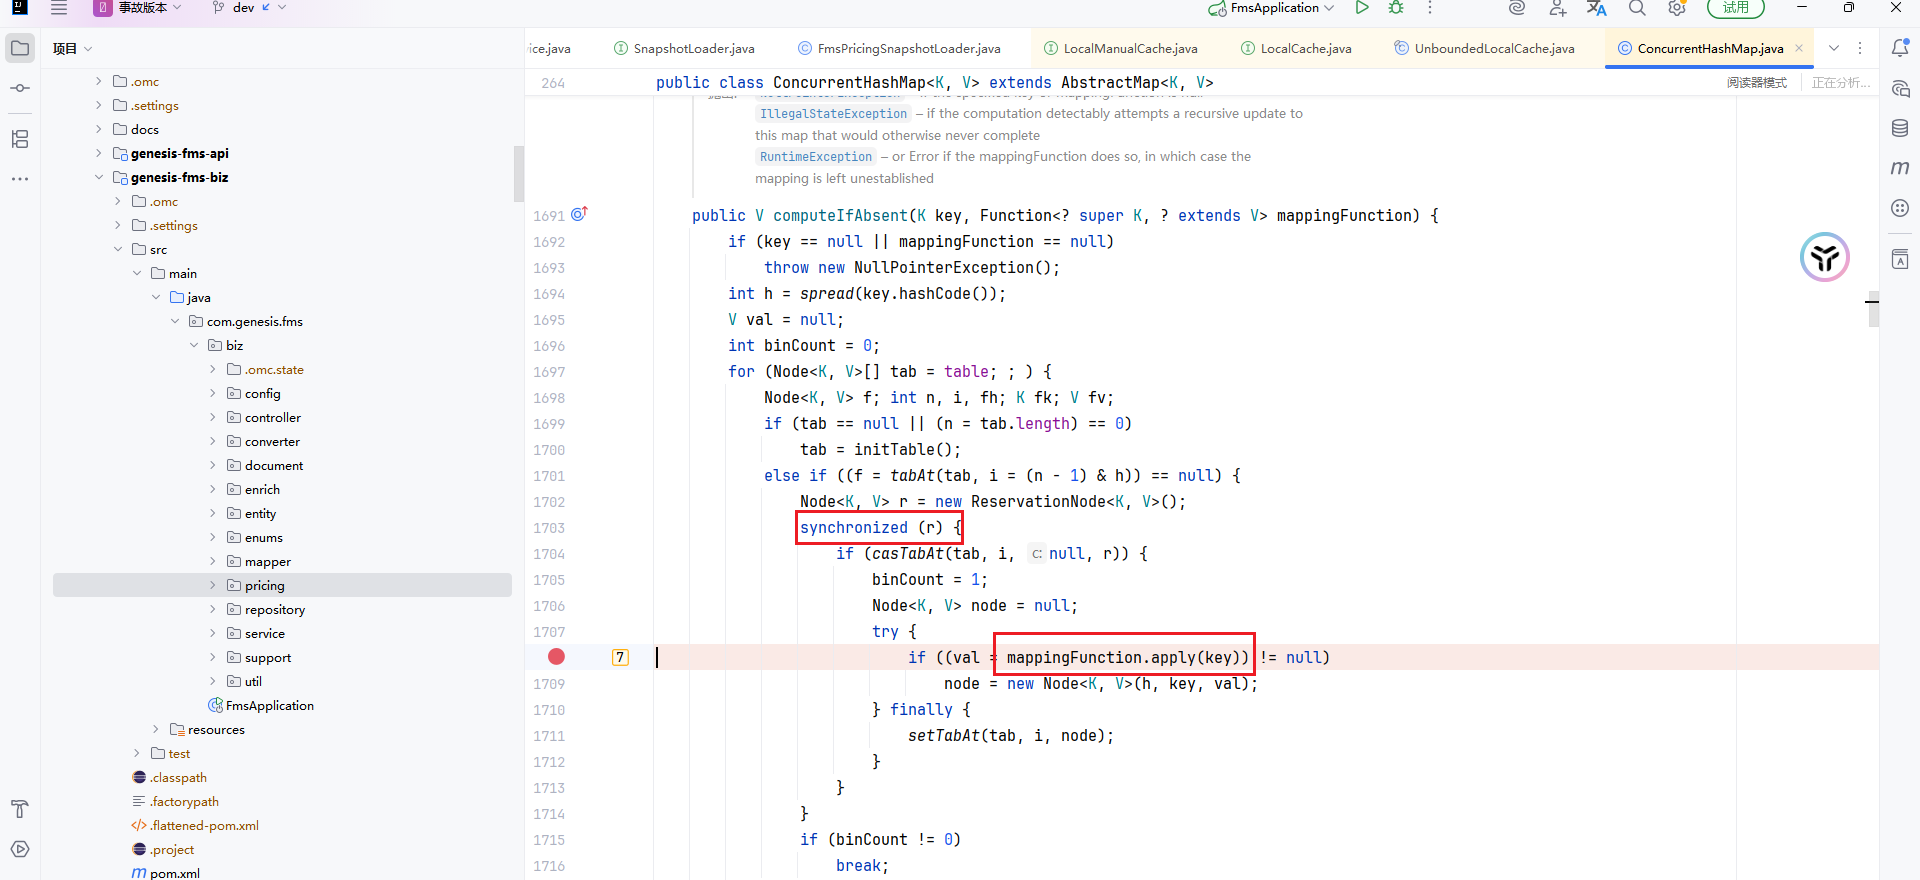
JDK 源码 ConcurrentHashMap.compute:
java
1909  else if ((f = tabAt(tab, i = (n - 1) & h)) == null) {
1910      Node<K,V> r = new ReservationNode<K,V>();
1911      synchronized (r) {                                        // 空桶分支
1916          if ((val = remappingFunction.apply(key, null)) != null) {   // loader 在此执行
1930  else {
1931      synchronized (f) {                                        // 占用桶分支
1940              val = remappingFunction.apply(key, e.val);         // loader 同样在此执行
两条分支均在 synchronized 内。 因此:
「换 key 避免哈希冲突即可规避」是错误 的 ------ 只要走
cache.get(k, loader),loader 必然在某个 monitor 内执行。哈希冲突只会叠加第二类 pin(阻塞在 monitor entry)。
⑧ 触发阈值:29 > 20
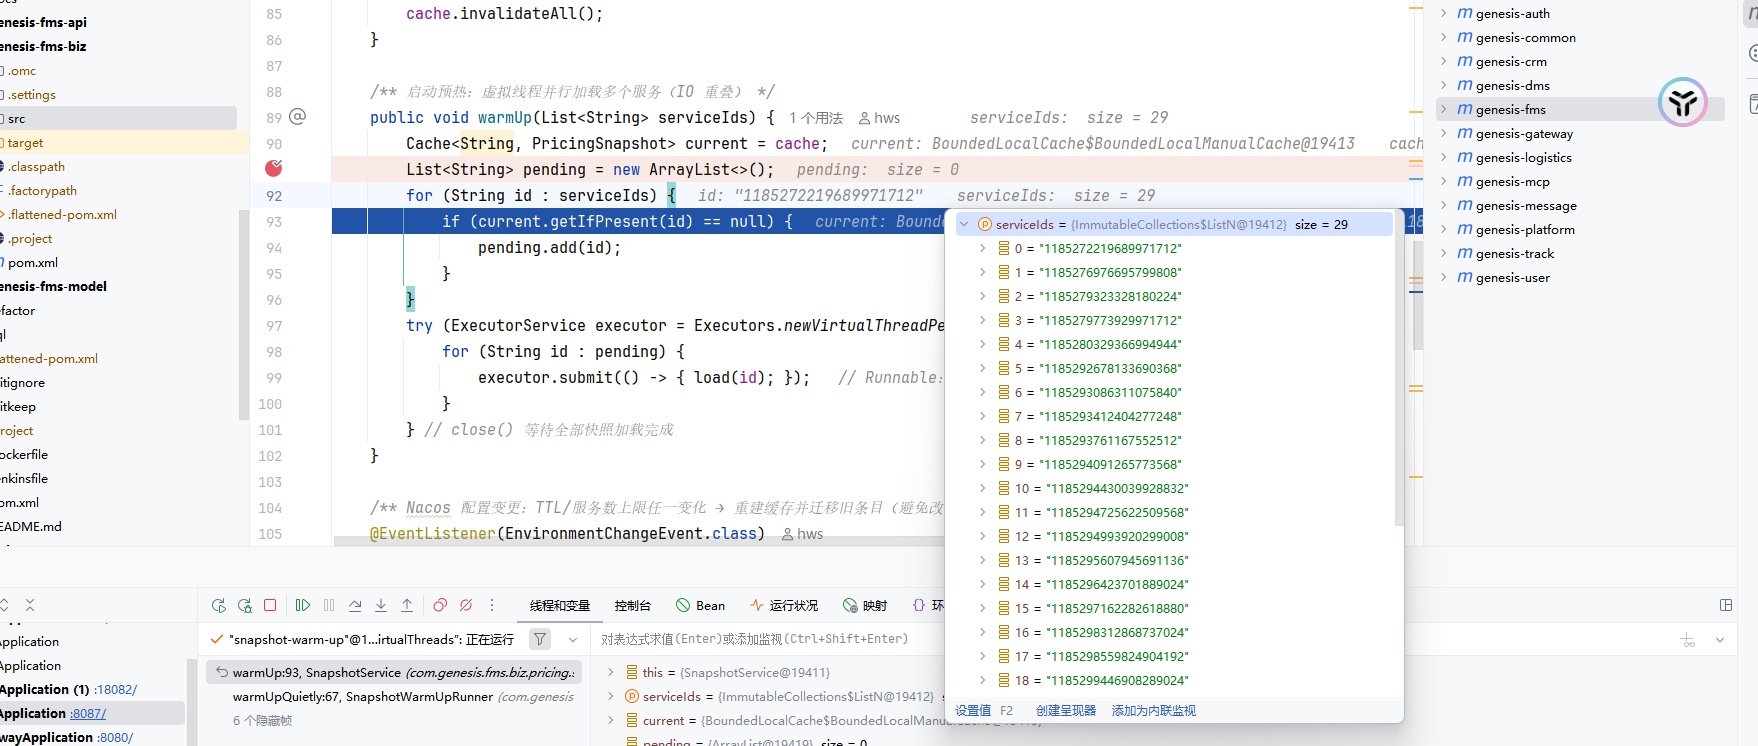
调试器断点处 serviceIds.size = 29,与运行期 dump 中 ThreadPerTaskExecutor 的 29 个虚拟线程互相印证。
预热并发数 = 29
载体线程数 = 20
29 > 20  →  跨过阈值 → 必然锁死
3.2 为什么 pin 会导致全局饿死
虚拟线程 A 需要 HTTP 响应才能走出 synchronized
    ↑                                        ↓
载体线程不归还  ←  A 不走出 synchronized  ←  响应收不到  ←  exchange 虚拟线程拿不到载体
                                                        ←  载体被 A 占着(pin)
标准 wait-for 闭环。权责方向 :载体是被「锁内已存在的虚拟线程」占住的,
exchange 虚拟线程是受害者(被饿死者),不是元凶。
3.3 为什么是阈值效应(躲得过测试)
pin 只是「借了载体不归还」。借出数量 < 载体数时,系统完全正常。
实测(20 核,pin 住的虚拟线程 + loader 内再起虚拟线程 = Feign 的真实形态):
| 场景 | 提交 | 实际启动 | 载体数 |
|---|---|---|---|
| 普通 park(正常卸载) | 60 | 60 | 6(空闲后收缩) |
synchronized 内 park(pin) |
60 | 20 | 20 |
| 60 个抢同一把 monitor(阻塞在 entry) | 60 | 20 | 20 |
真实 Caffeine cache.get(k, loader),loader 内阻塞 |
60 | 15 进入 loader | 20 |
结论:
- pin 不触发载体补偿扩容 ,
maxPoolSize=256不生效,天花板就是parallelism - 阻塞在 monitor entry 同样 pin ------ 不是只有「锁内 park」才 pin
- 真实 Caffeine 60 并发仅 15 个进入 loader,比理论值更差(哈希冲突叠加)
含义:同一份代码,预热 5 个服务永不触发,预热 25 个服务必然锁死。这就是它躲过所有单测和联调的原因。
4. 实测数据
4.1 运行期时间线(重启后自动采样,1.5s 间隔)
11:58:27  旧进程退出
11:59:20  检测到新进程 PID=58620(启动耗时 53s)
11:59:21  carriers=20  carrying=20  conn18082=0    ← 首次采样即已全满
11:59:23  carriers=20  carrying=20  conn18082=0
11:59:25  carriers=20  carrying=20  conn18082=0
   ...    (连续 120 次采样,4 分 12 秒,全部为同一行)
120 次采样零方差 。从预热提交到 20 个载体全部 pin 满,耗时 < 1 秒 。
是阶跃函数,不是渐变 ------ 没有「逐渐恶化」的窗口可供观察,这也是它难以在测试阶段暴露的原因。
4.2 锁死瞬间的全量 dump 统计
载体线程数                    = 20
虚拟线程数(有栈)            = 132
pin(栈含 parkOnCarrierThread)= 10
在 ConcurrentHashMap.compute  = 20   ← 10 个 @1916(锁内执行 loader)+ 10 个 @1932(阻塞在 monitor entry)
在 Feign 调用中               = 10
来自 SnapshotService 的       = 21   (20 个 load 任务 + warmUp 自身在外层 await)
到 18082 的 TCP 连接          = 0    (全程为 0)
其中 10 个「锁内执行 loader」的完整栈(自下往上):
SnapshotService.lambda$warmUp$0:99
  → SnapshotService.load:65
    → LocalManualCache.get:63
      → BoundedLocalCache.doComputeIfAbsent:2765
        → ConcurrentHashMap.compute:1916            ← synchronized(r) 内
          → BoundedLocalCache.lambda$doComputeIfAbsent$0:2767
            → FmsPricingSnapshotLoader.load:155
              → serviceCalcConfFrom:211
                → LogisticsServiceBaseConfSource.load:32
                  → $Proxy208.getInfo               ← Feign
                    → GenesisJdkHttpClient.execute:109
                      → HttpClientImpl.send:934
                        → CompletableFuture.get
                          → LockSupport.park
                            → VirtualThread.park:607
                              → VirtualThread.parkOnCarrierThread:675   ← ★ pin
                                → Unsafe.park
另 10 个(
compute:1932)栈顶无 park 帧 ------ 它们阻塞在 VM 的 monitor entry,属于 2.3 节所述「无法用
parkOnCarrierThread识别」的那一类。
5. 修复
5.1 根因修复:将阻塞 IO 移出 cache.get 的 mapping function
单文件改动 SnapshotService.java:
java
/** 在途加载(单飞):同 key 并发仅首个线程执行 loader,其余等待同一结果 */
private final ConcurrentMap<String, CompletableFuture<PricingSnapshot>> inFlight = new ConcurrentHashMap<>();

/** 热路径:命中直接返回(0 IO);未命中单飞加载,同 key 并发仅构建一次 */
public PricingSnapshot load(String serviceId) {
    Cache<String, PricingSnapshot> current = cache;
    PricingSnapshot hit = current.getIfPresent(serviceId);
    if (hit != null) {
        return hit;
    }
    CompletableFuture<PricingSnapshot> mine = new CompletableFuture<>();
    // 必须用 putIfAbsent:它不执行用户函数;computeIfAbsent 会在 synchronized 内执行 mapping function(同一个坑)
    CompletableFuture<PricingSnapshot> running = inFlight.putIfAbsent(serviceId, mine);
    if (running != null) {
        return awaitSameKey(running);
    }
    try {
        PricingSnapshot loaded = loader.load(serviceId);   // IO 在锁外,不 pin 载体
        if (loaded != null) {
            current.put(serviceId, loaded);
        }
        mine.complete(loaded);
        return loaded;
    } catch (RuntimeException | Error e) {
        mine.completeExceptionally(e);
        throw e;
    } finally {
        inFlight.remove(serviceId, mine);
    }
}

/** 等待同 key 在途加载;失败时抛原始异常(不向调用方暴露 CompletionException 包装) */
private static PricingSnapshot awaitSameKey(CompletableFuture<PricingSnapshot> future) {
    try {
        return future.join();
    } catch (CompletionException e) {
        if (e.getCause() instanceof RuntimeException cause) {
            throw cause;
        }
        throw e;
    }
}
语义保持 :同 key 并发只构建一次;loader 返回 null 不缓存;异常不缓存且原类型透出。
行为变化:单飞由 Caffeine 内部改为显式实现,IO 不再处于任何 monitor 内。
改完必须重启 fms ------ pin 状态不可自愈。
5.2 验证
本地回归测试(src/test/,已在 .git/info/exclude 中,不入库):
| 用例 | 新实现 | 旧实现 |
|---|---|---|
| 6 个用例 | 6/6 通过,0.545s | --- |
concurrentLoadsDoNotStarveCarriers(并发 = 核数+4,loader 内再起虚拟线程) |
通过 | 挂死,150s 被强杀 (The forked VM terminated without properly saying goodbye) |
编译:mvn -f genesis-fms/pom.xml -pl genesis-fms-biz -am -DskipTests -o compile → BUILD SUCCESS
6. 规避规范
6.1 硬性规则
- 锁内禁止阻塞 IO :
synchronized/ReentrantLock/compute*的 mapping function /Object.wait前后,
禁止 Feign、DB、Redis、文件、Thread.sleep、Future.get。 - 缓存回源一律「getIfPresent → 锁外加载 → put」 ;需单飞用
putIfAbsent+CompletableFuture,
禁止computeIfAbsent(同样在synchronized内执行 mapping function)。 - 虚拟线程场景下避免用
synchronized做并发控制 ,优先ReentrantLock(VT-aware,不 pin)。 - 预热/批量任务的并发度不要等于数据条数,应分批或串行,或确认加载路径无 pin 点。
6.2 危险 / 安全写法对照
java
// ✗ mapping function 在 synchronized 内执行
cache.get(key, this::loadFromRemote);
cache.get(key, k -> feignClient.getInfo(k));
map.computeIfAbsent(key, k -> jdbcTemplate.queryForObject(...));
map.compute(key, (k, v) -> restTemplate.getForObject(...));

// ✗ 显式锁内做 IO
synchronized (lock) { feignClient.call(); }
synchronized (lock) { Thread.sleep(100); }

// ✓ 单飞 + IO 在锁外(完整实现见 §5.1)
CompletableFuture<V> running = inFlight.putIfAbsent(key, mine);

// ✓ 不需要单飞时
V hit = cache.getIfPresent(key);
if (hit != null) return hit;
V loaded = loader.load(key);            // 锁外
if (loaded != null) cache.put(key, loaded);
return loaded;
6.3 自查命令
bash
# 危险 1:带 lambda / 方法引用的 cache.get
grep -rn --include=*.java -E "\.get\([^)]*,\s*[a-zA-Z0-9_.:]+\)" | grep -v "getProperty\|getBean"

# 危险 2:compute / computeIfAbsent / merge
grep -rn --include=*.java -E "\.(compute|computeIfAbsent|merge)\("

# 危险 3:synchronized 块内出现远程调用关键字
grep -rn --include=*.java -A15 "synchronized" | grep -E "FeignClient|jdbc|Redis|\.get\(|\.query\(|\.send\("
6.4 检测手段
| 时机 | 手段 | 说明 |
|---|---|---|
| 开发期 | -Djdk.tracePinnedThreads=full |
pin 发生时直接打印栈,最直接 |
| 开发期 | JFR 事件 jdk.VirtualThreadPinned |
统计 pin 次数与位置 |
| 线上 | jcmd <pid> Thread.dump_to_file -format=json <file> |
jstack / Thread.print 不输出虚拟线程栈,必须用此命令 + json 格式 |
| 线上 | 搜 VirtualThread.parkOnCarrierThread |
命中 = pin;仅覆盖「Java 层 park 型」,会漏掉 monitor entry 型 |
| 线上 | 数 ForkJoinPool-1-worker-* 个数 |
= 载体数 = availableProcessors();业务空闲时若仍「全部 Carrying virtual thread」→ 已 pin 满 |
| 线上 | `netstat -ano | findstr |
| 线上 | `jcmd |
grep virtualThread` |
6.5 兜底手段(治标)
| 手段 | 效果 | 代价 |
|---|---|---|
genesis.feign.executor-type: PLATFORM |
Feign 改用 ThreadPoolExecutor,绕开载体 |
放弃虚拟线程收益;仅使 Feign 不随之死,业务侧 pin 仍在 |
-Djdk.virtualThreadScheduler.parallelism=256 |
抬高天花板 | 掩盖问题;核数不足时只是把阈值后移 |
| 升级 JDK 24+(JEP 491) | 根治:monitor 不再绑定载体线程,持锁也可卸载 | 需整体升级验证 |
6.6 Code Review 检查项
- 新增的
cache.get(k, fn)/computeIfAbsent(k, fn),fn内是否有远程调用或 DB? -
synchronized块内是否有 Feign / DB / Redis / sleep /Future.get? - 启动预热、定时批量任务,并发度是否可能 ≥
availableProcessors()? - 新增的虚拟线程执行器是否与 Feign 共用默认调度器?(默认即共用)
- 新增的懒加载/单飞逻辑是否使用
computeIfAbsent?(应改putIfAbsent)
7. 附录
7.1 三个数量概念
| 上限 | 本机 | |
|---|---|---|
平台线程 (java.lang.Thread) |
无上限,系统内数千 | 数千 |
| 硬件线程 / 逻辑处理器 | 硬件固定 | 20 |
| 载体线程 | JVM 按 availableProcessors() 配置 |
20 |
CPU:i5-14500HX,物理核心 14(6 P-core + 8 E-core),逻辑处理器 20(6×2 HT + 8)。
7.2 虚拟线程调度器默认参数
| 系统属性 | 默认值 |
|---|---|
jdk.virtualThreadScheduler.parallelism |
availableProcessors() |
jdk.virtualThreadScheduler.maxPoolSize |
max(parallelism, 256)(pin 时不触发扩容) |
jdk.virtualThreadScheduler.minRunnable |
max(parallelism/2, 1) |
该调度器进程级共享。
7.3 本次事故关键数字
| 数字 | 含义 |
|---|---|
| 29 | 预热并发服务数(触发阈值) |
| 20 | availableProcessors() = 载体线程数 |
| < 1 秒 | 从预热提交到全部 pin 满 |
| 120 / 4分12秒 | 采样次数 / 时长,零方差 |
| 0.13 秒 | dms 直连响应时间(下游无辜) |
| 0 | fms → dms 的 TCP 连接数(请求未出网卡) |
7.4 一页速查
虚拟线程数      = 无上限(每任务一个)
载体线程数      = availableProcessors()(默认,进程级共享)
pin 触发        = synchronized 内阻塞 / monitor entry 阻塞 / native 帧 / Object.wait
pin 判定        = 栈含 VirtualThread.parkOnCarrierThread(仅覆盖 Java 层 park 型)
pin 后果        = 载体不归还 → 借满核数 → 全进程虚拟线程饿死(含 Feign exchange)
                 → 请求不出网卡 → readTimeout 失效 → 永久阻塞
阈值            = pin 数 ≥ availableProcessors()(未跨阈值时完全正常)
时间尺度        = < 1 秒锁死,之后永久恒定
修复            = 锁内不做阻塞 IO;单飞用 putIfAbsent 而非 computeIfAbsent
根治            = JDK 24+ / JEP 491