做了十几年Java开发,线上排查问题的工具换了一茬又一茬。从最早的jstack、jmap、jstat命令行三件套,到BTrace、Greys这类字节码工具,再到Arthas,技术演进的核心逻辑从来没变:用最低的侵入性,最快定位线上问题。
Arthas 4 是目前为止我认为最成熟的Java诊断工具,没有之一。它不是简单的功能堆砌,而是把JVM诊断的整条链路打通了------从基础的线程监控、内存查看,到方法级的入参出观测、调用链路追踪,再到字节码级的热更新、类冲突排查,甚至支持火焰图、JFR这些高级性能分析能力。更重要的是,所有操作都不需要重启应用,不需要提前埋点,生产环境直接用。
一、底层逻辑:Arthas 到底是怎么工作的
很多人用Arthas很久,却不知道它为什么能不重启就修改类、为什么能看到方法的入参出参。理解底层原理不是为了装X,而是遇到问题时你能判断:这个场景Arthas能不能解决?为什么命令没生效?性能开销有多大?
1.1 核心基石:Java Instrumentation API
Arthas所有能力的根源,是JDK 5就引入的java.lang.instrument.Instrumentation接口。这是JDK官方提供的、运行时修改类字节码的唯一合法途径,不是什么黑魔法。
这个接口的核心能力有三个:
- 注册
ClassFileTransformer,类加载时拦截并修改字节码 - 调用
retransformClasses(),对已加载的类重新转换字节码 - 调用
redefineClasses(),直接替换已加载类的字节码 - 获取JVM中所有已加载的类、所有对象内存使用情况等运行时数据
这里有个非常关键的约束,直接决定了Arthas的能力边界:retransform和redefine都不能修改类的结构------不能新增方法、不能删除方法、不能修改方法签名、不能新增字段,只能修改方法体内部的代码逻辑。
很多人问为什么Arthas不能加个字段、为什么不能改方法名,答案就在这里。这是JDK的限制,不是Arthas做不到。
1.2 字节码增强:ASM 与 Advice 机制
有了Instrumentation提供的"修改权限",接下来要解决的是"怎么改"的问题。Arthas底层用ASM库直接操作字节码,在目标方法的前后插入增强代码。
和Spring AOP那种生成代理类的方式不同,Arthas是直接修改原类的字节码,不需要创建代理对象,也不会改变类的继承关系。这也是它能对任何类生效的原因------不管是JDK的类,还是第三方框架的类,只要是被ClassLoader加载了的,都能增强。
Arthas的增强逻辑采用"Advice(通知)"模型:
- 方法进入时,触发
beforeAdvice,记录入参、开始时间 - 方法正常返回时,触发
afterReturningAdvice,记录返回值 - 方法抛出异常时,触发
afterThrowingAdvice,记录异常信息 - 方法退出时(无论正常返回还是抛异常),触发
afterAdvice,计算耗时
所有诊断命令(watch、trace、monitor、tt等)都是基于这套Advice机制实现的,只是各自处理数据的逻辑不同。
1.3 Attach 机制:如何注入到运行中的JVM
Arthas能"附着"到正在运行的Java进程上,靠的是JDK的Attach API。核心流程是:
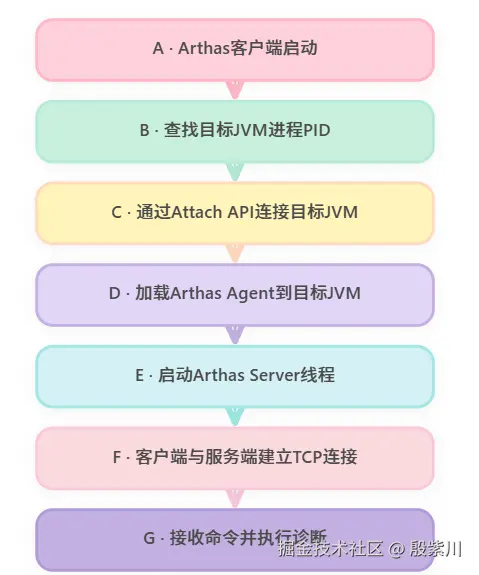
这里有两个容易踩的坑:
- 用户一致性:只能attach同一个用户启动的Java进程。root用户不能attach普通用户的进程,反之亦然。
- 进程响应:如果目标进程已经假死(比如Full GC卡死、死锁),无法响应attach信号,Arthas就连接不上。这种情况先用jstack试试,如果jstack也没反应,那Arthas也没用。
1.4 类加载器隔离:为什么Arthas不污染应用
很多人担心Arthas的jar包会不会和应用产生依赖冲突。答案是不会,因为Arthas用了独立的ClassLoader隔离。
Arthas的核心代码由自己的ArthasClassLoader加载,和应用的ClassLoader不在同一个层级。它只通过Instrumentation API修改应用类的字节码,自身的依赖不会暴露给应用。这也是为什么Arthas可以用ASM、OGNL这些库,却不会和应用里的同版本库产生冲突的原因。
二、Arthas 4 核心架构
Arthas采用经典的客户端-服务端架构,同时支持Tunnel代理模式,适配不同的部署场景。
2.1 基础架构:Client-Server 模型
css
graph LR
    A[Arthas Client<br>命令行交互] -->|TCP连接| B[Arthas Server<br>运行在目标JVM内]
    B --> C[字节码增强模块<br>ASM + Instrumentation]
    B --> D[命令执行引擎]
    D --> E[监控类命令<br>dashboard/thread/jvm]
    D --> F[诊断类命令<br>watch/trace/tt]
D --> G[增强类命令<br>redefine/jad/sc]- 客户端(arthas-client) :提供命令行交互界面,负责接收用户输入、格式化展示结果。支持Tab补全、命令历史、管道操作等,体验和Linux Shell一致。
- 服务端(arthas-core) :运行在目标JVM进程内部,是真正的执行引擎。负责解析命令、执行字节码增强、采集诊断数据。
- 字节码增强系统:基于ASM实现,统一管理所有类的增强和还原,支持多命令并发增强同一个类。
2.2 Tunnel 架构:远程统一管理
生产环境机器多、网络隔离,不可能每台机器上去操作。Arthas提供了Tunnel Server模式,实现统一管理多个Java进程。
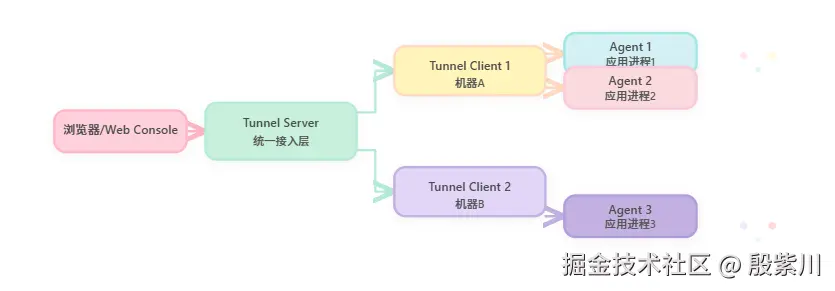
Tunnel模式的核心价值:
- 所有Agent统一注册到Tunnel Server,通过Agent ID区分不同进程
- 支持Web Console,浏览器直接访问,不需要登录服务器
- 适配K8s、Docker等容器化环境,Pod IP变化不影响诊断
- 支持权限控制,审计所有操作
2.3 MCP Server:标准化诊断协议
Arthas 4 新增了MCP(Model Context Protocol)Server支持,这是个很重要的信号------诊断工具开始向标准化、智能化发展。
MCP Server把Arthas的所有诊断能力封装成标准协议接口,AI Agent可以直接调用Arthas的能力。比如大模型可以自动分析异常,然后调用Arthas的trace、watch命令去排查问题,形成"发现问题-定位根因-给出方案"的闭环。
目前MCP Server已经支持29个核心工具,覆盖JVM监控、类加载、方法追踪、热更新等全场景。
三、核心命令深度解析
Arthas命令很多,但常用的也就十几个。按功能可以分成六大类,每一类掌握核心用法就够应对90%以上的场景。
3.1 全局概览:快速定位问题方向
遇到线上问题,不要一上来就trace、watch,先看全局信息,缩小排查范围。
dashboard:系统运行总览
dashboard是最常用的命令,没有之一。输入后实时展示JVM的整体运行状态,包括:
- 线程统计:总数、各状态数量、CPU使用率Top线程
- 内存统计:堆内存、非堆内存、各代内存使用情况
- GC统计:YGC、FGC次数和耗时
- 操作系统信息:CPU使用率、负载、磁盘IO
yaml
dashboard -i 5000  # 5秒刷新一次,默认5秒
dashboard -n 10    # 刷新10次后自动退出
经验之谈 :dashboard默认刷新间隔5秒,线程数多的场景会有一定CPU开销。如果只是想大概看一下,用dashboard -n 1看一眼就退,或者把间隔调大到10秒。
thread:线程级深度分析
比jstack强大太多的线程分析工具。
perl
thread              # 查看所有线程基本信息
thread -n 5         # 查看CPU使用率最高的5个线程栈
thread -b           # 找出阻塞其他线程的线程(死锁排查神器)
thread --state WAITING  # 查看所有WAITING状态的线程
thread 123          # 查看指定ID线程的完整堆栈
thread -i 1000 # 统计1秒内的CPU使用率,默认200ms重点说thread -b,这是排查死锁的利器。它能直接找出持有锁并阻塞其他线程的线程,输出里会明确标注- locked java.lang.Object@xxx <---- but blocks N other threads!。
注意 :thread -b目前只支持synchronized关键字的锁,java.util.concurrent包下的锁还检测不出来。
jvm:JVM 详细信息
查看JVM的完整运行参数,包括:
-
启动参数、系统属性
-
类加载统计
-
编译统计
-
GC收集器信息
-
内存池详细信息
jvm
排查内存问题、GC问题时,先看jvm确认堆大小、GC收集器类型、新生代老年代比例,避免上来就瞎调参数。
3.2 类与类加载器:解决类冲突的终极武器
线上遇到NoClassDefFoundError、ClassNotFoundException、NoSuchMethodError,或者代码发布了不生效,90%都是类加载的问题。这几个命令能帮你秒定位。
sc:搜索已加载的类
Search Class,查看JVM里到底加载了哪些类。
bash
sc *OrderService        # 模糊搜索
sc -d com.example.OrderService  # 查看类的详细信息,包括类加载器、源码位置
sc -d -f com.example.OrderService  # 查看类的字段信息
典型场景 :怀疑部署没生效,先sc搜一下类,看类的版本是不是最新的。很多时候是类加载器加载了旧版本的类。
sm:搜索类的方法
Search Method,查看类的方法信息。
bash
sm com.example.OrderService        # 列出所有方法
sm -d com.example.OrderService queryOrder # 查看方法详细信息,包括参数、返回值、注解排查NoSuchMethodError时,先用sm确认JVM里实际运行的方法签名是什么,经常发现是版本不对或者重载搞错了。
jad:反编译已加载的类
这是我用得最多的命令之一。直接把JVM里运行的字节码反编译成Java源码,看到的就是实际执行的代码。
bash
jad com.example.OrderService              # 反编译整个类
jad --source-only com.example.OrderService  # 只输出源码,不显示类信息
jad com.example.OrderService queryOrder # 只反编译指定方法黄金用法:线上怀疑代码没生效,直接jad反编译出来看。比去查发布记录、看日志靠谱一万倍------JVM里实际跑的代码不会骗人。
注意:反编译出来的代码和源码可能有细微差别,比如语法糖、循环优化等,这是正常的。
classloader:类加载器分析
查看所有类加载器的继承关系、加载的类数量、加载路径。
r
classloader                  # 查看类加载器统计
classloader -l               # 列出所有类加载器实例
classloader -c 1234abcd      # 查看指定类加载器的详细信息
classloader -c 1234abcd -r META-INF/spring.factories # 用指定类加载器加载资源类冲突排查步骤:
sc -d看目标类是哪个类加载器加载的classloader看有哪些类加载器- 确认是不是有多个类加载器加载了同一个类
classloader -c看每个类加载器的加载路径,找到冲突的jar包
3.3 方法诊断:watch / trace / monitor / tt
这四个是Arthas的核心功能,也是最容易用错的。很多人乱用导致性能问题,就是没搞清楚各自的适用场景。
watch:观测方法执行数据
查看方法的入参、返回值、异常,支持条件过滤。
bash
# 基本用法:查看入参和返回值
watch com.example.OrderService queryOrder "{params, returnObj}"

# 只看第一个参数和返回值
watch com.example.OrderService queryOrder "{params[0], returnObj}"

# 条件过滤:只看入参第一个值大于10000的调用
watch com.example.OrderService queryOrder "{params, returnObj}" "params[0] > 10000"

# 按耗时过滤:只看耗时超过100ms的
watch com.example.OrderService queryOrder "{params, returnObj}" "#cost > 100"

# 查看异常
watch com.example.OrderService queryOrder "{throwExp}" -e

# 展开深度:对象属性展开3层
watch com.example.OrderService queryOrder "{params, returnObj}" -x 3

# 只执行10次就退出
watch com.example.OrderService queryOrder "{params}" -n 10表达式说明:
params:方法入参数组,params[0]是第一个参数returnObj:返回值throwExp:抛出的异常target:目标对象本身#cost:方法执行耗时,单位毫秒
重要提醒:
- watch默认会匹配子类,接口也会匹配所有实现类,范围可能比你想的大
- 高频方法上用watch一定要加
-n限制次数,或者加条件过滤,否则会打爆CPU -x不要开太大,最多3层。展开大对象会触发大量反射,非常耗性能- watch是只读的,不能修改入参和返回值
trace:追踪方法调用链路
输出方法内部的完整调用路径,以及每个节点的耗时。排查接口慢的首选命令。
bash
# 基本用法
trace com.example.OrderService queryOrder

# 按耗时过滤,只看总耗时超过100ms的调用
trace com.example.OrderService queryOrder '#cost > 100'

# 追踪调用深度,默认1层
trace --maxDepth 3 com.example.OrderService queryOrder

# 跳过JDK方法,减少干扰
trace --skipJDKMethod true com.example.OrderService queryOrder

# 只追踪10次
trace com.example.OrderService queryOrder -n 10
trace输出的调用树非常直观,每个方法的耗时占比一目了然。比如:
css
`---[120.03ms] com.example.OrderService:queryOrder()
    +---[10.05ms] com.example.UserService:getUser()
    +---[85.23ms] com.example.OrderDao:queryByUserId()
    |   `---[80.11ms] java.sql.PreparedStatement:executeQuery()
    `---[20.45ms] com.example.PriceService:calculate()
一眼就能看出瓶颈在数据库查询。
注意事项:
- trace默认只追踪一层内部调用,不是递归追踪所有层级
- 想追踪多层可以用
--maxDepth,但不要太深,否则性能开销极大 - 3.3版本之后支持动态trace,可以指定listenerId逐层深入
- 被JIT内联的方法可能追踪不到,属正常现象
monitor:方法执行监控
统计方法的调用次数、成功率、耗时分布,适合做一段时间的监控统计。
r
# 每10秒统计一次
monitor -c 10 com.example.OrderService queryOrder

# 统计维度:总次数、成功次数、失败次数、平均耗时、失败率
monitor -c 5 com.example.OrderService queryOrder
输出包含:timestamp、class、method、total、success、fail、rt、fail-rate。
monitor和watch的区别:watch是每次调用都输出详情,monitor是周期性输出统计数据。长时间监控用monitor,开销小很多。
tt:时间隧道,最被低估的神器
TimeTunnel,记录方法每次调用的完整上下文,事后可以回放、查看、甚至重新执行。
很多人不知道tt的强大。watch是实时的,错过了就没了;tt是把所有调用都存下来,你可以慢慢看。
yaml
# 开始记录指定方法的调用
tt -t com.example.OrderService queryOrder

# 查看所有记录
tt -l

# 查看索引1001的详细信息
tt -i 1001

# 回放这次调用,重新执行一次方法
tt -i 1001 -p

# 回放时修改入参
tt -i 1001 -p "params[0] = 12345"

# 删除指定记录
tt -d -i 1001

# 清空所有记录
tt --delete-alltt的核心优势:
- 事后排查:偶发性异常,等你发现的时候可能已经过了,tt已经把现场存下来了
- 可回放:同一个入参可以反复执行,验证修复效果
- 可修改入参:不用改代码,直接测试不同入参的表现
注意:
- tt默认最多存100条记录,满了会覆盖
- 存的是对象引用,如果对象后续被修改了,看到的值可能不对
- 用完记得清空,否则会内存泄漏。退出Arthas不会自动清理tt缓存
- ThreadLocal里的信息会丢失,比如链路追踪的traceId
3.4 性能分析:profiler 与 jfr
排查CPU性能问题,火焰图是最直观的工具。Arthas集成了async-profiler,一条命令生成火焰图。
profiler:生成火焰图
csharp
# 开始采样,默认采样CPU
profiler start

# 采样内存分配
profiler start --event alloc

# 采样锁竞争
profiler start --event lock

# 采样30秒后自动停止
profiler start --duration 30

# 停止采样,生成火焰图
profiler stop

# 生成SVG格式文件
profiler stop --format svg

# 查看采样状态
profiler status生成的火焰图默认在arthas-output目录下,用浏览器打开就能看。火焰图的宽度代表CPU占用时间,越宽说明占用CPU越多。
经验之谈:
- CPU占用高,用默认的cpu事件采样
- 内存分配快,用alloc事件,看哪些对象分配多
- 锁竞争严重,用lock事件,看哪些锁等待时间长
- 采样时间建议至少30秒,太短样本不准
- 生产环境用对性能影响很小,放心用
jfr:JDK Flight Recorder
JFR是JDK内置的性能采集工具,功能非常强大,开销极低(不到1%)。Arthas支持动态开启JFR记录。
bash
# 开启JFR记录,持续30秒
jfr start --duration 30s

# 查看所有记录
jfr list

# 停止指定记录
jfr stop 1

#  dump记录到文件
jfr dump 1 --file /tmp/recording.jfr
JFR记录的信息非常全面,包括CPU、内存、GC、线程、锁、IO、异常等几乎所有JVM运行数据。dump出来的jfr文件可以用JDK自带的JMC(Java Mission Control)打开分析。
3.5 热更新:jad / mc / redefine 一条龙
线上出Bug,不用重启,直接热更代码。这是Arthas最"爽"的功能,也是最考验功底的功能。
完整的热更新流程:
- jad反编译源码
- 修改代码
- mc内存编译
- redefine热加载
bash
# 1. 反编译
jad --source-only com.example.OrderService > /tmp/OrderService.java

# 2. vim修改代码
vim /tmp/OrderService.java

# 3. 内存编译
mc /tmp/OrderService.java -d /tmp

# 4. 热加载
redefine /tmp/com/example/OrderService.class
redefine 和 retransform 的区别:
redefine:直接加载外部class文件,替换原类字节码。和watch/trace等命令冲突,因为会覆盖增强后的字节码retransform:基于原类字节码重新转换,会保留其他命令的增强。推荐优先用retransform
重要限制:
- 不能新增、删除、修改方法签名和字段,只能改方法体
- 类的版本号要一致,JDK版本也要一致
- 正在执行的方法不会立即生效,要等下次调用
- 静态代码块不会重新执行
- 和watch、trace等命令冲突,执行前先reset
热更新踩过的坑:
- 不要在生产环境第一次用,测试环境先练熟
- 改完一定要jad反编译确认生效了
- 热更新只是临时方案,最终还是要发版修复
- 复杂逻辑不建议热更,容易出问题
- mc编译失败的话,本地编译好class文件传上去
3.6 其他实用命令
vmtool:JVM 工具集
css
vmtool --action forceGc  # 强制Full GC
vmtool --action getInstances --className com.example.OrderService  # 获取类的所有实例
vmtool --action getInstances --className com.example.OrderService --limit 10
vmtool --action interruptThread --id 123  # 中断指定线程
heapdump:dump 堆内存
bash
heapdump /tmp/dump.hprof  # dump堆到文件
heapdump --live /tmp/dump.hprof  # 只dump存活对象
和jmap功能一样,但不用找PID,直接在Arthas里执行。dump下来的文件可以用MAT、JVisualVM分析。
options:全局开关
bash
options                # 查看所有选项
options save-result true  # 保存命令结果到文件
options strict true     # 严格模式,不匹配子类
常用的全局配置:
save-result:命令结果自动保存到日志文件strict:严格匹配,不匹配子类verbose:详细输出,调试用
四、实战场景
讲完命令,结合实际场景看怎么用。线上问题千变万化,但排查思路是相通的。
4.1 场景一:接口响应慢,性能瓶颈排查
现象:订单查询接口偶尔超时,平均响应时间从100ms涨到500ms。
排查步骤:
-
先看全局
dashboard
看CPU、内存、GC有没有异常。如果CPU飙升,先看是哪个线程占的。
- 确认方法耗时
arduino
trace com.example.OrderService queryOrder '#cost > 200' -n 20看调用链路上哪个节点耗时最长。大概率是数据库查询、外部RPC调用或者循环里的逻辑。
- 深入分析瓶颈点 如果是数据库慢:
css
trace com.example.OrderDao queryByUserId --maxDepth 2看SQL执行时间,是不是有全表扫描、没走索引。
如果是方法内部逻辑复杂:
sql
profiler start --duration 30压测或者等流量过来,30秒后生成火焰图,看CPU都耗在哪个方法上。
- 查看入参确认是不是特定请求导致
less
watch com.example.OrderService queryOrder "{params[0], #cost}" "#cost > 300" -n 10看是不是特定用户、特定参数导致的慢查询。
经验总结:80%的性能问题都能通过trace定位。先定位到具体方法,再决定用watch看参数还是用profiler看CPU。
4.2 场景二:系统卡死,线程阻塞与死锁
现象:应用所有接口都不响应,日志停止输出,CPU不高。
排查步骤:
- 先看阻塞线程
arduino
thread -b直接找出持有锁并阻塞其他线程的线程。如果是synchronized的死锁,这里会直接显示。
- 看所有线程状态
arduino
thread --state BLOCKED
thread --state WAITING
看有多少线程在等锁,都卡在哪个方法。
- 查看锁持有者的堆栈
arduino
thread <阻塞线程ID>看这个线程卡在什么地方,为什么不释放锁。常见的原因:
- 拿到锁之后执行了耗时很长的操作
- 锁嵌套,顺序不对导致死锁
- 拿到锁之后抛异常没释放
- 如果是JUC锁
arduino
thread -n 20看各线程的调用栈,手动分析锁的持有情况。JUC的锁thread -b检测不出来,只能靠堆栈分析。
典型案例:数据库连接池耗尽,所有线程都卡在getConnection()上,表现就是系统卡死,CPU不高。用thread一看,大量线程WAITING在连接池的锁上。
4.3 场景三:线上Bug热修复
现象:订单计算价格时,特定场景下计算错误,需要紧急修复。
操作步骤:
-
确认问题代码
jad com.example.PriceService calculate
反编译确认当前运行的代码逻辑,找到Bug点。
- 保存源码并修改
bash
jad --source-only com.example.PriceService > /tmp/PriceService.java
vim /tmp/PriceService.java
修改有问题的代码逻辑。
- 编译
bash
mc /tmp/PriceService.java -d /tmp如果mc编译失败,本地用相同JDK版本编译好传上去。
- 重置增强(如果之前有watch/trace过这个类)
perl
reset com.example.PriceService- 热加载
arduino
redefine /tmp/com/example/PriceService.class-
验证生效
jad com.example.PriceService calculate
确认代码已经更新。然后用tt回放或者直接调接口验证。
注意:
- 热更新只是临时救急,修复完赶紧发正式版本
- 不要热更新复杂的重构,只改小Bug
- 涉及字段新增、方法签名修改的,不要想了,只能发版重启
4.4 场景四:类冲突与代码不生效
现象:发版后功能没变化,或者报NoSuchMethodError,但本地代码明明有这个方法。
排查步骤:
-
确认类是否存在
sc com.example.OrderService
看类有没有被加载,有几个。
-
查看类加载器
sc -d com.example.OrderService
看是哪个类加载器加载的,代码源位置是哪个jar包。
- 查看方法签名
erlang
sm -d com.example.OrderService queryOrder确认JVM里实际的方法参数、返回值是什么。
-
查看所有类加载器
classloader -l
看是不是有多个类加载器都加载了这个类。
- 定位冲突jar包
bash
classloader -c <类加载器hash>看这个类加载器的加载路径,找到重复的jar包。
典型案例:maven依赖冲突,两个不同版本的同名类,类加载器加载了旧版本。用sc -d一看代码源,立刻就能定位到是哪个jar包里的旧类。
4.5 场景五:内存泄漏排查
现象:内存使用率持续上涨,Full GC频繁,老年代回收不掉。
排查步骤:
-
先看内存趋势
dashboard
看堆内存使用是不是一直在涨,GC后能不能降下来。
-
查看GC情况
jvm
看GC次数和耗时,特别是FGC的频率。
- dump堆内存
bash
heapdump --live /tmp/dump.hprof只dump存活对象,文件小一点。
- 用MAT分析 下载hprof文件,用MAT打开,分析:
- 内存占用最大的对象
- 对象的引用链
- 是不是有集合一直往里加元素没清理
- 是不是有缓存没过期
- 快速定位大对象
css
vmtool --action getInstances --className java.util.ArrayList --limit 10可以大概看一下大对象的情况,但详细分析还是要靠堆dump。
经验:内存泄漏90%都是集合、缓存、线程池、静态变量导致的。重点查static的集合、ThreadLocal、各种缓存框架的配置。
五、高级特性
5.1 Web Console:浏览器直接操作
Arthas支持Web Console,不用登录服务器,浏览器就能用。
启动时指定端口:
css
java -jar arthas-boot.jar --target-ip 0.0.0.0 --http-port 8563然后访问http://ip:8563,就能打开Web界面,功能和命令行完全一样。
生产环境建议配合Tunnel Server使用,不要直接暴露端口。
5.2 外部命令扩展
Arthas支持加载自定义命令,可以把团队常用的诊断逻辑封装成Arthas命令。
实现方式:
- 实现
Command接口 - 打成jar包,放到arthas的commands目录
- 启动时自动加载
外部命令和内置命令用法完全一样,适合做定制化的诊断工具。
5.3 Docker & K8s 支持
Arthas 4 对容器环境做了很多优化:
- sidecar模式:把Arthas放到sidecar容器里,attach同一个Pod里的应用进程
- kubectl debug:从临时调试容器attach,不需要修改原Pod
- 支持distroless镜像:即使应用镜像没有shell、没有JDK,也能诊断
K8s环境推荐用Tunnel Server模式,所有Pod的Agent都注册到Tunnel,统一管理。
5.4 管道与脚本
Arthas支持类似Linux的管道操作,可以组合命令:
perl
sc *Service | grep Order
thread | grep WAITING | wc -l还支持grep、wc、tee等命令,非常灵活。
复杂的诊断逻辑可以写成脚本,批量执行。
六、最佳实践与踩坑指南
6.1 性能开销控制
Arthas不是没有开销,只是大部分场景下可以接受。生产环境使用一定要注意:
- trace/watch不要用太宽泛的匹配 比如
trace com.example.* *,会增强大量类,性能开销爆炸。尽量精确到类和方法。 - 高频方法加条件过滤和次数限制 比如QPS上千的接口,直接裸watch会把CPU打满。一定要加
-n限制次数,或者加#cost条件只看慢调用。 - 用完及时退出或reset 诊断完执行
reset把增强的类还原,或者直接stop退出。不要一直挂着。 - dashboard不要长时间开着 dashboard默认5秒刷新一次,线程多的话有CPU开销。看完就关。
- profiler采样时间不要太长 一般30-60秒足够,采样本身开销很小,但也别一直开着。
6.2 常见问题与解决方案
连接不上目标进程
- 检查是不是同一个用户启动的
- 检查目标进程是不是假死,jstack能不能用
- 检查/tmp目录权限,attach需要写socket文件
- 之前有旧版本Arthas挂着,先stop再重新attach
命令执行了没输出
- 确认方法有没有被调用到
- 确认类名方法名拼写正确,注意大小写
- 是不是接口,实现类有没有被加载
- 用
sc确认类存在,sm确认方法存在 - 是不是被JIT内联了,特别是小方法
redefine失败
- 检查是不是修改了方法签名或字段
- 检查JDK版本是不是一致
- 检查类是不是被其他字节码工具增强过(比如SkyWalking旧版本)
- 先reset再redefine
反编译的代码和源码不一样
- 正常现象,字节码反编译会有差异
- 语法糖、泛型擦除、循环优化都会导致不一样
- 以实际执行逻辑为准
6.3 生产环境使用规范
- 生产环境操作前一定要在测试环境验证 特别是热更新、redefine这类操作,测试环境先试一遍。
- 最小权限原则 只给需要的人开通权限,操作留痕。用Tunnel Server可以做审计。
- 禁止在生产环境做破坏性操作 比如强制GC、中断线程、dump大堆,可能影响业务。
- 紧急操作双人确认 热更新这种操作,最好两个人一起确认。
- 事后及时清理 诊断完reset,退出Arthas,删除临时文件。
6.4 哪些场景不适合用Arthas
- 进程已经假死,jstack都连不上的
- 需要新增字段、修改类结构的Bug,只能发版
- 超高QPS(万级以上)的核心接口,trace/watch慎用
- JDK版本过低(1.6以下)不支持
- 非HotSpot虚拟机(比如JRockit、IBM J9)兼容性一般
七、the end
Arthas是个工具,工具是为人服务的。真正厉害的不是会用多少命令,而是遇到问题知道该用什么工具、按什么思路去排查。
我做了这么多年开发,最大的体会是:线上排查问题,思路比工具重要。先假设可能的原因,再用工具去验证,一步步缩小范围,而不是上来就乱试命令。
Arthas 4 相比3.x做了很多优化,性能更好,功能更全,特别是MCP、Docker支持这些新特性,能看出来是在往云原生、智能化的方向走。作为开发者,我们不需要去造轮子,但要把现成的工具用到极致。
最后提醒一句:工具是死的,人是活的。多练多用,踩过坑才会有体会。
参考资料:
- Arthas官方文档:arthas.aliyun.com/doc/