会用socket吗,具体怎么socket编程
服务端先调用 socket(AF_INET, SOCK_STREAM, 0) 创建套接字,然后通过 setsockopt 设置端口复用,使用 bind 绑定 IP 和端口,调用 listen 进入监听状态,最后通过 accept 接收客户端连接。连接建立后,服务端和客户端都可以使用 send/recv 或 write/read 收发数据,通信结束后调用 close 关闭连接。
客户端流程相对简单:创建 Socket 后调用 connect 连接服务端,再进行数据收发。地址设置时通常使用 inet_pton,端口使用 htons 转换为网络字节序。
.数据结构算法你还记得哪些,分别都罗列一下
动态规划。递归,贪心,二分查找,快排,归并排序,双指针,二叉树,链表
讲一下每种数据结构的特点
面试回答:
常见数据结构可以从存储方式和逻辑关系来理解,主要包括线性结构、树形结构、图结构和哈希结构。
- 数组:连续内存,支持随机访问,按下标访问是 \(O(1)\),但中间插入和删除通常需要搬移元素,复杂度为 \(O(n)\)。
- 链表:节点通过指针连接,内存不要求连续,已知节点位置时插入和删除是 \(O(1)\),但按下标查找需要 \(O(n)\),不支持高效随机访问。
- 栈:后进先出,只能在栈顶进行插入和删除,常用于函数调用、括号匹配和深度优先搜索。
- 队列:先进先出,一端入队、一端出队,常用于任务调度和广度优先搜索;双端队列可以在两端进行操作。
- 字符串 :本质上是字符序列,通常支持按下标访问;在 C++ 中需要注意
std::string的长度管理、扩容和小字符串优化等实现细节。 - 哈希表 :通过哈希函数把键映射到桶中,平均查找、插入和删除为 \(O(1)\),但需要处理哈希冲突,最坏情况可能退化为 \(O(n)\);
unordered_map和unordered_set就是典型实现。 - 树:具有层次关系。二叉搜索树可以按有序关系查找,平衡树如红黑树能保证查找、插入和删除为 \(O(\log n)\);堆适合快速获取最大值或最小值,常用于优先队列。
你刚才提到了红黑树,他如何保证平衡?
红黑树并不是要求左右子树高度完全相等,而是通过颜色约束把树高控制最长路径最多是最短路径的两倍。它主要满足五条性质:每个节点非红即黑;根节点是黑色;空节点视为黑色;红色节点的子节点必须是黑色;从任意节点到其所有叶子节点的路径上,黑色节点数量相同。
当插入或删除操作破坏这些性质时,红黑树通过重新染色和旋转进行修复。旋转会改变局部结构,但不会破坏二叉搜索树的有序性;重新染色则用于恢复黑高和红色节点约束。这样就能保证查找、插入和删除的时间复杂度都是 \(O(\log n)\)。
归并排序的是怎样的(画图讲解)?你有没有了解过他实际上适用于的地方?
归并排序的核心思想是分治:先把序列不断从中间拆分,直到每个子序列只剩一个元素;再利用双指针,把两个已经有序的子序列合并成一个更大的有序序列。
例如对:
[8, 4, 5, 7, 1, 3, 6, 2]可以这样处理: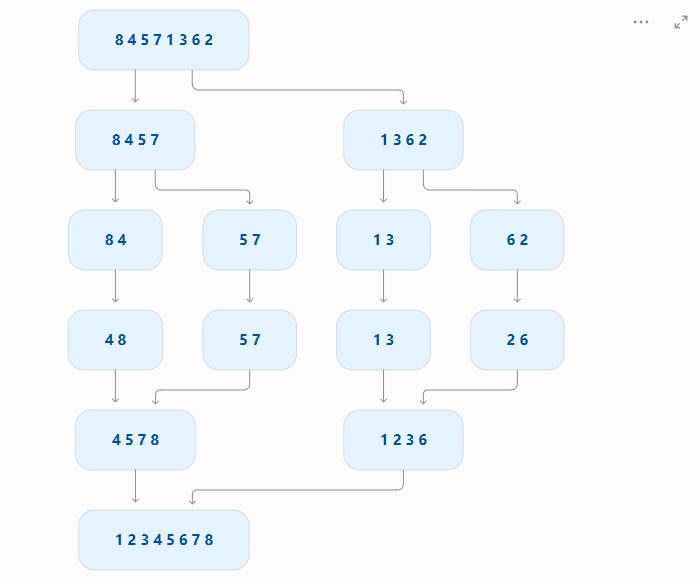
合并时分别设置两个指针,比较两个有序区间当前元素的大小,把较小的元素放入临时数组,直到两个区间处理完。它的时间复杂度在最好、平均和最坏情况下都是 \(O(n\log n)\),但通常需要 \(O(n)\) 的辅助空间。归并排序是稳定排序,也可以采用自底向上的非递归写法。
实际应用:
- 外部排序 :数据太大,内存放不下时,先分块排序,再从磁盘中逐段归并;数据库处理大型
ORDER BY、GROUP BY时会用到类似思想。 - 链表排序:链表不支持随机访问,但归并排序只需要顺序遍历和修改指针,比较适合。
- 需要稳定排序的场景:当两个元素关键字相同时,希望保持原有相对顺序时,可以使用归并排序。
- 并行或分布式排序:不同子区间可以并行排序,最后再统一合并。
操作系统的内存管理讲一下
操作系统的内存管理主要解决三个问题:如何给进程分配内存、如何隔离和保护进程、如何提高内存利用率。现代操作系统一般采用虚拟内存和分页机制。每个进程都有独立的虚拟地址空间,CPU 访问虚拟地址时,由 MMU 根据页表将其转换为物理地址;为了加快转换,会使用 TLB 缓存最近的页表项。
当访问的虚拟页没有装入物理内存时,会触发缺页异常,内核根据页表和磁盘映射把页面加载进来;如果物理内存不足,还会进行页面置换。操作系统还通过用户态和内核态、页表权限位实现读写和执行权限隔离,避免进程互相破坏。
在进程创建时,fork 通常采用写时复制,父子进程先共享物理页,只有某一方写入时才复制页面。用户程序中的 malloc 主要由用户态分配器管理,小块内存通常来自堆,大块内存可能通过 mmap 向内核申请。
操作系统的调度算法你知道哪些
- 优先级调度:优先执行优先级高的任务,可以抢占,也可以不抢占,但低优先级任务可能长期得不到执行,通常需要动态提升优先级避免饥饿。
- 时间片轮转(RR):每个任务轮流执行一个时间片,适合分时系统。时间片过大接近先来先服务,过小则上下文切换开销较大。
- 多级反馈队列:任务可以在不同优先级队列之间移动。交互性强、运行时间短的任务优先级较高,长期占用 CPU 的任务会逐渐降级,兼顾响应速度和公平性。
手撕一个业务场景(教师,学生,家长,其中教师有发放作业,批改作业,签到的功能;学生有)
cpp
#include <string>
#include <unordered_map>
#include <unordered_set>
#include <utility>

using Id = int;

// 作业
struct Homework {
    Homework(Id id, Id teacher, Id cls, std::string name)
        : id(id), teacherId(teacher),
          classId(cls), title(std::move(name)) {}

    Id id;
    Id teacherId;
    Id classId;
    std::string title;

    std::unordered_set<Id> submitted;   // 已提交的学生
    std::unordered_map<Id, int> scores; // 学生 -> 成绩
};

// 班级
class SchoolClass {
public:
    SchoolClass(Id id, Id teacher)
        : id_(id), teacherId_(teacher) {}

    void addStudent(Id student) {
        students_.insert(student);
    }

    bool signIn(Id teacher, Id student) {
        if (teacher != teacherId_ ||
            !students_.count(student)) {
            return false;
        }

        attendance_.insert(student);
        return true;
    }

private:
    Id id_;
    Id teacherId_;

    std::unordered_set<Id> students_;
    std::unordered_set<Id> attendance_;
};

// 教师
class Teacher {
public:
    explicit Teacher(Id id) : id_(id) {}

    Homework publishHomework(
        Id homeworkId,
        Id classId,
        const std::string& title
    ) const {
        return Homework(
            homeworkId,
            id_,
            classId,
            title
        );
    }

    bool gradeHomework(
        Homework& homework,
        Id student,
        int score
    ) const {
        if (homework.teacherId != id_ ||
            score < 0 || score > 100 ||
            !homework.submitted.count(student)) {
            return false;
        }

        homework.scores[student] = score;
        return true;
    }

    bool signIn(
        SchoolClass& schoolClass,
        Id student
    ) const {
        return schoolClass.signIn(id_, student);
    }

private:
    Id id_;
};

// 学生
class Student {
public:
    Student(Id id, Id classId)
        : id_(id), classId_(classId) {}

    bool submitHomework(Homework& homework) {
        if (homework.classId != classId_) {
            return false;
        }

        homework.submitted.insert(id_);
        homework.scores[id_] = -1;
        return true;
    }

    int getScore(const Homework& homework) const {
        auto it = homework.scores.find(id_);
        return it == homework.scores.end() ? -1 : it->second;
    }

    Id id() const {
        return id_;
    }

private:
    Id id_;
    Id classId_;
};

// 家长
class Parent {
public:
    explicit Parent(Id id) : id_(id) {}

    void bindChild(Id student) {
        children_.insert(student);
    }

    bool canView(Id student) const {
        return children_.count(student);
    }

private:
    Id id_;
    std::unordered_set<Id> children_;
};
两个栈如何实现一个队列
可以用一个输入栈和一个输出栈,通过倒栈反转元素顺序,实现队列的先进先出。
入队时,直接把元素压入输入栈。出队时,如果输出栈非空,就直接弹出它的栈顶;如果输出栈为空,就把输入栈中的元素依次弹出、压入输出栈,再弹出输出栈的栈顶。这样最早入队的元素就会先出队。如果两个栈都为空,说明队列为空,需要处理空队列情况。
什么是面向对象?
面向对象是一种以对象为基本组织单元,把数据和操作数据的行为封装在一起,并通过对象之间的协作完成业务的编程思想。C++ 中通常概括为封装、抽象、继承和多态:封装通过 private、public 等访问控制保护对象内部状态;抽象只暴露必要接口、隐藏实现细节;继承用于复用和扩展已有类;多态则允许通过统一接口调用不同对象的具体实现,运行时多态通常依靠基类指针或引用配合 virtual 实现,编译期也可以通过模板和重载实现静态多态。
设计一个类一般要遵循哪些原则?
设计一个类时,我通常遵循"高内聚、低耦合"和"职责单一"这两个核心原则。具体来说:
-
单一职责:一个类只负责一类相对独立的事情,避免把业务、数据库和日志等功能混在一起。
-
封装不变条件:隐藏内部数据和实现细节,只通过清晰、最小化的接口操作对象,保证对象始终处于合法状态。
-
面向接口编程:减少对具体实现的依赖,便于替换和测试。
-
开闭原则:新增功能尽量通过扩展实现,减少直接修改已经稳定的代码。
-
优先组合而不是继承:只有确实存在"is-a"关系时才使用继承,避免复杂的继承层次。
-
明确资源所有权:在 C++ 中优先使用 RAII 和智能指针管理资源,并尽量遵循 Rule of Zero,减少手动管理拷贝和析构。
类的五个设计原则
类设计中常说的五个原则可以概括为 SOLID:
- 单一职责原则(SRP):一个类只承担一类职责,应该只有一个引起它变化的原因。
- 开闭原则(OCP):对扩展开放,对修改关闭。新增功能尽量通过扩展实现,减少修改稳定代码。
- 里氏替换原则(LSP):派生类必须能够替换基类使用,并且不改变程序原有的正确性。
- 接口隔离原则(ISP):接口要小而专一,调用方不应该被迫依赖自己不需要的方法。
- 依赖倒置原则(DIP):高层模块和底层模块都应该依赖抽象,而不是直接依赖具体实现。
设计模式了解哪些?
工厂模式常用于解耦对象创建,策略模式适合动态切换算法,观察者模式适合事件通知
大小端的区别以及与网络编程的联系
大小端描述的是多字节数据在内存中的字节排列顺序,与位的高低顺序无关。
以 0x12345678 为例:
- 大端 :高位字节放在低地址,内存顺序为
12 34 56 78; - 小端 :低位字节放在低地址,内存顺序为
78 56 34 12。
x86 机器通常使用小端。网络编程中为了保证不同平台之间的数据能够正确解析,网络协议通常规定使用网络字节序,也就是大端字节序。
因此发送和接收多字节整数时,需要在主机字节序和网络字节序之间转换:
uint32_t net_value = htonl(host_value); // 主机序转网络序
uint32_t host_value = ntohl(net_value); // 网络序转主机序
对于 16 位整数使用 htons 和 ntohs。这样无论通信双方使用大端还是小端,都能正确解释数据。
网络编程的调试工具以及连接失败的具体排查方法
ping:检查基本网络连通性
netstat看本机端口是否监听、被哪个进程占用;
检查ip地址等协议格式是否写对
如何解决内存泄漏问题
RAII 和智能指针管理动态资源,例如独占所有权使用 std::unique_ptr,共享所有权使用 std::shared_ptr,避免手动 new/delete。
口述用C++11设计一个内存池
提前申请一大块连续内存,再把它切分成多个等大的内存块,用空闲链表管理;分配时直接从链表头取一块,释放时把内存块重新挂回链表,避免频繁调用 new/malloc,从而降低系统调用和碎片开销。使用时,如果存储的是对象,需要使用定位 new 构造对象,释放时显式调用析构函数:如果对象大小不固定,可以设计多个不同规格的内存池,例如 16、32、64、128 字节,按请求大小选择对应的池;如果并发访问,还需要给空闲链表加锁,或者为每个线程设置本地内存池,减少锁竞争。