作者:来自 Elastic Jeffrey Rengifo
使用 EDOT 收集器收集审计日志,然后在审计员要求你确认之前,确认365天的保留策略确实已生效。
Elasticsearch 在摄取时将原始日志转换为结构化、可搜索的数据。按照收集和分析日志教程,了解完整流程。立即开始免费云试用,或在你的本地计算机上试用 Elastic。
用于在实时数据上还原用户活动的 Elasticsearch 查询语言( ES|QL )查询,无需修改即可在已挂载的可搜索快照上运行,这正是365天审计日志保留策略能够切实执行的原因。你调查一年前事件的方式,与调查昨天事件的方式相同。
本文将追踪某家公司管理控制台中的六个审计事件,了解它们如何通过 Elastic 的 OpenTelemetry 发行版( EDOT )收集器进入专用数据流。其中涉及一位名为 alex 的用户,他两次登录失败,第三次成功登录,随后尝试更改角色。我们用一条 ES|QL 查询还原这一时间线,并读取保留策略,确认它已生效。然后,我们在由快照支持的索引上重新运行同一条查询。返回的证据采用你可以交给审计员并加以解释的形式。
前提条件
- Elasticsearch 和 Kibana 9.5+
- Docker,用于运行
elastic-otel-collector:9.5容器 - 由超级用户创建的 API 密钥
你可以在这里找到配套笔记本。它复现了本文的整个实验,包括收集器配置、可搜索快照以及中间的各个步骤,并在最后执行清理。
审计日志能告诉你哪些应用日志无法提供的信息
应用日志通常说明软件的运行情况,例如超时、异常,甚至连接失败。审计日志通过记录执行者、操作、目标、结果和时间,明确责任归属。它们也能帮助调试,但其价值在于还原活动,并展示控制措施如何发挥作用。
完整记录一次 Kubernetes 角色绑定变更
在 Kubernetes 中,角色定义权限,角色绑定则将这些权限授予命名空间内的某个身份。当审计策略包含这些资源时,对两者的变更都可以被审计。下面是一次真实的角色绑定创建操作,记录于一个独立的 Kubernetes 1.35.0 实验环境中。该事件通过 OpenTelemetry( OTel )收集,并在 Elasticsearch 中查询。
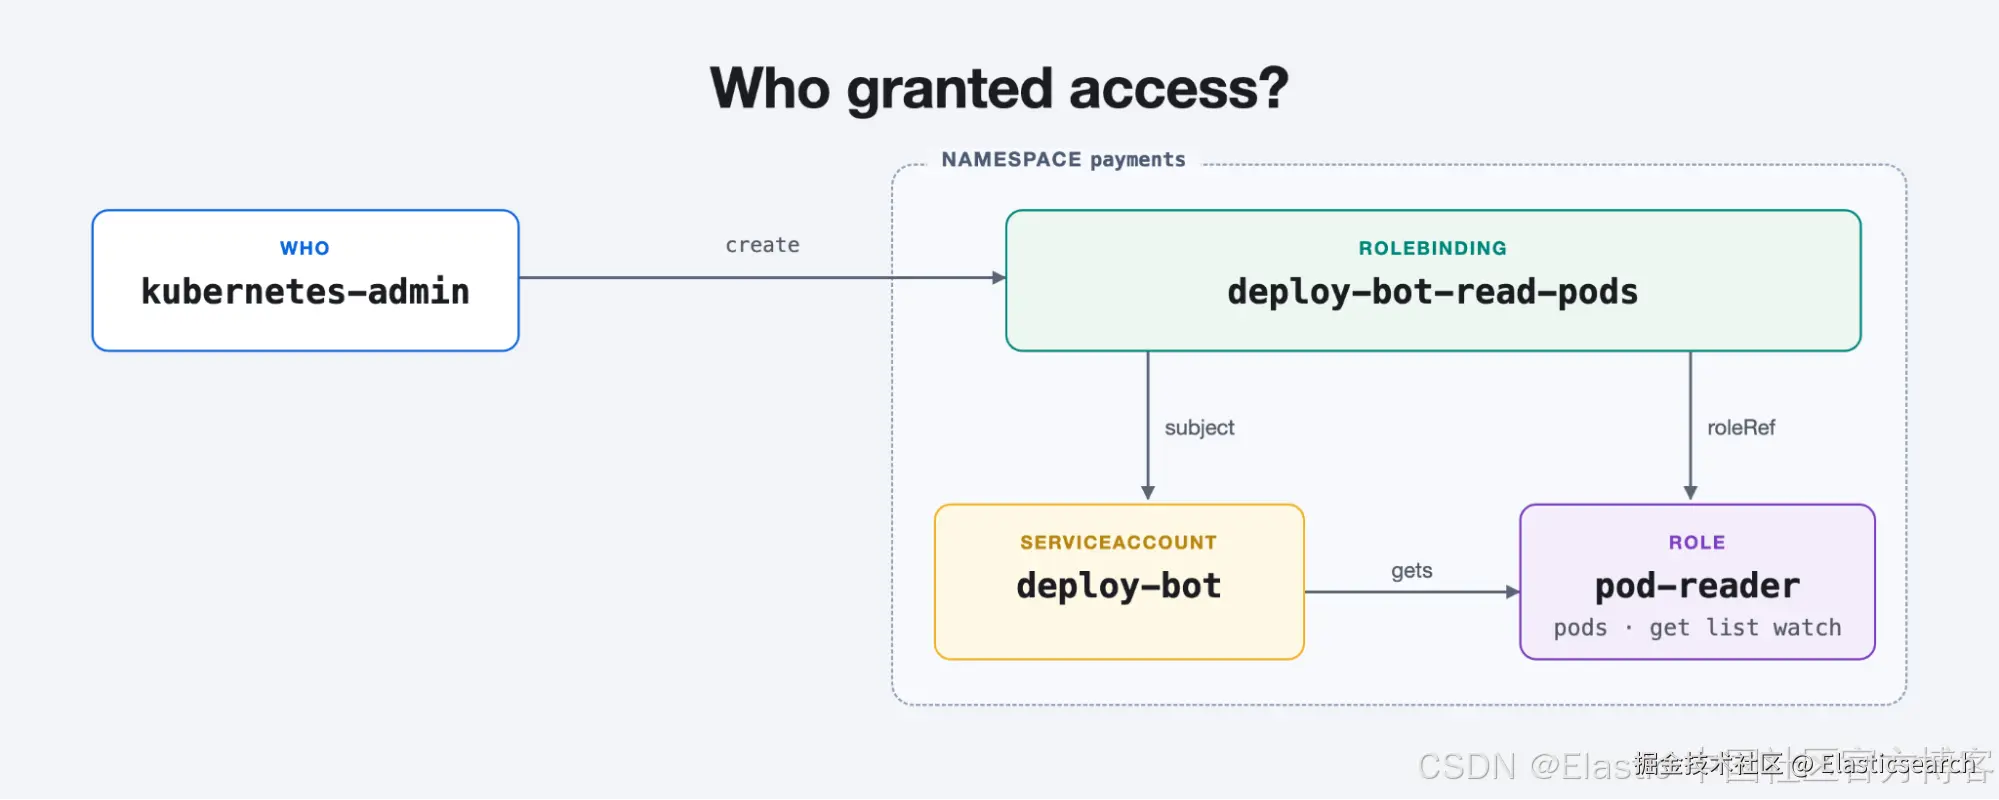
这次成功的请求将 payments 中现有的 pod-reader 角色授予 deploy-bot 服务账户。角色绑定的主体和角色引用来自请求正文,由本实验有针对性地配置的 Request(请求)审计级别记录。仅使用 Metadata(元数据)日志记录会省略该正文。
审计日志的来源
常见来源涵盖不同方面的信息:
| 来源 | 可以回答的问题 |
|---|---|
| Kubernetes API 审计日志 | 谁请求了资源变更, API 服务器如何响应? |
| 云提供商的操作记录 | 哪个主体对哪个资源执行了 API 操作? |
| 身份验证系统 | 谁成功登录或身份验证失败?谁更改了权限? |
| 数据库审计日志 | 谁访问了敏感对象或更改了数据库权限? |
收集日志首先要在源头启用适当的事件。云数据访问事件可能需要单独配置;数据库慢查询日志并不能提供完整的访问审计。有关 Kubernetes 的配置,请参考现有的托管 Kubernetes 审计日志教程。
审计日志流水线的四项要求
以下四项要求决定了审计流水线的设计:
| 要求 | 设计决策 |
|---|---|
| 长期保留 | 将审计数据保存在具有明确保留策略的数据流中,与短期保留的运维日志分开。 |
| 不可变性 | 明确哪些人不应有权修改或删除记录,以及这一限制应持续多久。只读索引无法阻止具有特权的管理操作。 |
| 篡改可检测性 | 保存原始记录和受到独立保护的验证材料,以便检测记录变更或缺失。 |
| 访问控制 | 将收集、调查和保留策略管理职责分开;记录对这些控制措施的变更。 |
对于系统与组织控制2( SOC 2 )或ISO/IEC 27001,日志为你的控制措施提供证据支持;仅仅 存储 日志并不意味着符合合规要求。你需要就以下事项达成一致:记录哪些活动、每份副本保留多久、谁可以检索,以及如何处理例外情况或法律保留。这两个框架都没有为本实验规定普遍适用的365天保留要求。
搜索和保存需要相互补充的控制措施。例如,CloudTrail 完整性验证使用经过签名的摘要文件,而且必须实际验证这些文件。如果要求采用一次写入的保留方式,应使用适当的控制措施设计源数据归档,例如S3 对象锁定。已建立索引的 JSON 字符串 不能替代该归档或其验证材料。
如何使用 EDOT 收集器收集审计日志
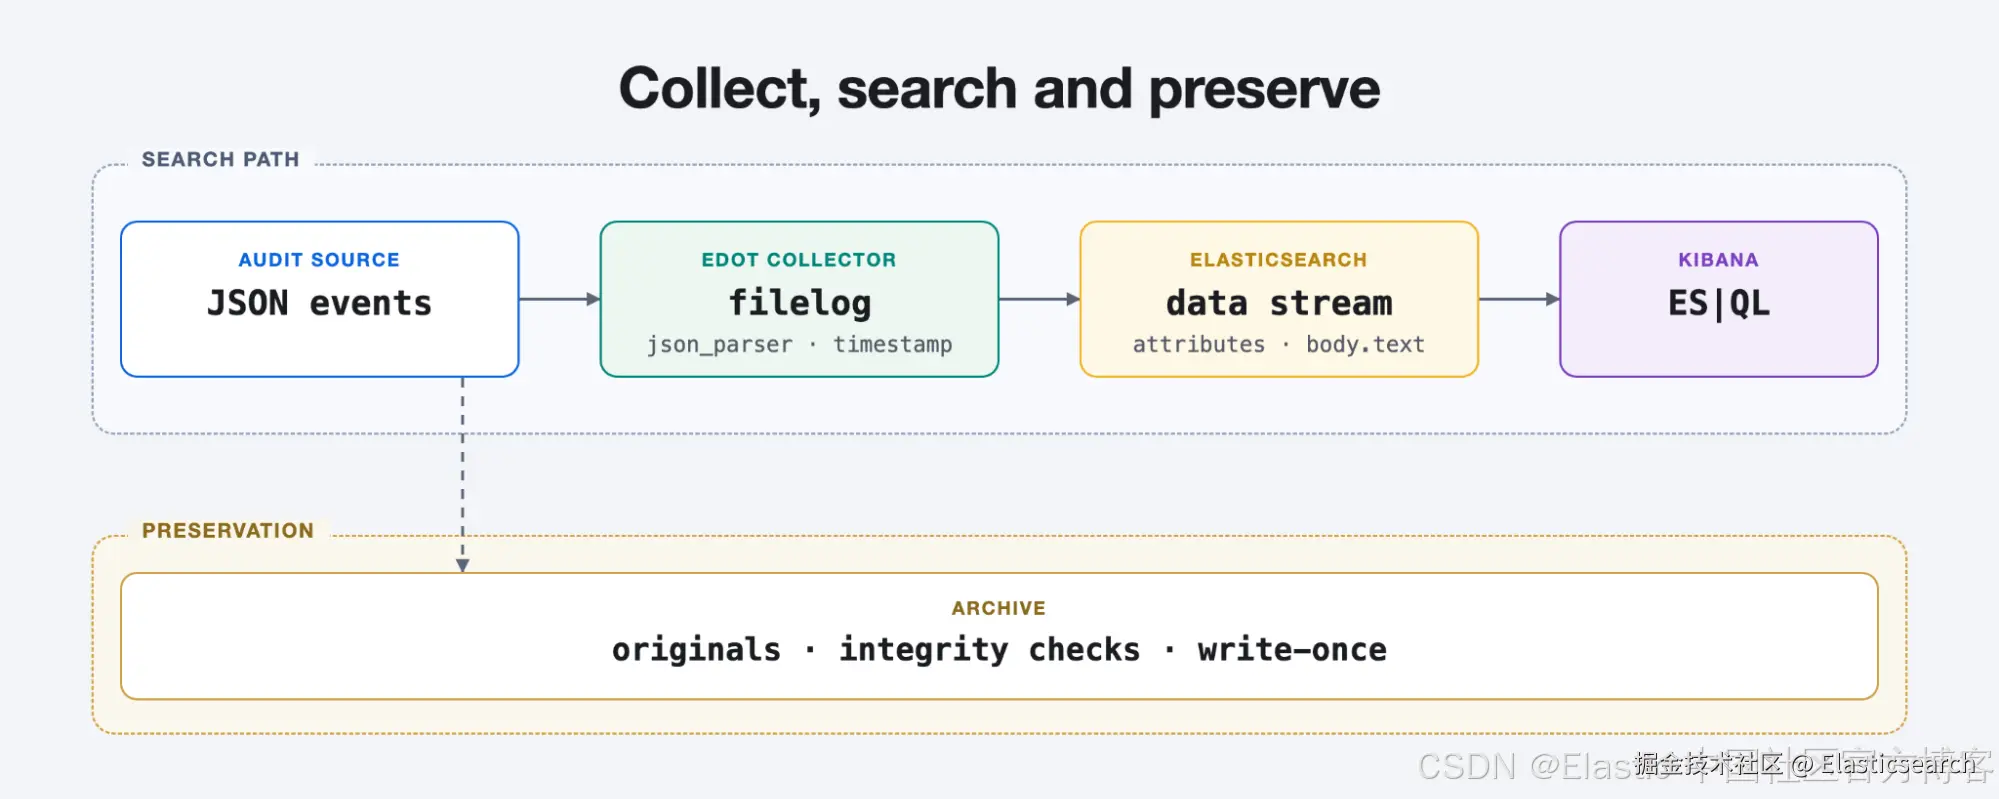
保留策略演示使用六条虚构的应用审计 JSON 事件:四条属于用户 alex,两条属于另一位用户 priya,以便按执行者筛选时有可排除的记录。EDOT 收集器以容器形式运行,并将数据发送到 Elastic 托管云( ECH )上的 Elasticsearch 和 Kibana 9.5.3。配置基于 Elastic 文档中的文件日志收集和 JSON 解析流程:使用带有 json_parser 操作器的 filelog 接收器、设置 data_stream.dataset 和 data_stream.namespace 的资源处理器,以及采用 otel 映射模式的 elasticsearch 导出器。本文重点介绍设计决策和结果;完整配置和命令见配套笔记本。
为什么 json_parser 使用 parse_to: attributes
收集器解析源 时间戳 和字段,然后将记录发送到专用的 logs-audit_demo.otel-lab 数据流。导出器根据数据集和命名空间构建该名称,并在数据集名称后附加 .otel。
文档示例使用 parse_to: body,而本实验的 json_parser 使用 parse_to: attributes,因此解析后的值存放在 attributes 下,原始 JSON 字符串则保留在 body.text 中。使用 parse_to: body 时,字段会存放在 body.structured 中,原始字符串则会丢失。在本次测试中,存储的六个字符串均与测试样本中的对应行一致。基于 Elastic 通用模式( ECS )的集成可以使用 user.name 等根字段,因此在复用查询前,请检查数据模式。
用一条 ES|QL 查询还原执行者的时间线
在 Kibana 的发现页面中,选择 ES|QL,即 Elastic 的管道式查询语言。时间选择器使用 dateFormat:tz 高级设置指定的时区,默认采用浏览器时区。因此,在输入从 2026-09-07T04:59:00Z 到 2026-09-07T05:06:00Z 的绝对时间范围之前,请先在堆栈管理 > 高级设置中将时区设为协调世界时( UTC )。然后运行以下查询:
sql
`

1.  FROM logs-audit_demo.otel-lab
2.  | WHERE attributes.user.name == "alex"
3.  | SORT @timestamp
4.  | KEEP @timestamp, attributes.event.action, attributes.event.outcome,
5.         attributes.audit.target, attributes.source.address
6.  | LIMIT 100

`AI代码解释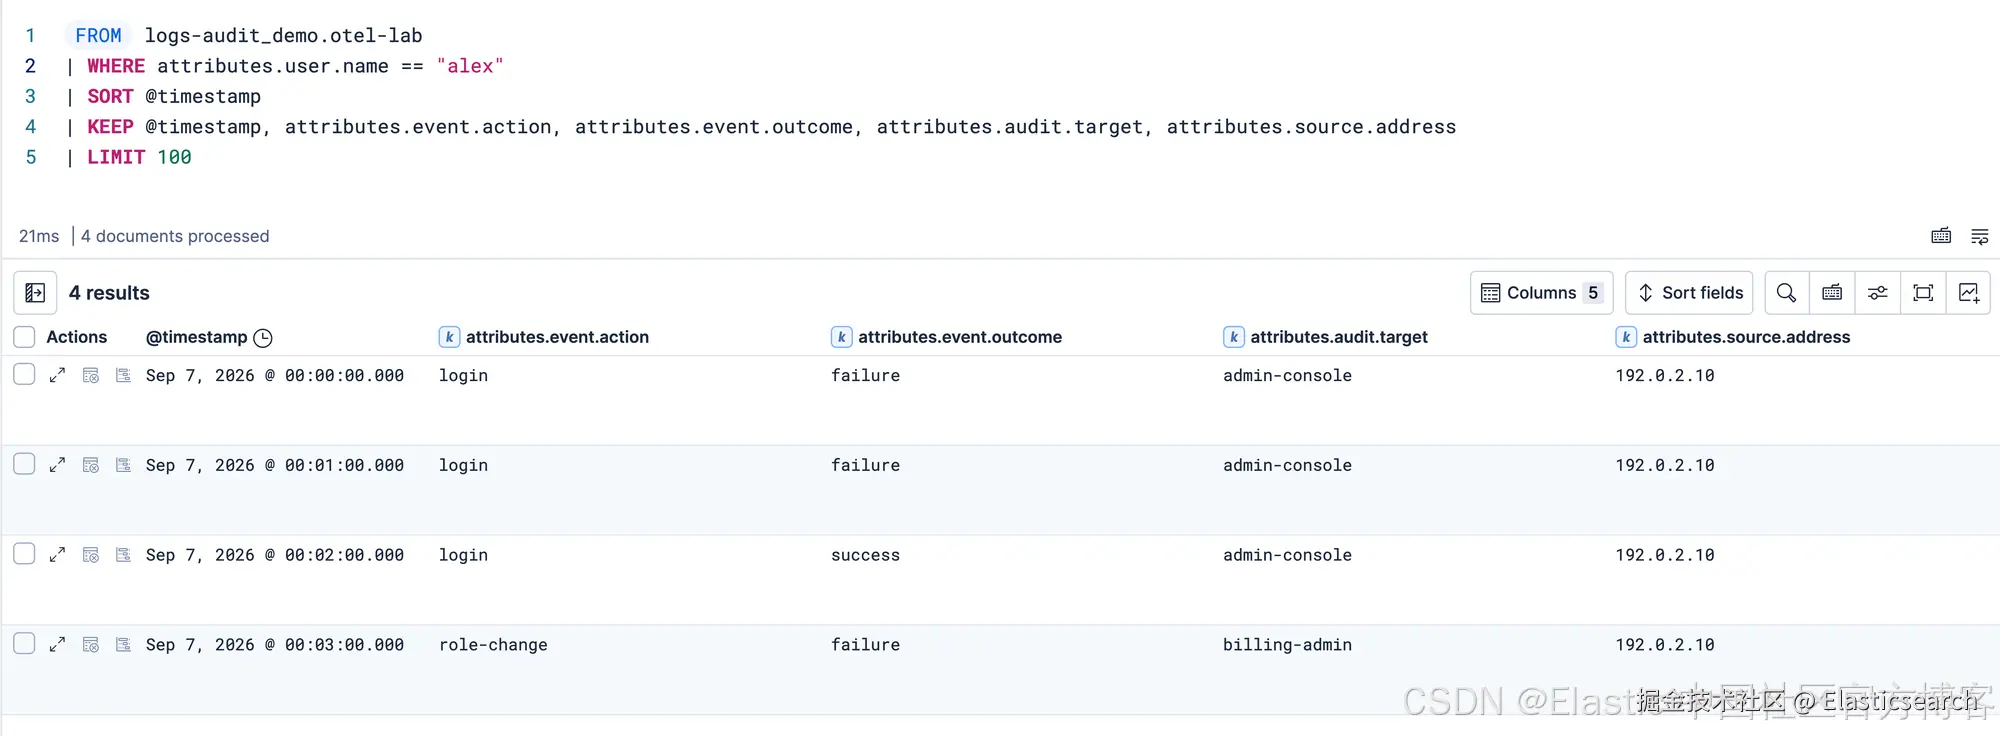
请注意,最后一个事件是一次失败的角色变更。目前,我们只知道 alex 尝试更改角色但遭到拒绝,这并不等同于权限已变更或账户已被入侵。要查明发生了什么,下一步应查看同一租户、同一时间范围内的身份提供商活动和资源活动。
将截图与查询进行比较时,请记住,测试样本使用协调世界时( UTC ),而 Kibana 按浏览器时区显示时间戳(本例为 UTC−05:00 )。因此,各行显示的是00:00,而时间范围是按协调世界时设置的。
发现页面的时间选择器会限制此查询的时间范围; API 客户端需要显式的时间戳筛选条件,笔记本中已添加该条件。向审核者提交证据时,请记录:
- 查询。
- 协调世界时时间范围。
- 来源。
- 检索时间。
- 结果数量上限。
LIMIT 100 提供的是有数量限制的调查视图,并非完整导出。
确认每个审计事件都已到达
在收集器正常重启前后,数据流都包含六条记录,且具有六个不同的事件标识符,因为 filelog 接收器将文件偏移量、导出器将发送队列保存在 file_storage 扩展中。在大规模运行时,还应监控 数据源 覆盖情况、解析失败、队列饱和情况和传输延迟。这项六事件检查是功能测试,并非摄取性能基准测试,也不保证每个事件恰好处理一次。
设置可验证的日志保留策略
保留设置应当可以验证。在 Elastic 托管云( ECH )上,内置的 logs-*-* 模板将新数据流交由 logs 索引生命周期管理( ILM )策略管理,因此本实验为其数据流配置了专用索引模板,具体如下:
- 优先级为500,高于同样匹配该数据流名称的内置日志模板,因此 Elasticsearch 会应用此模板。
- 复制内置
logs-otel@template的组件列表。 - 仅匹配
logs-audit_demo.otel-*。 - 将
index.lifecycle.prefer_ilm设为false。 - 定义365天的数据流生命周期。
随后,数据流 API 报告其后备索引由数据流生命周期管理,读取生命周期配置时返回 effective_retention: 365d:
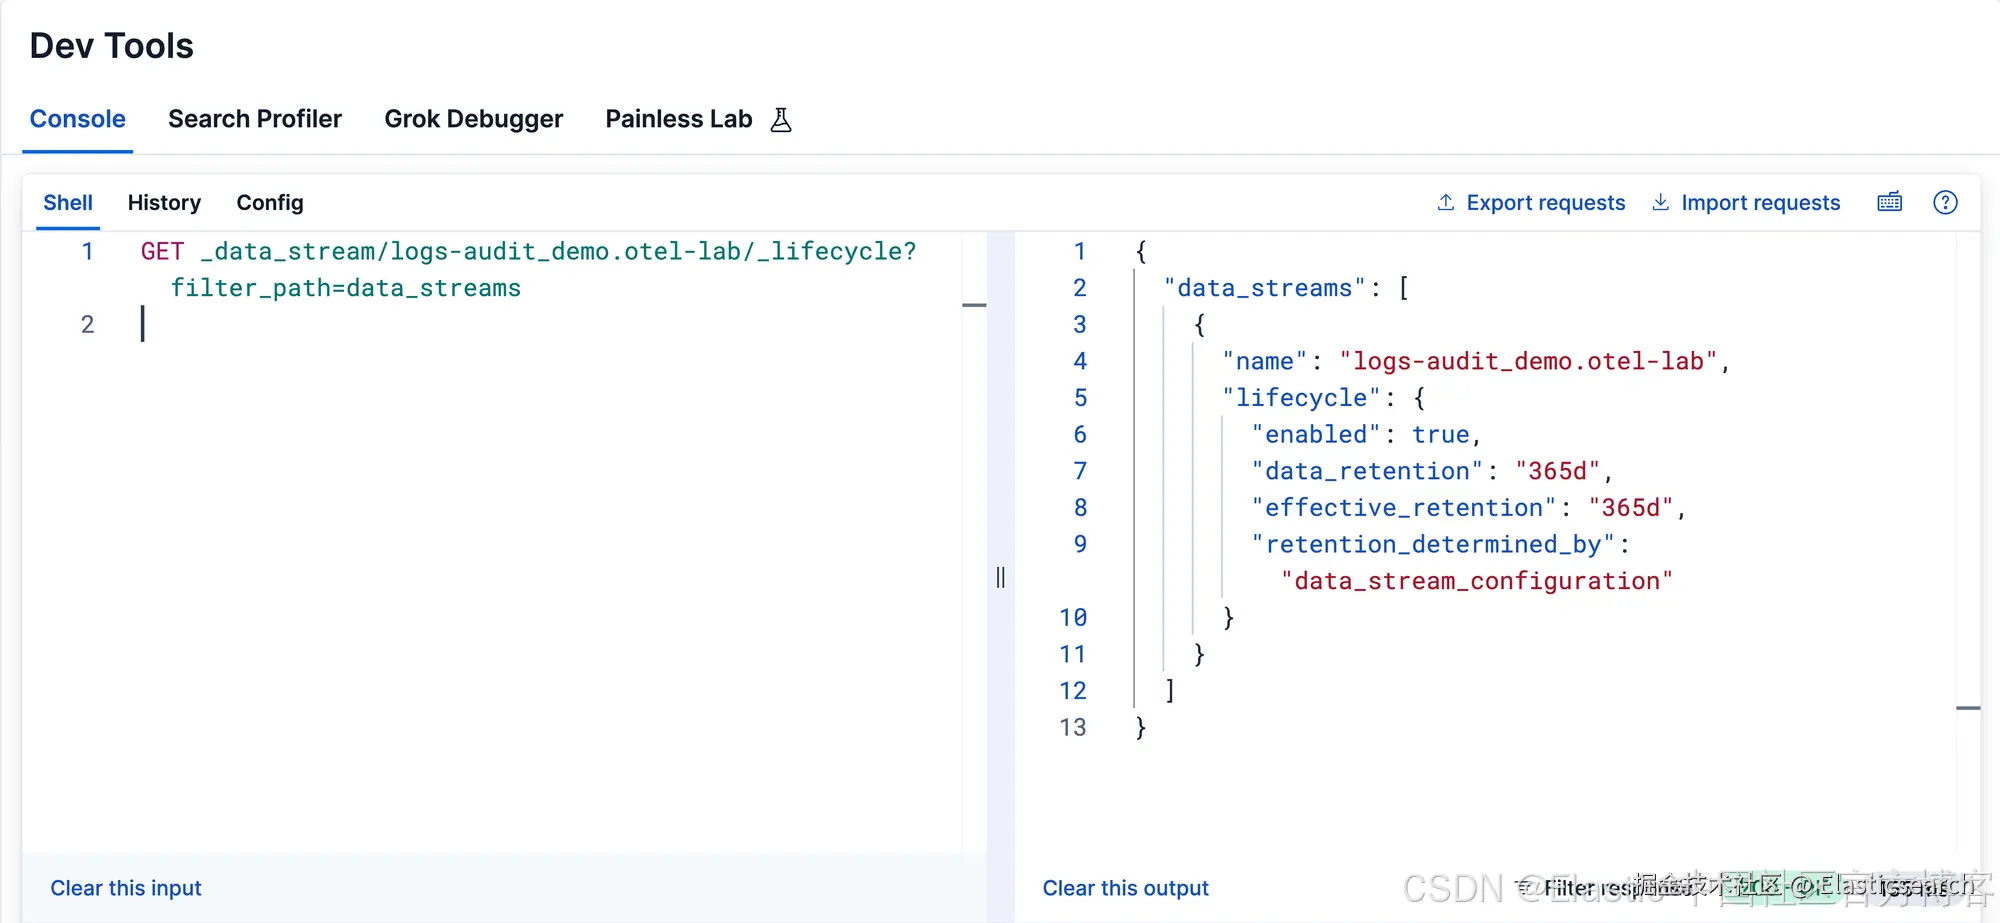
为什么你的审计数据流会忽略你设置的保留策略
数据流生命周期保留是一种基于后备索引生命周期时间安排的最低保留机制,并非每个事件的精确删除期限。成功读取配置只能证明配置已生效,不能证明数据能够持续可用一年。演练检索必须保留的最早记录,并定期检查数据源覆盖情况。有关保留设置界面及其与索引生命周期管理( ILM )的比较,请参阅使用数据流管理保留策略。
长期日志保留的容量规划
长期保留也会改变容量规划。每日摄取量乘以保留天数,可以得出初步的原始数据量;映射、压缩、副本、查询并发量和数据层分配都会影响实际所需的资源。应使用具有代表性的调查场景,针对符合实际情况的不同数据存放时长进行容量估算和测试。
使用可搜索快照查询较早的审计日志
可搜索快照使由快照支持的索引能够继续通过 Elasticsearch 查询。完全挂载的索引可以从冷数据层提供较早的数据;部分挂载的索引则使用冻结数据层中的共享本地缓存。这为近期和较早的证据提供了统一的查询方式,但存储与检索之间的权衡仍需根据你的工作负载进行测试:
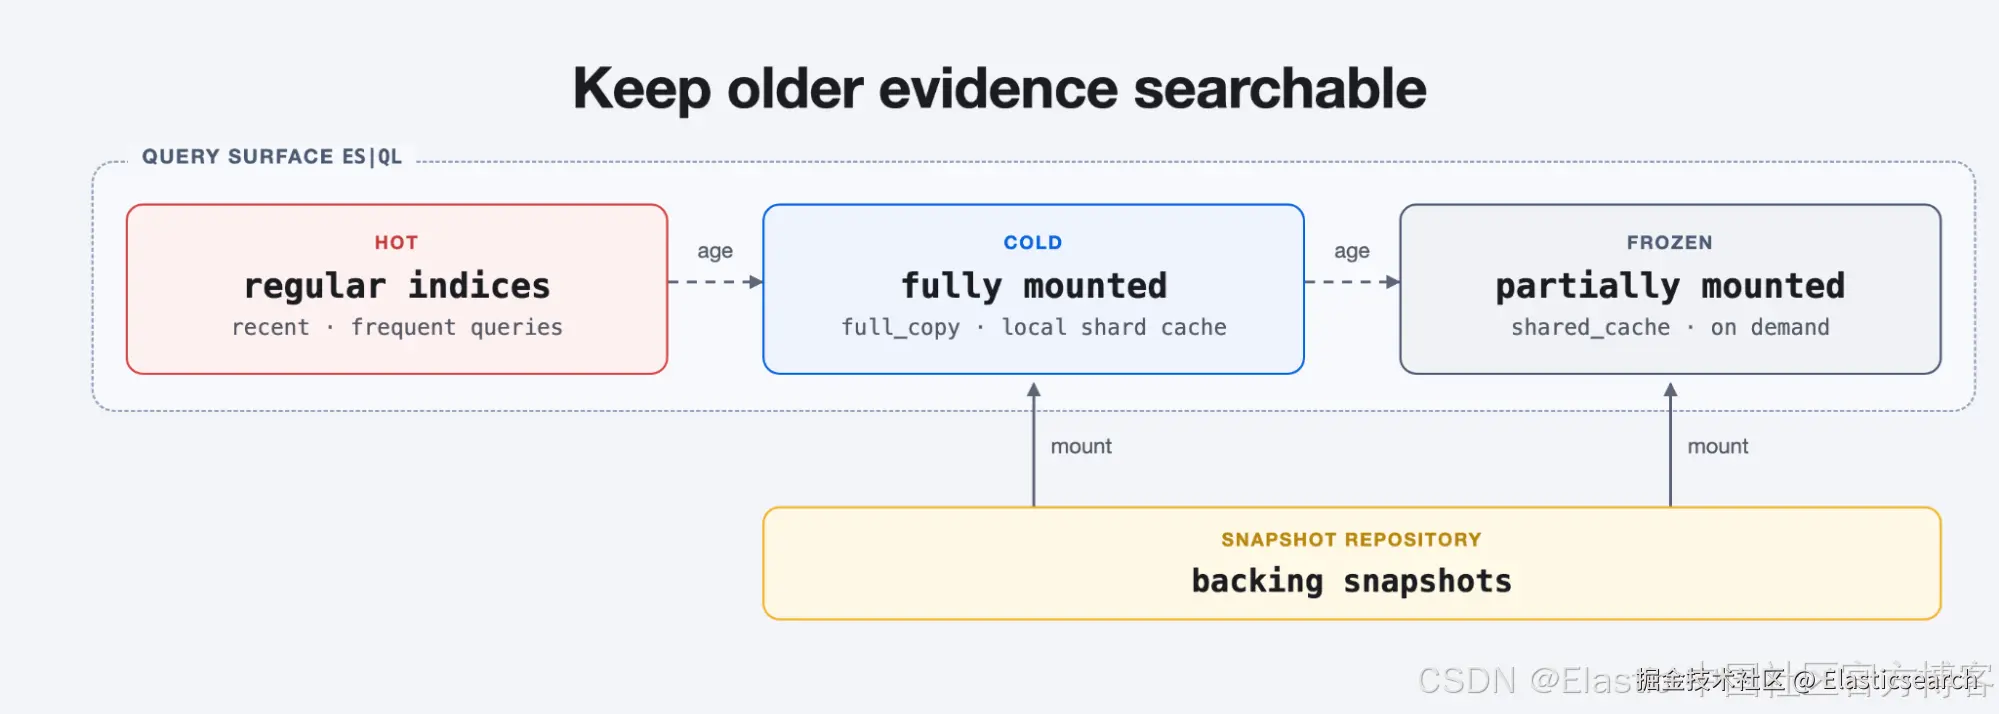
审计实验为包含六个事件的后备索引创建并挂载了快照,然后重新运行了同一条按执行者筛选的查询:
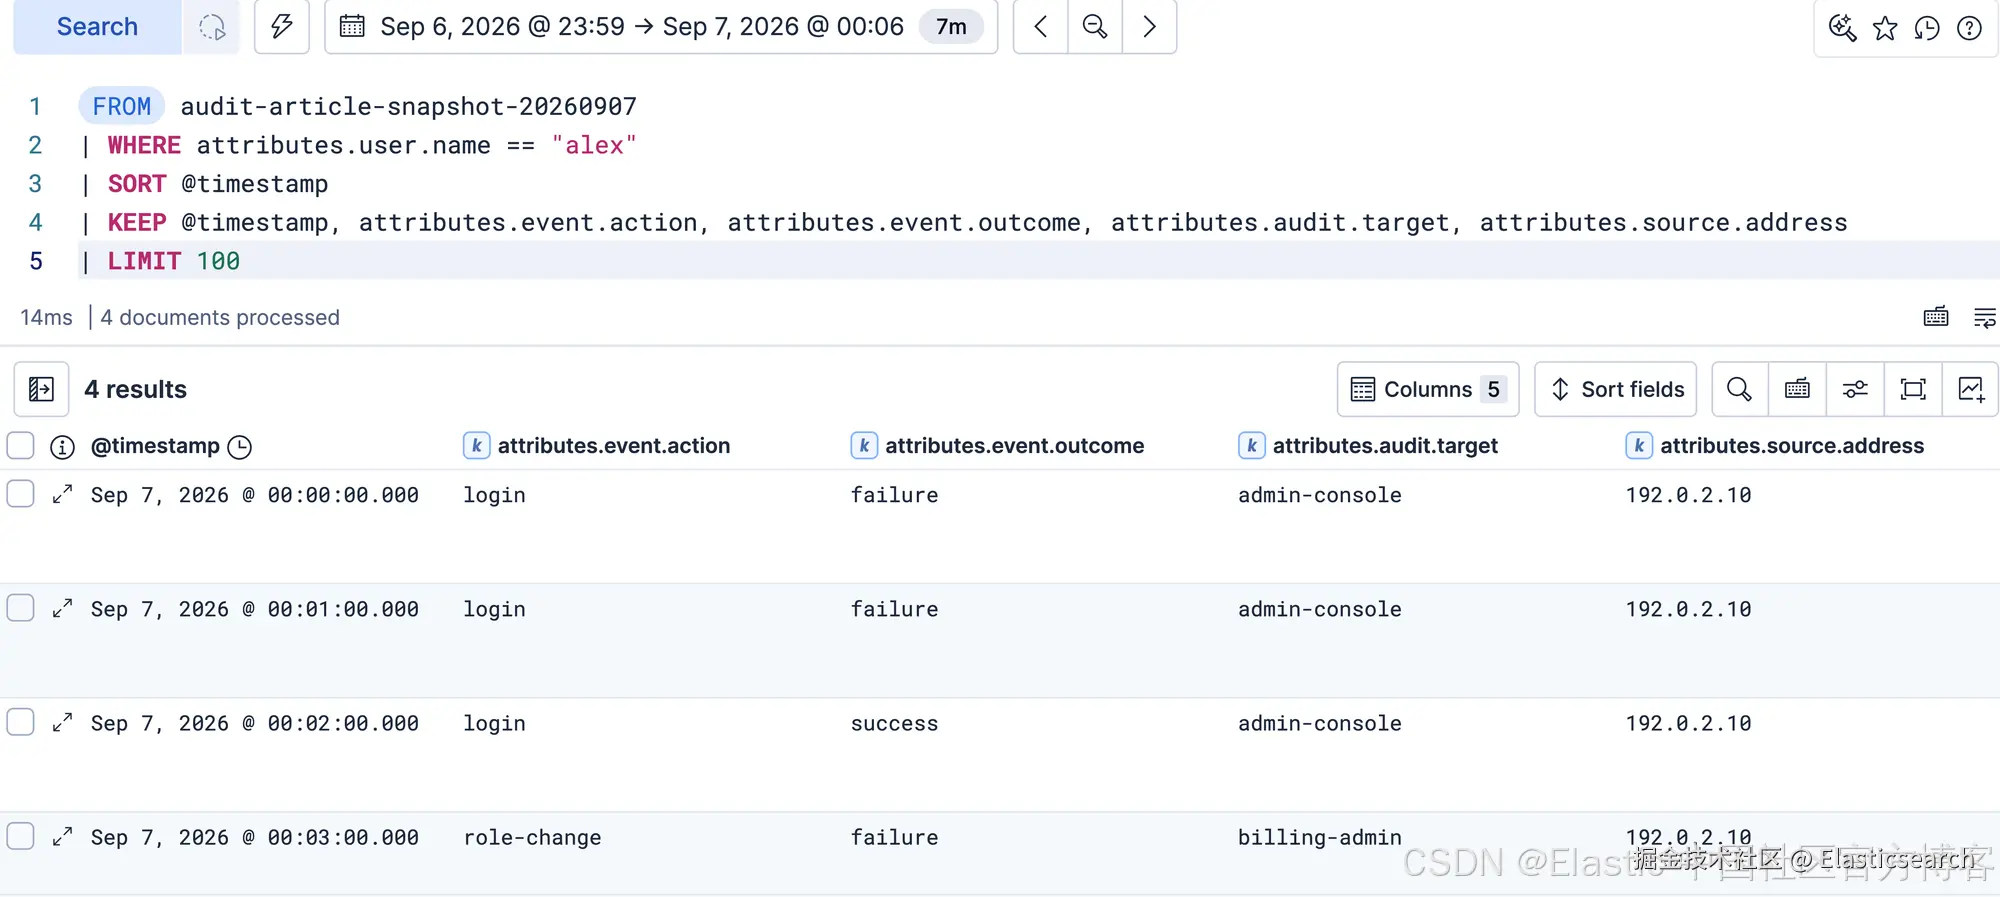
查询返回了相同的四个事件。本实验在可用的热数据节点上使用 full_copy 完全副本模式,并采用企业版许可证;没有对冷数据层或冻结数据层的成本或延迟进行基准测试。只要挂载的索引仍在使用其后备快照,该快照就必须保持可用,本地缓存也不能充当备份。实验中单独挂载的索引还需要自己的保留和清理计划。
谁可以读取和更改你的审计日志
使用基于角色的访问控制,授予调查人员对所需审计数据的 read(读取)和 view_index_metadata(查看索引元数据)权限,以及目标 Kibana 空间中发现页面的读取权限。将保留策略管理和快照管理分配给独立的角色。角色权限会叠加,因此读取者角色不会撤销其他角色授予的权限。
收集器的 API 密钥仅拥有其数据流上的 create_doc(创建文档)和 auto_configure(自动配置)权限,权限检查 API也确认它在该数据流上没有 index(索引)、 write(写入)、 delete(删除)或 manage(管理)权限。这限制了收集器的权限,但并不能阻止管理员修改记录。还应根据部署和订阅要求,为证据平台本身规划 Elasticsearch 和 Kibana 审计日志记录。
将 Kubernetes 审计日志与容器运行时数据关联
作为与安全实验室内容的衔接,将 Kubernetes 审计日志与容器运行时数据关联展示了如何将 API 活动与工作负载内部运行的内容联系起来。稳定的身份标识和资源上下文使这种关联成为可能。我们的小型应用测试样本演示了时间线还原,但并未验证这些 Kubernetes 检测规则。
从哪里开始管理审计日志
从一个审计数据源和一个几个月后你仍必须回答的问题开始。验证数据传输,保存所需的原始记录,演练对近期数据和保留数据的搜索,并审查谁可以更改证据处理流程。 Elastic 将收集、结构化调查、可搜索的数据保留和限定范围的访问整合在一起;你的策略则定义了这些能力必须保存哪些证据。
原文:Audit logging in Elasticsearch: Verify 365-day retention | Elastic Observability Labs