一、写在前面
运行说明:本文档为教学型实操流程文档。第 3--5 节的代码需在具备数据与运行环境的服务器终端或 RStudio 中按序执行,大家可参考给出代码,将数据路径修改为自己的实际路径, 其中标注"(终端执行)"的命令不参与 Knit;其余 R 代码块在数据就绪后可执行复现。第 6 节结果表为既往一次运行的真实输出,可作为复现结果的对照。
1 分析概述
1.1 研究背景
肝细胞肝癌(LIHC)的发生发展与体细胞基因突变密切相关。现有肿瘤基因组分析多聚焦于突变对蛋白编码序列的改变(错义、无义突变等);然而,大量位于编码区及邻近区域的单碱基突变可通过破坏或新增mRNA剪接位点,造成外显子跳跃、内含子滞留及异常剪接转录本的产生,最终导致基因功能紊乱。此类剪接层面的变异效应在常规突变注释中易被忽略。因此,系统性预测肝癌体细胞突变的剪接扰动效应,对补充肿瘤突变致病机制、挖掘潜在功能性突变具有重要意义。
1.2 工具介绍
SpliceAI是一款基于深度神经网络的剪接变异预测工具,用于评估单碱基突变对人类mRNA剪接模式的影响。该工具依托大规模基因组与转录组数据训练,可基于局部DNA序列特征,定量预测突变对剪接供体、剪接受体位点的扰动强度,已广泛应用于肿瘤及遗传病的功能性突变注释。本研究采用 GPU 加速模式完成大批量突变位点的预测。
设备受限的同学可参考:AI时代人人都在写代码,但是你有设备去运行代码吗?
1.3 基本原理
SpliceAI 采用基于序列对比的深度学习预测方法:输入突变位点上下游参考基因组序列与突变后序列,经神经网络模型评估突变是否改变原有剪接位点,或产生新的剪接位点,最终输出4项取值区间为0--1的剪接损伤分值(DS 值):
-
DS_AG:突变产生新的剪接受体位点;
-
DS_AL:突变破坏原有剪接受体位点;
-
DS_DG:突变产生新的剪接供体位点;
-
DS_DL:突变破坏原有剪接供体位点。
本研究取四项分值的最大值DS_max作为综合剪接损伤指标,以领域通用阈值DS_max ≥ 0.5判定该突变具有潜在高剪接破坏效应,可能引起异常mRNA剪接。需说明的是,上述结果均为算法预测,须经转录组数据或实验验证后方可确认。
1.4 整体分析流程
本研究基于TCGA-LIHC体细胞突变数据,完成从数据预处理、剪接预测、结果解析到队列统计的全部分析,具体步骤如下:
① 数据获取:从UCSC Xena数据库下载TCGA-LIHC体细胞突变TSV表格,数据包含肿瘤样本突变位点、基因注释、样本条形码等信息,同时包含SNP与INDEL变异。
② 数据预处理与VCF构建:在R中对原始突变数据清洗,过滤全部INDEL变异,仅保留单碱基SNP;去除染色体 "chr" 前缀,使其与GRCh38参考基因组命名规范一致;构建满足SpliceAI运行要求的简易VCF文件作为预测输入。
③环境搭建与GPU加速配置:构建Python 3.8专属conda环境,安装SpliceAI及适配版本的TensorFlow;解决服务器高版本驱动与旧版本TensorFlow的兼容问题,通过配置动态库搜索路径(LD_LIBRARY_PATH)启用GPU加速,并依托tmux实现后台稳定运行。
④ SpliceAI批量剪接预测:基于GRCh38参考基因组完成全部SNP位点的剪接效应预测,输出携带剪接分值信息的结果VCF;运行过程中自动过滤格式异常的残留INDEL位点,属预期现象。
⑤ 结果解析与样本关联:在R中读取输出VCF,提取四项剪接分值并计算 DS_max;通过"染色体--位置--参考碱基--突变碱基"唯一键值与原始样本信息匹配,完成突变位点与肿瘤样本、对应基因的关联注释。
⑥ 统计分析与结果汇总:区分"突变--样本事件"与"独立突变位点"双统计口径,筛选高剪接破坏性变异,统计携带高风险突变的肿瘤样本数量,汇总高频受扰动基因,完成TCGA-LIHC队列剪接突变特征的初步分析。
2 运行环境配置
2.1 硬件环境
本分析的全部剪接预测运算部署于Linux远程服务器。服务器搭载NVIDIA RTX 3080 GPU,支持CUDA并行加速,可满足大批量突变位点的预测需求;配备大容量内存与多核CPU,保障基因组数据读写与批量运算稳定执行。任务全程通过SS 远程操作,并采用tmux虚拟终端会话维持后台进程,避免SSH断开导致运算中断。
不推荐用自己的电脑做生信,不想让自己电脑负重前行的同学,也可以看看服务器处理数据的优势,按需选用适合自己的计算资源:
共享(经济实惠):有root权限的共享服务器,报我名字立减200¥
独享(省电省心):生信分析不求人
访问链接:https://biomamba.xiyoucloud.net/
更多内容可咨询**Biomamba_zhushou**
2.2 系统与环境管理
采用Miniconda3实现项目环境隔离,独立构建专属运行环境,以避免系统软件与多项目依赖间的版本冲突。依据SpliceAI及配套深度学习框架的兼容要求,选用Python3.8构建运算环境,单独创建并激活spliceai_env专用分析环境,所有预测相关依赖均在此独立环境中安装与运行。
2.3 核心软件与依赖配置
本分析核心依赖剪接预测工具与深度学习框架,需严格匹配兼容版本:安装 SpliceAI 主程序用于突变剪接效应预测,配套安装TensorFlow 2.10与Keras 2.4.3稳定版本。
服务器存在高版本NVIDIA驱动与低版本TensorFlow、CUDA库不兼容的问题,默认状态下无法识别GPU,仅能低速运行于CPU。通过手动配置动态链接库环境变量LD_LIBRARY_PATH,将conda内置CUDA库纳入系统搜索路径,可激活GPU加速。该环境变量为会话级配置,每次新建终端或tmux会话后均需重新设置。
2.4 参考基因组
采用Samtools对GRCh38 primary_assembly参考基因组构建索引文件(.fa.fai),供SpliceAI快速读取局部基因组序列。构建索引过程中出现的ncurses库版本兼容性警告由系统库与conda库版本差异所致,不影响索引生成。
参考基因组采用GRCh38 primary_assembly标准版本,可保证突变位点坐标匹配、序列读取准确,符合TCGA数据集基因组注释标准。
2.5 数据分析环境
数据预处理、VCF文件构建、预测结果解析、样本注释关联与统计分析均在RStudio Server中完成,基于tidyverse工具包实现数据清洗、字段拆分、表格匹配与批量统计。
二、实战内容
1 数据获取
1.1 数据来源
本研究的LIHC体细胞突变数据取自UCSC Xena数据库的公开TCGA数据集,采用经过统一质控与去冗余的体细胞突变数据集TCGA-LIHC.somaticmutation_wxs.tsv。该数据集包含全外显子测序得到的全部体细胞SNP与小片段INDEL变异,并记录突变位点坐标、参考碱基、突变碱基、对应基因及肿瘤样本条形码(Tumor_Sample_Barcode),为本次剪接效应分析的原始数据源。
1.2 数据下载与解压
数据下载与存储均在Linux服务器终端完成,统一存放于项目数据目录,以保证路径规范、结果可复现。
bash
# 切换至项目数据目录
cd ~/LIHC_data/ESV_data
# 下载 TCGA-LIHC 体细胞突变数据集
wget https://gdc-hub.s3.us-east-1.amazonaws.com/download/TCGA-LIHC.somaticmutation_wxs.tsv.gz
# 解压原始 TSV 文件
gunzip TCGA-LIHC.somaticmutation_wxs.tsv.gz
# 校验文件完整性
head -5 TCGA-LIHC.somaticmutation_wxs.tsv
2 数据处理
2.1 处理目的
原始TCGA-LIHC体细胞突变数据为TSV表格格式,包含大量INDEL变异与格式不规范位点,无法直接用于SpliceAI剪接预测。SpliceAI仅支持标准VCF格式输入,无法直接读取TSV表格,且其对INDEL变异兼容性较差,运行时会自动跳过绝大多数插入缺失位点。因此需统一数据格式、过滤无效变异、校正基因组坐标,最终生成合规的VCF文件。
2.2 处理内容
本阶段处理主要包括三步:变异筛选、坐标格式校正、TSV转VCF结构化重建。
① 变异筛选(仅保留单碱基SNP):SpliceAI无法识别不规范的插入缺失位点,运行时会自动跳过并提示。本研究统一剔除全部INDEL,仅保留ref与alt均为单碱基的SNP变异。
② 基因组命名统一:Xena原始数据染色体名称带有chr前缀,而所采用的GRCh38参考基因组无该前缀。为保证位点序列匹配成功,统一去除前缀,使突变坐标与参考基因组完全对齐。
③ 简易VCF重建:基于原始突变坐标手动重构标准VCF四元组(CHROM、POS、REF、ALT),其余非必要字段填充缺失值,生成满足预测最低标准的简易VCF文件。
2.3 处理代码
makefile
library(tidyverse)
# 设置工作目录
setwd("/home/cheemsyu/LIHC_data/ESV_data")
# 读取原始突变数据
mut_df <- read_tsv("TCGA-LIHC.somaticmutation_wxs.tsv")
# 1. 筛选有效 SNP,剔除全部 INDEL
snp_only <- mut_df %>%
filter(str_length(ref) == 1,
str_length(alt) == 1)
# 2. 统一染色体命名(去除 chr 前缀)
snp_only <- snp_only %>%
mutate(chrom = str_remove(chrom, "^chr"))
# 3. 构建简易 VCF 输入文件
vcf_input <- snp_only %>%
select(chrom, start, ref, alt) %>%
mutate(
ID = ".",
QUAL = ".",
FILTER = ".",
INFO = ".",
FORMAT = ".",
SAMPLE = "."
) %>%
rename(
`#CHROM` = chrom,
POS = start,
REF = ref,
ALT = alt
)
# 输出 SpliceAI 预测输入文件
write_tsv(vcf_input, "lihc_snp_only.vcf", na = ".")
2.4 处理后数据特征
处理完成后得到lihc_snp_only.vcf,作为SpliceAI的唯一输入文件,具有以下特征:
-
仅包含单碱基体细胞SNP,无INDEL干扰;
-
染色体坐标与GRCh38参考基因组一致;
-
结构简洁,满足SpliceAI批量预测的输入要求。
需说明的是,该文件为人工构建的简易VCF,未包含完整VCF元注释头部;对SpliceAI预测运行无影响,但结果解析阶段需手动定义列名。
3 工具调用与分析过程
3.1 分析目的
在完成SNP简易VCF输入文件准备后,调用SpliceAI深度学习模型,依托GRCh38参考基因组提取突变上下游DNA序列,批量预测体细胞单碱基突变对mRNA剪接位点的扰动程度,得到每个变异的剪接损伤分值,为筛选肝癌潜在功能性突变提供定量预测结果。
3.2 运行前置条件
① 已进入tmux后台会话,防止SSH断开造成进程中断;
② spliceai_env conda环境已激活;
③ 参考基因组Homo_sapiens.GRCh38.dna.primary_assembly.fa 及对应的 .fa.fai 索引文件完整;
④ 输入文件lihc_snp_only.vcf预处理完成。
关键兼容说明:旧版本 TensorFlow 与服务器高版本 NVIDIA 驱动存在动态库不匹配,每次新建会话均需设置 LD_LIBRARY_PATH 环境变量以启用 GPU 加速,否则仅以 CPU 低速运行。
3.3 程序调用命令
bash
# 激活专用 conda 环境
conda activate spliceai_env
# 设置 conda 内部 CUDA 动态库搜索路径,启用 GPU
export LD_LIBRARY_PATH=$CONDA_PREFIX/lib:$LD_LIBRARY_PATH
# SpliceAI 批量剪接预测主命令
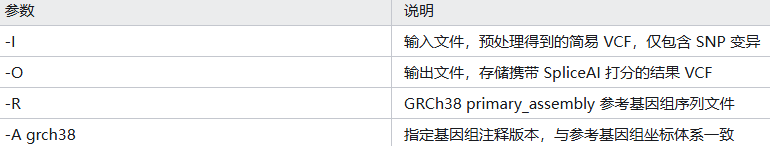
spliceai \
-I /home/cheemsyu/LIHC_data/ESV_data/lihc_snp_only.vcf \
-O /home/cheemsyu/SpliceAI/SpliceAI_out/lihc_spliceai_result.vcf \
-R /home/cheemsyu/ref/GRCh38_ensembl/Homo_sapiens.GRCh38.dna.primary_assembly.fa \
-A grch38
3.3.1 参数说明
3.4 运行监控
监控命令可在新开终端执行,无需激活conda:
bash
# 查看 GPU 利用率,确认 GPU 正常工作
nvidia-smi
# 观察输出文件大小动态变化,判断任务是否仍在执行
ls -lh /home/cheemsyu/SpliceAI/SpliceAI_out/lihc_spliceai_result.vcf
# 统计已处理完成的变异记录行数
grep -v "^##" /home/cheemsyu/SpliceAI/SpliceAI_out/lihc_spliceai_result.vcf | wc -l
3.5 运行过程中的正常提示
① WARNING:root:Skipping record (ref issue):少数残留格式异常、非单碱基变异被程序自动跳过。本研究已提前过滤INDEL,该类记录占比很低,不影响SNP预测结果。
② WARNING:tensorflow:No training configuration found in save file:预训练模型仅保存权重、未保存训练配置。该警告仅与模型训练相关,推理预测不受影响,无需处理。
3.6 输出文件结构
输出VCF的INFO字段存储全部预测结果,包含4项剪接损伤分值DS_AG、DS_AL、DS_DG、DS_DL及对应的位置信息DP。后续取四项DS的最大值 DS_max作为综合剪接损伤指标,并以DS_max ≥ 0.5作为潜在高剪接破坏性变异的筛选阈值。
3.7 任务完成判断
① 终端返回命令提示符,不再持续打印日志;
② 通过nvidia-smi观察该任务GPU占用降为0;
③ 输出VCF文件大小不再增长。
4 结果展示与解读
4.1 分析目的
SpliceAI输出为VCF格式文件,仅存储每个变异位点的剪接预测分值,不携带样本与基因注释信息。本阶段在R中解析输出VCF,提取剪接打分,并与原始Xena突变表关联,将样本条形码、基因名称等注释挂接至每条预测结果;基于DS_max ≥ 0.5筛选潜在高剪接破坏性突变,完成队列层面的统计描述。
4.2 输入文件
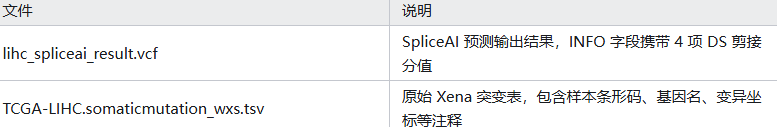
由于输出VCF缺少完整头部元信息,R读取时不可使用自动表头识别,需手动指定全部列名。
4.3 结果解析与关联代码
cs
library(tidyverse)
# 设置工作目录
setwd("/home/cheemsyu/SpliceAI/SpliceAI_out")
# 1. 读取 SpliceAI 输出 VCF,手动指定标准 VCF 列名
vcf_res <- read_tsv(
"lihc_spliceai_result.vcf",
comment = "##",
header = FALSE,
col_names = c("#CHROM","POS","ID","REF","ALT","QUAL","FILTER","INFO","FORMAT","SAMPLE")
)
# 2. 从 INFO 字段提取 SpliceAI 打分字符串
# INFO 格式示例:SpliceAI=DS_AG|DS_AL|DS_DG|DS_DL|DP_AG|DP_AL|DP_DG|DP_DL
spliceai_raw <- vcf_res$INFO %>%
str_extract("SpliceAI=[0-9|.]+") %>%
str_remove("SpliceAI=")
# 拆分 8 个数值字段
score_df <- str_split_fixed(spliceai_raw, "\\|", n = 8) %>% as.data.frame()
colnames(score_df) <- c("DS_AG","DS_AL","DS_DG","DS_DL","DP_AG","DP_AL","DP_DG","DP_DL")
# 转换为数值型,计算综合得分 DS_max
score_df <- score_df %>%
mutate(across(everything(), as.numeric)) %>%
mutate(DS_max = pmax(DS_AG, DS_AL, DS_DG, DS_DL))
# 合并坐标与打分
res_coordinate <- vcf_res %>%
select(`#CHROM`, POS, REF, ALT) %>%
bind_cols(score_df) %>%
rename(chrom = `#CHROM`)
# 3. 读取原始突变表,用于关联样本与基因信息
setwd("/home/cheemsyu/LIHC_data/ESV_data")
original_mut <- read_tsv("TCGA-LIHC.somaticmutation_wxs.tsv") %>%
filter(str_length(ref)==1, str_length(alt)==1) %>%
mutate(chrom = str_remove(chrom,"^chr"))
# 构建匹配键:chrom:start:ref:alt
res_coordinate <- res_coordinate %>%
mutate(key = str_c(chrom,":",POS,":",REF,":",ALT))
original_mut <- original_mut %>%
mutate(key = str_c(chrom,":",start,":",ref,":",alt))
# 表连接:同一突变可出现在多个肿瘤样本(many-to-many)
final_result <- inner_join(
res_coordinate,
original_mut,
by = "key",
relationship = "many-to-many"
)
# 4. 筛选潜在高剪接破坏性变异 DS_max >= 0.5
high_risk_splice <- final_result %>%
filter(DS_max >= 0.5)
# 输出结果表格
write_tsv(final_result, "spliceai_all_result.tsv")
write_tsv(high_risk_splice, "spliceai_highrisk.tsv")
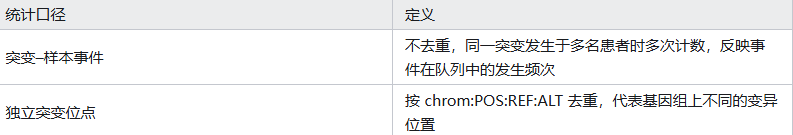
4.4 统计口径说明
两个统计口径需严格区分,以避免结果误读:
4.5 队列统计结果
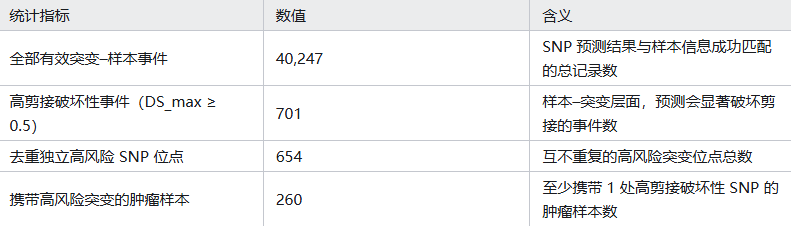
TCGA-LIHC队列纳入统计的肿瘤样本约374例,携带高风险突变的样本占比为260/374 ≈ 69.5%。该比例以纳入队列统计的肿瘤样本总数为分母,报告时应注明分母定义。
4.6 高频受影响基因
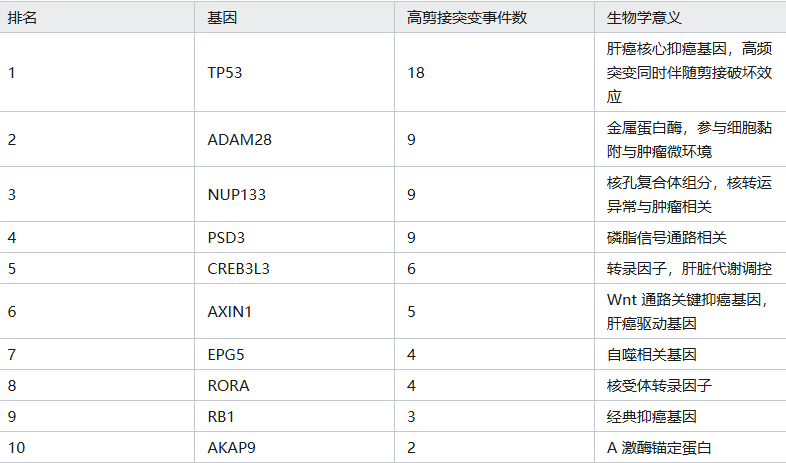
4.7 结果解读
① DS_max取值区间为0--1,数值越接近1,代表该变异对剪接位点扰动的模型预测置信度越高。
② DS_max ≥ 0.5为工具经验阈值,属计算预测结果,不等同于体内真实发生剪接异常。
③ TP53 居首(18 次事件):TP53是肝细胞癌突变频率最高的抑癌基因。其大量体细胞SNP除改变蛋白氨基酸序列外,部分位点可能同时伴随剪接改变(如外显子跳跃、内含子滞留),此为常规突变注释(MAF)易忽略的层面;是否真实发生异常剪接仍需转录组验证。
④ AXIN1(5 次):AXIN1为Wnt/β-catenin通路关键抑癌基因及肝癌驱动基因,其预测剪接破坏可能进一步加剧通路异常。
⑤ 高风险位点仅提示该突变有较高概率干扰mRNA剪接,后续需以Bulk RNA-seq可变剪接数据或体外实验进一步验证。
5 局限性与后续分析
5.1 数据层面
① 原始数据来源于UCSC Xena处理后的TCGA-LIHC体细胞突变数据,并非GDC官方标准VCF;分析过程直接舍弃全部INDEL变异,仅对单碱基SNP开展剪接效应预测,插入缺失变异的剪接扰动未作评估。
② 输入为自制简易VCF,缺少完整VCF元注释,依赖坐标与碱基字符串进行表连接匹配,存在极低概率的匹配错误。
5.2 工具预测层面的局限
① SpliceAI属深度学习计算预测工具,DS_max ≥ 0.5为文献通用经验阈值,仅代表序列层面的潜在剪接扰动,不等于肿瘤细胞内真实发生可变剪接异常,存在假阳性,不能直接等同于功能性突变。
② 模型仅依赖突变位点上下游DNA序列进行预测,不考虑基因表达量、染色质状态、RNA结合蛋白及其他顺式、反式调控因子等体内真实生物学环境。
③ 模型无法区分突变带来的具体剪接表型(外显子跳跃、内含子滞留、隐蔽剪接位点激活等),仅给出综合损伤分值。
5.3 队列与注释层面的局限
① 本研究仅有突变基因组数据,无配套的同一批样本转录组测序结果,无法直接验证预测所得的剪接异常是否真实存在。
② 仅分析肿瘤体细胞突变,未纳入胚系变异;未区分突变为驱动突变或乘客突变。
③ 统计仅描述突变--样本事件分布,未结合mRNA表达、蛋白表达及临床预后开展定量关联。
5.4 后续可进行的分析
5.4.1 多组学联合分析
① 转录组关联:利用TCGA-LIHC Bulk RNA-seq数据,比较携带高风险剪接突变的样本与其余样本的对应基因表达水平差异;进一步检测可变剪接事件,验证SpliceAI预测位点是否真实发生剪接异常。
② 蛋白表达:结合TCGA蛋白组数据,观察高剪接突变样本对应蛋白丰度是否改变。
③ 临床特征关联:将样本分为"携带高风险剪接SNP"与"无高风险剪接SNP"两组,比较两组的年龄、性别、肿瘤分级与分期等临床指标差异;绘制Kaplan--Meier生存曲线,探究潜在剪接破坏性突变与患者总生存期、无病生存期的关系。
5.4.2 基因与位点深度挖掘
① 聚焦高频基因(如TP53、AXIN1),统计同一基因内高风险剪接突变的位置分布,区分错义、同义突变中哪些同时附带剪接损伤效应,补充传统突变注释遗漏的功能信息。
② 筛选关键候选位点:挑选分值极高(DS_max接近1)且在多个样本中重复出现的突变,作为后续体外功能验证的候选位点。
6 附录
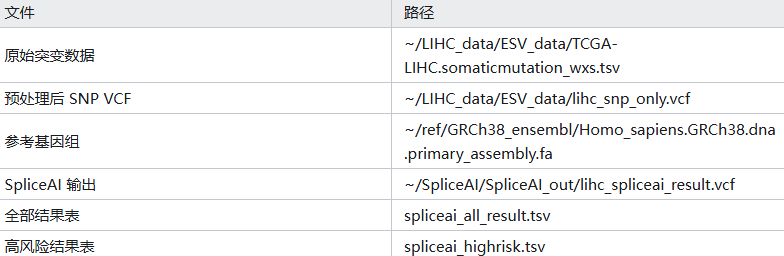
6.1 文件路径汇总
6.2 软件与依赖包版本信息
6.2.1 服务器系统
-
操作系统:Ubuntu 20.04
-
GPU:NVIDIA RTX 3080
6.2.2 Conda 环境 spliceai_env
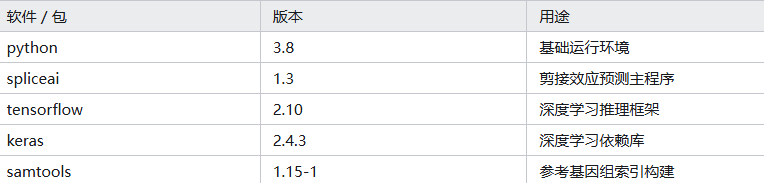
6.2.3 R 及 R 包(RStudio Server)
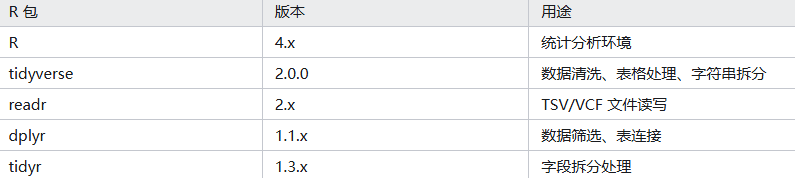
参考基因组版本:GRCh38 primary_assembly(Ensembl release-110)。
6.3 常见报错、警告与排查
6.3.1 SpliceAI 运行--GPU 相关
现象:GPU不工作,仅以CPU运行,速度较慢。
-
原因:conda内部CUDA动态库未被系统识别,会话环境变量丢失。
-
排查:每次新建 tmux 或终端会话后执行
bash
export LD_LIBRARY_PATH=$CONDA_PREFIX/lib:$LD_LIBRARY_PATH- 验证:通过nvidia-smi观察GPU利用率是否上升。
现象:WARNING:tensorflow:No training configuration found in save file。
- 说明:预训练模型仅保存权重,该警告不影响推理预测,无需处理。
6.3.2 SpliceAI 运行--变异位点警告
现象:WARNING:root:Skipping record (ref issue)。
-
原因:VCF中残留INDEL、碱基不匹配或染色体名称不一致的位点被程序跳过。
-
排查:确认输入VCF染色体不带chr前缀,与参考基因组一致;预处理阶段已过滤INDEL,少量该警告属正常现象,不影响SNP结果。
6.3.3 服务器会话断开导致程序终止
现象:关闭SSH后SpliceAI进程直接退出。
-
原因:前台进程依附于SSH会话,会话断开信号终止进程。
-
处理:长时运算须在tmux会话内部运行。
cs
tmux new -s splice_run
# 在 tmux 内部执行 spliceai 命令
# 快捷键 Ctrl+b 后按 d 脱离会话;重新接入 tmux attach -t splice_run
6.3.4 samtools faidx 索引警告
现象:samtools运行输出libncursesw.so版本无版本信息警告。
-
原因:conda库与系统库版本冲突,属动态库告警。
-
排查:检查目录下是否生成 .fa.fai索引文件,生成成功即可忽略。
6.3.5 R 读取 VCF 文件出错
现象:读入VCF后列错乱、字段错位,打分提取失败。
-
原因:自制简易 VCF 缺少完整元注释头部,自动识别表头失败。
-
处理:设置comment = "##" 与header = FALSE,手动指定全部VCF列名,不可直接使用默认方式读取。
6.3.6 R 表连接匹配失败,大量 NA
现象:inner_join后结果行数很少,大量打分字段为NA。
- 排查要点:染色体是否统一去除chr前缀;key拼接格式是否严格统一为 chrom:POS:REF:ALT;ref、alt碱基大小写是否一致;原始数据是否已提前过滤INDEL并仅保留SNP记录。
6.3.7 conda 安装软件包失败
现象:conda install samtools 提示包不存在。
-
原因:默认defaults通道不包含部分生物信息学工具。
-
处理:使用bioconda通道安装,或直接使用服务器预装的samtools。
6.3.8 wget下载 URL 解析失败
现象:wget报域名解析失败或链接乱码。
-
原因:复制链接时带入全角破折号等非半角字符。
-
排查:检查粘贴命令中的符号,统一使用英文半角符号。