项目地址:
yolo-object-detection-lab:基于 FastAPI 与 Ultralytics YOLO 的图像目标检测实验项目 - AtomGit
前面几篇里,这个项目已经陆续加入了目标检测、目标跟踪、过线统计、ROI 区域分析、轨迹热力图、多 ROI 流转分析、速度估计,以及四点透视标定。
做到这里以后,其实已经能够回答很多问题:
目标是谁?
目标在哪里?
目标走过哪里?
目标进入了哪个区域?
目标速度大概有多快?
但还有一个更有意思的问题:
它接下来会往哪里走?
所以这一次,我继续在现有 YOLO + ByteTrack 的基础上加入了:
Trajectory Prediction
也就是基于目标的历史运动轨迹,对未来 1~3 秒的位置进行预测。
这次实现了两种方法:
Constant Velocity
和
Kalman Prediction
并且继续支持前面已经做好的 Perspective 4-Point 透视标定。
一、为什么要做轨迹预测?
传统目标检测只能告诉我:
这一帧目标在哪里。
加入 ByteTrack 后,可以进一步知道:
连续多帧中的这个目标是不是同一个目标。
于是可以得到:
Track ID
历史位置
运动方向
运动速度
完整轨迹
再往前一步,就可以根据过去一段时间的运动状态,推测它未来可能出现的位置。
整个思路变成:
YOLO
↓
ByteTrack
↓
历史轨迹
↓
运动状态估计
↓
未来轨迹预测
这也是这次 Trajectory Prediction 的核心。
二、轨迹数据从哪里来?
这次依然没有重新设计一套目标位置,而是继续沿用项目里一直使用的:
Bottom-center Anchor
也就是目标检测框底边中心点。
计算方式:
anchor_x = (x1 + x2) / 2
anchor_y = y2
为什么不用 Bounding Box 中心?
因为对于道路视频来说,Bottom-center 更接近目标与地面的实际接触位置。
例如:
行人更接近脚的位置
车辆更接近车轮和道路接触的位置
所以它更适合:
Line Crossing
ROI
Heatmap
Speed Estimation
Trajectory Prediction
整个项目的空间分析逻辑也能保持统一。
三、每个 Track 都保存一段历史轨迹
对每一个 ByteTrack 的 Track ID,我会保存最近 N 个轨迹点。
这次测试设置:
History Length:10
也就是说,每个目标最多保留最近 10 个有效位置。
每个历史点至少包含:
时间戳
x 坐标
y 坐标
于是一个目标的历史轨迹可以理解为:
P1 → P2 → P3 → P4 → ... → P10
有了这些历史点以后,就可以估算:
运动方向
速度变化
轨迹稳定程度
然后进一步预测未来位置。
四、第一种方法:Constant Velocity
第一种方法是最简单、也最容易解释的:
Constant Velocity
也就是匀速模型。
核心假设是:
目标接下来短时间内,会继续保持最近的运动方向和速度。
程序会根据最近的历史轨迹估计:
vx = Δx / Δt
vy = Δy / Δt
然后预测未来某个时刻的位置:
future_x = current_x + vx × t
future_y = current_y + vy × t
这次不是只预测一个终点,而是生成一整条未来轨迹。
比如:
Prediction Horizon:2 s
Prediction Steps:10
意味着:
在未来 2 秒内,生成 10 个预测位置点。
于是就能在视频中画出一条:
未来预测轨迹线
五、为什么不能只预测一个点?
如果只预测:
"2 秒后会在哪里"
其实不太直观。
因为我更想知道的是:
它未来的运动趋势是什么?
所以这次预测的是一系列点。
例如:
当前点
↓
0.2 s
↓
0.4 s
↓
0.6 s
↓
...
↓
2.0 s
这样 Result Video 里看到的就不是一个孤立圆点,而是一条完整的未来轨迹。
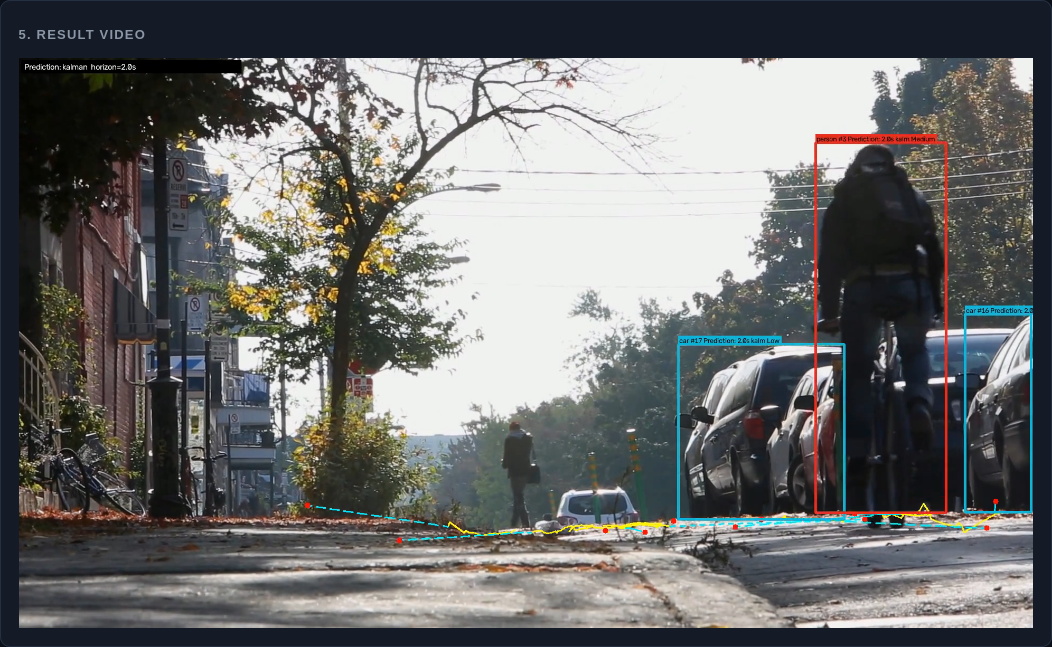
图中的历史轨迹和预测轨迹采用不同样式显示,避免把真实轨迹和未来预测混在一起。
六、Constant Velocity 真实测试结果
这次仍然使用之前一直测试的同一段道路视频。
视频信息:
Resolution:1920×1080
FPS:29.97
Total Frames:962
Duration:约 32.10 s
预测参数:
Prediction Method:Constant Velocity
Prediction Horizon:2 s
Prediction Steps:10
History Length:10
Confidence Threshold:0.50
Frame Interval:Every Frame
同时开启:
Perspective 4-Point
标定区域继续使用:
Width:6 m
Height:12 m
最终完整处理:
962 / 962 Frames
100%
结果:
Unique Tracks:37
Tracks With Prediction:34
Average History Length:8.1
Elapsed:84.0 s
Calibration Mode:perspective
七、为什么 37 个 Track 只有 34 个生成预测?
这个结果是正常的。
Constant Velocity 需要至少有足够的历史位置和有效时间差,才能计算速度。
如果某个 Track:
出现时间太短
历史点不足
有效 Δt 不足
轨迹不连续
就不会强行生成预测。
所以这次:
37 Unique Tracks
其中:
34 Tracks With Prediction
没有预测的 3 个目标,并不是程序出错,而是轨迹历史不足以支持可靠的匀速预测。
八、第二种方法:Kalman Prediction
第二种方法就是:
Kalman Filter
这次使用的是一个简单的二维匀速状态模型。
状态可以写成:
x, y, vx, vy
其中:
x、y 表示当前位置
vx、vy 表示当前速度
每一帧主要做两件事:
Predict
↓
Update
Predict 负责根据上一时刻的运动状态,预测当前位置。
Update 则利用当前实际检测到的位置,对预测进行修正。
这样相比直接计算平均速度,Kalman 能不断融合:
历史运动状态
当前观测位置
从而维持一个连续的状态估计。
九、Kalman 并没有直接使用 ByteTrack 内部状态
这里有一个设计细节。
虽然 ByteTrack 本身内部也包含运动模型,但这次没有直接去读取或修改 ByteTrack 的内部 Kalman 状态。
而是单独维护:
Trajectory Prediction State
这样可以避免影响原本的目标跟踪逻辑。
整个结构变成:
YOLO
↓
ByteTrack
↓
Track ID
↓
独立 Prediction State
↓
Kalman Predict / Update
↓
Future Trajectory
这样 Tracking 和 Prediction 是解耦的。
十、Kalman 真实测试结果
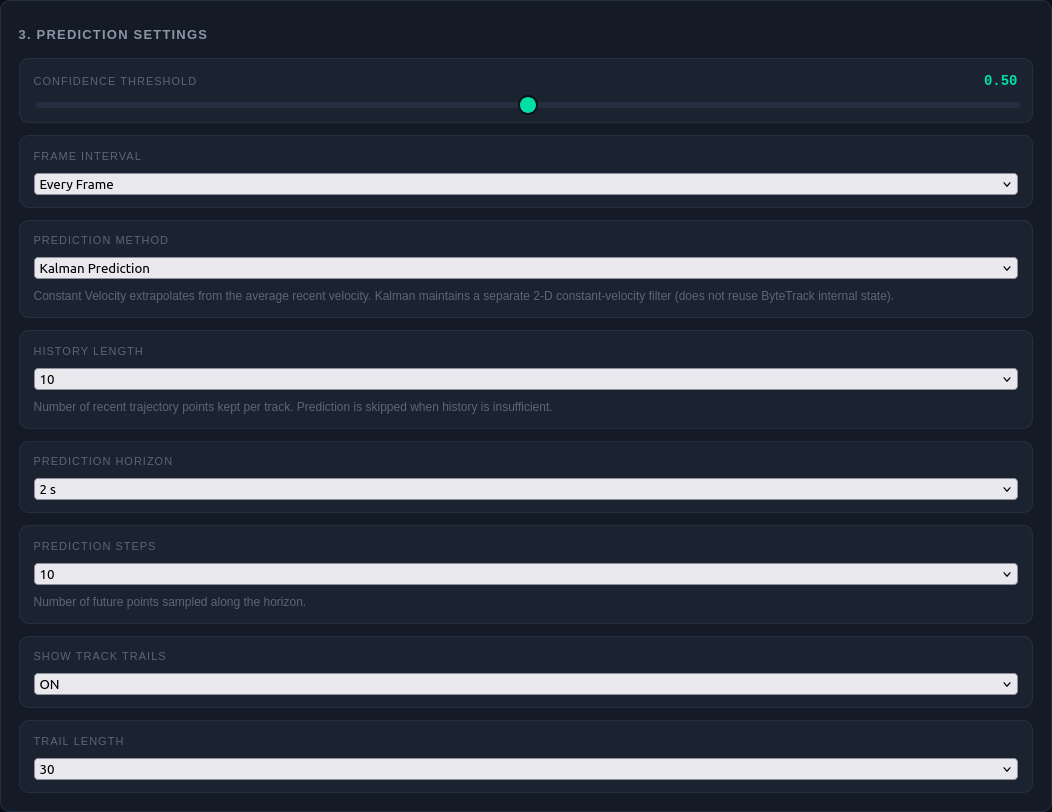
为了和 Constant Velocity 对比,我保持了基本相同的参数,只把:
Prediction Method
切换成:
Kalman
其余仍然是:
Prediction Horizon:2 s
Prediction Steps:10
History Length:10
Confidence:0.50
Every Frame
Perspective Calibration:ON
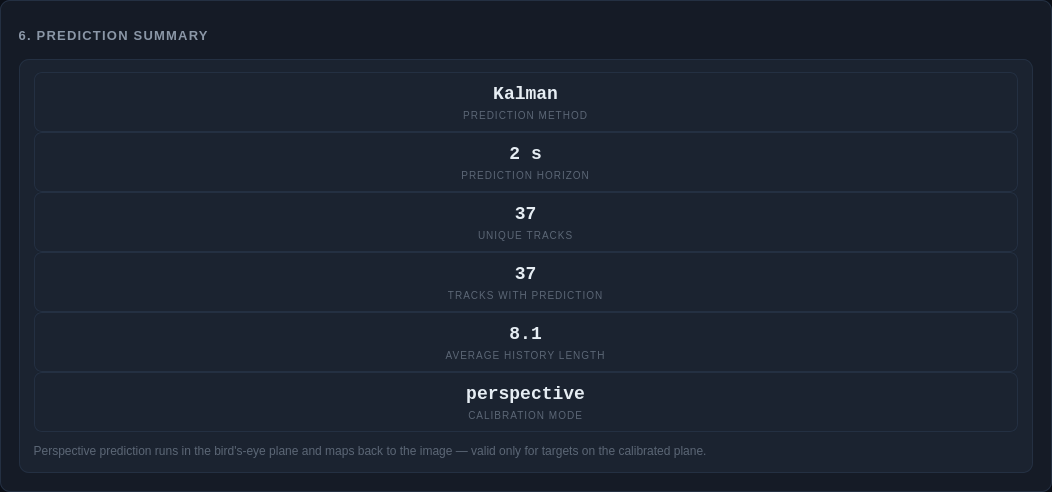
这次最终结果:
962 / 962 Frames
100%
Unique Tracks:37
Tracks With Prediction:37
Average History Length:8.1
Elapsed:53.8 s
Calibration Mode:perspective
也就是说:
37 个 Track 全部生成了预测轨迹。
十一、Constant Velocity 和 Kalman 实测对比
这次两组真实实验结果如下:
| 指标 | Constant Velocity | Kalman |
|---|---|---|
| Total Frames | 962 | 962 |
| Unique Tracks | 37 | 37 |
| Tracks With Prediction | 34 | 37 |
| Average History Length | 8.1 | 8.1 |
| Prediction Horizon | 2 s | 2 s |
| Calibration | perspective | perspective |
| Processing Time | 84.0 s | 53.8 s |
从这次实验结果来看:
Constant Velocity:34 / 37 生成预测
Kalman:37 / 37 生成预测
Kalman 在这次数据中覆盖率更高。
不过这里要注意:
不能因为这一轮 Kalman 用时更短,就直接得出 Kalman 一定比 Constant Velocity 更快。
整体处理时间还受到:
YOLO 推理
视频编码
磁盘 IO
系统负载
当前运行环境
等因素影响。
所以更准确的表述是:
在本次相同视频实验中,Kalman 版本的总处理时间更短。
十二、分类统计结果
Kalman 这一轮中:
bicycle:3 个 Unique Track,3 个生成预测
car:18 个 Unique Track,18 个生成预测
person:16 个 Unique Track,16 个生成预测
也就是说三类目标全部完成预测。
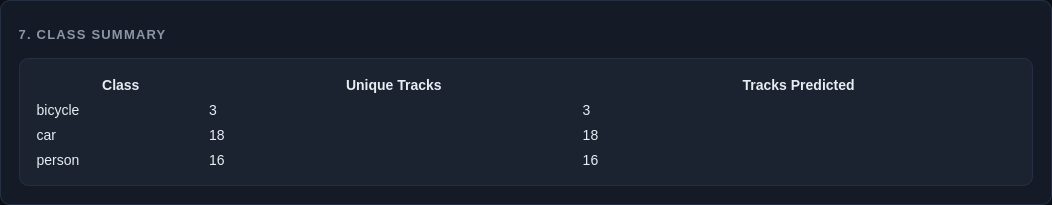
这说明预测逻辑并不是只针对车辆,而是对 ByteTrack 产生的不同类别 Track 都可以工作。
十三、Perspective Calibration 也参与了预测
这一版还有一个比较有意思的地方:
Trajectory Prediction 可以继续使用前面 Speed Estimation 已经实现的:
Perspective 4-Point Calibration
也就是:
原图目标位置
↓
Homography
↓
Bird's-eye Plane
↓
进行轨迹预测
↓
Inverse Homography
↓
映射回原视频
这样预测可以先在更适合道路运动分析的鸟瞰平面中完成,再映射回原始图像显示。
这次真实实验里,Prediction Summary 已经明确显示:
Calibration Mode:perspective
说明这不是单纯前端画了一个标定框,而是真正进入了预测流程。
十四、为什么还要映射回原图?
最终用户看的还是原始视频。
所以即使预测是在 Bird's-eye Plane 中完成的,最后还是需要把预测位置映射回原图。
这也是为什么 Track Prediction Table 里的:
Predicted End X
Predicted End Y
仍然可以理解为最终原图中的预测终点坐标。
这样就可以直接在视频上画:
未来轨迹
预测终点
Track ID
而不是只能看一张单独的鸟瞰图。
十五、Result Video 里到底显示了什么?
最终 Result Video 中同时包含:
Bounding Box
Track ID
Class
真实历史轨迹
未来预测轨迹
预测终点
Prediction Method
Prediction Horizon
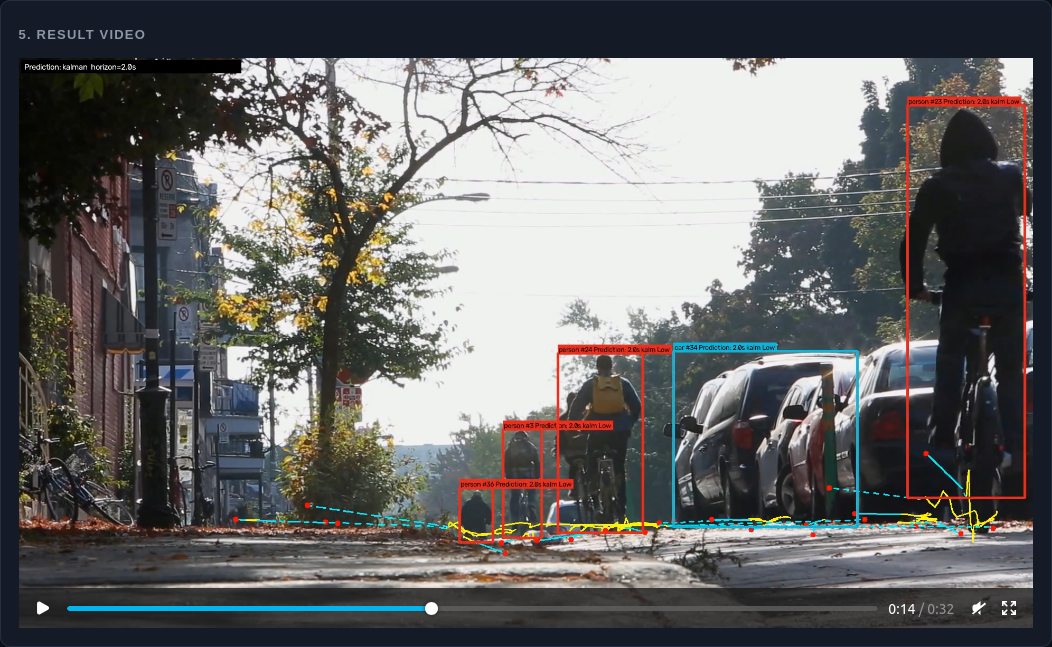
这时候就可以非常直观地看到:
目标之前怎么走
↓
现在在哪里
↓
未来两秒可能往哪里走
这比单纯在表格里看坐标直观很多。
十六、Prediction Horizon 是什么意思?
这次设置的是:
Prediction Horizon:2 s
也就是说:
程序预测的是目标未来 2 秒内的运动趋势。
同时:
Prediction Steps:10
所以会把未来 2 秒分成多个预测点。
需要注意:
Prediction Horizon 越长,并不代表结果越好。
因为随着预测时间变长,不确定性也会越来越大。
例如车辆可能:
刹车
转弯
变道
行人也可能:
突然停下
改变方向
所以这种简单运动模型更适合:
短时间轨迹预测
而不是预测十几秒之后的位置。
十七、Reliability 不是概率
这次还加入了:
Reliability
结果分为:
Low
Medium
High
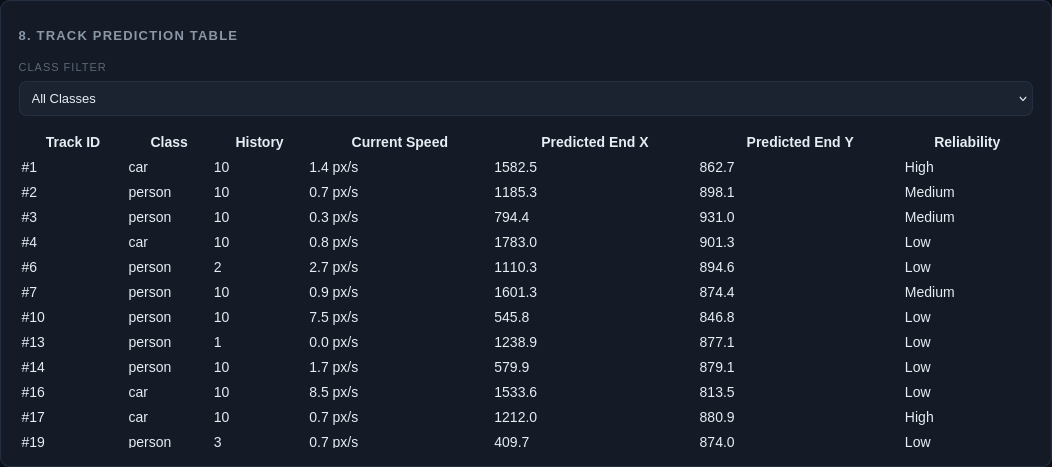
但这里一定要说明:
Reliability 不是神经网络输出的概率。
它只是一个启发式指标。
主要参考:
历史轨迹点数量
最近运动速度稳定程度
轨迹波动情况
例如:
历史点很少
速度变化很大
就更容易得到 Low。
反过来:
历史点较多
运动比较稳定
则可能得到 Medium 或 High。
所以:
High Reliability
并不代表:
"预测有 90% 概率正确"。
它只是帮助判断:
当前这条 Track 的历史状态是否适合进行短时运动预测。
十八、Current Speed 为什么还是 px/s?
在 Track Prediction Table 中,还可以看到:
Current Speed
目前这里仍然主要作为图像空间中的辅助运动量使用。
所以不要直接把它解释成:
真实 m/s
真实 km/h
Trajectory Prediction 的重点是:
未来位置和运动趋势
而不是重新做一遍 Speed Estimation。
如果需要真实世界速度,还是应该使用之前已经完成的:
Perspective Speed Estimation
两者关注的目标不同。
十九、轨迹预测并不等于"知道未来"
这点也需要说清楚。
当前实现基于的是:
Constant Velocity
Kalman Constant Velocity Model
它们本质上都是根据:
过去的运动状态
去推测:
短时间未来运动趋势
它并不知道:
红绿灯
道路规则
驾驶员意图
行人意图
障碍物
车辆转向灯
所以如果一个目标突然:
转弯
停车
变道
模型之前的预测轨迹就可能失效。
因此这里更准确的说法是:
短时运动轨迹预测
而不是:
精准预测目标未来行为。
二十、这次测试增加到 511 个
Trajectory Prediction 完成以后:
511 pytest passed
相比之前的:
428
新增了:
83 个后端测试。
前端:
308 assertions passed
相比之前:
288
新增了:
20 个前端断言。
覆盖内容包括:
Bottom-center
History Buffer
Constant Velocity
Stationary Target
Horizontal Motion
Vertical Motion
Prediction Horizon
Prediction Steps
Kalman Initialization
Kalman Predict / Update
Insufficient History
Zero dt
Reliability
Prediction Clipping
Zero Tracks
Export
Stale Reset
Detector Failure
而前面已经完成的其他模式也全部保留。
二十一、开发分支
这次开发使用:
Branch:
feat/trajectory-prediction
最终 commit:
2a5a45366af58139eeb5360577bd323377538e12
主要新增:
app/trajectory_prediction.py
static/prediction.js
tests/test_trajectory.py
同时对:
app/main.py
app/schemas.py
static/index.html
static/app.js
tests/test_frontend_logic.js
进行了对应集成。
二十二、项目已经从"检测"走到了"预测"
一路做到现在,这个项目的能力已经从最开始的:
Single Image Detection
逐步发展成:
Single Image
↓
Batch Images
↓
Video Detection
↓
ByteTrack Tracking
↓
Line Crossing
↓
ROI Analysis
↓
Trajectory Heatmap
↓
Multi-ROI Flow
↓
Speed Estimation
↓
Perspective Calibration
↓
Trajectory Prediction
整个过程已经不只是:
"YOLO 能不能识别一个目标"
而是在逐渐回答:
它是谁?
它在哪里?
它从哪里来?
它去了哪里?
它在区域里待了多久?
它移动得有多快?
它接下来可能往哪里走?
总结
这次真实实验中,我分别跑了 Constant Velocity 和 Kalman 两种预测方式。
Constant Velocity:
962 Frames
37 Unique Tracks
34 Tracks With Prediction
Average History Length:8.1
Prediction Horizon:2 s
Elapsed:84.0 s
Kalman:
962 Frames
37 Unique Tracks
37 Tracks With Prediction
Average History Length:8.1
Prediction Horizon:2 s
Elapsed:53.8 s
同时启用了:
Perspective 4-Point Calibration
最终完整流程已经变成:
YOLO
↓
ByteTrack
↓
Bottom-center Anchor
↓
History Buffer
↓
Perspective Homography
↓
Constant Velocity / Kalman
↓
Future Trajectory
↓
Inverse Homography
↓
Result Video
相比之前只能回答:
目标现在在哪里?
这一次已经可以进一步尝试回答:
目标未来两秒大概会往哪里走?
当然,这仍然属于基于运动状态的短时预测,并不能理解真正的驾驶意图或行人意图。
但对于一个从 YOLO 检测项目逐步扩展出来的视频行为分析系统来说,这一步已经让它从:
Detection
开始走向:
Motion Understanding
项目地址:
yolo-object-detection-lab:基于 FastAPI 与 Ultralytics YOLO 的图像目标检测实验项目 - AtomGit
下一步如果继续做,我准备在现有 Trajectory Prediction 上加入:
Collision Risk / TTC Analysis
也就是利用两个目标的相对运动状态,进一步判断:
它们会不会发生潜在冲突,以及大概还有多久接近危险区域。