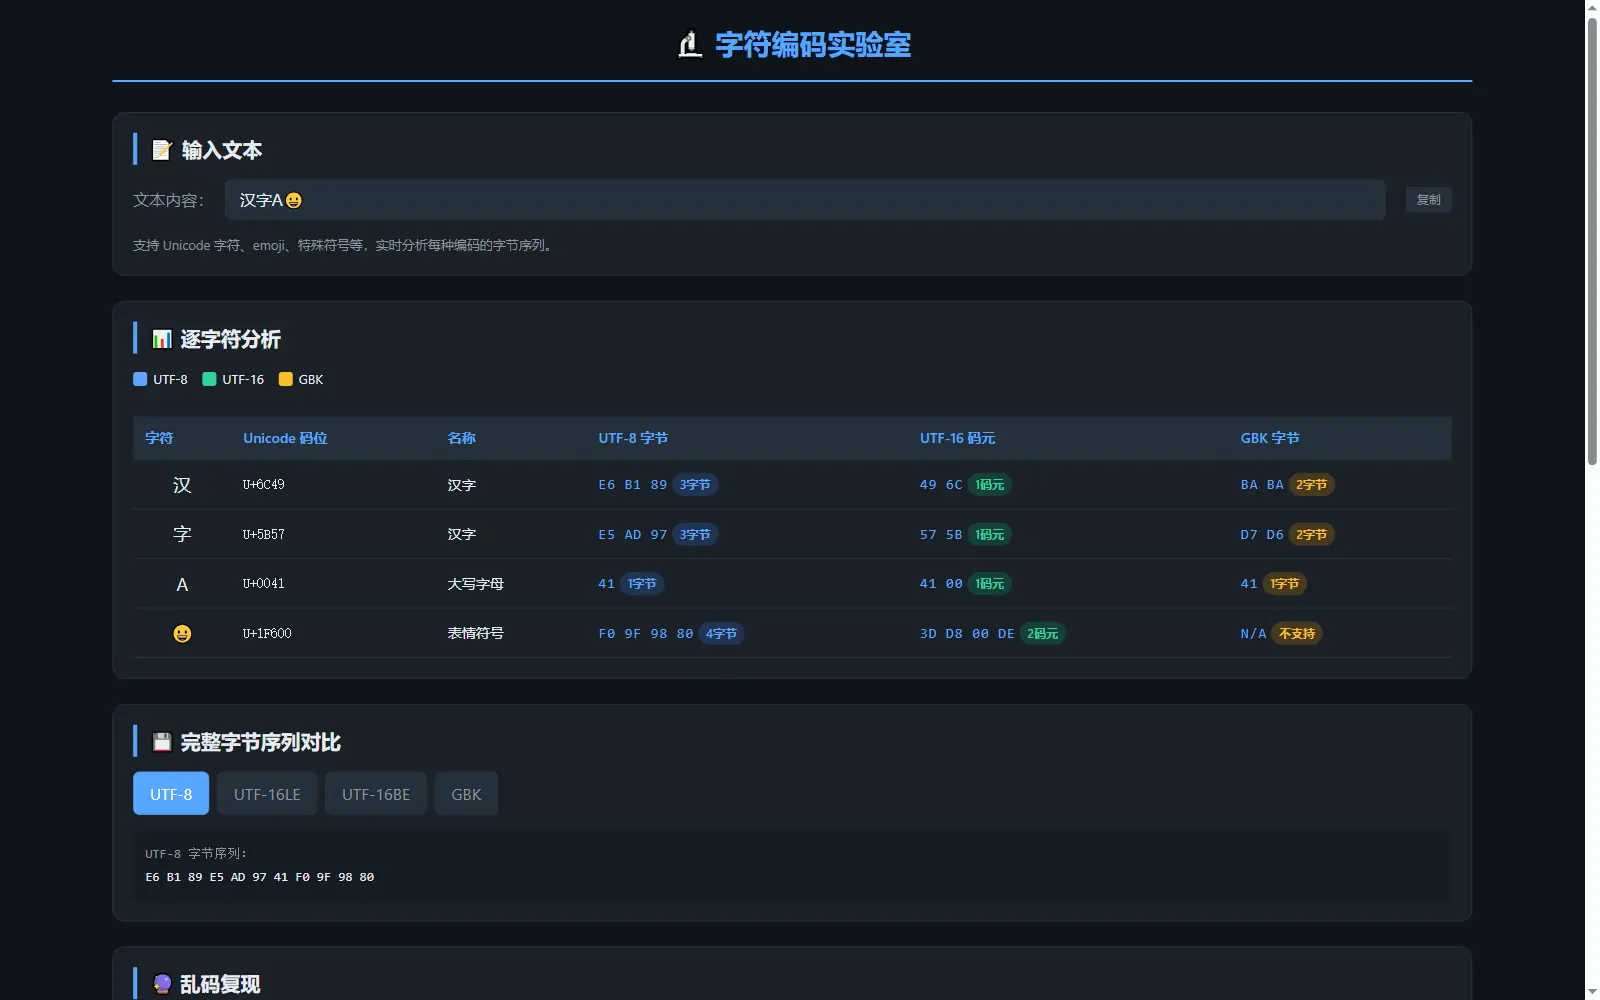
「汉」在 UTF-8 里是 E6 B1 89,在 GBK 里是 BA BA,在 UTF-16LE 里是 49 6C。
同一个字,三种编码,分别是 3 字节、2 字节、2 字节。
我把这三个数字摊在同一张表里对了一遍,谁多一个字节、谁换了字节序,一眼可见。
emoji 的差别更大:😀 在 UTF-8 里占 4 个字节,在 UTF-16 里也是 4 个,GBK 干脆编不出来,页面上标成 N/A。
乱码也不是文件坏了,是拿另一种编码去读了同一串字节。
成品是一个单文件 index.html,双击就能跑,不联网,不引第三方库。
案例目录在这里,下载下来直接打开:
text
https://atomgit.com/deli007/demo_park/tree/main/codearts-unicode-encoding-lab一、先把默认文本的字节摊开
| 字符 | Unicode 码位 | UTF-8 字节 | UTF-16LE 码元 | GBK 字节 |
|---|---|---|---|---|
| 汉 | U+6C49 | E6 B1 89 | 49 6C | BA BA |
| 字 | U+5B57 | E5 AD 97 | 57 5B | D7 D6 |
| A | U+0041 | 41 | 41 00 | 41 |
| 😀 | U+1F600 | F0 9F 98 80 | 3D D8 00 DE | 不支持 |
表里每一格都是页面打开时当场算的,不是我抄的。
汉字在 UTF-8 里占 3 字节,这就是「一个汉字三个字节」这句话的出处。
GBK 只占 2 字节,这也是老项目里中文文本普遍更小的原因。
字母 A 在三种编码里都是自己,UTF-16 为了凑对齐,后面补了一个 00。
emoji 那行最扎眼,GBK 那一格直接写着不支持。
二、为什么值得做这个页面
乱码是中文开发者绕不开的事,但很多人停在了「编码不统一」这句结论上。
具体是哪几个字节、被谁读成了什么、为什么正好是「锟斤拷」,很少有人讲透。
我回想了一下自己踩坑的经历:这个问题在三个不同项目里各出现过一次,每次都靠搜索救回来。
所以它不是一个看完就忘的演示,而是有明确检索词的东西:UTF-8、GBK、乱码、UTF-16。
页面要做的事很窄,给我一串字符,告诉我它在四种编码下的真实字节。
窄的好处是每一项都能验。
三、怎么做:三种编码,三条不同的路
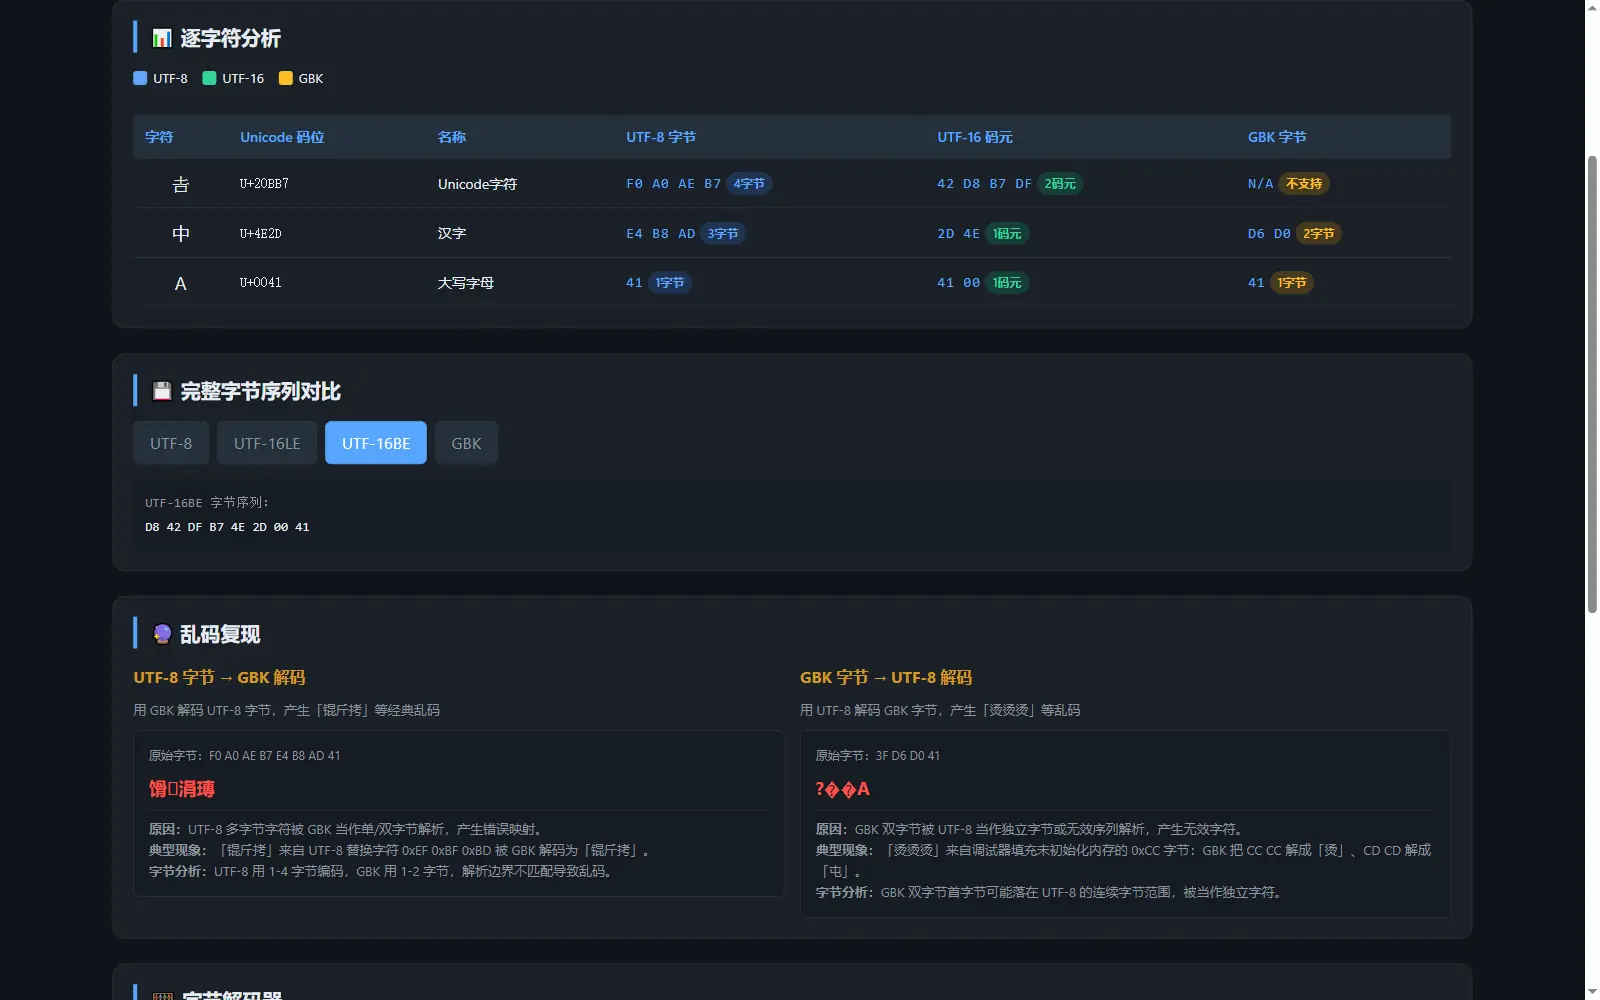
UTF-8 和 UTF-16 在浏览器里是原生能力,直接调就行。
UTF-8 用 TextEncoder 一行拿到字节数组。
UTF-16LE 和 UTF-16BE 用 charCodeAt 把每个码元拆成高低字节,BE 只是把这两个字节换个顺序。
麻烦的是 GBK,浏览器只给了 TextDecoder,负责解码,没有对应的编码器。
没有编码器,就得自己造一张反查表。
我的做法是让解码器反过来工作:首字节从 0x81 枚举到 0xFE,次字节从 0x40 枚举到 0xFE,跳过 0x7F。
每组两字节丢进 TextDecoder('gbk') 解一次,解得出的字符就跟这两个字节绑在一起。
一共试了 23940 组,建出 24067 条映射,其中 128 条来自 ASCII 单字节。
我在页面上掐了时间,整张表建完 18.5 毫秒,再刷一遍是 17.7 毫秒,映射条数两次都是 24067。
这个数字是页面上真跑出来的,不是估的。
四、乱码复现:把两次错误解码摆在同一屏
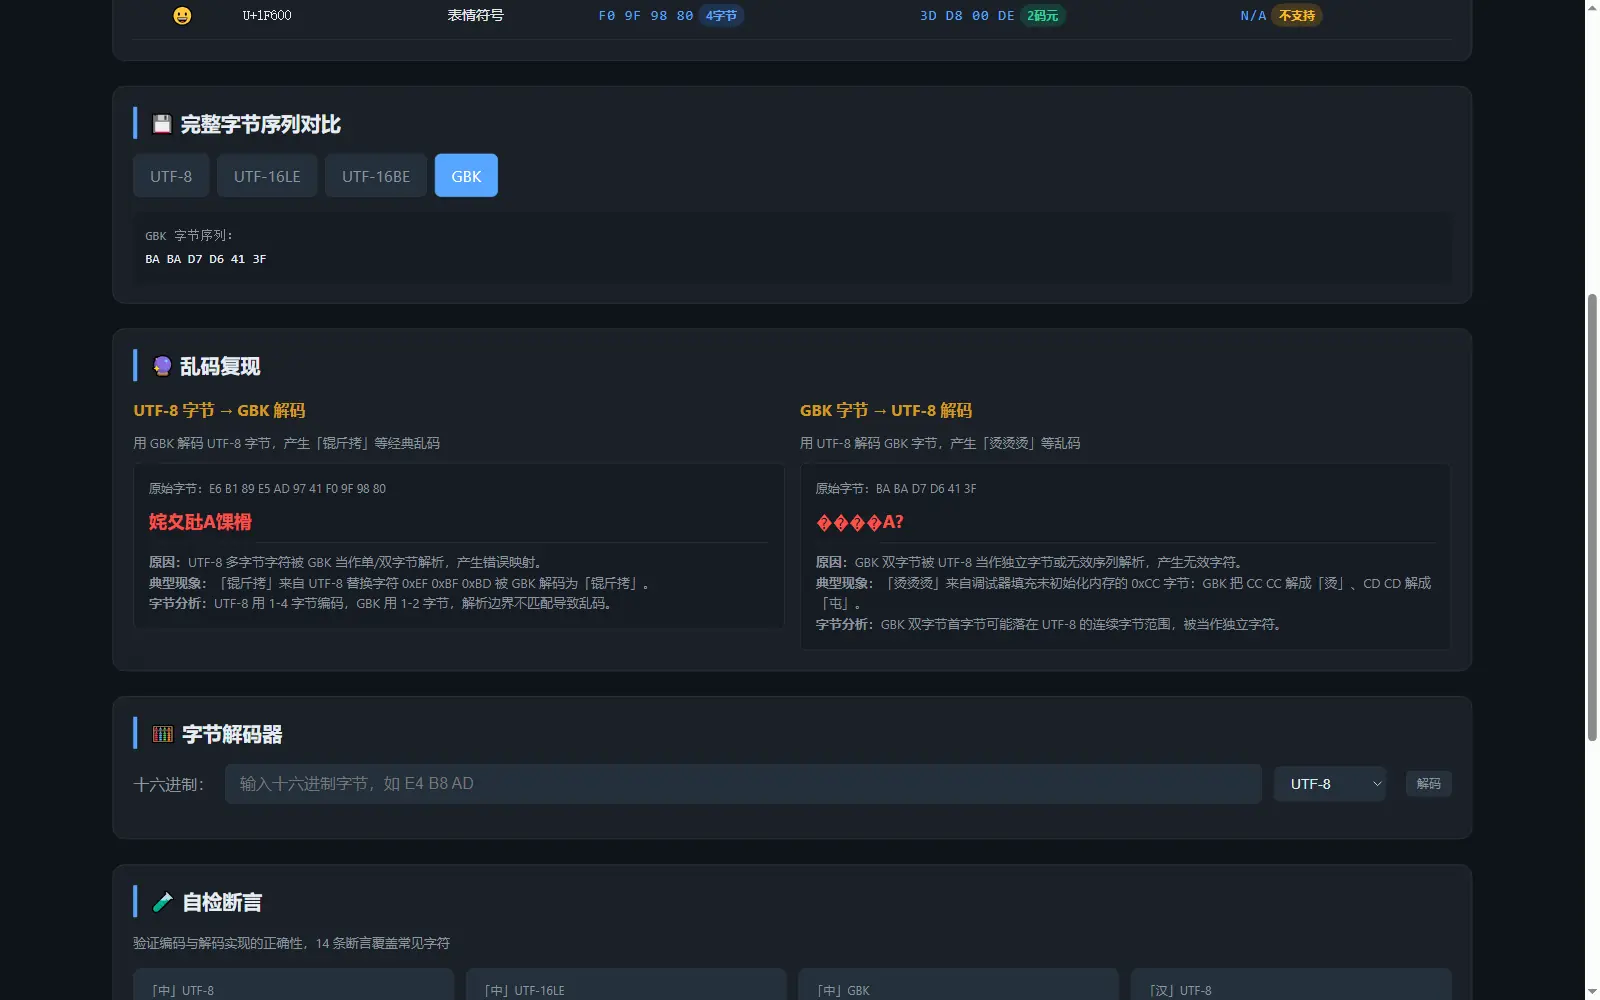
左栏的原始字节是 E6 B1 89 E5 AD 97 41 F0 9F 98 80,按 GBK 读出来是「姹夊瓧A馃榾」。
右栏的原始字节是 BA BA D7 D6 41 3F,按 UTF-8 读出来是四个替换字符加一个 A?。
同一串「汉字A😀」,换个读法就成了两个不同的怪东西。
「锟斤拷」的来历我也在页面上验了一遍。
把两个 UTF-8 的替换字符 0xEF 0xBF 0xBD 连起来,用 GBK 解,正好是「锟斤拷」。
单个 EF BF BD 解出来只有一个「锟」加半个乱码,两个连在一起才凑齐这三个字。
这也是老文章里的乱码经常成对出现的原因。
五、验证与踩坑:自检 12 条全绿,UTF-16BE 解码却是崩的
页面底部有自检区,把每种编码的期望字节写成断言,跑完显示通过条数。
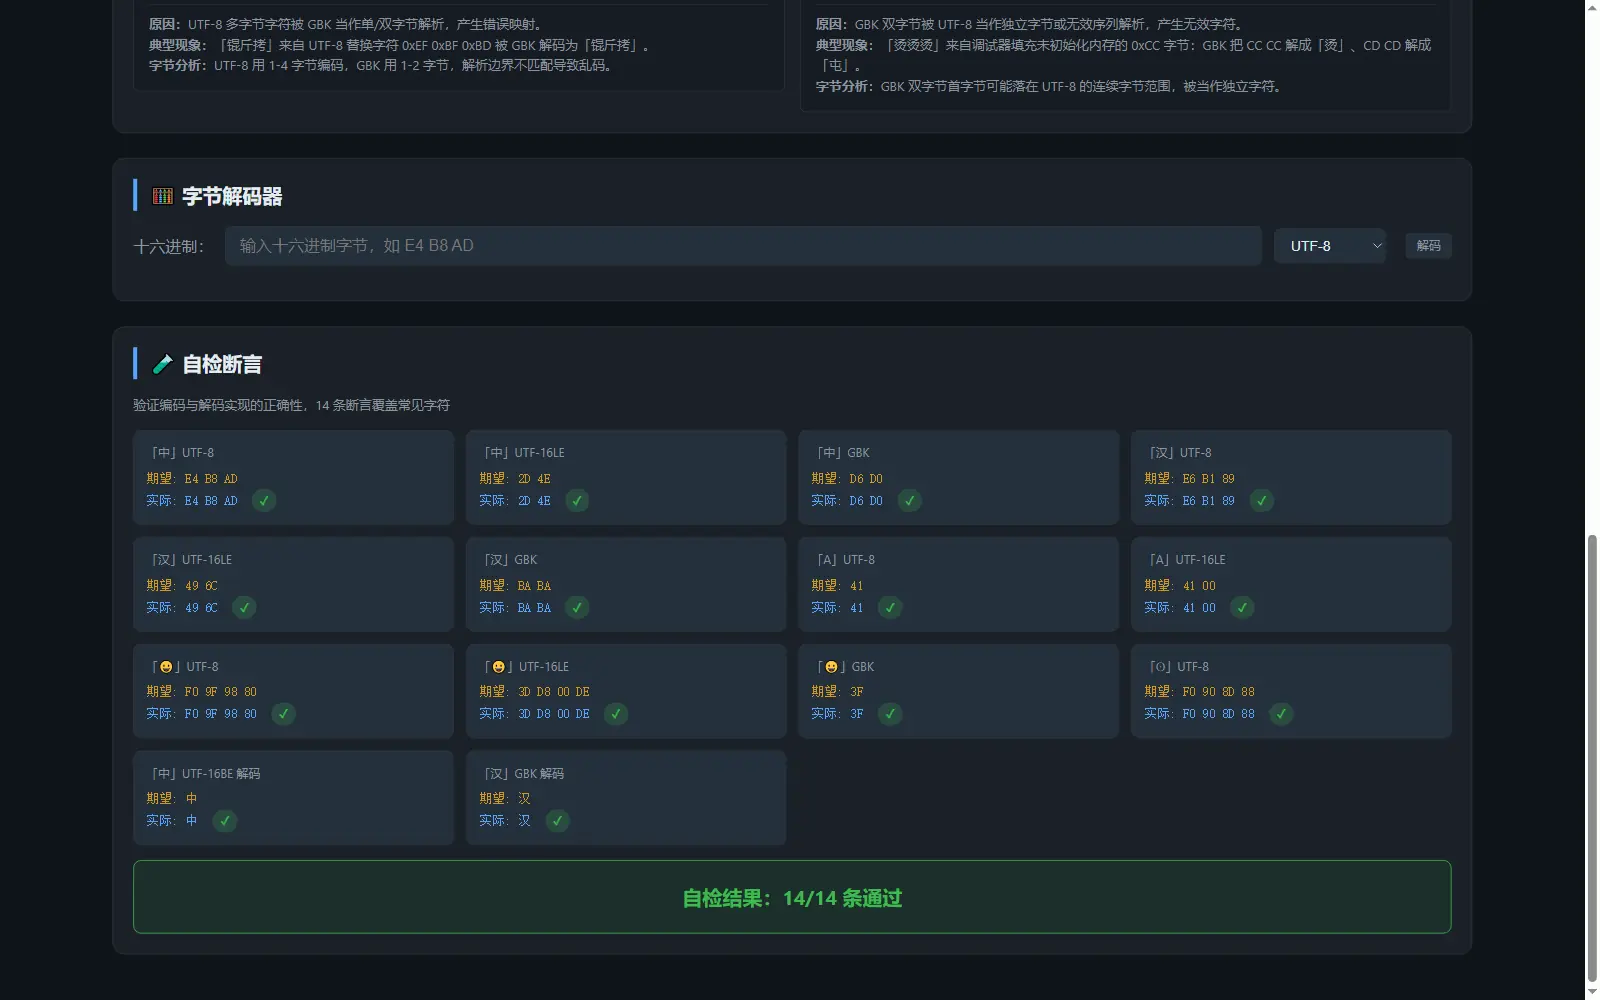
交付过来的时候是 12 条,全绿。
但我在字节解码器里试 UTF-16BE 的时候,它当场就崩了。
输入 4E 2D、选中 UTF-16BE,输出是「❌ 解码失败:e is not defined」。
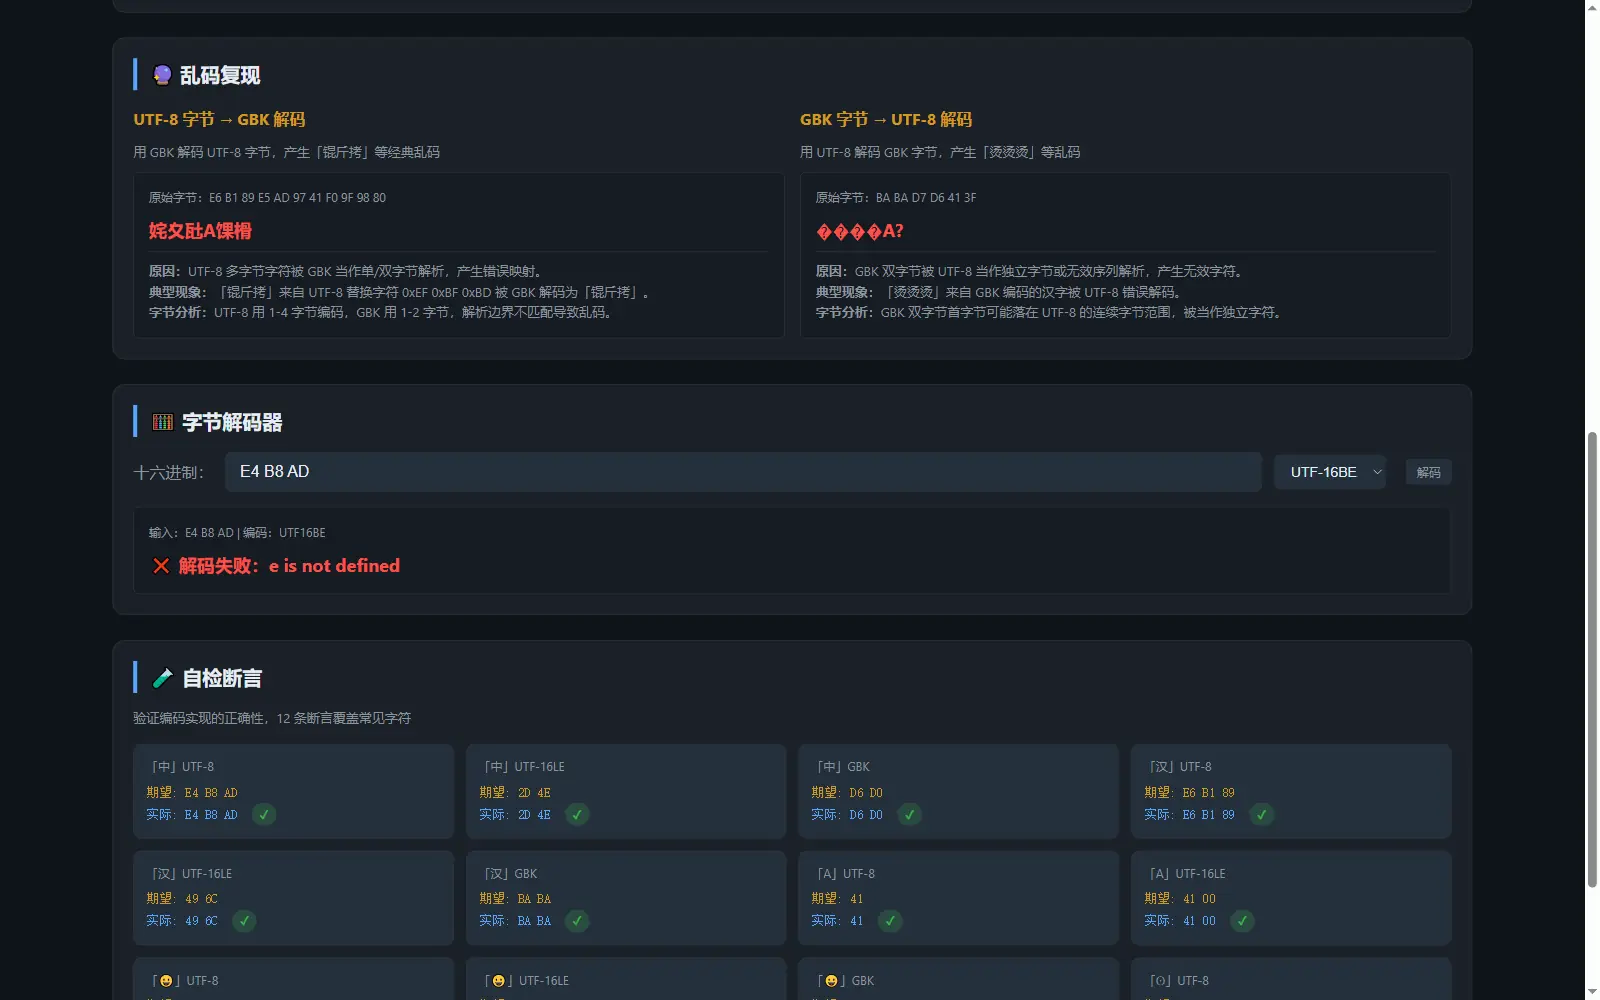
原因很小:那个函数的成功分支里写了一句 e.message,而 e 只在 catch 里存在。
成功路径一走就抛 ReferenceError。
更值得记的是它为什么没被自检拦住,12 条断言全是把字符编成字节,没有一条是把字节解回字符。
编解码是对称的东西,只测一半等于没测。
我补了两条解码断言,一条测「中」的 UTF-16BE,一条测「汉」的 GBK,现在自检是 14 条。
第二处是文案错,不改就是误导。
右栏下面原来写着「烫烫烫来自 GBK 编码的汉字被 UTF-8 错误解码」,这句话是错的。
我在页面上试了原始字节:CC CC 用 GBK 解是「烫」,CD CD 用 GBK 解是「屯」。
所以「烫烫烫」来自调试器把未初始化内存填成 0xCC,跟「GBK 汉字被 UTF-8 解码」没关系。
我把这段文案改成了正确说法,改完又跑了一遍确认数字对得上。
第三处是解码器对非法输入太宽容。
原来输入 ZZ 11,它把 Z 悄悄扔掉,解出一个控制字符 0x11,看起来像正常结果。
现在它会直接报「❌ 含非十六进制字符:ZZ」,十六进制位数是奇数时也会提示补全。
三处改完刷新,自检 14/14,UTF-16BE 解 4E 2D 得到「中」,解 4E 2D 5B 57 得到「中字」。
六、本地复现
把案例目录下载下来,随便起一个静态服务:
bash
cd codearts-unicode-encoding-lab
python -m http.server 8000
浏览器打开 http://localhost:8000/index.html 就能看到跟截图一样的页面。
不起服务直接双击 index.html 也可以。
亲手点三下:先看默认文本的字节表,再把输入换成 𠮷 或 😀 看 N/A 那一格,最后去解码器里贴一段非法十六进制,看它怎么报错。
七、准备环境:打开码道 Web 版
浏览器打开码道 Web 版:devcloud.cn-north-4.huaweicloud.com/chat?source...
登录后在对话框里把需求说清楚就行,不用装软件。
码道有三种使用方式:WebUI 浏览器对话、TUI 终端命令行和桌面 IDE 插件,本文用的是 WebUI。
八、用码道做这个页面的一点体会
需求我一次说完了:四种编码的字节序列、逐字符展开、乱码复现、字节解码器,再加一个自检区。
它一次就给了一个能跑的单文件页面,内置预览里直接能点。
但「能跑」和「对」是两件事。
这三处问题里,最要命的那处在自检全绿的情况下藏得最好。
另外两处是文案和输入校验,都属于不跑一遍就发现不了的。
我的做法是,把自检断言写进需求,交付后自己再逐项点一遍,尤其是编解码这种对称的东西。
让 AI 写代码,验收这一半得自己扛。
九、边界,我写清楚
第一,GBK 映射表是靠 TextDecoder('gbk') 枚举出来的,实测建出 24067 条,覆盖常用汉字够用,但它是按解码结果反推的,不等价于一份权威码表。
第二,页面只处理 GBK,不处理 GB18030,也不处理 Big5 和 Shift-JIS。
第三,emoji 在 GBK 里编不出来,页面统一用 0x3F 问号代替,这是我定的规则,不是标准规定。
第四,自检里的期望值是我手写的,它只能证明代码算出了我预期的东西,证明不了我的预期一定对。