1、什么是Milvus?
Milvus 由 Zilliz 开发,并即将捐赠给 Linux 基金会旗下的 LF AI & Data Foundation,现已成为全球领先的开源向量数据库项目之一。
- 海量规模:单集合支持百亿级向量,水平扩展
- 丰富索引 :
AUTOINDEX、HNSW、IVF_FLAT、IVF_PQ、DISKANN等 - 多距离度量 :
COSINE、L2、IP、HAMMING等 - 混合检索:向量相似度 + 标量字段过滤(metadata filter)一次完成
- 云原生:计算存储分离,存算可独立扩容;数据落在对象存储(MinIO/S3)
- 多语言 SDK:Python(pymilvus)、Java、Go、Node.js、RESTful、gRPC
1.1官方地址
1.2 三种部署形态
| 形态 | 说明 | 适用 |
|---|---|---|
| Milvus Lite | 单进程库,数据存本地文件 | 快速原型、Notebook |
| Standalone | 单机 Docker Compose 一键部署 | 学习、开发、小规模生产 |
| Cluster | K8s 分布式集群 | 大规模生产 |
2、核心概念
对照关系型数据库理解最快:
| 关系型数据库 | Milvus | 说明 |
|---|---|---|
| Database | Database | 库,逻辑隔离 |
| Table | Collection | 集合,一组相同结构的向量 |
| Column | Field | 字段(主键、标量字段、向量字段) |
| Row | Entity | 一条记录(一个向量 + 一堆标量) |
| Primary Key | Primary Key Field | Milvus 支持 Int64 / VarChar 主键 |
| 索引 | Index | 建立在向量字段(或标量字段)上 |
SELECT ... WHERE |
Search / Query | 向量检索 / 标量查询 |
| 表结构定义 (DDL) | 集合模式 (Collection Schema) | Milvus 需要预先定义好 Schema,明确包含哪些字段及其类型,才能创建集合。 |
2.1 Collection 的 Schema
一个最小可用的 Collection 至少要有一个主键字段 和一个向量字段。例如示例项目中 Spring AI 约定使用下面四个字段(名字不能改):
| 字段名 | 类型 | 说明 |
|---|---|---|
doc_id |
VarChar(64),主键 | 文档 ID |
content |
VarChar(65535) | 文档正文 |
metadata |
VarChar(65535) | 元数据,以 JSON 字符串存储 |
embedding |
FloatVector(dim) | 向量,维度必须与 Embedding 模型输出一致 |
2.2 距离度量怎么选
| 分类大类 | 具体类型 | 核心机制 / 特点 | 典型适用场景 |
|---|---|---|---|
| 一、度量类型 (如何算相似度) | 欧氏距离 (L2) | 计算空间直线距离,值越小越相似。对向量的大小/模长敏感。 | 计算机视觉、图像检索、对特征绝对差异敏感的场景。 |
| 内积 (IP) | 计算向量点积,值越大越相似。同时看方向和大小。 | 推荐系统、协同过滤(向量大小/强度包含信息时)。 | |
| 余弦相似度 (COSINE) | 计算向量夹角余弦值,值越大越相似。只看方向,忽略大小。 | 文本/NLP、语义搜索、RAG(最通用省心的选择)。 | |
| 二、索引类型 (如何加速检索) | 平面 (FLAT) | 暴力精确计算,100% 召回率,但速度最慢、内存消耗大。 | 小数据集(百万级以下)、要求绝对准确的场景。 |
| IVF_FLAT | 倒排索引 + 原始向量。速度和内存平衡,召回率较高。 | 中等规模数据集,需要平衡精度和性能的场景。 | |
| IVF_SQ8 | 标量量化,内存占用大幅降低(约为原 1/4),速度快,精度略有损失。 | 内存受限,且能接受轻微精度损失的大规模场景。 | |
| IVF_PQ | 乘积量化,极致压缩内存,但精度损失较大。 | 超大规模数据集,内存极度受限的场景。 | |
| GPU_IVF_FLAT | 基于 GPU 的 IVF_FLAT,利用 GPU 加速,吞吐量极高。 | 对延迟要求极高、有 GPU 资源的高吞吐场景。 | |
| GPU_IVF_PQ | 基于 GPU 的 IVF_PQ,兼顾 GPU 速度与内存压缩。 | 超大规模 + GPU 加速场景。 | |
| HNSW | 基于图的索引,检索速度极快,召回率极高。 | 当前最流行的索引之一,适合对延迟和精度要求都很高的场景(内存消耗较大)。 | |
| DISKANN | 磁盘索引,内存占用极低,适合超大规模。 | 百亿级向量、内存严重受限的场景。 | |
| 三、向量数据类型 (界面顶部标签) | 浮点 (Float) | 存储连续浮点数(FLOAT_VECTOR),最常用的向量类型。 |
配合上述 L2 / IP / COSINE 度量,适用于绝大多数 AI 场景。 |
| 嵌入二进制嵌入 (Binary) | 存储二进制向量(BINARY_VECTOR)。 |
配合汉明/杰卡德距离,适合哈希或极速粗筛。 | |
| 稀疏嵌入 (Sparse) | 存储稀疏向量(SPARSE_FLOAT_VECTOR)。 |
配合 BM25 或内积,适合关键词 + 语义的混合检索。 |
3、docker compose安装单节点
3.1 安装文档
https://milvus.io/docs/zh/install_standalone-docker-compose.md
3.2 安装
Milvus 在其仓库中提供了一个 Docker Compose 配置文件。要使用 Docker Compose 安装 Milvus,只需运行
wget https://github.com/milvus-io/milvus/releases/download/v3.0.2/milvus-standalone-docker-compose.yaml -O docker-compose.yaml

sudo docker compose up -d

Creating milvus-etcd  ... done
Creating milvus-minio ... done
Creating milvus-standalone ... done
默认部署(v3.0.2):
docker compose up -d将启动三个容器------milvus-etcd(元数据)、milvus-minio(对象存储)和milvus-standalone。消息队列使用Woodpecker(嵌入式,以 MinIO / 对象存储作为其 WAL 后端),因此无需单独的消息队列容器。各版本的消息队列默认设置:
- 2.5.x --- 默认消息队列为RocksMQ。
- 2.6.x 及更高版本 --- 默认消息队列为Woodpecker(嵌入式)。
启动 Milvus 后,
- 名为Milvus Standalone 、milvus-minio 和milvus-etcd 的容器已启动。
- milvus-etcd 容器未向主机暴露任何端口,并将数据映射到当前文件夹中的volumes/etcd。
- milvus-minio 容器在本地监听9000 和9001 端口,使用默认身份验证凭据,并将数据映射到当前文件夹中的volumes/minio目录。
- Milvus Standalone 容器在本地通过默认设置提供19530 端口服务,并将数据映射到当前文件夹中的volumes/milvus目录。
您可以使用以下命令检查容器是否已启动并正在运行:
docker compose ps

NAME                IMAGE   COMMAND                  SERVICE      CREATED         STATUS                   PORTS
milvus-etcd         ...       "etcd -advertise-cli..."   etcd         2 minutes ago   Up 2 minutes (healthy)   2379-2380/tcp
milvus-minio        ...       "/usr/bin/docker-ent..."   minio        2 minutes ago   Up 2 minutes (healthy)   9000-9001/tcp
milvus-standalone   ...       "/tini -- milvus run..."   standalone   2 minutes ago   Up 2 minutes (healthy)   0.0.0.0:9091->9091/tcp, 0.0.0.0:19530->19530/tcp
3.3 访问WebUI
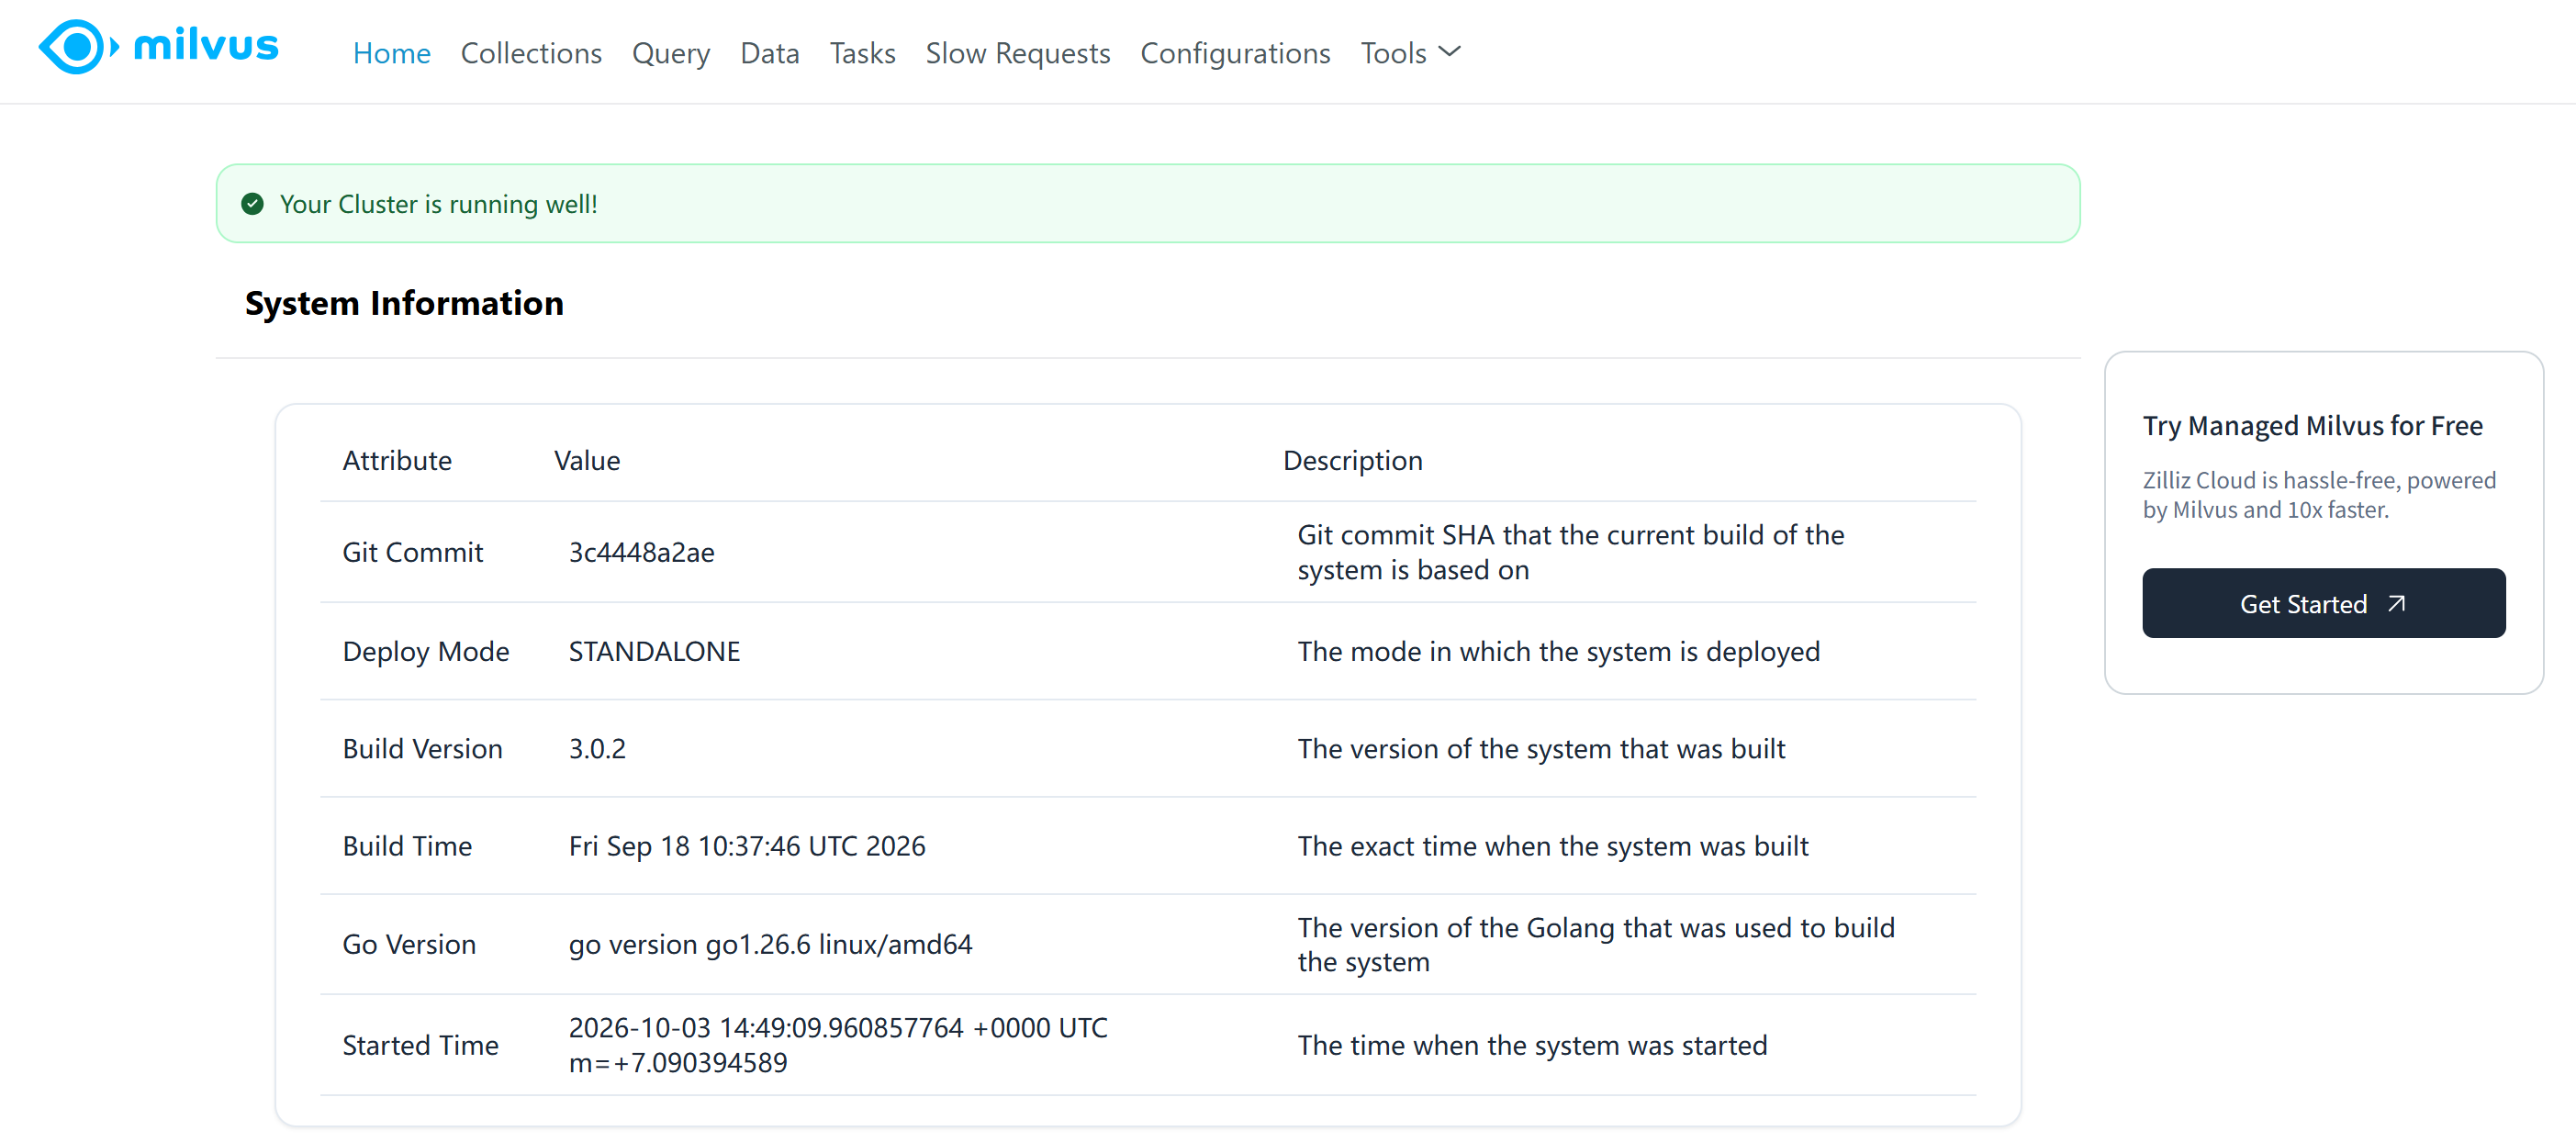
您还可以访问http://127.0.0.1:9091/webui/ 上的 Milvus WebUI,以了解有关您的 Milvus 实例的更多信息。有关详细信息,请参阅Milvus WebUI。
4、java代码示例
4.1 依赖
<properties>
    <java.version>21</java.version>
    <spring-ai.version>2.0.0</spring-ai.version>
</properties>

<dependencies>
    <!-- Web -->
    <dependency>
        <groupId>org.springframework.boot</groupId>
        <artifactId>spring-boot-starter-webmvc</artifactId>
    </dependency>

    <!-- Milvus 向量存储 Starter(核心) -->
    <dependency>
        <groupId>org.springframework.ai</groupId>
        <artifactId>spring-ai-starter-vector-store-milvus</artifactId>
    </dependency>

    <!-- Ollama Embedding 模型 -->
    <dependency>
        <groupId>org.springframework.ai</groupId>
        <artifactId>spring-ai-starter-model-ollama</artifactId>
    </dependency>

    <!-- 读取 PDF/Word/TXT 等文档 -->
    <dependency>
        <groupId>org.springframework.ai</groupId>
        <artifactId>spring-ai-tika-document-reader</artifactId>
    </dependency>
</dependencies>

<dependencyManagement>
    <dependencies>
        <dependency>
            <groupId>org.springframework.ai</groupId>
            <artifactId>spring-ai-bom</artifactId>
            <version>${spring-ai.version}</version>
            <type>pom</type>
            <scope>import</scope>
        </dependency>
    </dependencies>
</dependencyManagement>
4.2 配置(application.yaml)
spring:
  ai:
    vectorstore:
      milvus:
        client:
          host: 172.168.0.1        # Milvus 地址
          port: 19530              # gRPC 端口
        collection-name: spring_ai_docs
        # 关键:必须与 Embedding 模型输出维度完全一致
        embedding-dimension: 768
        # 距离算法:COSINE / L2 / IP
        metric-type: COSINE
        # 首次启动设为 true,让 Spring AI 自动建集合与索引
        initialize-schema: true
    ollama:
      base-url: http://172.168.0.1:11434
      embedding:
        model: nomic-embed-text:latest
配置要点:
| 配置项 | 说明 |
|---|---|
collection-name |
集合名,不存在且 initialize-schema=true 时自动创建 |
embedding-dimension |
必须与模型维度一致,否则写不进去 |
metric-type |
相似度算法,改了需要重建集合与索引 |
initialize-schema |
自动建表开关;生产环境建议关掉,用 Flyway/脚本管理结构 |
4.3 文档向量增删改查(CRUD)
4.3.1 增:单条 / 批量
// 单条:指定 ID + 正文 + 元数据
Document doc = new Document(
        TEST_ID,
        "Milvus 是一个开源的分布式向量数据库,支持向量相似度搜索和丰富的过滤功能。",
        Map.of("category", "database", "type", "test")
);
vectorStore.add(List.of(doc));

// 批量
List<Document> docs = List.of(
        new Document("Java 是一门面向对象的编程语言......", Map.of("category", "programming", "lang", "java")),
        new Document("Python 简洁易学,在 AI 领域广泛使用......", Map.of("category", "programming", "lang", "python"))
);
vectorStore.add(docs);
metadata 会被序列化成 JSON 存进 metadata 字段,是后续做过滤的唯一依据。
4.3.2 查:相似度检索
List<Document> results = vectorStore.similaritySearch(
        SearchRequest.builder()
                .query("高性能向量数据库")        // 自然语言查询,无需关键词命中
                .topK(3)                          // 返回最相似的 3 条
                .similarityThreshold(0.3)         // 相似度下限(0~1),过滤噪声
                .build()
);
4.3.3 查:带 metadata 过滤(混合检索)
FilterExpressionBuilder b = new FilterExpressionBuilder();
List<Document> results = vectorStore.similaritySearch(
        SearchRequest.builder()
                .query("编程语言")
                .topK(5)
                .similarityThreshold(0.3)
                .filterExpression(b.and(
                        b.eq("category", "programming"),
                        b.eq("lang", "java")
                ).build())
                .build()
);常用过滤表达式:eq / ne / gt / gte / lt / lte / in / nin / like / and / or / not。
4.3.4 改:删除 + 重新插入
向量数据库一般不支持「原地改向量」,标准做法是 按 ID 删除后再插入同 ID 的新文档:
vectorStore.delete(List.of(TEST_ID));          // 1. 删旧
Document updated = new Document(TEST_ID, "新内容......", Map.of("version", "v2"));
vectorStore.add(List.of(updated));             // 2. 插新(保持 ID 不变)
4.3.5 删:按 ID / 按过滤条件
vectorStore.delete(List.of(tempId));                 // 按 ID 批量删
vectorStore.delete(b.eq("type", "test").build());    // 按条件删(清理测试数据)