先给结论:取模分片加一台机器,10 万个 key 里有 8 万个要换家。
换成一致性哈希,同一批 key 只有 7.6% 动窝。
这两个数字不是我算的,是页面打开时当场跑出来的。
我把哈希环、负载柱状图和 9 条自检断言塞进了一个单文件页面。
双击就能跑,不联网,不引第三方库。
案例目录在这里,下载下来直接打开:
text
https://atomgit.com/deli007/demo_park/tree/main/codearts-consistent-hashing-ring先说结论:1/N 是平均值,不是保证
加一台节点后要搬多少 key,取决于新节点在环上接管的那段弧有多长。
期望值是 1/N,四台变五台就是 25%。
我实测了三次加节点,迁移率分别是 4.2%、7.6% 和 17.3%。
落在短弧上就远低于 25%,落在长弧上就会超。
所以「只有 1/N 要搬家」的准确说法是「平均 1/N,单次看运气」。
为什么取模分片一扩容就全线失效
取模分片的分法是 hash(key) % N,机器数 N 就是公式里的分母。
N 从 4 变成 5,绝大多数 key 的余数都会变,缓存几乎全部作废。
| 方案 | 4 台加 1 台后的迁移率 | 要搬的 key 数 |
|---|---|---|
| 取模 hash % N | 80.0% | 80022 / 100000 |
| 一致性哈希 | 7.6% | 7648 / 100000 |
取模法这次迁移 80.0%,正好等于 N/(N+1)。
一致性哈希的 7.6% 只落在新节点接管的那段弧上,其余 key 一个没动。
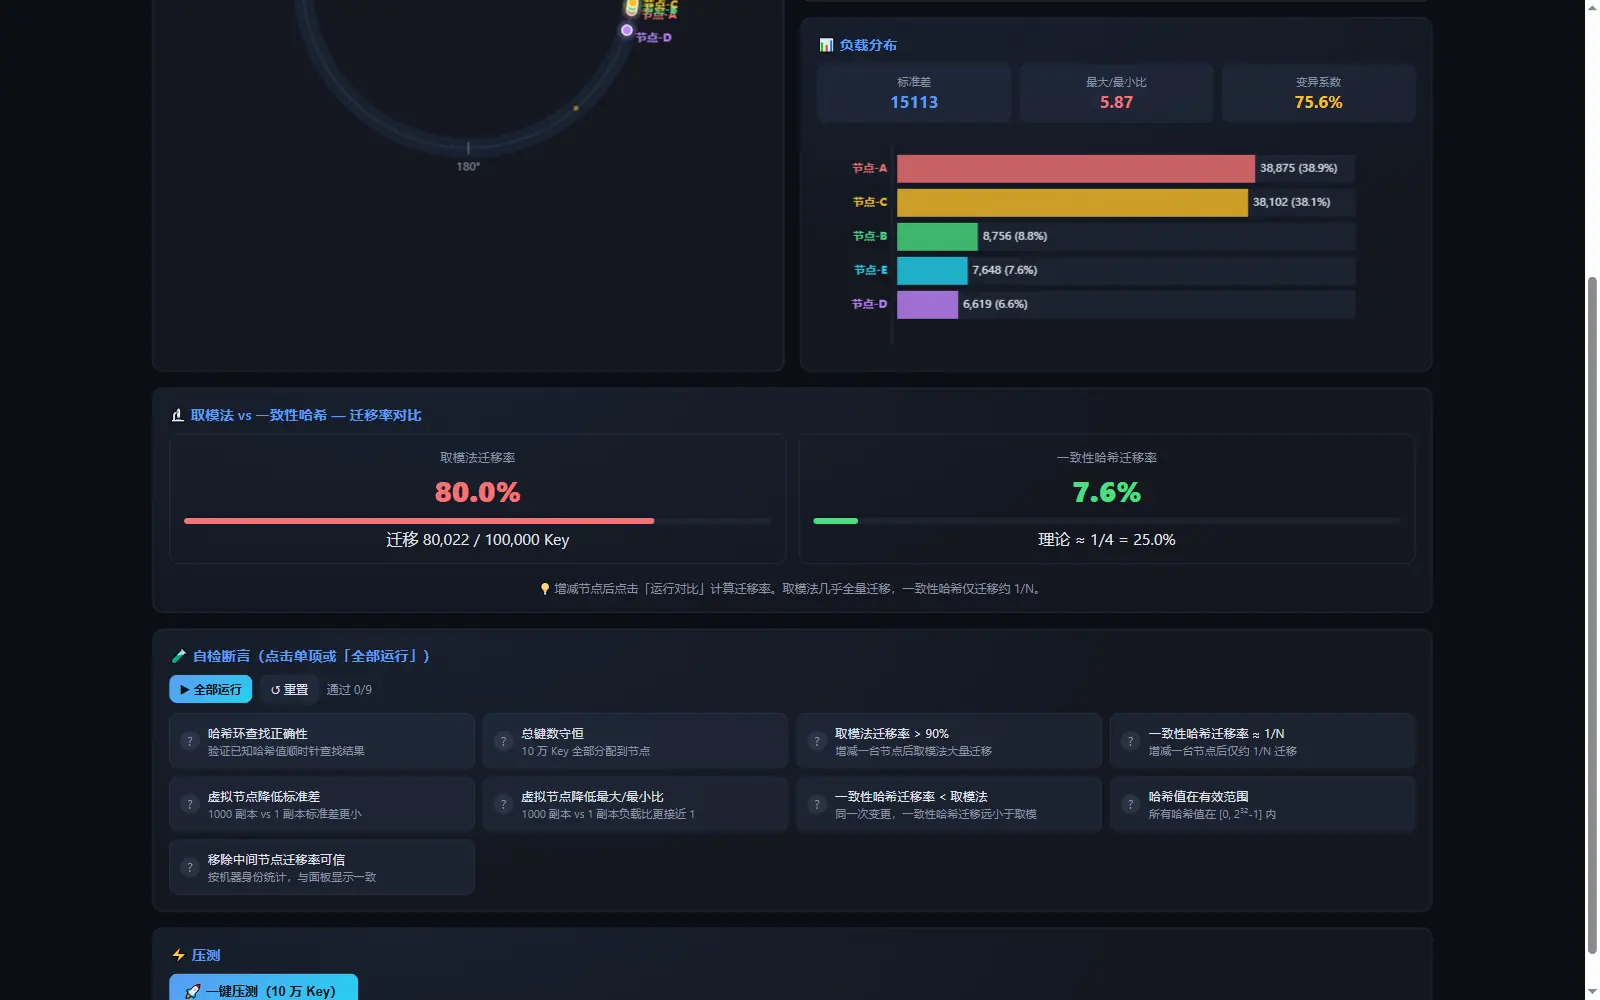
这不是调参调出来的差距,是两种分法在数学上的区别。
第一步:把 key 和机器都丢到同一个环上
哈希函数用的是 FNV-1a 32 位,机器名和 key 走的是同一个函数。
机器名先哈希成一个 32 位整数,再按 hash / 2³² 映射到 0°~360°。
key 也一样,落在哪个角度就顺时针找第一台机器。
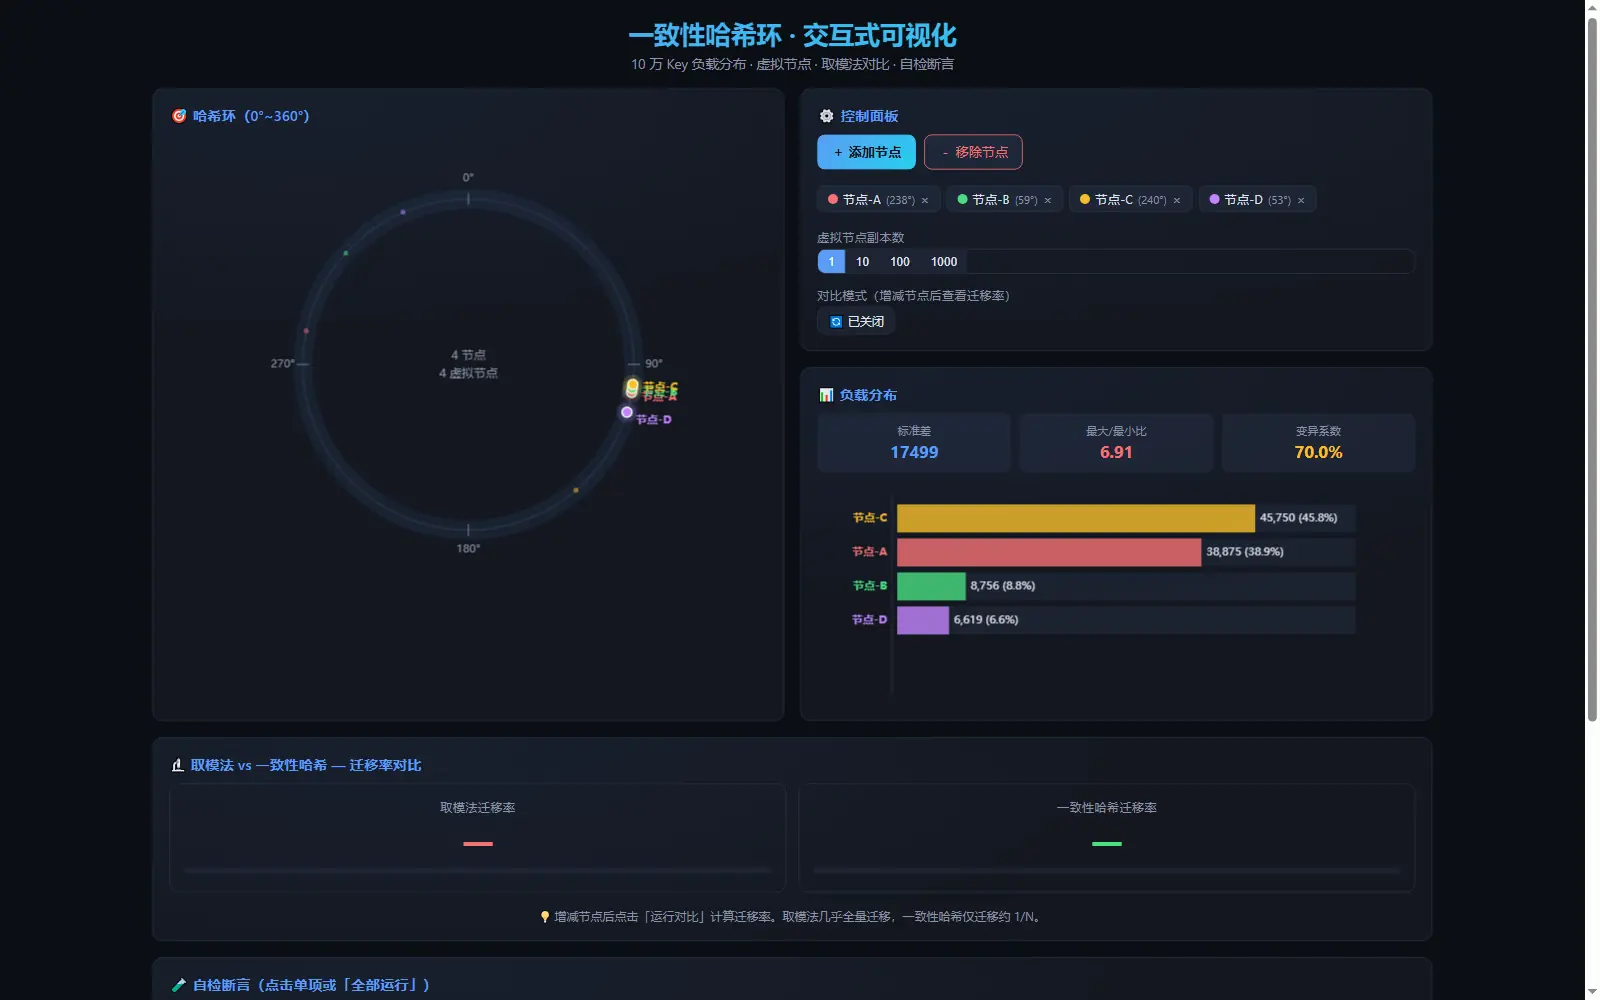
四台机器落在环上的位置是 238°、59°、240° 和 53°。
图 1 里能直接看到,四个点全挤在右侧,环的大半圈是空的。
第二步:只有 4 个点的时候,环是歪的
点数少,弧长就极不均匀。
10 万个 key 分下来,四台机器的负载是 45750、38875、8756 和 6619。
最多的那台占 45.8%,最少的那台只有 6.6%,相差 6.91 倍。
| 副本数 | 环上点数 | 标准差 | 最大/最小比 | 变异系数 |
|---|---|---|---|---|
| 1 | 4 | 17499 | 6.91 | 70.0% |
| 10 | 40 | 18177 | 8.05 | 72.7% |
| 100 | 400 | 7006 | 2.15 | 28.0% |
| 1000 | 4000 | 3201 | 1.37 | 12.8% |
这里有个反直觉的地方:10 副本比 1 副本还差。
原因是 40 个点仍然是随机撒的,这次刚好撒得更偏。
要到 100 副本以上,标准差才开始稳定往下走。
所以「加虚拟节点能均衡」这句话,前面得加个数量级。
第三步:1000 副本之后环才真正均匀
把副本数拉到 1000,环上就有 4000 个点。
环上整圈都被涂满了,四台机器的色带长度肉眼看着差不多。
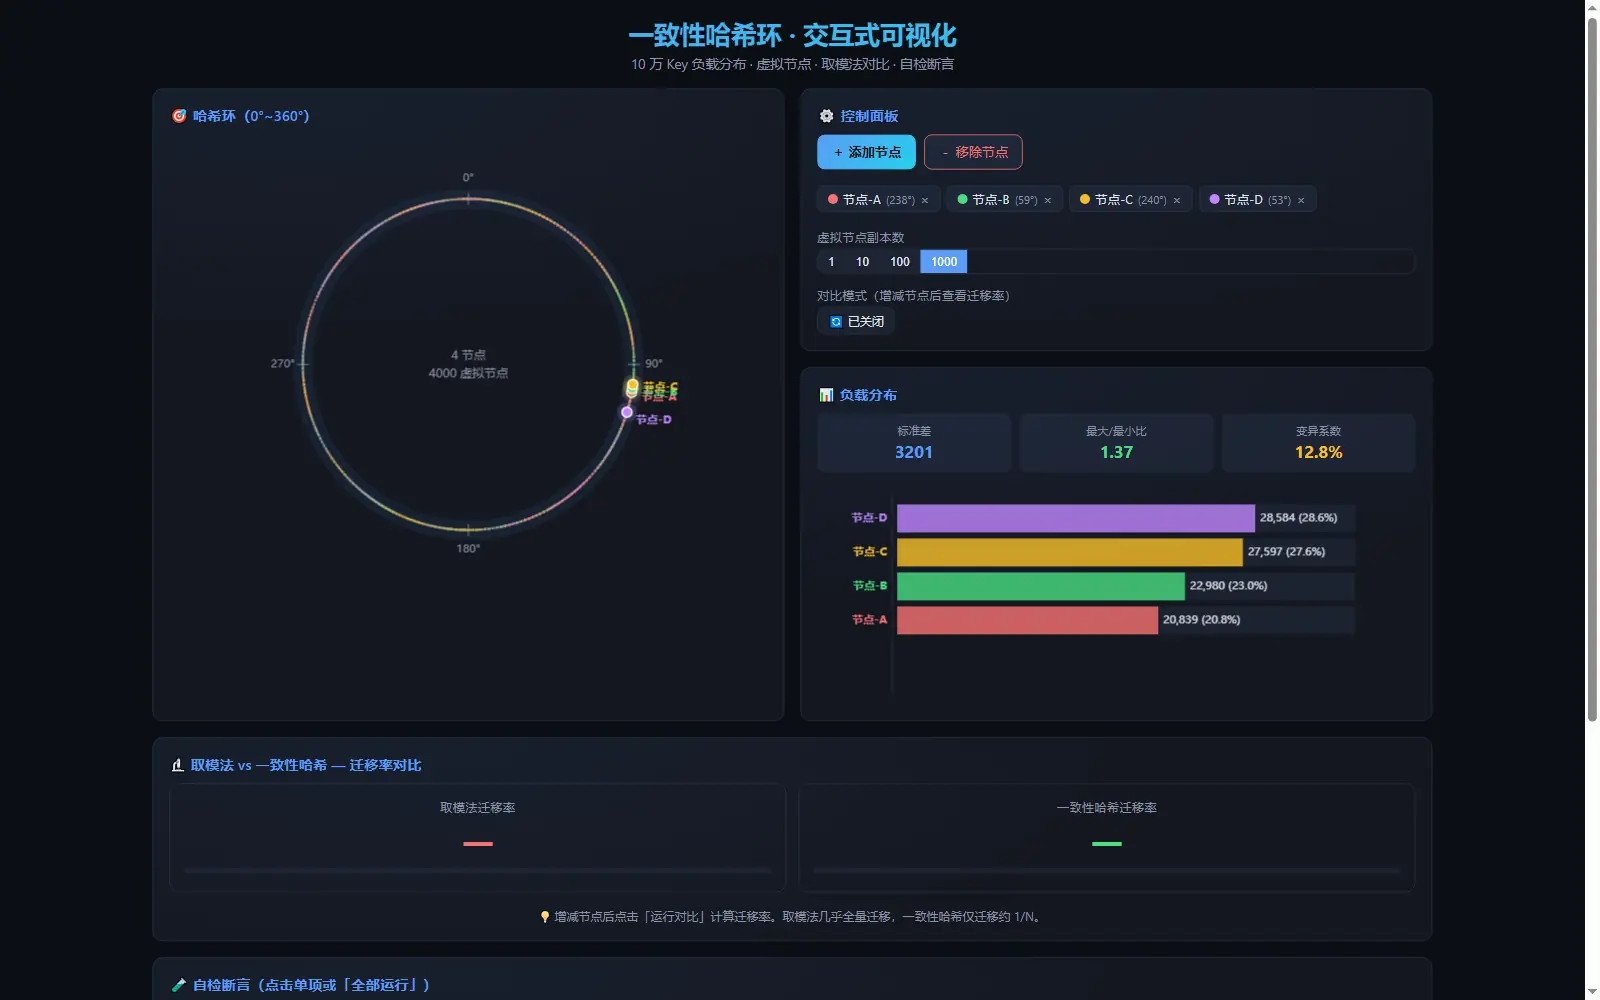
负载变成 28584、27597、22980 和 20839,最多的只比最少的多 37%。
标准差从 17499 掉到 3201,变异系数从 70.0% 掉到 12.8%。
代价是环上的点从 4 个涨到 4000 个,查找时二分要多走 10 层。
验证与踩坑:9 条断言抓出一个真 bug
页面底部有 9 条断言,点一下就跑,每条都给实测值和结论。
前面 8 条都是常规检查:查找正确性、键数守恒、两种方案的迁移率、虚拟节点的方差改善、哈希值范围。
第 9 条是我加进去专门盯指标本身的,它当场红了一条。
红的那行错误提示写着「面板显示 61.1%,按机器身份实为 8.8%」,底部统计是 8/9 通过。
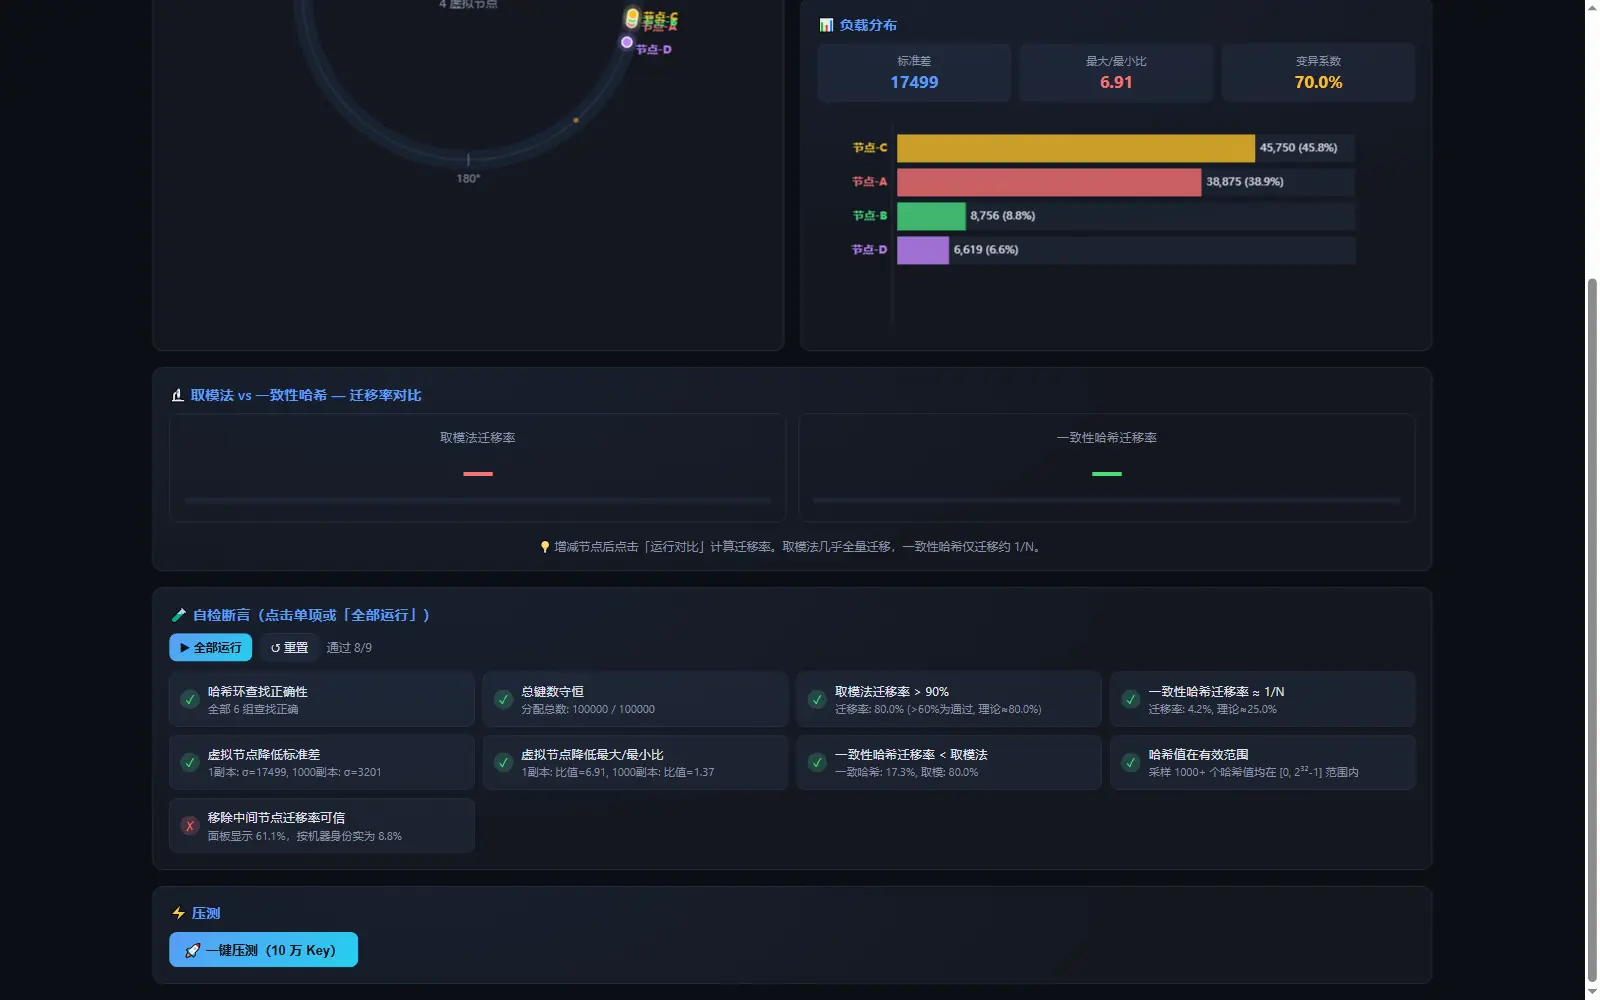
移除一台中间节点后,面板报出的一致性哈希迁移率是 61.1%。
但按机器身份逐个比对 10 万个 key,真正换家的只有 8.8%。
差了 52 个百分点,问题出在比较方式上。
迁移率原来是拿数组下标比的,移除中间节点会让后面所有机器的下标往前挪一位。
同一个物理节点下标从 3 变成 2,代码就认定它上面的 key 全搬走了。
删最后一台不会触发,因为最后一个下标没人跟着挪,所以之前的测试一直没发现。
修法很简单:给每个 key 记下它归属的机器名,比较时比名字而不是比下标。
改完之后,同样的场景面板显示 8.8%,和按名字统计的结果完全一致。
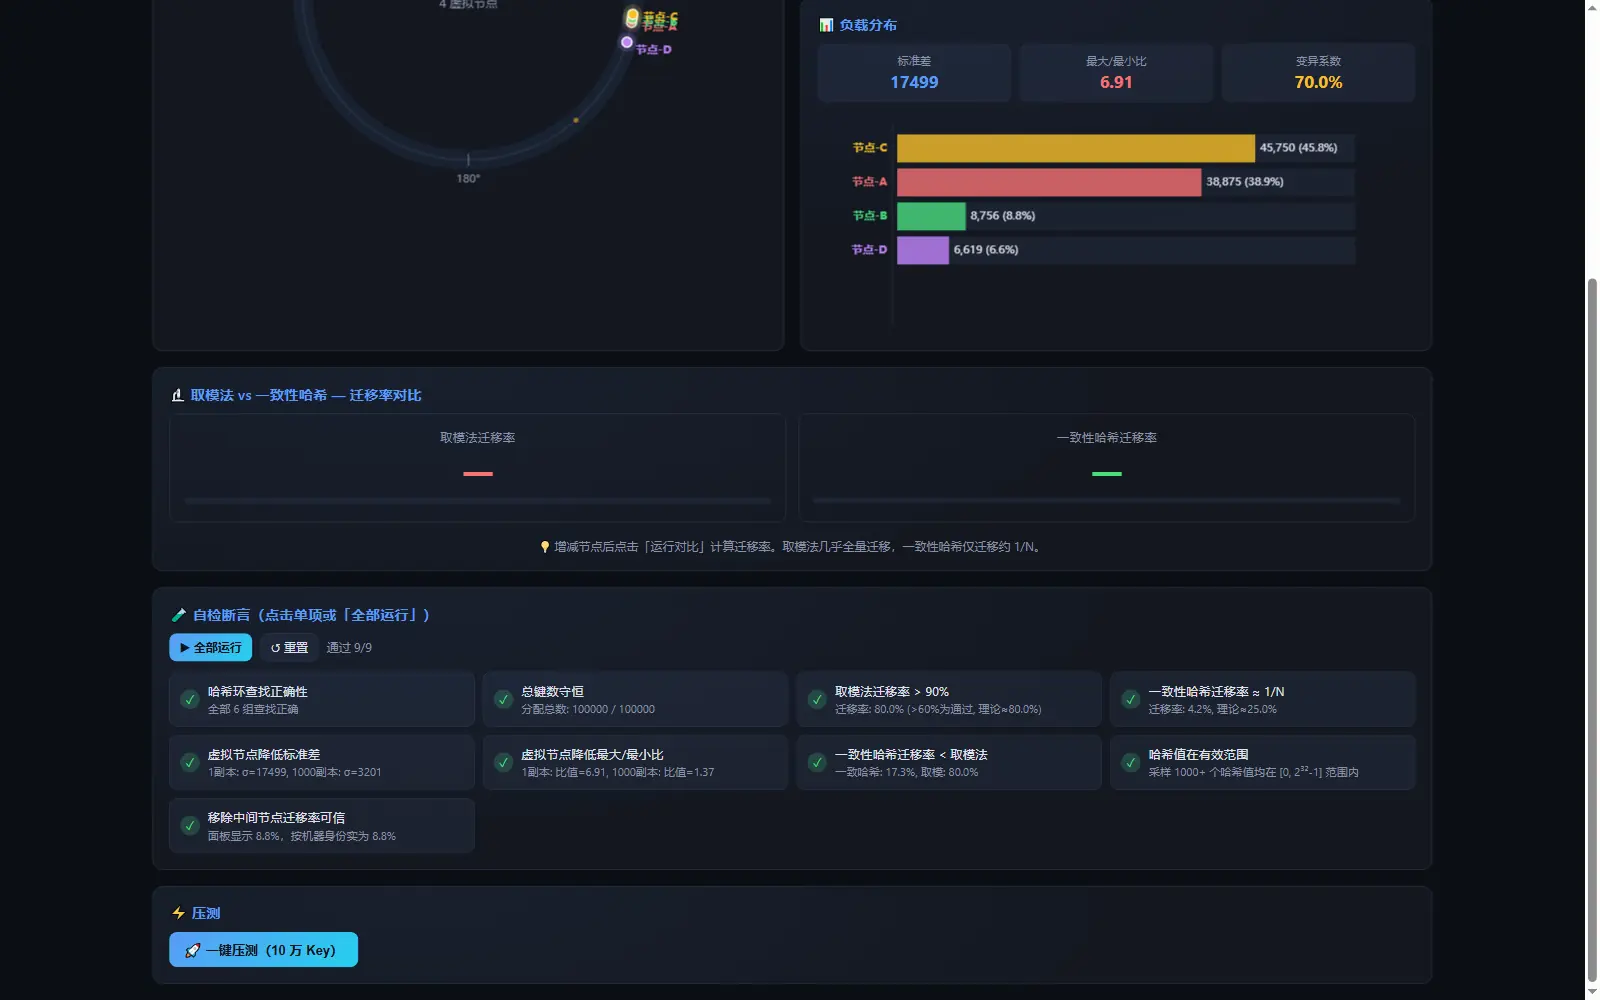
9 条断言跑完是 9/9 通过,刷新两遍数字一样。
顺手压了个测:10 万个 key 11.9 ms
页面上有个一键压测按钮,跑的是同一套 key 生成和哈希分配。
实测分配 10 万个 key 耗时 11.9 ms,平均每个 key 0.12 μs。
这个数字只说明分配本身不慢,它不是真实网络的延迟。
真正的 Redis 集群里,一次请求的开销远不止算一次哈希。
本地复现
把案例目录下载下来,起一个静态服务就行:
bash
cd codearts-consistent-hashing-ring
python -m http.server 8000
浏览器打开 http://localhost:8000/index.html 就能看到和截图一样的页面。
不起服务直接双击 index.html 也可以。
想看那条红断言的样子,把代码里迁移率改回按下标比较,再点「全部运行」。
准备环境:打开码道 Web 版
浏览器打开码道 Web 版:devcloud.cn-north-4.huaweicloud.com/chat?source...
登录后在对话框里把需求说清楚就行,不用装软件。
码道有三种使用方式:WebUI(浏览器对话)、TUI(终端命令行)和桌面 IDE(IDE 插件),本文用的是 WebUI。
用码道做这个页面的一点体会
我把需求一次说完:哈希环、增删节点、10 万 key 负载柱状图、取模对比、虚拟节点、自检断言、一键压测。
它一次就给了一个 895 行的单文件页面,点开就能玩。
但「能跑」和「数字对」是两件事。
那个迁移率 bug 藏在指标实现里,页面看着一切正常,9 条断言里前 8 条也全是绿的。
它不是读代码读出来的,是新加的断言把两个口径摆在一起才露出来的。
图 3 那张均匀的环也不是第一版就有的,是我把副本数从 1 一路试到 1000 才确认的点位。
我的结论只有一句:AI 写的页面,验收这一半得自己扛。
边界,我写清楚
第一个边界:负载和迁移率都是在浏览器里用 FNV-1a 算的,和 Redis、Nginx 用的哈希函数不一样,绝对数字不能直接搬。
第二个边界:10 万个 key 的负载分布只代表这一批 key,换个 key 前缀,四台机器的负载会重排。
第三个边界:1/N 是期望值,单次加节点的迁移率可能远低也可能高于它,页面给的是实测值不是保证值。
第四个边界:这台机器上的耗时数字只反映本机浏览器,不代表线上集群的延迟。