@toc 
本篇摘要
本文详解C++ atomic 类型,涵盖其线程安全原理、CAS操作(含weak/strong区别)、内存顺序选项及无锁编程实践。通过对比无锁栈与有锁栈性能,阐明低并发用锁、高并发用无锁的选型逻辑,并附自旋锁实现,帮助理解原子操作核心机制。
一.atomic介绍
简单介绍
-
atomic的定义 :atomic是一个模板的实例化和全特化均定义的
原子类型,它能够保证对一个原子对象的操作是线程安全的(因为如果临界区太小,频繁加解锁会在等待和唤醒的时候付出代价,因此引入了atomic这个原子类型)。 -
高版本的语法支持
智能指针管理atomic,对应atomic的话,它是支持全部内置类型,但是自定义类型就不一定了。 -
对应
atomic<int>这个类型其实就是atomic_int(这个是atomic<int> typedef出来的) -
atomic对T类型的要求 :atomic可以使用任何满足可复制构造(CopyConstructible)和可复制赋值(CopyAssignable)的可平凡复制(TriviallyCopyable)类型T进行实例化。当使用以下几个函数对T类型进行判断时,如果其中
任何一个函数返回false,则用于atomic的操作就不是原子操作。
cpp
std::is_trivially_copyable<T>::value
std::is_copy_constructible<T>::value
std::is_move_constructible<T>::value
std::is_copy_assignable<T>::value
std::is_move_assignable<T>::value
std::is_same<T, typename std::remove_cv<T>::type>::value- 因此我们使用自定义类型的时候就可以检测下,如果不符合,那么就不能使用
atomic< type >了(比如string就不是原子的)。
比如进行atomic定义整型 指针变量的时候,这个atomic类特化了一些函数,如下:
| 函数 | 描述 | 备注 | |
|---|---|---|---|
| 为整数、浮点数(C++20 起)和指针类型特化 | |||
| fetch_add | 原子地将实参加到存储于原子对象的值上,并返回先前保有的值 | (公开成员函数) | |
| fetch_sub | 原子地从存储于原子对象的值减去实参,并获得先前保有的值 | (公开成员函数) | |
| operator+= operator-= | 与原子值进行加、减 | (公开成员函数) | |
| 仅为整数和指针类型特化 | |||
| fetch_max (C++26) | 原子地进行实参和原子对象的值的 std::max,并获得先前保有的值 | (公开成员函数) | |
| fetch_min (C++26) | 原子地进行实参和原子对象的值的 std::min,并获得先前保有的值 | (公开成员函数) | |
| operator++ operator++(int) operator-- operator--(int) | 令原子值增加或减少一 | (公开成员函数) | |
| 仅为整数类型特化 | |||
| fetch_and | 原子地进行实参和原子对象的值的逐位与,并获得先前保有的值 | (公开成员函数) | |
| fetch_or | 原子地进行实参和原子对象的值的逐位或,并获得先前保有的值 | (公开成员函数) | |
| fetch_xor | 原子地进行实参和原子对象的值的逐位异或,并获得先前保有的值 | (公开成员函数) | |
| operator&= operator | = operator^= | 与原子值进行逐位与、或、异或 | (公开成员函数) |
==举个例子:==
比如之前讲的单核 多核cpu操作的时候,就拿简单的加法计算操作来说,由于对应加法操作不是原子的,也就不是一条指令而是多条指令(看汇编可以看出),因此会造成多线程情况下造成意外发生(之前在上几篇,线程不安全的介绍中讲过,这里就不多说了)。
而对应atomic,它就保证读取与写入是同一个指令操作;这样就不会造成多线程操作导致的不安全事件的发生。
atomic原理分析
load和store可原子读写atomic封装的T对象。atomic原理依赖硬件:现代处理器提供原子指令(如 x86 的 CMPXCHG),能执行不可分割的读 - 比较 - 写操作(CAS 等);还采用缓存一致性协议,保证多处理器缓存中变量副本的一致性(也就是多核的时候,拿到内存中的变量应该保持正确性,比如要么旧数据标记无效,要么及时同步最新被修改的数据)。
==对应CAS操作的接口,不同平台都有封装,C++11也提供了:==
GCC支持的CAS接口:
cpp
bool __sync_bool_compare_and_swap (type *ptr, type oldval, type newval);
type __sync_val_compare_and_swap (type *ptr, type oldval, type newval);
Windows支持的CAS接口:
cpp
InterlockedCompareExchange (
    __inout LONG volatile *Target,
    __in LONG Exchange,
    __in LONG Comperand
);
C++11支持的CAS接口:
cpp
template <class T>
bool atomic_compare_exchange_weak (atomic<T>* obj, T* expected, T val) noexcept;

template <class T>
bool atomic_compare_exchange_strong (atomic<T>* obj, T* expected, T val) noexcept;
C++11中atomic类的成员函数:
cpp
bool compare_exchange_weak (T& expected, T val,
                            memory_order sync = memory_order_seq_cst) noexcept;

bool compare_exchange_strong (T& expected, T val,
                              memory_order sync = memory_order_seq_cst) noexcept;
先看图抽象理解下CAS的操作:
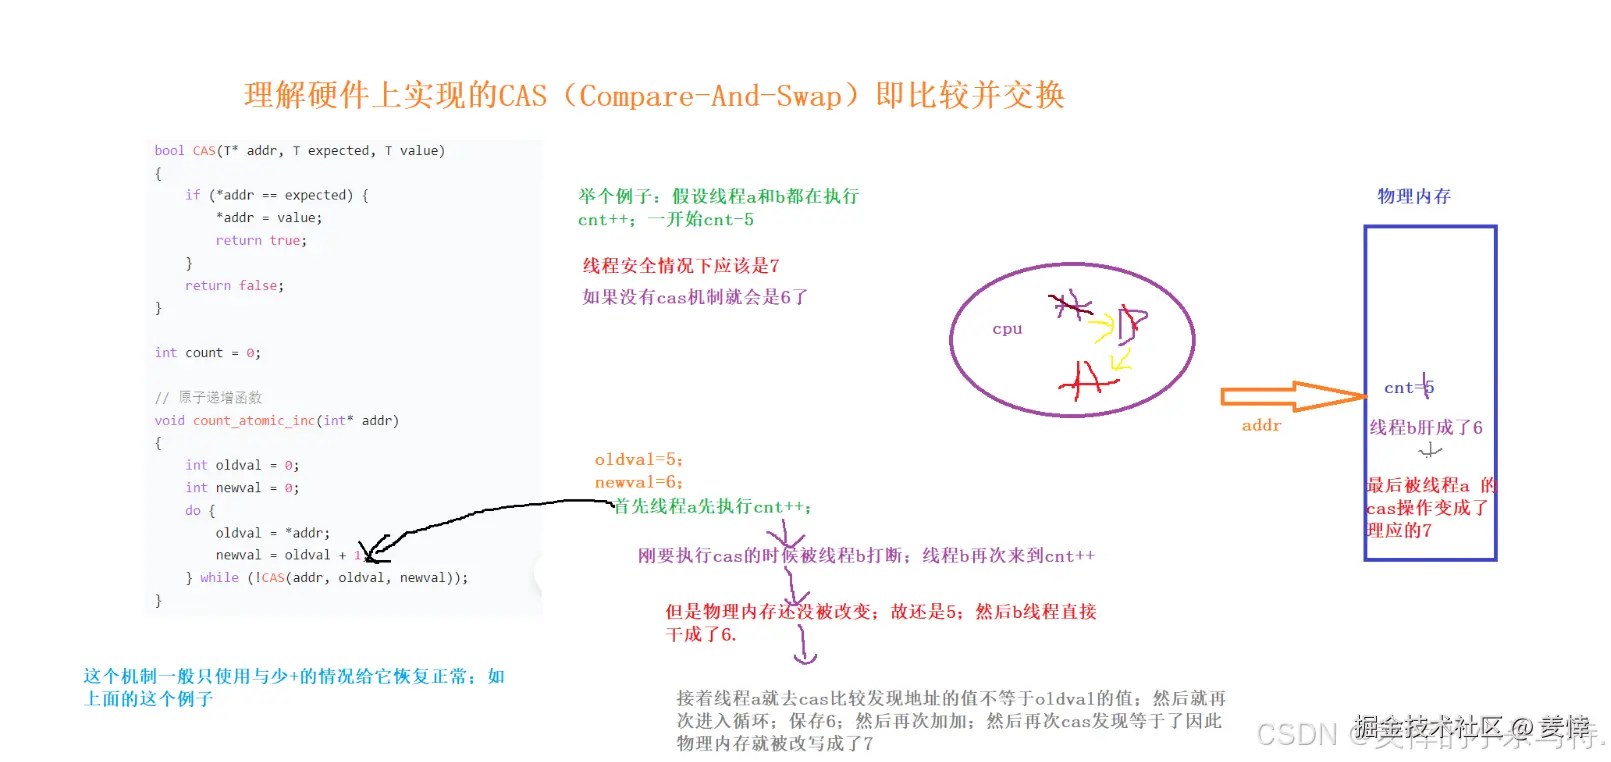
下面通过atomic内部调用的函数来模拟下atomic的整型变量++的操作:
首先先看段模拟的关于普通cnt++与atomic修饰后++的程序:
cpp
#include<atomic>
#include <iostream>
#include <thread>
#include <mutex>
#include<vector>
//atomic<int> acnt;
atomic_int acnt; //typedef的
int cnt = 0;
void Add1(atomic<int>& cnt)
{
    int old = cnt.load();

    while (!atomic_compare_exchange_weak(&cnt, &old, old + 1));//系统接口
   // while (!cnt.compare_exchange_weak(old, old + 1));//atomic封装的,里面能直接拿到对应的cnt值;两个等效
}

void f()
{
    for (int n = 0; n < 100000; ++n)
    {
        //++acnt;
        // Add1的用CAS模拟atomic的operator++的原子操作
        Add1(acnt);

        ++cnt;
    }
}
int main()
{
    std::vector<thread> pool;
    for (int n = 0; n < 4; ++n)
        pool.emplace_back(f);

    for (auto& e : pool)
        e.join();

    cout << "原子计数器为 " << acnt << '\n'
        << "非原子计数器为 " << cnt << '\n';

    return 0;
}
下面解释下:
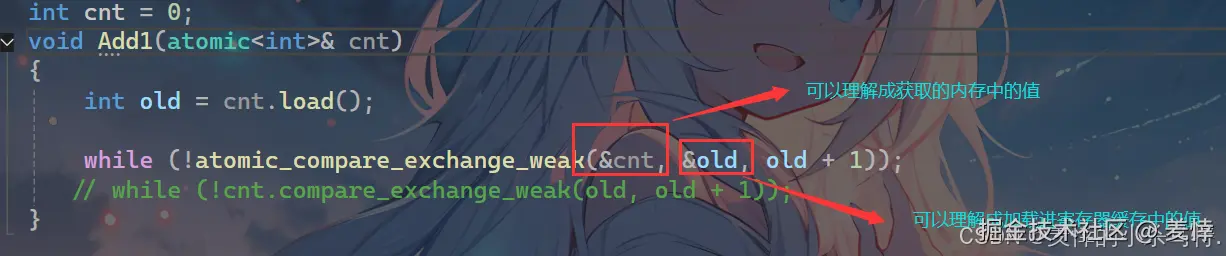
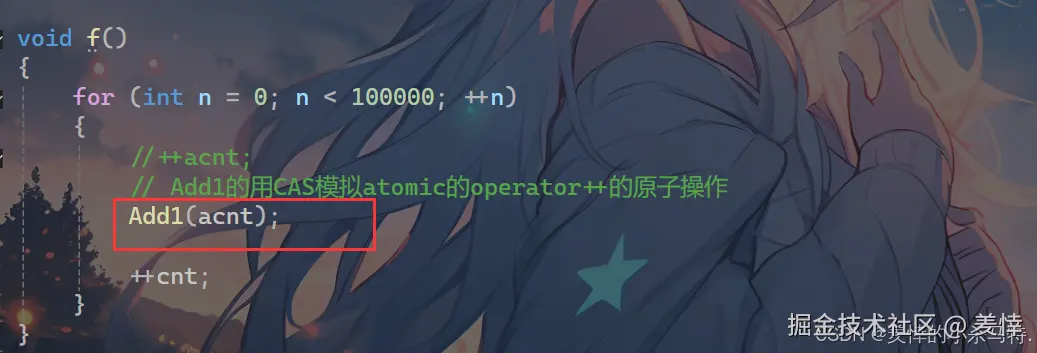
- 这里如果不是多线程的话,也就是单线程,此时走Add1函数,假设一开始acnt是0,此时&cnt拿到的是内存中也是0,发现和old(也就是在&cnt之前,从内存加载到寄存器中的值相等,此时就把old+1,也就是寄存器拿到的为1;之后再写会内存,此时acnt就变成1了)(对应acew函数返回true)。
- 而这里atomic的出现是保证多线程的时候仍是安全的,也就是保证原子性,假设多线程出现这个情况:线程1进行acnt load后拿到1(也就是此刻内存中的值),但是在进行atomic_compare_exchange_weak的时候,瞬间一个线程刚完成对应的内存值修改,acnt变成2了,然后这个函数就会发现old为1,acnt为2;此时把old变成acnt;old再++变成3,进而内存中的acnt变成3了(此时acew函数返回false)。
下面看下对应对比效果:
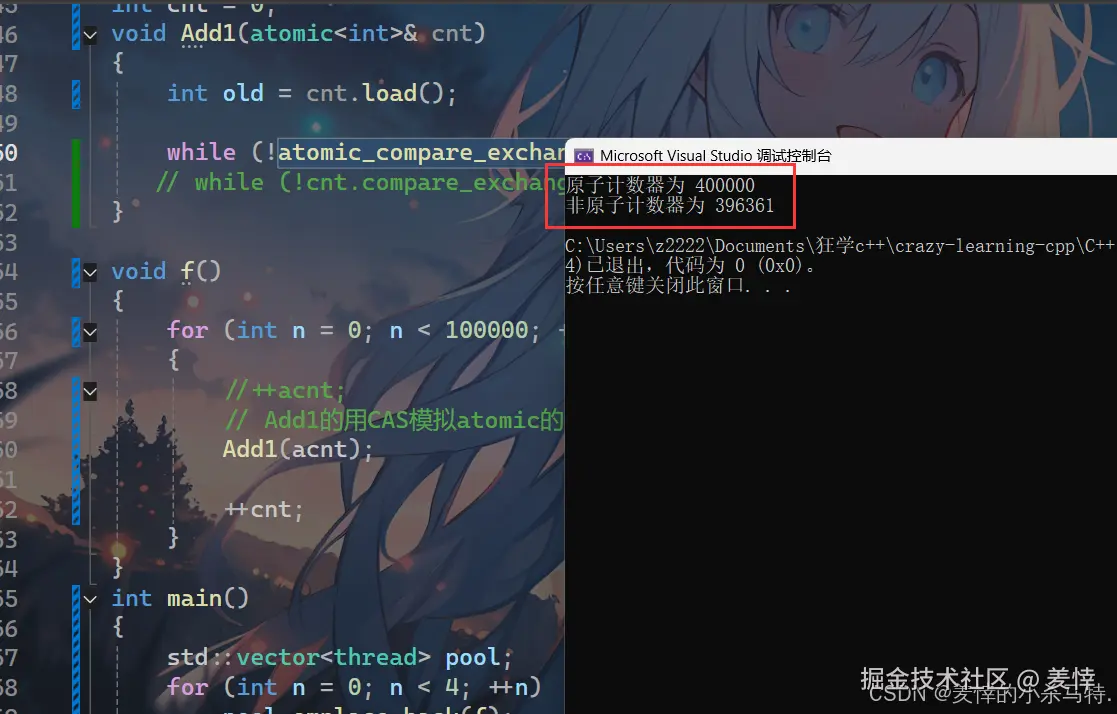
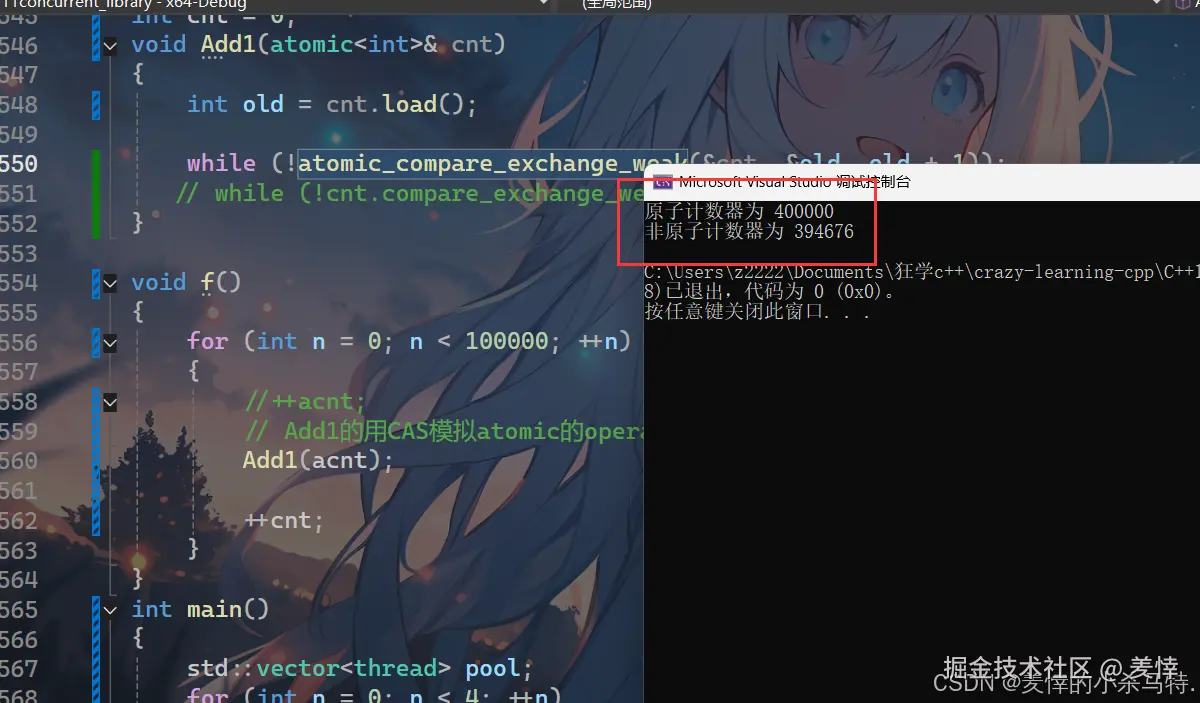
- 这里发现无论试多少次atomic操作的值(也就是原子性即线程安全的操作,无需加锁来付出代价)都是正确的,而cnt也就是线程不安全,连锁都没有故不确定性。
下面再举一个多线程进行链表头插的例子(这里通过atomic实现原子性而不是加锁):
对应代码:
cpp
#include <atomic>         // std::atomic
#include <thread>         // std::thread
#include <vector>         // std::vector
//
// a simple global linked list:
struct Node { int value; Node* next; };
std::atomic<Node*> list_head(nullptr);

void append(int val) {     // append an element to the list
	std::this_thread::sleep_for(std::chrono::seconds(1));//多线程卡在在休眠,创建的差距可以忽略不计也就是不能保证谁先链接

	Node* oldHead = list_head.load();
	Node* newNode = new Node{ val,oldHead };

	//oldHead = newNode;//如果这里直接头插这样,此时无锁多线程就是不安全的
	// what follows is equivalent to: list_head = newNode, but in a thread-safe way:
	while (!list_head.compare_exchange_weak(oldHead, newNode))
		newNode->next = oldHead;
}

int main()
{
	// spawn 10 threads to fill the linked list:
	std::vector<std::thread> threads;
	for (int i = 0; i < 10; ++i)
		threads.push_back(std::thread(append, i));

	for (auto& th : threads)
		th.join();

	// print contents:
	for (Node* it = list_head; it != nullptr; it = it->next)
		std::cout << ' ' << it->value;
	std::cout << '\n';

	// cleanup:
	Node* it; while (it = list_head) { list_head = it->next; delete it; }

	return 0;
}如果这里直接就是oldHead = newNode;此时进行头插,多线程的时候可能会出现(某线程被插入忽略的情况):
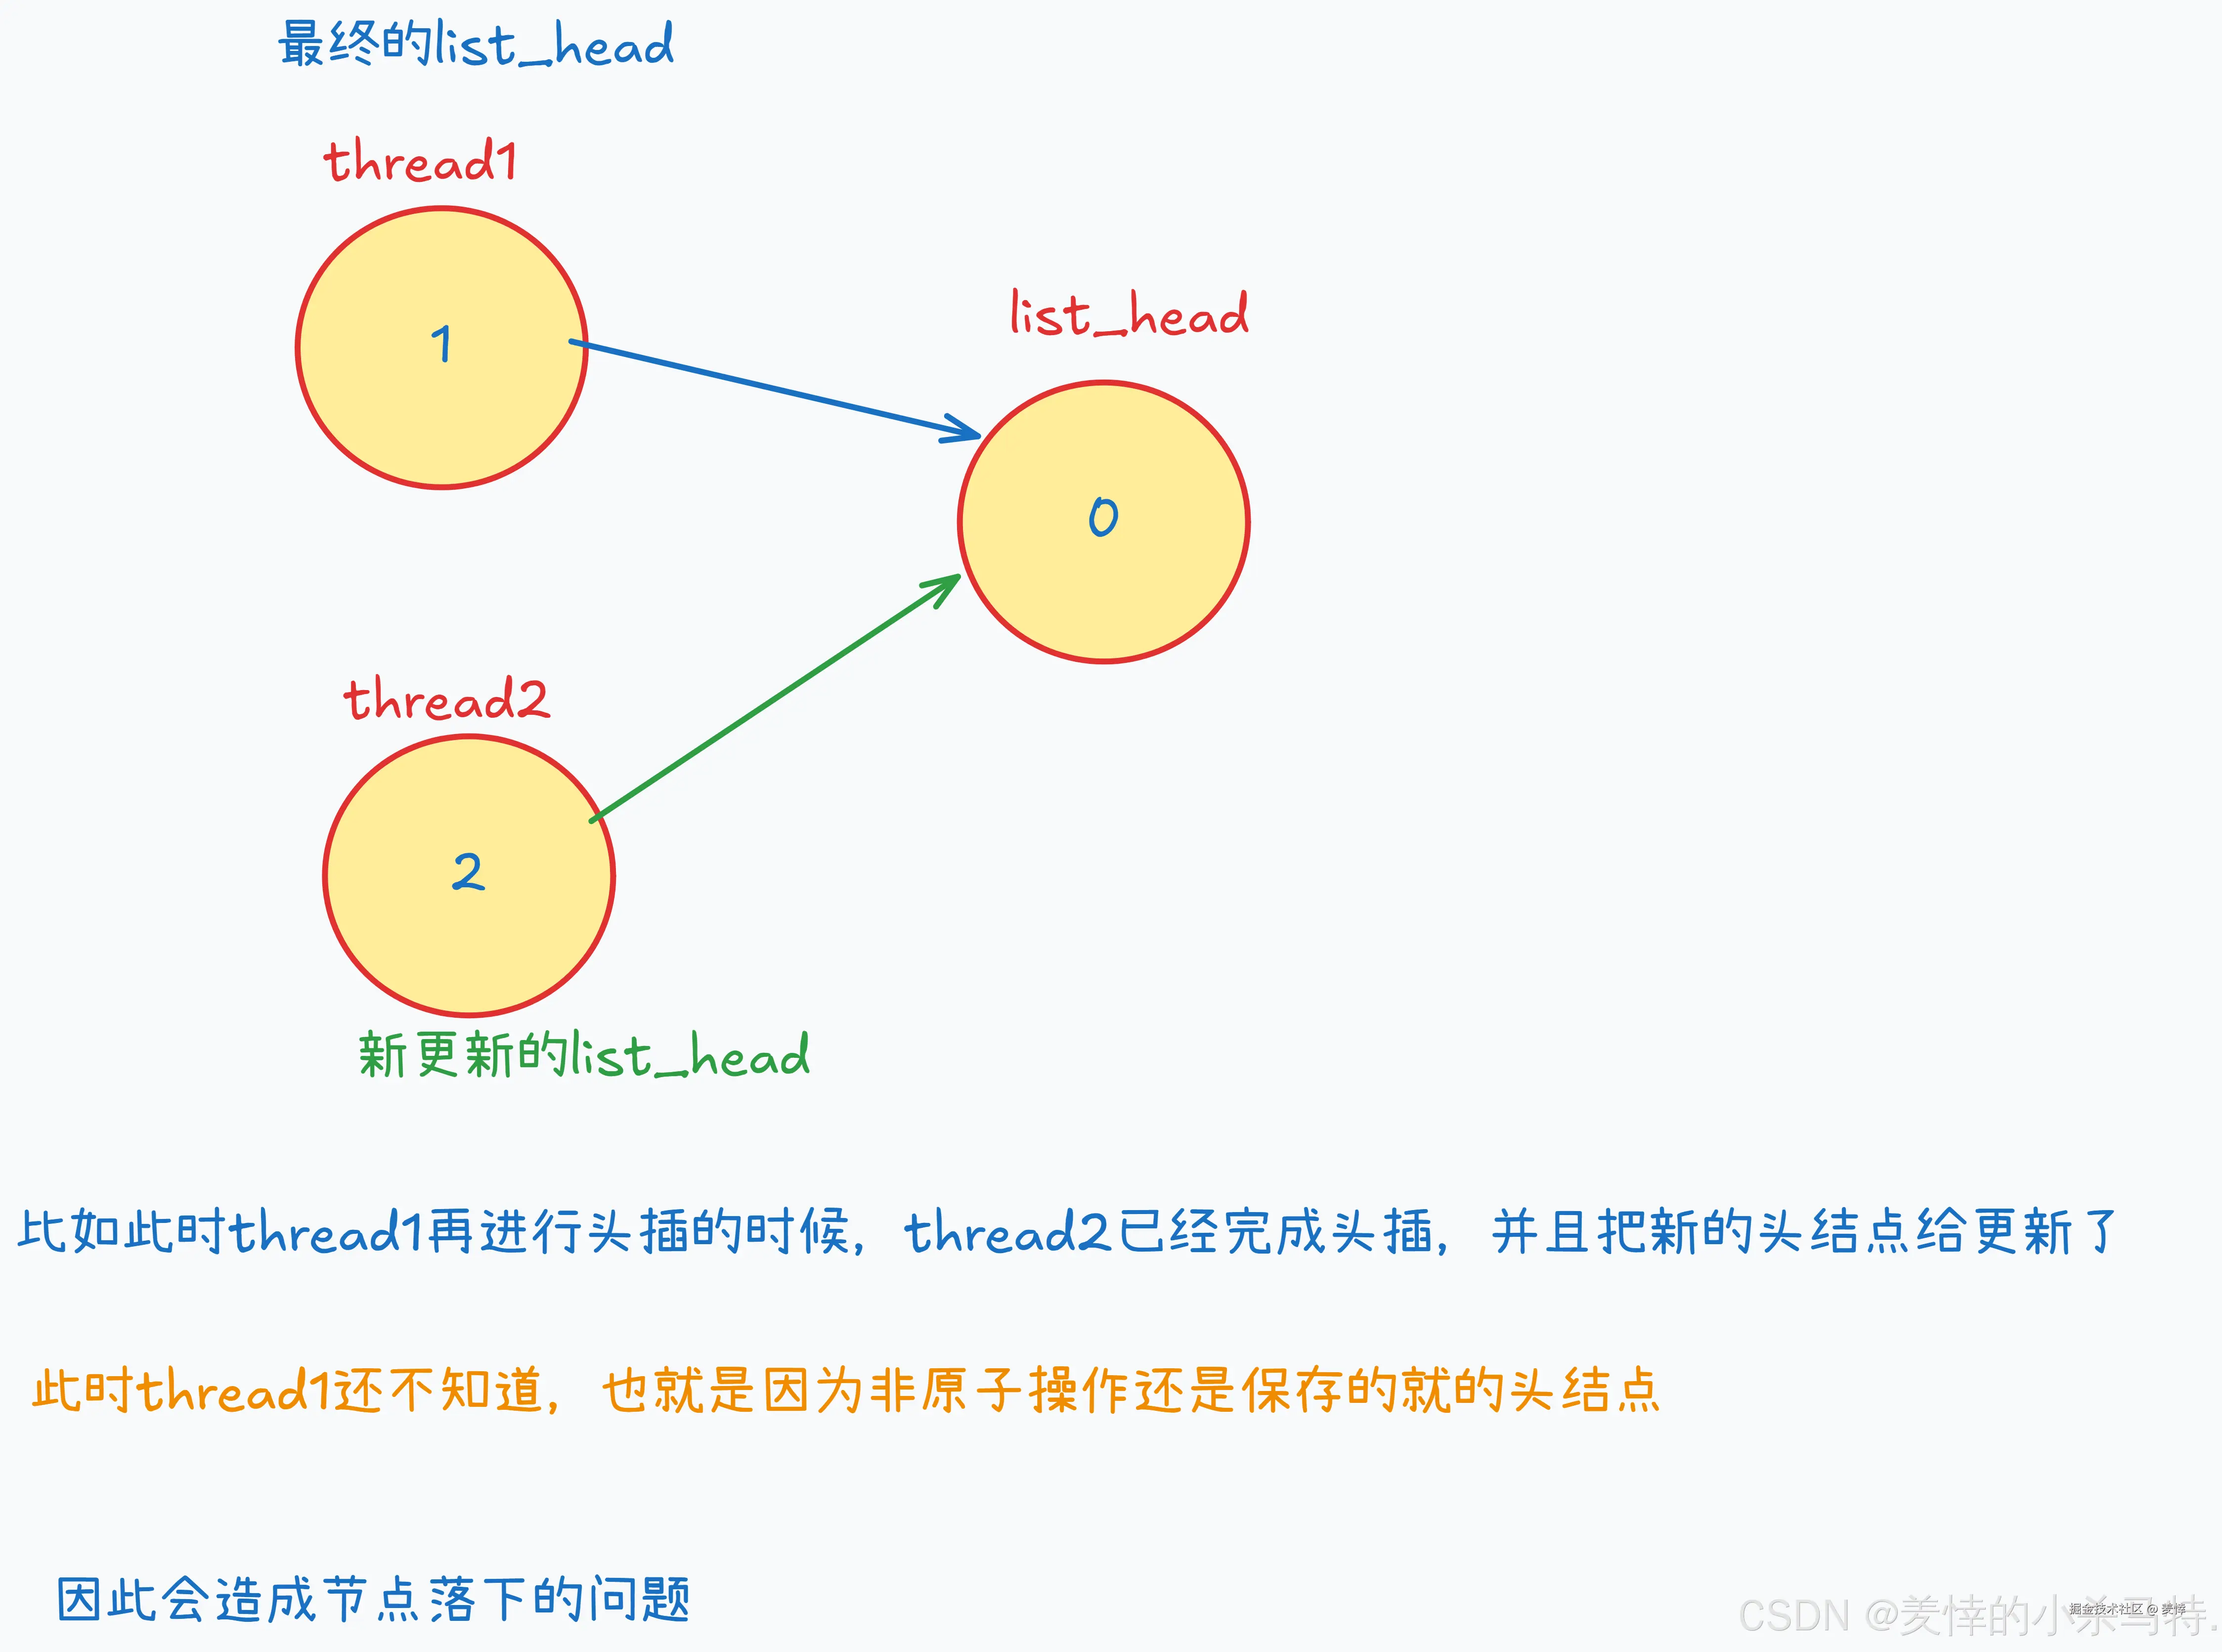
而下面使用atomic类内的操作进行CAS操作保证线程安全,有两种情况,一种就是线程没有干扰,一种就是存在干扰:
第一种:
正常插入也就是compare_exchange_weak返回true,就是某线程插入的时候原头结点没有被改变,因此成功进行头插。
第二种:
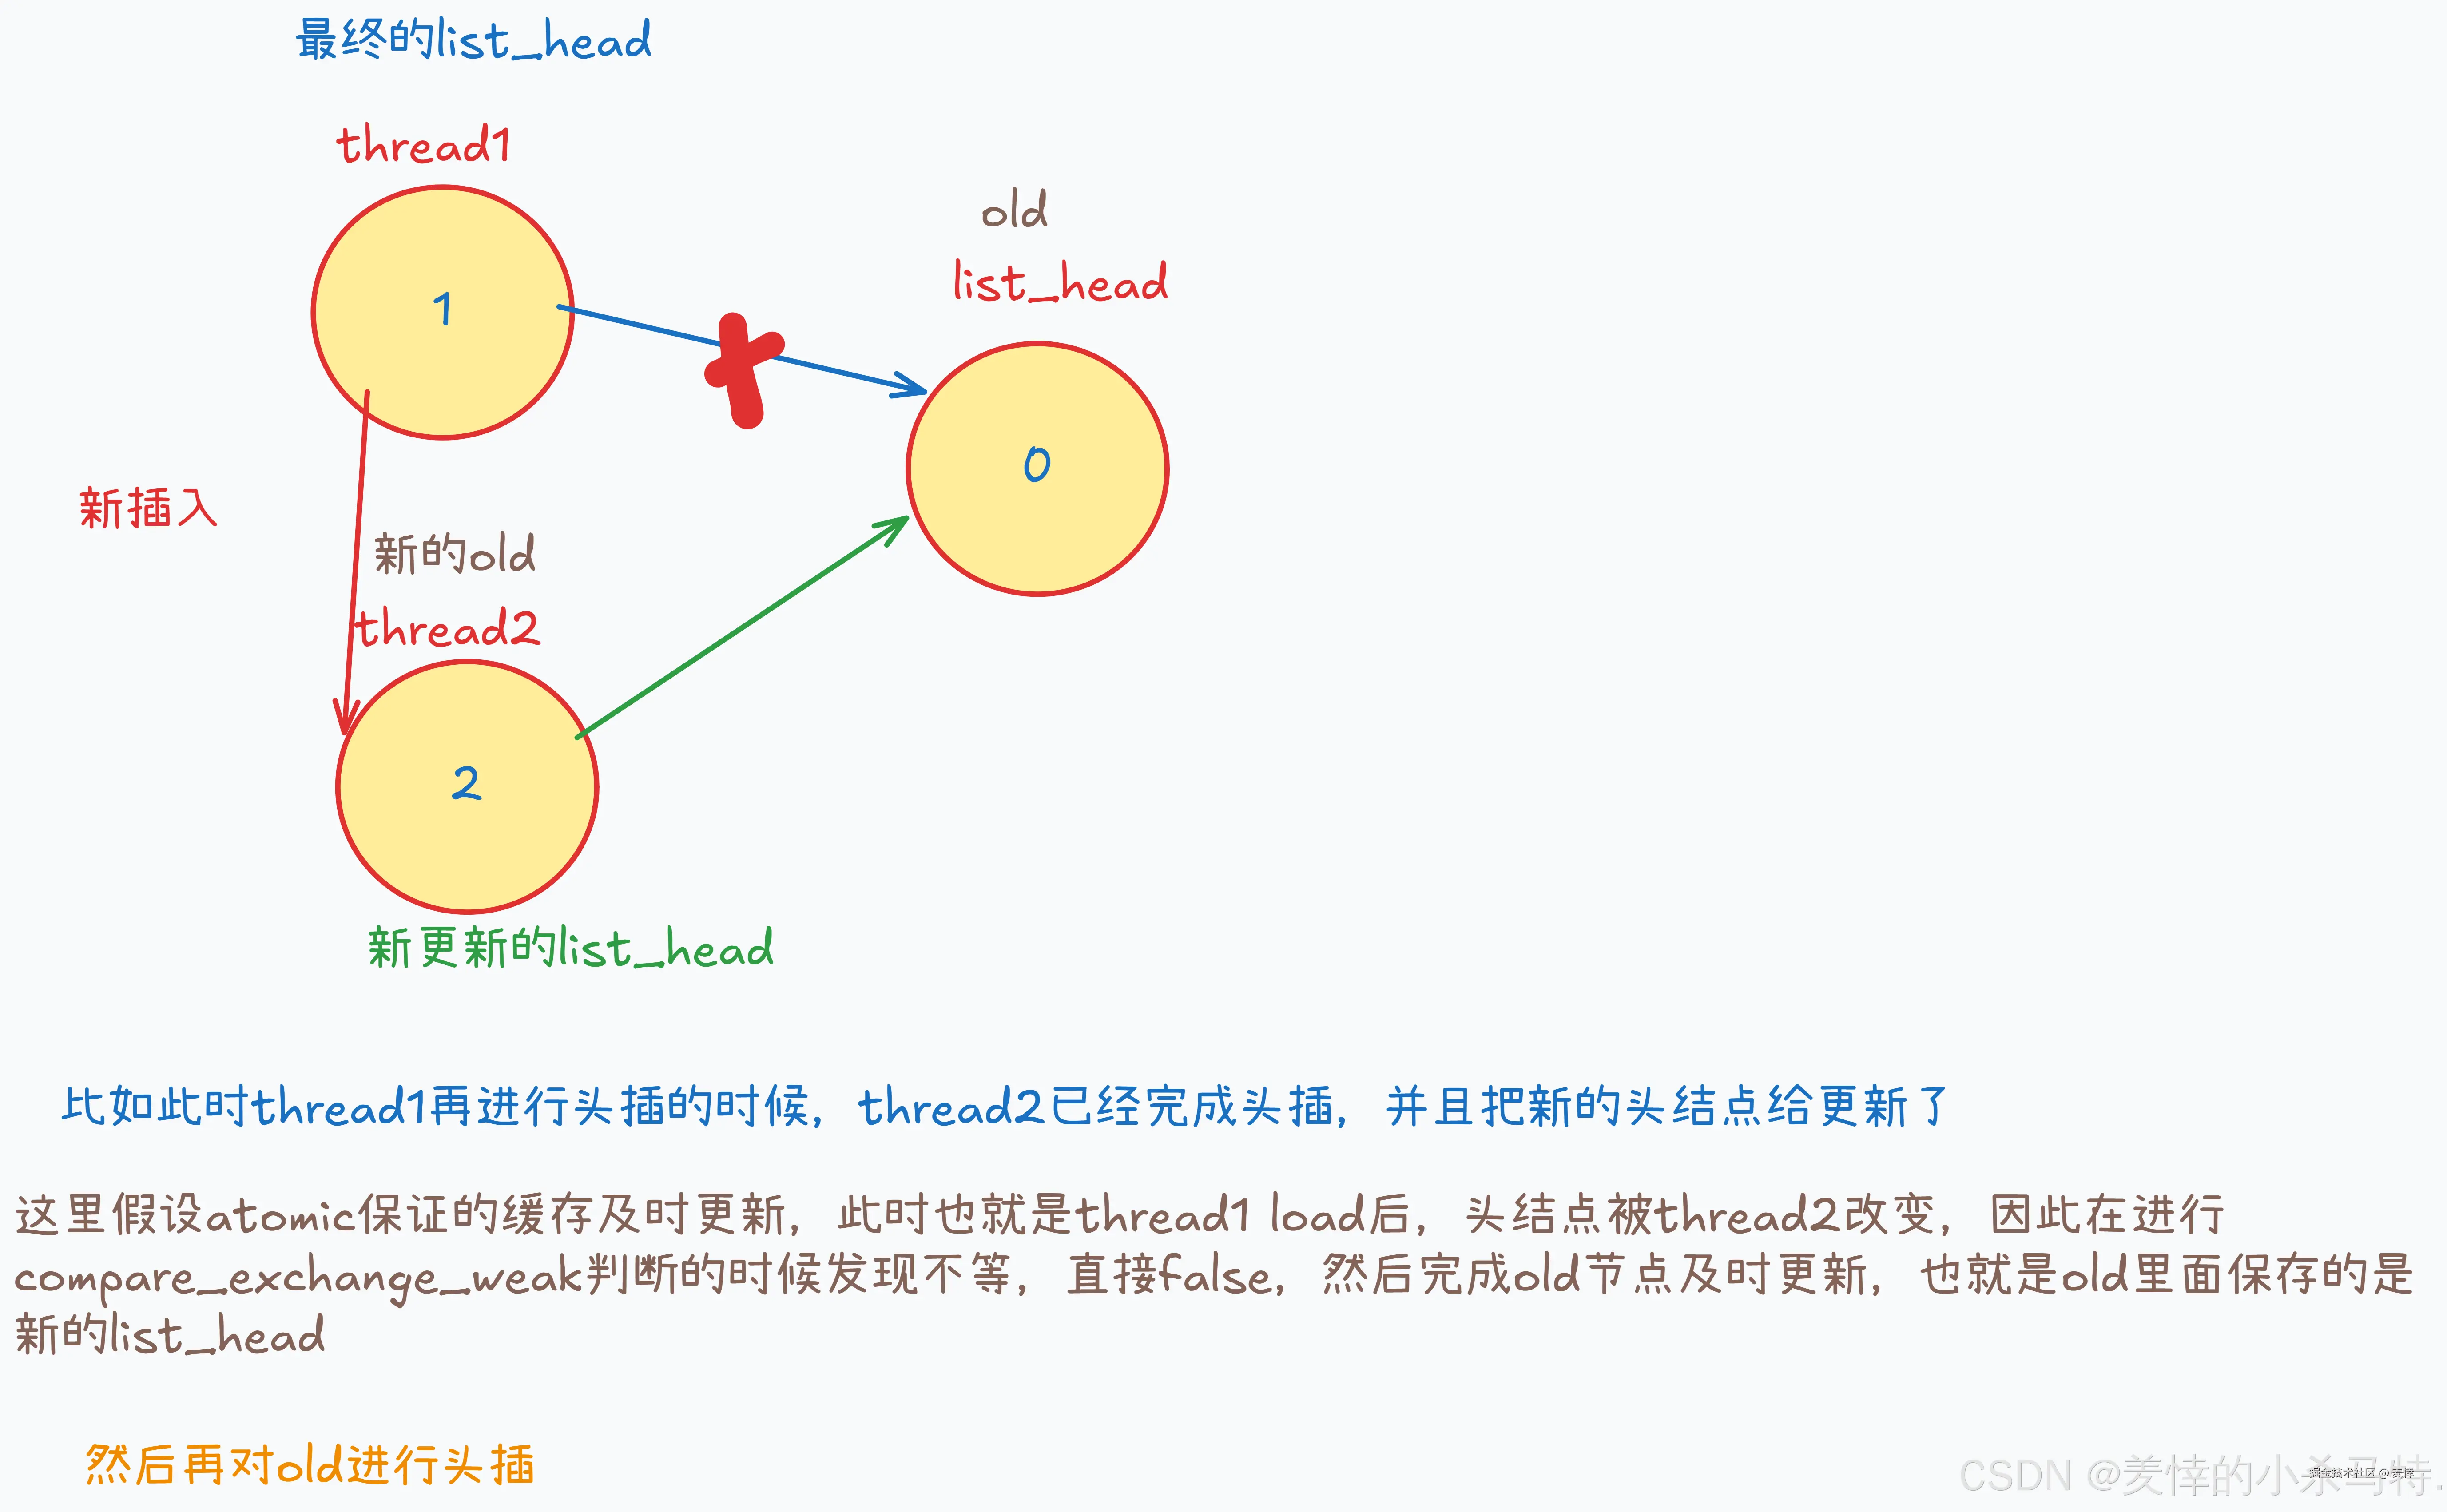
下面看下运行结果(这里为了更方便看出,不知道哪个线程先进行的插入,因此通过sleep_for保证尽量同步):
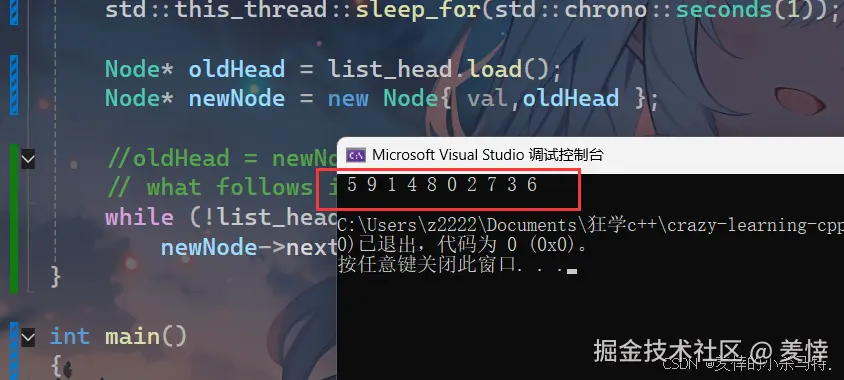
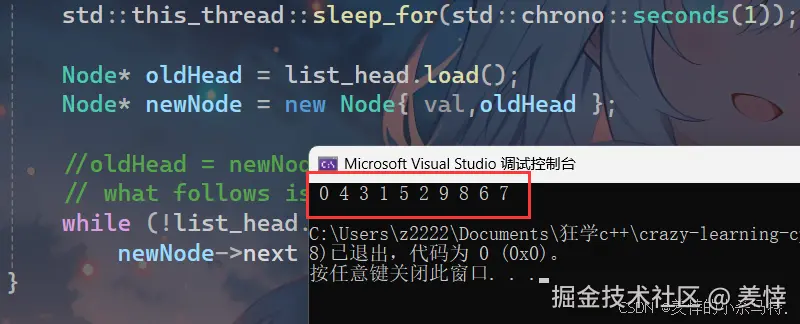
- 数字不少,故没有线程发生插入时候失败,而结果不一说明多线程操作线程有快有慢。
==因此总结下:==
-
对于简单的操作(也就是临界区小的比如++,比较等),此时可以使用atomic自带的重载(包含CAS检测)来完成多线程安全,就不要加锁了;但是比如atomic检测后发现不是原子性的(也就是比如string),此时atomic<某某>就没用,只能老是调用系统等提供的CAS判断操作手动完成线程安全;或者就老实加锁。
-
而上面关于链表指针的操作其实如果都换成atomic类型,此时无需CAS操作就是原子性的(atomic内部自己调用),但是atomic检测对应类型(那几个函数)不符合那么此时就不能这样。
-
因此符合atomic类型的可以直接用,如果不符合就需要手动CAS或者加锁。
atomic 里面的compare_exchange_weak / strong两者区别
这两个是 C++ 原子操作(
<atomic>头文件) 提供的"比较并交换"(Compare-And-Swap,CAS)接口,属于硬件级别的原子操作,主要用来做多线程下的"无锁同步":
compare_exchange_weak(expected, desired):
它会先比较原子变量的当前值是否等于 expected;如果相等,就把原子变量改成 desired,然后返回 true;否则就把 expected 改成原子变量的当前值,然后返回 false。所谓"weak(弱)",指的是它有可能在"值确实等于 expected"的情况下,仍然返回 false(也就是所谓的"虚假失败")。这种虚假失败往往是因为 CPU 缓存一致性、编译器优化等原因,导致硬件层面并没有真正去对比 / 交换,但还是返回了失败。
compare_exchange_strong(expected, desired):
行为和 weak 几乎一样,区别在于它会 保证"只要原子变量的值真的等于 expected,就一定返回 true"(不会虚假失败)。为了做到这一点,它在硬件上可能需要做更多工作(比如严格的内存屏障、等待缓存同步完成,比如采用缓存一致协议等),所以在一些平台上可能比 weak 稍慢一点。
下面举个例子帮助理解下:
-
线程1 和 线程2 同时读取 cnt,都得到 old = 0(初始值)。
-
线程1 先执行 CAS,成功把 cnt从 0改成 1。
-
线程2 执行 CAS 时,虽然 old = 0(它读取的值),但此时 cnt已经被线程1 改成 1,所以 CAS 失败(这是正常的竞争,不是虚假失败)。
-
但如果线程1 和 线程2 的 CAS 操作在 CPU 缓存同步时出现延迟,线程2 可能仍然认为 cnt = 0(
比如此时线程1改变cnt为1的值还没有写入内存或者还在准备些,而线程2就把原先的0读走了),但硬件 CAS 操作失败(虚假失败)(比如还可能有编译器优化导致读取cnt的时候读取的缓存还是0,这也是所谓的虚假失败)。 -
因此
strong对应的就是解决这种问题,因此判断比较准确些,但也消耗性能,因此compare_exchange_weak还是我们常用的。
memory_order系列选项介绍
在C++11标准库中,std::atomic 提供了多种内存顺序 (memory_order) 选项,用于控制原子操作的内存同步行为(比如只保证了原子性,但是同步没保证也会造成一些问题)。这些选项允许开发者在性能和正确性之间进行权衡,特别是在多线程编程中。std::atomic 支持六种内存顺序选项。
下面认识下:
load和store可以原⼦的读取和修改atomic封装存储的T对象;其实就是管理对应atomic里面封装的不同类型的变量。
下面举个例子:
cpp
std::atomic<bool> flag(false);
int data = 0;
// 线程 1
data = 42;
flag.store(true);
// 线程 2
while (!flag.load()) {}
std::cout << data; // 不一定 data = 42- 比如这里,虽然线程1改了对应data,可能还没同步给线程2,也就是线程2还没收到,此时修改了true,线程2退出循环,后发现data还是0,此时虽然保证原子性(但是因为atomic在c++11之后默认就是
memory_order_seq_cst;因此也能保证内存同步。)。
此时就需要添加选项来完成手动对于内存的同步。
六种内存顺序选项:
-
memory_order_relaxed(宽松顺序)只保证"原子性"(比如一个操作要么全做完、要么全不做),但不保证不同线程之间的操作顺序,也不保证一个线程对数据的修改能立刻被其他线程看到。 适合那些"只需要原子操作、不关心顺序"的场景(比如统计一个全局计数器)。
-
memory_order_consume(依赖顺序)主要用于"加载操作",保证"依赖这条数据的后续操作"能看到这条数据的最新值。不过实际开发中用的不多,
因为容易出错,也很少有场景必须用它。 -
memory_order_acquire(获取顺序)也是"加载操作"用的。它保证:在这条加载操作之前 发生的所有读/写操作,在其他线程里不能 被重排到这条加载操作之后 。 简单说就是:我读了某个值之后,之前所有对内存的操作结果,
其他线程都得"认可",不能乱序把它们放到我读的后面。 -
memory_order_release(释放顺序)用于"存储操作"。它保证:在这条存储操作之后 发生的所有读/写操作,在其他线程里不能 被重排到这条存储操作之前 。 对应上面
acquire的理解:如果一个线程做了release,另一个线程做了acquire并读到了这个值,那么release之后的所有写操作,在另一个线程看来都像是已经完成了(和memory_order_acquire进行连用)。 -
memory_order_acq_rel(获取-释放顺序)用于"读-修改-写"这类操作(比如
fetch_add)。它同时有acquire和release的语义:既保证"修改前"的操作不会被重排到修改之后,也保证"修改后"的操作不会被重排到修改之前。 相当于对"读-改-写"整个过程加了"获取"和"释放"的约束。 -
memory_order_seq_cst(顺序一致性顺序,c++11后默认的选项)最严格的一种,对所有操作都生效。它保证了"全局顺序一致性"------所有线程看到的操作执行顺序都是一样的,就像有一个"全局时钟"在调度所有线程的操作一样。 虽然性能相对差一点,但能最大程度保证多线程下的正确性,如果你不确定该选哪个,用这个往往不会错。
表格说明:
| 内存顺序 | 适用操作 | 语义描述 |
|---|---|---|
| memory_order_relaxed | 任意操作 | 仅保证原子性,无同步或顺序约束。 |
| memory_order_consume | 加载操作 | 保证依赖链的可见性,实际使用较少。 |
| memory_order_acquire | 加载操作 | 保证当前操作之前的读写不会被重排序到之后。 |
| memory_order_release | 存储操作 | 保证当前操作之后的读写不会被重排序到之前。 |
| memory_order_acq_rel | 读-修改-写操作 | 同时具有 acquire 和 release 语义。 |
| memory_order_seq_cst | 任意操作 | 全局顺序一致性,保证所有线程看到的操作顺序一致。 |
通俗解释:
| 内存顺序 | 谁能用? | 它干啥? | 生活例子 |
|---|---|---|---|
memory_order_relaxed |
所有操作 | "只保证这个操作是原子的,其他随便排!" | 寄一个不重要的小礼物,早到晚到无所谓 |
memory_order_consume |
加载(读) | "我读的数据,它的'依赖数据'也要可见" | 你收到"快递单号",就能查到包裹位置(依赖链) ⚠️ 实际很少用,很多编译器当 acquire 处理 |
memory_order_acquire |
加载(读) | "在我之后的操作,不能跑到我前面去!" | 你收到"付款成功"通知后,才能发货(不能先发货后付款) |
memory_order_release |
存储(写) | "在我之前的操作,不能跑到我后面去!" | 你必须先打包好商品,再点"已发货"(不能先点发货再打包) |
memory_order_acq_rel |
读-改-写(如 fetch_add) |
同时具备 acquire + release |
一手交钱一手交货:收钱(release)+ 给货(acquire) |
memory_order_seq_cst |
所有操作 | "所有线程看到的操作顺序都一样!" | 全国统一按下单时间发货,绝对公平(最慢但最安全) |
下面我们拿最常见的用法举个例子:
假设有一个原子变量 flag 和一个数据变量 data。线程A执行以下操作:
cpp
data = 42;                  // 普通写操作(非原子,但假设后续有同步)
atomic_flag.store(true, memory_order_release);  // 存储操作,使用 release 语义
线程B执行:
cpp
while (!atomic_flag.load(memory_order_acquire));  // 加载操作,使用 acquire 语义
int val = data; // 保证能看到线程A写入的 data = 42在这里,memory_order_release 保证了线程A在存储 flag 为 true 之前的写操作(比如 data = 42)不会被重排序到存储 flag 之后,从而线程B通过 memory_order_acquire 加载 flag 为 true 后,能够正确看到 data 的更新值。
atomic实现无锁化程序与mutex的有锁化对比
cpp
#include <atomic>         // std::atomic
#include <thread>         // std::thread
#include <vector>         // std::vector
#include<mutex>
template<typename T>
struct node
{
    T data;
    node* next;
    node(const T& data) : data(data), next(nullptr) {}
};

namespace lock_free
{
    template<typename T>
    class stack
    {
    public:
        std::atomic<node<T>*> head = nullptr;
    public:
        void push(const T& data)
        {
            node<T>* new_node = new node<T>(data);

            // 将 head 的当前值放到 new_node->next 中
            new_node->next = head.load(std::memory_order_relaxed);

             //如果线程1在进行检查的似乎也就是load后,线程2没有改变head的值,此时就返回true;
            //如果出现了线程2去修改此时除法CAS机制,把new_node->next保存head新值,然后再把new_node->next也就是head保存对应new_node值
            //正确完成链接
            while (!head.compare_exchange_weak(new_node->next, new_node,
                std::memory_order_release,
                std::memory_order_relaxed))
                ; // 循环体为空
        }
    };
}- 这里我们实现了一个头插模拟的栈,这里原理还是和之前的atomic的头插链表一样的,详细见注释。
下面是普通实现线程不安全,也就是不可重入的stack(后面加锁后进入):
cpp
namespace lock
{
    template<typename T>
    class stack
    {
    public:
        node<T>* head = nullptr;

        void push(const T& data)
        {
            node<T>* new_node = new node<T>(data);
            new_node->next = head;
            head = new_node;
        }
    };
}
然后进行多线程同时插入多个节点对比无锁(atomic实现)与有锁的对比:
cpp
int main()
{
    lock_free::stack<int> st1;
    lock::stack<int> st2;
    std::mutex mtx;
    int n = 1000000;

    auto lock_free_stack = [&st1, n] {
        for (size_t i = 0; i < n; i++)
        {
            st1.push(i);
        }
    };

    auto lock_stack = [&st2, &mtx, n] {
        for (size_t i = 0; i < n; i++)
        {
            std::lock_guard<std::mutex> lock(mtx);
            st2.push(i);
        }
    };

    // 6个线程分别使用无锁方式和有锁方式插入n个数据到栈中对比性能


    //无锁测试:
    size_t begin1 = clock();
    std::vector<std::thread> threads1;
    for (size_t i = 0; i < 6; i++)
    {
        threads1.emplace_back(lock_free_stack);
    }
    for (auto& th : threads1)
        th.join();
    size_t end1 = clock();

    std::cout << end1 - begin1 << std::endl;


    //有锁测试:
    size_t begin2 = clock();
    std::vector<std::thread> threads2;
    for (size_t i = 0; i < 6; i++)
    {
        threads2.emplace_back(lock_stack);
    }
    for (auto& th : threads2)
        th.join();
    size_t end2 = clock();

    std::cout << end2 - begin2 << std::endl;

    return 0;
}- 6个线程,每个都跑1000000次。
下面看下测试结果:
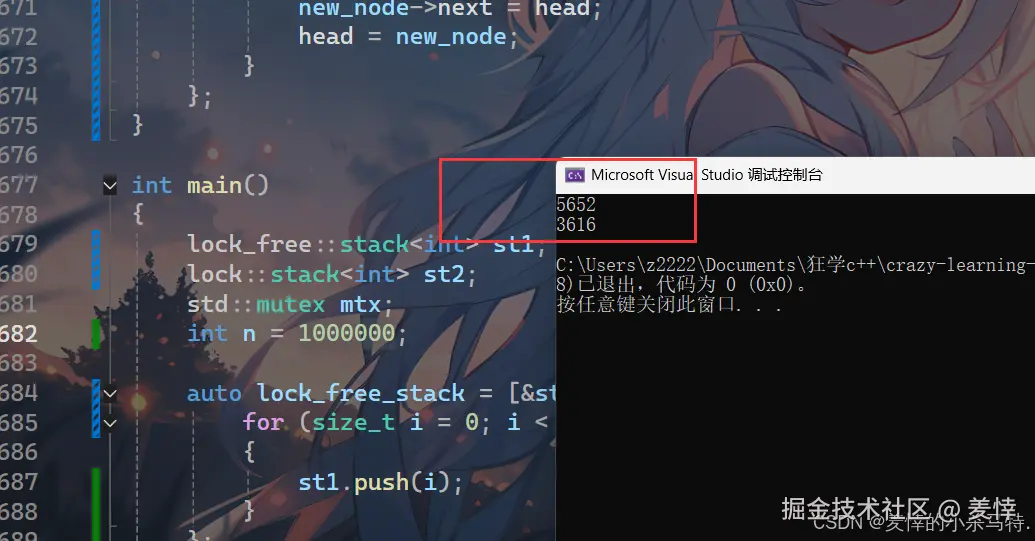
- 解释下,这里发现对应的无锁甚至比有锁还慢,主要是无锁存在
内存屏障、线程调度、缓存一致性,但是mutex自身存在优化行为。 - 也就是CAS的操作多线程的时候,成功就退出循环,不成功就进行循环,这样不断完成(比的是线程的操作的速度);而mutex的是如果抢不到就去保存上下文等信息去阻塞;也就是上下文少以及线程少影响CAS操作(故看到此时CAS效率不高)。
- 低并发、简单操作、开发效率优先 用 mutex(有锁);高并发、极轻量临界区、追求极限性能 优化后的无锁(如 CAS)可能更快,但难度大、易出错,需谨慎使用。
基于atomic的atomic_flag类型实现自旋锁
简单介绍下自旋锁
自旋锁(SpinLock)是一种锁机制,适用于锁持有时间非常短的场景。在多线程编程中,当一个线程尝试获取已被其他线程持有的锁时,自旋锁会让该线程在循环中不断检查锁是否可用,而不是进入睡眠状态。这种方式可以减少上下文切换的开销,但在锁竞争激烈或锁持有时间较长的情况下,会导致CPU资源的浪费。
对于自旋锁C++11没有实现,但是基于atomic实现个简单的自旋锁也是可以的。
代码实现如下:
cpp
#include <atomic>         // std::atomic
#include <thread>         // std::thread
#include <vector>         // std::vector
#include<mutex>
class SpinLock
{
private:
    // ATOMIC_FLAG_INIT默认初始化为false
    std::atomic_flag flag = ATOMIC_FLAG_INIT;
public:
    void lock()
    {
        // test_and_set将内部值设置为true,并且返回之前的值
        // 第一个进来的线程将值原子的设置为true,返回false
        // 后面进来的线程将原子的值设置为true,返回true,所以卡在这里空转,
        // 直到第一个进去的线程unlock,clear,将值设置为false
        while (flag.test_and_set(std::memory_order_acquire));
    }

    void unlock()
    {
        // clear将值原子的设置为false
        flag.clear(std::memory_order_release);
    }
};

// 测试自旋锁
void worker(SpinLock& lock, int& sharedValue) {
    lock.lock();
    // 模拟一些工作
    for (int i = 0; i < 1000000; ++i) {
        ++sharedValue;
    }
    lock.unlock();
}

int main() {
    SpinLock lock;
    int sharedValue = 0;
    std::vector<std::thread> threads;

    // 创建多个线程
    for (int i = 0; i < 4; ++i) {
        threads.emplace_back(worker, std::ref(lock), std::ref(sharedValue));
    }

    // 等待所有线程完成
    for (auto& thread : threads) {
        thread.join();
    }

    std::cout << "Final shared value: " << sharedValue << std::endl;
    return 0;
}- 这里其实就是如果flag_test_set的时候,flag是false,就改成true然后返回false,相当于当前线程拿到锁,之后另一个线程在来的时候就发现是true改成true,然后返回true,进入这个循环等待,等到第一个线程置成false,完成获取锁。
下面看下效果:
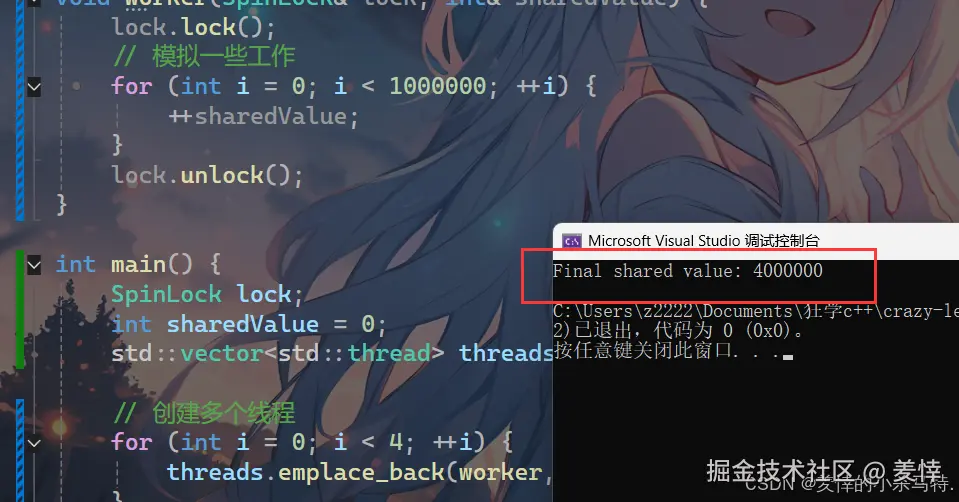
- 发现多少次都是4000000次;证明多线程的时候没有出现问题(这种上下文比较简单,竞争不激烈就可以用
spinlock)。
对于自旋锁特征可以概括成:
循环去等待,不舍弃cpu进行休眠来代替mutext的上下文切换+阻塞,经常用于短临界区+多核cpu使用,等待极短的时候使用(也就是上下文短),对此性能也是很高的,更加轻量。
二.本篇小结
atomic 通过硬件级原子指令保障线程安全,适用于轻量临界区;CAS与内存序灵活控制同步;无锁编程性能潜力大但需谨慎;自旋锁轻量却易耗CPU,短临界区适用。合理选择同步策略是多线程优化的关键。