前端转行 agent,记录一下自己开发的一个新闻转播客的项目。
项目起点是 GitHub 上一个 awesome 项目里的「文本转播客」小 demo,我觉得很适合作为个人学习项目,就在它的基础上做扩展。
技术栈选了 FastAPI + Next.js,买了两台服务器:一台部署项目,一台部署 Langfuse(LLM 链路观测)。
整体链路
我的想法很简单:从新闻源拉取 → 入库 + 向量化 → 检索召回 → 合成口播脚本 → TTS 合成播客。
展开一点:
RSS 源 / 新浪滚动 API
  → 抓取正文(质量门禁 + SimHash 去重)
  → LLM 打标(摘要 + 分类)
  → 向量化入库(Milvus)
  → 话题检索(hybrid 召回 + 精排)
  → 事实卡抽取(素材 → 原子事实 + 原文锚定)
  → 写手生成口播稿
  → 评审循环(不达标打回改写)
  → TTS 合成 + 音频拼接
部署结构(docker compose)
主应用和异步层都在同一台服务器上,用 docker compose 编排,一共 9 个容器:
| 服务 | 作用 | 说明 |
|---|---|---|
| nginx | 反向代理 | 统一入口:/api /media /feed 转发到后端 |
| web | FastAPI 主应用 | HTTP API + SSE 流式对话 |
| frontend | Next.js 前端 | 用户界面 |
| celery-crawl | 抓取 worker | IO 密集型任务 |
| celery-llm | LLM worker | LLM 调用类任务 |
| celery-media | 媒体 worker | TTS 合成 + 编排任务 |
| celery-beat | 定时调度 | 每天凌晨 2 点触发新闻拉取流水线 |
| postgres | 数据库 | 文章 / 播客 / 用户 |
| redis | 缓存 + broker | 缓存 + Celery 消息队列 |
外部依赖(不在 compose 里,直接用云服务):
- Milvus:向量库,用火山引擎 serverless 版本
- Langfuse:LLM 链路观测,单独一台服务器
用到的模型
| 环节 | 模型 | 选择理由 |
|---|---|---|
| 写手(生成口播稿) | 智谱 glm-4.5-air | 长文生成纪律好,不越界编造 |
| 事实卡抽取 | 智谱 glm-4.5-air | 与写手同模型,任务同源 |
| 评审(多维打分) | DeepSeek deepseek-v4.1-flash | 跨厂商评审,避免同源偏袒 |
| 打标(摘要 + 分类) | 智谱 glm-4.5-air | 付费档稳定,批量调用不限流 |
| 语义质检(正文判定) | 智谱 glm-4-flash(免费档) | 简单二分类,免费档够用 |
| 类目分类 | 智谱 glm-4-flash | 18 选 1,无需强模型 |
| Query 改写 / HyDE | 智谱 glm-4-flash | 短文本改写 |
| 向量化 | 阿里 DashScope text-embedding-v4 | 1024 维,中文效果好 |
| 精排 | 阿里 DashScope gte-rerank-v2 | cross-encoder 精排 |
| 语音合成 | MiniMax TTS | 音色自然,支持多音色 |
数据采集管线
这部分是整个项目改动最多的地方------因为检索质量的上限,取决于语料的质量和结构。
一篇新闻的生命周期
arduino
RSS 源 / 新浪滚动 API
  → ① 正文抓取(三级降级抽取:正文节点 → p 标签 → 全文兜底)
  → ② 去重(URL 精确匹配 + SimHash 内容指纹,近 7 天窗口内比对)
  → ③ 规则质检(四条硬规则,不合格直接隔离)
  → ④ 语义检测(小模型判断"是否完整可读的新闻正文")
  → ⑤ 打标(LLM 生成摘要 + 分类)
  → ⑥ 入库 PostgreSQL + 向量化 Milvus
规则质检的四条硬规则
抓下来的正文不一定是正文------可能是导航页、英文页、JS 渲染的空壳。所以设了四条确定性规则(微秒级,零成本):
| 规则 | 阈值 | 拦什么 |
|---|---|---|
| 导航行占比 | > 30% | 列表页 / 首页被误抓 |
| 中文占比 | < 60% | 英文页 / 混杂大量代码 |
| 标题词命中率 | < 50% | 抽取错位(正文和标题对不上) |
| 有效段落 | 为空且 < 200 字 | 只有零散碎句的壳 |
另有长度软指标:低于 200 字标记为 suspect,交给下一层语义检测复核。
规则层拦不掉的,也交给语义检测------这是规则管结构、模型管语义的分工。
打标体系的四版演进
v1:让 LLM 自由打标签
最初直接让模型根据预设标签打标。问题很快暴露:预设标签太少,覆盖不了全量新闻,导致后续召回质量差------很多文章因为"没有合适的标签"而检索不到。
v2:自增标签表
改成让模型自己维护标签:Redis + SQL 存一套自增标签数组,模型遇到新新闻时先查表,有能表达的标签就直接用,没有就新建并写回表。
解决了覆盖率问题,但引出新问题:语义相近的词在召回时是割裂的。搜"天气"和搜"气象"可能检索出完全不同的两批结果------因为它们被存成了两个不同的标签。
v3:标签向量化 + Query 重写
在打标任务跑完后,对整个标签表做一次向量化。检索前先做一轮 query 重写、提取关键词,然后找出与关键词余弦相似度 > 0.5 的标签,一次性加入检索。
效果立竿见影:搜"天气"能自动带出"气象"、"台风"等相关词。
但接着撞上了数据治理问题 ------新闻变多,标签就膨胀。实测到 300 篇新闻时,标签已经涨到 160 个。标签在自增长,没人能控制它的边界,最终会变成一坨谁也不敢删的脏数据。
v4(当前):放弃 LLM 打标签,改封闭类目 + 稀疏向量
想明白了一件事:标签这条路的问题不是技术,是"开放词表"这个设计本身------只要允许模型造词,就一定收敛不了。
于是彻底换方案:
- 固定类目表:自己定 18 个类目
- LLM 只从表里选,没有造词权
- 检索侧改用 Milvus 稀疏向量 :给 collection 加一个
sparse字段,和 dense 向量做 RRF 融合
第三点是关键。dense 管语义、sparse 管字面------"天气"和"气象"由 dense 负责关联,"天气"这个词本身由 BM25 负责精确命中,两路融合后干扰越密优势越大(实测 hit@10 从 dense 单路的 0.856 提升到 0.878,而且退化斜率最平缓)。
检索管线
检索也经过了多轮改版。
第一版:用户提示词进来 → 做一轮 query 重写成适合检索的内容 → 直接丢给 Milvus 召回。很快暴露两个问题。
问题一:泛性话题处理薄弱
实测数据:
| 话题类型 | 召回得分 |
|---|---|
| 泛性话题 | 普遍 0.2 以下,偶尔能到 0.4,但非常不稳定 |
| 具体话题(相关) | 0.4 ~ 0.7 |
| 具体话题(不相关) | 0.14 ~ 0.18 |
原因是泛性话题在 Milvus 里不存在具体的"锚" ------"最近有什么大事"这种问法,跟任何一篇文章都不够近。而具体话题根据测试出的断崖阈值取了 0.25 这个相对保守的值。
问题二:乱码输入
原本用户输入乱码时,LLM 不会报错,而是脑补出一个合理话题 ------实测 !@#$%^&*() 被改写成「科技动态 新技术 发展趋势」,??? 变成「科技发展趋势 未来创新 科技前沿」。然后照常走完整个管线,给用户生成一期完全跑题的播客。
这比报错更糟------静默失败。
当前做法
① 改写 + 自检循环(最多 3 次)
markdown
用户输入 → query 重写 → 自检:改写是否匹配用户原意?
    ├─ 不通过 → 带反馈重新改写(最多 3 次)
    └─ 3 次仍不通过 → 前端提示用户重新描述
自检由做改写的那次 LLM 调用顺带完成(输出 valid + reason)------不通过时把原因作为反馈喂回去重试,实测能显著提高第二次的通过率。乱码输入稳定在 3 次后被拒绝。
② 意图识别分两条管道
具体话题走精确检索,泛性话题走类目事件分组(下一节展开)。
③ 召回数为 0 直接拒绝
不再创建"注定失败、只能在详情页看到没有素材"的播客------创建前就预检,0 命中或素材与话题无关都直接提示用户换话题。
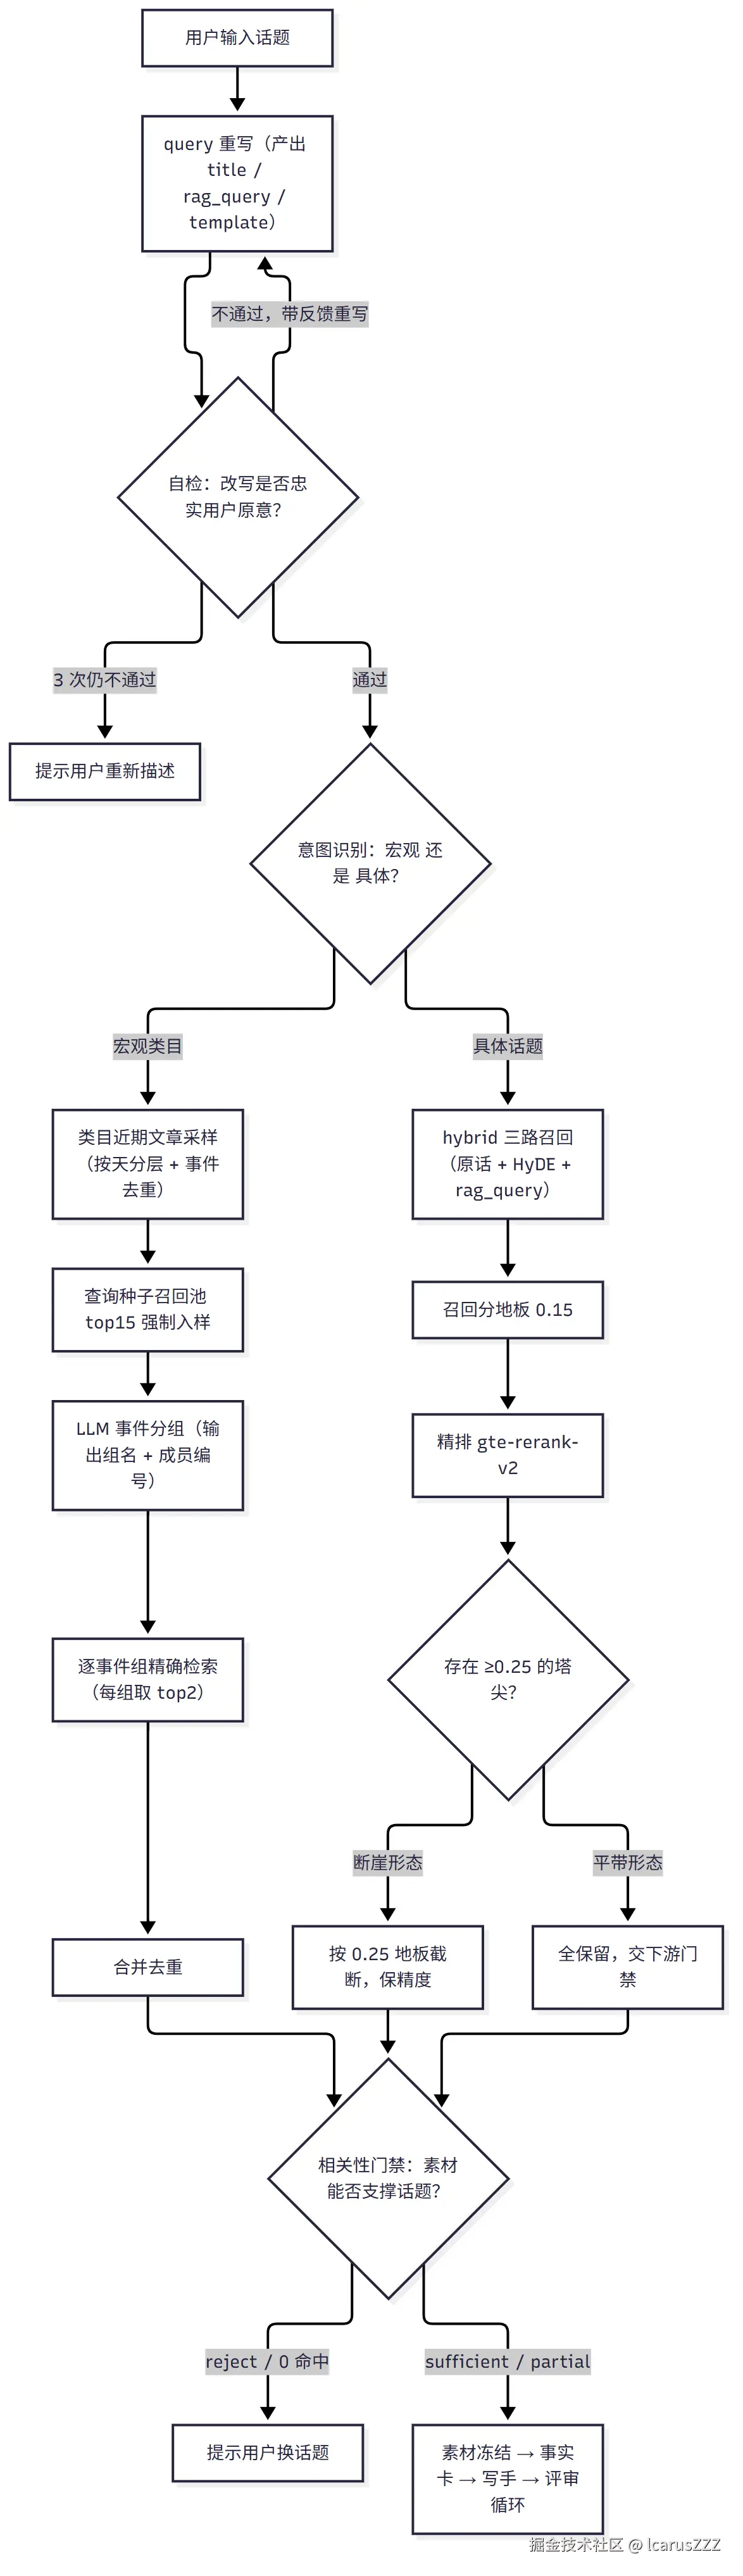
播客生成管线
主播音色是用 MiniMax 复刻的(我在后台建了多个主播)。最初的版本很简单:写手 agent 根据用户提示词 + 召回素材生成口播脚本(支持单人和双人两种模式),脚本合成后调 MiniMax 生成音频。
优化的重点全部落在口播脚本生成侧------因为播客的可用性完全取决于脚本的可靠性。
第一版:LLM-as-judge 评审管线
自建了一条评审管线:
- 出题:评审员从新闻 SQL 数据里随机采样标题,出成播客话题(避免固定测试集失效)
- 写稿:写手 agent 按话题 + 素材生成脚本
- 打分 :评审员按 五个维度 评分------忠实度 / 素材利用率 / 相关性 / 可读性 / 完整性
- 重点:忠实度(faithfulness)------新闻产品的底线
忠实度的评分标准:
| 分 | 标准 |
|---|---|
| 5 | 全部事实性陈述可溯源 |
| 4 | 个别修饰性说法无源,但不影响主体 |
| 3 | 有 1~2 处无源,或与素材相悖 |
| 2 | 多处无源 |
| 1 | 大面积编造 |
初版实测:忠实度普遍在 1.7 ~ 2.5。
根因很清楚:模型在写脚本时混入了大量训练数据------那些数字是真的,但素材里没有。对新闻播客来说,这就是编造。
第二版:把评审接进生成流程(Self-Refine)
第一次改版:让评审成为生成流程的一环,所有维度 ≥4 才算通过:
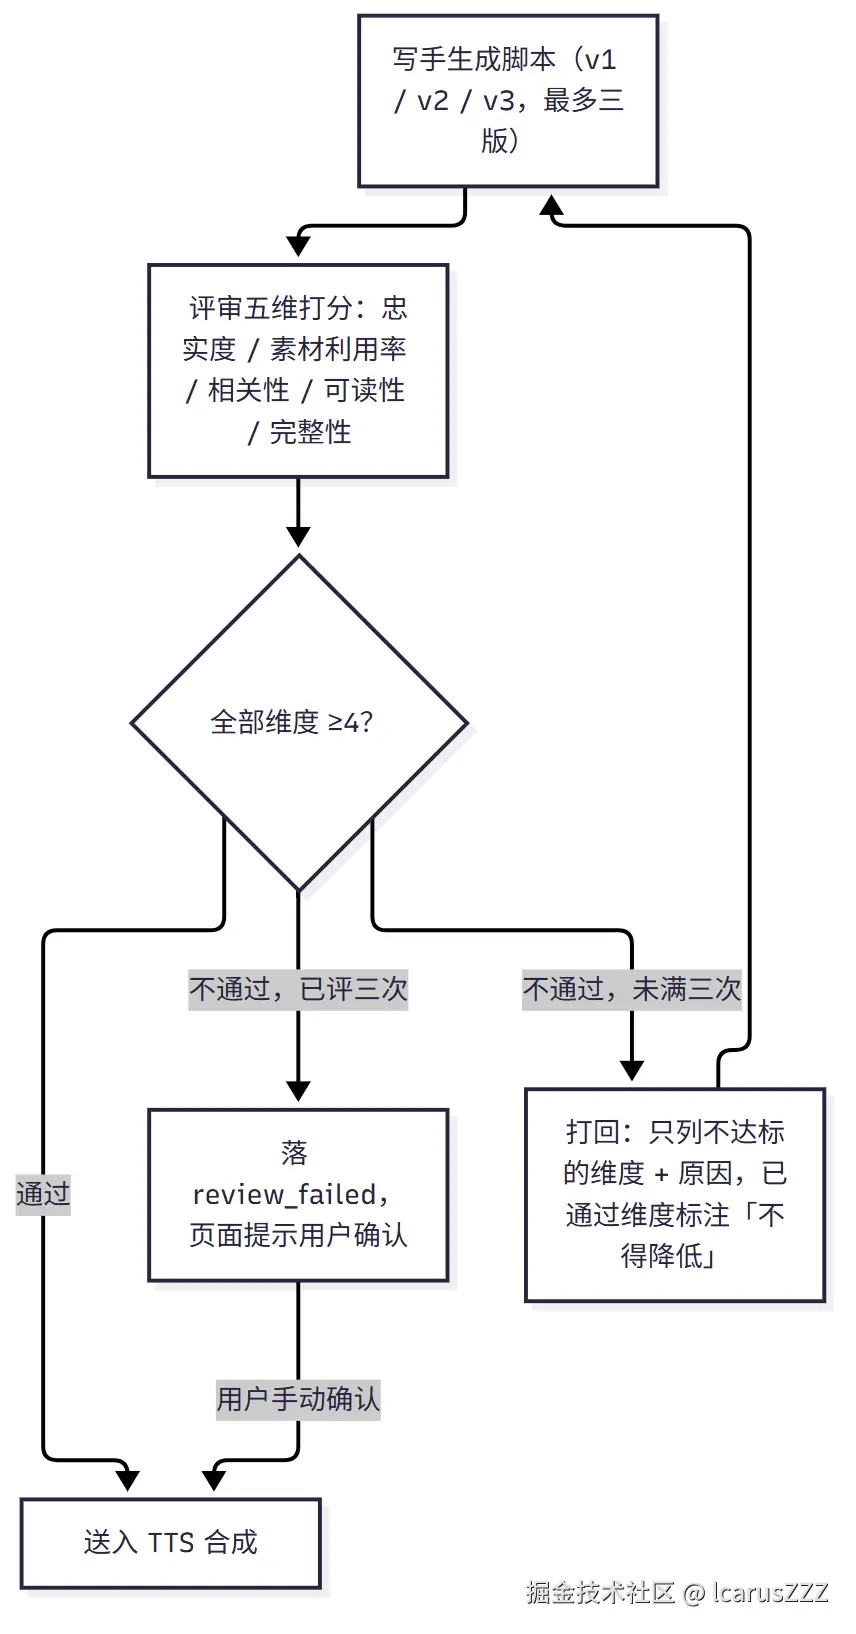
两个细节是踩坑加的:
- 打回时只列不达标的维度,并明确告诉写手"已通过的维度不得降低"------否则会出现"按下葫芦浮起瓢"(改好了忠实度,可读性掉下去)
- 改写后做回归复评:任一原本合格的维度退化 → 回退到改写前版本
- 三次评审仍不通过 → 不再重写 ,落
review_failed状态,页面上让用户手动确认是否继续合成
效果:忠实度从 1.7~2.5 提升到 2.5 ~ 4,平均在2.5-3.0
但问题也明显:得分非常不稳定。即使反复调提示词,写手也很难控制自己"不带训练数据"------因为素材本身是几千字的新闻正文,写手要从中提炼、组织、写成口播稿,自由度太大,编造的空间就大。
第三版:事实卡(关键改版)
调研了两天,在一篇文献上找到了原子事实分解(FActScore)的思路,改造成"事实卡":
核心设计:把写手的输入从"素材原文"换成"事实白名单"。
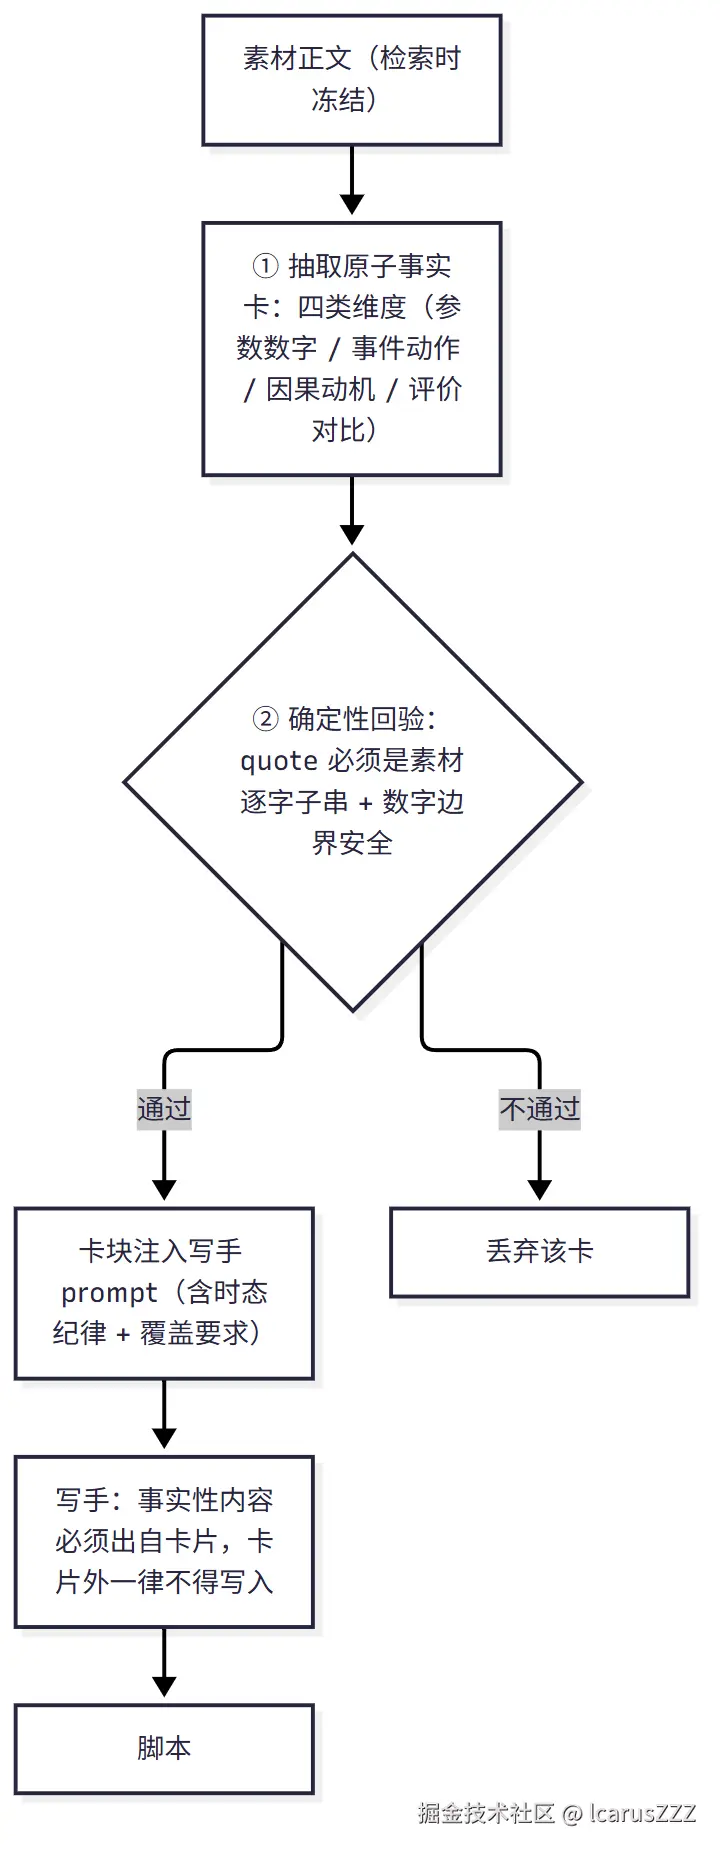
每张卡包含三部分:来源素材编号(src)+ 原子事实(fact)+ 原文引句(quote,≥12 字)。
quote 是整个设计的锚------每张卡必须能指回素材原文的连续片段,锚不上就整卡丢弃。这样"卡片上的每个字都能在素材里找到依据"就是可验证的,而不是靠模型自觉。
三轮加固:
| 轮次 | 踩的坑 | 修法 |
|---|---|---|
| ① | 卡丢了时态:卡上"到 2030 年达 4 平方米"(目标)被写成"截至今天已达"(现状),faith 掉到 1 | 抽取 prompt 强制保留时间/语气限定词 + 卡块加【时态纪律】 |
| ② | 回验器有洞 :数字用子串匹配时 "450" 命中 "1450万";窄域语料里高频词让编造卡也能凑够重合度 | 改 quote 逐字锚定(零误报)+ 数字边界安全匹配 (?<!\d)450(?!\d) |
| ③ | 抽卡维度太窄:只抽参数/事件,不抽因果/评价 → 写手把留白处自己补 | 扩成四类维度 + 标题级关键数字强制入卡 |
效果:跑了300轮测评,忠实度稳定在 3.9 ~ 4.1 (配合把写手模型从 qwen-plus 换成 glm-4.5-air------qwen 即使对着事实卡也照样垫训练数据话术,说明写手纪律比证据形态更关键)。
加入事实卡后的完整生成管线
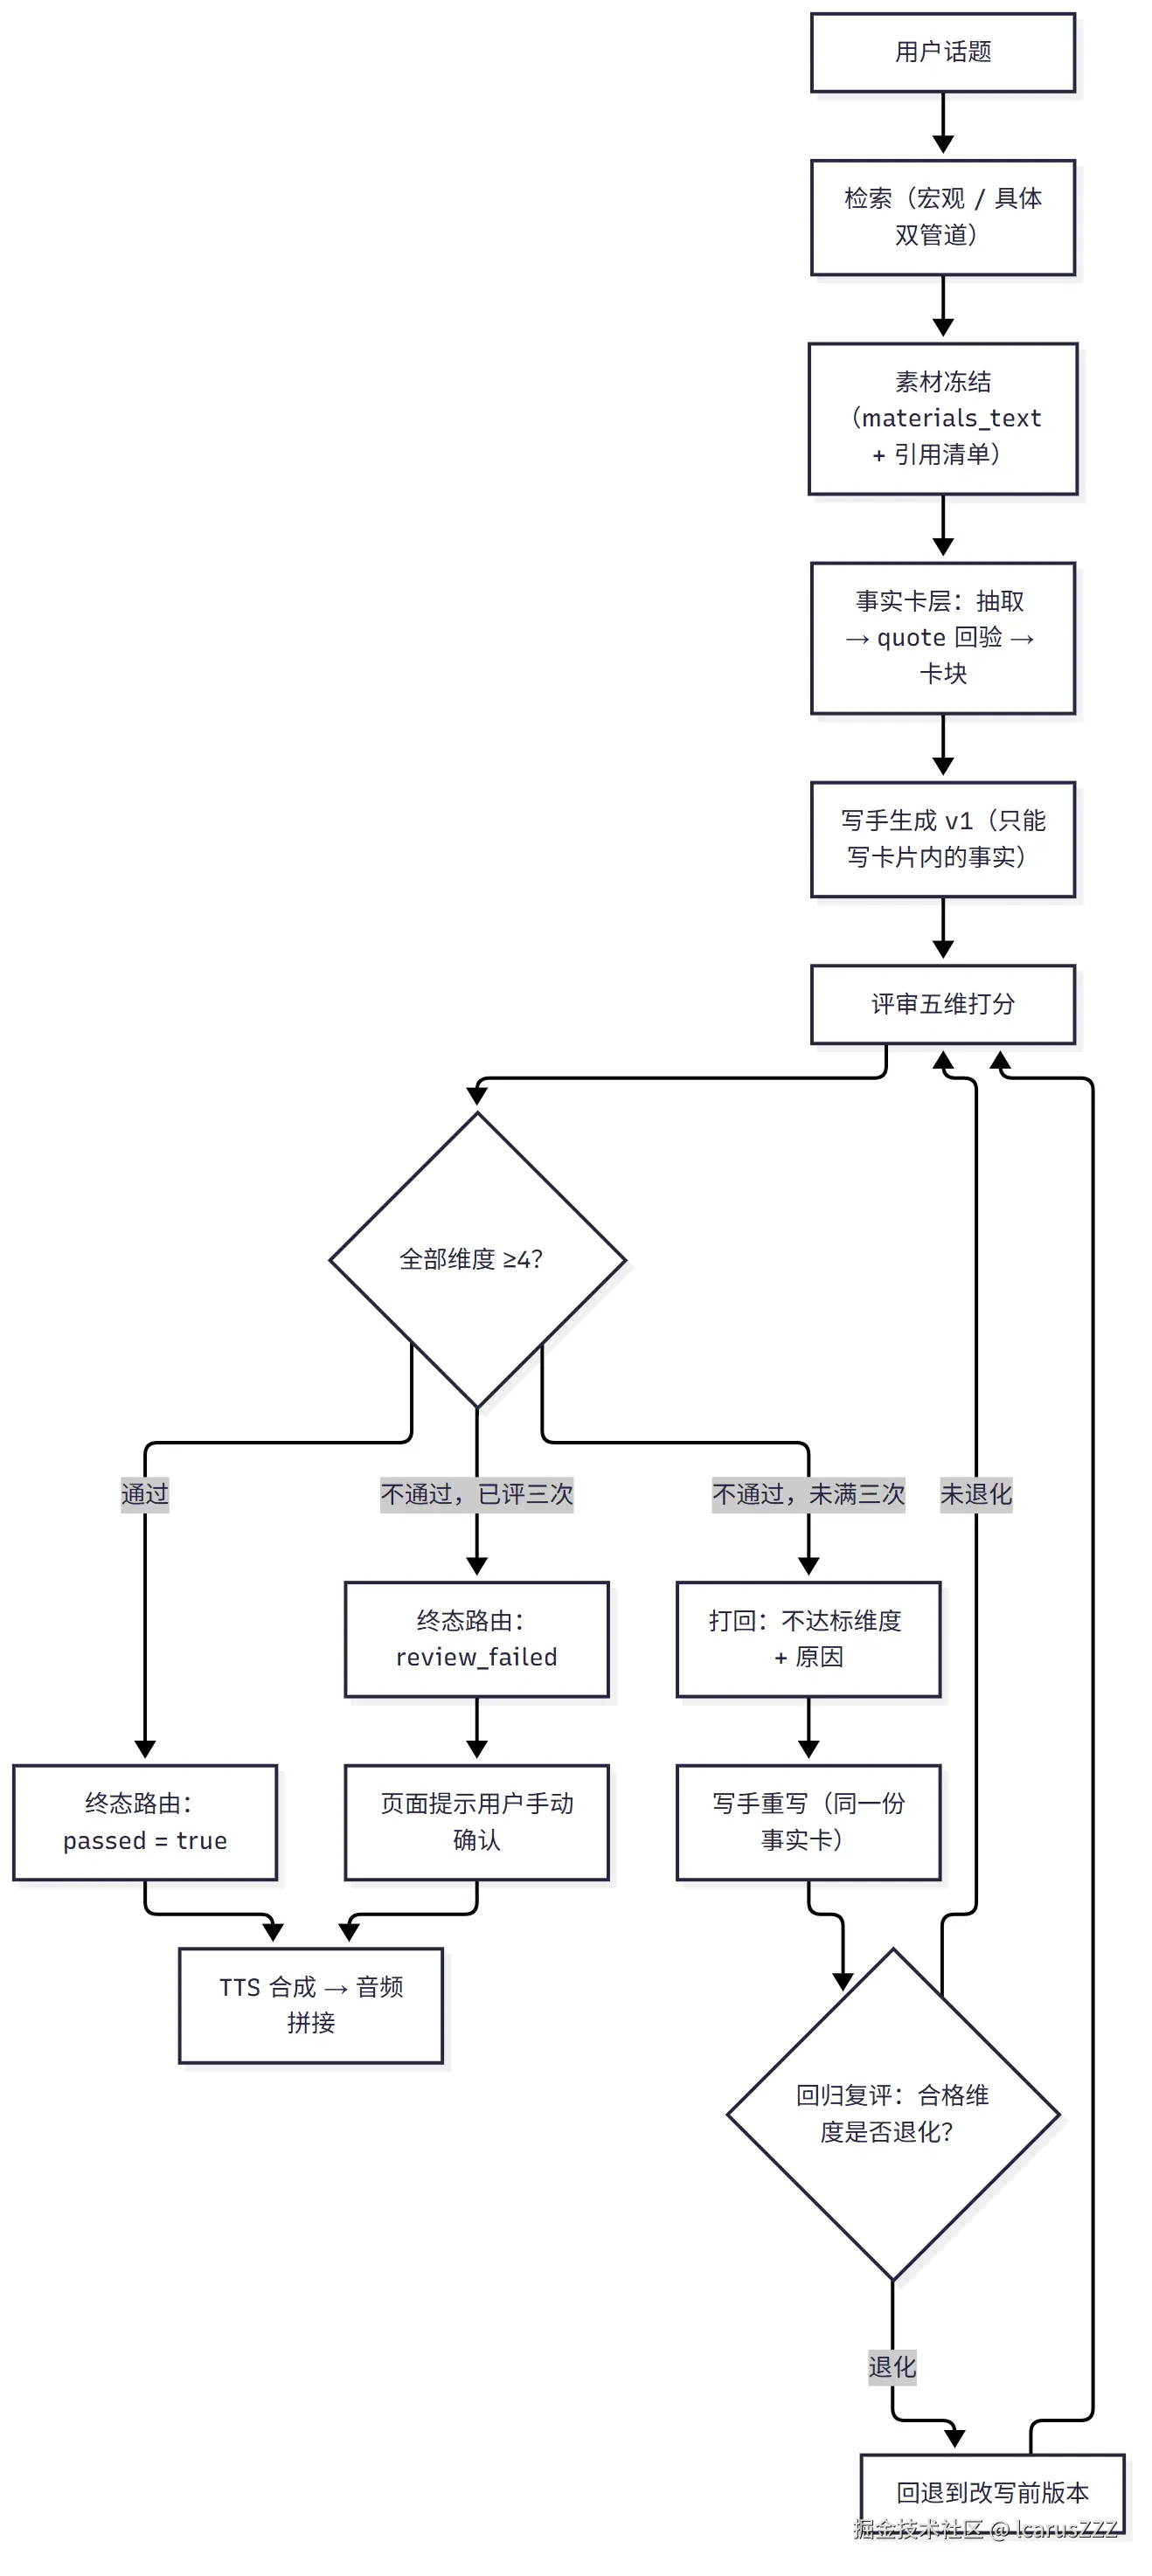
两条终态路径的区别:通过 走自动合成;三次不通过走人工审核节点------因为这时候需要人来判断"是素材确实不够,还是模型写不好",模型不该替用户做这个决定。
数据规模与成本
数据规模
| 指标 | 数值 |
|---|---|
| 新闻库存(PostgreSQL) | 12,541 篇 |
| 可检索(全链成功,已进向量库) | 8,480 篇 |
| 近 30 天 | 10,002 篇 |
| 来源 | RSS(央视网等)+ 新浪滚动 API 回填 |
注意库存和可检索差了 4,000 多篇------这不是丢数据,是质量门禁拦掉的(约 32% 的损耗率)。逐级明细:
| 阶段 | 拦截原因 | 篇数 |
|---|---|---|
| 抓取 | 中文占比不足(英文页 / 混杂页) | 2,300 |
| 抓取 | 标题词命中率低(正文与标题对不上) | 453 |
| 抓取 | 导航行占比过高(列表页被误抓) | 178 |
| 抓取 | 正文抽取失败(JS 渲染 / 空壳页) | 100 |
| 抓取 | SimHash 内容判重 | 169 |
| 打标 | 语义质检拦截(非完整可读正文) | 577 |
| 打标 | LLM 打标失败(重试耗尽) | 97 |
| 打标 | 待处理(管线未跑完) | 151 |
| 其他 | 人工审核移除 | 36 |
最大的单项是**「中文占比不足」2,300 篇**------新浪滚动流里混着大量英文/译文页面。这类文章留在库里对检索是负价值(用户问中文新闻,召回一堆英文页),拦掉反而是好事。
所以这个损耗率不该被"优化"------它是门禁在正确工作。真正要关注的是保留下来的那 8,480 篇质量如何。
向量库用的是 火山引擎 serverless Milvus ------不用自己维护索引、不用管扩容,按量计费。个人规模下成本基本可忽略,这也是选它而不是自建的原因:省下的运维精力远大于那点费用。
单期成本
一条 5 分钟 的播客,全链路成本约 1.1-1.3元。
拆开看调用结构(这是成本的主要来源):
| 环节 | 模型 | 调用次数 |
|---|---|---|
| query 改写 / HyDE / 相关性门禁 | flash 级小模型 | 3 次 |
| 事实卡抽取 | glm-4.5-air | 1 次 |
| 写手生成 | glm-4.5-air | 1~3 次(最多三版) |
| 评审(五维打分) | deepseek-v4.1-flash | 最多 15 次(5 维 × 3 轮) |
| 改写 | glm-4.5-air | 最多 2 次 |
| TTS 合成 | MiniMax | 按字数 |
两个值得注意的点:
① LLM 侧其实很便宜。 脚本生成 + 抽卡 + 改写(glm-4.5-air 付费档)加起来才几毛钱;评审虽然调用次数最多(最多 15 次),但用的是 flash 级模型,单次也就几百 token 输入。
② 成本大头在 TTS。 语音合成按字符计费,而一期播客是 1300+ 字------所以优化 TTS 的性价比远高于优化 LLM 调用。真要压成本,方向是复用音频片段或换更便宜的 TTS,而不是省评审次数。
今年四月前端仔失业了,也想往AI方面走走看,分享一下踩过的坑,也希望大家给点建议,顺便杭州求agent或者前端相关的工作