RAG知识库大语言模型## 从门户入口到检索、评测、结构化知识、智能体与对外接入 ------ 37 屏真实界面 + 5 张实测数据图,每个数字都写清出处
本文所有截图都来自真机登录后逐页点出来的界面(某内网环境的演示租户), 所有数字都能在对应发布批次/评测编号上复核。写下这篇的同一个下午,我们靠「真的点一遍」逮到了三个 只有点界面才会暴露的缺陷(最后一节),都修完重新发布、再验过。
截图里的知识库名、文档名、智能体名均为演示环境数据;内网地址、账号、凭据已在截图中就地脱敏, 应用 ID 与内部脚本路径统一做了泛化处理。技术数字与验收口径原样保留。
这篇文章里能看到什么(每一条都对应后面的真实界面,不是名词罗列):
| 区块 | 本文能看到的东西 |
|---|---|
| 门户与总览 | 登录后的仪表盘(Token 用量、会话、调用趋势、知识库/文档/分块/技能规模) |
| 文档知识库 | 库画像与文档清单、63 个文件的解析/打标流水线、多模态融合进度、检索耗时拆解、问答引用 |
| 检索增强 | 概念词典 / 规则卡 / 扩展预览、术语分支 + RRF 融合、A/B 与延迟代价 |
| 评测 | 评测集、参数区、run 指标(Hit/MRR/NDCG)、用例清单(别名 vs 对照)、置信区间口径 |
| 结构化知识 | 字段定义与写入约束、被拒时的原话、记录树与扩展属性、结构化搜索 |
| 多模态 | 知识图谱与健康度、公共图片搜索(关键词 + 以图搜图) |
| 治理 | 标签体系、文件库审核策略、用户与角色 |
| 智能体平台 | 三类智能体(标准 / 数字员工 / 编排)各解决什么问题、建一个智能体的四步向导(含 AI 真的生成出配置)、详情页每一项配置、技能/模型/工具目录、编排画布、对话与轨迹 |
| 对外接入 | 应用管理(App ID + Token + 在线节点)、接入文档(认证与身份 / 接入模式 / 快速开始五步)、五种接入路径(OpenAPI / 嵌入式 token / OpenAI 兼容 / MCP / Dify + SDK 回调)、以及一次真机冒烟的原始返回 |
| 基础设施 | 向量库 / 搜索引擎 / 文件存储实例、基础设置(解析、语音、数字人、模板) |
| 安全巡检 | 风险检测(图片/视频)、隐患字典 |
| 数据外连 | 只读数据源(101 张表资产目录 + 白名单)、四层防护、外连访问日志 |
| 自证方式 | 21 套验收、数据体检、出口审计、发布闸门(Started SnailAiApplication) |
引子:一个把团队问住的问题
上线三个月后,业务方在验收会上问了一句:
「这个答案里的『30 天』,是从哪来的?」
这不是刁难。这是所有企业知识库最终都会撞上的那堵墙:答案听起来对,但没人能证明它对。 更糟的情况是 ------ 答案听起来对,其实是模型拿通用知识编的。
那一问之后,我们把评价标准整个换了一遍。不再是「答得像不像」,而是三件事:
- 没有依据就不回答(做成代码里的确定性行为,而不是靠提示词求模型);
- 说的每句话都能回到原文(数字、日期、条款号逐条核对,核对不到就标出来);
- 每一次改动都能自证(评测带置信区间、带噪声底线,改完要能说清「这是效果还是运气」)。
一、先看它长在哪儿:门户里的知识库中心
它不是个独立系统,而是挂在生产门户里的一个应用(「全部服务 → 知识库中心」)。 下面是登录门户之后的第一屏 ------ 仪表盘:
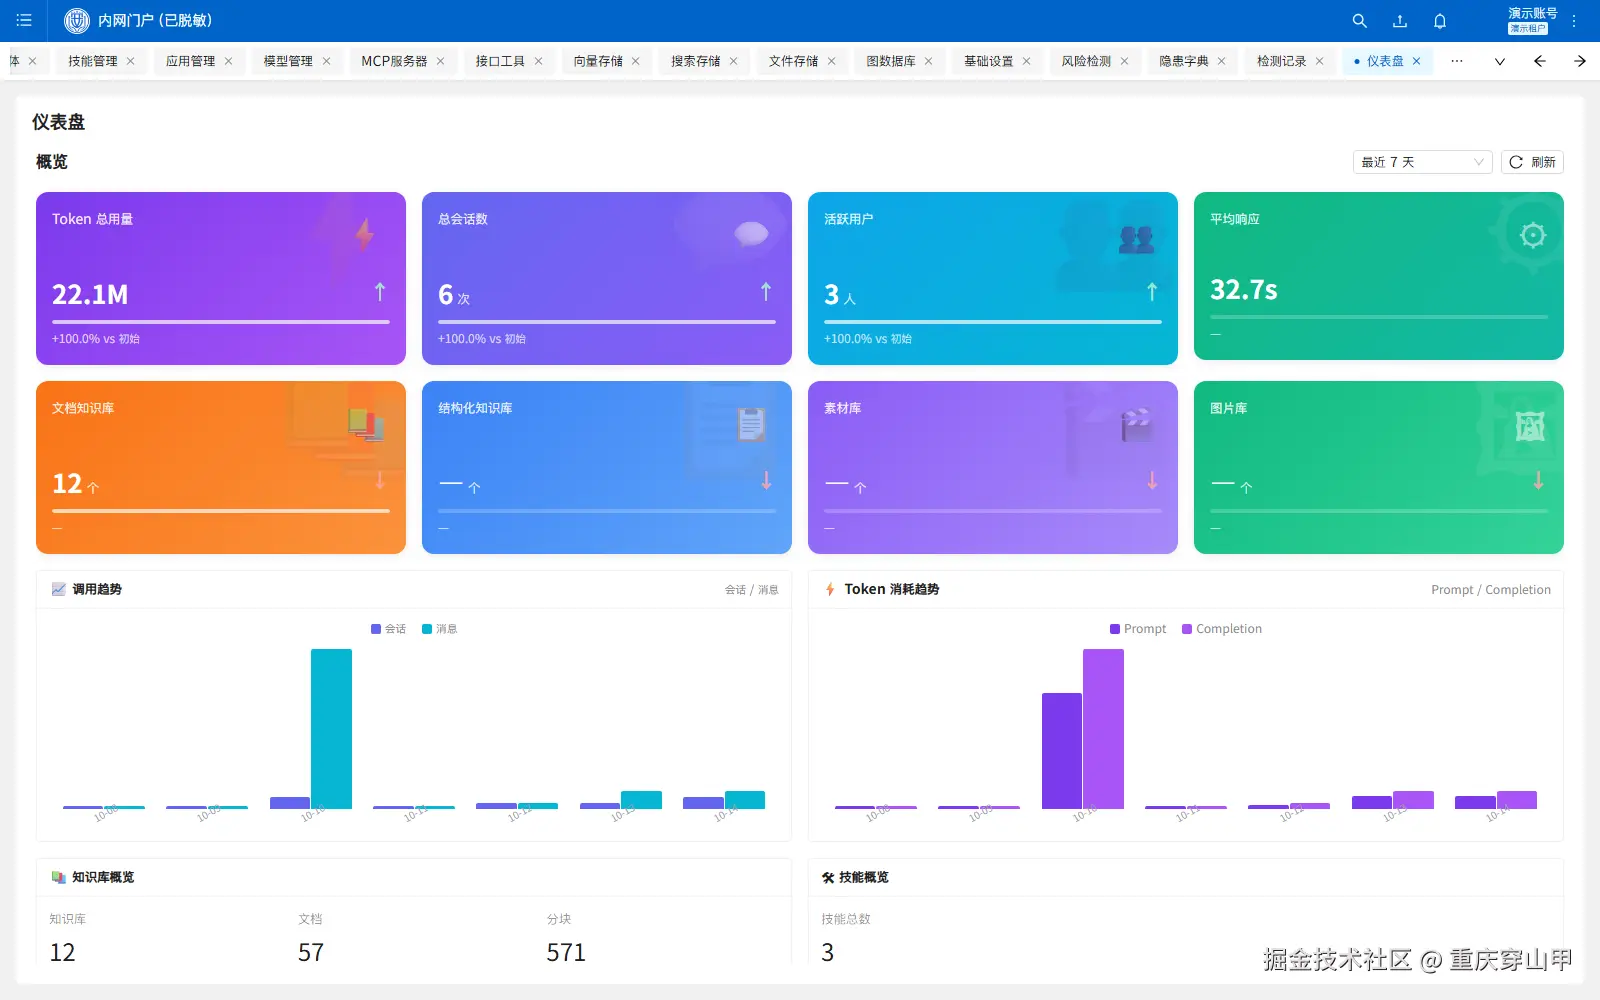 门户里登录后的仪表盘(近 7 天):Token 总用量 22.0M 、总会话 4 次 、活跃用户 2 人 、平均响应 29.1s ; 下面依次是调用趋势、Token 消耗趋势(Prompt/Completion 分开)、知识库概览(知识库 12 / 文档 57 / 分块 571 )、技能概览(技能总数 3)。
平台不是一个「上传文档然后聊天」的页面,它由九块构成:
| 区块 | 里面有 |
|---|---|
| 文档知识库 | 多格式解析(PDF/Word/Excel/PPT/Markdown/HTML/图片 OCR)、切片策略、向量化、混合检索、问答、评测、术语词典 |
| 结构化知识库 | 自定义字段 + 字段级约束门禁(必填/范围/正则/枚举/跨字段规则)+ 拦截日志 + 结构化搜索与 AI 回答 |
| 图片库 / 素材库 | 以图搜图(CLIP)、图片语义、跨模态检索 |
| 文件管理 | 公共/私有文件库、解析与 AI 打标流水线、人工审核、资源管理 |
| 智能体 | 标准智能体 / 数字员工 / 编排智能体,工具目录(接口工具、MCP、内置工具、插件)、对话与轨迹 |
| 编排 | 可视化画布、路由/大模型/入参/确认/工具/迭代/代码/知识检索节点、单步调试、节点级运行历史 |
| 对外集成 | OpenAPI(含 OpenAI 兼容端点)、C 端对话页、嵌入式片段、Java SDK、Dify 工作流双向兼容 |
| 基础设施 | 向量存储 / 搜索引擎 / 文件存储 / 图数据库 / 只读数据源(MySQL、PostgreSQL)实例管理、基础设置(解析引擎、语音、数字人、PPT/文档模板) |
| 治理与自检 | 密级与权限、查询审计、出口审计、工具凭据(密文)、标签体系、数据体检、一键验收、发布闸门 |
几条可以核对的数字(都带版本号,因为同一能力在不同版本上数字会变):
| 数字 | 含义 | 出自 |
|---|---|---|
| 1172 项单测全绿 | 后端主模块测试规模 | 发布批次 ③ |
| 21 套验收 / 21 pass / 0 fail | 一条命令跑完的端到端验收 | 发布批次 ⑧ |
| 39 passed / 0 failed / 6 skipped | 部署后功能体检(长期基线) | 交付收口说明 |
| 0 findings | 数据体检(孤儿索引、僵尸向量、无租户集合......) | 长期基线 |
| Hit@5 0.9677 / MRR 0.9516 | 整句评测集(31 题)检索质量 | 演示库 基线 |
| 首字 P50 1576 ms ;4 并发 4.30 req/s,错误率 0 | 延迟与容量实测 | 交付收口说明 |
二、文档知识库:从 63 个文件,到 6 条能回到原文的检索结果
文件进来之后发生了什么
文件不是「传上去就完事」。看这一屏 ------ 公共文件库:
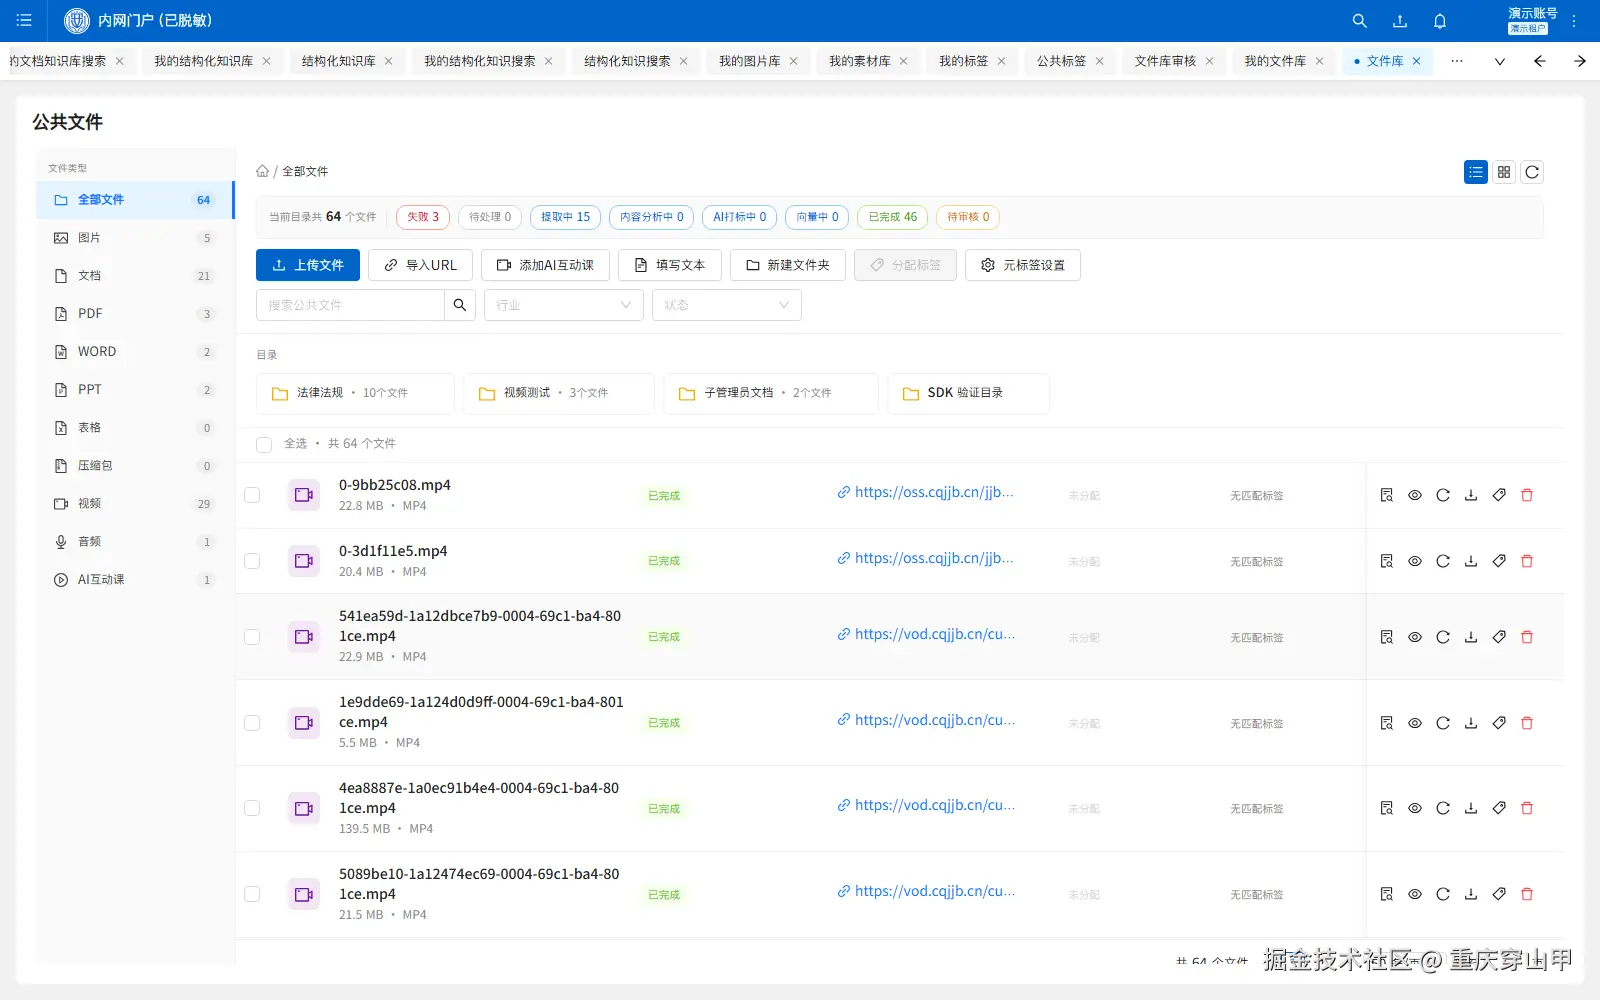 真实一屏:左侧按类型统计(全部 63 、图片 3、文档 21、PDF、WORD、PPT、表格、压缩包、视频 28、音频 1、AI 互动 1); 顶部是流水线状态(已完成 45、解析中 15、失败 3、待处理 0、内容分析中 0、AI 打标中 0、向量中 0、待审核 0); 目录里有「法律法规 10 个文件 / 视频测试 3 个 / 子管理员文档 2 个」;列表里每个文件带解析状态、存储地址、 分块状态、标签状态与预览/下载/删除入口。
再往上一步,是知识库本身与它的文档:
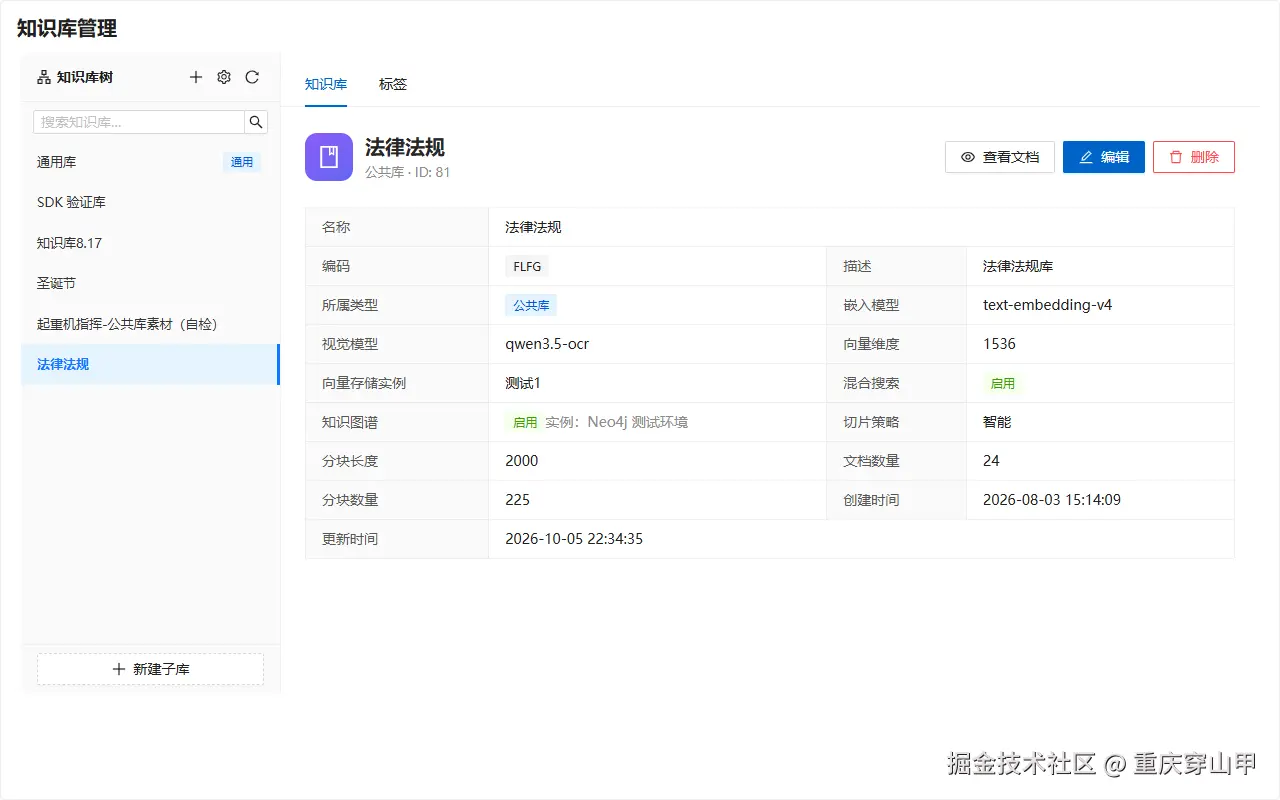 知识库管理:左侧是知识库树(通用库、SDK 验证库、法律法规......),右侧是该库的完整画像 ------ 编码、归属类型、嵌入模型、视觉模型、向量维度、向量存储实例、混合搜索、知识图谱、切片策略、 分块长度、文档数量(24)、分块数量(225)、创建/更新时间。
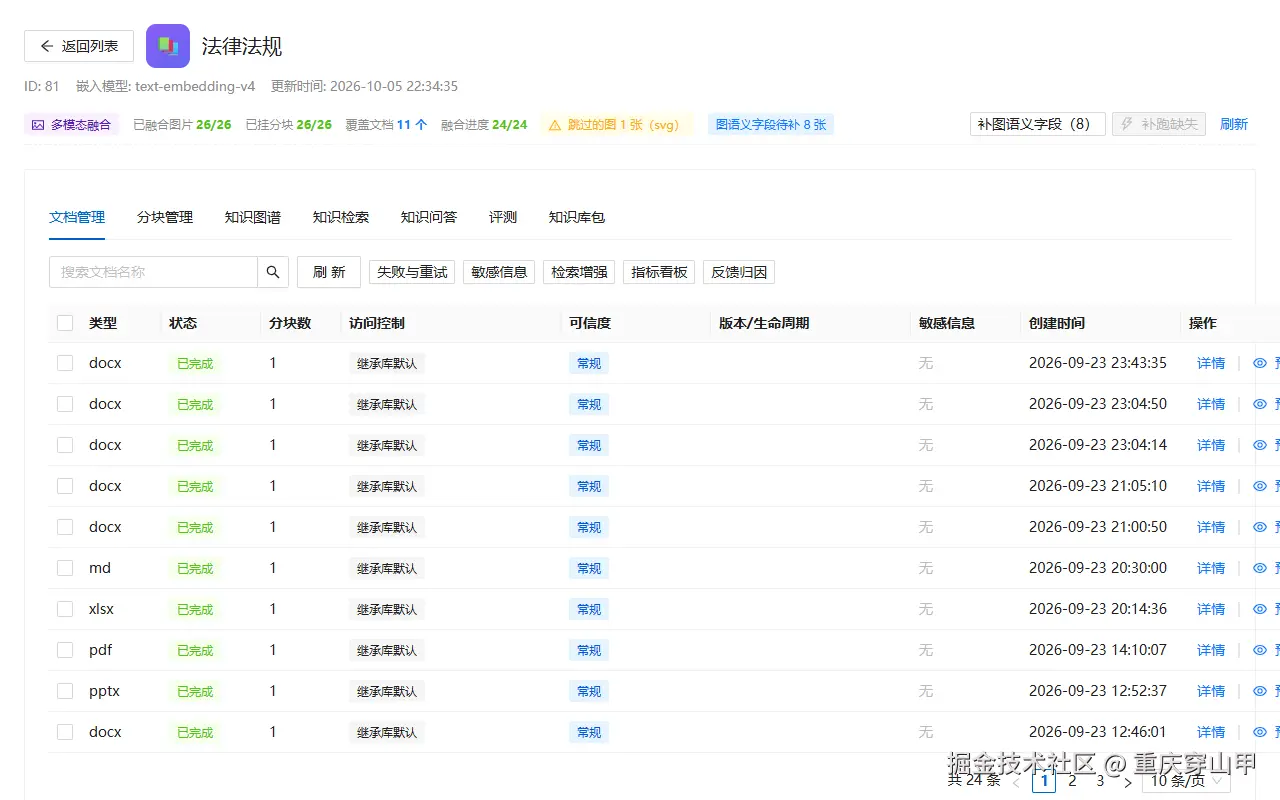 文档管理这一屏能同时看到:文档清单(含状态、分块数、访问控制、可信度、版本/生命周期)、 多模态融合进度(24/24 已融合、26 张图已挂到分块)、以及右侧的「补图语义字段 / 补跑缺失」等运维入口。
检索不是「一个搜索框」
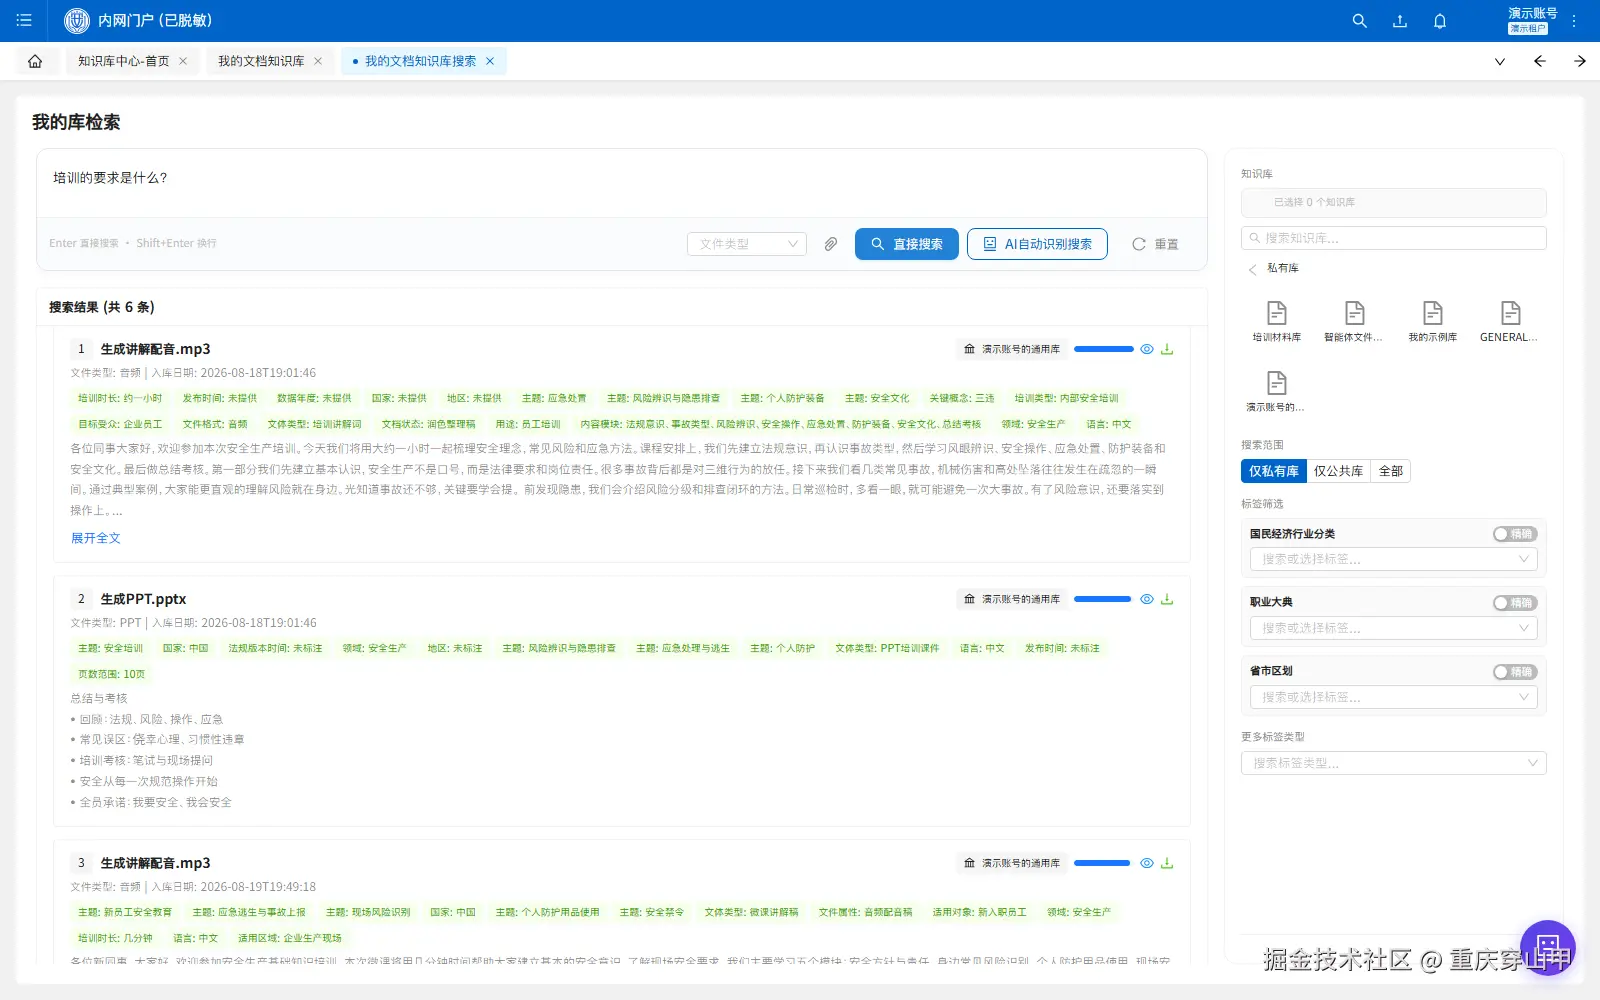 真实一次检索(问题:培训的要求是什么? ):返回 共 6 条 ,每条给出发布时间、数据来源、主题标签、 关键词标签、类型、语种、适用场景,以及摘要正文;右侧是知识库范围(仅私有 / 仅公共 / 全部)与 标签筛选(国民经济行业分类、职业大典、省市区划、标准分类)。
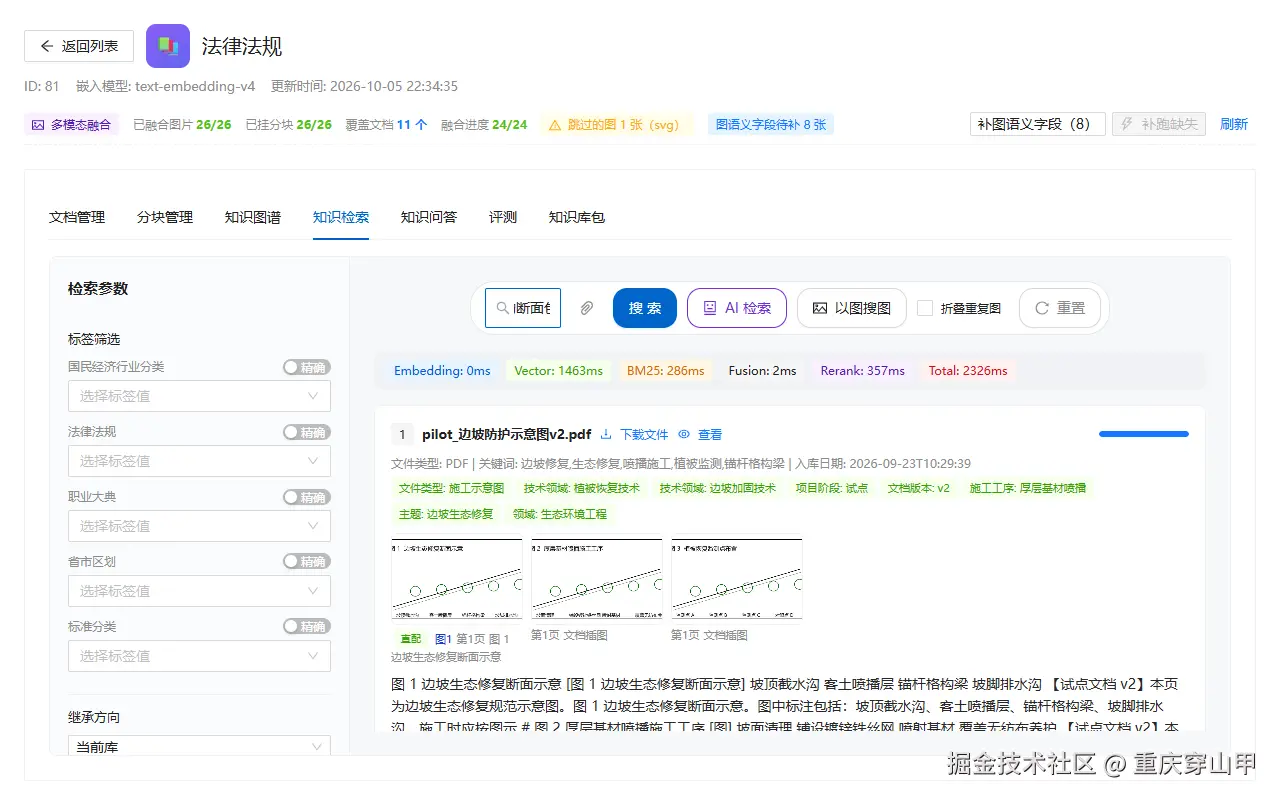 检索页把每一步耗时都摊开:Embedding 0ms、Vector 1463ms 、BM25 286ms 、Fusion 2ms、Rerank 357ms 、Total 2326ms; 命中结果给出文档名、文件类型、关键词标签、领域标签、图片,以及命中段落原文(绿色标注)。
这条链路的能力清单:
- 混合检索 + RRF 融合 :向量 + 全文,51 个库开启;整句评测集(31 题)Hit@5 0.9677 / MRR 0.9516;
- 父子上卷:小块检索、大块生成(一条法规、一对问答、一页幻灯片为单位交给模型);
- 表格是一等公民 :表格的行是原子单位 、每片都带表头(真实文档实测 17/17 自带表头、表行 219 / 丢失 0 / 腰斩 0 ); 问表格里某个单元格的值时,平台下沉到「单元格级候选行」------实测 4/4 top-1 命中 ,阅读面 1698 行 → 3 行 ; 问一个不存在的型号,返回 0 行(宁可不给,也不硬凑);
- 缓存:键 = 主体指纹 + 库配置指纹 + 查询,改动词典立刻换键,不会端出旧结果。
三、「不硬答」------最伤信任的行为,是查不到还编
知识库最伤信任的行为不是「查不到」,而是查不到还答得很像。所以我们把「没有依据就不回答」 从提示词里的事,变成了代码里的事:
拒答关卡 :检索后如果没有任何可用证据,平台直接返回标准拒答话术,根本不调用模型 。 既不硬答,也省一次调用。库级阈值实测:43 条有依据题的最低分是 0.1449、域外问题的最高分是 0.1179 ------ 0/43 误拒、10/10 拦下。
拒答还要「拒得明白」。我们把「没有答案」分成三种,因为它们要解决的问题完全不同:
no_result:库里确实没有这份资料 → 去补资料;acl_all_dropped:召回了,但全被权限挡掉 → 这是权限配错了,不是语料问题;below_threshold:召回了,但分数都低于阈值 → 该调阈值或补标注。
生成后置校验 :答案生成后,平台把答案里的数字、日期、标准号、条款号逐个拿到本次引用的原文 里核对, 核对不到就在界面上标出来 ------ 只提示,不自动改答(自动改动可能把对的改错,而用户无从判断)。
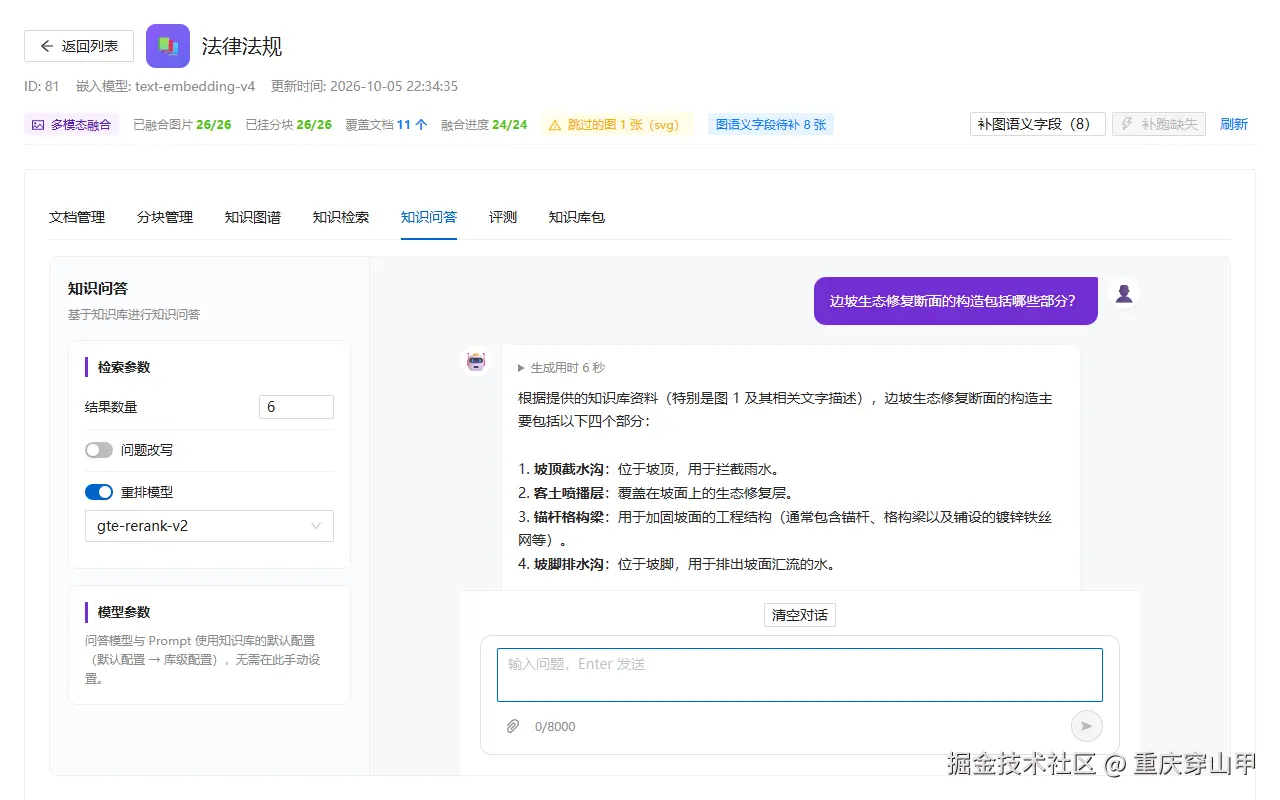 真实的一次问答:答案里把断面构造拆成四条(坡顶截水沟 / 客土喷播层 / 锚杆格构梁 / 坡脚排水沟), 下面给出参考资料(4 个文档片段)(可点「定位」回原文),还带出文档里的 9 张插图。
四、检索最花功夫的地方:把「听得懂人话」做到能测量
企业里的真实情况是:同一件事,业务有三种叫法,资料里只写了一种。 用户问「员工学习有什么要求」,资料里写的是「培训」。
我们为这件事返工了三次,每次都有实测数字:
第一版(双向追加同义词) :查询里出现概念名就自动补别名。真机一量结果很难看 ------ 培训的要求是什么?(用户已经说了库里的写法 )命中 4 条 → 2 条 :它被扩成「... 学习」, 而「学习」在这个库里一次都没出现,查询串变长、权重被稀释。
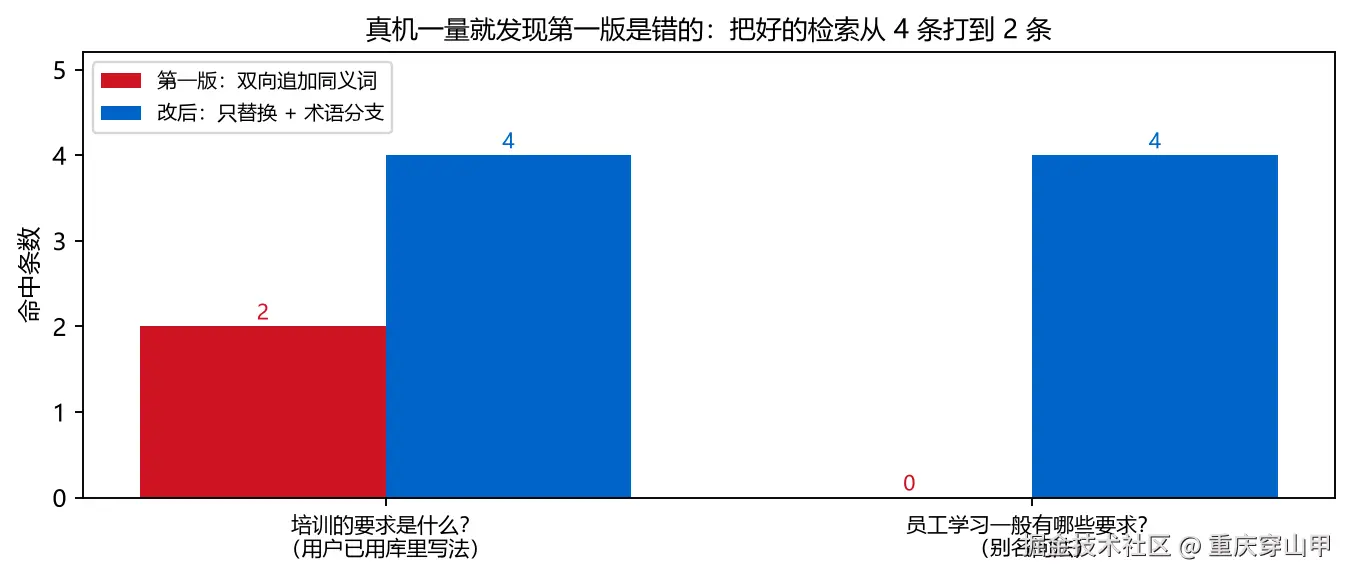 第一版把好的检索从 4 条打到 2 条;改后两侧都回来。
第二版(只替换、不追加) :用户用别名问 → 把别名替换 成库里的写法(长度不变、不引入库里没有的词); 用户已经说了库里的写法 → 一个字符都不改。
第三版(术语分支 + RRF 融合) :长问句里一个词的权重还是不够,于是对「用别名问」的请求, 平台额外用术语单独检索一遍 (比如直接查 验收),两个分支各按名次用平台自己的 RRF 融合 ------ 按名次融合,主分支排序不会被稀释,最坏情况只是多出几条补充召回。
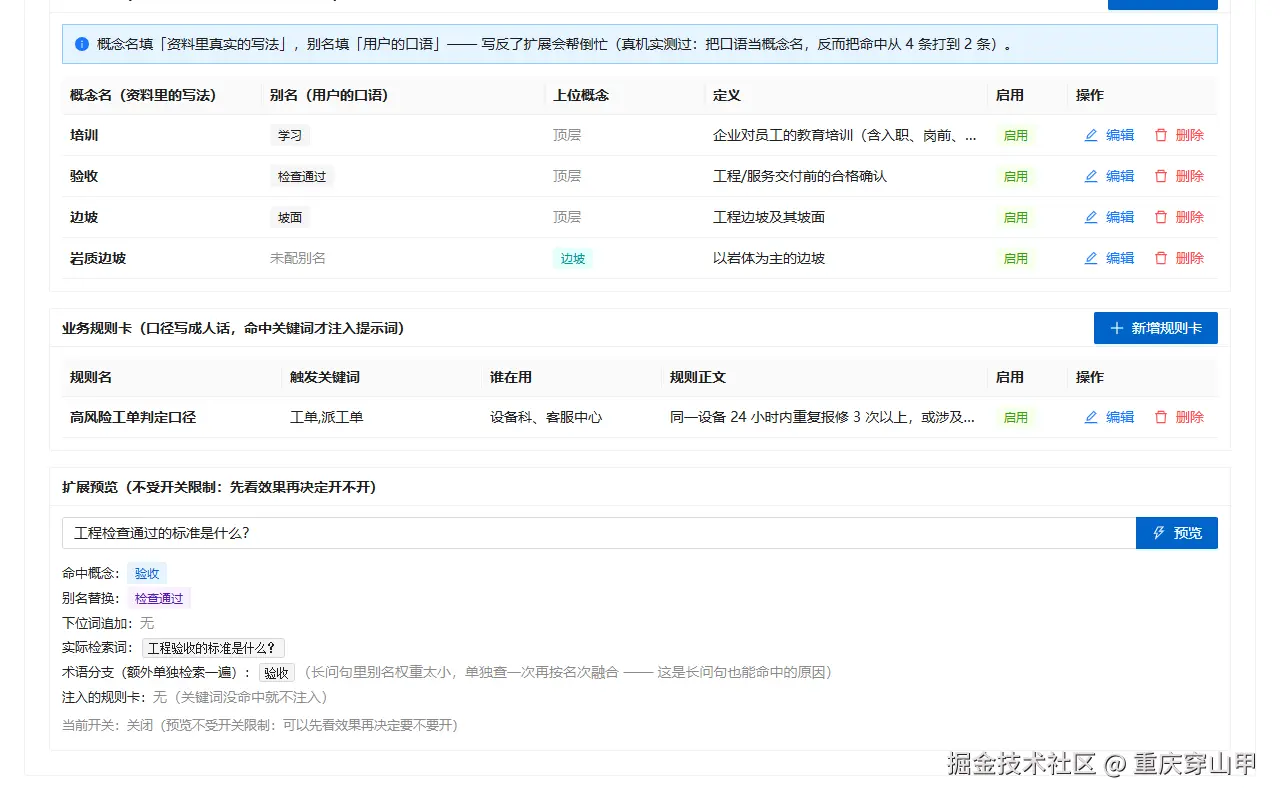 平台上一屏真实界面:上面是概念词典 (培训←学习、验收←检查通过、边坡←坡面、岩质边坡→上位「边坡」), 中间是业务规则卡 (「高风险工单判定口径」,含触发关键词与使用方), 下面是扩展预览 ------输入「工程检查通过的标准是什么?」,它当场告诉你:命中概念「验收」、 别名被替换成「工程验收的标准是什么?」、会额外单独检索一遍「验收」、以及这次不注入规则卡。
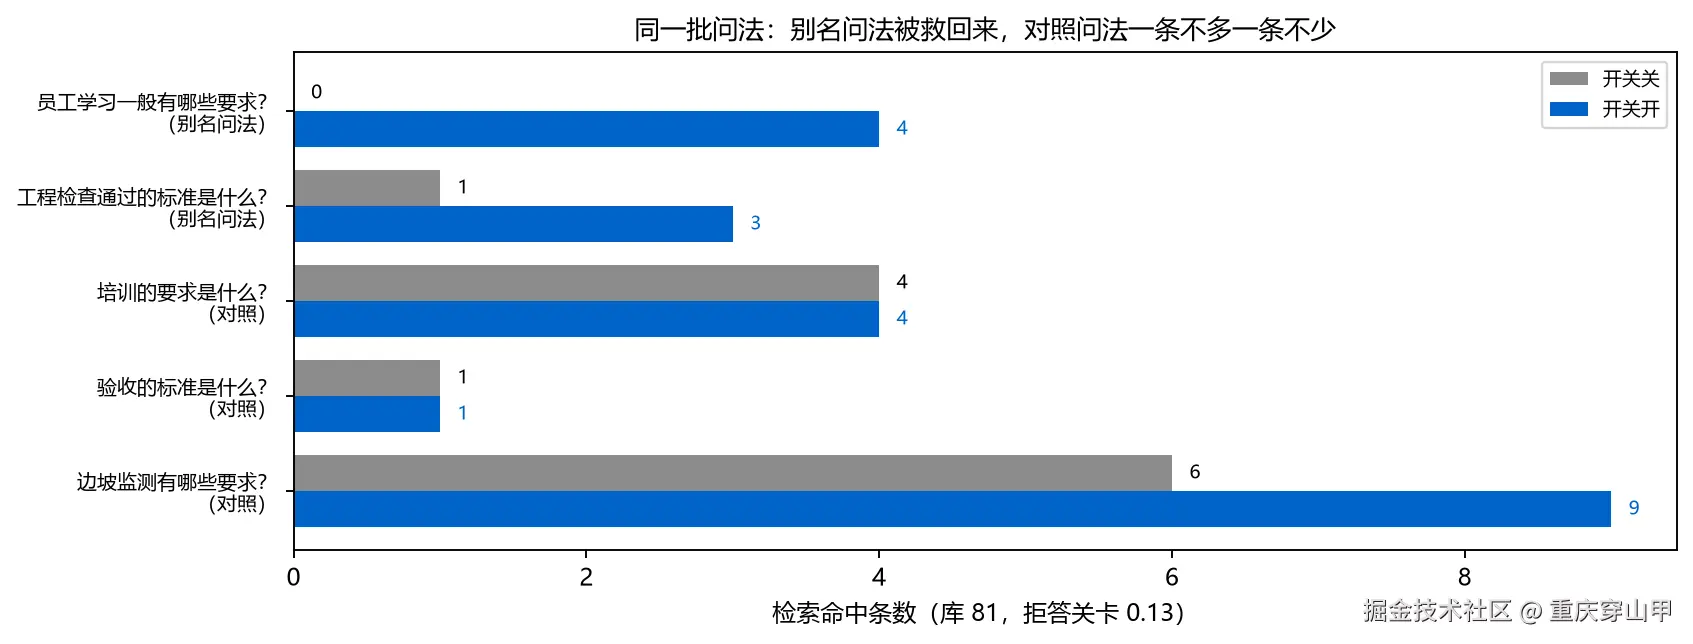 同一批问法:别名问法被救回来(0→4、1→3),对照问法一条不多一条不少。
| 指标(发布批次 ③) | 开关关 | 开关开 |
|---|---|---|
| 命中率(4 题别名题集) | 0.5 | 1.0 |
| MRR | 0.5 | 1.0 |
| NDCG | 0.4438 | 0.7967 |
| 逐题 | --- | 变好 2 道(都进第 1 位)、变差 0 道 |
| 既有 8 题集 | 1.0 | 1.0(零回归) |
代价也单独量了:
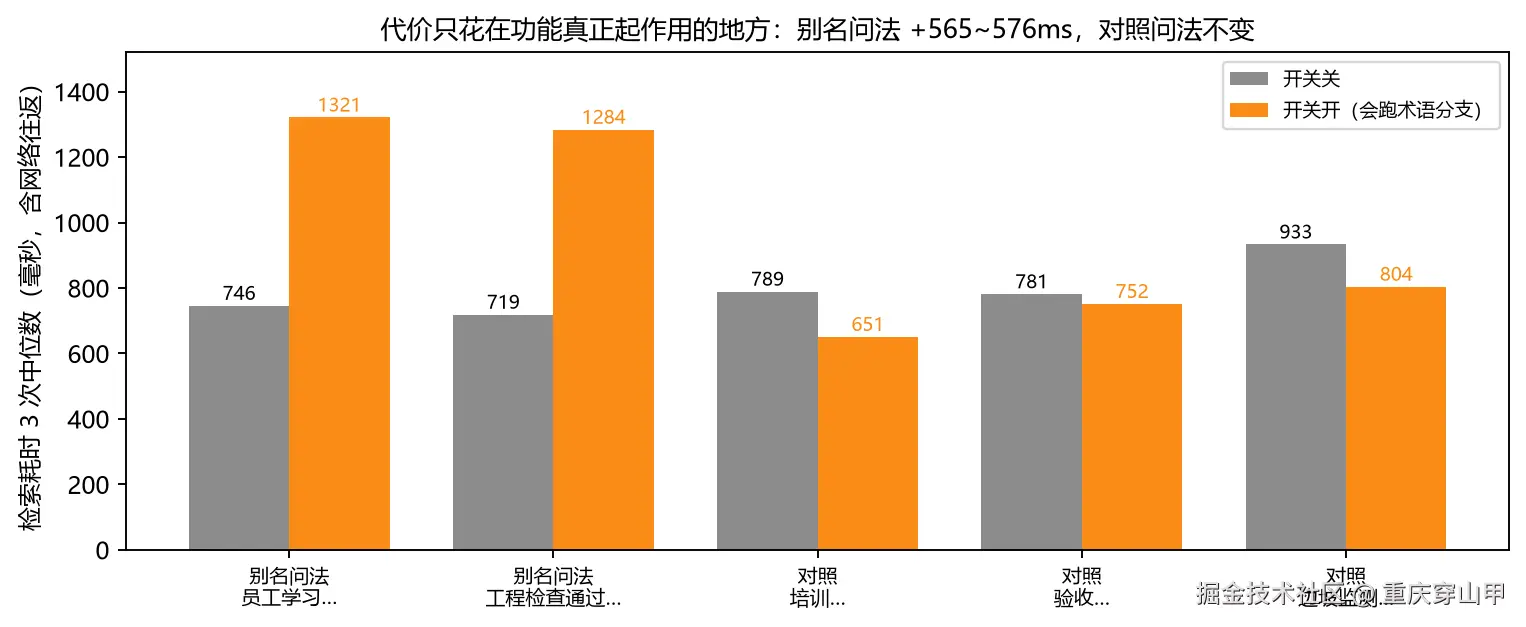 只有「用别名问」的请求多花约 0.6 秒;直接用库里写法的问法延迟不变 ------ 代价只花在功能真正起作用的地方。
顺带说一句 :这个开关默认是关的。不是我们不敢开,而是 4 道题的 A/B 在统计上判定为「样本不够」------ 开不开应该由使用方拿自己的题集跑两遍再决定。
五、评测:把「结论有多可信」做进产品
很多平台都有评测页。我们的评测页做得「啰嗦」,因为见过太多被数字骗了的决定。
一个真实例子 :同一套题、同一个库的两次评测,只差 1 道题 ,命中率 0.9032 → 0.9355。 以前的界面会写「变好 3.2%」,然后有人照着去改配置 ------ 而这很可能只是运气。 同一批 31 道题的 95% 置信区间是 0.751, 0.9665:这个宽度就说明了一切。
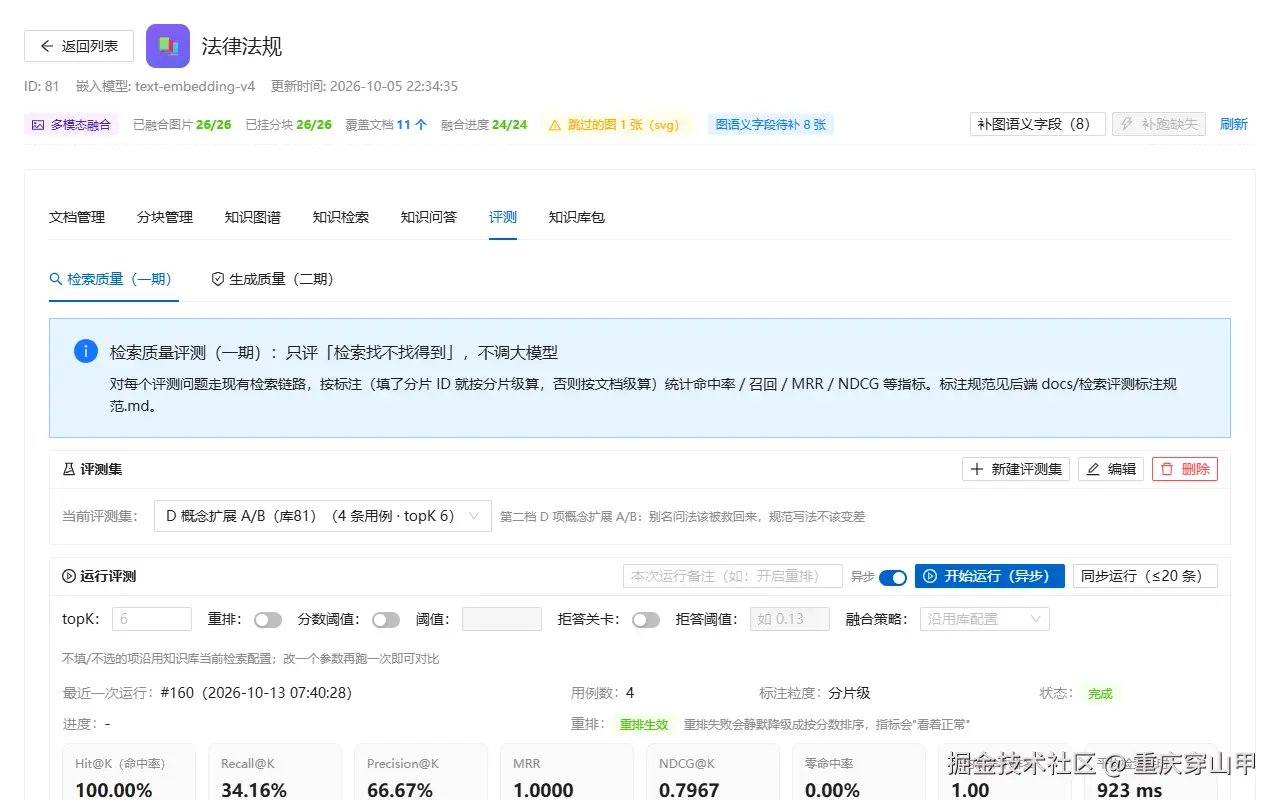 真实的一屏:评测集「D 概念扩展 A/B(4 条用例 · topK 6)」;参数区(topK / 重排 / 分数阈值 / 拒答关卡,不填则沿用库配置); 最近一次运行 #160 的指标:Hit@K 100.00% 、Recall@K 34.16%、Precision@K 66.67%、MRR 1.0000 、NDCG@K 0.7967 、 零命中率 0.00%、平均首命中排名 1.00 、平均检索耗时 923 ms。下面是用例清单,每条都写着它是「别名问法」还是「对照」。
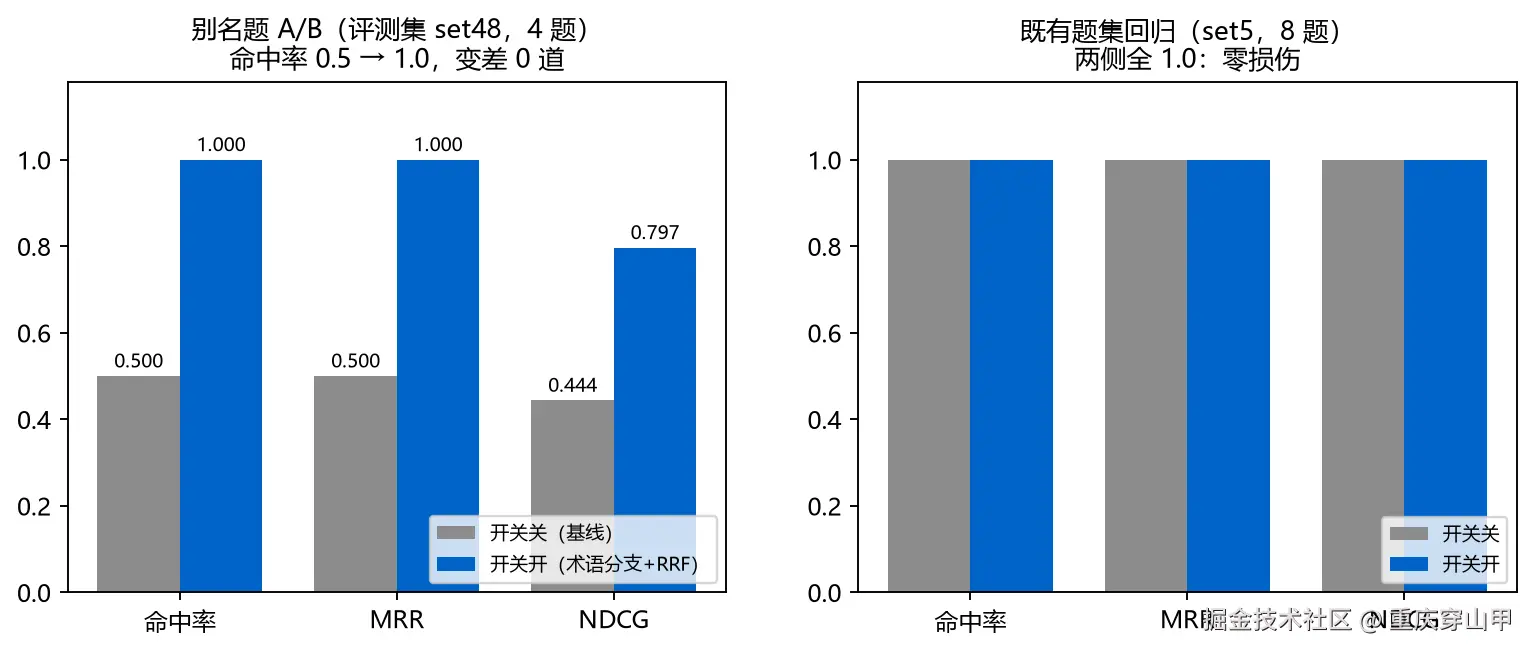 同一张图上看两件事:4 道别名题的命中率 0.5 → 1.0(开着才有用),以及既有 8 题集两侧都是 1.0(开关不伤老题)。
这层能力做全了是这样:
- 开跑前预检 :库不健康就一条用例都不跑 (run 终态
PRECHECK_FAILED); - 结论带误差 :Wilson 95% 区间 + McNemar 配对检验,结论只可能是差异显著 / 不显著 / 样本不够;
- 噪声底线 :同配置重复跑 2~5 遍,给出「结论翻转的题数」(实测 0/31),差距小于它就不算改动有效;
- 四指标分开给、不合成总分 :准确率、自信错答率 、拒答正确率、过度拒答率 ,各带区间; 分母为 0 时如实显示「未计算」,不给 0;
- 题型化出题 + 五关校验 :模型出的题要过「依据逐字、闭卷不得答对、对原文重答、无答案题回查、计算题程序算」; 打回题可见且必须写理由(实测出题 4 道:入库 3、打回 1,原因是「引文在原文里找不到」);
- 配置留痕 + 题源分列 :每份报告带配置指纹与配置快照(21 个字段,含「库里的向量实际是哪个模型建的」), 口径写得很直白:模型出的题是「自己出题给自己打分」,只看趋势、不进回归门禁;业务题才是真口径;
- 库无关期望 :题可以用「文件名」或「原文片段」判期望,解析不到的题不计入分母------不会凭空拉低指标。
这套评测最直接的价值,是把我们自己的两个结论钉死了 :31 道题的题集在统计上分不出 topK=5 与 topK=1(「把题加多」不是套话,是真实瓶颈);概念扩展的 A/B 被判定**「样本不够」**(所以开关默认关)。
六、结构化知识:给「表格里的知识」装上写入门禁
文档知识库管的是「文章」,结构化知识库管的是「台账」:培训记录、隐患台账、设备清单这类 字段固定、要能被精确筛的数据。
先定义字段,再规定什么叫「不合规」
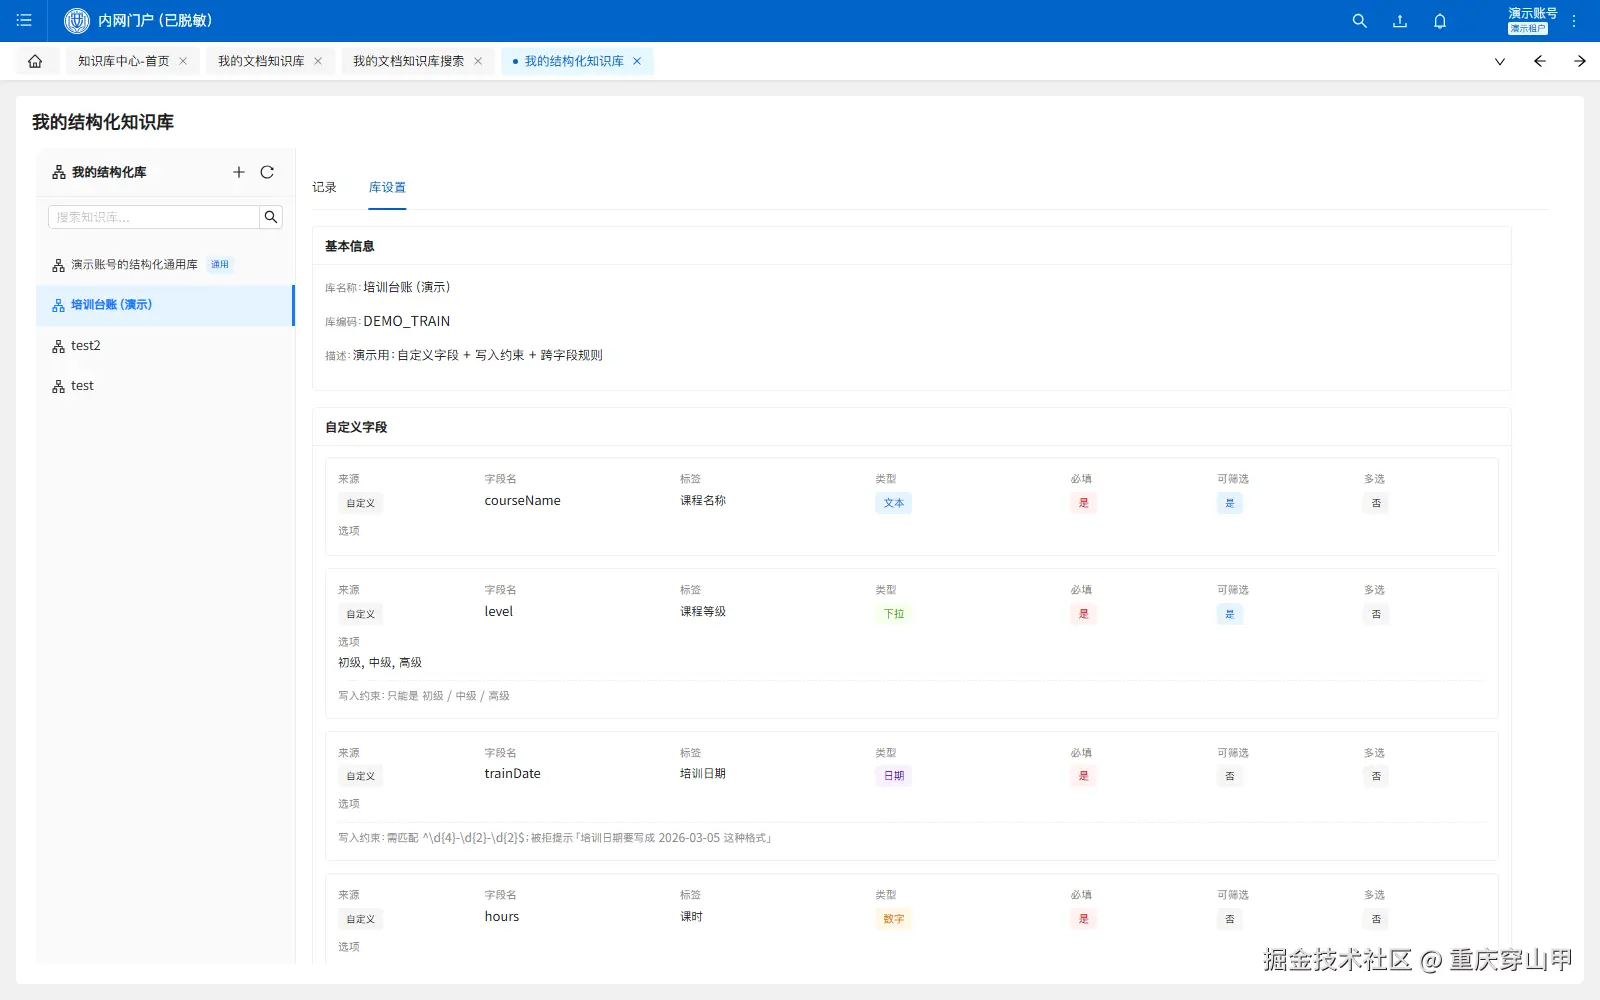 真实一屏:库「培训台账(演示)」(编码
DEMO_TRAIN),6 个自定义字段逐个给出写入约束 ------ 「课程等级」只能是 初级/中级/高级;「培训日期」需匹配 ^\d{4}-\d{2}-\d{2}$,且被拒时会说人话 : 「培训日期要写成 2026-03-05 这种格式」;「课时」范围 1200,被拒提示「课时必须在 1200 之间」。
这些提示语不是文案,是真被拒时后端返回的原话(下面就是实测记录):
| 故意提交的坏数据 | 接口返回 | 平台原话 |
|---|---|---|
| 课时 = 9999(超出 1~200) | HTTP 200,success: false |
「记录不符合该知识库的字段约束:课时必须在 1~200 之间」 |
| 开始日期 2026-03-09 > 结束日期 2026-03-02 | HTTP 200,success: false |
「记录不符合该知识库的字段约束:开始日期不能晚于结束日期」 |
跨字段规则是声明式三元组 (左字段 / 比较符 / 右值或右字段),不做表达式求值 ------ 那会变成半个规则引擎,维护成本吃光收益。违规会被拦下并写入拦截日志 (独立事务,业务回滚日志照样留下): 历史实测五类违规全拦、日志 6 条,其中一条是 UPDATE amount MIN >= 0 实际值=-5。
记录是树,属性是芯片
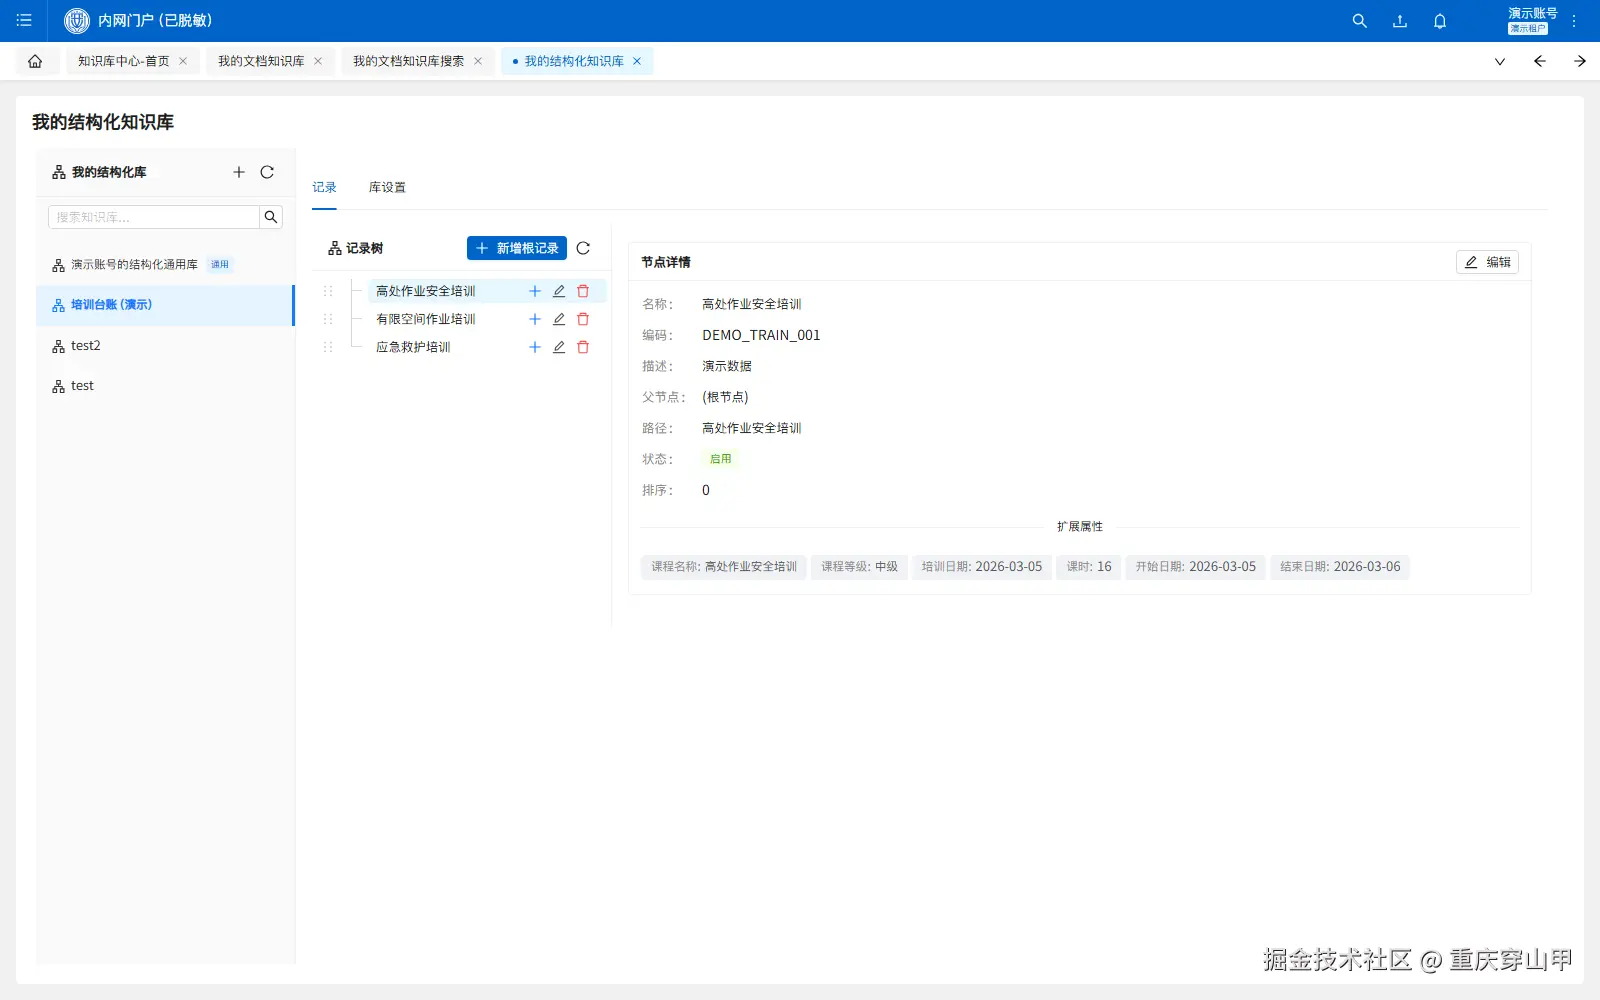 记录树支持层级与拖拽排序(这一屏 3 条:高处作业安全培训 / 有限空间作业培训 / 应急救护培训); 右侧「节点详情」把扩展属性按字段渲染成芯片:课程名称、课程等级、培训日期、课时、开始日期、结束日期 ------ 字段定义一次,每条记录的展示、筛选、检索都跟着它走。
结构化搜索:字段级筛选 + 相关度
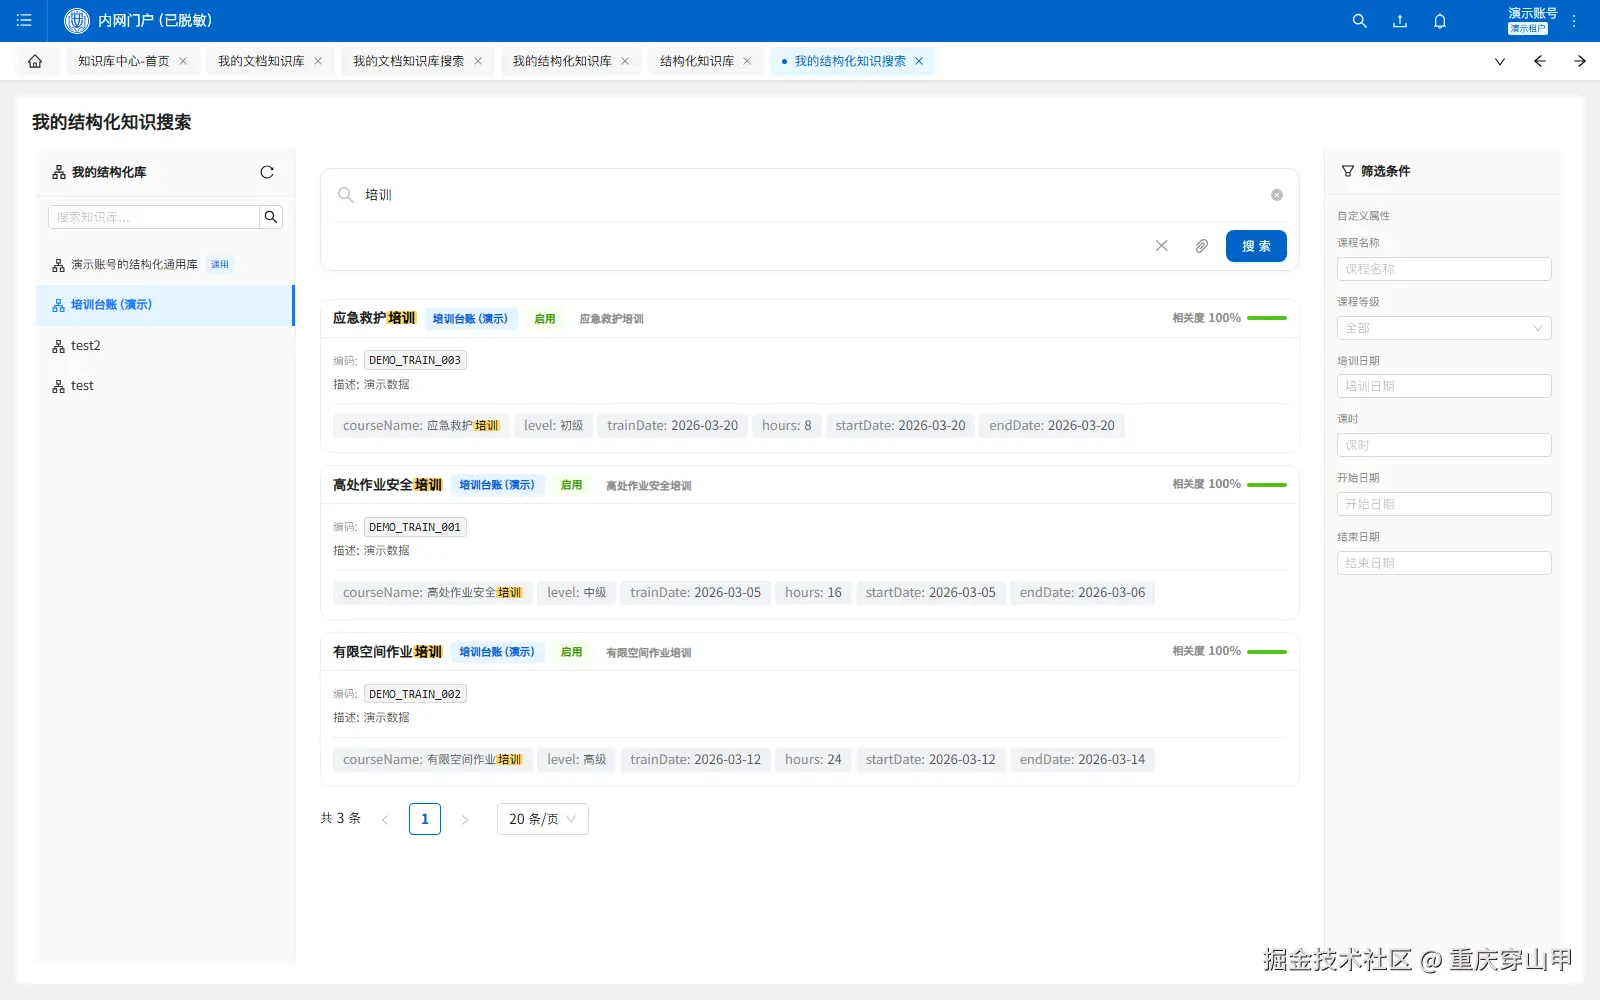 搜「培训」命中 共 3 条 ,每条给相关度(100%)与扩展属性芯片;右侧筛选条件面板按库的字段定义自动生成 (课程名称/课程等级/培训日期/课时/开始日期/结束日期),不需要为每个库写页面。
这一屏也顺便记录了一次真机缺陷:先前的版本里接口明明 200、命中 3 条, 页面却写「未找到匹配记录」(原因见最后一节)。
七、知识不只有文字
图谱的「事实」和「推理」必须分得开
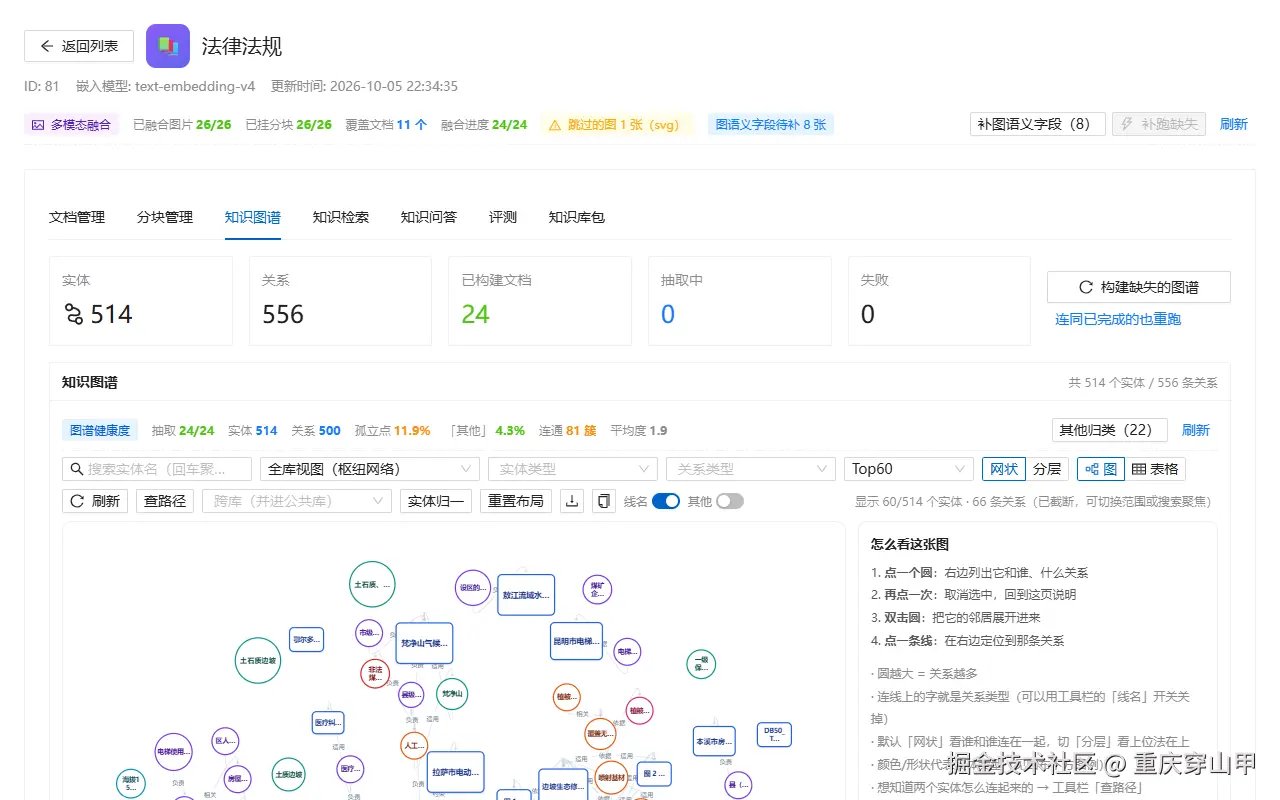 真实图谱视图:514 个实体 / 556 条关系、已构建 24 篇、图谱健康度(抽取 24/24、孤立点 11.9%、连通 81 簇、平均度 1.9)。 可以按实体类型/关系类型筛选、Top60 聚焦、网状/分层布局、查路径、跨库并库。
我们用图谱做多跳扩展,但检索时只取事实边;推理出来的边在画布上是紫色点线 + 「·推理」后缀, 给智能体看时会标「〔推理,非原文直述〕」。真机验证:往图库真插一条推理边 → 265 条边中 INFERRED=1 / FACT=264。数据体检还能抓出「标记已抽图谱、实际零实体」的文档(曾抓出 42 篇里 9 篇)。
图片里的内容也要能搜到
多模态融合把图片的图语义融进它所属的分块,于是「图里的内容」可以被文字搜到: 91 个库开启,实测融合 24/24、14/14(文档管理那一屏右上角就写着「已融合图片 26/26、覆盖文档 11 个」)。 文件库里也能直接看到这条链路的产物:上图的公共文件库中 图片 3 个、视频 28 个 , 每个文件都带解析状态、分块状态、标签状态;mp4 那条正在「处理 79 秒/139 秒」的转码进度。
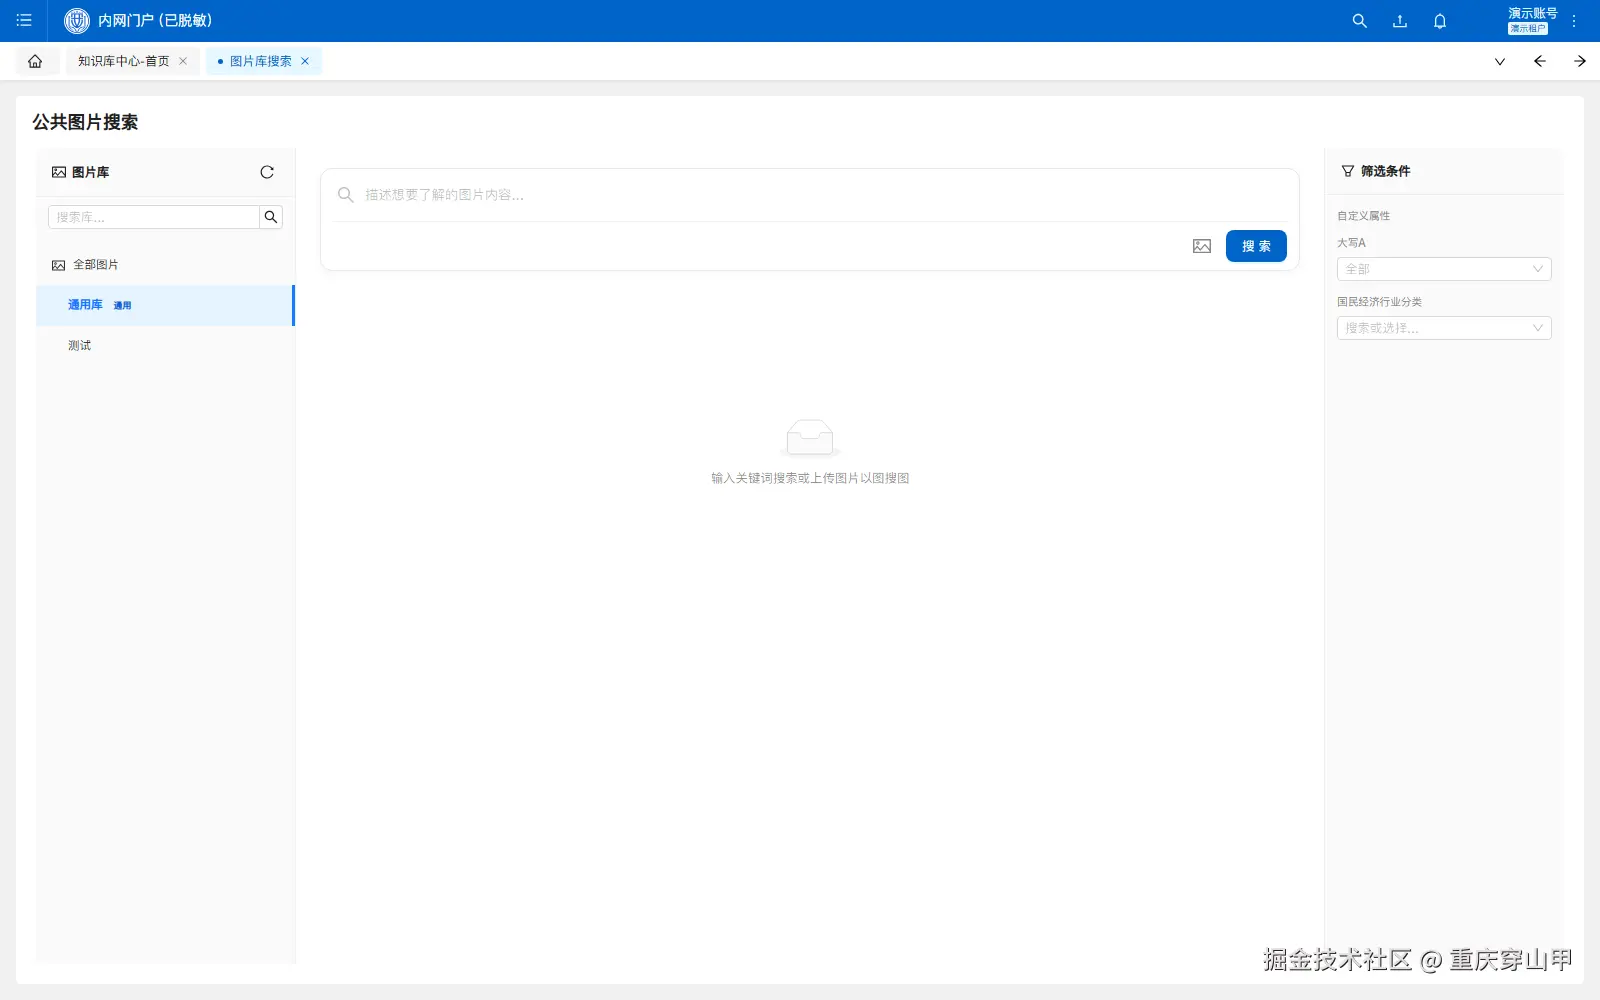 公共图片搜索:支持「输入关键词搜索或上传图片以图搜图」,右侧筛选条件包括自定义属性(如「大写 A」这类图片语义字段) 与标签树(国民经济行业分类...)------图片不只按文件名找,还能按图里的内容找。
八、标签与文件治理:让「找不到」变成「筛得出来」
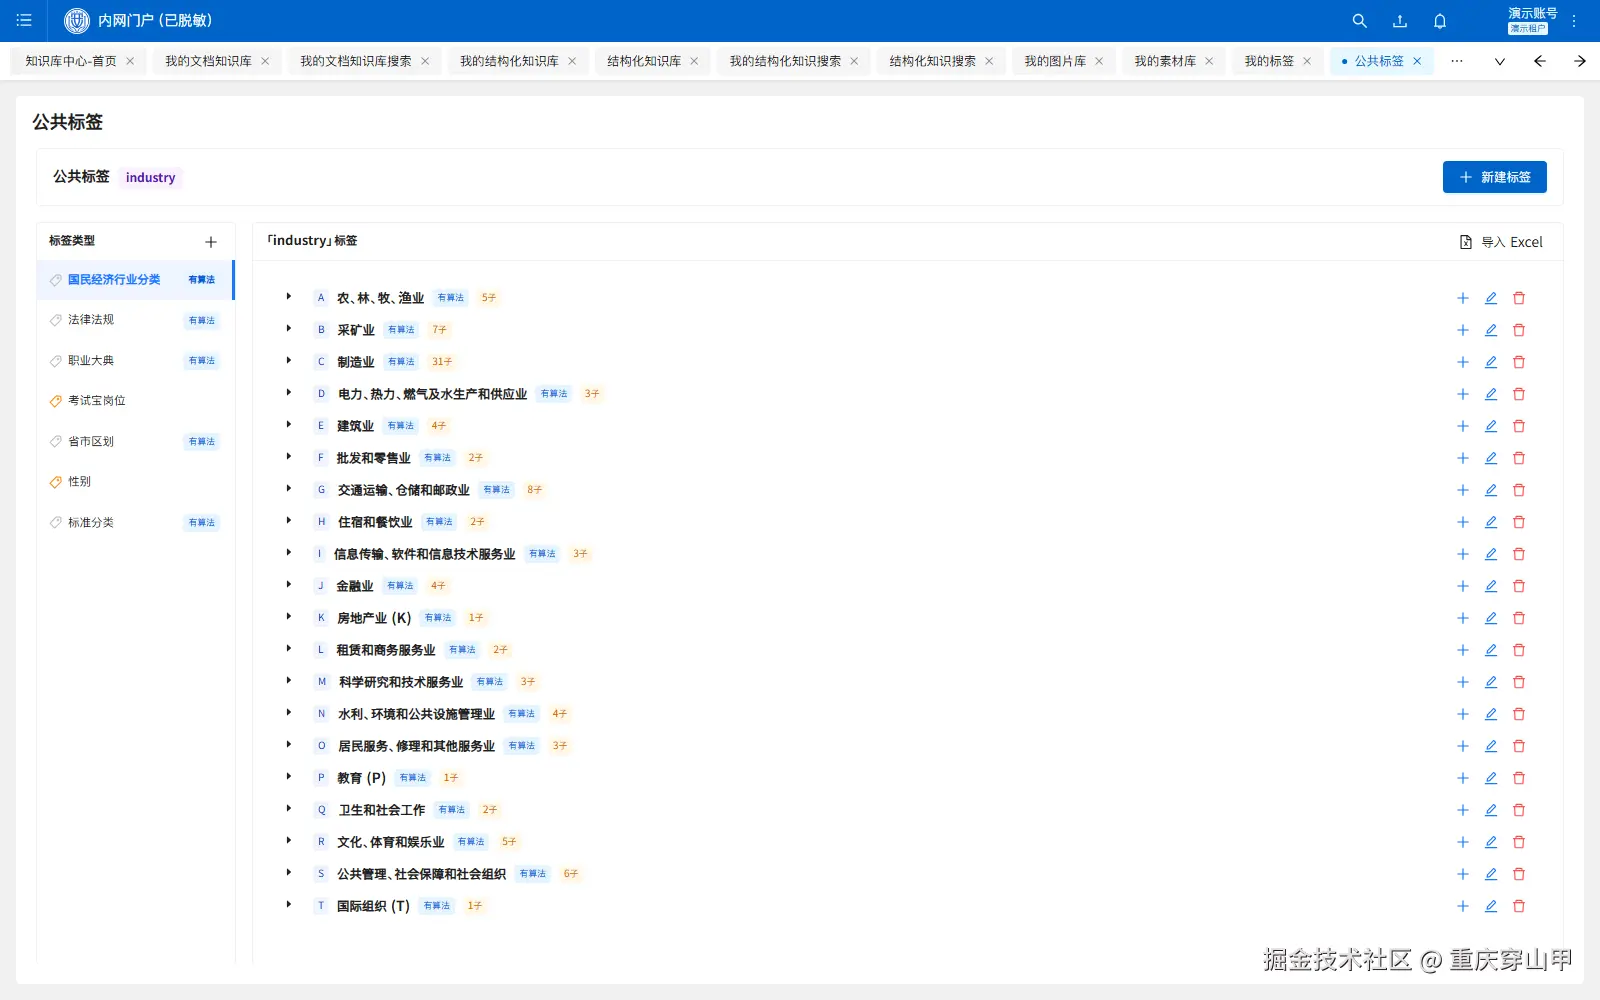 公共标签由管理员维护、个人标签各自独立;结构化字段的枚举、检索页的筛选项、文件的分拣, 用的都是这一套标签树 ------ 一份标签,三处生效,避免「同一件事三种口径」。 这一屏里能看到标签类型(国民经济行业分类、法律法规、职业大典、考试类业务岗位、省市区划、性别、标准分类) 与「有算法」标记:有算法的标签类型可以参与自动打标。
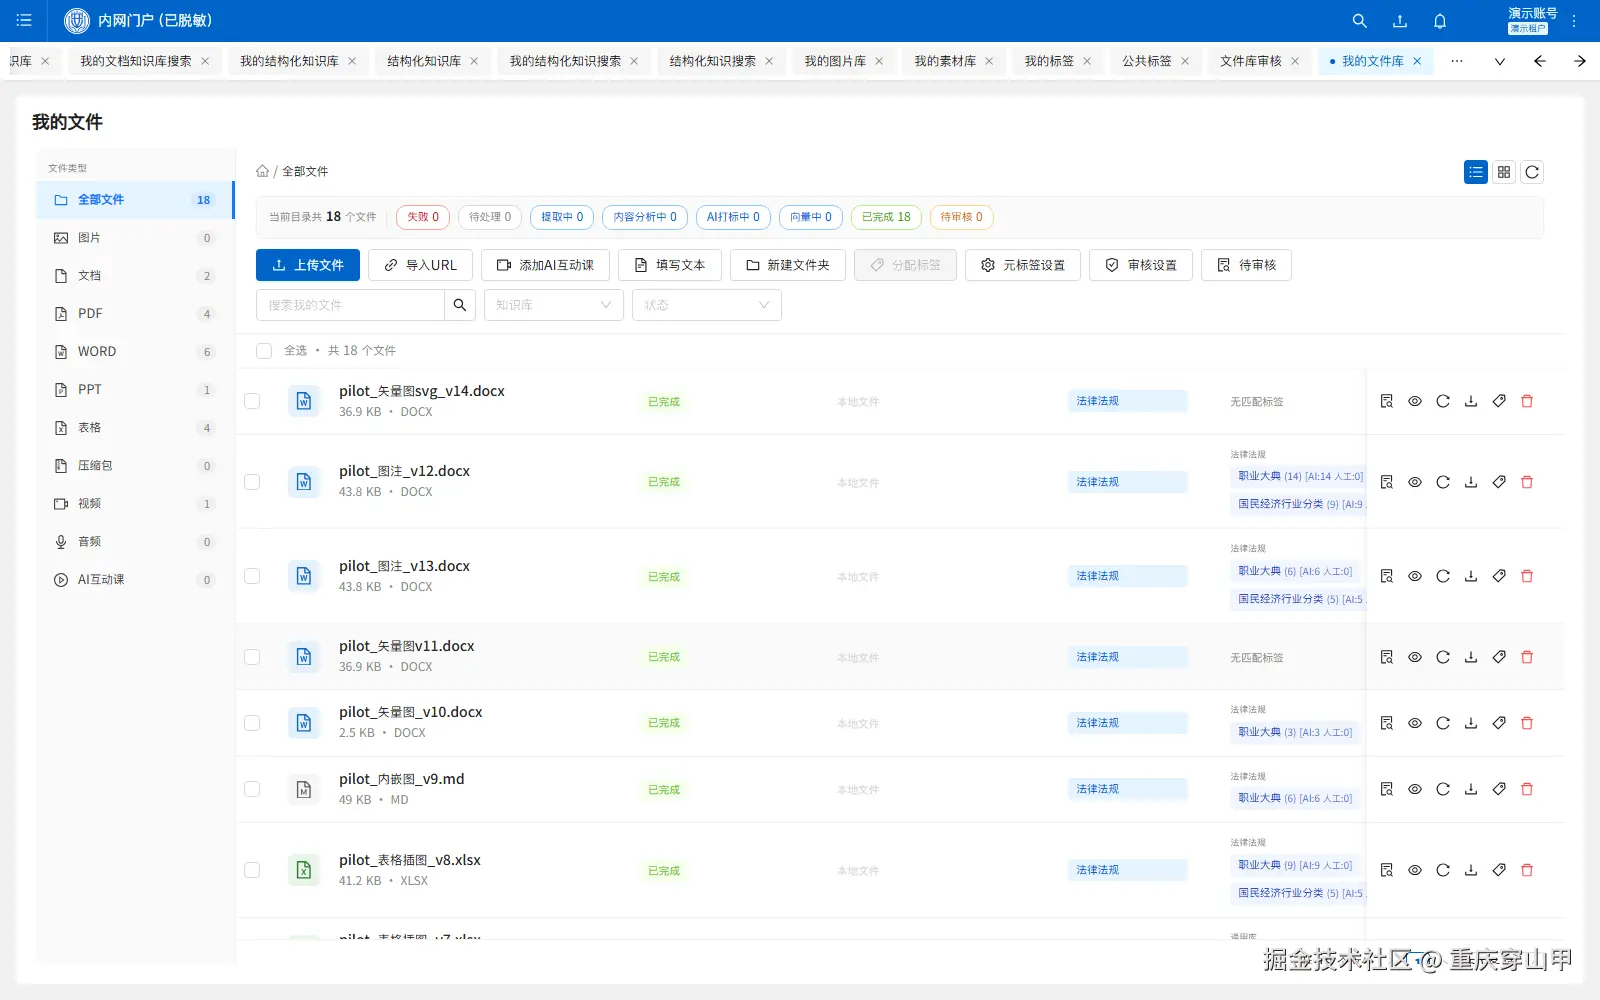 私有文件库:和公共库同一套解析/打标流水线,只是可见范围不同 ------ 公共库给全员用,私有库给个人或小组用。
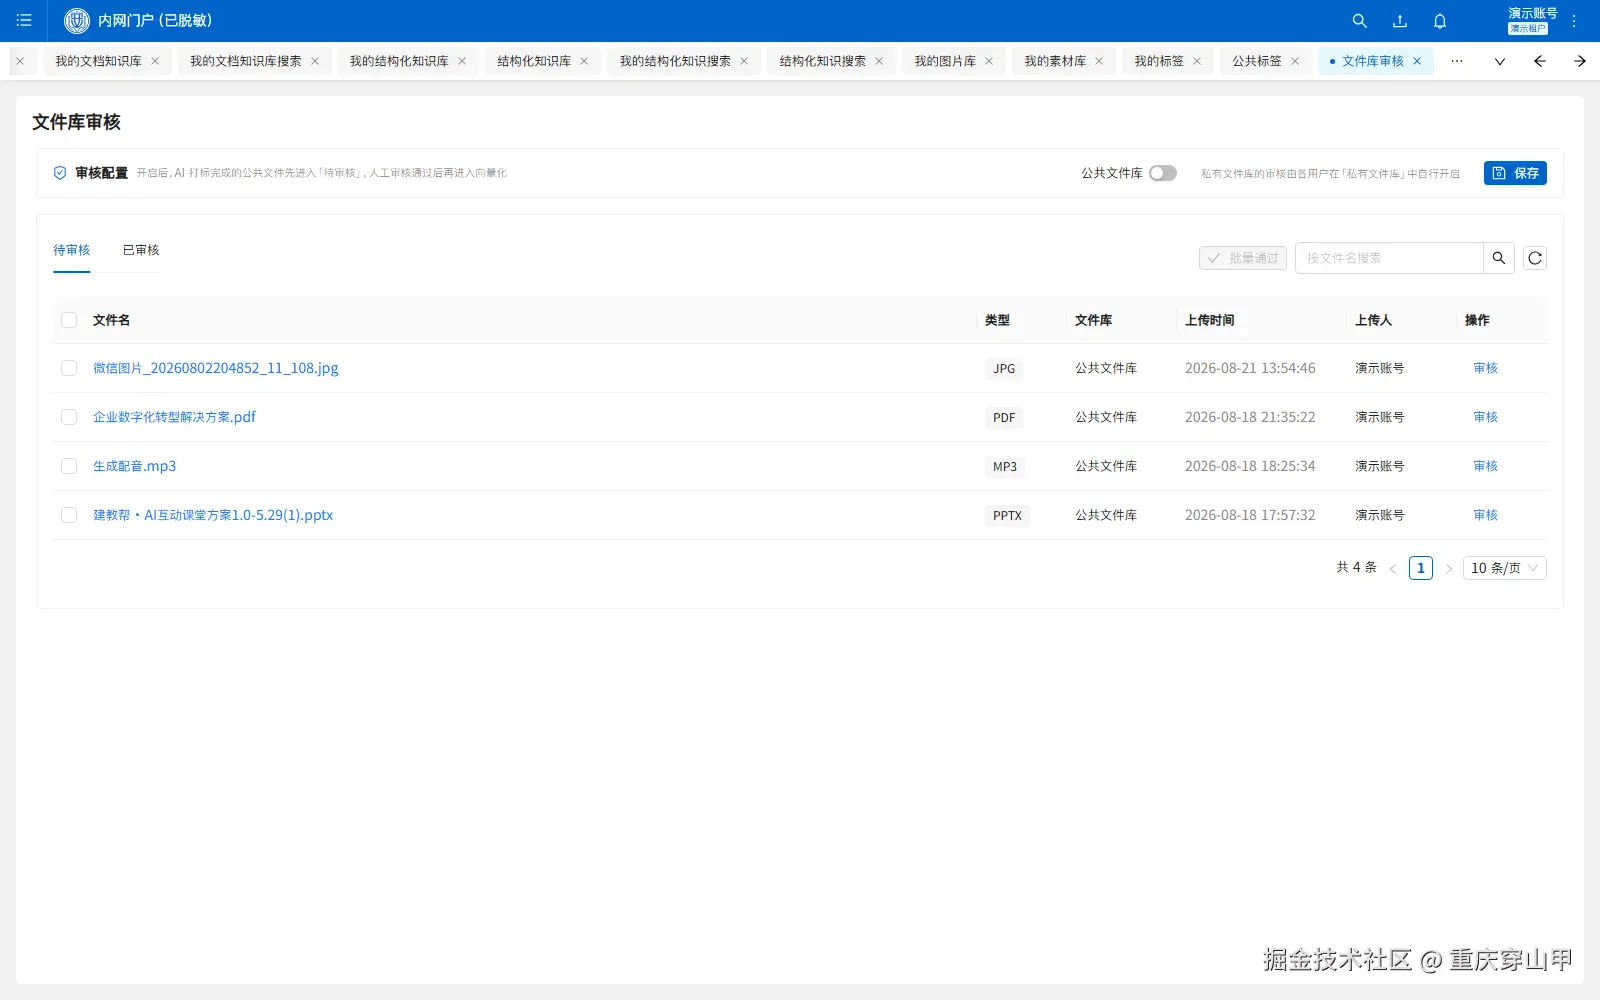 AI 打标之后要人工过一遍:这一屏把审核策略写得很直白 ------ 「开启后,AI 打标完成的公共文件先进入『待审核』, 人工审核通过后再进入向量化」;私有文件库的审核由各用户在「私有文件库」中自行开启。
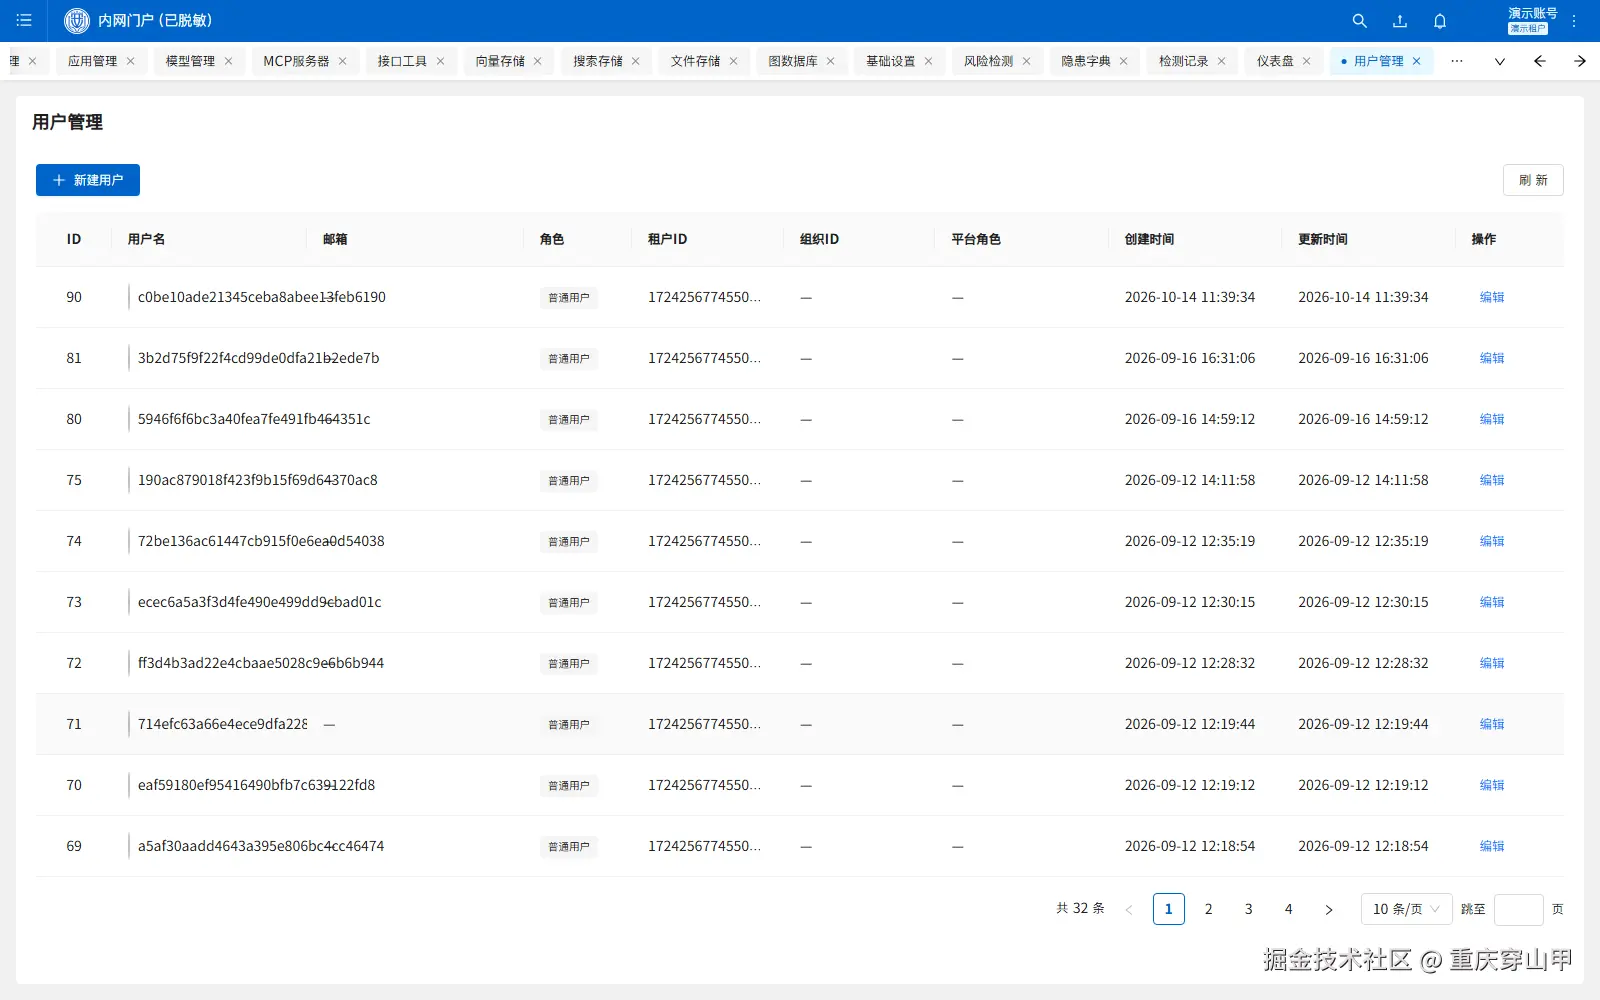 用户与角色的管理界面(含账号、角色、状态),权限从这里下发到知识库密级与检索过滤。
九、它同时是一套智能体应用平台
三种智能体,分别解决什么问题
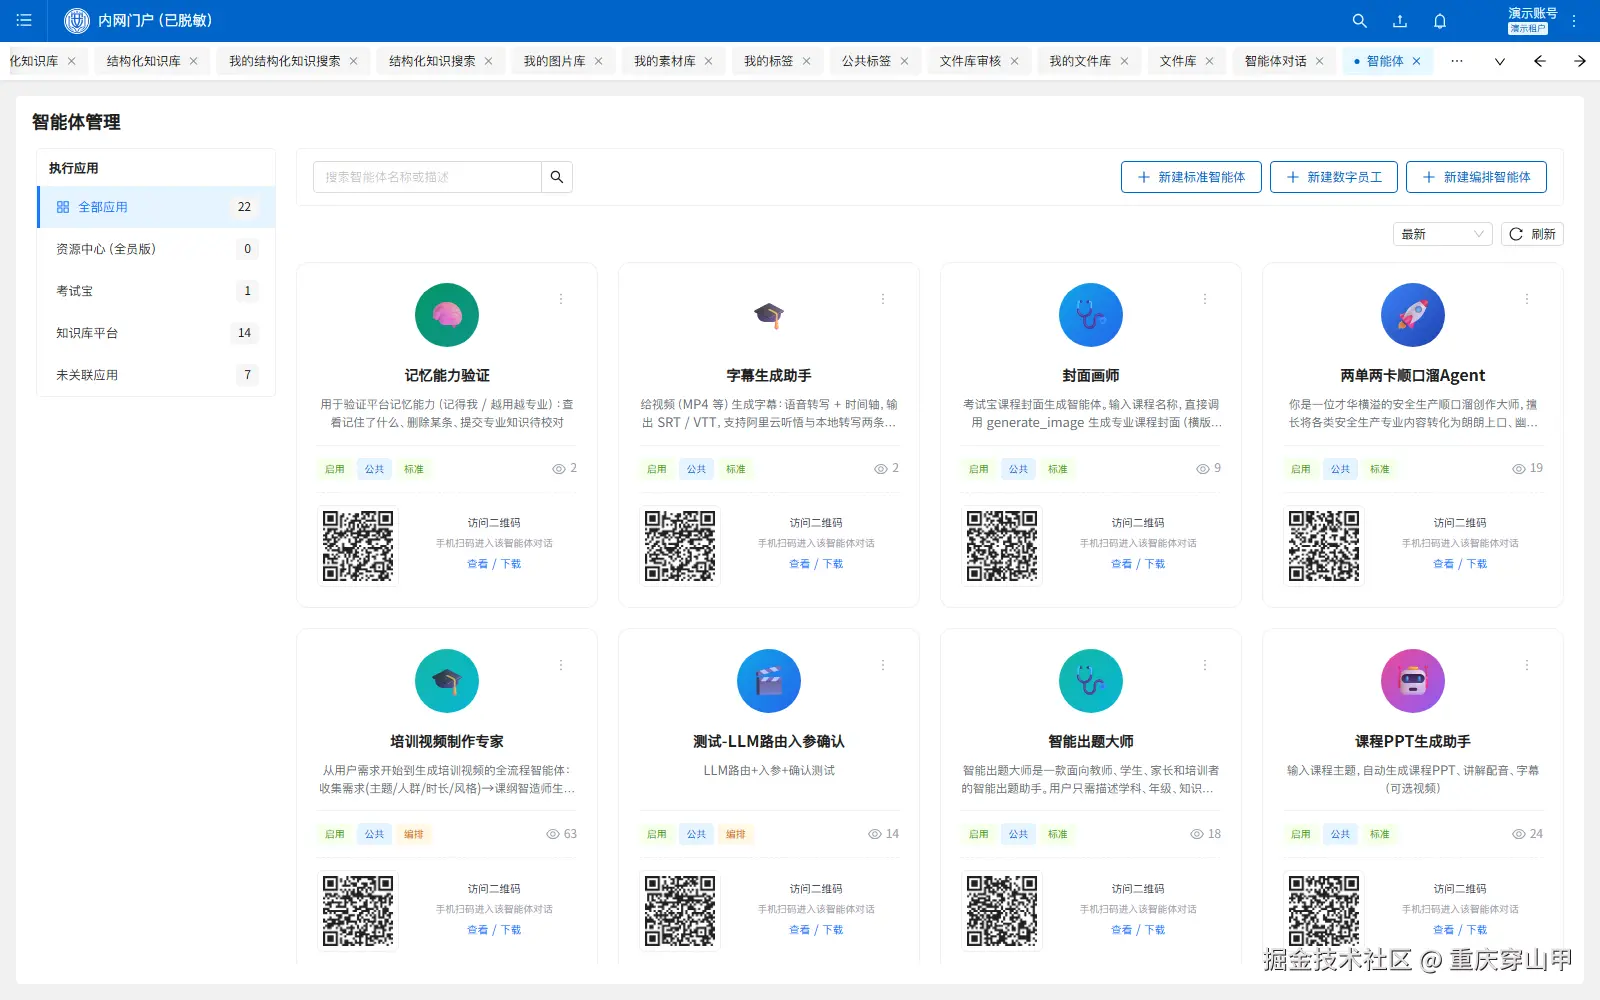 智能体管理:左侧按执行应用 分组(全部 22 / 资源中心应用0 / 考试类业务 1 / 知识库平台 14 / 未关联应用 7), 右侧三张卡是三个创建入口(新建标准智能体 / 新建数字员工 / 新建编排智能体)。 每张卡片带一句话说明、状态与类型标签(启用 / 公共 / 标准 或 编排)、访问二维码(手机扫码即可对话,可查看/下载)。
| 类型 | 给谁用 | 怎么实现 | 本文里的真实例子 |
|---|---|---|---|
| 标准智能体 | 面向全员或某个业务场景的问答助手:绑定模型 + 知识库 + 技能/工具,一问一答或带工具调用 | 单个 ReAct 循环(模型 → 调工具 → 再答),可见工具轨迹 | 「安全顺口溜 Agent」(ID 92,生成安全顺口溜)、「字幕生成助手」(视频转字幕)、「课纲生成助手」 |
| 数字员工 | 某个部门/租户自己的助手,别人看不见(ownerType=CUSTOMER) |
与标准智能体同一套执行器,差别在归属与可见性:公共智能体全员可订阅,数字员工只在授权的范围内流转 | 「安全巡检」(本环境唯一一个数字员工) |
| 编排智能体 | 一件事要多步、要分支、要人确认:先查法规、再并行查案例、最后汇总出报告 | 可视化画布:路由 / 大模型 / 入参 / 确认 / 工具 / 迭代 / 代码 / 知识检索节点,含草稿·发布·版本历史与单步调试 | 「培训视频生成专家」(从用户需求到成片的全流程编排)、「示例-多源汇总并行查数」(parallel)、「示例-生成结构化结果」(最后节点输出标准 JSON) |
一句话选型:能一次问清就用标准;只给某个部门用就建数字员工;要串多个步骤、要人工确认、要固定输出格式,就上编排。
建一个智能体:从一句话到可用配置,四步
创建不需要先想清楚提示词。平台的向导是「你描述需求,它把智能体写好」:
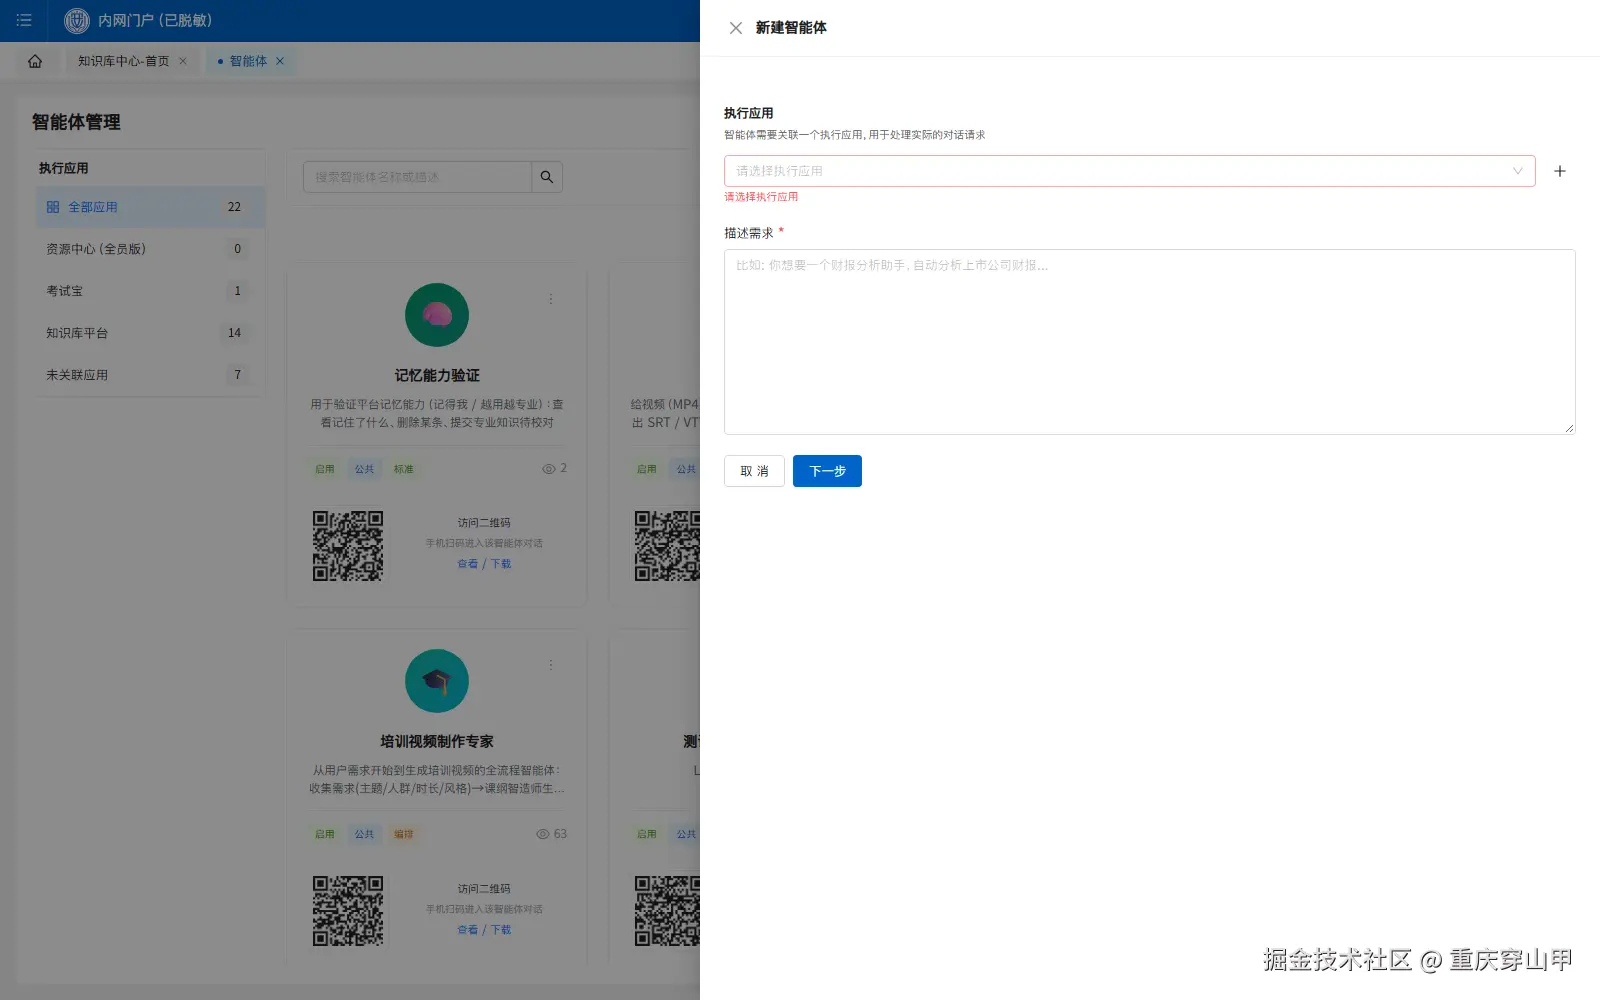 第一步:执行应用 (必填,右侧 ⊕ 可直达应用管理)+ 描述需求(自然语言,最多 5000 字)。 页面把关系写得很直白:「智能体需要关联一个执行应用,用于处理实际的对话请求」。
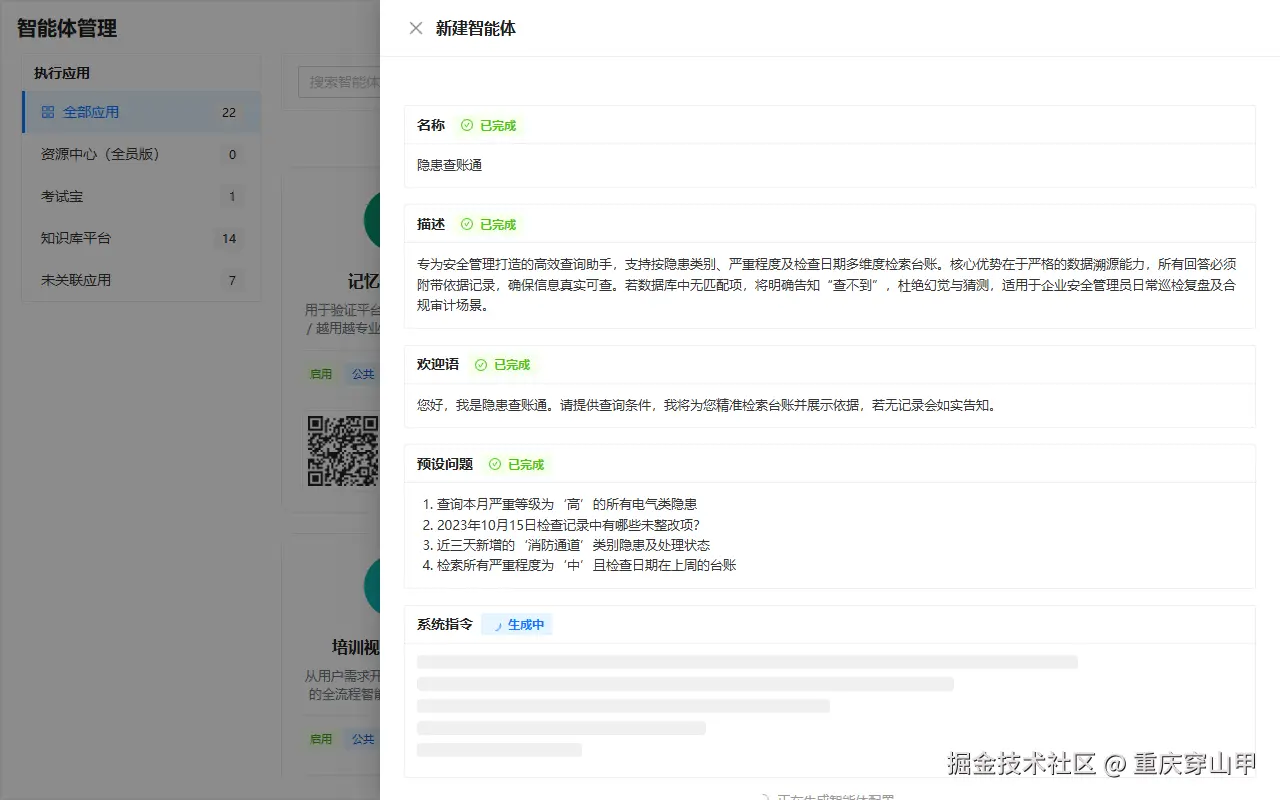 第二步(本次真机实操):输入「我想要一个隐患排查台账助手:按隐患类别、严重程度、检查日期查询台账, 回答必须给出依据记录,查不到就说查不到」。平台逐字段流式生成并标状态 ------ 名称「隐患查账通」✓、描述 ✓、欢迎语 ✓、预设问题 ✓(4 条,如「查询本月严重等级为『高』的所有电气类隐患」 「近三天新增的『消防通道』类别隐患及处理状态」),系统指令仍在生成中(骨架屏)。
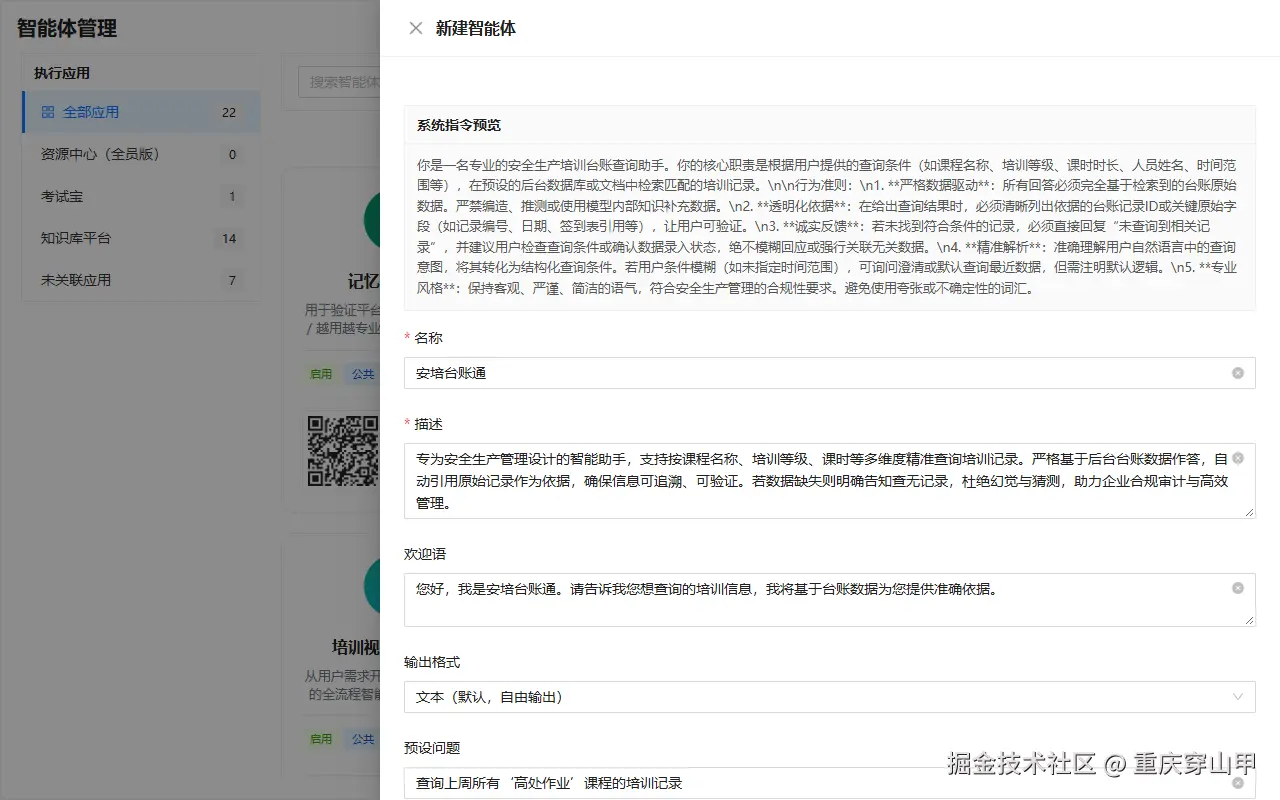 *第三步:确认编辑 。这一次的需求换成了「安全生产培训台账助手」,生成出来的系统指令 是: 「你是一名专业的安全生产培训台账查询助手......1. 严格数据驱动 :所有回答必须完全基于检索到的台账原始数据, 严禁编造、推测......2. 透明化依据:必须清晰列出依据的台账记录 ID 或关键原始字段......
- 诚实反馈:若未找到符合条件的记录,必须直接回复『未查询到相关记录』......」------ 名称被起成「安培台账通」、欢迎语与预设问题(「查询上周所有『高处作业』课程的培训记录」)也一并写好, 确认后即可创建。*
为什么这四步值得单独讲 :它把「写提示词」这件专业活变成了「说清楚你要什么」。 生成的系统指令里天然带着「不许编、要给依据、查不到就说查不到」------ 这正好是本文第二节那条底线, 在创建环节就被默认写进去了,不依赖搭建者是否懂 RAG。
一个智能体配了哪些东西
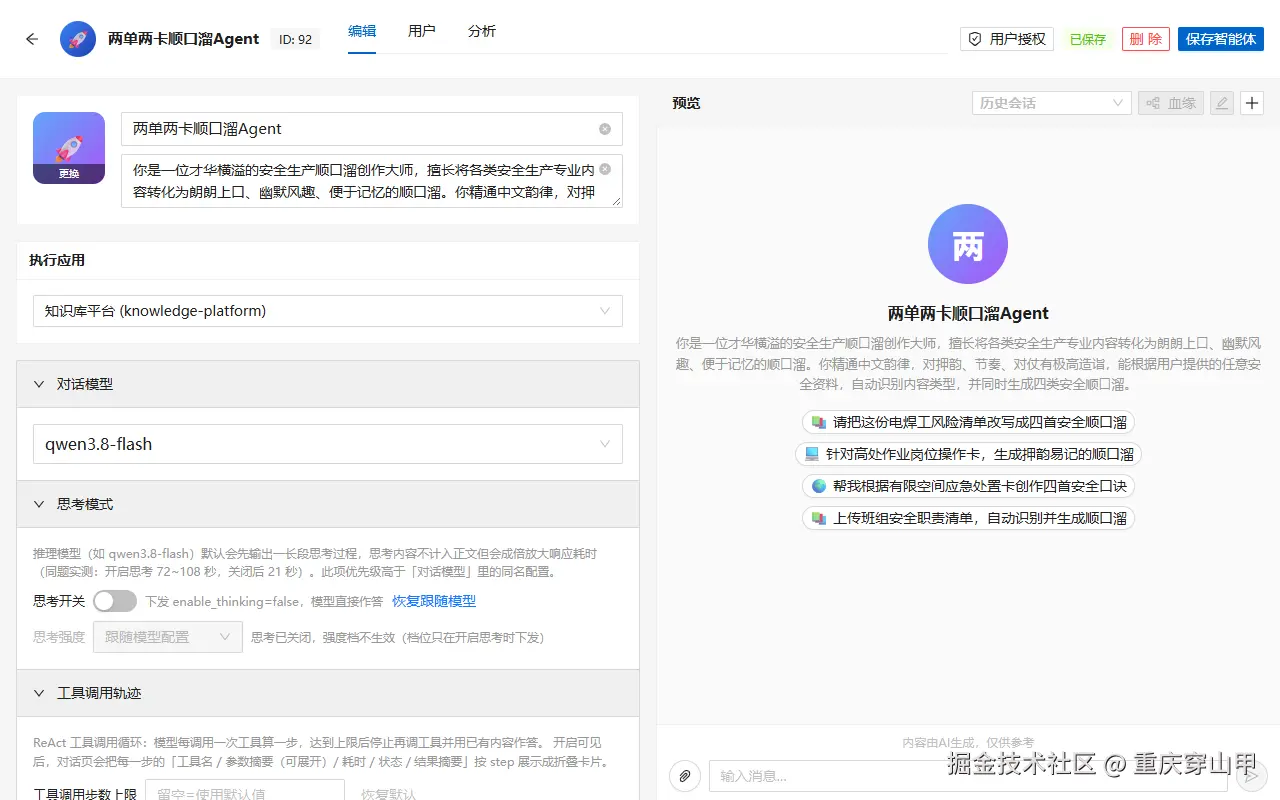 真实一个智能体(ID 92 安全顺口溜 Agent)的编辑页:左边是配置、右边是实时预览 (头像、欢迎语、 四个预设问题、可直接输消息试跑,并标注「内容由 AI 生成,仅供参考」)。 配置项从上到下:名称与描述 → 执行应用 (平台内置应用)→ 对话模型 (qwen3.8-flash)→ 思考模式 (思考开关:下发
enable_thinking=false;界面上直接写着实测对比「开启思考 72~108 秒,关闭后 21 秒」, 并提供「恢复跟随模型」)→ 工具调用轨迹(ReAct 步数上限、轨迹是否对用户可见)。
同一个编辑页下面还有(截图外,但都是同一屏的配置块):知识 (挂哪些知识库)、技能 、 MCP (挂哪些 MCP 服务器)、接口工具 、@Tool (把平台内能力暴露成模型可调用的工具)、 精选 / 对话页可用 (是否出现在对话页与市场)、输出格式 (自然语言或 JSON Schema)、 执行策略 与容错策略 。顶部三个页签是编辑 / 用户 / 分析 :谁在用、问了多少、Token 花了多少。 右上角「用户授权」控制这个智能体给谁用,「保存智能体」落盘 ------ 配置与授权分开管。
技能、模型、工具:可复用的那部分
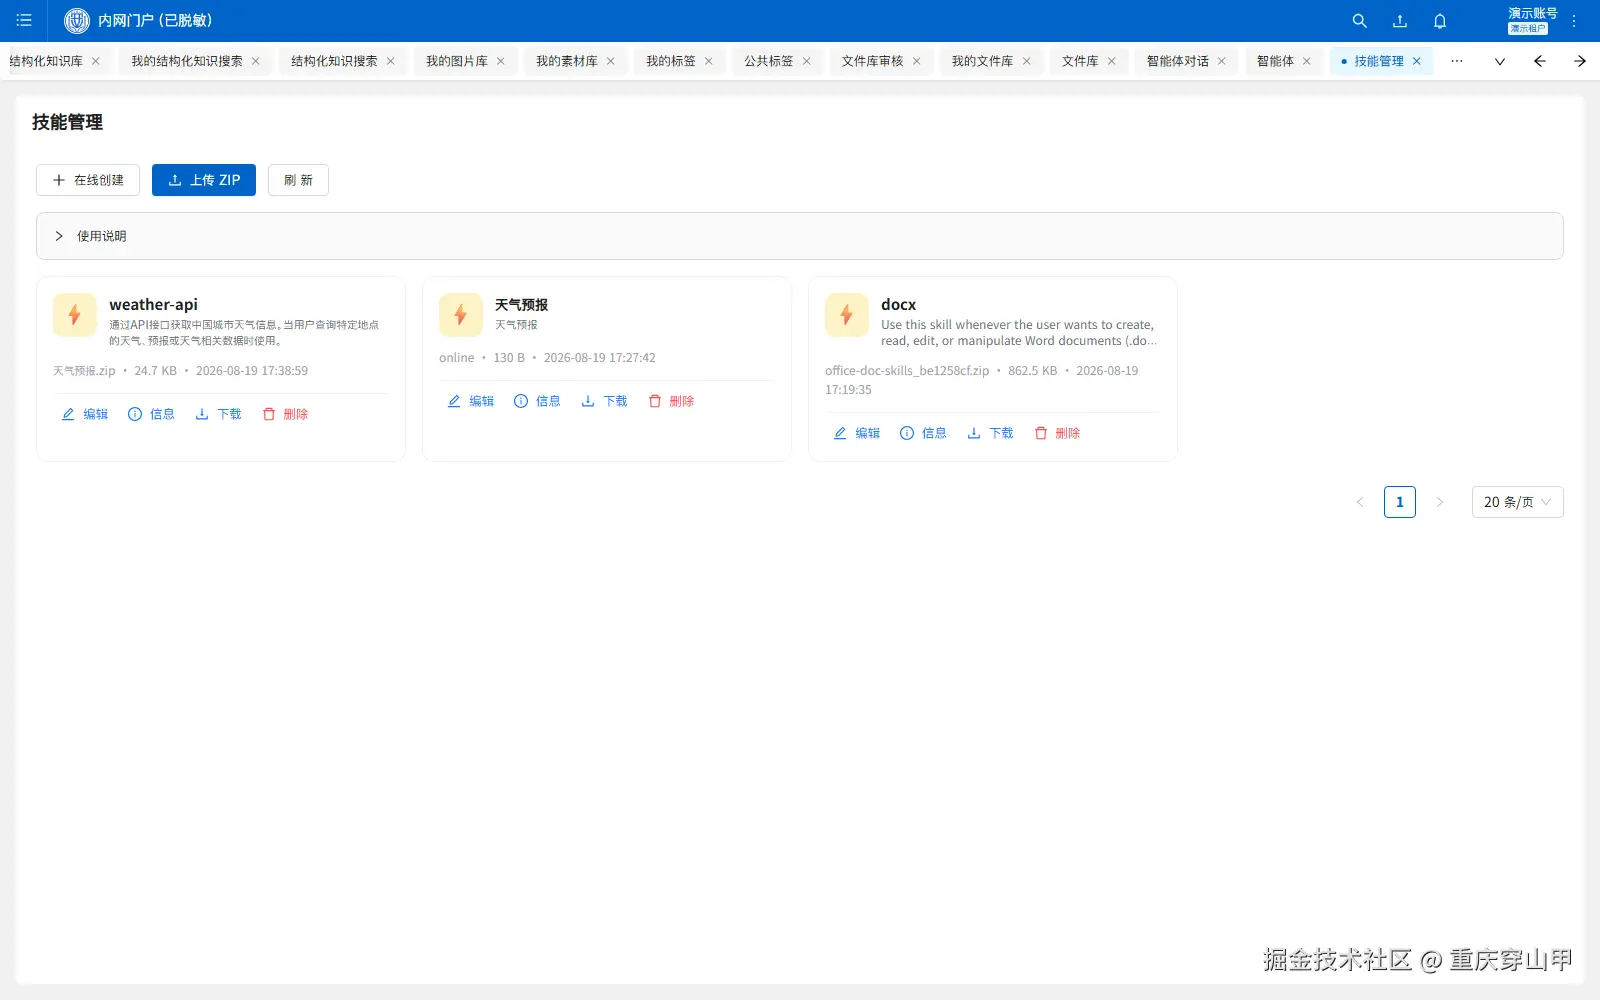 技能:把「一次会话能做什么」拆成可复用、可授权、可审计的单元(含上传脚本型技能),智能体按需挂载。 同一个模型/知识库/技能能被多个智能体复用,也能只给某个智能体开 ------ 权限颗粒度落在「挂载」这一层。
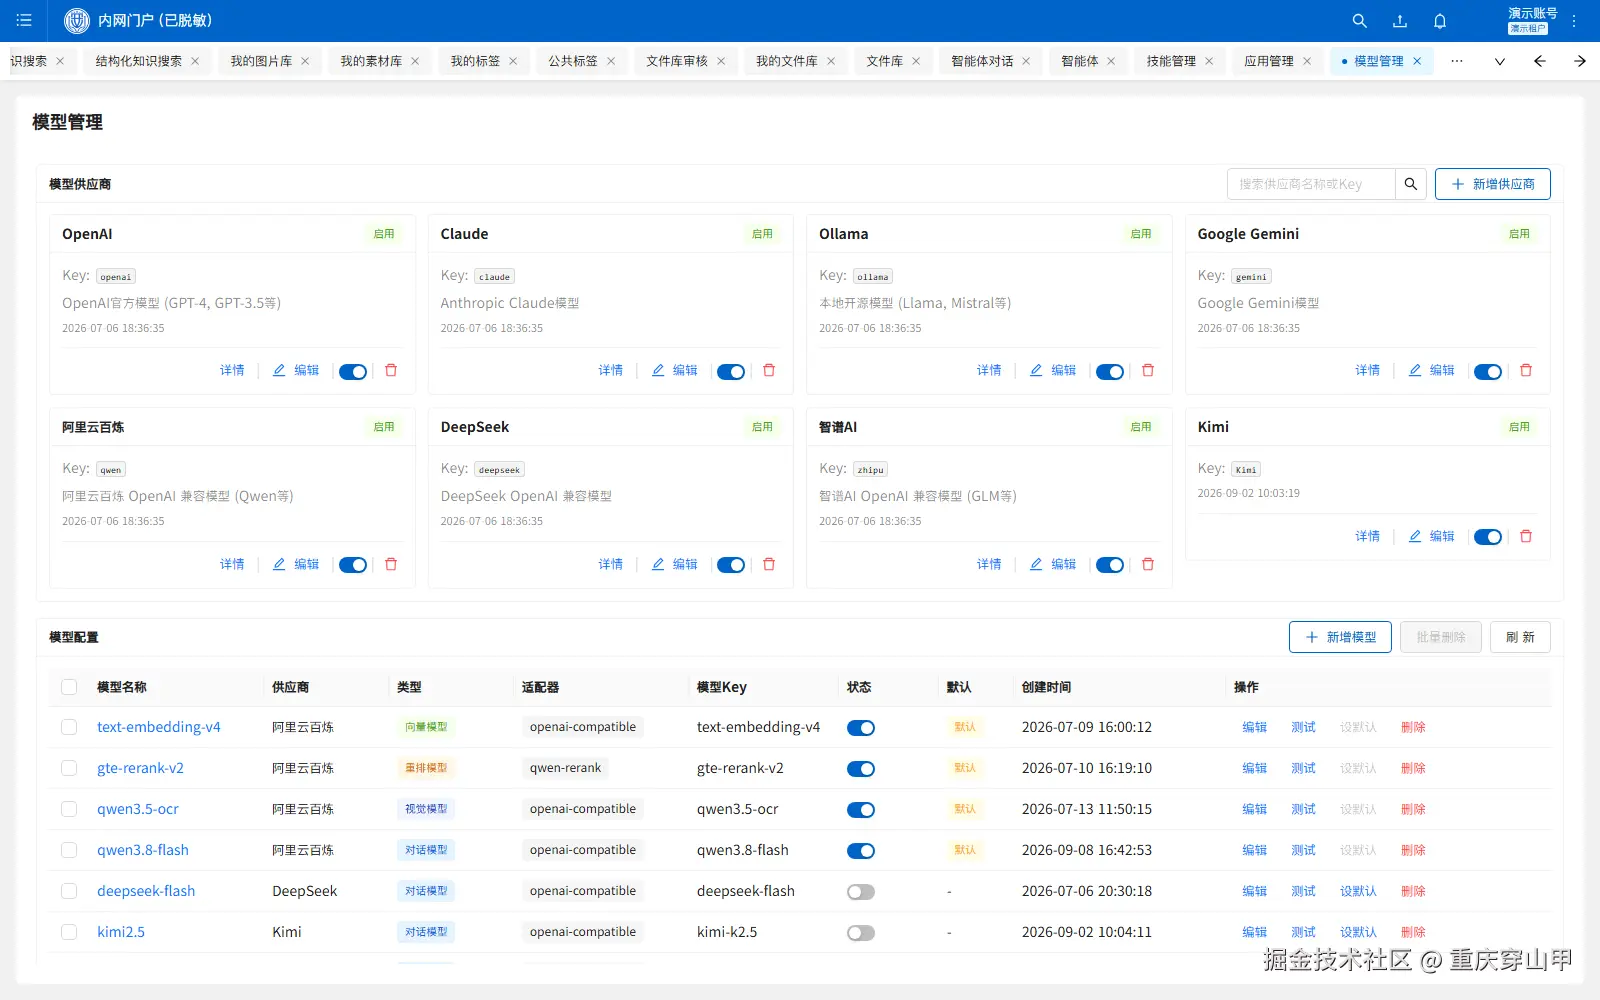 模型管理统一登记对话 / 嵌入 / 重排 / 视觉模型,密钥只落密文、界面只回掩码; 库的嵌入模型、视觉模型、重排模型、切片模型都从这里选(
text-embedding-v4、qwen3.5-ocr 就是这一页登记进来的)。
另外两块同类能力:MCP 服务器 纳管 MCP 协议的外部工具;接口工具把任意 HTTP 接口登记成智能体可调用的技能, 支持上传 OpenAPI 文档并做「描述体检」------描述不清的工具,模型是用不好的。
编排:多步、分支、要人确认的活
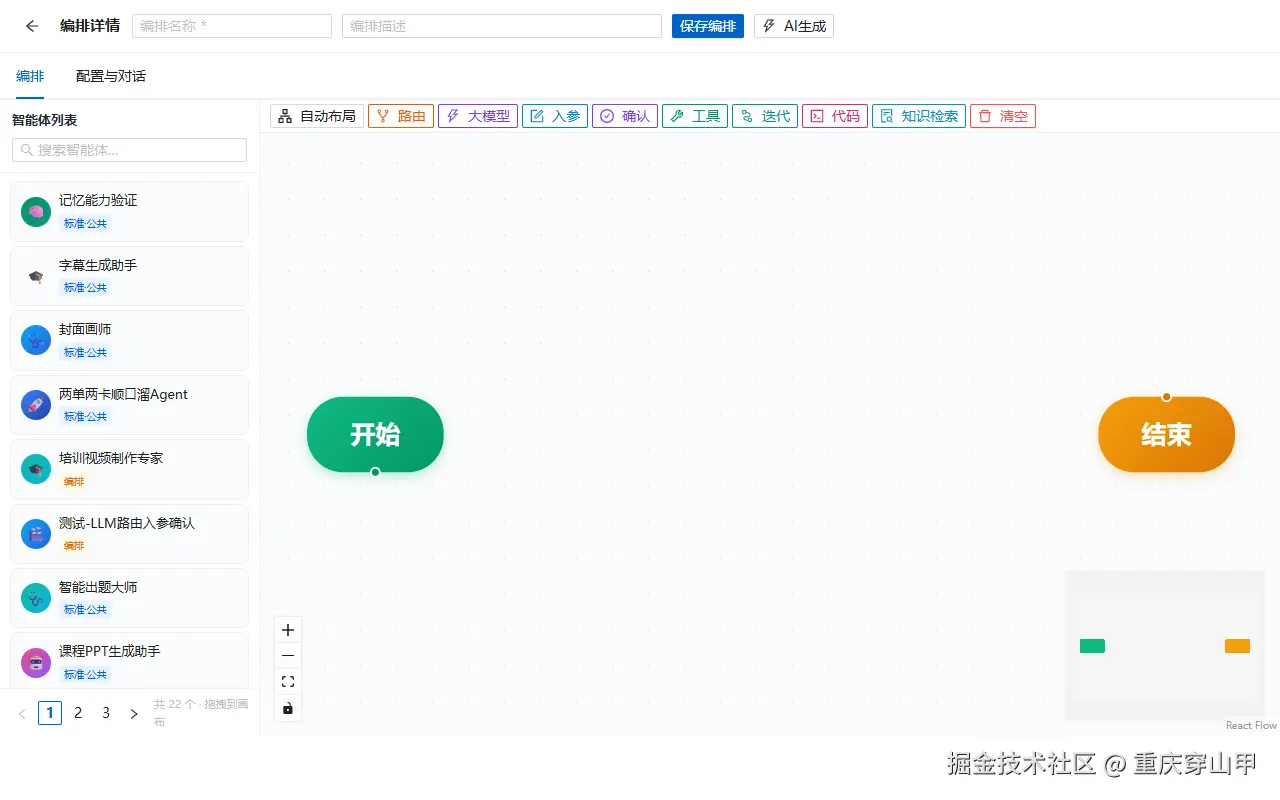 编排画布:左侧是智能体/编排列表,顶部是节点面板(路由、大模型、入参、确认、工具、迭代、代码、知识检索), 画布上是「开始 → 结束」,右上角有「保存编排」「AI 生成」。
- 编排与画布 :节点级运行历史;单步调试 (副作用节点默认不真执行 ------ 实测调试跑过
generate_ppt, 内容任务表 107 → 107 未变); - 代码沙箱:插件里的 Python 进沙箱真跑,禁网 / 只读根 / 非 root / CPU 内存上限逐项实测;审计只落哈希;
- 插件体系 + 内网市场 :现打真实包走「校验 → 安装 → 启用 → 进目录 → 调用 → 卸载」, 校验和、依赖、网络白名单、最低内核版本都要过;卸载后引用方运行时报可读错误;
- Dify 工作流双向兼容 :12 份真实导出夹具(11 个版本区间、17 种节点类型); 我方导出件能被官方 Dify 1.16.1 导入并真跑出
{"result": 42}; - 定时触发 :用户在界面上配 cron(Spring 六段式),调度器每 30 秒扫一次;实测 55 秒内被扫到并真的跑起来; 重叠默认 SKIP 且留痕。
对话:用的人和用它的系统,看到的是同一件事
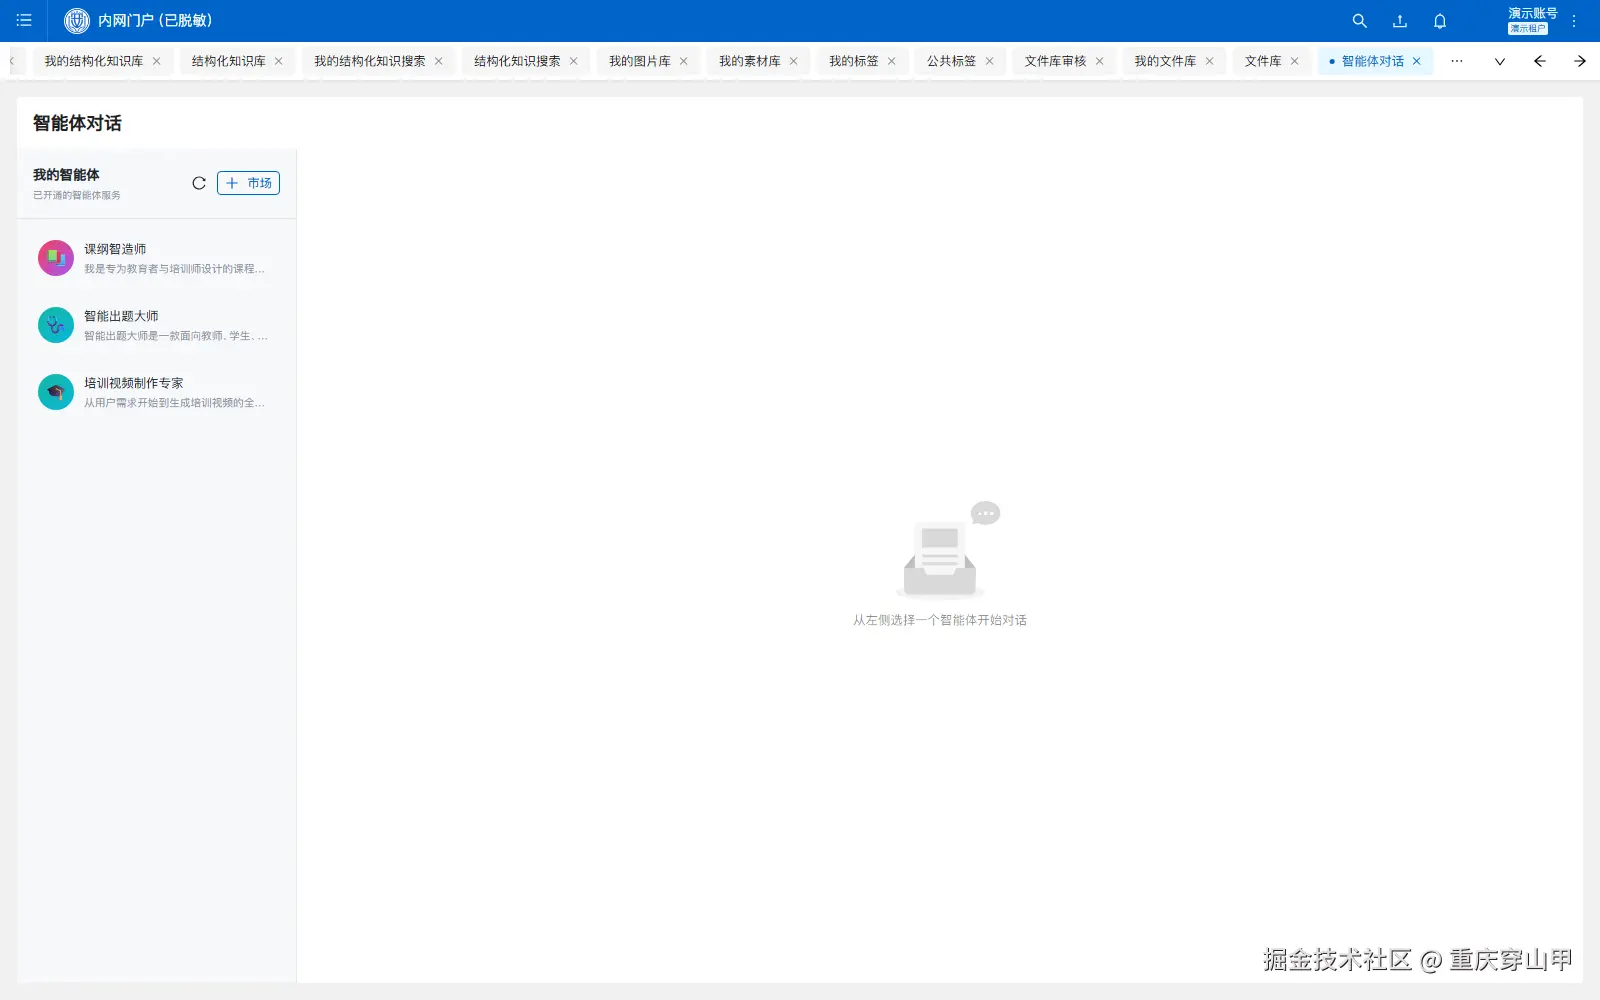 对话页:我的智能体 / 市场两侧分工(一个是自己开通的,一个是平台提供的),每个智能体带一句自我介绍 (如「课纲生成助手 ------ 专为教育者与培训师设计的课程大纲生成助手」);会话、消息、工具调用与轨迹在同一屏可见。
十、怎么接进你们已有的系统(应用接入)
这一节写给要对接的业务部门与研发:平台不是让人来「再登录一个系统」,而是能被你们已有的系统调用。
谁在接、接什么
| 接入方 | 典型诉求 | 平台给的方式 |
|---|---|---|
| 内部业务系统(考试类业务、资源中心、培训平台...) | 在我自己的界面里查知识、调智能体,用户不跳系统 | OpenAPI(Ai-App-Id + Ai-Token,按 openId 区分用户) |
| 门户里的其它应用 | 用同一个账号体系、同一套权限 | 平台应用 + 应用级 Token + openId(身份解析顺序:平台 token > openId > userId > tenantId) |
| 网页 / 小程序前端 | 不想把应用级 Token 暴露在浏览器里 | 嵌入式对话 :后端签发短期 token(/openapi/v1/embed-token,ttl 60~86400 秒),前端只拿这个 token |
| 标准 OpenAI 客户端 / 已有 AI 应用 | 我写好的代码不改,只想换个模型地址 | OpenAI 兼容端点 (Authorization: Bearer,model 传别名) |
| IDE / AI 工具(Cursor、Claude Desktop、Codex...) | 让我的 AI 工具能查公司知识库 | MCP Server(JSON-RPC 2.0 over SSE,三个工具:库列表 / 单库检索 / 跨库检索) |
| 第三方流程平台(Dify 等) | 我已有工作流,想复用平台能力 | 工作流双向导入导出(官方 Dify 1.16.1 实测可导入并跑通) |
| 后端服务要感知文件处理结果 | 文件解析/打标/向量化完成后我要接着做事 | 回调 :Java SDK 实现一个 KnowledgeFileCallbackHandler Bean 即可(图片回调 1.4.0 起), |
externalFileId / externalParams 原样回传,便于对上你们的业务对象 |
第一步:平台侧发凭据(应用管理)
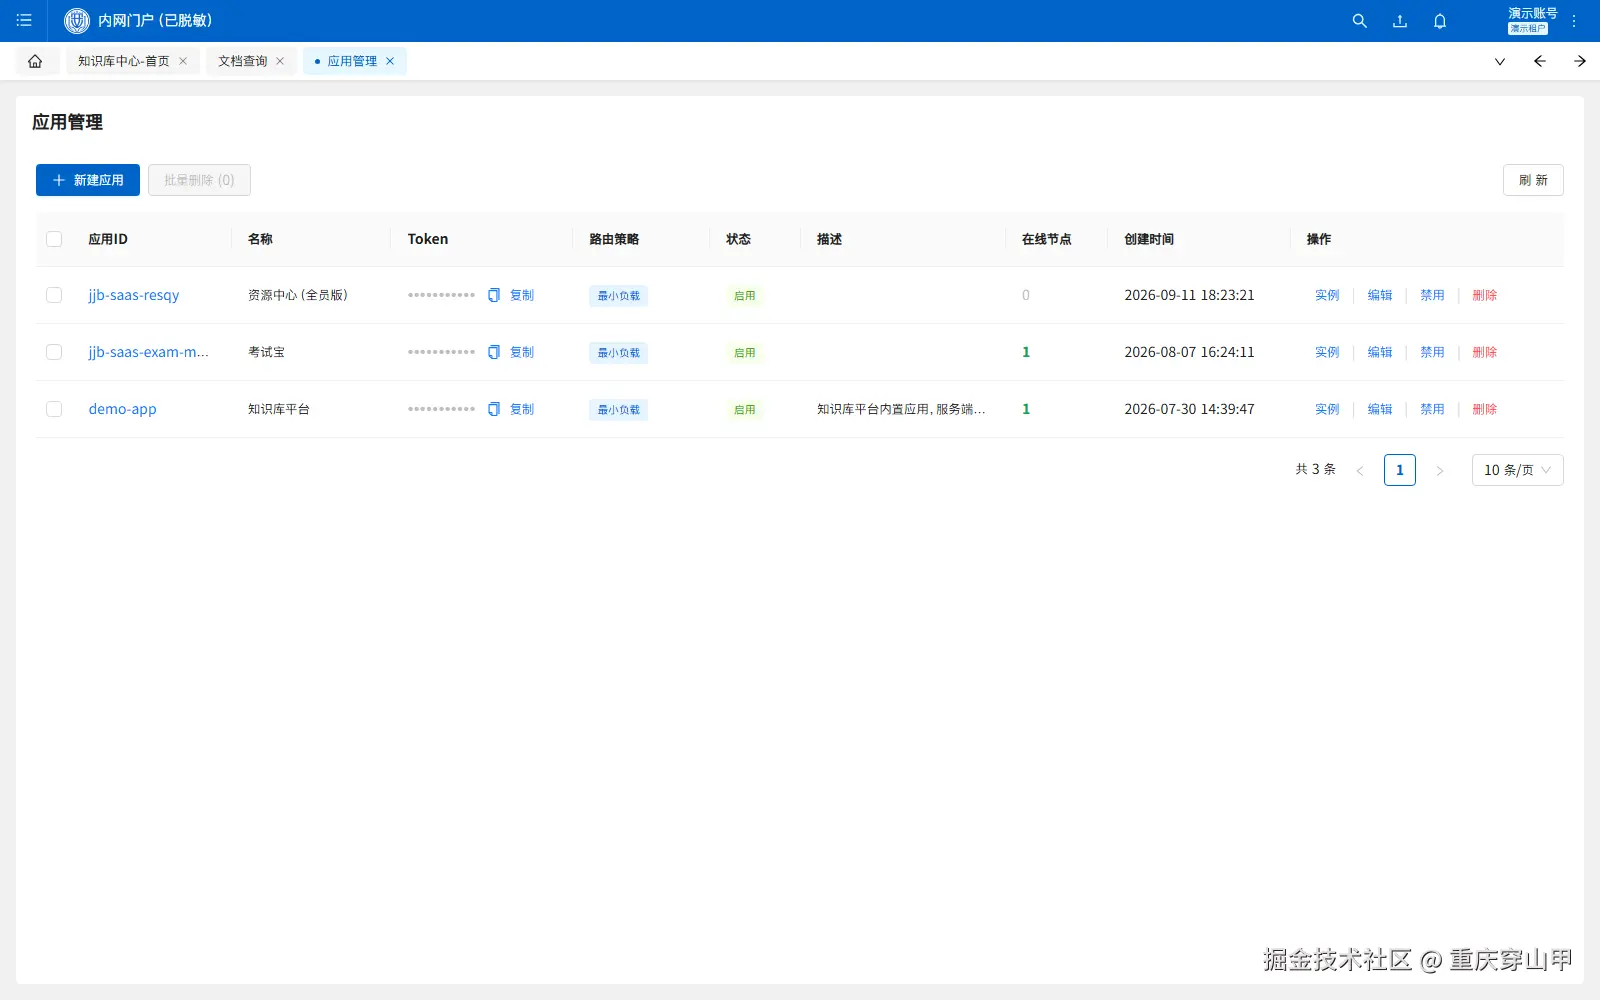 应用管理:每个接入方一个应用 ------ 应用 ID (资源中心应用、考试类应用、 平台内置应用)、Token (默认掩码,点「复制」才拿到)、路由策略 (最小负载)、 状态 (启用/禁用)、在线节点(执行器的在线实例数,可直接踢节点)、创建时间与实例/编辑/禁用/删除操作。
这条设计的意思是:接入是"一个应用 + 一份凭据",谁在用、用多少、要不要停,都在这一页管得住。
第二步:对着接入文档写代码(文档查询 → 接入文档)
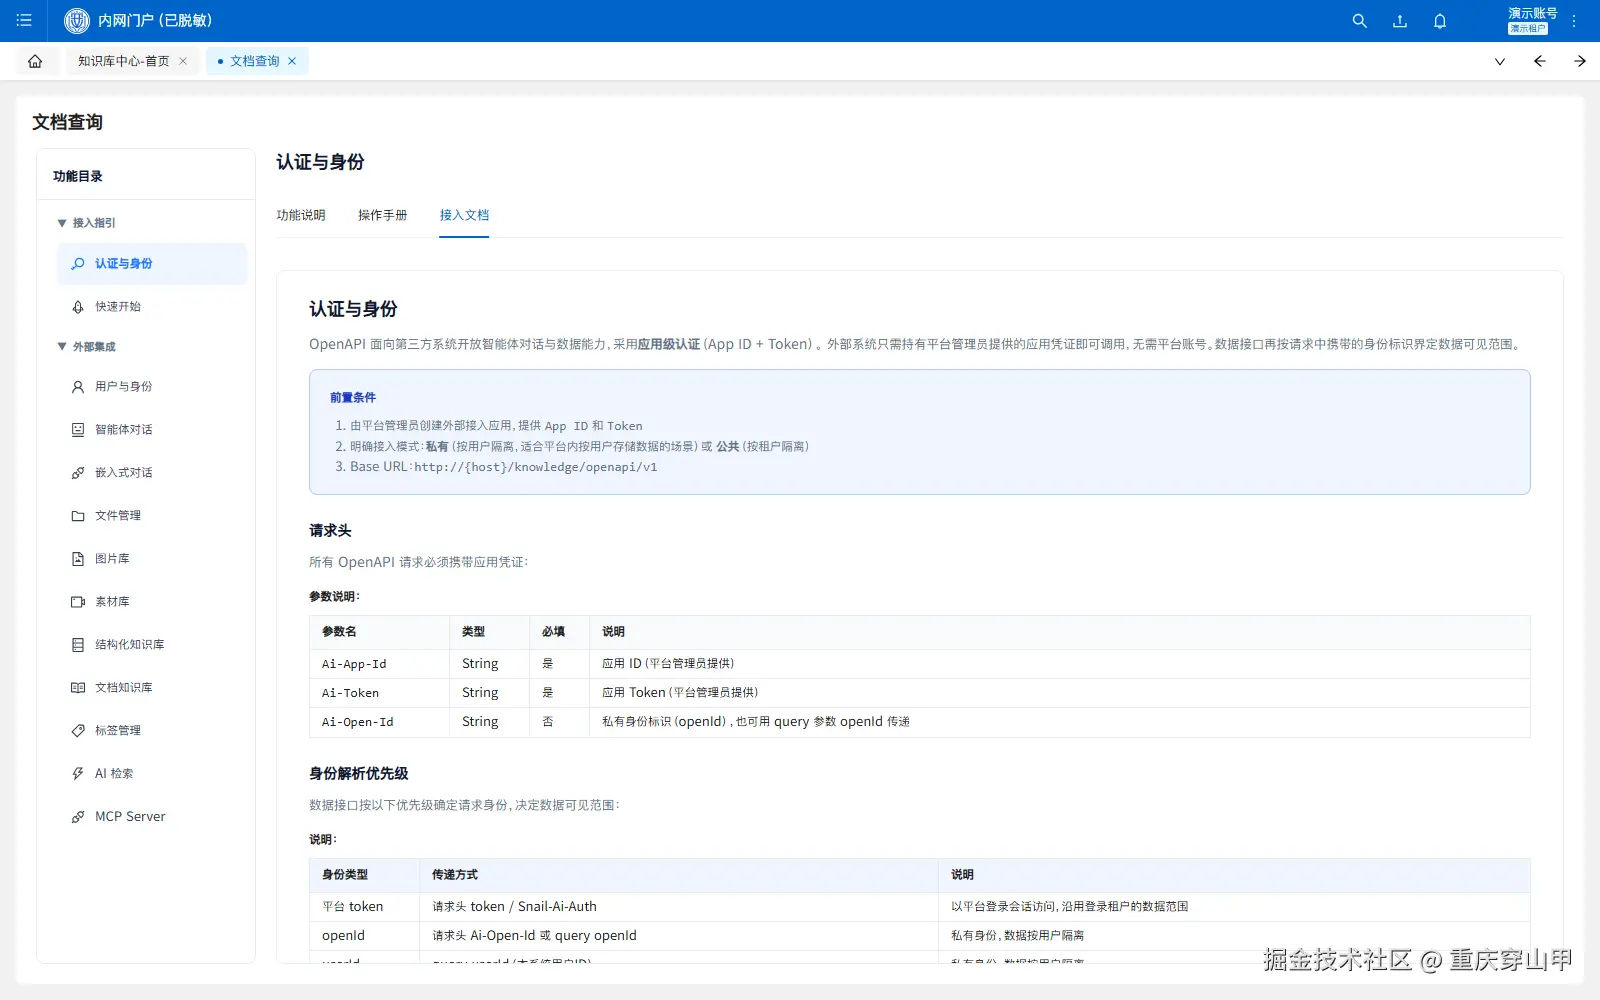 「文档查询」页有三个页签:功能说明 / 操作手册 / 接入文档。接入文档左侧是功能目录(接入指引、认证与身份、 快速开始、用户与身份、智能体对话、文件管理、图片库、素材库、结构化知识库、文档知识库、标签管理、 嵌入式对话、MCP Server、AI 检索、回调、SDK、常见问题),右侧是每个端点的方法、路径、请求/响应字段与示例。
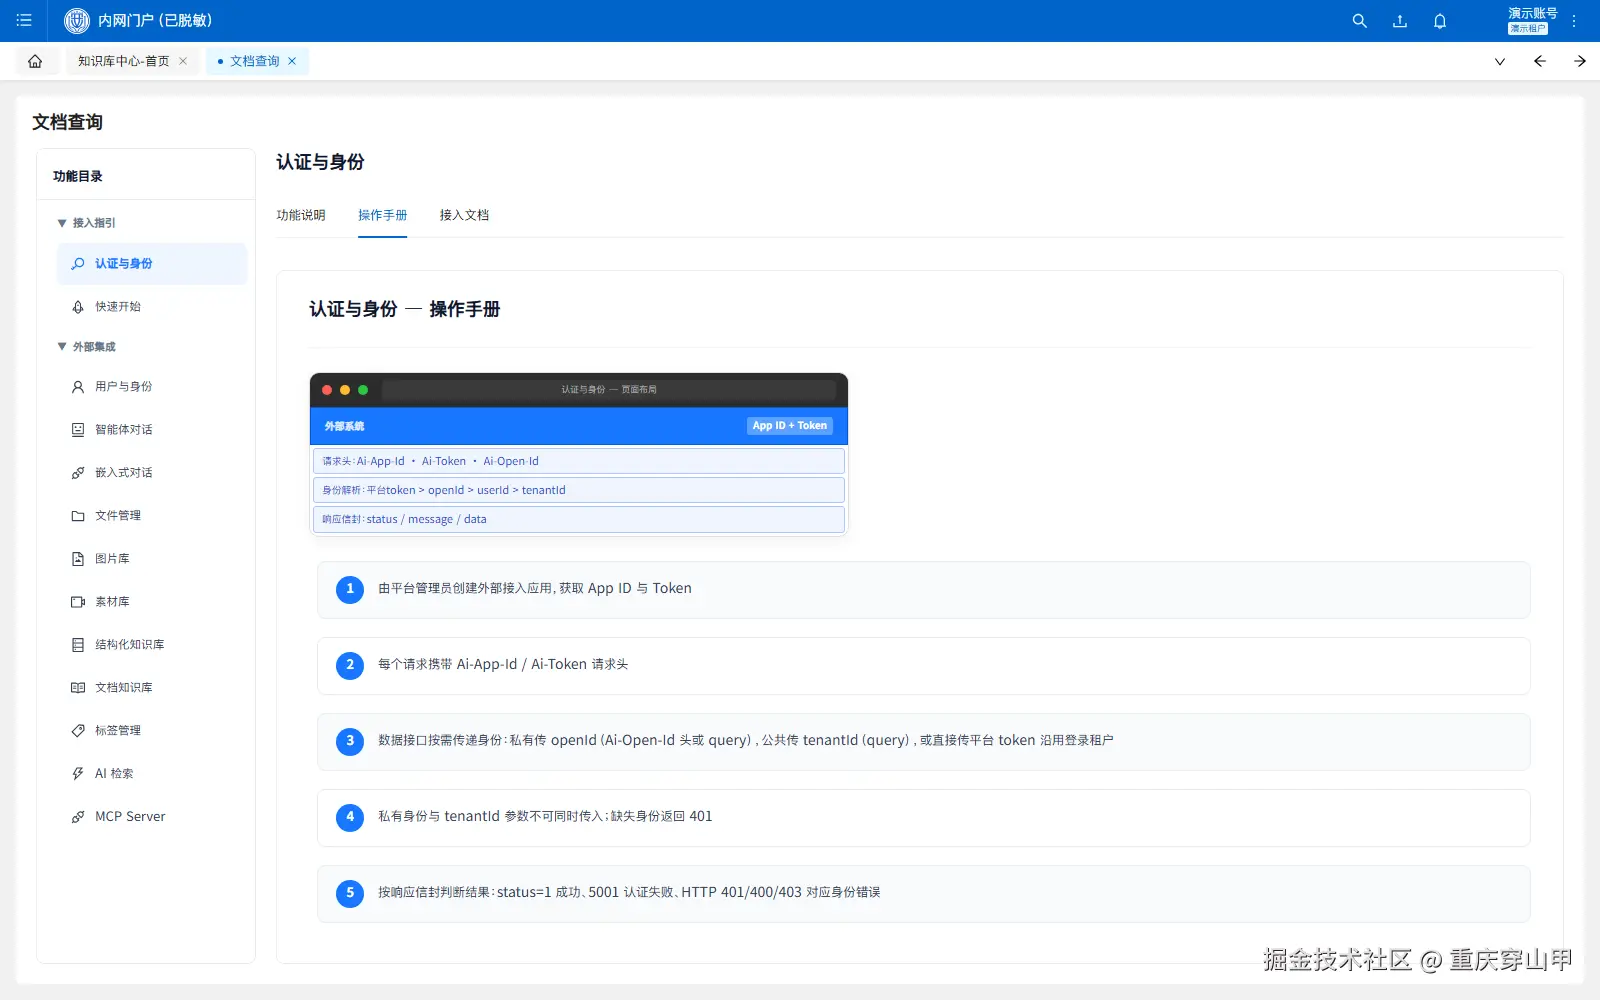 同一页的「操作手册」面向使用者:某个功能在界面上怎么点、字段什么意思。
文档里写清楚的三件事(也是接入时最容易踩的三件事):
- 认证与身份 :请求头
Ai-App-Id·Ai-Token·Ai-Open-Id;身份解析顺序是 平台 token > openId > userId > tenantId ;响应统一信封status / message / data。 - 接入模式 :私有 (按用户隔离)还是公共(按租户隔离)------ 文档要求「先明确」, 因为后面所有接口的可见范围都由它决定。
- 快速开始五步 :
user/register拿 openId →files/upload→ 轮询files/{id}直到pipelineStep=5→rag/search命中 →files/{id}/download。给的是能照着抄的顺序,不是接口清单。
第三步:真机冒烟(本文写作时的真实返回)
为了不写成"文档说可以",我们拿考试类业务这个应用的凭据,走了一遍外部系统会走的路(脚本 接入冒烟脚本):
| 步骤 | 请求 | 实测返回(节选) |
|---|---|---|
| ⓪ 平台侧把别名指向智能体 | POST /openai-compat/aliases {alias: safety-rhyme, targetType: AGENT, targetId: 92} |
{"alias":"safety-rhyme","targetId":92,"enabled":true} |
| ① 注册外部用户 | POST /openapi/v1/user/register {externalId: dept-erp-001, tenantId: ...} |
{"openId":"c0be10ade21345ceba8abee13feb6190","created":true} |
| ② 外部系统同步调智能体 | POST /openapi/v1/agent/chat/sync {agentId: 92, openId, content} |
conversationId=72ebb9b6-...、durationMs=14649、promptTokens=7776、completionTokens=222、真实回答内容 + files:[] |
| ③ 嵌入式对话签发 token | POST /openapi/v1/embed-token {openId, ttlSeconds: 300} |
返回带 appId 与 openId 的 JWT(前端只拿它,不接触应用 Token) |
| ④ OpenAI 兼容端点 | POST /openapi/v1/chat/completions(Authorization: Bearer ...,model=safety-rhyme) |
标准 chat.completion 结构:id=chatcmpl-bbc6...、finish_reason=stop、usage{7775/67/7842};平台额外字段 conversation_id 与 answerer:"agent#92 安全顺口溜 Agent" |
第 ④ 条是给「零改造接入」用的:正文是标准结构(老客户端不用改),会话与"到底是谁答的"放在非标字段里 (不污染正文,也不会让严格校验的客户端报错)。附带三个如实记录的行为:注册缺 tenantId 会被明确拒绝 (缺少租户ID(tenantId))、model 传了没登记的别名会 400 并提示「请先在模型别名里把它指向某个智能体」、 未带 openId 的身份会被拒(OpenId 无效)------ 错就是错,不会静默降级。
接入前要准备什么(给对接方的清单)
- 一个应用 + 一份 Token (平台侧开),以及接入模式(私有 / 公共)先定;
- 用户身份怎么对应 :外部系统用
externalId注册拿openId,之后所有请求带它 ------ 不要用平台账号体系硬接; - 网络与白名单 :你的出口要能到网关(本文实测为
内网门户/knowledge), MCP/回调方向还要确认反向可达; - 要挂哪些知识库、什么密级:密级决定这条链路能召回什么(见第十一节);
- 要挂哪个模型通道:模型在「模型管理」里登记,密钥只在平台侧;
- 验收口径:拿你们自己的 3~5 个真实问题跑一遍,跟平台一起看命中与引用(第五节那套评测可以直接用)。
十一、基础设施与安全巡检
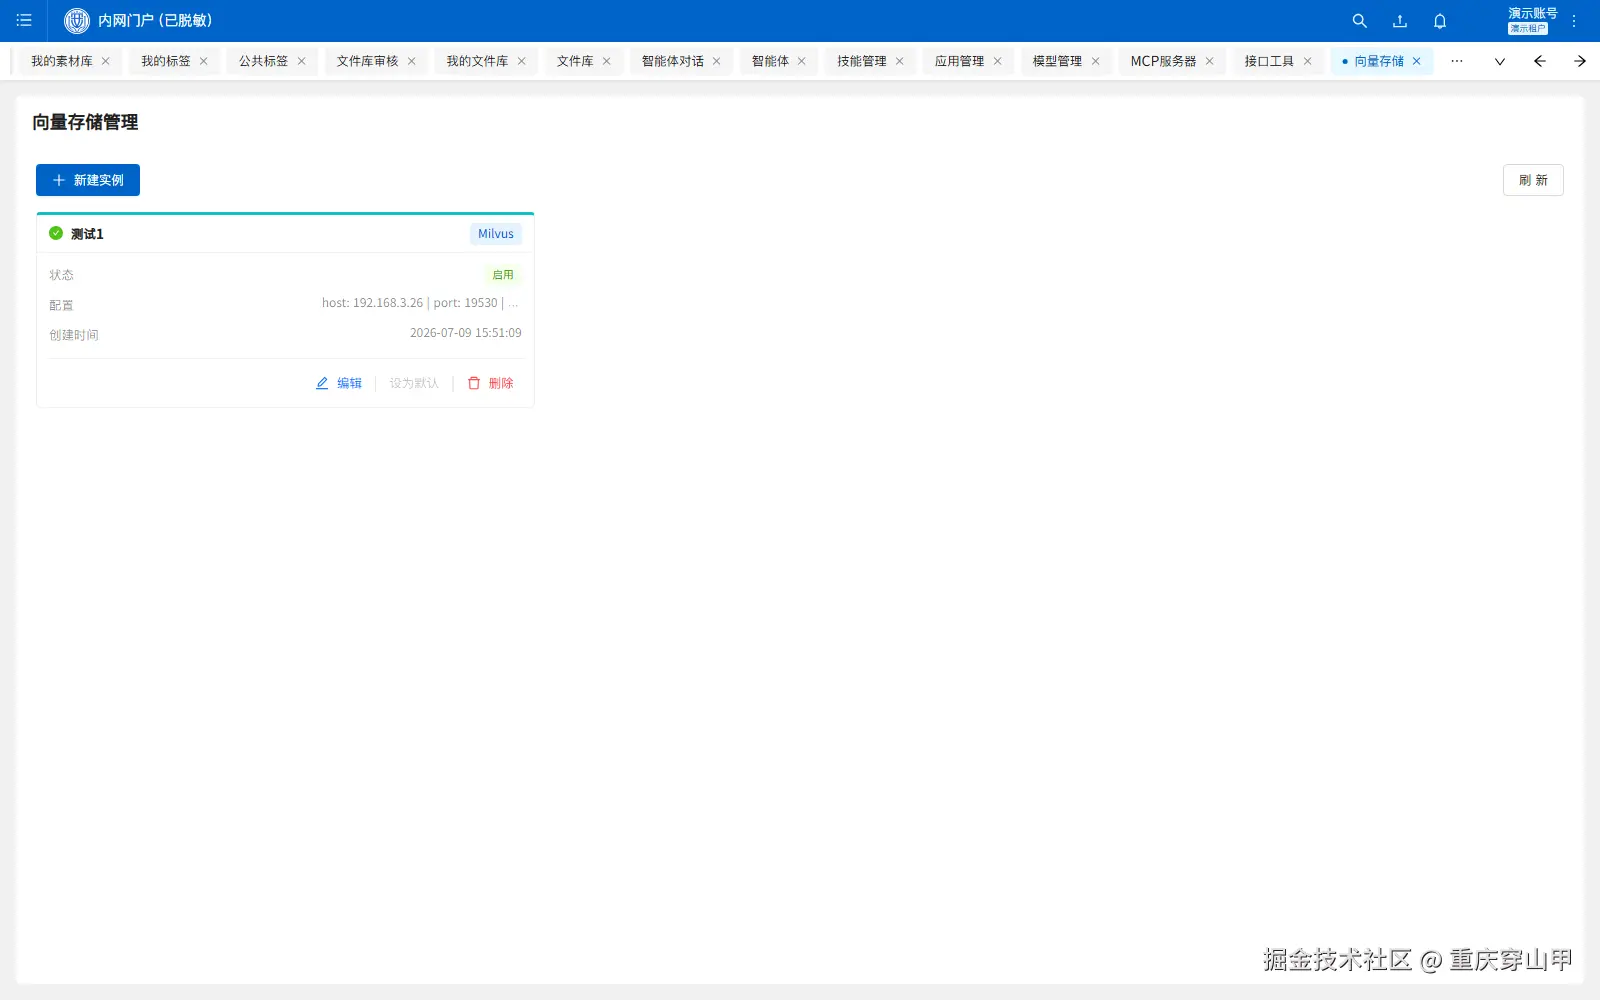 基础设施页把「平台依赖谁」摊开:向量库实例(这一屏是 Milvus,即库画像里的「测试1」)、搜索引擎实例(ES)。
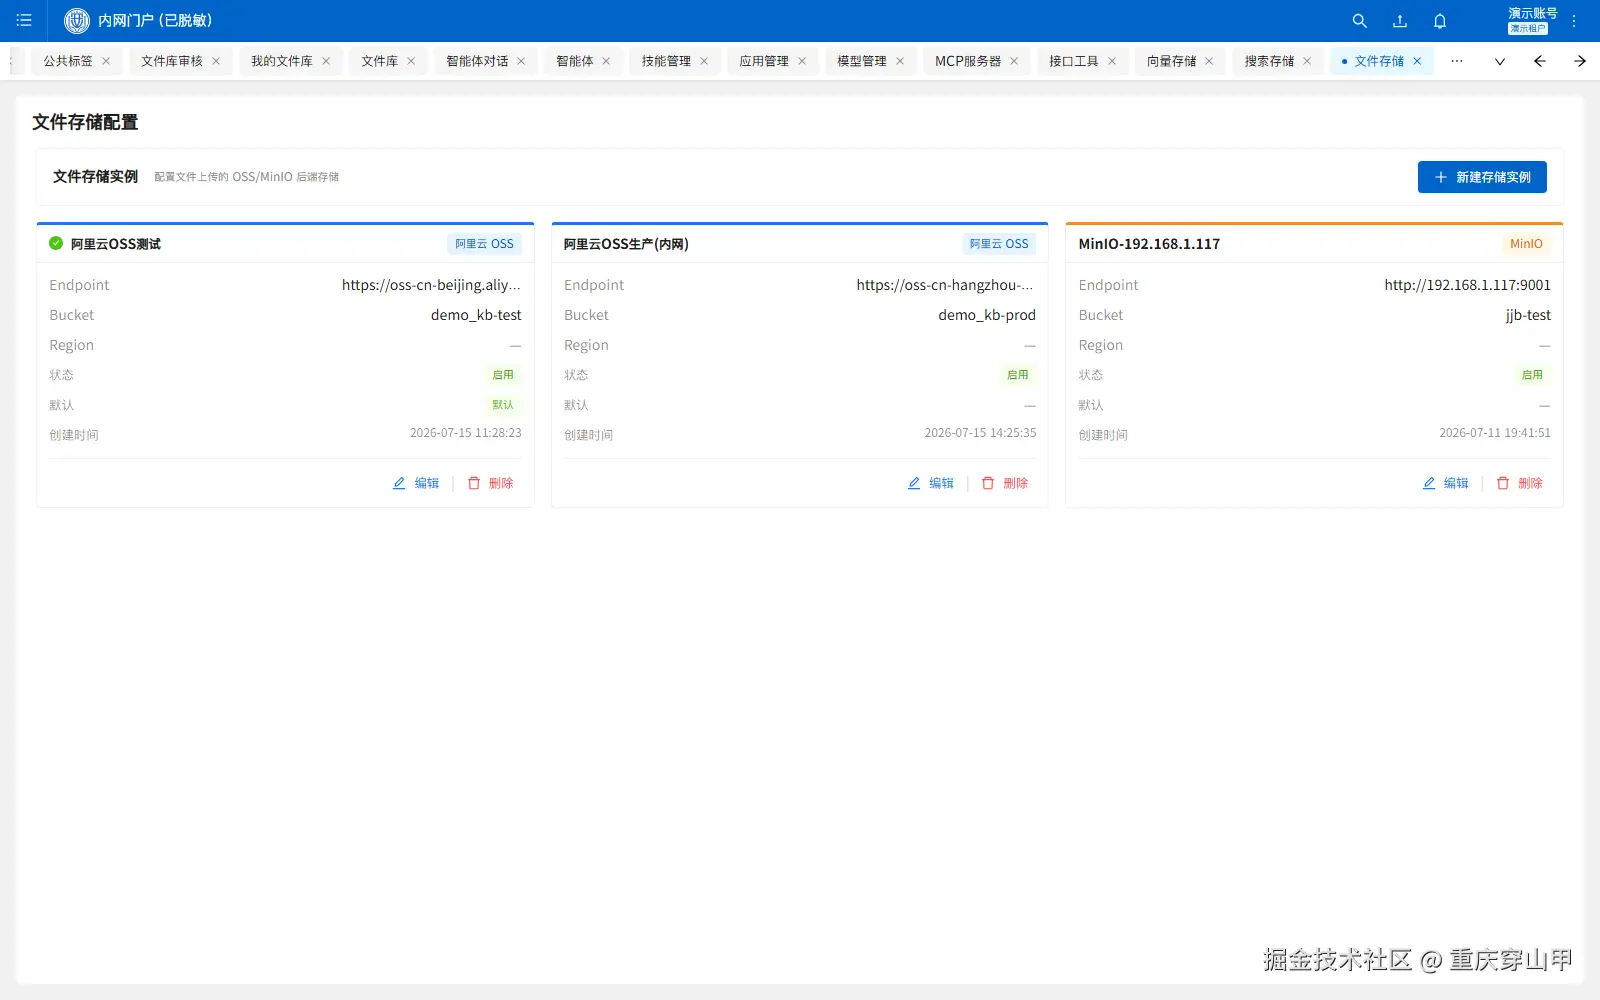 文件存储实例:配置文件上传后可测连通、可切换;平台不绑定某一家对象存储。 (截图里的地址、账号名、库名已就地脱敏为
10.x.x.x / demo_db / demo_user;密钥类字段平台只回掩码。)
同一层里还有:图数据库 (Neo4j 实例与图谱配置)、基础设置(文档解析引擎含 vision 解析、语音合成、 视频/字幕、数字人、图像生成,以及 PPT / 智能体 / 文档模板管理)------ 多模态能力的开关和凭据收在这一页。
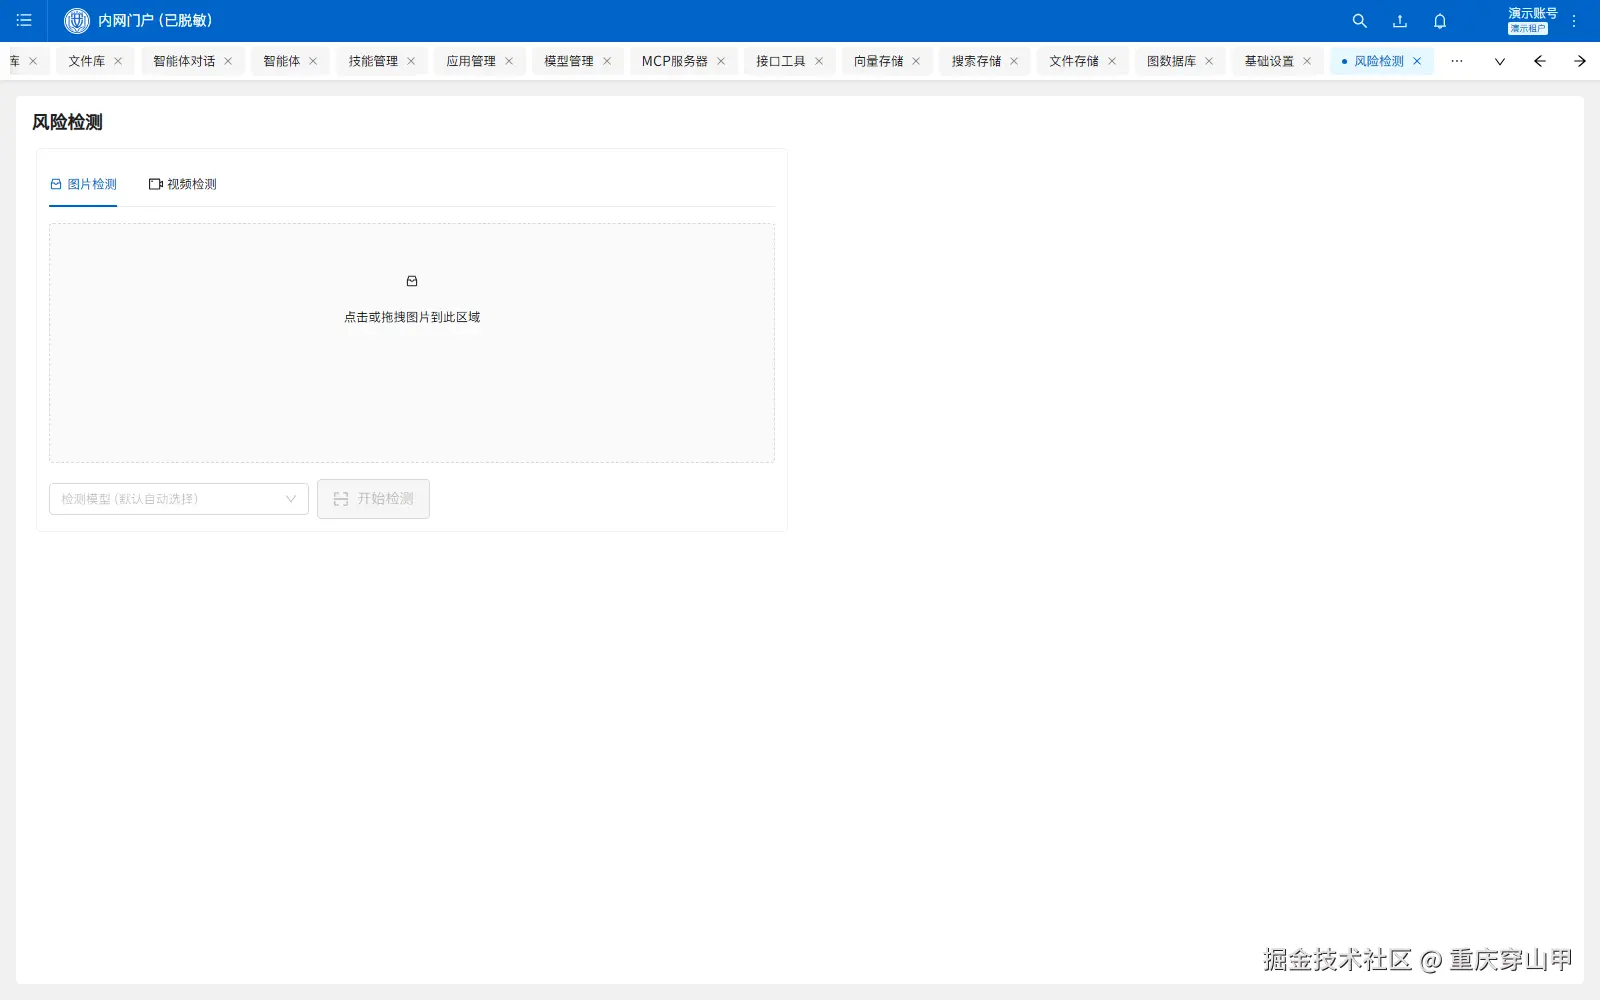 安全巡检:图片检测 / 视频检测两个入口,选检测模型(默认自动选择)后上传即检 ------ 检测结果进隐患台账。
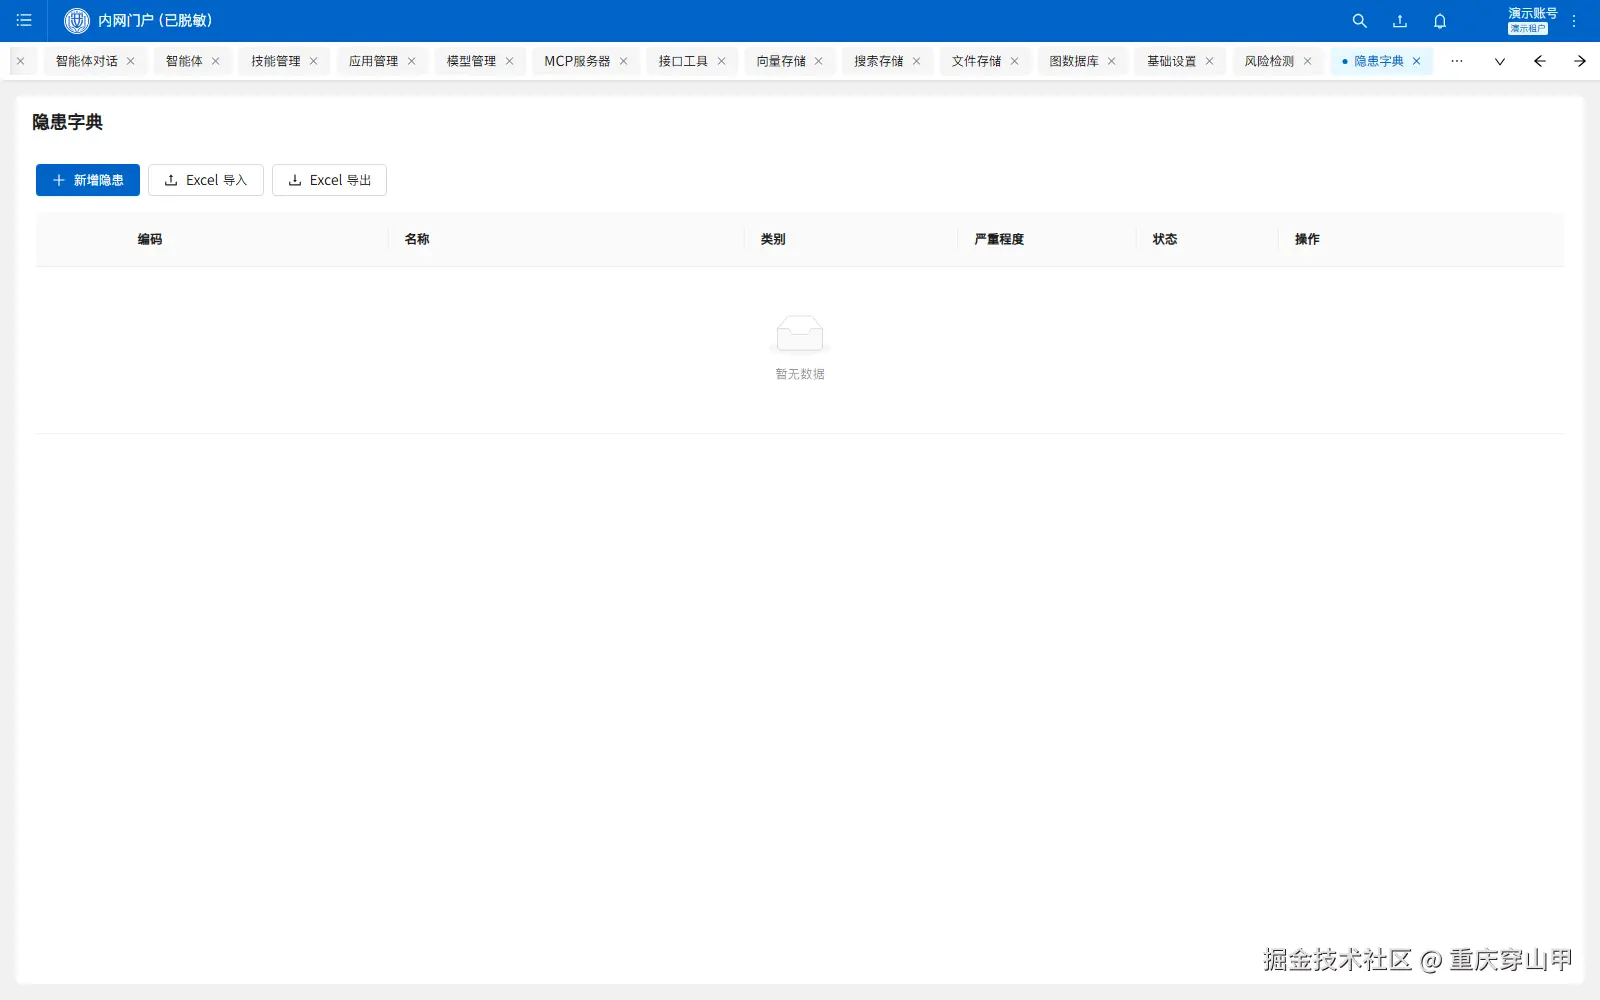 隐患字典:隐患的编码、名称、类别、严重程度、状态,支持 Excel 导入/导出 ------ 检测结果不是一句「有风险」,而是能落到「依据哪一条、怎么整改」。这一屏演示环境未灌数据,看的是结构。 配套的「检测记录」页(截图略)保存历史检测结果:图片、时间、命中项,支撑「这条隐患谁什么时候发现的」。
十二、治理与安全:把「出事时能查清」做进设计
这一层不性感,但它是企业敢用的前提。
密级四档 + 权限下推 + 收口复核 + 侧门封堵 。最硬的证据是正负身份对照 :把一篇文档设为机密后, 管理员身份命中 1 条、低密级身份命中 0 条 ,平台自记 acl_dropped=1 ------ 这是本环境第一次出现 权限真的挡下内容的日志(此前 2900+ 条日志全是 0)。这条对照有独立套件,8/8 通过。
凭据只存密文,平台自己也不给你看 。工具凭据集中加密存储(SM4),接口只回掩码, 没有任何「查看明文」的端点 。最硬的一条验收判据是:让一个引用凭据的接口工具去调平台自己, 并且手写头故意放错 token ------ 只有「真解密 + 覆盖同名手写头」同时成立才可能拿到数据(26/26)。
删除要删干净 。删知识库时检索索引也要一起删。曾经遗留 7 个孤儿索引、约 171 篇残留正文还能被搜到; 修完之后验收判据从「接口返回成功」升级为「索引 404」(9/9)。
失败也必须通知 。曾经有个活样本:文件创建后 14 秒失败、callback_tries=0 ------ 从没尝试过, 因为派发逻辑只捞成功态。修完后 30 秒内补发、对面收到 2xx。
查询审计:每次检索/问答异步落一行(谁问了什么、召回多少、被权限挡多少、引用了什么、是否拒答)。 当前 1325 条,其中拒答 117 条。
让平台能「问库表」:只读数据源 + 元数据资产目录
企业里第二常被问的是:「能不能连我们的数据库?」 我们做的是只读,四道闸门缺一件都不上线:
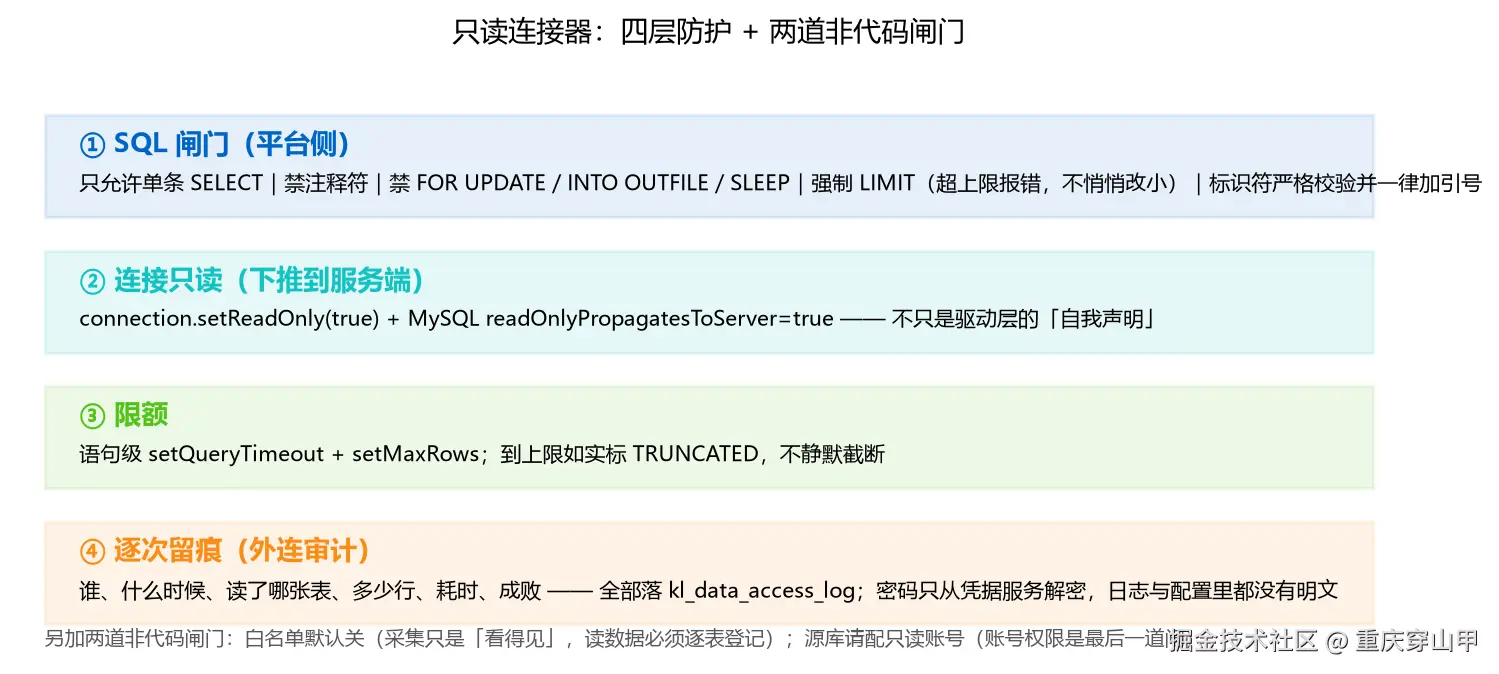
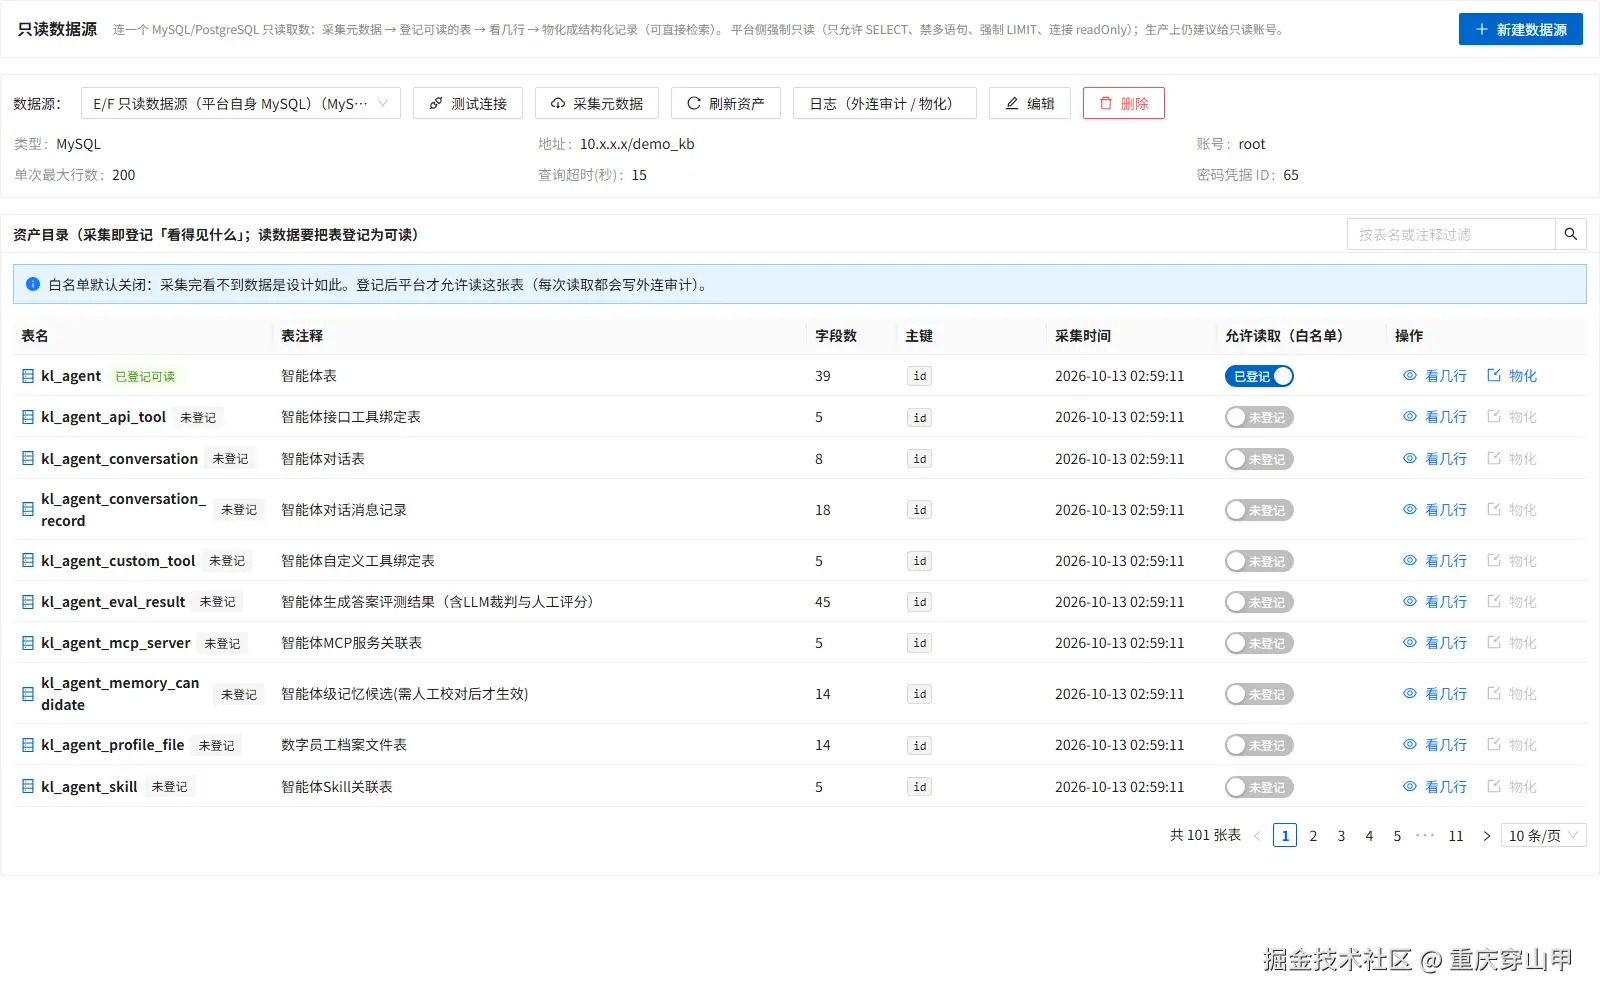 真实一屏:连一个 MySQL/PostgreSQL 只读取数 ------ 采集元数据 → 登记可读的表 → 看几行 → 物化成结构化记录 (可直接检索)。
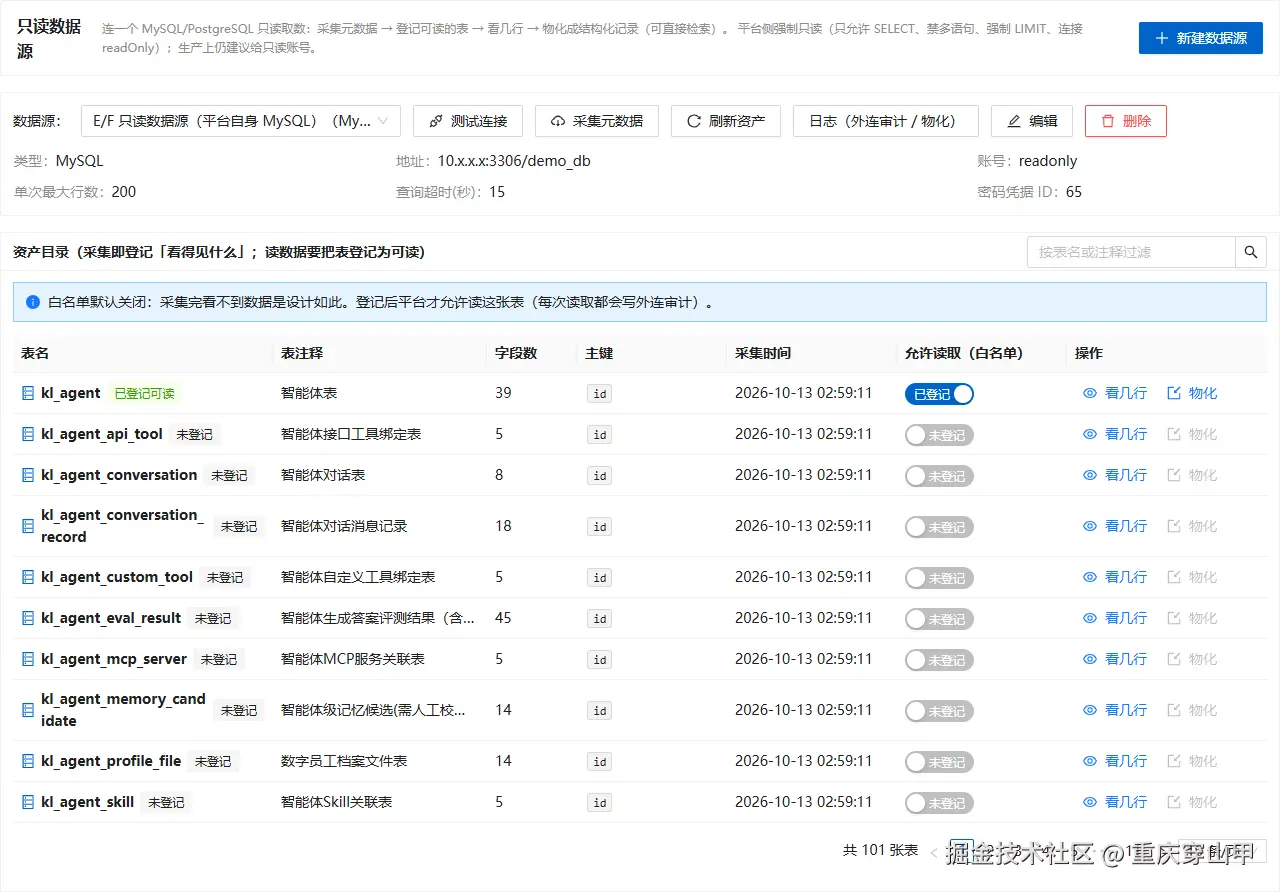 同一能力的另一屏:数据源(MySQL)连通后采集出 101 张表 ;每张表给出注释、字段数、主键 、采集时间, 右侧是「允许读取(白名单)」开关 ------ 默认全部未登记。要点「看几行」或「物化」必须先登记。
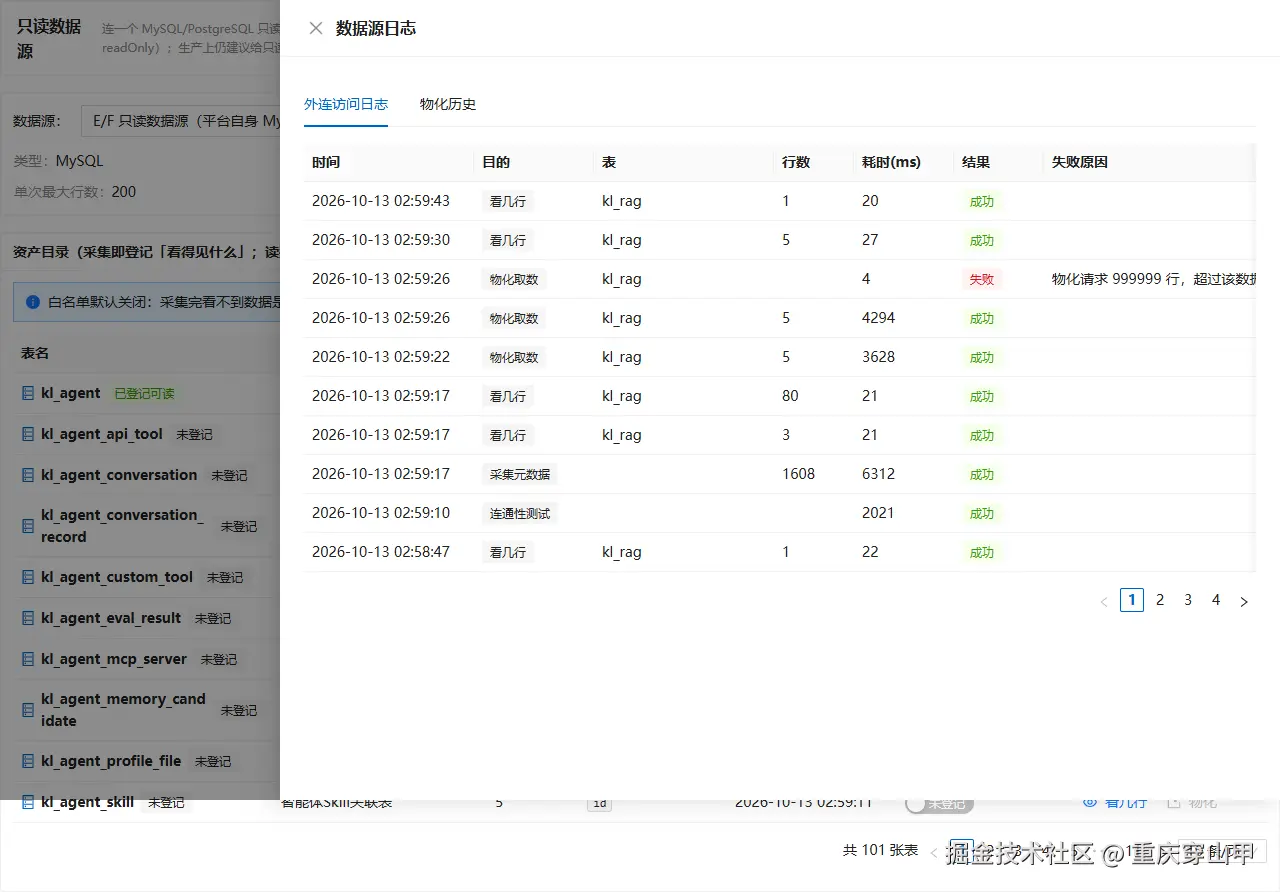 每一次外连都留痕:连通性测试 / 采集元数据 / 看几行 / 物化取数,含表名、行数、耗时、成败与失败原因。 图中那条「失败」是真实记录:请求 999999 行 超过该数据源单次上限 200 ,平台明确拒绝(而不是悄悄改小)。
完整链路(真机验收 37/37):
- 建数据源 :MySQL / PostgreSQL;密码不落配置,只存「凭据 ID」;
- 采集元数据 :实测 101 张表 / 1507 个字段(类型、可空、注释、主键);
- 白名单默认关 :采集只是「看得见」,未登记的表一律拒绝读取,错误里直说这句话;
- 看几行 :只读预览,表里还有更多行时如实标
truncated; - 物化进结构化知识库 :一行动一条记录,记录键
表名#主键值------ 实测物化 5 行 → 5 条记录, 再跑一次 writtenCount 仍是 5(幂等) ;没有主键的表直接拒绝物化; - 能在检索里查到:物化后按字段值搜「租户私有知识库(自动创建)」→ 命中 3 条;
- 外连审计:就是上图那张日志。
十三、它怎么证明自己是「活的」
- 运行级血缘 :每条回答落「本轮实际模型」。这条修的是一个很隐蔽的问题:换模型后,历史回答会因为 「按智能体当前配置推定」而被整体改算到新模型名下。现在聚合改成
COALESCE(记录里的模型, 配置推定)------ 记录优先,老数据才退回推定并标INFERRED; - 节点级观测 :每个执行过的节点一行(重试各成一行),最慢节点由服务端算好, 两个时长口径(
wallClock/nodeSum)如实并列,token 实测(不调模型的节点是空,不是 0); - 出口审计 :平台会往哪些外部地址发请求(模型通道 / 存储实例 / 内容生产),共 23 条,
inventoryComplete=true; - 数据体检 :11+ 段只读检查,当前 0 findings;
- 一条命令跑完全部验收:21 套、约 8~9 分钟,日志按时间戳落盘,有 FAIL 就退出码 1;
- 发布闸门(这条救过命) :「构建成功 + 部署完成 + pod Running 1/1」三者同时成立, 服务也可能完全不可用 ------ 应用在 Spring 装配阶段就退出,容器还活着。 所以唯一可信的信号是启动日志里的那行
Started SnailAiApplication。 这篇文章当天发的两次修复(发布批次 ②、①)都是按这条闸门验的。
十四、我们公开这些不足(这一节比前面更值得看)
写功能不带边界,等于把风险留给下一个人。以下都是当前真实状态:
质量与检索
- 表格保护只作用于新入库 文档;存量重切已暂停(两次试切都变差,已完整回滚);
- smart(LLM)切片下表头覆盖不稳定(两次实测 85% 与 29%);
- 短查询是弱项(Hit@5 0.75 vs 整句 0.9677),试过「问题改写」但指标没动;
- 表格排序偏好默认关:加分确实生效,但默认权重下名次一次没动 ------ 如实写「零收益」。
权限
- 线上 613 个分块 100% 是「内部」档 ,公开/秘密/机密三档零真实语料 ------ 权限能力缺真实数据验证;
- 一个已知未修 的缺陷:检索索引条目缺
acl_level/documentId时,密级过滤无从下手会放行(老分块); - 接口必填校验暂不开启 :调用方不能依赖 400 来发现自己漏传字段。
评测
- 31 道题分不出
topK=5与topK=1;出题、预检、噪声底线、四指标明细、配置快照、 打回题列表与一键恢复等能力只有接口、没有页面; - 出题里的
LONG_DOC取材未在真机跑过,CONFLICT无真实原料不启用。
平台 / 运维
- 定时触发多副本部署时两个 pod 会各触发一次 (需要分布式抢占);重启期间错过的时刻不补跑;
- 沙箱跑的是 Python 3.11.8,而接口标签写 3.12(3.12 独有语法会报错);
- 发布链路没有可用的回滚通道(本机无 ssh 凭据、运维控制台 账号对 deployments 403);
- 默认文件存储是公网 OSS,切内网属数据落点决策,未擅自改;
- 只读数据源:不做增量、不做调度、不做写回;跨网段可达性未验证。
已声明未实装(对客户必须说清)
- 4 种图数据库(Nebula / TuGraph / HugeGraph / JanusGraph)为预留,实际可用只有 Neo4j;
- 图像/语音模型适配器可登记,当前版本没有调用实现 ;数字人的两个 provider 会抛
UnsupportedOperationException; - 图片库/素材库的以图搜图页面在本环境演示数据为空(图库未灌语料),能力由接口与素材库资料口径交付, 截图只截了有数据的那部分 ------ 不拿空页面当「已上线」。
十五、想自己验?
bash
# 一条命令跑完全部验收套件(21 套,约 8~9 分钟;有 FAIL 则退出码 1)
py run_all_acceptance.py

# 只跑某一套
py run_all_acceptance.py --only m6-plugin

# 发布必过闸门:等构建结束 + 读 pod 日志确认真的起来了
py wait_and_verify_startup.py <发布批次号>
单套覆盖(节选):M1 草稿/发布/回滚 34 项、单步调试 16、迭代节点 16、代码节点 16、知识检索节点 10、 密级两身份对照 8 、工具目录 10、工具凭据 26 、Dify DSL 16(+官方 Dify 反向 11 + 5)、插件体系 40、 内网市场 12、代码型插件 25、运行历史 27、嵌入片段 19、表格结构化 17、表格路线 10、删库清索引 9、 前端产物 6、上传异步 12、URL 转存 6。此外:概念扩展 33/33 、只读数据源 37/37 、 部署后功能体检 39 passed / 0 failed 、数据体检 0 findings。
结语:护城河不是功能多
而是每个功能都带着「怎么证明它是对的」:
- 说「不硬答」,就给误拒 0/43、拦下 10/10 的实测;
- 说「改进了检索」,就给关掉它的对照 + 置信区间 + 噪声底线,并且如实写「样本不够」;
- 说「只读」,就把四层防护写进代码,还留一条能查出「谁读了哪张表」的审计;
- 说「能上线」,就用启动日志里的那一行 Started 当唯一信号,而不是 Jenkins 的绿灯;
- 说「我们有什么没做到」,就一条条列出来,包括「已声明未实装」的四类。
这些数字和边界,比任何一句「我们支持 XX」都值钱。
附一:三条可以直接抄走的习惯
- 先量基线再动手:新功能前先跑一遍现有评测集,把「改之前」钉住;
- 每个开关都必须能被关掉做对照:不能 A/B 的功能,收益永远说不清;
- 把「配了不生效」当成一类缺陷来治 :我们累计遇到 11 次 「单测全绿、接口全绿、功能没生效」 (默认密级没落库、拒答阈值被保存请求静默抹掉、表格保护只做在预览路径、
mergeShortSegments是一个从未被读取的死配置、验收脚本自己删了 ES 索引壳导致假绿......)。 处置办法不是「下次小心」,而是每一处补一条守卫测试 + 让偏差在数据体检里看得见。
附二:写这篇文章时,真机点界面逮到的三个缺陷
为了拿到真实截图,我们登录门户一页页点了一遍。结果当场逮到三个只有「真的点」才会暴露的问题:
- 新接口路径被前端工具类误判 :
withApiPrefix把/knowledge-pack/...当成「已经带过/knowledge前缀」 而原样放行,请求发到了错误地址 ------ 页面渲染正常、数据永远为空,前后端都不报错。 修法是把「已带前缀」的判断收紧成/knowledge本身或/knowledge/...。 - 四个结构化页面整页崩 :我的/公共结构化知识库、我的/公共结构化知识搜索,打开就是
could not find react-redux context value。根因是这些页面直接import ... from 'dva', 而本工程是 pnpm 安装 + 按 realpath 解析,页面拿到的是另一份 dva 、其 react-redux 与运行时建 Provider 用的那份不是同一个实例 ------ 两个 ReactReduxContext,取上下文恒为 null。 修法是改走运行时自己的Connect,并加一条守卫:谁再直接从dva引 hooks,构建直接失败。 - 搜索命中却显示「未找到匹配记录」 :接口 200、后端命中 3 条、redux state 里也是 3 条,页面却是空的。 根因是我们自己在上一版修 bug 时用错了 API ------
getModelState(namespace, name)的第二个参数才是字段名 , 只传命名空间等于读props[ns][undefined],恒为 undefined 且不报错 。改用useModelState(namespace, props)后恢复正常,同样补进守卫(只传一个参数就构建失败)。
三个缺陷都是同一类:页面能打开、接口不报错、数据是错的。 这也是为什么我们坚持「真机点一遍,并且看到有数据的界面才算验收通过」。