摘要
我的个人项目里有一步,是在网页里把视频一帧一帧取出来处理。写长片子之前我想先弄清一件事:这样处理下去,内存是被什么占掉的,我又该盯着哪个数看。这篇笔记按我查的顺序写。先算一帧画面有多大,再看每帧用完就释放时的样子,然后故意把帧留着不放,看内存涨在哪里。接着查每帧都释放了为什么还会涨,最后把控制节奏的写法和四个浏览器的读数都对了一遍。
结论先放这里。一帧 1920×1080 的画面解码出来约 3.1 MB。留着 1500 帧不放,在 Chromium 149 里系统的图形缓冲多了 1508 个,系统内存多了两千多 MB,浏览器进程内存只涨了 138 MB。我一开始盯的正是进程内存,按它排,最省内存的写法反倒是最不该用的那个。每帧都释放也不保险。处理比解码慢、又不控制节奏的时候,等着处理的帧最多排到 1421 个。按两条队伍的长度控制节奏之后,待处理的帧最多 17 个,图形缓冲只多 29 个,总用时和不控制时接近。这批实验没有测到页面崩掉,也没有量帧率,文中只写我量到的内存。
版本声明
实测是 2026-10-12 在一台 Apple M4、16 GB 内存、装着 macOS 26.5.2 的电脑上做的。浏览器是 Chromium 149.0.7827.55、Chrome 154.0.8037.98、Firefox 151.0 和 WebKit 26.5(macOS)。这个 WebKit 是 macOS 上的内核构建,不是 iPhone 上的浏览器。在网页里拆 MP4 文件用的是 mp4box.js 0.5.2,样片是拿 ffmpeg 7.1 转的。文中说哪个浏览器怎么表现,都只对这几个版本成立。
适用边界
只测了这一台电脑。别的机器、别的显卡、Windows 和手机都没测。文中反复出现的「图形缓冲」是 macOS 上的说法,别的系统上解码出来的帧放在哪里,我没有测。样片是网上找的示例视频,用 ffmpeg 转码后首尾循环拼接成的长样片,不是原生的长视频,画面内容是重复的。编码只测了 H.264,没有区分硬件解码和软件解码。4K 有两个场景只喂了 300 帧和 400 帧。系统内存的读数波动很大,同一个场景跑两次可以差 1 GB 以上,文中凡是引用它的地方都只能看量级。
文章目录
一、逐帧处理视频的内存该看哪个数
- 1.1 逐帧处理要先把视频拆成一张张画面
- 1.2 样片是示例视频循环拼成的
- 1.3 我每半秒记三个内存读数
二、视频解码后一帧有多大
- 2.1 一帧全高清画面约3.1 MB
- 2.2 解码出的帧要手动调close释放
三、每帧立即释放时内存是什么样
- 3.1 立即释放时图形缓冲只多12个
- 3.2 我另找了一条现成流水线做参照
四、解码帧留着不放会占多少内存
- 4.1 留着不放时图形缓冲多了1508个
- 4.2 浏览器进程内存只涨了138 MB
- 4.3 涨的是整台机器的内存
- 4.4 喂到2956帧解码器仍没有报错
五、浏览器会不会自己回收没释放的帧
- 5.1 Chromium里观察6秒没有回收
六、每帧都释放了内存为什么还涨
- 6.1 处理慢时待处理的帧排到1421个
- 6.2 队伍排空后图形缓冲没有跟着降
七、逐帧解码怎么控制节奏
- 7.1 队伍超过上限就先不喂数据
- 7.2 控节奏后待处理帧最多17个
- 7.3 两种写法总用时接近
八、四个浏览器的内存读数为什么对不上
- 8.1 Firefox 151把帧算在进程内存里
- 8.2 WebKit 26.5丢掉引用后会回收
- 8.3 Chrome和Chromium读数相近
九、4K视频逐帧处理内存会怎样
- 9.1 超高清一帧推算约12.4 MB
- 9.2 留着不放的场景只喂了300帧
- 9.3 控节奏后图形缓冲多101个
十、现成的逐帧流水线内存是什么样
- 10.1 全程图形缓冲最多多出79个
- 10.2 这次对照说明不了抠像效果
十一、我的项目里逐帧处理怎么写
- 11.1 每一帧只留一条释放的路
- 11.2 喂数据前先看两条队伍
- 11.3 自查时数系统的图形缓冲
十二、适用边界与风险
十三、测量方法的坑
十四、还没解决的
一、逐帧处理视频的内存该看哪个数
先把问题和工具摆出来。这一章讲我到底想查什么、拿什么片子查、每次记哪几个数,后面每一章的数字都是这么来的。
1.1 逐帧处理要先把视频拆成一张张画面
视频文件里存的不是一张张完整的图片,是压缩过的数据。要对画面动手,比如给每一帧加个效果、抽几帧做缩略图,得先把压缩数据还原成完整的画面,这一步叫解码。这样摊开的画面,一张就叫一帧。逐帧处理的意思就是:解一帧,处理一帧,再解下一帧。浏览器里有一套叫 WebCodecs 的接口可以做这件事。其中的 VideoDecoder 是解码器,你把压缩数据一份一份喂给它,它把解好的画面一帧一帧交还给你。交还回来的那个东西叫 VideoFrame,可以把它理解成一张已经摊开、随时能画到屏幕上的大图。我的项目用的就是这套接口。
处理短片的时候怎么写都行。我担心的是长片:一分钟的视频按每秒 25 帧算就是 1500 帧,要是哪里写得不对,这 1500 张大图会不会全堆在内存里。你可能碰到过这种情形:网页处理着视频,电脑上别的程序跟着变卡,打开浏览器自带的任务管理器一看,那个标签页的内存却不高。读数和体感对不上,我想先在自己电脑上把内存这一半量清楚。于是问题变成两个:内存被什么占了,以及该看哪个数才看得到它。
1.2 样片是示例视频循环拼成的
样片不是我拍的。我从维基共享资源找了两段示例视频,一段是海浪,1920×1080,每秒 25 帧,原片只有 12.56 秒。另一段是河道,3840×2160,每秒 30 帧,原片 16.50 秒。两段都太短,测不出长片的情况。这两段我都用 ffmpeg 转成了 H.264 编码的 MP4,去掉声音,再把原片首尾相接循环拼长。H.264 是最常见的一种视频压缩方式。
拼出来的海浪样片是 60 秒、1500 帧,文件 120,575,433 字节。河道样片是 33 秒、990 帧,文件 272,771,599 字节。下文说「1080p 样片」指海浪这段,「4K 样片」指河道这段。1080p 和 4K 是画面尺寸的俗称,前者是 1920×1080,后者是 3840×2160。
循环拼接有个副作用要先讲明白:画面内容是重复的。系统在内存紧张时会把暂时不用的数据压小,重复的画面可能更好压。我量到的系统内存数字因此可能比真实长片偏低。
1.3 我每半秒记三个内存读数
每个场景我都单独开一个全新的浏览器来跑,跑的时候每 0.5 秒记一次下面三个数,跑完再多记 6 秒才停。三个数都和开跑之前的那一刻比,只看多出来多少。
第一个是浏览器的进程内存。浏览器开起来不是一个程序,是一个主进程带着一串子进程,我把它们各自实际占着的物理内存加在一起。这个数的术语叫 RSS,浏览器任务管理器里看到的也是同一类数字。第二个是系统内存,是从整台电脑的角度看占用多了多少。第三个是图形缓冲的个数。图形缓冲是 macOS 里专门用来放画面的一种内存块,名字叫 IOSurface,系统提供了一条命令能数出当前一共有多少个。
js
const { execSync } = require('child_process');
const run = (cmd) => execSync(cmd).toString();

// 读数一:浏览器主进程和它所有子进程的 RSS 加起来,单位 MB
function browserTreeMb(rootPid) {
  const table = run('ps -axo pid=,ppid=,rss=').trim().split('\n')
    .map((line) => line.trim().split(/\s+/).map(Number));
  const children = {};
  const rssOf = {};
  for (const [pid, parent, rss] of table) {
    (children[parent] = children[parent] || []).push(pid);
    rssOf[pid] = rss;
  }
  let totalKb = 0;
  const todo = [rootPid];
  while (todo.length) {
    const pid = todo.pop();
    totalKb += rssOf[pid] || 0;
    for (const kid of children[pid] || []) todo.push(kid);
  }
  return Math.round(totalKb / 1024);
}

// 读数二和读数三:整台机器的占用,和系统里图形缓冲的个数
function machineNow() {
  const vmText = run('vm_stat');
  const pagesMb = (label) =>
    Number((new RegExp(label + ':\\s+(\\d+)').exec(vmText) || [0, 0])[1]) * 16384 / 1048576;
  const swap = /used = ([\d.]+)M/.exec(run('sysctl -n vmText.swapusage'));
  const surf = /=\s*(\d+)/.exec(run('ioclasscount IOSurface'));
  return {
    usedMb: Math.round(pagesMb('Pages wired down')
      + pagesMb('Pages occupied by compressor')
      + (swap ? Number(swap[1]) : 0)),
    surfaces: surf ? Number(surf[1]) : null,
  };
}
代码说明:这段跑在 Node.js 里,不在网页里。browserTreeMb 先用 ps 命令列出所有进程,再从浏览器主进程出发,把它的子进程、孙进程一路找齐,RSS 全部相加。machineNow 里的 vm_stat 是 macOS 自带的内存统计命令。我取了其中两项:Pages wired down 是系统锁住、不能挪走的内存,Pages occupied by compressor 是系统把数据压小之后占的地方。再加上交换区的已用量,交换区是内存不够时系统挪到硬盘上的那部分。三项加起来就是我说的「系统内存」。ioclasscount IOSurface 这条命令直接报出图形缓冲的个数。16384 是这台电脑上一页内存的字节数。
三个数里系统内存最不稳。测的时候电脑上还开着别的程序,交换区在测试前就已经用掉约 10.7 GB,这个读数自己就有几百 MB 的起伏。图形缓冲的个数是三个里最稳的,后面我主要拿它说话。
二、视频解码后一帧有多大
查内存之前得先有个量级的概念。这一章回答两件小事:解出来的一帧占多少字节,以及这一帧用完之后归谁收拾。
2.1 一帧全高清画面约3.1 MB
VideoFrame 上有个方法叫 allocationSize,它会告诉你:把这一帧的像素完整拷一份出来,需要多少字节。1080p 样片解出来的帧,这个读数是 3,110,400 字节,约 3.1 MB。
这个数能自己算出来。解码器给的帧是一种叫 NV12 的格式。它记亮度时每个像素用一个字节,记颜色时每四个像素合用两个字节,摊下来每个像素 1.5 字节。按 1920×1080×1.5 算,结果正是 3,110,400。
对比一下文件大小就知道解码有多能「撑」。整段 1080p 样片 1500 帧,压缩着存只有 120,575,433 字节,平均一帧八万字节左右。解开之后每帧三百多万字节。1500 帧全摊开,按 1500 乘 3.1 MB 算是四个多 GB,这是纸面上的数,已经超过这台电脑 16 GB 内存的四分之一。
2.2 解码出的帧要手动调close释放
平时写 JavaScript 很少管内存。一个对象没人用了,浏览器的垃圾回收会找时间把它清掉,垃圾回收就是浏览器自动收拾没人要的对象的机制。VideoFrame 不太一样,它上面有一个 close 方法,文档的意思是用完要自己调它,把这一帧占的地方交出来。
我给自己打的比方是图书馆占座。每解出一帧,就等于在图书馆的桌上占了一个座位,放着一摞书。close 是把书收走、把座位让出来,不调它,座位就一直被我占着。这个比方到第四章还要用一次。
到这里我有了两个要验证的猜想。一是不调 close,帧会一直占着。二是既然每帧都这么大,占用应该很容易从读数上看出来。第一个后来证明是对的,第二个错了一半。
三、每帧立即释放时内存是什么样
做对照实验得先有一条基线。我先跑最规矩的写法,每拿到一帧立刻释放,看三个读数各是多少,后面所有「不对劲」的数字都拿它来比。
3.1 立即释放时图形缓冲只多12个
网页这边分两步。第一步把 MP4 文件拆开,取出一份份压缩数据,这一步叫解封装,我用的是 mp4box.js 这个开源库。第二步把压缩数据逐份喂给解码器,解码器每交回一帧,我就调一次 close。
js
const pause = (ms) => new Promise((ok) => setTimeout(ok, ms));

// 第一步:把 MP4 拆成一份份压缩数据
async function loadClip(clipUrl) {
  const raw = await (await fetch(clipUrl)).arrayBuffer();
  raw.fileStart = 0;
  const box = MP4Box.createFile();
  const packets = [];
  let meta;
  box.onReady = (m) => { meta = m; };
  box.onSamples = (_id, _user, list) => {
    for (const one of list) {
      packets.push({
        isKey: one.is_sync,
        at: one.cts * 1e6 / one.timescale,
        span: one.duration * 1e6 / one.timescale,
        bytes: one.data,
      });
    }
  };
  box.appendBuffer(raw);
  box.flush();
  const track = meta.videoTracks[0];
  box.setExtractionOptions(track.id, null, { nbSamples: 100000 });
  box.start();
  box.flush();
  const entry = box.getTrackById(track.id).mdia.minf.stbl.stsd.entries[0];
  const w = new DataStream(undefined, 0, DataStream.BIG_ENDIAN);
  entry.avcC.write(w);
  const setup = {
    codec: track.codec,
    codedWidth: track.video.width,
    codedHeight: track.video.height,
    description: new Uint8Array(w.buffer, 8),
  };
  return { packets, setup };
}

// 第二步:逐份解码,每拿到一帧马上释放
async function decodeAndFree({ packets, setup }) {
  const stat = { got: 0, maxInDecoder: 0 };
  const startedAt = performance.now();
  const dec = new VideoDecoder({
    output: (frame) => { stat.got++; frame.close(); },
    error: (e) => { stat.failed = String(e); },
  });
  dec.configure(setup);
  for (const p of packets) {
    while (dec.decodeQueueSize > 8) await pause(2);
    dec.decode(new EncodedVideoChunk({
      type: p.isKey ? 'key' : 'delta',
      timestamp: p.at,
      duration: p.span,
      data: p.bytes,
    }));
    stat.maxInDecoder = Math.max(stat.maxInDecoder, dec.decodeQueueSize);
  }
  await dec.flush();
  stat.ms = Math.round(performance.now() - startedAt);
  return stat;
}
text
样片 1920x1080,共 1500 份压缩数据,编码 avc1.42c028,isConfigSupported 返回支持
输出 1500 帧,解码队列峰值 9,用时 752 毫秒
进程内存增量 186 MB,系统内存增量峰值 102 MB,图形缓冲增量峰值 12
代码说明:loadClip 里的 packets 是拆出来的压缩数据,每份记着它是不是关键帧、时间点、时长和数据本身。关键帧是不依赖前后画面、能单独解开的那种帧。setup 是解码器开工前要知道的信息,包括编码类型和画面宽高。decodeAndFree 里的 output 是解码器每解好一帧就会调用的函数,我在里面数了个数就立刻 close。decodeQueueSize 是解码器身上的一个数字,表示交给它但还没开始解的数据有多少份。循环里那句 while 的意思是:解码器手里的活超过 8 份,就先等 2 毫秒再喂。flush 是告诉解码器「没有新数据了,把手里的都解完」。输出第一行里的 isConfigSupported 是开跑前另外问浏览器的一句,问它支不支持这种编码,这句我没贴进来。第三行的内存读数来自 1.3 节那段代码。
基线读数就是输出里的第三行。1500 帧不到一秒解完,图形缓冲最多只多了 12 个,系统内存多了 102 MB。进程内存涨了 186 MB,这个数先记着,下一章它会变得很奇怪。
3.2 我另找了一条现成流水线做参照
自己写的测试页只有解码这一步。真实的逐帧处理后面还跟着几步:把每帧交给模型算一遍(这一步叫推理),和背景合成,再编码成新的视频。我想知道一条完整的流水线跑起来,图形缓冲是什么量级。我用的是图映 ImgIng(imging.cn/)里的视频抠像功能(B... Chromium 149 里让它处理同一份 1500 帧的海浪样片,全程系统图形缓冲的增量在 −2 到 79 之间,没有随着进度上涨。它是一个在浏览器里处理图片和视频的在线工具,这项功能还在 Beta 阶段,说明页写的是优先支持桌面 Chrome 和 Edge。
要交代清楚的是,海浪画面里没有人物这类可以抠的主体,这次对照只能说明内存表现,说明不了抠得好不好。它里面是怎么写的我看不到,我只记了读数。细节放到第十章,这里先拿它当第二条基线:一条跑完整流程的流水线,图形缓冲的增量也是几十个的量级。
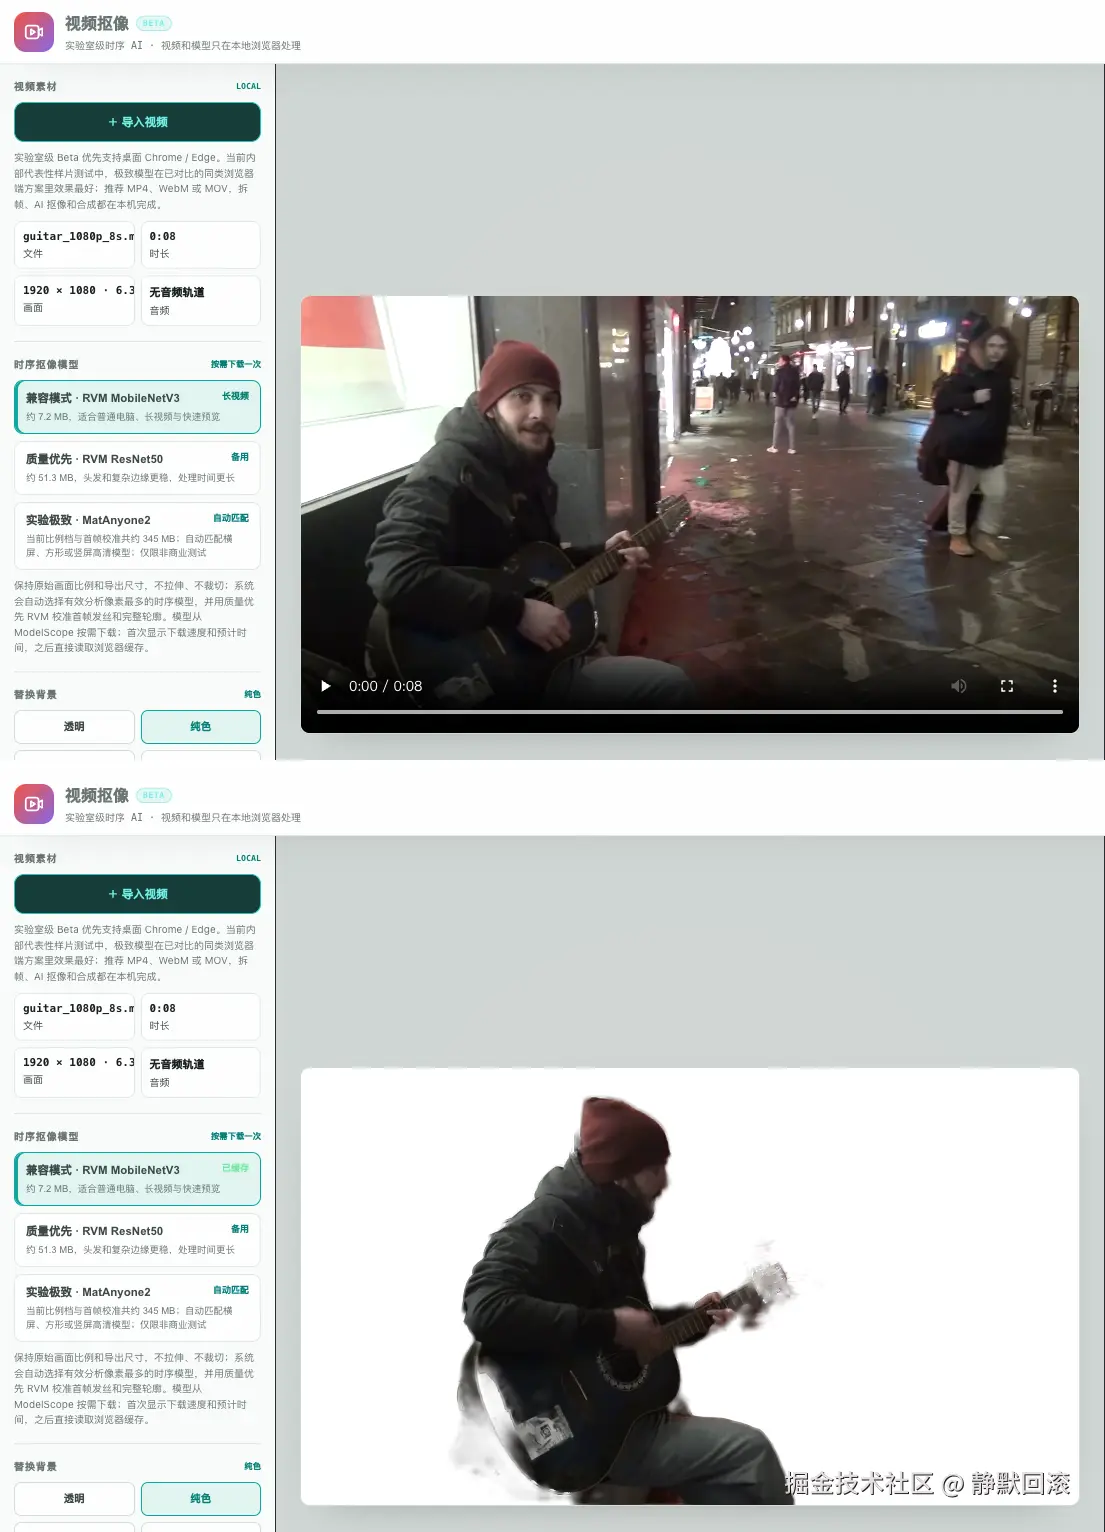
海浪里没有人,抠像界面上只有一片白,我就换了一段 8 秒的街头演奏另截了图。上半张是刚导入的原片,下半张是处理完、背景换成纯白的样子。画面出自维基共享资源上 Isak Zvegelj 拍的卢布尔雅那街头吉他演奏,CC BY 3.0。前面的读数不是用这段片子量的。
四、解码帧留着不放会占多少内存
有了基线,接下来故意把事情做错。我只改一个地方:把每帧的 close 去掉,帧全部留在一个数组里。要看的是三个读数里哪个会动。
4.1 留着不放时图形缓冲多了1508个
改动只在解码器交回帧的那个函数里。我一共准备了三种处理方式,这一章用第二种,第三种留到下一章。
js
const shelf = [];   // 「留着不放」时用来存帧的数组

function onFrame(frame, plan) {
  if (plan === 'free') {
    frame.close();          // 立即释放
  } else if (plan === 'hold') {
    shelf.push(frame);      // 留着不放:存进数组,不调 close
  } else if (plan === 'forget') {
    // 丢掉引用:不调 close,也不存,函数结束后就没人记得这一帧了
  }
}
text
方式        输出帧数  进程内存增量  系统内存增量峰值  图形缓冲增量峰值
立即释放    1500      186 MB        102 MB            12
留着不放    1500      138 MB        2694 MB           1508
丢掉引用    1500      0 MB          3316 MB           1508
代码说明:三种方式的区别只在这个函数里,喂数据的节奏和上一章完全一样。shelf 这个数组一直存在,放进去的帧就一直有人「记着」。输出是 Chromium 149 里 1080p 样片的读数,每一行都是单独开一个浏览器跑的。
看第二行。1500 帧留着不放,图形缓冲多了 1508 个,和帧数基本对得上,多出来的那几个我没有细究。一帧占一个图形缓冲,这是我从数字上看到的对应关系。
4.2 浏览器进程内存只涨了138 MB
再看同一行的进程内存,只涨了 138 MB。这个数比立即释放的 186 MB 还小。我一开始盯的正是这个数。按 2.1 节的算法,1500 帧摊开是四个多 GB,我以为进程内存会涨出几个 GB 来,结果它几乎没动。把三行按进程内存从低到高排一下更离谱:丢掉引用是 0 MB,留着不放是 138 MB,立即释放是 186 MB。照这个数挑写法,最省内存的是「不释放也不留引用」,最费的是规规矩矩每帧 close 的那个。这显然说不通。要么帧没占内存,要么我看错了地方。
图形缓冲那一列告诉我是后者。1508 个缓冲实实在在多出来了,只是没算进浏览器进程的 RSS 里。回到占座的比方。进程内存看的是我宿舍的书桌,帧占的是图书馆的座位,我在宿舍里怎么数也数不出来。
4.3 涨的是整台机器的内存
系统内存那一列有反应:留着不放时峰值多了 2694 MB,丢掉引用时多了 3316 MB。这两个数的先后不要当真。前面说过系统内存这个读数不稳,同一个场景跑两次可以差 1 GB 以上,谁大谁小说明不了问题。能当真的只有量级:立即释放是一百 MB 上下,另外两种是两三千 MB。
2694 MB 比按乘法算出来的四个多 GB 少了不少。系统在内存紧张时会把这些帧压小,压到什么程度不固定,我的样片画面又是循环重复的。这个差值我没有再往下拆。
到这里第一个问题有了答案。在 Chromium 149 里,没释放的帧放在系统的图形缓冲里,浏览器的进程内存看不出来。要看它,得看系统内存,或者直接数图形缓冲的个数。
4.4 喂到2956帧解码器仍没有报错
我还想知道一直留下去会怎样,就把同一份样片循环喂三遍,仍然留着不放。为了不把电脑压出事,我设了一条保护线:系统内存增量超过 6000 MB 就主动停。
结果是喂到 2956 帧时触发了保护线。停下来那一刻,系统内存增量的峰值是 7557 MB,图形缓冲多了 2922 个。整个过程里解码器没有报错,控制台没有警告,页面也还开着。再往上压会发生什么我没有测,那条保护线就是为了不去测它。
这次加压让我记住的是另一件事。帧留着不放,Chromium 149 不会提醒我:解码器不报错,控制台没警告,进程内存还很好看。我要是只靠这三样判断代码有没有问题,会一直以为没问题。
五、浏览器会不会自己回收没释放的帧
上一章的表里还有第三行没讲。既然平时写 JavaScript 不用管内存,那我不调 close、也不把帧存起来,浏览器是不是就会当它是垃圾,自己收走?
5.1 Chromium里观察6秒没有回收
「丢掉引用」就是这么做的:解码器交回一帧,我什么都不干,函数一结束,代码里再没有任何变量指向它。引用可以理解成「还有人记得这个对象在哪」。没人记得的对象,垃圾回收才有资格收。
Chromium 149 里的读数和留着不放一样,图形缓冲多了 1508 个。解码结束后又多记了 6 秒,这个数没有往回落。在我观察的这段时间里,没人记得的帧照样占着图形缓冲。
这里要把话说窄一点。我只等了 6 秒,更久之后会不会回收,没有测。我也没有去查 Chromium 的垃圾回收是按什么条件触发的。能确定的只有:在这 6 秒里指望它自己收,是指望不上的。
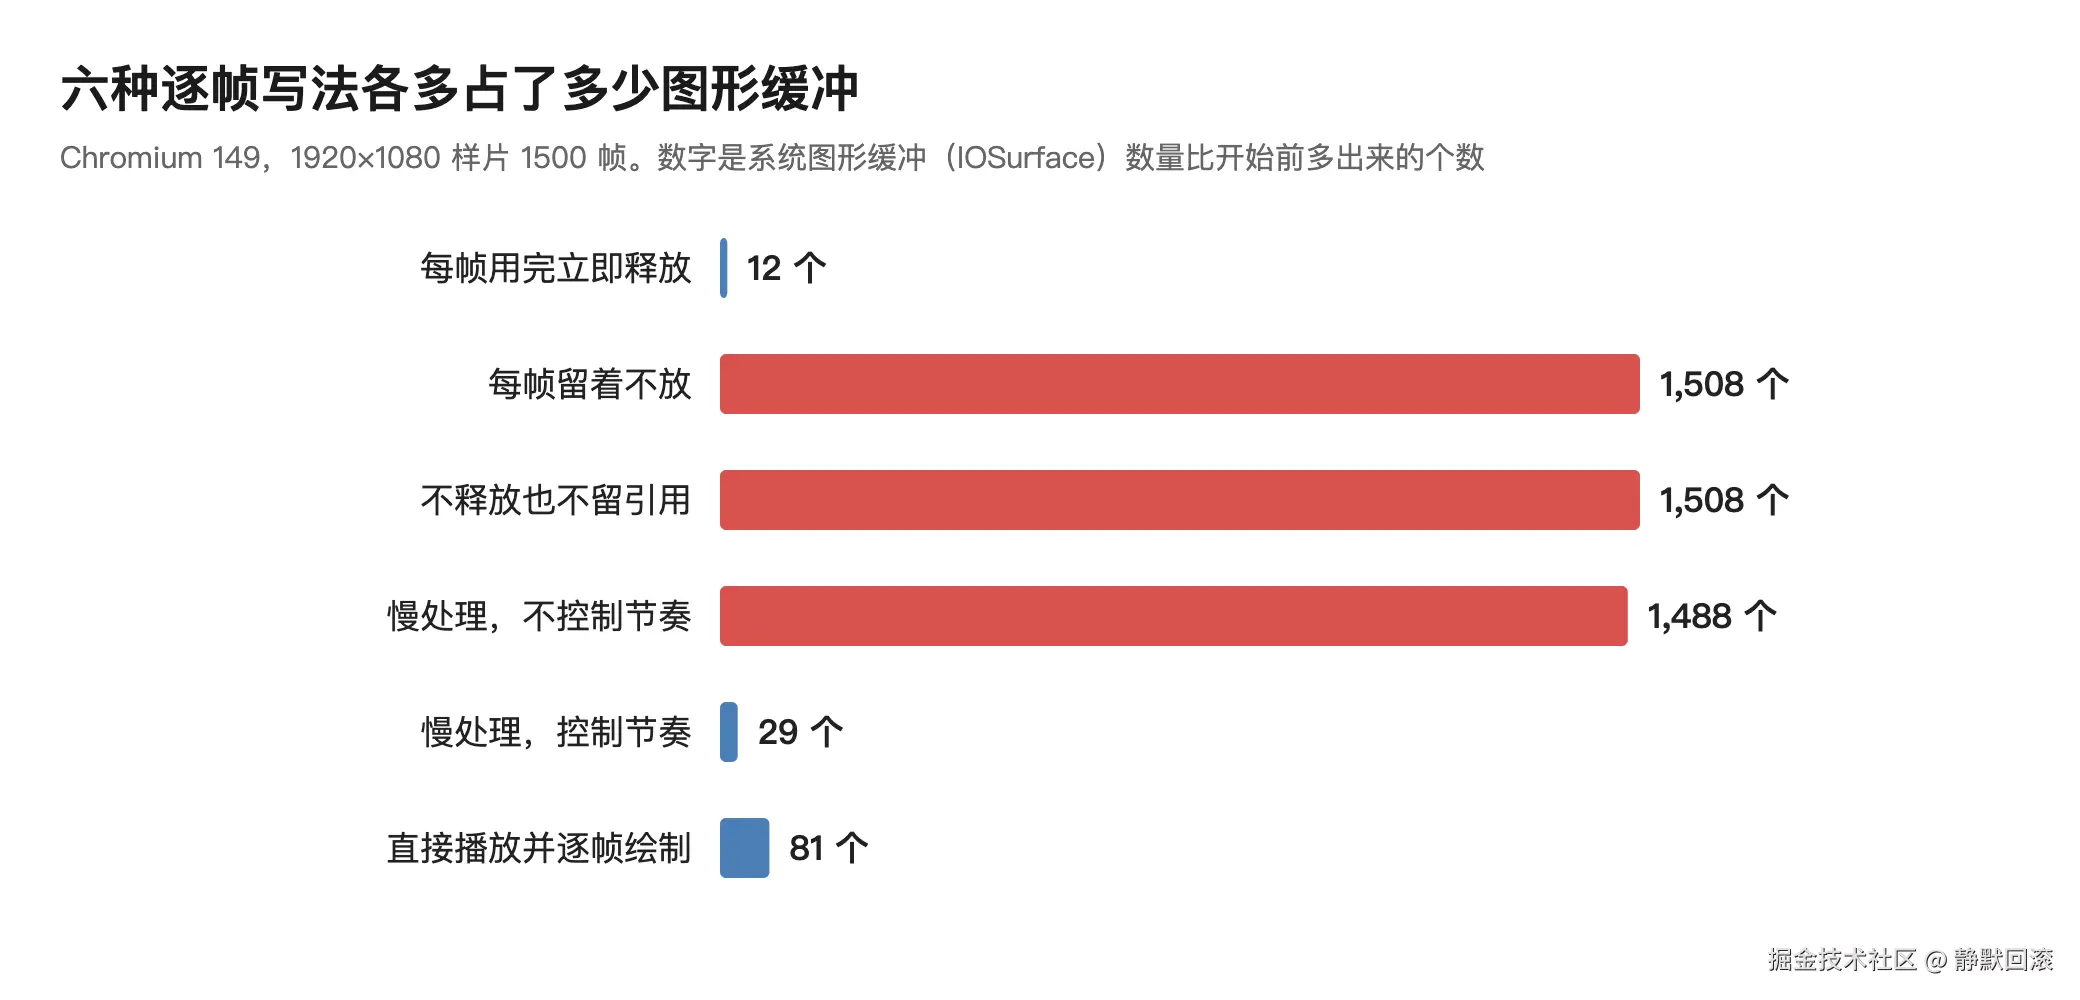
这张图把 Chromium 149 里的六种写法放在了一起,横条越长,多占的图形缓冲越多。先看红色的三条:留着不放和丢掉引用都是 1508 个,慢处理不控制节奏是 1488 个,后一种是下一章的主角。蓝色的三条都很短,立即释放 12 个,慢处理控制节奏 29 个,最下面那条 81 个是另一种做法,用 video 标签直接播放 20 秒,每播一帧往画布上画一次,一共画了 500 次。我把它也测了,是想知道浏览器自己播放视频时图形缓冲是什么量级。
六、每帧都释放了内存为什么还涨
前两章查的都是「忘了释放」。我的项目代码里每一帧都有 close,按说不该有事。可真实的处理不像基线那样拿到就放,中间有活要干,这一章查的就是这个差别。
6.1 处理慢时待处理的帧排到1421个
我把测试页改得更像真实情况:每帧先画到一块小画布上,读一个像素,再等 10 毫秒,最后才 close。这 10 毫秒用来模拟「处理一帧要花的时间」。喂数据的方式也换成最省事的那种,把 1500 份压缩数据一口气全交给解码器,不看它忙不忙。
js
// 慢处理:每帧画到小画布、读一个像素、等 10 毫秒,再释放
// paced 为 true 时控制喂数据的节奏,为 false 时一口气喂完
async function slowRun({ packets, setup }, paced) {
  const brush = document.querySelector('canvas')
    .getContext('2d', { willReadFrequently: true });
  const waiting = [];            // 解码出来、还没轮到处理的帧
  const stat = { got: 0, handled: 0, maxWaiting: 0, maxInDecoder: 0 };
  const startedAt = performance.now();
  let pouring = true;

  const dec = new VideoDecoder({
    output: (frame) => {
      stat.got++;
      waiting.push(frame);
      stat.maxWaiting = Math.max(stat.maxWaiting, waiting.length);
    },
    error: (e) => { stat.failed = String(e); },
  });
  dec.configure(setup);

  const worker = (async () => {
    while (pouring || waiting.length) {
      const frame = waiting.shift();
      if (!frame) { await pause(2); continue; }
      brush.drawImage(frame, 0, 0, 320, 180);
      brush.getImageData(0, 0, 1, 1);
      await pause(10);
      frame.close();
      stat.handled++;
    }
  })();

  let sent = 0;
  for (const p of packets) {
    if (paced) {
      while (dec.decodeQueueSize > 8 || waiting.length > 4) await pause(2);
    }
    dec.decode(new EncodedVideoChunk({
      type: p.isKey ? 'key' : 'delta',
      timestamp: p.at,
      duration: p.span,
      data: p.bytes,
    }));
    stat.maxInDecoder = Math.max(stat.maxInDecoder, dec.decodeQueueSize);
    if (++sent % 20 === 0) await pause(0);
  }
  await dec.flush();
  pouring = false;
  await worker;
  stat.ms = Math.round(performance.now() - startedAt);
  return stat;
}
text
slowRun(clip, false)   不控制节奏,Chromium 149,1080p 样片
输出 1500 帧,处理并释放 1500 帧
待处理帧峰值 1421,解码队列峰值 1000,用时 20.3 秒
进程内存增量 0 MB,系统内存增量峰值 3752 MB,图形缓冲增量峰值 1488

时间(秒)   待处理的帧
0.3        360
1.3        1403
5.3        1106
10.3       737
15.3       372
20.3       4
代码说明:pause 和 loadClip 是 3.1 节里定义的,调用时传进来的 clip 就是 loadClip 的返回值。waiting 是一个数组,当队列用,队列就是先进来的先处理的一条队伍。解码器每交回一帧就排到队尾,worker 那个循环每次从队头取一帧来处理,处理完才 close。paced 这个开关这一节传的是 false,循环里那句 while 不会执行。每喂 20 份歇一下的那句 pause(0),是为了让 worker 有机会插进来干活。
看输出。按页面里每四分之一秒记一次的进度,开跑 1.3 秒时 1500 帧已经全部解出来了。处理这边每帧光等待就是 10 毫秒,跟不上。解出来没处理的帧只能在 waiting 里排着,最多排到 1421 个。之后的二十秒就是慢慢消化这条长队。每一帧我都 close 了,一帧没漏,可它在轮到自己之前一直占着地方。
我给这件事打的比方是追番。新番一口气把整季都缓存下来,可我一晚上只看得完一集,硬盘先被没看的那些集占住了。每一集看完我都删,一集没漏,硬盘在头几天照样是满的,因为下得比看得快。
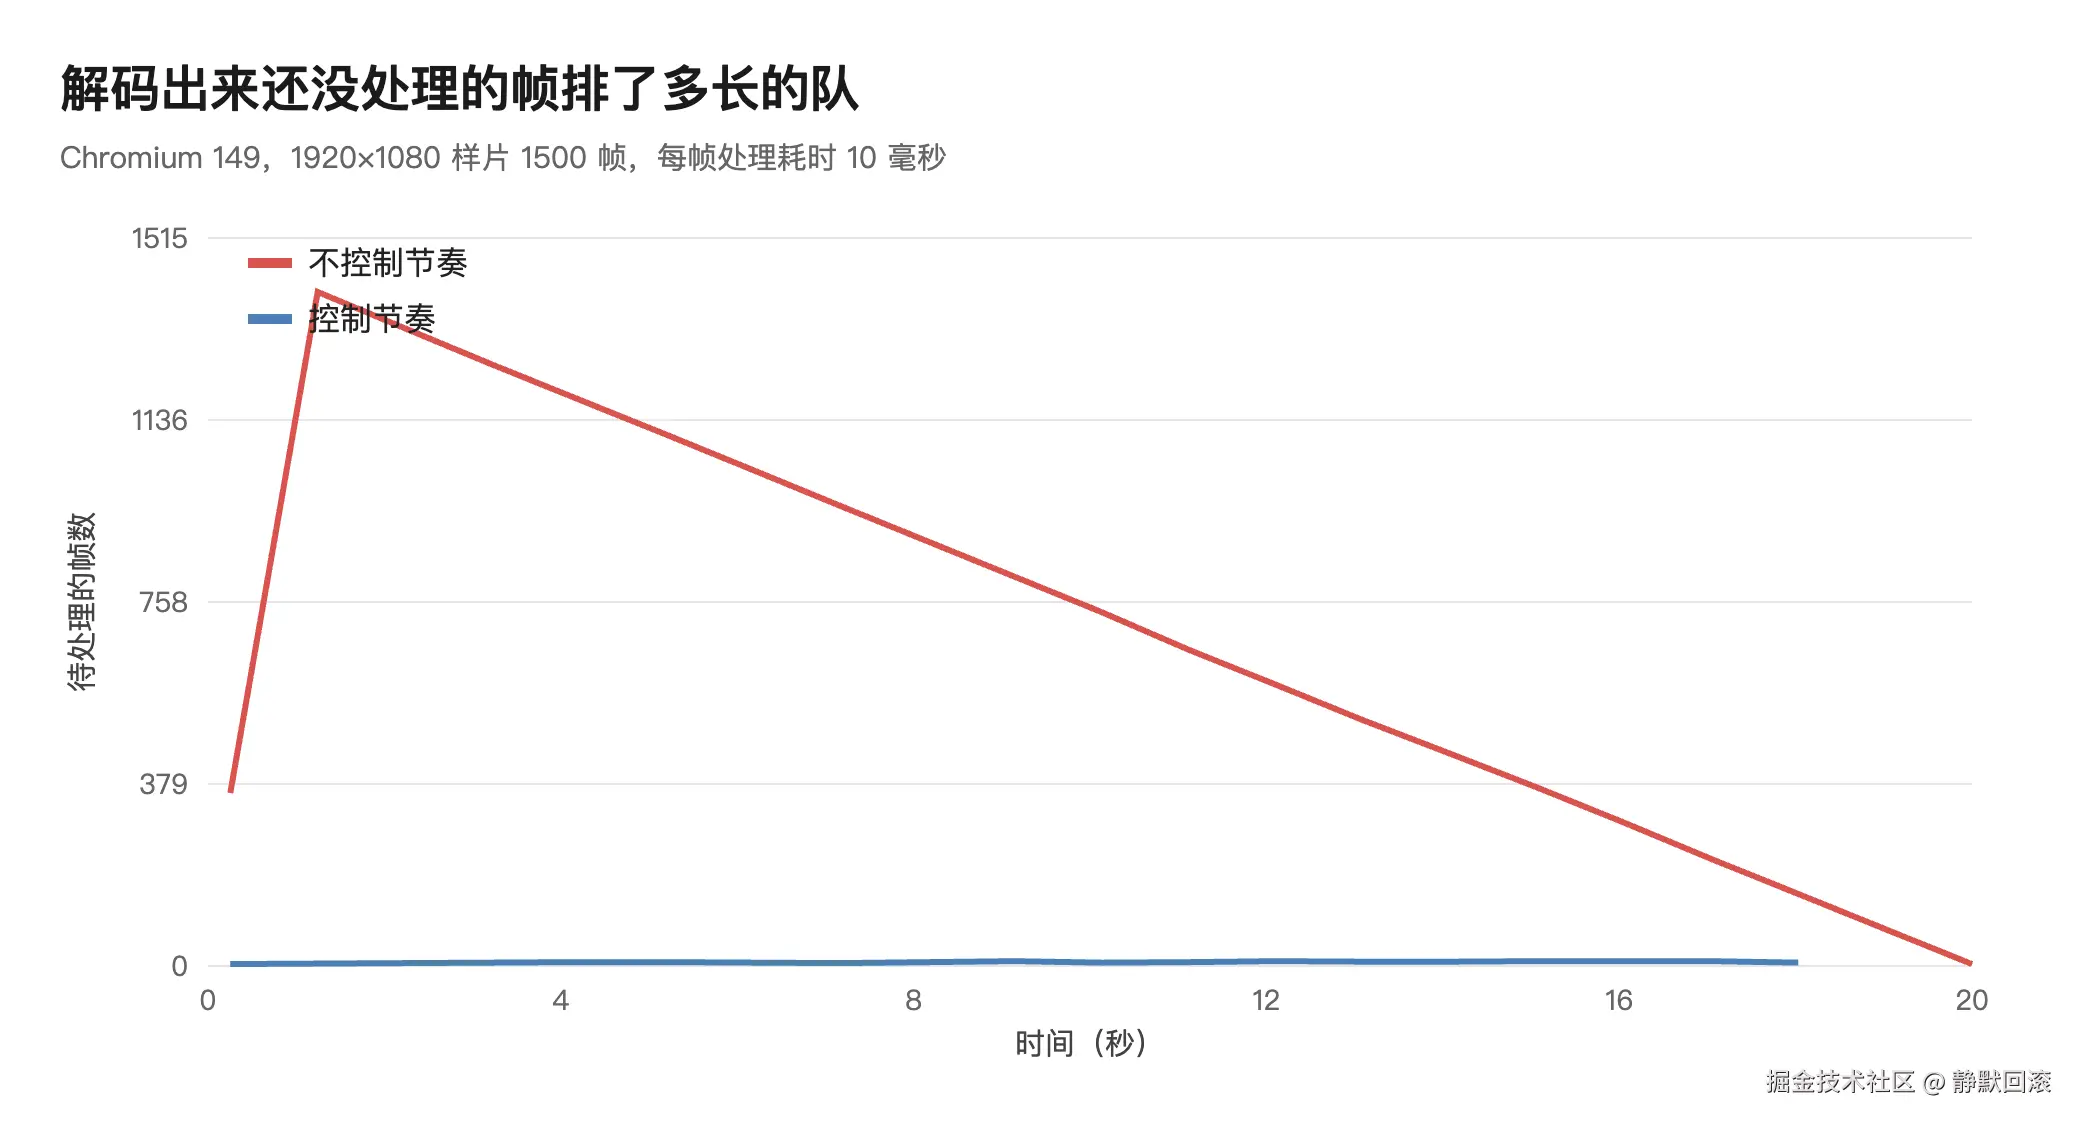
图上横轴是时间,纵轴是排队等处理的帧数。红线是不控制节奏:一秒多一点冲到 1403,然后沿着一条斜线降下来,20 秒时剩 4 个。蓝线是下一章要讲的控制节奏,它全程贴着横轴,在这个刻度下几乎看不出起伏。两条线跑的是同一份样片、同样的每帧 10 毫秒。
6.2 队伍排空后图形缓冲没有跟着降
还有一个现象我没想到。待处理的帧从 1403 一路降到 4,按一帧一个图形缓冲的对应关系,图形缓冲也应该跟着降。实际上它全程在 1430 到 1490 之间,没有跟着队伍往下走,一直到浏览器退出才回落。
在 Chromium 149 里,帧 close 之后,图形缓冲的个数没有马上减少。原因我没去查。close 还是得调,只是调完读数不会立刻好看。对我的项目来说这反倒让结论更简单:别让队伍排起来。等它排起来再靠 close 一帧一帧消化,从图形缓冲的个数上看是来不及的。
七、逐帧解码怎么控制节奏
既然问题出在喂得太快,办法就是喂慢一点。可慢到什么程度、看什么来决定快慢?上一段代码里留了个 paced 开关,现在把它打开。
7.1 队伍超过上限就先不喂数据
从压缩数据到处理完,中间其实有两条队伍。第一条在解码器里面,是交给它还没解的数据,长度就是 decodeQueueSize。第二条在我自己手里,是解出来还没处理的帧,也就是 waiting 数组的长度。
控制节奏的写法只有一行,就是 slowRun 里那句 while:解码器里的队伍超过 8,或者我手里的队伍超过 4,就先等 2 毫秒,等到两条队伍都短下来再喂下一份。这种「后面处理不过来,就让前面慢下来」的做法有个名字,叫背压。
为什么两条都要看?第三章的基线只看了解码器里那一条,照样很稳。我补跑了一次:处理还是每帧 10 毫秒,喂数据时只看 decodeQueueSize,不管手里排了多少。结果解码器里的队伍稳稳停在 9,待处理的帧照样排到 1401 个,图形缓冲多了 1549 个,和完全不控制时差不多。基线能稳是因为它拿到帧就放,手里那条队伍根本排不起来。
8 和 4 这两个数不是我算出来的。我直接定了这两个值,没有换别的值对比过,取大一点或小一点各有什么代价,这次没有测。
7.2 控节奏后待处理帧最多17个
text
slowRun(clip, true)    控制节奏,Chromium 149,1080p 样片
输出 1500 帧,处理并释放 1500 帧
待处理帧峰值 17,解码队列峰值 9,用时 18.9 秒
进程内存增量 135 MB,系统内存增量峰值 165 MB,图形缓冲增量峰值 29

时间(秒)   待处理的帧
0.3        4
5.3        8
10.3       7
15.3       10
18.3       7
同样的样片,同样的每帧 10 毫秒,待处理的帧最多 17 个,图形缓冲最多只多 29 个。系统内存增量的峰值是 165 MB,不控制节奏时是 3752 MB,相差约 3.6 GB。和第三章的基线比,29 对 12,165 MB 对 102 MB,已经是同一个量级了。
有一处我没搞懂。上限我写的是 4,采样里看到的也一直是个位数到 10,峰值却记到了 17。多出来的那十来帧是怎么冒出来的,我没有去查,先把现象记在这里。
7.3 两种写法总用时接近
动手之前我有个担心:喂一下停一下,会不会把总时间拖长。这次量到的是不控制节奏 20.3 秒,控制节奏 18.9 秒,两个数接近。这个对比我只敢读到这一步。每种只跑了一次,我也没有量过帧率,不能据此说哪种更快。能说的是在这份样片上,控制节奏没有让总用时变长,内存少占了几个 GB。对我来说这已经够下决定了。
八、四个浏览器的内存读数为什么对不上
前面几章全是 Chromium 149。我的项目不能只在一个浏览器里跑,就把立即释放、留着不放、丢掉引用这三种在另外三个浏览器里各跑了一遍。先说一句前提:四个浏览器都有 VideoDecoder,都回报支持这段 H.264,1500 帧都能解完。
| 浏览器 | 进程内存增量(立即释放 / 留着不放 / 丢掉引用) | 系统内存增量峰值 | 图形缓冲增量峰值 |
|---|---|---|---|
| Chromium 149 | 186 / 138 / 0 MB | 102 / 2694 / 3316 MB | 12 / 1508 / 1508 |
| Chrome 154 | 195 / 149 / 143 MB | 151 / 1604 / 2810 MB | 46 / 1510 / 1589 |
| Firefox 151 | 163 / 2291 / 2221 MB | 39 / 2116 / 2132 MB | 5 / 7 / 7 |
| WebKit 26.5 | 测不到 | 109 / 2358 / 107 MB | 19 / 1510 / 32 |
8.1 Firefox 151把帧算在进程内存里
Firefox 151 那一行和别人是反着的。留着不放时,它的进程内存涨了 2291 MB,丢掉引用时涨了 2221 MB,图形缓冲却只多了 7 个,和立即释放时的 5 个差不多。
在 Firefox 151 里我最初的看法倒是对的:帧没释放,进程内存就会涨上去,浏览器任务管理器里一眼能看到。在 Chromium 149 里同样的看法就是错的。同一段代码、同一个毛病,换个浏览器要看的读数完全不同。
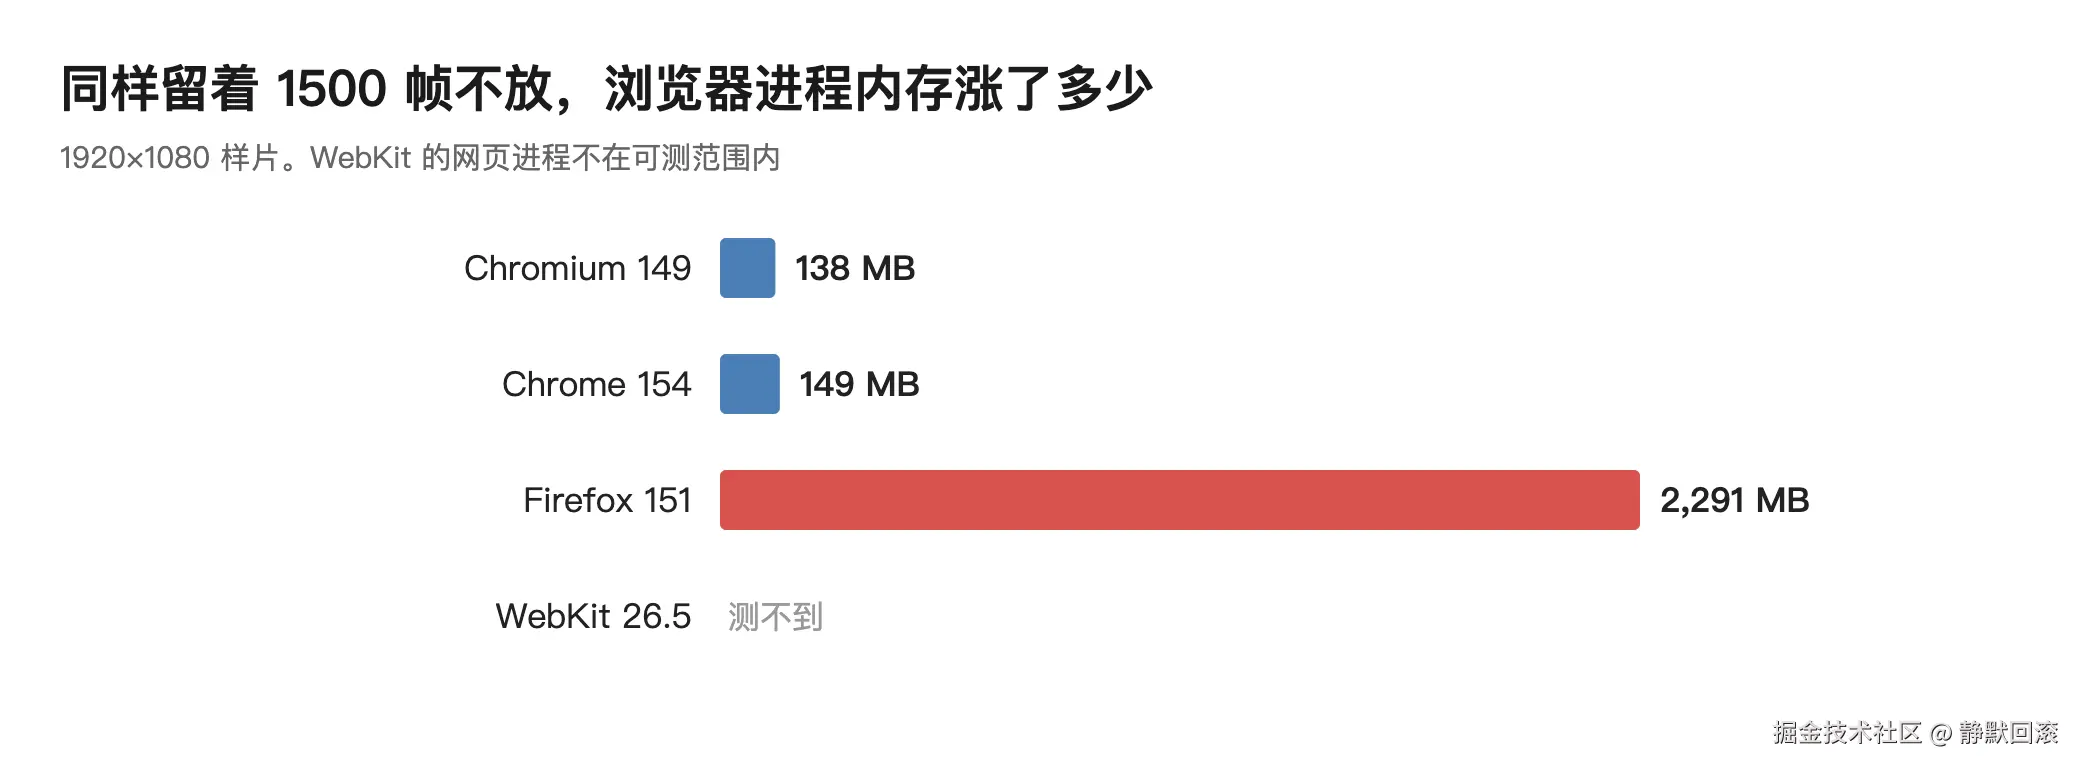
这张图只画了留着不放这一种情况下的进程内存。Chromium 149 是 138 MB,Chrome 154 是 149 MB,两根短条几乎一样。Firefox 151 那根红条是 2291 MB,长出去十几倍。WebKit 26.5 那一行写的是测不到,原因在下一节。
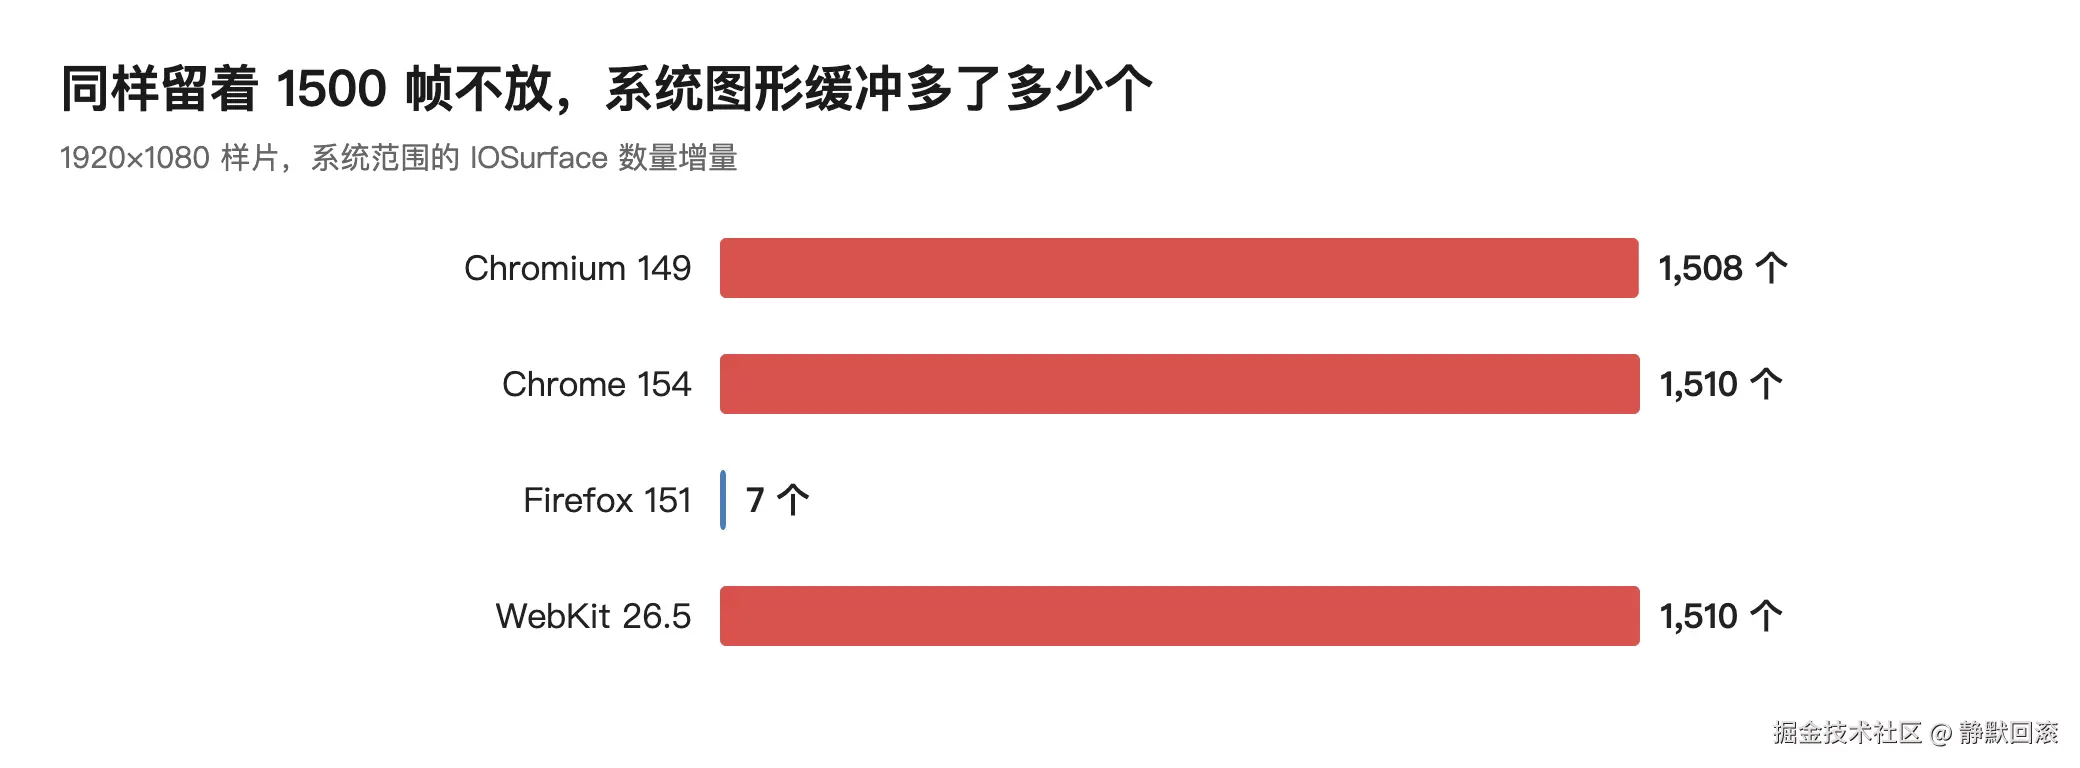
这一张换成了图形缓冲的个数,形状正好和上一张相反。Chromium 149 多了 1508 个,Chrome 154 和 WebKit 26.5 都是 1510 个,Firefox 151 只有 7 个。两张图要放在一起看:每个浏览器都在其中一张图上有一根长条,只是不在同一张上。只看其中一个读数,总有浏览器会被漏掉。
8.2 WebKit 26.5丢掉引用后会回收
WebKit 26.5 有两处和别人不同。第一处是进程内存测不到。它的网页进程不在我能顺着主进程找到的那棵进程树里,1.3 节那个把子进程加起来的办法对它无效,表里那一格只能空着。它的图形缓冲和系统内存是能读到的,留着不放时图形缓冲多了 1510 个,系统内存多了 2358 MB。
第二处是丢掉引用。在 WebKit 26.5 里,不 close 也不留引用的帧在 6 秒内被回收了,图形缓冲只多了 32 个,系统内存只多了 107 MB,和立即释放差不多。同时控制台打印了一行警告,原文是「A VideoFrame was destroyed without having been closed explicitly」,意思是有一帧没有被明确 close 就被销毁了。Chromium 149、Chrome 154、Firefox 151 这三个在同样的 6 秒里都没有回收,控制台也没有任何提示。四个浏览器里只有这一个会替我收,还顺便提醒了我。可我不能因此不写 close,另外三个不收。
8.3 Chrome和Chromium读数相近
Chrome 154 的三种读数和 Chromium 149 相近:留着不放时图形缓冲多了 1510 个,进程内存只涨 149 MB。有一处小差别,丢掉引用时 Chromium 149 的进程内存增量是 0 MB,Chrome 154 是 143 MB,这个差别我没有去追。
慢处理的两种写法我在 Chrome 154 里也各跑了一次。不控制节奏时待处理的帧最多 1430 个,图形缓冲多了 1487 个,系统内存增量 3088 MB。控制节奏之后这三个数变成 17 个、33 个和 123 MB。和 Chromium 149 的结论一致。Firefox 151 和 WebKit 26.5 的慢处理我没有跑。
回头看这一章的问题,读数对不上是因为帧记在了不同的地方。Chromium 149、Chrome 154 和 WebKit 26.5 记在系统的图形缓冲里,Firefox 151 记在浏览器进程自己的内存里。至于各家为什么这么安排,我没有去查。
九、4K视频逐帧处理内存会怎样
画面大四倍,事情会不会只是数字乘四?我用河道那段 4K 样片在 Chromium 149 里把几个场景又跑了一遍。先说明,为了保护电脑,有的场景没敢把 990 帧喂完。
| 场景 | 喂入帧数 | 进程内存增量 | 系统内存增量峰值 | 图形缓冲增量峰值 | 待处理帧峰值 |
|---|---|---|---|---|---|
| 立即释放 | 990 | 583 MB | 656 MB | 35 | --- |
| 留着不放 | 300 | 0 MB | 4546 MB | 320 | --- |
| 慢处理不控节奏 | 400 | 0 MB | 5553 MB | 595 | 332 |
| 慢处理控节奏 | 400 | 161 MB | 624 MB | 101 | 16 |
9.1 超高清一帧推算约12.4 MB
4K 的一帧我没有单独去读 allocationSize。按 2.1 节的算法,3840 乘 2160 再乘 1.5 是 12,441,600 字节,约 12.4 MB,是 1080p 一帧的四倍。这是推算出来的数,不是量出来的。
立即释放那一行说明规矩的写法在 4K 上也稳。990 帧全部喂完,图形缓冲最多多 35 个,用时 1.76 秒。系统内存增量的峰值是 656 MB,比 1080p 基线的 102 MB 高出一截,同样只能看量级。
9.2 留着不放的场景只喂了300帧
留着不放我只喂了 300 帧就停手。这 300 帧让图形缓冲多了 320 个,系统内存增量峰值 4546 MB。对比一下 1080p:那边留了 1500 帧,系统内存增量是 2694 MB。4K 只用了五分之一的帧数,占掉的更多。
同样的 300 帧我在 Chrome 154 里也跑了一次,系统内存增量到了 6787 MB,碰到了 6000 MB 的保护线。4546 和 6787 差得不少,这还是那个老问题,系统内存的读数两次之间能差出 1 GB 以上。两次都说明同一件事:4K 的帧留不了多少。
慢处理不控制节奏我喂了 400 帧,待处理的帧最多排到 332 个,图形缓冲多了 595 个,系统内存增量峰值 5553 MB,离保护线已经很近。这里有个数我对不上:排队的帧是 332 个,图形缓冲却多了 595 个,比 1080p 时一帧一个的对应关系多出不少。为什么会多,我没查。
9.3 控节奏后图形缓冲多101个
控制节奏同样喂 400 帧,待处理的帧最多 16 个,图形缓冲多 101 个,系统内存增量峰值 624 MB,和 4K 立即释放的 656 MB 差不多。用时方面,控制节奏是 5.7 秒,不控制是 6.5 秒,还是接近。
4K 的结论和 1080p 方向一致,只是留给我犯错的余地小得多。1080p 忘了控节奏,1500 帧排起来,系统内存多占三千多 MB。4K 才排三百多帧就到五千多 MB 了,离我设的 6000 MB 保护线只差几百。
十、现成的逐帧流水线内存是什么样
第三章提过,我拿一个在线抠像工具当了第二条基线。它做的事情比我的测试页多得多,要逐帧解码、逐帧推理、合成背景再编码。前面查出来的两个毛病要是出在这样一条完整的流水线上,图形缓冲会越跑越多。它的曲线是不是这样,我记了一遍。
10.1 全程图形缓冲最多多出79个
我在 Chromium 149 里打开它,选了那份 1500 帧的 1080p 海浪样片。模型选的是「兼容」档,背景用纯色,输出 MP4,其余保持默认。任务跑完,界面显示「视频处理完成」。处理期间我每 2 秒记一次读数,一共记了 104 次。
| 读数 | 最小 | 最大 | 中位 | 前三分之一平均 | 后三分之一平均 |
|---|---|---|---|---|---|
| 图形缓冲数量增量 | −2 | 79 | 26 | 35 | 25 |
| 系统内存增量 | −42 MB | 724 MB | 272 MB | 462 MB | 285 MB |
| 进程内存增量 | 69 MB | 798 MB | 329 MB | 572 MB | 283 MB |
三个读数都没有随进度往上走,后三分之一的平均值比前三分之一还低。1500 帧处理下来,图形缓冲最多只多出 79 个。拿它和前面的数比:不控制节奏时是 1488 个,控制节奏时是 29 个,用 video 标签直接播放时是 81 个。它落在「几十个」这一档里。
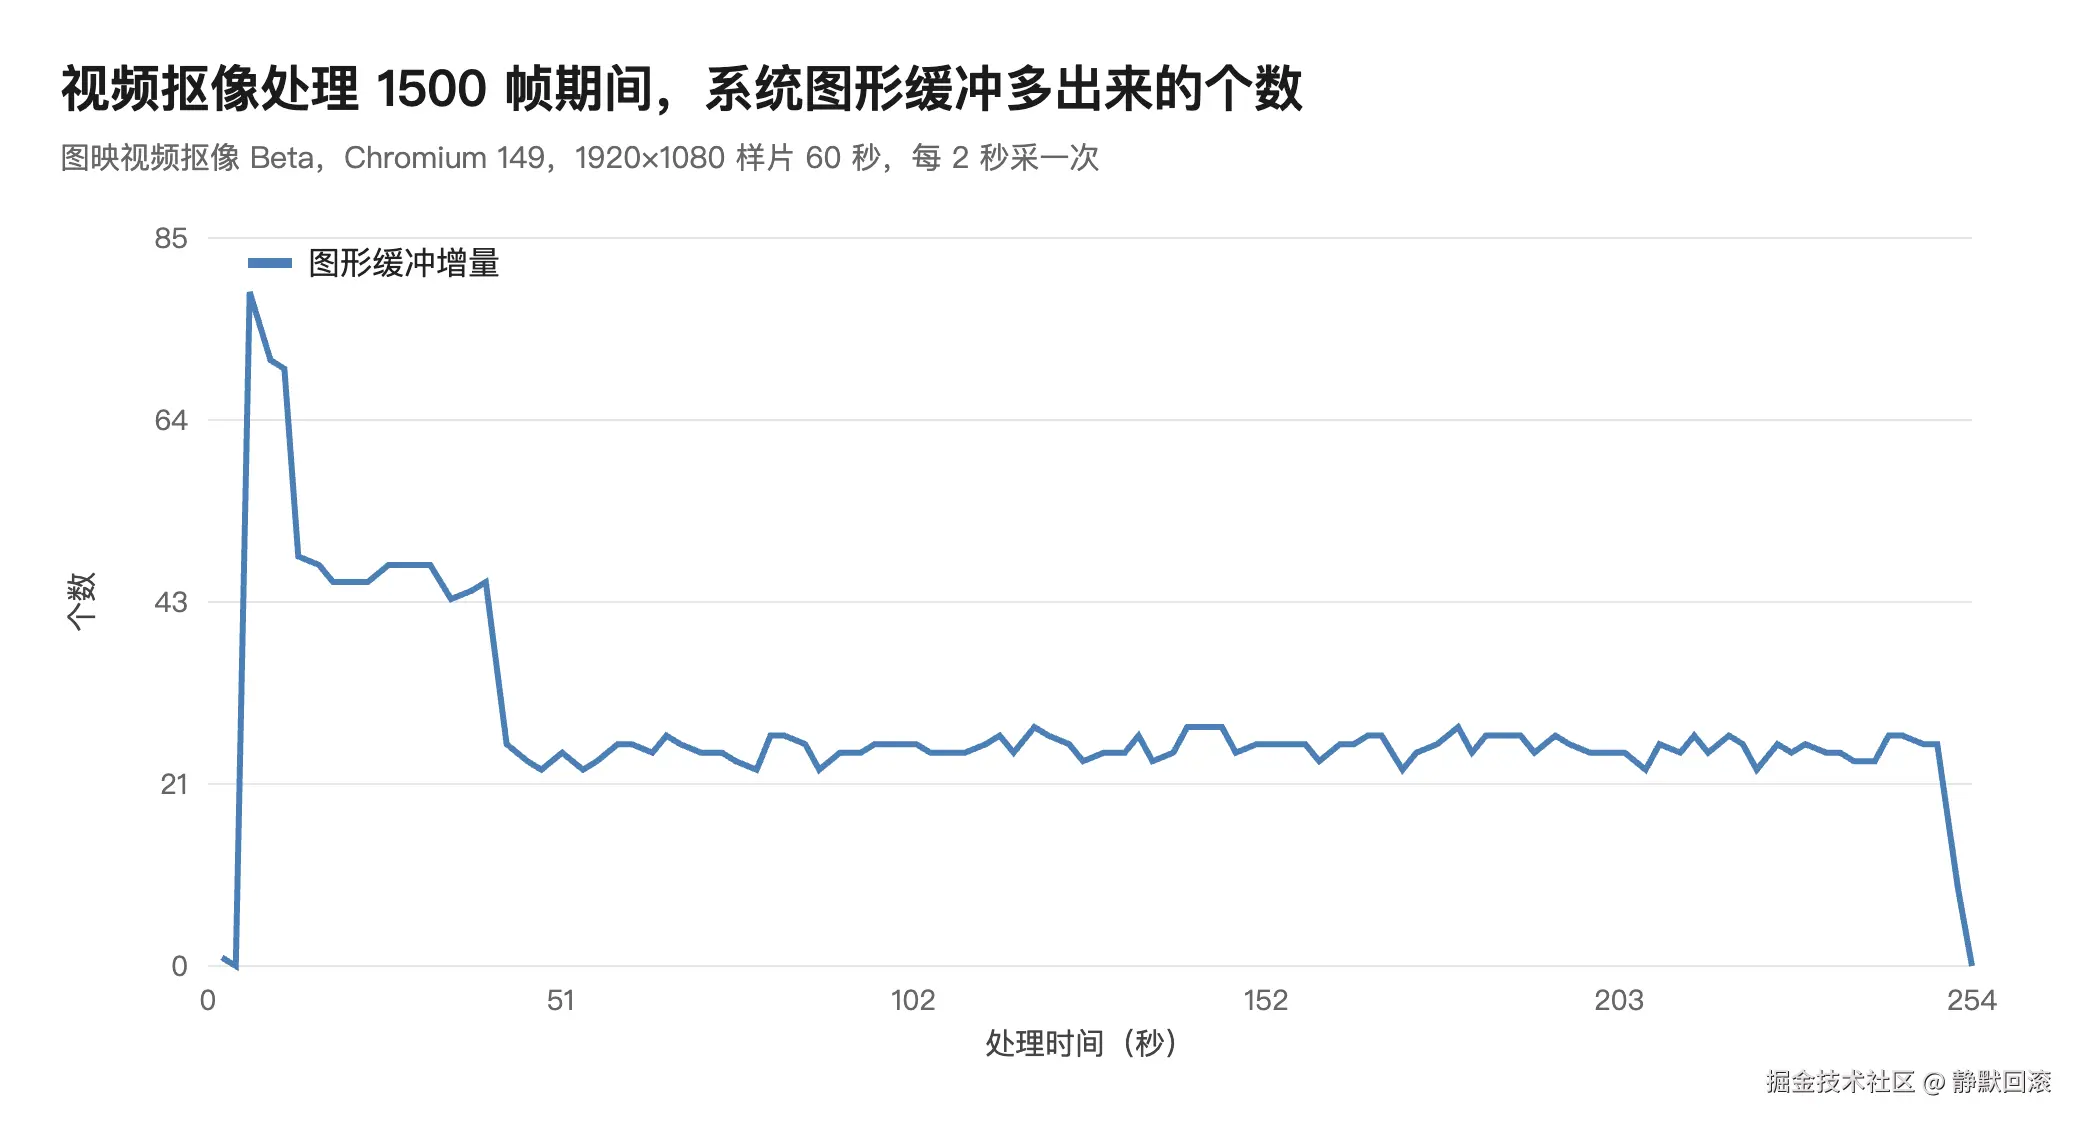
这张图的横轴是处理进行的时间,纵轴是图形缓冲比开始前多出来的个数。开头有一个尖,最高到 79 个,四十多秒之后落到二十多个,然后一直是一条带小毛刺的平线,到最后收尾才掉回开始前的水平。要看的就是这条线的形状:它是平的,没有随着处理的帧越来越多往上爬。
它内部有没有 close、有没有控制节奏,我看不到,也不打算猜。我能说的只有读数:一条跑完整流程的逐帧流水线,在这份样片上图形缓冲是平稳的。这给了我一个参照,自己的项目写完之后,图形缓冲的曲线应该长成这个形状。
10.2 这次对照说明不了抠像效果
这一节是给上面那段话划边界的。海浪样片里没有人物,界面底栏显示的是「主体 0.0%」,输出的成品整幅都是纯色背景。这次它没有抠出任何东西,我测到的只是画面里没有主体时这条流水线的内存表现。抠得好不好、边缘干不干净,这次完全没有涉及。
范围也很窄。我只跑了这一段 60 秒的 1080p、这一个档位、这一次,更长的片子、4K、别的模型档都没有测。处理花了多久我记了,但那只是这台电脑这一次的读数,不拿来说明快慢。
十一、我的项目里逐帧处理怎么写
查到这里,该回到自己的代码了。下面三条是我给项目定下的做法,每一条后面都对着前面某一章的数字。
11.1 每一帧只留一条释放的路
第四章和第五章告诉我两件事:帧不 close 会一直占着,指望浏览器自己收在四个浏览器里只有一个靠得住。我定的规矩是,一帧从解码器交到我手上开始,到 close 为止,中间不管走哪个分支、有没有抛错,最后都要经过同一句 close。处理的代码我打算包进 try 和 finally 里,把 close 放在 finally 那一段。这个写法这批实验里没有单独测,是我照着前面的读数给自己定的规矩。
我考虑过另一种写法,把帧存起来,等整段处理完再统一释放,这样代码最好写。可 1080p 留 1500 帧,系统内存就多出两千多 MB,4K 留 300 帧是四千多 MB,这条路我没选。
11.2 喂数据前先看两条队伍
第六章告诉我每帧都 close 也不够,第七章又告诉我只看解码器那一条队伍也不够。我的喂数据循环里现在固定有一句等待,条件就是 7.1 节那两个:解码器里排着的超过 8 份,或者我手里没处理的超过 4 帧,就先不喂。
两个数我照搬了测试里的值。它们在 1080p 和 4K 两份样片上都把待处理的帧压在了十几个,用时也没有变长,对我的项目够用了。将来处理一帧的时间要是变长很多,这两个数要不要改,到时候再量。
如果需求只是「看到每一帧的画面再画点东西」,不需要自己掌握解码的节奏,那用 video 标签播放、每帧往画布上画一次也是条路。我测的那 20 秒里它的图形缓冲只多了 81 个,节奏由浏览器自己管。我的项目要逐帧导出,用不了这条路。
11.3 自查时数系统的图形缓冲
最后是怎么知道自己写对了。第四章之后我不再拿浏览器任务管理器里的数字当证据。在 macOS 上我的做法是开跑之前在终端里执行一次 ioclasscount IOSurface,记下个数,处理过程中隔几秒再执行几次,看多出来多少。
判断的尺子就是前面量到的几个数。立即释放多 12 个,控制节奏多 29 个,直接播放多 81 个,都是几十个的量级。留着不放和不控节奏是一千四五百个,而且会跟着帧数涨。所以我看两点:增量是不是停在几十个,以及片子换长一倍之后它有没有跟着翻倍。4K 的数会大一些,控制节奏时是 101 个,判断方法一样。
用 Firefox 的时候换一个读数。它的图形缓冲几乎不动,要看的是进程内存,留着不放时它会涨出两千多 MB。
十二、适用边界与风险
上面的做法有几处是踩在很窄的实验上的,照搬之前要知道它们的边界。
所有数字来自一台 16 GB 的 Apple M4。内存更小的机器上会怎样,我没有测。这批实验里没有测到页面崩掉的情况,加压到系统多占 7557 MB 时解码器仍在正常工作,但这不等于继续加下去也没事。我也没有量帧率,「处理会不会变慢」这个问题这篇回答不了。
图形缓冲这个读数只在 macOS 上有。Windows、Linux 和手机上,Chromium 把解码出来的帧放在哪里、用什么命令能数出来,我都不知道。11.3 节的自查方法换个系统就得重新找读数。
样片的局限有三条。它是循环拼接的,系统内存增量可能比真实长片偏低。它只有 H.264 一种编码,VP9、AV1、HEVC 都没测。我没有区分这次走的是硬件解码还是软件解码,这两种情况下帧放的地方会不会不同,不清楚。
丢掉引用那个场景只观察了 6 秒。「Chromium 不会自己回收」这句话要带着这个时间限定来读。
十三、测量方法的坑
这几个坑都是量的过程里碰到的,和代码怎么写无关,但踩中任何一个都会得出错的结论。
头一个坑是采样停得太早。1500 帧不到一秒就解完了,我半秒才记一次数,要是解完立刻停止记录,只来得及记上一两次,很可能错过峰值。后来我改成解码结束后再保持 6 秒才停,1508 这个数是这样才稳定记到的。留着不放的帧只有在页面还留着它们的时候才看得到,浏览器一关就全没了。
系统内存这个读数本身也是坑。它是整台电脑的数,别的程序一动它就跟着动。测试前交换区已经用掉约 10.7 GB,读数自己有几百 MB 的起伏,同一个场景两次能差 1 GB 以上。文中凡是两个系统内存数字相差不到 1 GB 的,我都没有拿来比大小。
加压那次的记录里有个容易读错的数:图形缓冲有一段稳定在 3620 个上下。这是系统里当时的总个数,开跑之前就已经有几百个了,减掉之后的增量是 2922 个。总数和增量混着读,会多算出好几百个。
图形缓冲的个数是全系统的计数,这一点也要留神。别的程序开个窗口、关个窗口都会让它变,所以增量会出现负数,第十章的表里就有 −2。另外它数的是个数,一个 1080p 的帧和一个 4K 的帧都算一个,我没有跨分辨率比过个数。
最后是进程内存。增量为 0 不代表没占内存。Chromium 149 的丢掉引用场景就是 0 MB,同时系统内存多了三千多 MB。再加上 WebKit 26.5 的网页进程根本不在我统计的进程树里,这个读数在四个浏览器里只有 Firefox 151 那一个能直接用。
十四、还没解决的
最想弄明白的是 6.2 节那件事。Chromium 149 里帧已经 close 了,图形缓冲的个数为什么不马上降,要等到浏览器退出才回落。这些缓冲之后会不会被新的帧重新用上,还是就这么空占着,我没有查,也还不知道该用什么办法查。
再就是时间。丢掉引用我只等了 6 秒。等一分钟、等十分钟,Chromium 和 Firefox 会不会收,值得补一次。
7.2 节的 17 也还挂着。上限写的是 4,峰值却是 17,4K 那次是 16。还有 4K 不控节奏时排队 332 帧、图形缓冲却多 595 个。这两处我都只有现象。还有一批是范围上的:真实的长视频而不是循环拼的,硬件解码和软件解码分开测,换一台不是 macOS 的电脑找到对应的读数。
手上有类似代码的话,可以先做一件小事:找一段一分钟左右的视频,按 11.3 节的办法在处理前后各数一次图形缓冲,再把片子换成两分钟的数一次。增量停在几十个就先不用动,跟着片长翻倍了,就按第四章和第六章的顺序,先检查有没有哪条路漏了 close,再检查喂数据前有没有看那两条队伍。
参考资料
- MDN:VideoDecoder、VideoFrame(close 与 allocationSize)、EncodedVideoChunk
- W3C WebCodecs:decodeQueueSize 与 flush
- MDN:video 元素的 requestVideoFrameCallback 方法
- mp4box.js 0.5.2 项目说明
- FFmpeg 7.1 文档:-stream_loop 与 libx264 参数
- macOS 命令手册:vm_stat、ps、ioclasscount
- 海浪那段样片的原片:Water waves in Herzliya beach.webm,Wikimedia Commons,David Shay(דוד שי),CC BY-SA 4.0
- 河道那段样片的原片:Kanamegawa - Hiratsuka - 2024 12 6.webm,Wikimedia Commons,Nesnad,CC BY-SA 4.0
- 实测数据:我 2026-10-12 在本机跑出来的记录,机器和版本见开头的「版本声明」