把一份带表格的 PDF 转成 Excel,是后台提得最多的需求之一。但多数人第一次认真看转换结果时都会愣一下:明明原表只有 3 列,转出来的 xlsx 却有 9 列,其中 6 列是空的;反过来,有些没有框线的表格又能转得整整齐齐。行列到底是靠什么对上的?这次我把一份真实的 PDF 拆开看了一遍,又用在线转换跑了一次,把这件事讲清楚。
一、PDF 文件里根本没有"表格"这个对象
先说结论:PDF 的文件结构里,不存在"表格"这种元素。Word 的 docx 里有 <w:tbl> 表格标签,HTML 里有 <table>,而 PDF 里只有两类东西和表格有关:
- 文本:一串带坐标的字符绘制指令。每个字符落在页面坐标系的哪个位置,是写入文件时就定死的;
- 线条:路径绘制指令,横线竖线无非是"从点 A 画到点 B"。
换句话说,你在阅读器里看到的表格,只是"一堆文字"和"一堆线段"恰好摆放得像表格。表格的行列关系、合并单元格的信息,在文件里一个字节都不存在。这也解释了为什么"复制 PDF 里的表格再粘贴到 Excel"经常乱成一团------粘贴板拿到的只是散装文字。
二、转换器重建表格的三步
既然文件里没有表格,转换器就只能"看图猜表",主流实现大致三步:
**第一步,找线。**把页面上的路径指令按方向分组,横向的归横线、纵向的归竖线。横竖线两两相交,交点围出来的封闭区域,就是候选单元格。
**第二步,落字。**遍历每个文本对象的坐标,看它落在哪个候选单元格的矩形范围内,就记到哪个格子里。字符的字号、行距在这里会被用来做行归并------同一行内 y 坐标接近的字符拼成一个单元格内容。
**第三步,拼行拼列。**把单元格按 y 坐标聚类成行、按 x 坐标聚类成列,输出二维网格。
这套流程决定了两件事:框线完整、横平竖直的表格最容易转;而没有框线的表格(比如用空白对齐排版的),第一步就没有线可找,只能退化为按文本坐标聚类去"猜"列边界,稳定性明显下降。很多在线转换工具会把"扫描件"单独列为一个选项,也是同一个原因------扫描件在 PDF 里只是一整张图片,连文字坐标都没有,必须先过 OCR 把图片变回文字,才有坐标可落格。
三、实测:逻辑 3 列,转出来 9 列
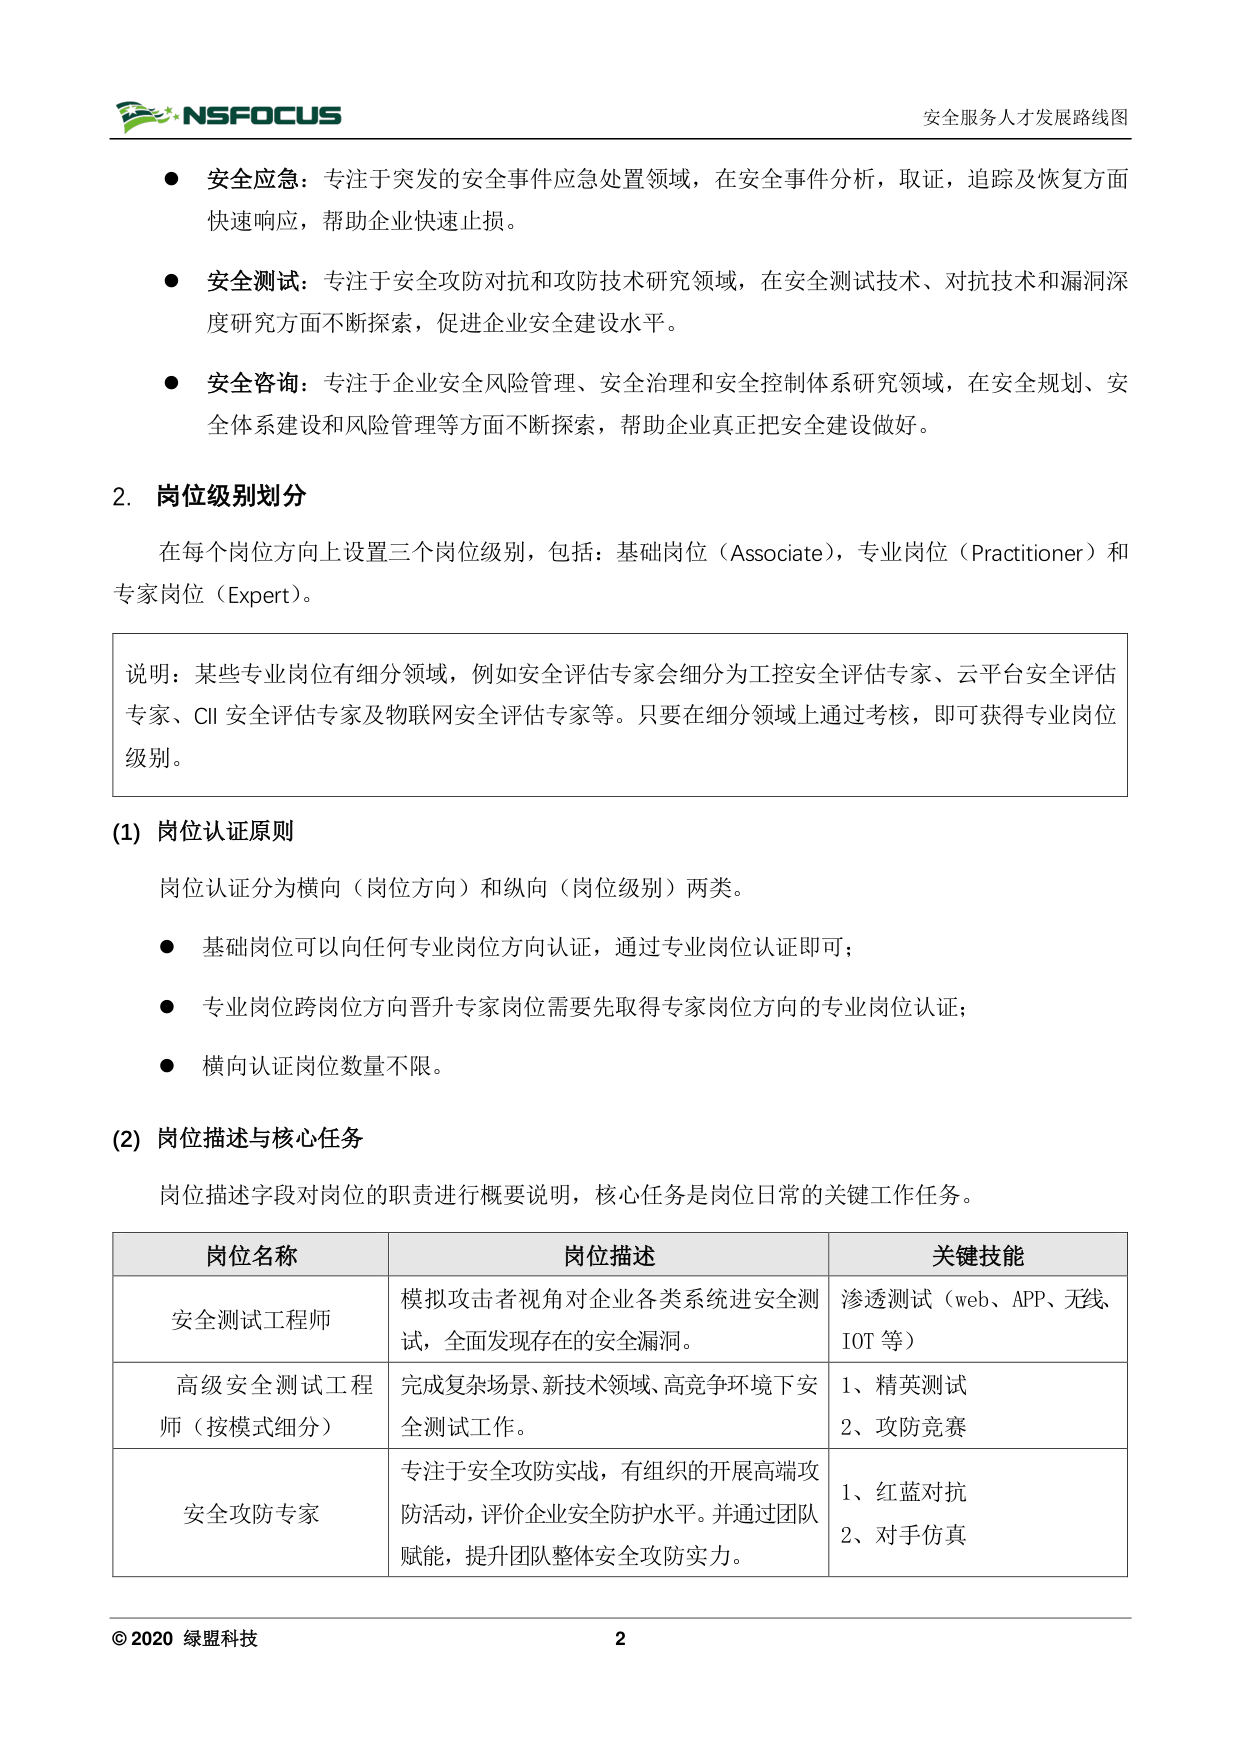
用一份真实的岗位表 PDF 来验证。这份 PDF 的第 4 页有一张表格,逻辑上是 3 列:岗位名称、岗位描述、关键技能,共 4 行(含表头)。
页码范围填 4,只转换这一页:
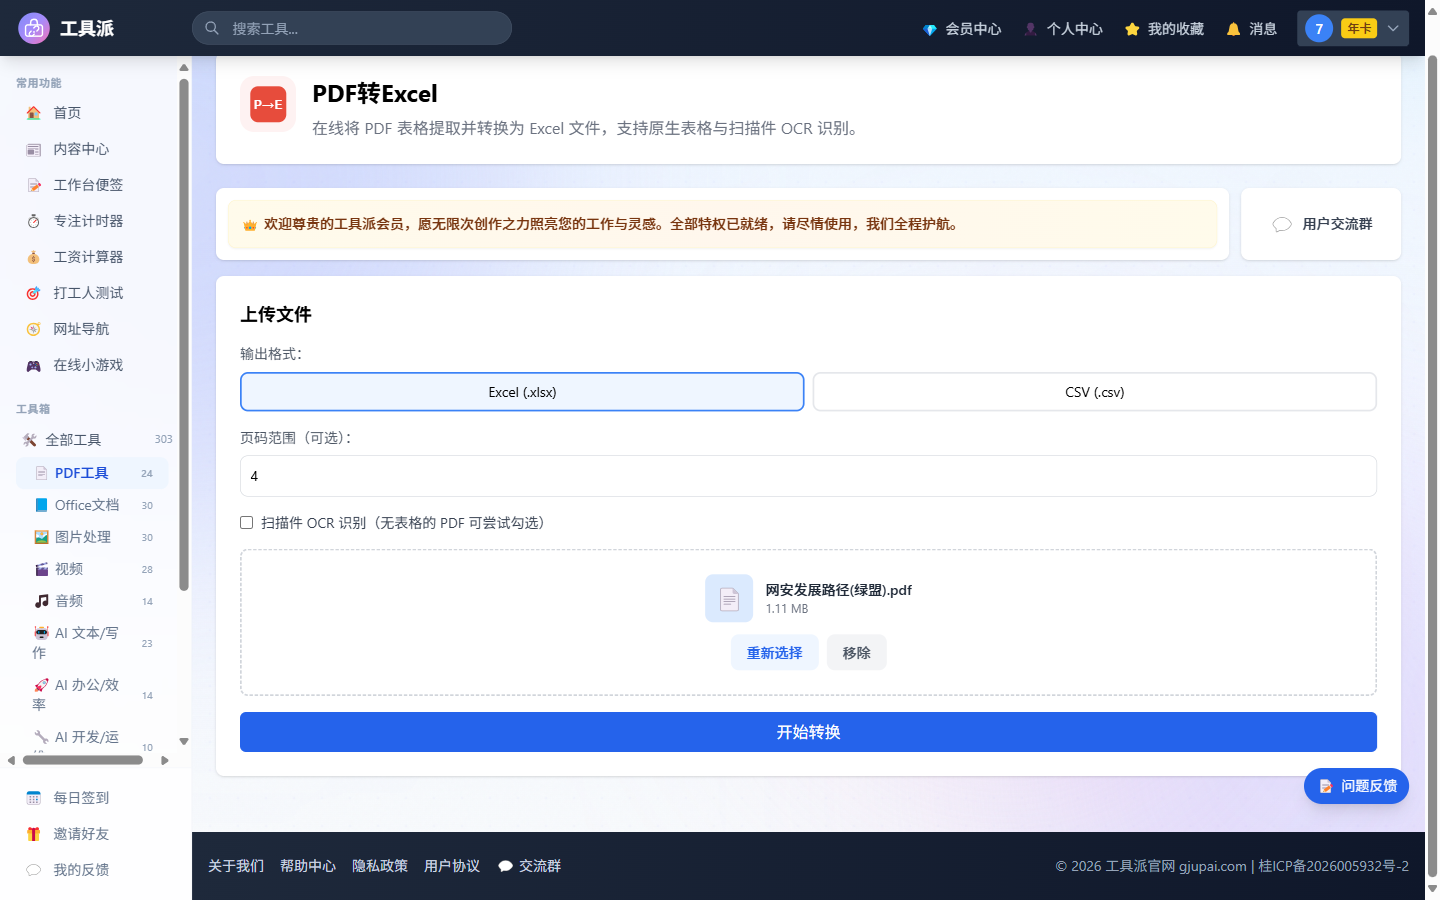
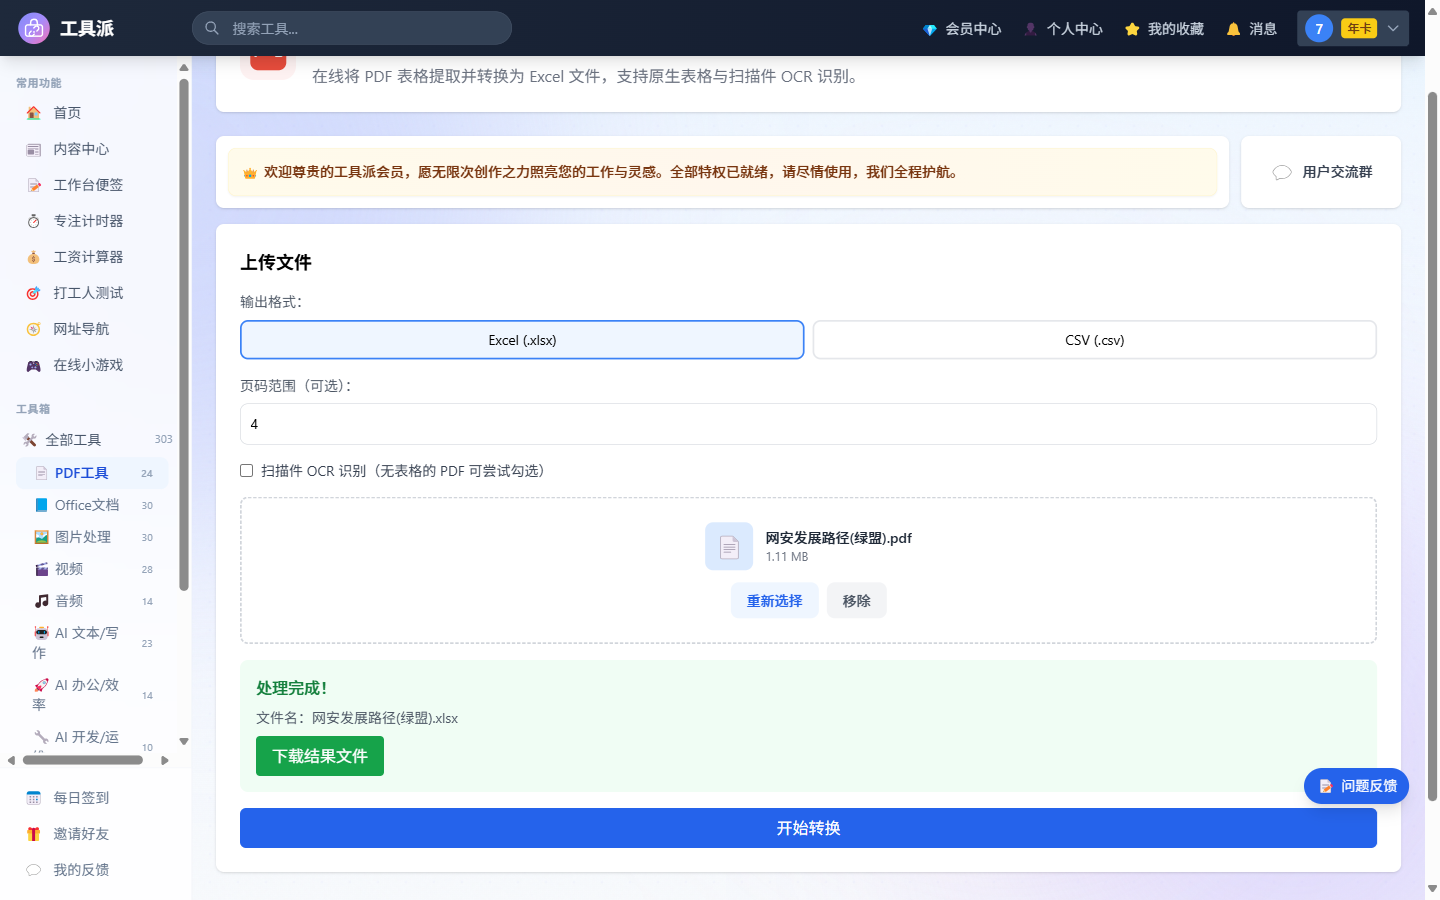
转换耗时 3 秒左右,输出了一个同名的 xlsx:
用 openpyxl 打开产物核对,结果很有意思:
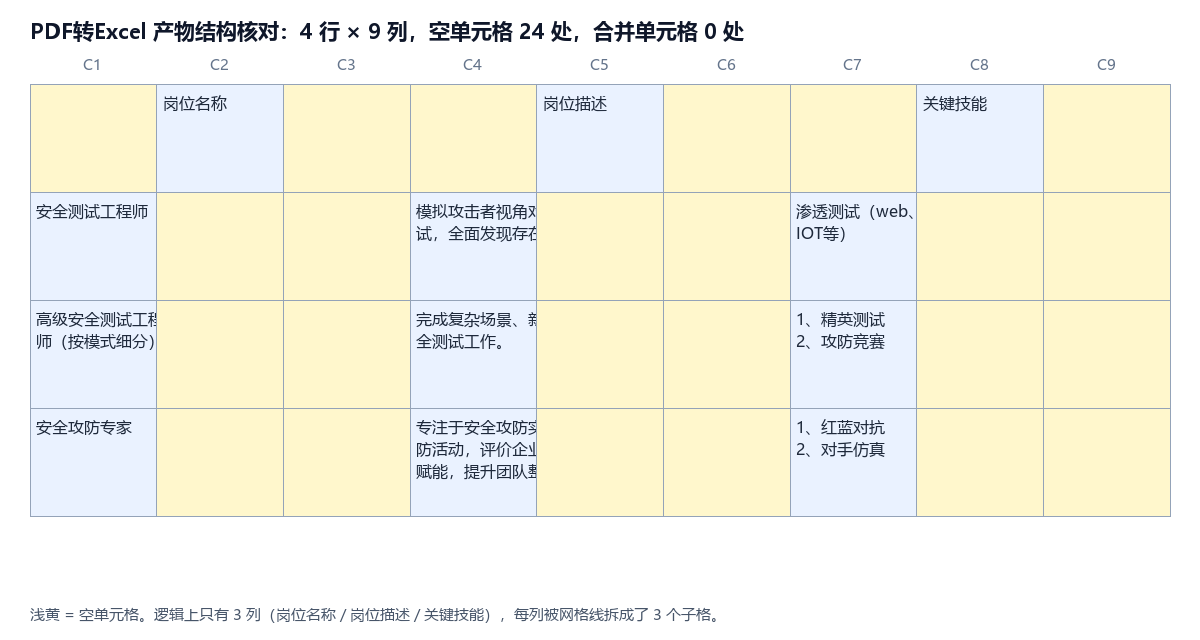
- 工作表名是"第4页",行列数据完整,一行不少;
- 但网格是 4 行 × 9 列 ,合并单元格 0 处;
- 逻辑上的每一列,被拆成了连续 3 个子格:内容落在第一个子格,后两个是空的(上图浅黄格)。
为什么会这样?回到第二节的三步就明白了:原 PDF 画这张表时,每个逻辑列内部还有辅助竖线(或者说绘制者把一个逻辑列画成了三个格子),横竖线交叉切出来的网格本来就是 9 列,转换器老老实实按线还原,输出就是 9 列。内容没有丢,丢的是"这几格本来该合并"的信息------而这个信息 PDF 里从来就没存过。
用 PyMuPDF 对同一页做线检测交叉验证,得到的也是 4×9 的网格,边界框和转换产物的行列划分一致。可以确认这不是转换工具的 bug,而是原始文件的真实几何结构。
四、几个实用结论
把这次的观察收敛成四条:
- 转完先看列数。列数比预期多,多半是原表格内部有辅助线,把空列手动合并回去就行;数据本身大概率没丢。
- 带完整框线的表最稳。无框线表格靠文本坐标猜列,多列文本挨得近就容易并错;转之前能补框线就补。
- 扫描件别用普通转换。扫描件是图片,必须走带 OCR 的路径,且识别结果要抽查------OCR 认错的字会被原样写进 Excel。
- 合并单元格要自己恢复。任何转换器都只能给你几何网格,"哪几格该合并"是语义判断,目前没有可靠的自动化方案,量小就手动。
回到标题的问题:行列不是"对"上去的,是转换器用横竖线的交点切出来的。行列错位、多出空列这些现象,根源都不在转换这一步,而在 PDF 把"表格"降维成了线和文字的那一刻。
这次验证我用的是工具派上的 PDF 转 Excel 工具,顺手记录一下。