Run:ai 开源了,我把 GPU 编排摆回 AI 栈里看了一遍
作 者:吴佳浩Alben
撰稿时间:2026.10.13 更新时间:2026.10.14
微某信公某众号:全栈架构师笔记
引言:
最近 AI 圈每天都有人在喊:"XX 开源了。"**
模型开源、Agent 开源、Runtime 开源、框架开源......
但真正值得认真看的,并不多。
因为开源两个字,从来不是重点。
真正重要的是:它到底开在哪一层。
开在模型层,影响的是能力;
开在 Runtime,影响的是性能;
开在 Agent,影响的是开发方式;
而开在 GPU 编排层,影响的是整个 AI 基础设施。
2026 年 10 月 13 日,NVIDIA 宣布将完整的 Run:ai 平台开源。
很多人把它当成了一条普通新闻。
但在我看来,这更像是 NVIDIA 把 AI 基础设施最后一块长期闭源的核心组件放了出来。
今天,我们不聊新闻。
我们把 Run:ai 放回整个 AI 技术栈,再看一次它到底解决了什么问题。
🔸 一、先说结论
三句话:
- GPU 编排该单独成一章,因为它是唯一同时管「钱」和「卡」的那一层。 Kubernetes 管机器,vLLM 管 Token,只有它管「谁用哪几张卡、用多久、占多少显存」。
- NVIDIA 买的不是软件,是 GPU 的控制面。 数据面决定算得多快,控制面决定这批算力算不算得值。把控制面开源,等于不要软件钱,换当公共层。
- 开源不等于免费企业级,也不等于赢。 NGC 上的 Community Product 不用订阅费,但不含企业支持;能不能真成为事实标准,看生态,不看许可证。
一句话:这条新闻的分量不在代码,在它承认了 GPU 编排是一个必须开放的公共层。
🔸 二、卡不缺,缺的是让卡流动
GPU 是 AI 时代最贵、也最容易被浪费的资源。
大家都在说「卡不够」。我的观察是另一回事:越来越多团队把卡买回来了,却不会用。
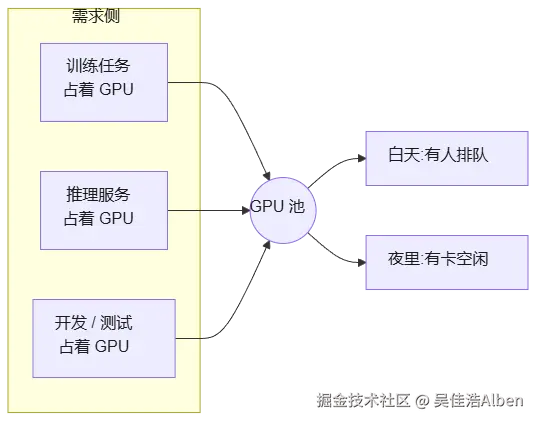
不是卡不够,是卡不会「流动」:训练占着、推理占着、开发测试占着;白天有人排队,夜里一堆空转。
真正稀缺的不是算力,是调度。
有一条口径要先说清:「最容易被浪费」是我的判断,不是测量结果。 各家算利用率的口径不一样,这里不引用任何一个「平均只有百分之多少」的笼统数字。
还有一种更隐蔽的浪费:冷启动。NVIDIA 官方博客里提到,K8s 上冷启动一个推理负载可能要几分钟------这几分钟里卡已经分配出去了,却只干一件事:把模型权重从存储搬进显存。
🔸 三、Kubernetes 为什么管不好 GPU
很多人会想:
Kubernetes 已经能调度 CPU、内存了,GPU 不也是一种资源吗?
不是。
CPU 调度被研究和打磨了几十年,面向 AI 的 GPU 调度才刚刚开始。 这就是专门的 GPU 调度层会冒出来的原因。
两者的诉求根本不是一回事:
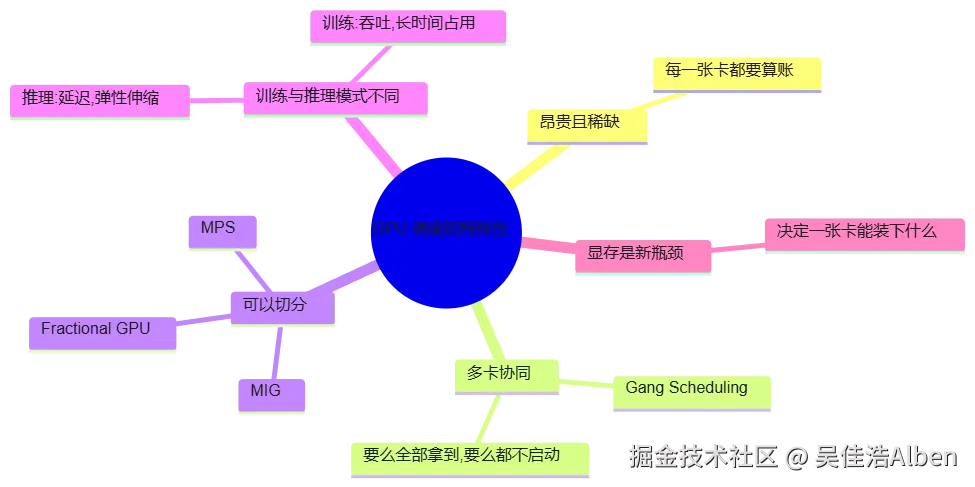
最直观的例子是 Gang Scheduling:
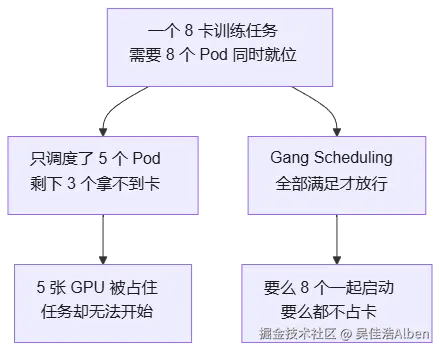
这类能力,原生 Kubernetes 调度器不擅长。
🔸 四、Run:ai 是什么
一句话:
Run:ai = Kubernetes 上面的一层 AI 工作负载与 GPU 编排平台。
它不是 Kubernetes 的替代品,也不是推理框架。
最容易被误解的地方在这一张职责图:
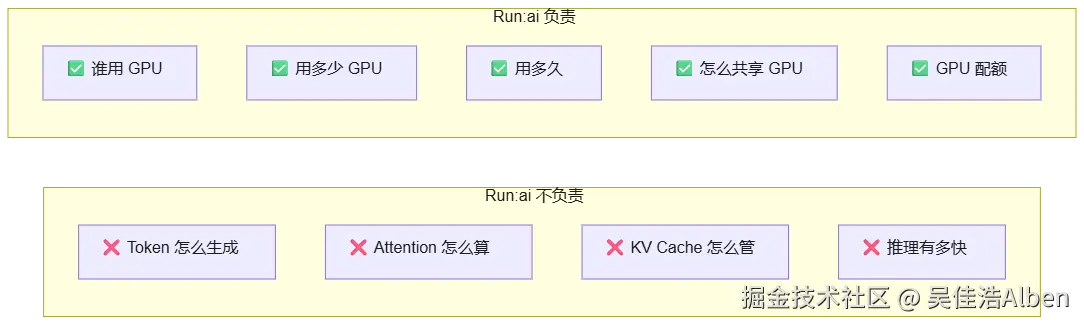
它为什么存在
因为在一个多团队共享的 GPU 集群里,这三件事会同时出现:
🔸 多卡任务要么全拿、要么不拿。 否则就是占着卡却跑不起来的死等(第三节的 Gang Scheduling)。 🔸 小负载不需要一整张卡。 Notebook、小模型推理需要能被切分。 🔸 每个团队要有自己的份额。 既要保证,又不能让人独占。
Kubernetes 给的是「通用资源调度」的底座,这三件事要在它之上再加一层面向 AI 负载的编排。这一层,就是 Run:ai 的位置。
它由什么组成
产品细节放最后。按 NVIDIA 官方的说法,这次开源包含完整平台,以及四个可以单独采用的组件:
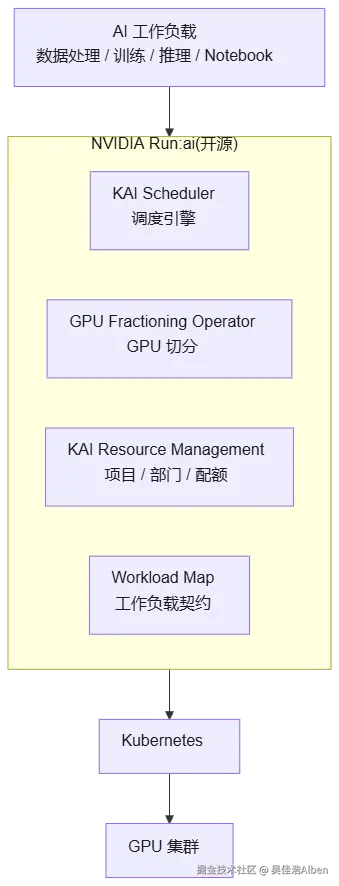
| 组件 | 解决的问题 |
|---|---|
| KAI Scheduler | 怎么放:Gang 调度、公平份额、拓扑感知、GPU 共享、DRA 支持 |
| GPU Fractioning Operator | 怎么切:基于 CUDA 原生的 GPU 切分,并给出 Pod 级指标 |
| KAI Resource Management | 给谁用:项目、部门、配额、节点池 |
| Workload Map | 是什么:统一描述 PyTorchJob、RayCluster、JobSet、KServe InferenceService |
有个细节值得单独说:Run:ai 过去用的是专有的 GPU 分片实现 ,现在这套已经退役,改用 CUDA 13.4 原生的 GPU fractioning,由 CUDA 驱动强制执行每个负载的显存硬上限。
能力下沉到了 CUDA。 记住这句话,第六节还要用。
🔸 五、NVIDIA 为什么花钱买它
先看时间线:
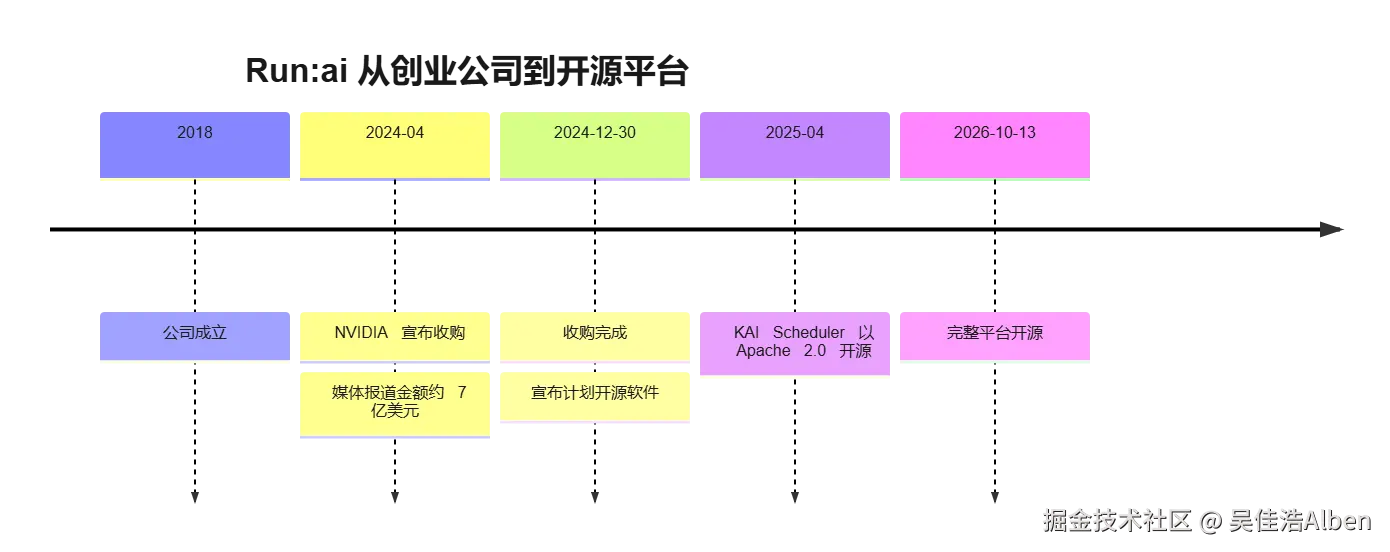
(金额口径:NVIDIA 没有官方披露,「约 7 亿美元」来自媒体报道。)
很多人认为:为了卖软件。
我的判断:不完全是。真正值钱的是 GPU Control Plane。
先把两个概念说清:
数据面(Data Plane) 负责真正执行计算。
控制面(Control Plane) 负责决定资源怎么分配。
Run:ai 更接近 GPU 的控制面。
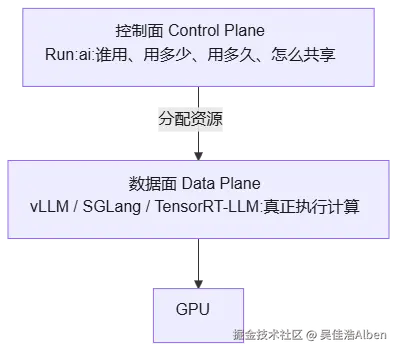
Control Plane 是我的概括,官方用词是 AI workload and GPU orchestration。把推理 Runtime 放在数据面,是为了好理解做的简化。
往后所有 AI 集群------训练、推理、微调、Agent------都要经过「谁用哪几张卡、用多久、占多少显存」这一层。
谁定义了这一层的抽象,谁就更有机会影响 GPU 的利用效率。
公平起见:这一层不止它一家
这一节不能省。
调度层同样有别的选择:NVIDIA 自己的 Grove 就提到支持 Volcano 作为调度器后端,并且在推进 Kueue 支持。
所以准确的说法是「控制面是必争之地」,不是「Run:ai 是唯一答案」。开源这件事的意义,一半在于它降低了被替代的门槛,另一半才在于它争取成为默认选择。
🔸 六、为什么是现在开源
这一节不复述新闻,只看动机。
先澄清一个事实:这不是「突然」。
🔸 2024 年底收购完成时,Run:ai 就公开说过会开源。 🔸 2025 年 4 月,调度核心 KAI Scheduler 先行开源,Apache 2.0,并进入 CNCF Sandbox。 🔸 2026 年 10 月,完整平台开源。
这是一次分步走完的开源。
我认为有三个层面的原因(以下都是我的判断):
① 能力在往 CUDA 下沉
GPU 切分已经有了 CUDA 原生实现。专有实现退役,意味着这一层不再靠「闭源的魔法」做差异化。
能被 CUDA 干掉的差异,留着收钱是留不住的。
② AI 基础设施正在标准化
企业里同时存在着 Kubernetes、Slurm、Ray、Kubeflow、KServe,每一个都在碰 GPU 调度。
没有人想为每个框架各写一套资源管理。开源更容易成为事实上的公共层。
③ 生态合作比单点销售更值钱
官方首批列出的 DSX 生态伙伴有 8 家:Crusoe、Mirantis、Nebius、OpenNebula Systems、Rafay、Saturn Cloud、Spectro Cloud、vCluster。
他们要做的是把 Run:ai 嵌进自己的云、自己的平台。开源让集成变容易。
三个原因归到一句话:Run:ai 已经从一款产品,变成 NVIDIA 希望建立的基础设施生态。(这是我的判断,不是官方表述。)
关于监管,和一条必须说清的边界
收购期间,欧盟委员会和美国司法部都分别调查过。欧委会最终批准。
媒体普遍猜测开源承诺对放行有帮助------这是媒体推测,双方都没有这样表述。
另一条边界更要紧:开源 ≠ 免费企业级。
官方写得很明确:NGC 上的 Community Product 不需要付费订阅,但不包含 NVIDIA 企业级支持。企业版仍然走 NVIDIA AI Enterprise、Mission Control 这些商业渠道。
竞争的重心正在下沉。过去竞争模型,后来竞争 Runtime,现在开始竞争 Resource Scheduler。
🔸 七、它和 vLLM、SGLang、TensorRT-LLM 是什么关系
这是全文最重要的一张图。
很多人会把它们画成一条链:Application → Run:ai → vLLM → ......
但严格说,Run:ai 不在「请求调用链」上。它决定的是另一件事:你的推理服务被放到了哪几张 GPU 上。
所以应该画两条路径:
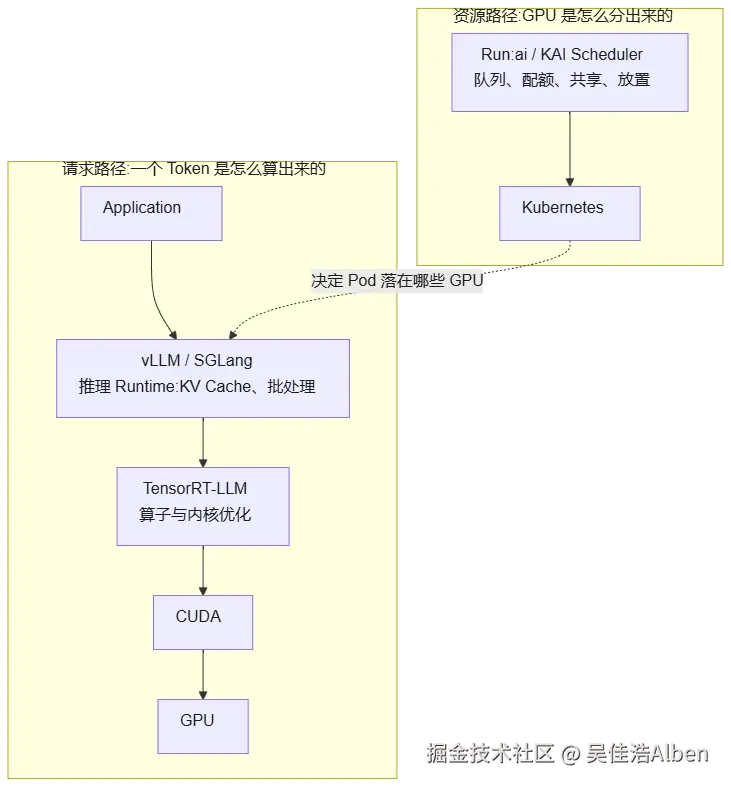
一句话分工:
🔸 Run:ai 管 GPU 怎么分。 🔸 vLLM、SGLang 管推理 Runtime。 🔸 TensorRT-LLM 管算子执行。 🔸 CUDA 管硬件。
大家优化的是不同层,不是竞争关系。
把关注点再拉高一层:
| 层 | 关注点 |
|---|---|
| Runtime | 如何让 Token 更快出来 |
| Scheduler | 如何让 GPU 不浪费 |
| Cluster | 如何让机器不浪费 |
Runtime 解决「一张卡怎么跑得快」,Scheduler 解决「一堆卡怎么用得值」。
Runtime 优化的是执行效率(Execution Efficiency);Scheduler 优化的是资源效率(Resource Efficiency)。
而且这两层之间已经有真实的连接点:Run:ai 的 Model Streamer (并发读取权重、直接流式送进显存)已经集成进 vLLM 和 SGLang,--load-format runai_streamer 就能开。
官方博客与合作方公布的部分数据:
| 来源 | 结果 |
|---|---|
| Microsoft Azure(8 台 H100 VM) | 比默认加载器快 3x--6x;吞吐稳定在 80 Gbps,默认路径约 40 Gbps |
| WEKA | 加载到 GPU 显存仅 3.5 秒,比本地 NVMe 快约 40% |
| DDN | 65.5 GB 的 Qwen3-32B 在 8 张 GPU 上不到 4 秒完成流式加载,称最多省 10% 的日 GPU 运行时间 |
这些都是厂商公开发布的测试结果,环境不同,不能横向对比。
🔸 八、栈里还要长出一层:Agent Runtime
现在的栈大致长这样。但我认为未来还会多出一层:Agent Runtime。
理由是:Agent 正在从「一次请求」变成「持续执行任务」,工具调用、状态管理、任务编排开始形成独立的运行时,于是 Agent Runtime 逐渐成为 Serving Runtime 之上的一层。
(这是我的归纳,不是行业标准分层。)
| 层级 | 代表项目 | 解决的问题 |
|---|---|---|
| AI Application | 各类 AI 应用 | 面向用户 |
| Agent Runtime(新增) | LangGraph、OpenAI Agents SDK、OpenManus | 怎么完成任务 |
| Serving Runtime | vLLM、SGLang、TensorRT-LLM | 怎么生成 Token |
| GPU Scheduler | Run:ai(KAI Scheduler) | 怎么分 GPU |
| Cluster Scheduler | Kubernetes | 怎么分机器 |
| CUDA | CUDA 驱动与运行时 | 怎么驱动 GPU |
| Hardware | NVIDIA GPU | 提供算力 |
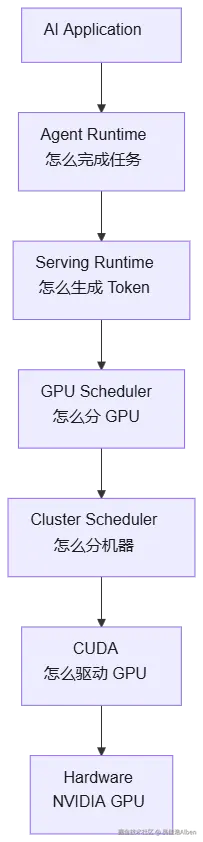
这是逻辑分层,不是调用链,和第七节的双路径图不矛盾。
未来的大模型工程师,不能只懂模型,还要理解整条 AI 基础设施栈。
🔸 九、「操作系统」这个类比,站得住吗
先把话说清:这里说的「操作系统」,更接近云计算时代 Control Plane 的概念,不是传统意义上的 Linux 内核。
不是内核,也不是桌面系统。它管的是:
🔸 资源 :GPU、显存、节点池 🔸 调度 :放置、排队、Gang、公平份额 🔸 生命周期 :从提交、运行到回收 🔸 权限 :项目、部门、配额 🔸 隔离:每个负载只看得到自己那部分显存
这些东西合起来,构成一套 AI Infrastructure OS。
这不是凭空类比,官方博客里能找到一一对应的真实功能:
| OS 的职责 | Run:ai 对应能力 |
|---|---|
| 资源管理 | GPU 共享、节点池 |
| 调度 | KAI Scheduler:Gang、公平份额、拓扑感知 |
| 权限与配额 | KAI Resource Management:项目、部门、层级配额 |
| 隔离 | GPU Fractioning:CUDA 驱动强制每个负载的显存硬上限 |
| 生命周期 | Workload Map:统一描述与管理不同类型的负载 |
NVIDIA 自己也把 Run:ai 放进了 DSX OS(官方称之为开放、模块化的软件组合)。命名本身就透露了方向。
把整条栈画完整还有一处容易画错:Memory 不是「下一层」,它横切所有层。
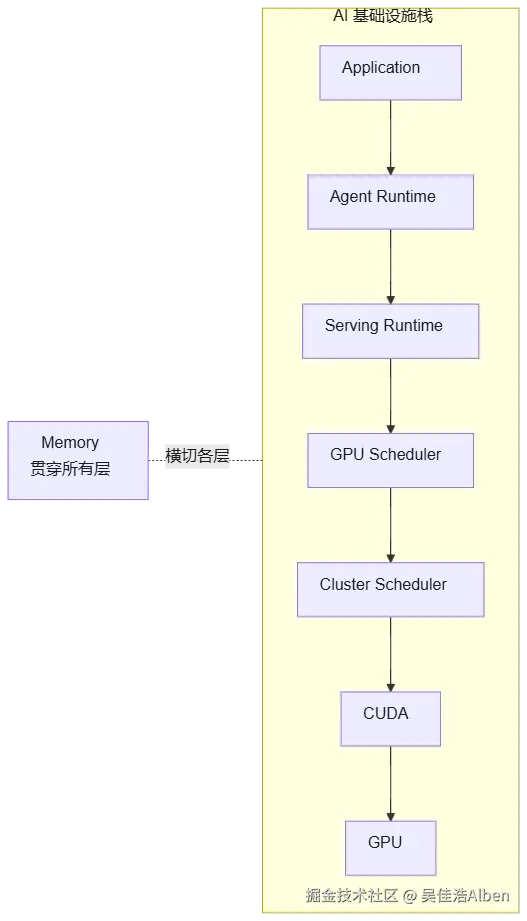
模型负责思考,Runtime 负责推理,Scheduler 负责资源。三者叠起来,就是 AI 基础设施的新分层。
Run:ai 开源,值得关注的不是代码本身,而是 GPU 编排正在从企业能力演变为开放生态。
再补一个延伸的预测:未来 GPU Scheduler 很可能成为 Agent Runtime 自动申请算力的一部分。这是我的预测,不是已发布的产品能力。
🔸 十、落到工程师身上
过去十年,Linux 定义了 CPU 时代的操作系统。
未来十年,AI 集群也会逐渐形成属于自己的「操作系统」。
个人见解:
- Run:ai 的开源不是突然,是分三步走完的承诺。
- 调度这一层的价值,在于把 GPU 从「设备」变成「可编排的资源」。
- 开源不等于胜利,生态是否真的围着它长出来,才是接下来要看的事。
说回人身上:
今天,你可能只有一张 5090。 明天,你可能要管几十张 H100。
理解 Runtime,只能让一张卡跑得更快;理解 Scheduler,才能让整个集群跑得更值。
这也是我这篇想接上之前 Runtime 系列的原因------上一篇讲的是「一张卡怎么跑满」,这一篇讲的是「一堆卡怎么用值」。如果这条线对你有用,点个关注,《全栈架构师笔记》会接着把基础设施这层往下拆。
差点忘记了 (阿拉也小小的参与了一下这个项目的开源工作感兴趣的筒子们可以留言一起探讨)
【一句话总结】Run:ai 开源值得记住的不是它开了什么代码,而是它把 GPU 编排推成了一个开放层:K8s 管机器、Runtime 管 Token、只有 Scheduler 管「谁用哪几张卡用多久」,所以它的价值在于把 GPU 从设备变成可编排资源,而它最终站不站得住,不看 Apache 2.0 的许可证,看生态愿不愿意围着它长。