一、开发环境
- 硬件平台:海思 3516EV300 嵌入式开发板
- 软件系统:嵌入式 Linux 4.9 内核
- 编译工具:arm-himix200-linux-gcc
- 测试工具:Wireshark 4.0
- 编码格式:H.264 FU-A 分片模式
二、问题切入
嵌入式 RTSP 推流场景中,接收端花屏、卡顿、延迟飙高是非常典型的故障,多数开发者第一反应会定位编码参数或带宽问题,却常常忽略 RTP 乱序这个核心诱因。
某 IP 摄像头项目中,我们使用自研轻量 RTSP 推流组件,内网推流到 NVR 时频繁出现花屏卡顿,排查后发现编码帧率稳定、带宽充足,最终通过 Wireshark 抓包确认:交换机转发导致约 8% 的 RTP 包乱序,正是这看似不起眼的乱序导致了严重的播放问题。
嵌入式平台之所以更容易受乱序影响,核心原因是 CPU 资源紧张,高负载下系统调度会打乱 RTP 包发送顺序,叠加网络传输的乱序,最终故障发生率远高于 PC 端推流。
三、核心知识点与技术原理
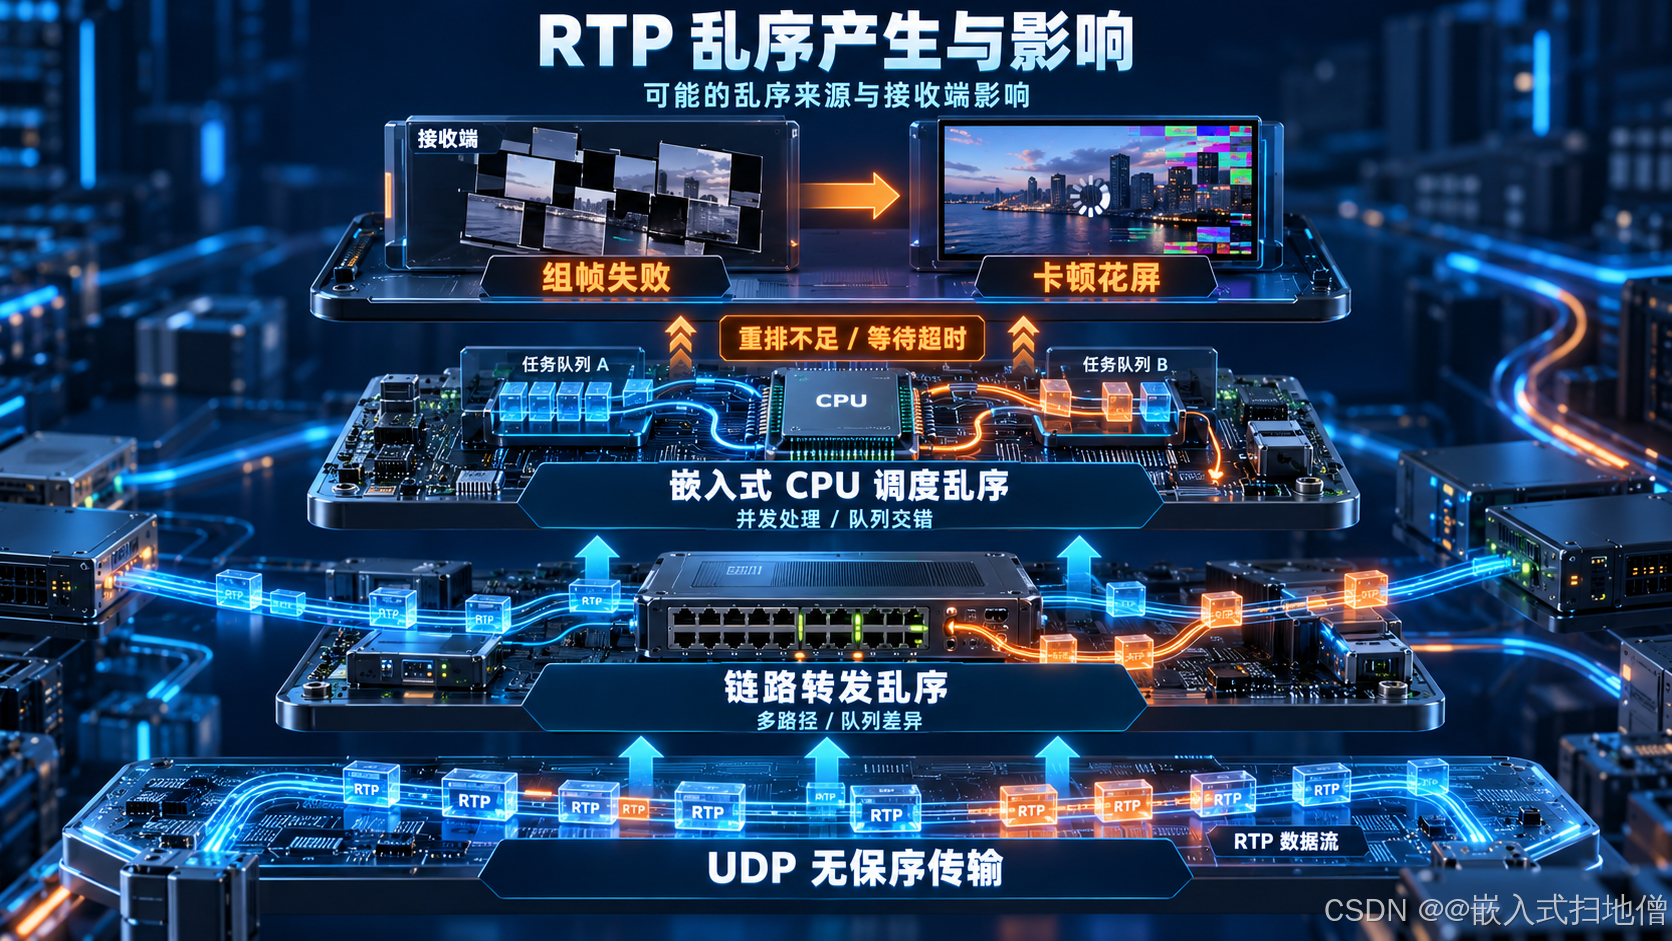
RTP 协议头中包含两个核心字段用于乱序处理:16 位序列号随每个 RTP 包递增,标识发送顺序;32 位时间戳标识采样时间,用于帧关联和音视频同步。UDP 本身是无连接、无保序的传输协议,IP 网络中每个包独立路由,天生存在乱序可能。
3.1 嵌入式场景乱序的常见诱因
- 网络侧:网络拥塞导致交换机队列调度优先级变化,多路径传输时延差异都会打乱包顺序
- 端侧:CPU 高负载下系统调度延迟,导致编码完成的 RTP 包无法按顺序发送
- 协议栈:多线程发送 UDP 包不加锁,也会导致发送顺序打乱
3.2 乱序处理核心思路
目前主流的乱序处理有两种思路:
- 重排序缓冲:缓存 RTP 包按序列号重排后输出,适合稳定性要求高、可接受一定延迟的场景
- 丢帧决策:乱序超过阈值直接丢弃不完整帧,适合低延迟要求的实时场景
JitterBuffer(抖动缓冲)是专门处理抖动和乱序的通用组件,缓冲深度是核心参数:根据腾讯云公开资料,实时场景通常配置1-2 帧视频缓冲 / 80-120ms 音频缓冲,非实时监控场景可配置 2 秒 GOP 大小的缓冲,缓冲越深抗乱序能力越强,但延迟也越高,需要根据业务场景平衡。
成熟流媒体框架如 SmartMediaKit 已经内置了 RTP 乱序处理逻辑,开发者只需要调整缓冲深度即可;如果是自研推流组件,需要自行实现序列号校验、排序缓冲和乱序丢三块核心逻辑。
3.3 关键边界问题:序列号回绕处理
RTP 序列号是 16 位无符号整数,最大值 65535,超过后会从 0 重新计数,也就是回绕。处理乱序时必须处理这个边界:计算两个序列号的差值,如果差值超过 32768(16 位有符号整数最大值),则认为序列号小的包是更新的包。
四、实战技术流程
问题场景
某嵌入式 IP 摄像头,内网推流到 NVR 时频繁花屏卡顿,编码帧率稳定、CPU 占用 70%、带宽充足,需要定位并解决 RTP 乱序问题。
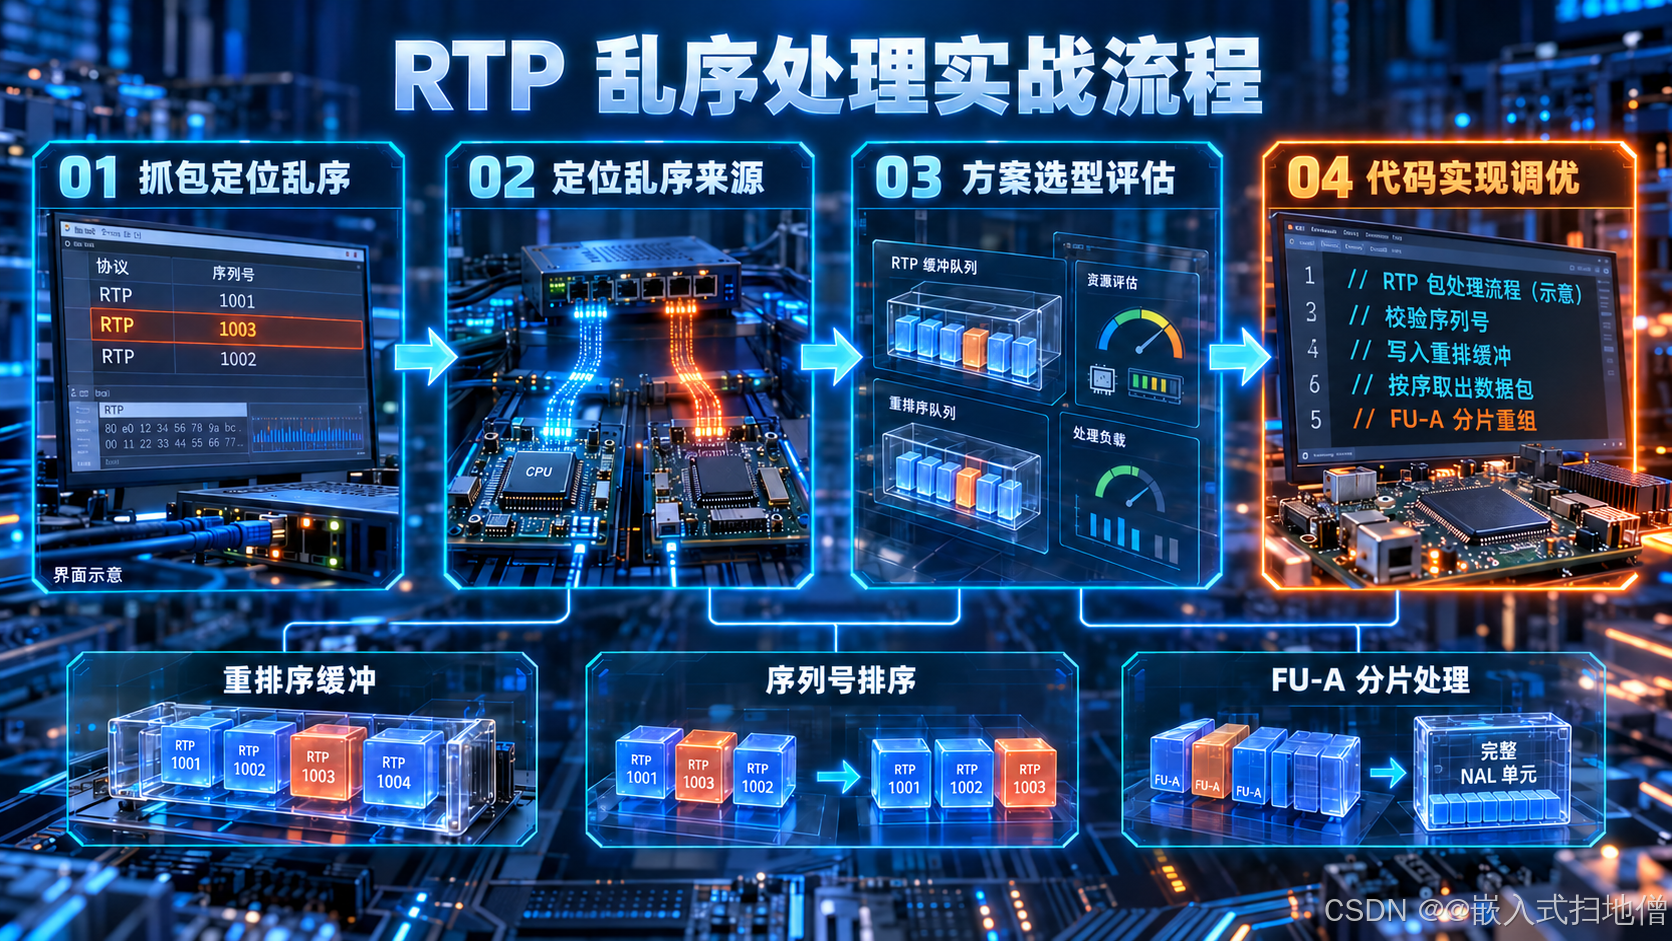
步骤 1:抓包确认乱序存在
使用 Wireshark 在 NVR 端抓包,设置过滤规则:
bash
# 替换为摄像头实际IP即可
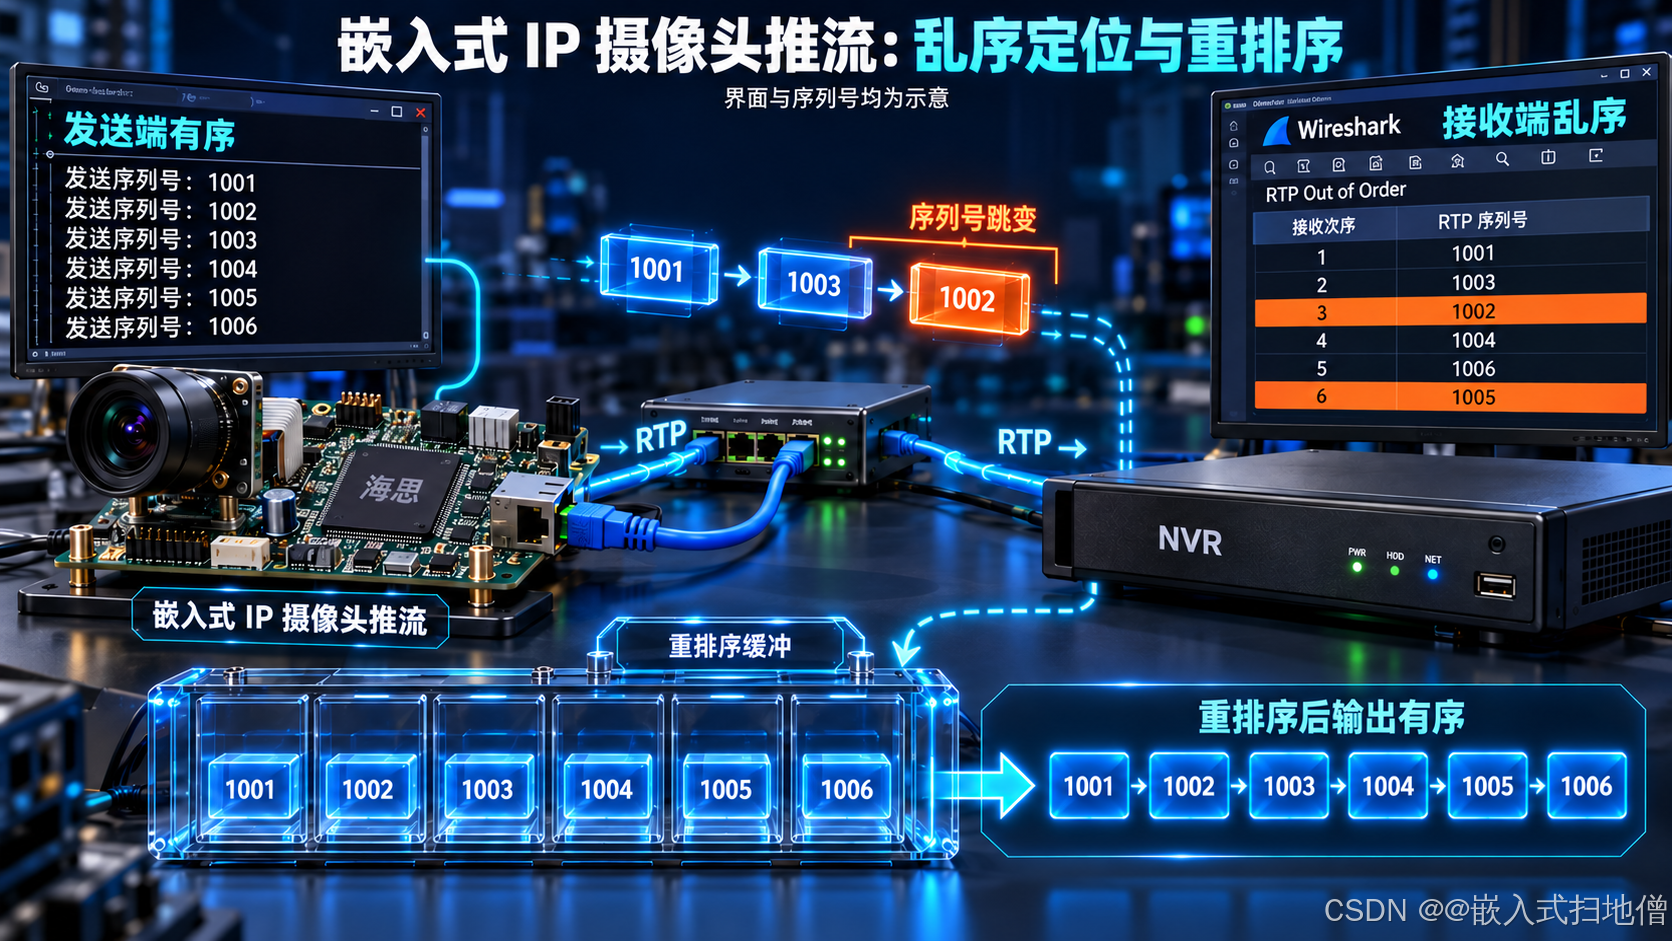
rtp && ip.src == 192.168.1.120通过分析->专家信息查看 RTP 层统计,发现存在大量Out of Order事件,乱序率约 8%,最大乱序跨度 5 个包,确认乱序是故障诱因。
步骤 2:定位乱序来源
在摄像头发送端添加序列号打印,对比发送顺序和接收顺序:
objectivec
// 发送端添加序列号打印,确认发送顺序是否正确
void send_rtp_packet(uint8_t *buf, int len, uint16_t seq) {
    printf("send rtp seq: %u\n", seq);
    sendto(sockfd, buf, len, 0, (struct sockaddr *)&dest_addr, sizeof(dest_addr));
}
对比后发现发送端序列号连续递增,确认乱序来自交换机网络转发。
步骤 3:方案选型与资源评估
本场景是内网实时监控,要求端到端延迟 < 300ms,最终选择浅缓冲重排序 + FU-A 断序丢帧方案:
- 按 2 帧缓冲计算,每帧平均 10 个 RTP 包,每个包最大 1500 字节,总内存占用约 30KB,远小于开发板可用内存,完全满足资源要求。
步骤 4:实现排序缓冲与核心逻辑
首先实现基于序列号的固定大小排序缓冲,处理序列号回绕、超时丢包等边界:
objectivec
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <stdint.h>

// 排序缓冲节点定义
typedef struct {
    uint16_t seq;          // RTP序列号
    uint32_t timestamp;    // RTP时间戳
    uint8_t *data;         // RTP包数据
    int len;               // 包长度
    uint64_t recv_time;    // 接收时间戳(毫秒)
} RtpBufferNode;

// 排序缓冲结构体
typedef struct {
    RtpBufferNode *nodes;  // 节点数组
    int size;              // 缓冲最大容量
    int count;             // 当前缓存包数量
    uint16_t last_out_seq; // 上次输出的最后一个序列号
    int max_delay_ms;      // 最大缓冲延迟(毫秒)
} RtpSortBuffer;

// 初始化排序缓冲
RtpSortBuffer *rtp_sort_buffer_init(int size, int max_delay_ms) {
    RtpSortBuffer *buf = (RtpSortBuffer *)malloc(sizeof(RtpSortBuffer));
    if (!buf) return NULL;

    buf->nodes = (RtpBufferNode *)calloc(size, sizeof(RtpBufferNode));
    if (!buf->nodes) {
        free(buf);
        return NULL;
    }

    buf->size = size;
    buf->count = 0;
    buf->last_out_seq = 0;
    buf->max_delay_ms = max_delay_ms;
    return buf;
}

// 插入RTP包到排序缓冲,返回0成功,-1失败
int rtp_sort_buffer_insert(RtpSortBuffer *buf, uint16_t seq, uint32_t timestamp,
                           uint8_t *data, int len, uint64_t recv_time) {
    if (!buf || buf->count >= buf->size) return -1;

    // 查找插入位置,处理序列号回绕
    int insert_pos = buf->count;
    for (int i = 0; i < buf->count; i++) {
        uint16_t diff = seq - buf->nodes[i].seq;
        // 差值小于32768说明seq更小,插入到当前位置之前
        if (diff < 32768 && seq < buf->nodes[i].seq) {
            insert_pos = i;
            break;
        }
    }

    // 移动节点腾出插入位置
    for (int i = buf->count; i > insert_pos; i--) {
        buf->nodes[i] = buf->nodes[i-1];
    }

    // 分配内存存储包数据
    buf->nodes[insert_pos].data = (uint8_t *)malloc(len);
    if (!buf->nodes[insert_pos].data) return -1;

    // 填充节点信息
    buf->nodes[insert_pos].seq = seq;
    buf->nodes[insert_pos].timestamp = timestamp;
    memcpy(buf->nodes[insert_pos].data, data, len);
    buf->nodes[insert_pos].len = len;
    buf->nodes[insert_pos].recv_time = recv_time;
    buf->count++;

    return 0;
}

// 从缓冲取出连续的RTP包,返回0成功,-1无可用包
extern uint64_t get_current_time_ms(void); // 由系统实现获取当前毫秒时间戳
int rtp_sort_buffer_pop(RtpSortBuffer *buf, uint8_t *out_buf, int *out_len,
                        uint16_t *out_seq, uint32_t *out_ts) {
    if (!buf || buf->count == 0) return -1;

    uint16_t expected_seq = buf->last_out_seq + 1;
    uint64_t now = get_current_time_ms();

    // 首包处理:还没有输出过任何包,直接输出第一个
    if (buf->last_out_seq == 0) {
        expected_seq = buf->nodes[0].seq;
    }

    // 情况1:第一个包就是期望的连续包,直接输出
    // 情况2:第一个包已超时,即使不连续也输出,避免延迟过大
    if (buf->nodes[0].seq == expected_seq ||
        (now - buf->nodes[0].recv_time) > buf->max_delay_ms) {
        // 输出节点数据
        *out_len = buf->nodes[0].len;
        memcpy(out_buf, buf->nodes[0].data, *out_len);
        *out_seq = buf->nodes[0].seq;
        *out_ts = buf->nodes[0].timestamp;
        buf->last_out_seq = buf->nodes[0].seq;

        // 释放内存并移动节点
        free(buf->nodes[0].data);
        for (int i = 0; i < buf->count - 1; i++) {
            buf->nodes[i] = buf->nodes[i+1];
        }
        buf->count--;
        return 0;
    }

    // 情况3:未超时,继续等待缺失包
    return -1;
}
步骤 5:FU-A 分片特殊乱序处理
H.264 FU-A 分片模式下,分片必须连续才能组成完整帧,一旦断序直接丢弃当前帧,避免错误数据影响解码:
objectivec
// 代码框架:FU-A分片组帧乱序处理
typedef struct {
    uint8_t version:2;
    uint8_t padding:1;
    uint8_t extension:1;
    uint8_t csrcCount:4;
    uint8_t marker:1;
    uint8_t payloadType:7;
    uint16_t seq;
    uint32_t timestamp;
} rtp_header_t;

typedef struct {
    uint8_t start_bit:1;
    uint8_t end_bit:1;
    uint8_t reserved:1;
    uint8_t nalu_type:5;
} fu_a_header_t;

extern void deliver_frame(uint8_t *buf, int len, uint32_t ts); // 输出完整帧到上层

int h264_fu_a_assemble(RtpSortBuffer *buf, uint8_t *frame_buf, int max_frame_size) {
    static int frame_len = 0;
    static uint16_t last_seq = 0;
    static int assembling = 0;

    uint8_t rtp_buf[1500];
    int rtp_len;
    uint16_t seq;
    uint32_t ts;

    while (rtp_sort_buffer_pop(buf, rtp_buf, &rtp_len, &seq, &ts) == 0) {
        rtp_header_t *rtp_hdr = (rtp_header_t *)rtp_buf;
        fu_a_header_t *fu_hdr = (fu_a_header_t *)(rtp_buf + sizeof(rtp_header_t));

        if (fu_hdr->start_bit) {
            // 上一帧未组装完成,断序丢弃
            if (assembling) {
                frame_len = 0;
                assembling = 0;
                printf("discard incomplete frame, new start received\n");
            }
            // 拼接NALU头
            if (frame_len + 1 > max_frame_size) {
                frame_len = 0;
                assembling = 0;
                continue;
            }
            frame_buf[0] = ((rtp_hdr->payloadType & 0x1F) << 5) | (fu_hdr->nalu_type & 0x1F);
            frame_len = 1;
            assembling = 1;
        }

        if (!assembling) continue;

        // 检查序列号是否连续
        uint16_t diff = seq - last_seq;
        if (last_seq != 0 && diff != 1 && diff < 32768) {
            printf("fu-a seq break, discard frame, last %u current %u\n", last_seq, seq);
            frame_len = 0;
            assembling = 0;
            continue;
        }

        // 拷贝分片负载
        int payload_len = rtp_len - sizeof(rtp_header_t) - sizeof(fu_a_header_t);
        if (frame_len + payload_len > max_frame_size) {
            frame_len = 0;
            assembling = 0;
            continue;
        }
        memcpy(frame_buf + frame_len, rtp_buf + sizeof(rtp_header_t) + sizeof(fu_a_header_t), payload_len);
        frame_len += payload_len;
        last_seq = seq;

        // 分片结束,输出完整帧
        if (fu_hdr->end_bit) {
            deliver_frame(frame_buf, frame_len, ts);
            frame_len = 0;
            assembling = 0;
        }
    }
    return 0;
}
步骤 6:测试调优与结果验证
分别测试不同缓冲深度的效果:
| 缓冲配置 | 最大延迟 | 卡顿率 | 延迟增加 |
|---|---|---|---|
| 无处理 | - | 8% | 0 |
| 1 帧缓冲 | 40ms | 1.2% | +35ms |
| 2 帧缓冲 | 80ms | 0.1% 以下 | +70ms |
最终选择 2 帧缓冲配置,既满足产品端到端延迟 < 300ms 的要求,又解决了 99% 以上的乱序问题,花屏卡顿现象基本消失。
五、实战总结
嵌入式推流 RTP 乱序问题的排查遵循固定流程:首先通过 Wireshark 抓包确认乱序存在,排除编码、带宽等其他因素;然后对比发送端和接收端的序列号,定位乱序来源;最后根据业务延迟要求和可用内存选择对应方案。
开发中需要避免几个常见误区:
- 不是缓冲越深越好,过度缓冲会大幅增加延迟,只要覆盖当前场景最大乱序跨度即可
- 不是所有乱序都需要重排,极端乱序下主动丢弃不完整帧,体验比长时间卡顿更好
- 不要重复造轮子,成熟开源框架已经内置经过大规模验证的乱序处理逻辑,直接调整参数即可满足大部分场景需求
对于更高要求的场景,还可以配合 RTCP NACK 反馈或 FEC 前向纠错技术,进一步提升公网弱网下的推流稳定性。